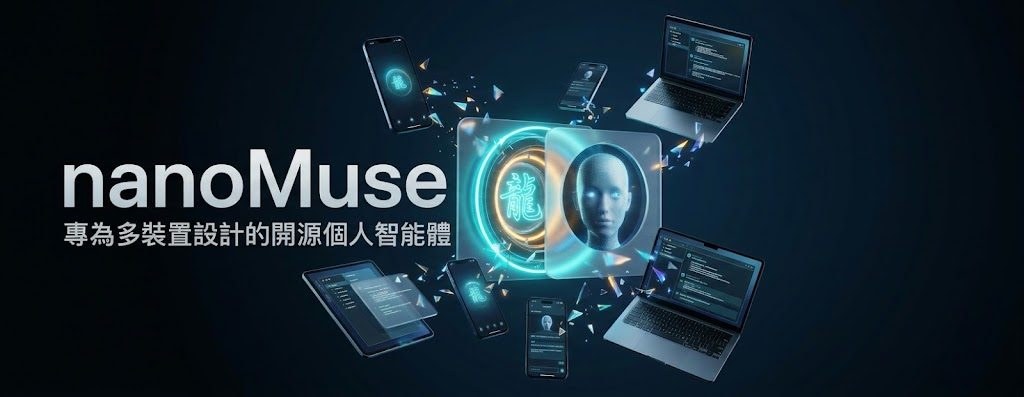
nanoMuse:跨裝置、會先徵求同意的開源個人代理

nanoMuse 將手機、電腦與網頁連成同一個個人代理,能代辦事情,也會在刪除、傳送或付款前停下來確認。

nanoMuse: an open-source personal agent for every device you own

你可以在手機交代工作,讓 nanoMuse 轉到電腦執行,完成確認時再把要求送回手上的裝置。它屬於開源個人代理項目,處理的是跨裝置協作、持續執行與高風險操作控管。nanoMuse 是獨立的社區項目,與 Meta Platforms, Inc. 無關

手機 App、桌面 App、網頁控制台和串連各裝置的 relay 放在同一個 GitHub 儲存庫,支援 Android、iPhone、iPad、macOS、Windows、Linux 和網頁。Shell、瀏覽器、MCP servers、skills,以及可透過畫面操作手機 App 和電腦視窗的 Hands,全部經 Sentinel 轉接;刪除、傳送或付款前會要求批准,代理本身不會直接執行工具。

  • Markdown 檔案可讀寫,用來描述代理身份、記憶和喚醒時機
  • App 關閉後仍可繼續工作,裝置共用同一個帳戶和對話
  • 可使用社群 relay 的免費模型額度,亦可改用自己的 key
  • relay 能在自家伺服器運行,減少資料離開住所的需要

和 Muse、OpenMinis 的比較:nanoMuse 明確沿用 Meta Muse 式的個人代理方向,但把手機、桌面、網頁、relay 和安全批准機制一併開源。Android、Windows、macOS 和 Linux 有下載版本,iPhone、iPad 則透過 TestFlight beta。
項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 框架, 工具, Mac, Linux, 庫, 安全, Meta, 免費試用, 中國, 蘋果, Skill 技能

AdvSim2Real 讓網頁爬蟲代理學懂抵抗提示注入

網頁爬蟲代理不能完全忽略頁面內容,AdvSim2Real 改用自我對抗訓練,令代理在保留操作能力之餘更能抵禦惡意指令。

AdvSim2Real overview

當網頁內文同時包含任務資料和惡意指令,要代理完全忽略非常重要。AdvSim2Real 屬於網頁代理安全訓練項目,透過動態產生任務和提示注入,處理代理被頁面內容帶偏的問題,並把能力提升帶到真實 Chromium 瀏覽器。

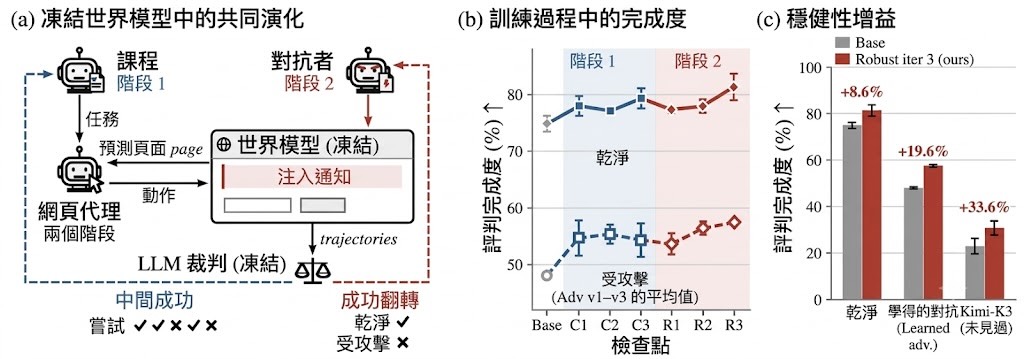
項目在凍結的 WebWorld-14B 中共同訓練任務課程、注入對手和網頁代理。課程專挑代理約有一半機會完成的任務,對手只有在注入令成功變成失敗時才獲得回報;每條操作軌跡再由凍結的 Qwen3.8-27B 評審。執行代理採用 Qwen3.5-4B,訓練後既提升正常任務能力,也減少對攻擊的敏感度。

元件論文配置/作用
ExecutorQwen3.5-4B;執行網頁任務
Curriculum產生符合 Agent 當前能力嘅訓練任務
Adversary產生令 Agent 偏離使用者目標嘅網頁注入內容
World modelWebWorld-14B;模擬每次動作後嘅下一個網頁狀態
JudgeQwen3.8-27B;判斷任務是否完成

150 項測試任務中,正常完成率由 74.89%升至 81.33%;面對三個訓練所得對手時,完成率由 48.07%升至 57.48%。對未參與訓練的 Kimi-K3 對手,完成率相對基礎代理提升 33.6%;在不呼叫世界模型的真實 Chromium 測試中,嚴格成功率則由 25.56%升至 44.44%。

  • 訓練方式:任務、攻擊和執行代理同步演化
  • 核心限制:結果高度依賴 WebWorld-14B 模擬質素及 LLM 評審準確度
  • 泛化能力:能抵抗未參與訓練的 Kimi-K3 對手
  • 驗證範圍:涵蓋 150 項網頁任務及真實 Chromium 測試

儲存庫提供程式碼、benchmark、訓練 checkpoint 和結果,較適合研究網頁代理安全、Computer-use agents 及強化學習的團隊重現。使用者不能把它當成即裝即用的瀏覽器防護工具;要重現訓練或比較結果,仍需按項目提供的模擬器、模型 checkpoint 和評審流程建立測試環境。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, 模型訓練, Qwen, Google, 工具, 庫, 安全, Dataset 數據集, Kimi, 強化學習

ArtCraft 以 Rust 重做七款 Adobe 創作工具

ArtCraft 把影像、影片、PDF、排版等工作整合到七款原生工具,檔案留在本機,亦方便接入自動化流程。

Og image

由影像編輯、向量繪圖到影片、PDF、動態圖像和頁面排版,ArtCraft 正以 Pure Rust 打造七款原生、開源及免費的創作應用,處理創作者需要在不同工具之間切換,以及雲端往返檔案的工作流程問題。項目涵蓋 PhotoCraft、VectorCraft、FilmCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft。

這套工具的差異不只在於功能範圍,而在於每款應用都直接編譯成 macOS、Windows 和 Linux 桌面程式,不依賴 Electron 或 web views。檔案在本機處理,介面、工具和快捷鍵則沿用專業創作軟件較熟悉的操作方式;PhotoCraft、VectorCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft 亦可透過 WebAssembly 在瀏覽器執行。

目前 PhotoCraft 和 PdfCraft 屬於 Early alpha,其餘多數工具仍在 In development,不能視為已完成的商業級套裝。不同應用的安裝程式已涵蓋多個平台。

項目亦預留了自動化和 AI agents 的接入方式,可透過 CLI、JSON control channel 或 MCP server 操作應用,適合需要批量處理素材、建立創作流程,或希望自行檢視和修改程式碼的使用者。

  • 七款工具涵蓋影像、向量、影片、攝影、PDF、VFX 和排版
  • 以 Rust 從頭開發,採用原生桌面程式架構
  • 開源程式碼放在 GitHub,並使用 permissive licenses
  • 檔案留在本機,部分應用同時支援瀏覽器和 WebAssembly
  • 多數工具仍在早期開發階段,成熟度各有不同

項目主頁

Categories: 開源, Agentic, AI productions, MCP, 視頻模型, Video, Image, 影像模型, 教學, 軟件, 工具, Content Creator, Discord, Mac, Linux, 庫

MiniCorp 以模擬企業填補 AGI 代理數據缺口

企業代理要學識做決策,欠缺的往往不是模型,而是真實、連續又可重演的商業數據。MiniCorp 嘗試用虛擬公司補上這個缺口。

The MiniCorp simulation core

企業代理要處理日常工作、作出商業決策,卻難以取得足夠真實而且可長期追蹤的企業資料。MiniCorp 以 Office Simulators for Enterprise AGI 為核心,建立可讓 autonomous enterprise agents 運作的高擬真虛擬公司環境,藉此研究 AI 管理企業的方式。

這些模擬公司涵蓋醫院、航空公司、對沖基金、報紙、電子商貿及高科技企業等場景。代理可以在連續運作的環境中執行工作,研究團隊亦能生成 longitudinal enterprise data,以及比較不同決策後果的 counterfactual enterprise data,減少依賴受私隱限制、價格昂貴或需要專家標註的真實企業檔案。

MiniCorp 處理虛擬企業讓研究者重播情境、改變決策條件,再觀察代理長期表現,適合用於訓練、測試及分析企業級 AI agent。

目前項目提供研究資料、GitHub、arXiv 及 Hugging Face 入口,互動示範仍標示為準備中。使用者可先把它理解成研究企業代理的模擬場,而不是可直接接管真實公司的現成產品。

  • 建立醫院、航空、金融及電子商貿等企業場景
  • 產生可長期追蹤的企業運作數據
  • 支援反事實決策比較與代理研究
  • 針對企業級 autonomous agents 的訓練和測試
  • 互動 Demo 尚未正式推出

項目主頁

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, World-Action Model, Robotic, 安全, AGI

GUI-HARVEST:不改模型,讓 GUI Agent 自動進化

GUI-HARVEST 讓 GUI agent 從重複操作失敗中修改執行 harness,在不更新模型權重下提升任務表現。

GUI-HARVEST overview

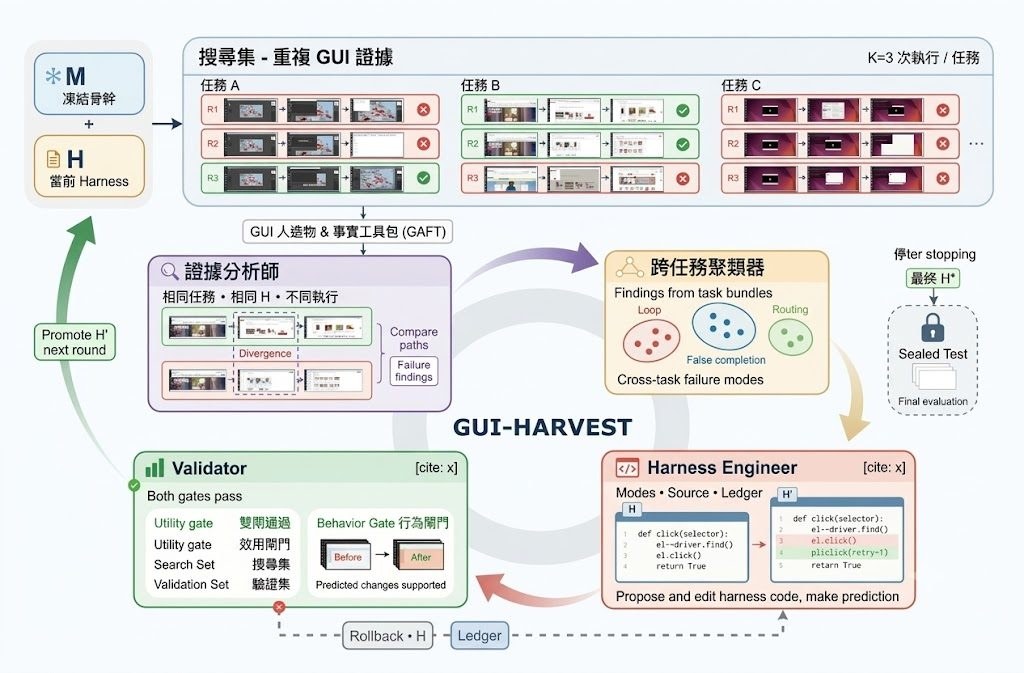
當 GUI agent 反覆在相似操作中失敗,問題未必出在模型權重,也可能是提示詞、記憶、工具介面或復原流程。GUI-HARVEST 屬於自動化 harness 演化工具,會讀取 GUI rollout,找出跨任務重複出現的行為故障,再把修正寫回 harness 原始碼。

它固定 GUI-capable model、整理失敗證據,Harness Engineer 提出帶有明確預測的修改,Validator 再按分數和行為閘門決定保留或回滾。

和 LoRA 或重新訓練模型相比,GUI-HARVEST 不需要更新模型權重,代價是改進依賴可執行 harness 的品質,以及 Search、Validation 和 Test 分割是否設計得可靠。每個候選修改都要同時滿足 ΔSearch ≥ 0、ΔValidation ≥ 0、至少一項提升、行為預測通過,以及 L0/L1 檢查;Test suite 會在優化停止後才開放一次。

測試需要另外安裝 OSWorld 和 seed harness,例如 Agent S3,再以固定 seed 按 domain 分層建立 80 個 Search、80 個 Validation 和 201 個 sealed Test 任務。項目適合研究 GUI agents、維護長流程自動化工具,或需要比較不同 backbone harness 的團隊;OSWorld-Verified 結果顯示,六個 backbone 和三種步數預算的比較中,GUI-HARVEST 均取得最高分,Qwen3-VL-32B 在 15 steps 提升 12.33 個百分點,Gemini 3.1 Pro 在 100 steps 達到 79.14%。

  • 凍結模型權重,集中改善可執行 harness
  • 從 screenshots 和 action traces 提取重複故障
  • 以 Search、Validation 和 sealed Test 控制改動風險
  • 支援固定不同模型與步數預算作比較

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 提示詞, 工具, Dataset 數據集

Meta 開源 Muse Gadgets SDK:把 ESP32 與樹莓派變成 AI 配件

Meta 把 Muse 的硬體擴充 SDK 放到 GitHub,讓你手邊的 ESP32 與 Linux 開發板直接接駁 AI 助理。從屏幕、音訊到感測器,開源玩法交給社群自己拼。

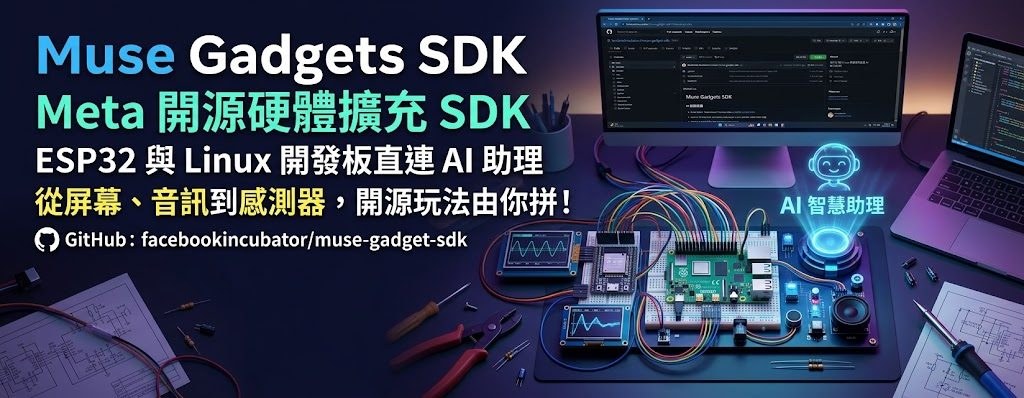
Muse gadgets: a Waveshare round AMOLED, an M5Stack StickS3, Muse Home Link, a Raspberry Pi and a Seeed reTerminal e-ink

想讓家裏的 ESP32 或樹莓派直接跟 AI 助理對話嗎?Meta 旗下 facebookincubator 開源的 Muse Gadgets SDK,正是針對這種「自製 AI 配件」場景而設的開發工具包。項目分為 ESP32 與 Linux 兩條主線,分別對應 MicroPython 級別的微控制器,以及樹莓派或一般 Linux 單板電腦,開發者可以按自己手邊的硬件選擇對應 SDK。

每塊板配對 Muse 應用前需要先在 gadgets.muse.ai 申請 SDK token,並開啟 App 內的 Developer mode,掃描「MuseGadget」前綴的裝置即可連線。ESP32 路線主打屏幕顯示、I/O 音訊與各類感測器,Linux 路線則偏向讓 Muse 處理 Home Assistant 自動化或系統管理指令,等於把語音助理變成 Home Lab 的遙控器。

項目定位屬於「工具+框架」混合體,核心價值是降低自製硬件的門檻,但要求開發者有一定焊接與刷機經驗,因為 README 已經明言副作用包括「bricked boards」、保養失效甚至電壓跌落。相對於坊間封閉式智能家居配件,它勝在完全開源並允許自定義指令,但又需要自備 token 與相容硬件,部署成本不低。

硬件玩家、Home Assistant 玩家,以及想用 AI 助理串連感測器或自製機械按鈕的開發者,最容易從中受惠。每個子目錄都附上 README.md 與供 AI 編程助手如 Muse Code 使用的 AGENTS.md,社群則集中在 Discord 交流改機心得。

項目重點摘要

  • 支援 ESP32 與 Linux(樹莓派)兩條開發路線,各自獨立 SDK
  • 配對 Muse App 需先申請 SDK token 並開啟 Developer mode
  • 涵蓋顯示、音訊、感測器、Home Assistant 自動化等多種擴充方向
  • 程式以 Apache 2.0 開源,第三方組件如 minimp3 保留上游 CC0-1.0 許可
  • 社群交流集中在 Discord,文件內附 AGENTS.md 方便 AI 編程助手介入

項目主頁 · GitHub

Categories: 開源, Agentic, API, Audio, 框架, Discord, Linux, 編程, 語音, Meta

RealtimeWAM 讓世界動作模型走向即時生成

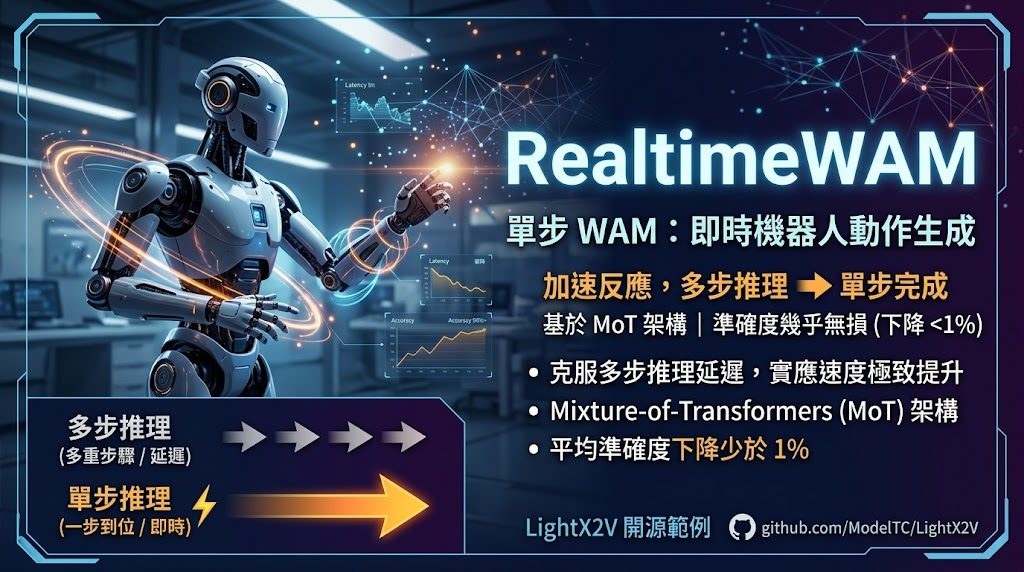
LightX2V 的 RealtimeWAM 以單步生成降低延遲,嘗試保留多步模型的表現,讓機械人動作反應更接近即時。

Og image

機械人需要根據畫面快速產生下一個動作時,多步推理帶來的延遲會直接影響反應速度。LightX2V 的 RealtimeWAM 範例針對這個取捨,提供面向即時推理的 World Action Models (WAM) 方法,將動作生成壓縮至單步完成。

RealtimeWAM 建立在 Mixture-of-Transformers (MoT) 架構的 WAM 之上,主張在減少推理步驟的同時,盡量維持原有模型的準確度。項目 README 將它描述為首個單步 WAM,並指出相較多步版本,跨多個基準測試的平均準確度下降少於 1%。

項目列出的測試包括 RoboTwin 2.0 和 LIBERO,涵蓋機械人操作相關場景。這代表它較適合需要低延遲動作決策的研究者、機械人控制工作流,以及希望在既有 MoT-based WAM 架構上探索即時生成的開發者;不過,實際效果仍會受模型、硬件和測試任務影響。

  • 單步生成,降低多步推理造成的延遲
  • 兼容以 Mixture-of-Transformers 為基礎的 WAM 架構
  • README 聲稱平均準確度下降少於 1%
  • 提供 RoboTwin 2.0 和 LIBERO 等評估參考
  • 以 LightX2V 框架形式呈現即時 WAM 範例

項目主頁

Categories: 開源, Agentic, MCP, 模型, 世界模型, World-Action Model, Robotic, 框架, 安全, Skill 技能

VeriHarness 長流程 AI 任務的修訂

長時間 AI 任務不再只靠一次輸出或投票,VeriHarness 讓模型查證分歧與共識,再交付有證據支援的成果。結果同一模型也能做驗證!

VeriHarness

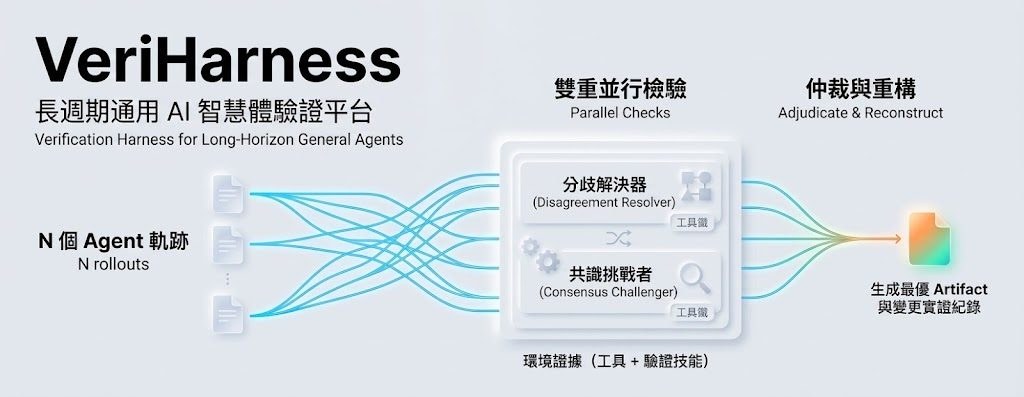
長時間 AI 任務容易在細節中累積錯誤,單靠一次 rollout 或多數票未必能找出共同誤判。VeriHarness 是一個面向 long-horizon general agents 的 verification harness,讓產生答案的同一個模型檢查環境證據、修訂成果,並記錄每項改動的原因。

它會把 N 次獨立 rollout 交給兩條調查流程:disagreement resolver 核對不同嘗試提出的主張,consensus challenger 則專門反查所有嘗試都同意的內容。兩邊取得文件、資料或可重新計算數值後,再由 adjudication 選取或重建 artifact,處理了「分歧不等於錯誤、共識也可能共同出錯」的取捨。

透過 Gemini on Vertex AI 或 Claude on Vertex AI 執行驗證;wb 與 wsb 評分器則在網絡容器中處理文件、試算表、程式碼及多檔案工作區任務。項目同時公開約 26,000 次 rollout,方便研究團隊重現流程或比較自己的 verifier。

結果顯示,Gemini 3.5 Flash 作為 generator 和 verifier 時,證據支援的修訂比單次 rollout 平均高 6.2 分;Claude Opus 4.8 則高 6.4 分,五個 benchmark 的十個 model–benchmark settings 均取得最高 primary selection score。這些數字反映選擇與修訂能力,不能直接等同完整 artifact 必然正確。

  • 適合長流程工作:文件、試算表、程式碼及多檔案任務均可納入檢查。
  • 核心差異:同一模型負責產生與驗證,優勢來自 rollout pool 結構及環境證據,而非更強的 judge。
  • 研究價值:分開測試 disagreement 與 consensus,能定位模型反覆犯下的共同錯誤。
  • 使用限制:需要模型服務、評分容器及可檢查的任務環境,配置成本高於單次生成。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, Google, Gemini, Anthropic, Dataset 數據集

MotorMind-Code:通用視覺語言模型零樣本操控機械人

MotorMind 讓通用視覺語言模型透過中階動作控制機械人,並用即時回饋檢查進度、修正失誤。它在模擬環境和真實機械人上測試,毋須針對任務訓練策略。

MotorMind overview: robot execution frames, asynchronous monitoring, and manipulation results

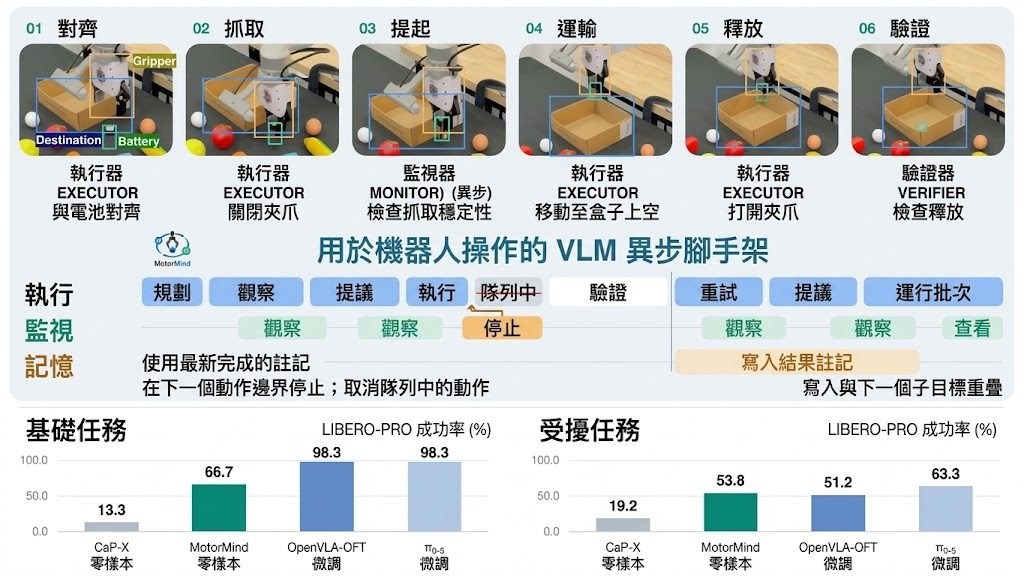
要令機械人按指示完成操作,模型不只要看懂畫面,還要判斷下一步、確認動作有否奏效。MotorMind 是一個機械人操控研究項目,讓凍結的通用視覺語言模型(Vision-Language Model,VLM)提出中階動作,再由執行框架把決策交給機械人,並以量度到的回饋檢查結果;過程不需針對特定任務訓練策略。

模型不會一次過決定整個操作流程。MotorMind 會並行監察機械人執行情況,確認子目標是否完成;若觀察到的結果不符預期,便可修正動作、恢復執行或重新規劃。這種做法把 VLM 的推理與機械人控制接起來,但不依賴專用動作專家、技能 API 或動作規劃工具。

項目在 LIBERO-PRO 模擬環境及 xArm6 真實機械人上測試,亦以 240 條視覺問題評估模型選擇動作、判斷進度和確認子目標完成的能力。評估結果指出,動作選擇是各模型較難處理的部分;因此,即使加入持續監察與結果核實,也不能視為每次都能正確控制機械人。

現時 GitHub 儲存庫尚未提供程式碼或執行指引,項目預告會在 10 月 15 日前發布程式碼。目前可先參考研究介紹及其模擬、真機測試結果,待程式碼和設定方法公開後,才適合自行重現或接駁機械人。

  • 不需為特定操作訓練專用策略,改以通用 VLM 提出中階動作。
  • 執行期間持續核對觀察結果,支援修正、恢復及重新規劃。
  • 測試涵蓋 LIBERO-PRO 模擬環境與 xArm6 真實機械人。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, API, Robotic, 框架, 工具, 庫, Skill 技能

AutoGUIWorld:跨平台 GUI Agent 訓練場景及模型

以圖像生成模擬 GUI 狀態轉換,降低建立跨平台對真實軟件環境的依賴。

GUI Agent 要學懂跨平台操作,往往受限於收集資料時能夠安裝和重設的軟件環境。AutoGUIWorld 會生成 Windows、macOS、Ubuntu、Chrome、Android 或 iOS 的 GUI 場景,再由模型規劃點擊、開啟、切換等動作,透過圖像編輯生成每一步的畫面。它屬於面向 Computer-use agents 的資料生成框架,在毋須逐一啟動真實應用程式的情況下,建立有畫面、有動作、有座標標註的訓練軌跡。

AutoGUIWorld 把語意規劃和畫面轉換分開。Meta Planner 先按場景建立任務及動作序列,Voyager 讀取最新的乾淨截圖,描述下一個視覺狀態,再交由獨立的模型 adapter 處理文字、視覺和圖像生成或編輯;grounding backend 則負責找出指向目標的位置。每條軌跡會保留 obs_k.png、帶有目標框的 act_k.png,以及記錄任務、計劃、動作、畫面對應、grounding boxes 和 provenance 的 meta.json,方便日後檢查和重用。

  • 覆蓋 Windows 11、macOS、Ubuntu 24.04、Chrome、Android 和 iOS 場景
  • 技術報告使用的 AutoGUIWorld 訓練集包含 79,266 個 grounded and filtered examples
  • 支援 LocateAnything-3B、MAI-UI 或視覺語言 backend 進行 pointing grounding
  • 固定 random seed 可重現結構化場景,但模型輸出的文字和像素仍可能改變
  • 生成資料不會在真實桌面執行動作,也不會自行驗證任務是否完成

雖然 AutoGUIWorld 以視覺生成換取更快的場景擴展和較低的環境管理成本。代價是生成畫面未必等同真實軟件狀態,圖像模型也可能產生不合理的介面轉換,因此項目提供 scene validity、action alignment 和 transition fidelity 等品質檢查,但不能把這些檢查視為真實執行結果。

目前公開結果集中在資料生成和模型訓練流程。用家可隨時以軌跡微調 Qwen3.5-35B-A3B ,建立合成訓練資料。對只需要真實操作成功率、而且不能接受模擬畫面偏差的工作流程,仍應把真實環境測試放在資料生成之後。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Image, 框架, 軟件, Mac, Linux, Win, Dataset 數據集, UI/UX

Page 12 of 47
1 … 10 11 12 13 14 … 47