CASE 讓 8B 模型主動尋找長期病歷證據

CASE 訓練視覺語言模型自行翻查跨時段 MRI 與臨床資料,將醫療問答由讀答案推進至主動取證。

Repository image for VinyehShaw/CASE

面對需要比較多次就診、器官變化與 MRI 切片的臨床問題,CASE 讓模型先決定應該查哪次訪視、哪個器官及哪種工具,再整理證據作答。這個項目屬於醫療多模態模型與 Agentic learning 實作,處理的是長期臨床推理中「證據未預先整理」的難題。

核心模型採用 Qwen3-VL-8B-Instruct,透過兩階段訓練建立工具使用能力:先以 RSFT 學習經篩選的教師軌跡,再以 Agentic RL 和 GRPO 讓模型根據自身操作結果修正策略。RLAIF rubric judge 負責評分,OPSD 則利用 privileged self-distillation,改善由證據走向結論的推理,而不硬性規定工具次序。

同一個 checkpoint 會按三種臨床角色工作:Anatomist 處理器官分割和體積變化,Radiologist 比較跨訪視 MRI,Consultant 則綜合影像、體積、MedGemma 報告和 skill memory。工具預算由 4 至 12 次不等,反映不同任務在查證深度與成本之間的取捨。

  • 以 UK Biobank 4,739 名參與者建立 50,401 條縱向臨床問題
  • 訓練資料包含 147,434 條 frontier-model 互動軌跡
  • 在匹配條件下,Qwen3-VL-8B agent 的答案準確率較 GPT-5.4 高逾 16%,較 Claude Opus 4.8 高逾 10%
  • 適合研究醫療 agent、MRI 分析及跨訪視證據整合的團隊

項目提供 Docker 環境,但執行預設需要 8 張 GPU、運行時可用的 gcc、另行下載 Qwen3-VL-8B-Instruct 權重,以及供 RL rubric judge 使用的 OpenAI-compatible API key。資料須透過 UK Biobank Showcase 或已獲批的 UKB-RAP 申請取得;適合作為研究型項目測試,未宜直接視為可即時投入臨床的產品。
項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 多模態模型, 模型訓練, Qwen, API, Image, 工具, Medical醫學, Dataset 數據集, Skill 技能, 強化學習

ProgramGym:程式重製代理訓練

由可驗證環境到持續開發流程,ProgramGym 把程式重製代理的訓練推向長流程任務。

ProgramGym logo

要令 coding agent 重建一個未公開實作的程式,單靠規格並不足夠,還要探索參考執行檔、推斷行為、設計架構,再反覆修正。ProgramGym 屬於面向程式重製代理的訓練環境與工作流程項目,透過 Program-Env 和 Program-Agent 處理測試環境難以大量建立、長時間開發容易失去脈絡兩個問題。

Program-Env 會由真實 repository 建立參考 executable 和 runtime sandbox,再以驗證回饋逐步產生 behavioral tests;Program-Agent 則把分析、實作和 review 分開處理,利用持續保存的交接紀錄與 revision checkpoints,讓代理可以延續多輪工作,而不是每次重新理解整個程式。

項目目前提供 ProgramGym-1648 dataset,涵蓋 Go、C++、Rust 和 C,共 1,648 個可驗證任務,其中 Go 有 818 個。資料集適合用來訓練或比較 coding agents,尤其是需要黑盒探索、跨多個修訂階段,以及重視行為相容性的工作情境。

• Program-Env 負責建立 executable、sandbox 和行為測試
• Program-Agent 分拆分析、實作與 review 流程
• 任務涵蓋四種系統程式語言及八個領域
• Qwen3.8-27B 基準分數由 34.87% 提升至 42.84%
• 配合 Program-Agent 後,分數提升至 55.71% 或 56.25%

測試結果顯示,Qwen3.8-27B 配合 Program-Agent 達 55.71%,Qwen3.8-27B-SFT 則達 56.25%,較各自基準明顯提升,但仍低於 Claude Opus 4.8 的 70.9% 和 GPT-5.6 Sol 的 69.9%。GitHub 儲存庫主要是資訊中心,提供論文、項目網站及 Hugging Face 資源連結;原始資料沒有交代完整安裝或本地執行步驟,使用者需要先按相關資源了解取得方式。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型訓練, Qwen, Vibe Coding, 庫, 編程, Dataset 數據集

REA:讓 AI 逆向拆解 App 功能至二進制層面

想複製別人 App 的功能,REA 讓 AI 代理在沒有原始碼下調查行為、保留證據,並協助重建。

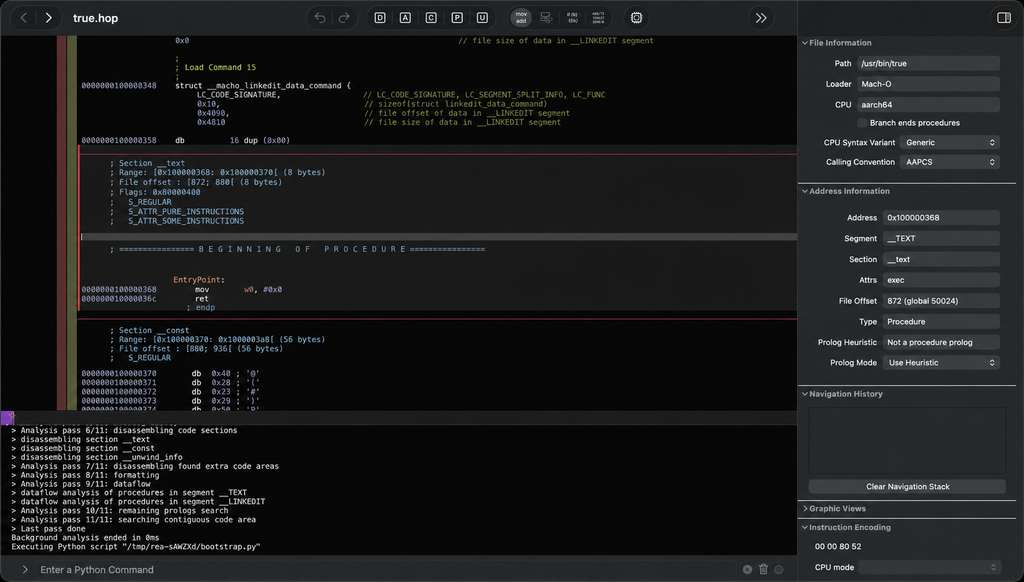
REA launching its analysis bridge inside Hopper while inspecting a native binary

想知道一個 App 的功能點樣運作,卻拿不到原始碼,REA 讓 AI 代理直接檢查應用程式、原生二進制檔案及執行時行為,再用證據解釋結果。它屬於開源逆向工程工具,實際處理的是由功能觀察、底層分析到重建實作的工作流程。

REA 以 Model Context Protocol(MCP)把分析工具接入代理,代理可按步驟展開調查,讀取工具結果、管理 sessions,並將 snapshots 匯出或匯入。對產品團隊而言,價值不只是找出某個功能的表面行為,而是把調查所得轉化為自己項目的實作參考;不過分析結果仍取決於可取得的執行環境、工具支援及代理判斷,不能視為自動產生的完整原始碼。

How To Use REA To Clone Any Software In Minutes

使用時可先透過 Node.js 設定 agent registration 和 provider,再檢查單一 agent 或 analysis engine 的 readiness。CLI 提供 provider 選擇、證據管理、退出狀態及診斷功能,MCP contracts 和 agent prompts 則用來固定工具回傳格式及引導調查流程。

EP424 - 一句話逆向任何 App?AI 逆向工程 REA,這代表什麼

可留意的重點包括:
– 支援 native binaries、應用程式及 runtime behavior 的逆向分析
– 在沒有 source code 的情況下展示調查證據
– 透過 MCP 連接代理、工具、providers 和 sessions
– 提供 snapshots、import/export、readiness troubleshooting 及 CLI catalog
– 適合產品仿製研究、相容性分析及安全研究,但不保證每次都能還原完整功能

REA 比單次檢查工具更接近一套可重複的代理工作流,適合需要比較競品功能、研究封閉軟件或建立相容版本的工程團隊。項目仍在按 roadmap 擴展能力,採用前應先確認目標平台、分析工具及 provider 是否獲支援。

GitHub

Categories: 開源, Agentic, MCP, 軟件, 工具, 編程, 安全

[技術文章] HARNESSSQL 讓 SQL 代理在真實資料庫中學習

SQL 代理不再只需一次生成查詢,而是在可執行資料庫內探索、修正錯誤並完成任務。

Hero image preview

面對陌生資料庫,SQL 代理往往要先查看 schema、檢查欄位和值,再執行試探查詢、分析錯誤,最後修訂並提交 SQL。HARNESSSQL(Harness-Native Training for SQL Agents in Realistic Database Environments)是一套面向這類互動流程的後訓練框架,針對模型訓練只學習「問題直接對應查詢」、但推理時才加入執行工具的落差作出修正。

傳統 Text-to-SQL 通常把資料庫視為靜態提示內容,難以涵蓋長時間、多回合的探索。HARNESSSQL 建立隔離且可執行的資料庫環境,配合隱藏的 execution oracles,讓教師模型直接在目標 SQL harness 內完成互動,並只保留經驗證的操作軌跡進行 full-sequence SFT,之後再以 execution reward 進行 RL。

項目的核心做法包括:
• 將 schema 檢查、工具呼叫、查詢執行及錯誤修正納入訓練流程
• 以 sandbox 控制資料庫狀態,保存結果與錯誤回饋
• 只使用可驗證的成功軌跡,減少錯誤示範干擾
• 讓模型適應 Spider 2.0-SQLite 的互動式任務

在 Spider 2.0-SQLite 上,Qwen3-8B 的 execution accuracy 由 15.5% 升至 45.2%,Qwen3-14B 則由 22.2% 升至 54.8%;訓練所得能力亦能轉移至 BIRD-Interact 和 LiveSQLBench。結果反映,資料庫代理要處理複雜工作流,訓練階段同步保留執行 harness,比只在推理階段補上工具更能縮小訓練與使用環境的差距。

Paper

Categories: 開源, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, Qwen, 微軟, 框架, 香港, 工具, 庫, 強化學習

WeKnora 把企業知識庫變成可問、可做、可追溯的 AI

WeKnora 將 RAG、Agent 與 Wiki 放進同一個知識庫,兼顧企業資料整合、任務執行和私有化部署。

WeKnora: find the answers, and put knowledge to work. Tencent

不只可以問文件內容,WeKnora 會幫你用 AI 操作工具、整理 Wiki,並保留已確認的偏好與事實。WeKnora 是一個開源 LLM 知識框架,處理企業文件理解、語意檢索與多步推理;RAG、Agent 和 Wiki 共用同一套知識庫,減少資料分散造成的落差。

RAG 會結合語意及關鍵字檢索,回答附上原文引用;Agent 可搜尋網頁、呼叫 MCP 工具、執行技能,並在沙箱中處理檔案。Wiki 則把文件整理成互相連結的頁面與知識圖譜,支援編輯、差異比較和版本回滾,適合需要持續維護內部知識的團隊。

  • 支援 PDF、Word、圖片、Excel、XMind 等十多種格式
  • 可同步飛書、Confluence、GitLab、Notion、語雀、RSS 等來源
  • 透過企業微信、飛書、Slack、Telegram、MCP Server 或 API 提供服務
  • 具備多空間 RBAC、審計日誌、任務佇列及 Langfuse 追蹤

模型、向量資料庫及儲存後端都可以替換,內置 29 家模型供應商,包括 OpenAI、DeepSeek、Qwen、Gemini、MiniMax、LiteLLM 和 Ollama。v0.8.2 加入本機瀏覽器操作、MCP Server、對話分叉與回滾,令知識庫不再只負責回答問題,也能參與任務流程。

Docker、Kubernetes、Helm、Lite 單機版及桌面應用都在支援範圍內,資料可以留在本地或私有雲。對重視資料留存、內部協作和可追溯性的企業,這套整合度具備明確吸引力。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, RAG, MCP, Qwen, OpenAI, DeepSeek, Gemini, Image, 框架, KnowledgeGraph, Ollama, 庫, Anthropic, MiniMax, Skill 技能

OneSearch-VL:多模體視覺 deep research agent

由單張相片到影片片段,OneSearch-VL 會找出視覺線索、搜尋外部資料,再把證據串成可核對的答案。

OneSearch-VL

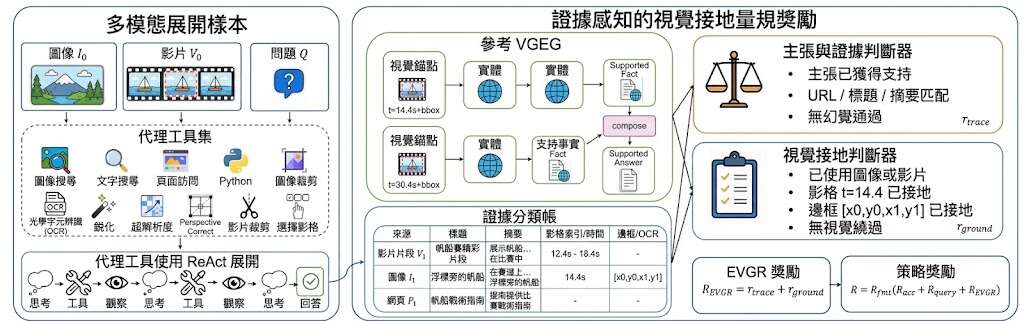
由一張相片、相片集合到影片片段,OneSearch-VL 會先定位視覺線索,再檢索外部知識,將相關證據組合成答案。它屬於多模態 deep research agent,處理的是影像內容理解與資料查證之間難以銜接的工作。

核心是 Visually Grounded Evidence Graph(VGEG),把視覺錨點、來源支持的事實和產生答案所需的操作連在一起。VGEG 亦支援資料建立及驗證;Evidence-aware Visual-Grounded Rubric reward(EVGR)則在強化學習中監督證據是否可追溯,以及答案有沒有真正對應影像內容。

項目提供 OneSearch-MI-Bench 和 OneSearch-Video-Bench,分別面向多圖及影片研究能力。輸入資料未列出具體分數或模型名稱,因此不能把它描述成已全面勝過其他視覺研究方案;它較適合用作研究原型、訓練資料管線和 agentic workflow 的基礎。

OneSearch-VL 包含 Agentic SFT、Agentic RL、推理及評估相關目錄,並標示 Python 3.11+;先準備模型、資料集和外部工具,再執行訓練或評估流程。對需要查核圖片來源、比較多張圖片,或從影片整理證據的研究團隊,這種統一處理方式較容易整合到既有工作流,但部署成本和工具依賴仍要自行確認。

• 同時支援單圖、多圖集合及影片
• 以 VGEG 統一視覺線索與外部證據
• EVGR 強調證據可追溯及視覺對齊
• 提供多圖與影片專用 benchmark
• 支援 SFT、RL、推理和評估流程

GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Video, Image, 工具, Python, 庫, Dataset 數據集, 強化學習

Compo:以 Spatial Canvas 編排海報中的文字、人物與圖像

Compo 讓你用畫布安排文字、人物與圖像位置,再交由模型生成海報,減少只靠文字描述構圖的反覆試錯。

Compo Teaser

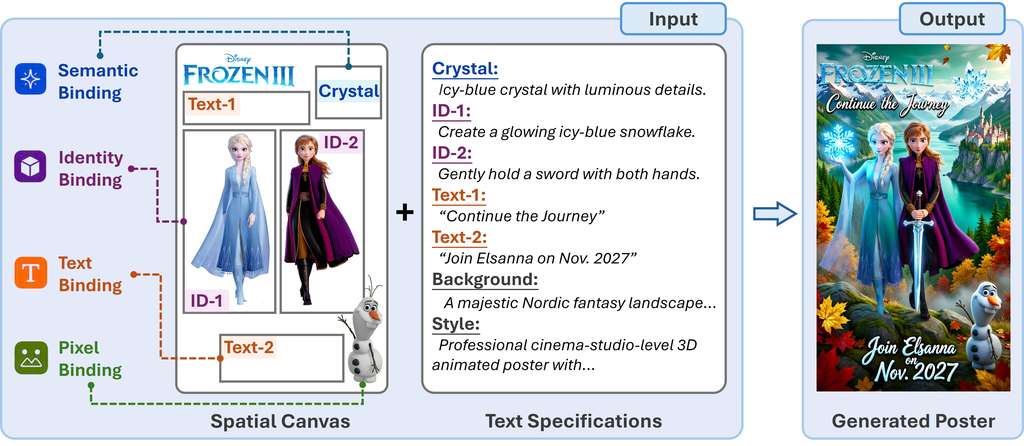
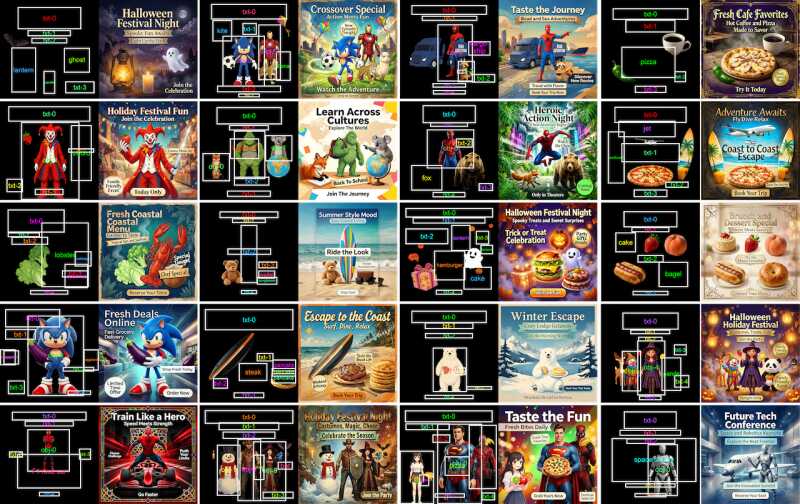
海報生成最難控制的往往不是主題,而是文字、人物和裝飾元素應該放在哪裏。Compo 屬於海報生成模型及介面項目,將 Spatial Canvas Interface 與 Text Specifications 結合,讓使用者直接在畫面中表達二維構圖意圖。

Spatial Canvas 支援四種綁定方式:Semantic Binding 指定文字概念及目標區域,Identity Binding 以參考圖保留視覺身份,Text Binding 同時交代準確字句與位置,Pixel Binding 則放入需要保留的像素內容。Bounding boxes、參考圖片和文字識別資料會一併渲染到畫布,形成模型接收的統一影像輸入。

  • 以畫布補足單靠文字提示難以交代的空間關係
  • Compo 由預訓練 image editing model 改編而成,毋須另建 task-specific architecture
  • 支援 direct inference,也支援 agentic mode 自動規劃畫布
  • 可用於海報、宣傳圖及需要精確排版的視覺內容

Compo 的模型改編重點,是令現有 image editing model 理解不同綁定方式及其組合,而不是從零訓練專用 poster generator。項目亦建立自動產生監督數據的流程,協助模型學習各類 Spatial Canvas 輸入;這比純文字提示更容易控制位置,但使用者仍要準備畫布內容,agentic mode 的自動規劃亦未必取代人工微調。

適合研究人員、設計工具開發者和需要批量製作宣傳海報的內容團隊作為試驗起點,而非直接視作成熟的製作平台。

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, 視覺模型, 模型訓練, 微軟, Image, 影像處理, 香港, 工具, 中國, Dataset 數據集

AgentGarten 以神經渲染器打造可演化的 AI 世界

AgentGarten 讓智能體在由程式控制狀態與規則、再由神經渲染器生成畫面的世界中反覆學習,兼顧可控性與視覺真實感。

MirroS logo

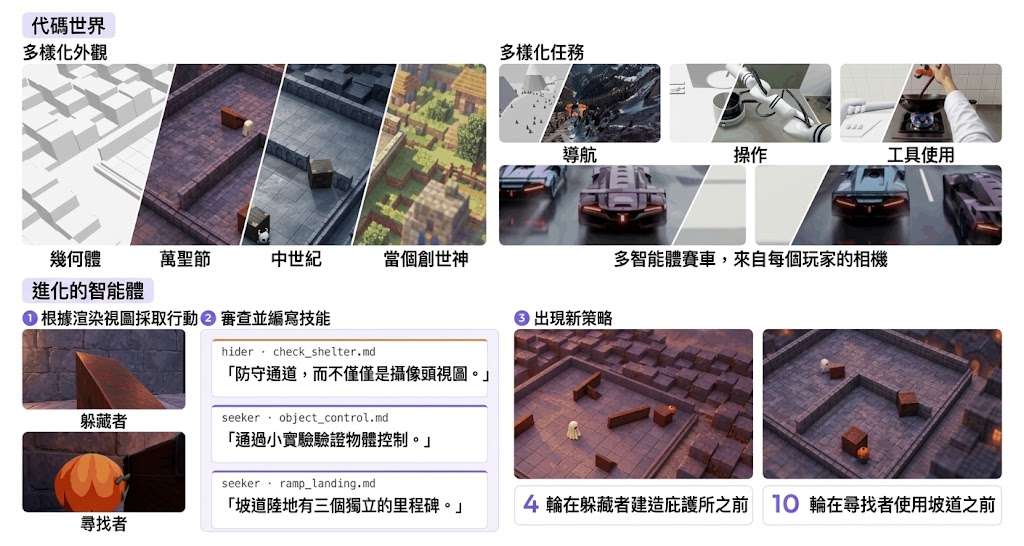
讓智能體在同一個世界反覆試錯,關鍵不只在模型能力,也在環境是否真的記得狀態、遵守規則,並以接近真實的畫面回應行動。AgentGarten 屬於面向 Agentic 系統的互動環境與神經渲染器項目,處理的是可執行世界難以同時兼顧規則一致性、視覺質感與即時速度的問題。

世界中的物件、目標和變化由程式保存,程式輸出的 depth 或 surface normals 則交給共享 neural renderer 生成智能體看到的畫面。renderer 以 NVIDIA Cosmos3-Nano 為基礎,先用 bidirectional rectified-flow 訓練完整影片,再以 autoregressive block-causal 方法配合 teacher forcing 或 diffusion forcing 生成後續畫面,最後透過 Adversarial Forcing 將模型蒸餾成較少步驟的學生模型。

目前公開內容集中在 neural renderer、訓練配方及 streaming inference;code worlds 和完整 agent practice loop 仍會逐步加入。試用需要 Python 3.11 或以上、PyTorch 2.9 或以上,以及 CUDA 主機,較適合研究智能體、模擬環境或自製互動遊戲的團隊,而非只想即時調用一個現成聊天模型的讀者。

  • 可控狀態:規則和世界變化留在可檢查、可修改的程式內。
  • 統一視覺介面:只要提供幾何條件,同一世界可以切換不同視覺風格。
  • 即時能力:官方資料指在單張 H100、480×832 解析度可超過每秒 30 幀。
  • 學習閉環:智能體每輪把經驗整理成 playbook,交給後續輪次繼承。

這種做法以幾何條件取代為每個世界重新製作完整視覺資產,換來較高彈性,但畫面質素仍取決於 renderer 訓練資料、條件輸出和硬件。項目展示的 shelter、bridge 及 companion dog 場景說明它可支援 self-play RL;不過完整程式世界尚未全部公開,現階段更適合作為研究原型和 renderer 實驗基礎。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Video, Python, 強化學習

SuperNav 讓多模態模型指揮機械狗導航

由多模態模型處理找物件、按次序到訪及高層次指令,SuperNav 把導航變成可觀察、可評估的代理工作流。

SuperNav

當指令由「找出籃球」延伸至「先找打印機,再找垃圾桶」,SuperNav 以 Agentic Navigation System 的形式處理場景理解、路線行動與任務進度。項目實際解決的是機械人面對不同場景和非固定指令時,難以只靠預設導航流程完成工作的問題。

系統由預訓練多模態模型 (multimodal model) 作決策,再透過工具、task-progress tracking 和 context management 將決定轉成移動行動,不需要為導航專門微調模型。Codex、OpenCode 或 Kimi 都可作為代理執行端,任務、工具與 Skills 則透過實驗設定組合,彈性高於寫死單一路線,但結果仍會受模型判斷及工具能力影響。

作者提供 agent runtime、導航工具、Skills、實驗配方及評估工具,支援 Habitat-GS 和 AI2-THOR。測試時可先在模擬環境執行單物件、多物件和 demand-driven navigation,再查看 RGB 觀察、軌跡、tool calls、提示詞、工具結果及原生記錄;儲存庫目前沒有真實機械人驅動程式,Unitree Go2 的示範主要來自研究項目展示。

研究結果指出,SuperNav 在單物件、多物件及需求導向導航的成功率高於所比較的基線,並展示 Unitree Go2 實體部署。可留意的限制是,資料只交代高於評估基線,未提供足夠細節讓讀者單靠儲存庫重現所有真實機械人測試。

  • 適合場景: 室內找物件、依次到訪多個目標,以及較高層次的整理要求
  • 可觀察性: 即時查看 RGB 影像、軌跡和工具呼叫,完成後再檢查記錄
  • 模型關係: 多模態模型負責決策,SuperNav 負責工具協調、進度追蹤與導航執行
  • 測試範圍: Habitat-GS、AI2-THOR,並有 Unitree Go2 示範

研究團隊、具身 AI 開發者和需要比較導航代理的人,會較容易從這個開源項目受益;一般使用者則要先準備相應模型服務、模擬環境和實驗設定,不能把儲存庫直接當成已包裝完成的機械人應用。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 多模態模型, 模型訓練, Image, 提示詞, 工具, 庫, Kimi, Skill 技能

RecursiveGameCreator:讓你的創意從原型走向成功的遊戲開發框架

Recursive Game Creator 把設計、開發、遊玩與評審串成循環,令 AI 遊戲開發不止於成功運行。

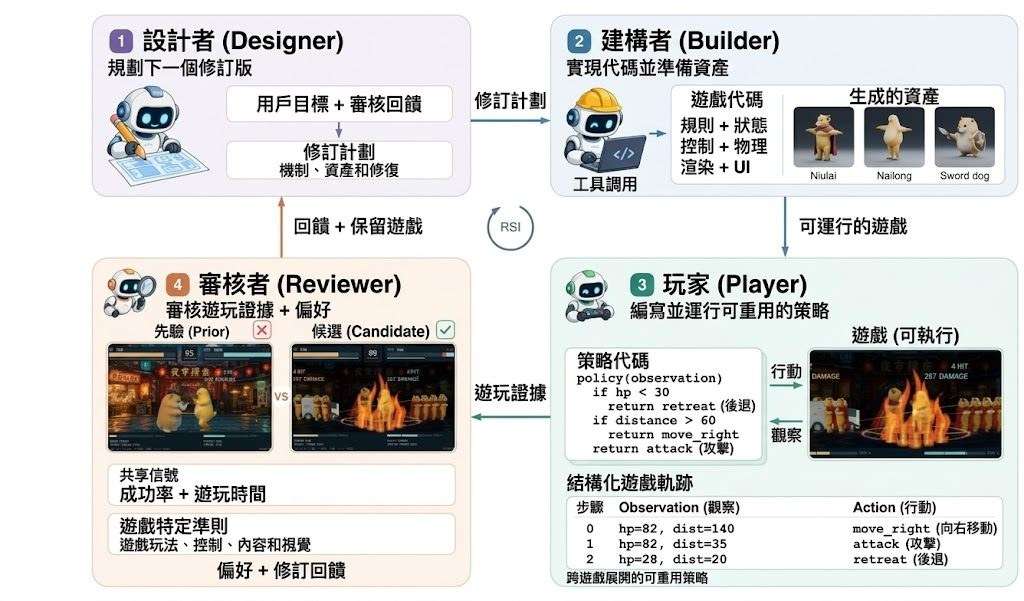
Recursive Game Creator framework: Designer, Builder, coding-native Player, and Reviewer connected through game developme

遊戲能夠運行,不代表玩家會覺得好玩。Recursive Game Creator 將 Designer、Builder、coding-native Player 與 Reviewer 串成循環,屬於一個 Agentic Product-Level Experience-Oriented Game Harness,處理 AI 由可玩原型持續改良至完整遊戲時,缺乏體驗評估的問題。

Player 會透過程式介面執行可重用的 gameplay policies,收集多條 gameplay trajectories,毋須每個動作都重新呼叫模型,較適合反覆測試機制與內容。Reviewer 再結合行為軌跡、畫面觀察、玩家偏好及遊戲專屬準則,為下一輪 Designer 計劃提供修訂回饋。

項目支援 HTML 和 Godot,遊戲可在隔離 runtime 內開發及測試,亦可選擇接入影像、3D asset 與 Blender。macOS 或 Linux、Git、Node.js 22/npm,以及運行中的 Docker daemon 是主要環境要求;Docker 使用 software rendering,主機不必配備 GPU。

目前公開結果以三輪迭代展示改良,GameCraft-Bench overall 由 R1 至 R3 提升 5.19 points。這個數字反映循環式修訂的效果,但未等同所有遊戲都能獲得相同體驗,因為評審準則、玩家偏好及遊戲類型仍會影響結果。

較適合研究 agentic game development、需要大量自動 playtesting 的團隊,以及希望比較遊戲版本演進的開發者。實驗可從 HTML 遊戲開始,再按需要加入 Godot、視覺素材或 Blender 整合,先驗證設計—開發—遊玩—評審流程是否符合自身工作流。

  • 以四個角色連接設計、實作、遊玩與評審
  • 透過 reusable policies 收集 gameplay trajectories
  • 同時考慮行為、畫面與玩家偏好
  • 支援 HTML、Godot、3D asset 及 Blender 整合
  • GameCraft-Bench 三輪迭代提升 5.19 points

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, DeepSeek, Image, 框架, 香港, 軟件, Mac, 3D, Linux, 編程

Page 11 of 47
1 … 9 10 11 12 13 … 47