EVA-Client 補上真實機械人部署斷層

訓練好嘅操作策略,去到真實機械人往往先開始出現混亂。EVA-Client想處理嘅,正正係部署、記錄同評測之間長期分散嘅那段流程。

EVA-Client Logo

研究團隊把模型訓練做得愈來愈完整,但一到真實機械人落地,常見情況仍然是靠零散 script、臨時橋接同各自為政嘅除錯流程撐住。EVA-Client屬於開源框架,集中處理已訓練操作策略喺真機部署、數據收集與評估之間嘅斷層,重點唔係再訓練一個新模型,而係令整個閉環更可重用。

它同一般只覆蓋單一步驟嘅工具唔同,將 transport、policy backend 同 inference strategy 放入同一套流程,支援 ROS1、ROS2、ZeroMQ 同 offline dataset,也能接 OpenPI、OpenPI-RTC、StarVLA、GR00T、mock、replay。作者明顯想修正「訓練框架成熟,但真機端仍然拼裝化」呢種既有範式,所以瀏覽器內直接整合 debug、部署、錄製、重播同比較,定位相當鮮明。

使用路徑方面,現有資料已交代可以用 .py config 串接機械人通訊、策略後端與推理策略,再透過介面喺 DEBUG、COLLECT、RESULT 分頁切換;不過完整安裝細節仍然要配合官方文件先夠穩陣。資料收集亦唔止錄影,還會保存 camera video、3D URDF scene、state charts、milestone scores,同步回放亦保留 QC PASS/FAIL 與每幀品質旗標,對做 dataset 整理同失敗分析幫助幾大。

  • 把部署、收數同評測放入同一個 browser workflow,減少真機迭代時來回切換工具
  • 支援多種 transport、backend 同 inference strategy,取向偏向兼容不同機械人與策略棧
  • 內建 live latency compensation、async strategy 同 replay,重點放喺真機穩定度而唔只係跑通
  • Teleop demos 與 model rollouts 共用同一套 on-disk layout,方便後續整理成 LeRobot v2.1 episodes

性能數字方面,現有資訊未見統一 benchmark 分數,較多是能力與流程層面的描述,所以暫時唔適合把它理解成用單一指標決勝負嘅項目。較受惠嘅會是做 VLA、VAM、WAM 或機械人操作研究嘅團隊,尤其要頻繁比較 checkpoint、遠端連 policy server、或者同時管理多款真機平台嘅場景;已列出可配合嘅相關模型與系統包括 OpenPI、OpenPI-RTC、StarVLA、GR00T,以及 LeRobot、VLA Foundry 呢類訓練側框架。
項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, NVIDIA, DeepSeek, Video, VLA, 3D, Dataset 數據集

LingBot-Vision 補強密集空間感知

想做深度估計或語意分割,但又唔想每個下游任務都重訓視覺編碼器,LingBot-Vision正是針對這個卡位而來。它把邊界、形狀同語意區域一併學好,重點放在更可靠的空間特徵。

Boundary-centric masked modeling

做深度估計、語意分割或者影片物件分割時,最麻煩往往唔係有冇大模型,而是編碼器抽出的特徵夠唔夠貼近物件輪廓。LingBot-Vision屬於模型,更準確地說是自監督預訓練的 Vision Transformer 視覺骨幹,處理的是密集空間感知裏面「語意有了,但邊界唔夠準」這個老問題。

它的取向幾明確:唔係一味追求分類式語意表示,而是用 masked boundary modeling 去逼模型同時保留空間結構與語意訊息。凍結後的 patch tokens 已經可以直接支援輕量 readout,涵蓋 depth estimation、semantic segmentation、video object segmentation,亦作為 LingBot-Depth 2.0 的 visual encoder 初始化,這種設計比起只偏重全局語意的 ViT 骨幹,更適合需要逐像素判斷的工作流。

這個項目較接近「取用預訓練骨幹再接下游任務」的用法,而唔係即裝即用的完整應用。模型已放到 Hugging Face 與 ModelScope,較合理的理解方式,是把不同尺寸的 LingBot-Vision 權重接入現有 dense prediction pipeline,先測 frozen features 的表現,再決定需唔需要額外微調。

  • 重點不在生成內容,而在提高 dense spatial perception 的特徵品質
  • 已公開多個相關模型:ViT-S/16、ViT-Base、ViT-L/16,以至 1.1B 參數的 ViT-g/16
  • 支援的方向包括 depth estimation、semantic segmentation、video object segmentation、depth completion
  • 與同類做法相比,更重視 boundary-faithful features,而唔係只強化高層語意表示

受益最大的會是做機械人視覺、3D 感知、影像理解基建的團隊,尤其當你手上已有 segmentation 或 depth 項目,只差一個更穩定的 encoder。性能方面,README 用「substantial performance gains」形容 LingBot-Depth 2.0 在換上 LingBot-Vision 編碼器後的提升,但公開內容未列出完整基準數字,所以現階段較值得先留意其特徵可遷移性,以及在邊界敏感任務上的潛力。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, Video, VLA, 影像處理, Robotic, 3D

WorldDirector 14B:可控影片世界模型點樣做長時記憶

呢個項目想解決影片世界模型難以長時間記住物件身份與動作邏輯的問題。重點不在單純出片,而是把鏡頭、物件移動與一致性分開控制。

Repository image for pPetrichor/WorldDirector

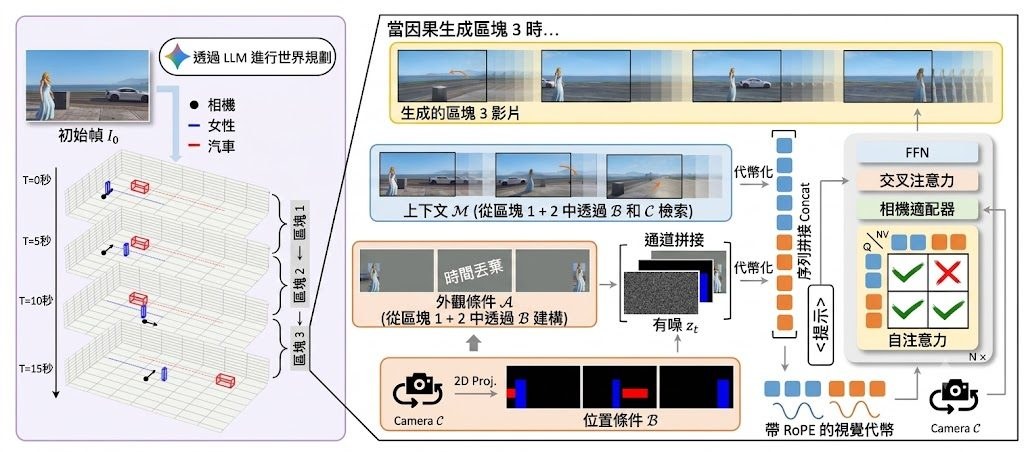
WorldDirector 是一個影片世界模型框架,屬於研究原型兼開源推理項目。它的核心任務,是讓系統在生成長片段影片時,仍能記住動態物件的身份、位置變化與鏡頭運動,減少角色或物件一離開畫面就「變樣」或失去連續性的情況。

它的做法不是直接把所有事情交畀單一生成模型處理,而是先用 Large Language Model(LLM)規劃 3D 物件軌跡與相機路線,再把規劃投影成 2D 控制訊號交畀視覺生成模組。呢種拆分令項目的取向很清晰:先保住語意層面的動作因果,再處理畫面生成,因此比起只靠像素連續性的世界模型,更重視可控性、物件恆常性同長時段一致性。

目前已公開的是完整 inference code 同 WorldDirector-14B 權重,同時亦交代依賴 Torch 2.4.0、FlashAttention,以及 Hugging Face 下載模型的流程。換句話說,現階段較適合已有 GPU 環境、懂得整理 JSON 規劃輸入的人測試;它不是裝完即用的消費級工具,而較接近可重現論文結果的研究型項目。

項目展示的例子集中在人物、車輛、鏡頭切換與長時間事件編排,重點是物件暫時離開視野後再返回,外觀仍能維持穩定。公開資訊提到它支援 persistent dynamic object memory 同 unrestricted viewpoint exploration,但未見提供完整量化基準細節,因此現階段較適合把它理解為一個方向鮮明、控制力強的世界模型方案,而不是已全面驗證的通用產品。

  • 類型定位:影片世界模型框架,主打可控生成與長時記憶
  • 主要差異:把運動規劃同視覺生成拆開,先處理 3D 語意軌跡
  • 較適合情境:研究團隊、影片生成工作流、需要鏡頭與角色一致性的實驗
  • 部署理解:需先配置依賴、下載 WorldDirector-14B,並準備符合格式的 JSON 計劃輸入
  • 相關模型:WorldDirector-14B;流程中亦依賴 Large Language Model(LLM)參與動作與鏡頭規劃

整體來看,WorldDirector 最有價值的地方,在於它把「世界模擬」由單純畫面續寫,推進到可描述、可規劃、可回放的控制流程。對想研究影片 world model、角色一致性與可操控鏡頭生成的人來說,呢個項目值得留意;對只想快速出片的人,現有門檻仍然偏高。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 世界模型, Google, NVIDIA, 3D, 蘋果

ABot-M0 用 600 萬軌跡訓練機械人操作

ABot-M0 是面向機械人操作的 VLA foundation model,結合大型資料與新動作學習方法。它重點解決機械人資料分散、控制不穩定和跨任務泛化問題。

ABot-M0 model overview

這是一個面向機械人操作的 Vision-Language-Action(VLA)foundation model,名為 ABot-M0。它主要用來讓機械人根據視覺與指令完成操作任務,並處理資料分散、動作表示不一致,以及控制模型訓練效率偏低的問題。

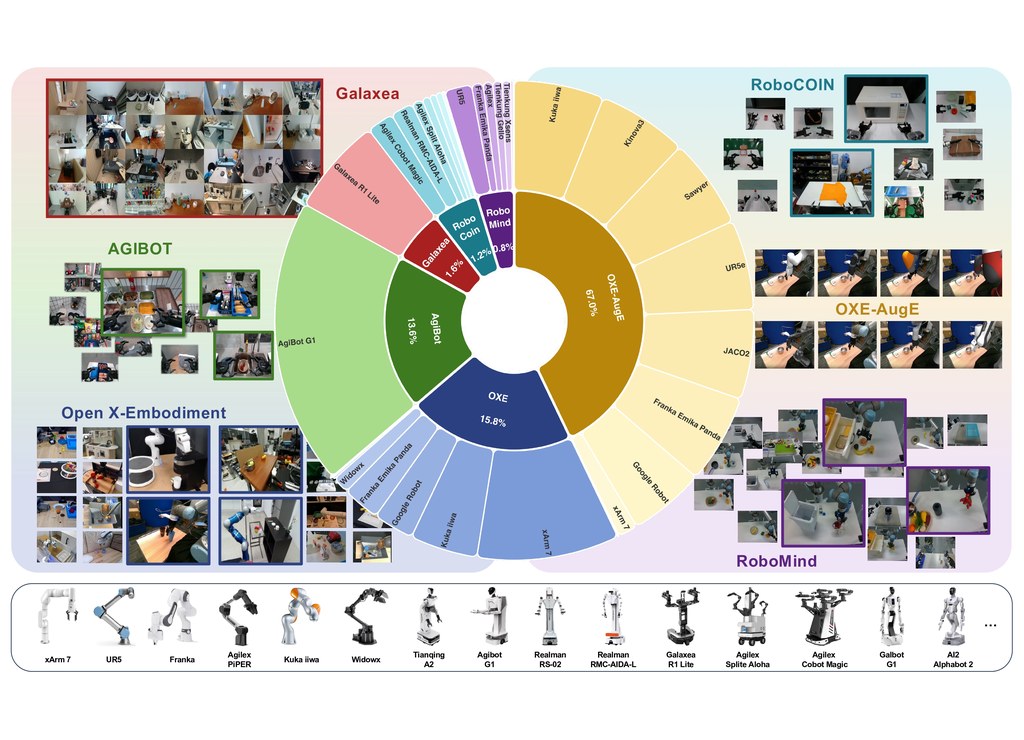
ABot-M0 的基礎來自 UniACT-dataset。這個資料集整合 6 個公開資料來源,包含 OXE、OXE-AugE 與 AgiBot-Beta,合共超過 600 萬條 trajectories、9,500 小時以上互動資料,並覆蓋 20 多種機械人形態;資料亦經過清理、標準化與統一,將動作轉成 end-effector 座標系中的 delta actions,旋轉則採用較穩定的 rotation vector 表示。

它和常見 diffusion 式控制方法的主要差異,在於採用 Action Manifold Learning(AML)。一般 diffusion model 多數學習預測 noise,ABot-M0 則直接做 Direct Action Prediction(a-prediction),輸出乾淨的動作序列;這種做法把學習重點由「擬合噪聲」轉成「投影到可行動作流形」,理論上更有效率,也更有助提升解碼速度與 policy stability。

另一個實用方向是模組化 3D perception。ABot-M0 支援 plug-and-play 模組去加強 3D 空間理解,對涉及精準位置、姿態與複雜操作步驟的任務會更有幫助;同時,它亦用「pad-to-dual」策略統一 single-arm 與 dual-arm 任務,令同一模型可覆蓋更廣的操作場景。

  • 整合超過 600 萬條 trajectories,資料規模相當大
  • 以 UniACT-dataset 統一不同來源與不同機械人表示方式
  • 採用 Action Manifold Learning(AML),直接預測動作而非噪聲
  • 支援 plug-and-play 3D perception 模組,提升複雜任務精度
  • 適合關注 robotic manipulation、VLA 與通用機械人控制的讀者

現有資料重點放在方法設計與資料規模,具體基準分數與完整比較結果在這份內容中未完全展開。即使如此,ABot-M0 已清楚展示一條很具代表性的路線:先用大規模統一資料打底,再用更貼近可行動作結構的學習方式,提升機械人操作模型的泛化與穩定性。

項目主頁

Categories: 開源, 模型, 視覺模型, 多模態模型, VLA, Robotic, 3D, Dataset 數據集

SimFoundry:單段影片變機械人模擬場景

這是 NVIDIA 的 real-to-sim 項目,可把真實場景影片自動轉成可互動模擬環境。它主打機械人策略訓練、評測與 sim-to-real 遷移。

Digital twin and cousins of the wooden drawer organizer

這是一個由 NVIDIA Research 推出的 robot learning 項目。它的主要用途是把單一真實場景的圖片或影片,自動轉成可供機械人策略訓練與評估的互動式 simulation environment,減少真實世界收集數據與反覆測試的成本。

SimFoundry 的核心做法是建立 modular and automated 的 zero-shot real-to-sim pipeline,從單一影像或影片生成 sim-ready digital twins,並支援 object、scene 與 task editing。除了重建原場景,系統亦可自動產生多種 digital cousins,讓同一個任務在不同物件配置、場景條件或操作要求下擴展訓練資料,提升策略泛化能力。

和常見要大量人工建模、手動調參或依賴多視角掃描的做法相比,這個項目強調以較低輸入門檻快速建立可用模擬場景。頁面亦提到 hybrid scene 表示方式,結合 3D Gaussian Splat 背景與 textured object meshes,重點不只在視覺重建,而是要讓場景可直接用於 policy learning and evaluation。

重點摘要:
– 以單一 image 或 video 建立 real-to-sim 場景
– 可生成 sim-ready digital twins,並編輯 object、scene、task
– digital cousins 有助擴充訓練變化,改善 sim-to-real 泛化
– 在 7 個 manipulation tasks、5 個 policies 上,simulation evaluation 與真實表現高度相關
– object、scene、task cousins 分別帶來平均 17%、21%、50% 任務成功率提升

評測結果顯示,SimFoundry 在 7 項 manipulation tasks 與 5 個 policies 上,simulation evaluation 對真實世界表現具有很強預測力,mean Pearson correlation 為 0.928,mean maximum ranking violation 為 0.018;用於評估真實策略時,頁面亦列出 mean Pearson correlation 0.911。文中提及的策略包括 DreamZero、Gr00t N1.7、π 0.5,顯示這個項目適合用於機械人操作研究、policy benchmarking,以及想以較低成本建立可重複測試流程的團隊。

項目主頁 · Paper

Categories: 模型訓練, NVIDIA, Video, Robotic, 3D

GauntletBench 評測框架點出 Agent 盲點

這是用來測試 agent 泛化能力的評測工具。它避開常見應用,專攻視覺密集又偏專業的網頁任務。

GauntletBench logo

GauntletBench 是一個極具挑戰性的基於 Web 的基準測試,用於衡量智能體系統在複雜、基於視覺的專業任務中的泛化能力。

GauntletBench 圍繞著五個鮮為人知的應用場景構建——視頻編輯器、工作流程構建器、3D 建模器、飛行分析器和電路設計器——評估了三個尚未充分探索的能力:時間感知、圖形理解和3D 推理。該基準測試涵蓋100 項人類可完成的任務、模組化的評估流程以及自動化的領域特定評分,揭示了前沿智能體與人類表現之間存在顯著差距:被評估的最強智能體的成功率僅為19.1%,而非專家人類標註者的成功率則超過80%,這表明當前的智能體在復雜的真實世界中仍可達到可靠的真實世界的性能水平。

現有 benchmark 多數放在熱門應用和較直接的任務,容易令新一代 agents 出現分數飽和,未必真能反映它們離真實工作有幾遠。GauntletBench 的取向剛好相反:刻意避開常見 app,改用 Circuit Designer、Flight Analyser、Video Editor、3D Modeller、Workflow Builder 五類較少被覆蓋的環境,重新把問題定義成「能否在不熟悉介面完成視覺密集工作」。

這個 GitHub 項目本身不是模型,而是跑評測的框架;README 已交代可按單一 task、整個 application,甚至用 JSON 批次執行實驗,也支援並行執行與 YAML task file。底層 agent run mechanics 直接沿用 REAL 的 browser harness 與 task loop,這個項目新增的重點則是 evaluation framework、batch runner、objective and LLM-as-a-judge evaluators,以及新的 task suites。

  • 100 個任務,每個應用 20 個,全部屬 vision-intensive tasks
  • 預設模型參數 可指定 --model,預設為 o3
  • 可擴充測試方式,支援 YAML 任務檔與 JSON 批量設定
  • 結果訊號清楚:最佳 agent 約 19.1% 至 20.9% success,非專業人類標註者超過 80% 至 90%

最值得留意的是它反映出一個很實際的落差:agent framework 普遍比單純 raw models 好,但整體距離人類仍然很遠;open-source models 甚至普遍低於 1%。Video Editor 屬較可處理的範圍,Circuit Designer 則接近「幾乎做不到」,所以這套工具特別適合研究 Agentic、Computer-use agents、網頁自動化與多模態能力的團隊,用來找出模型不是「答錯」,而是根本看不懂時間、圖形與空間結構的位置。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 模型, 多模態模型, Qwen, Gemini, Video, 框架, 香港, 工具, 3D, Anthropic

Hermes3D:把 AI 團隊放進 3D 辦公室協作

Hermes3D 將 AI agents 的工作流程搬入自建 3D 辦公室,讓協作、程式碼審查和 QA 監控變得可見。

Hermes3D

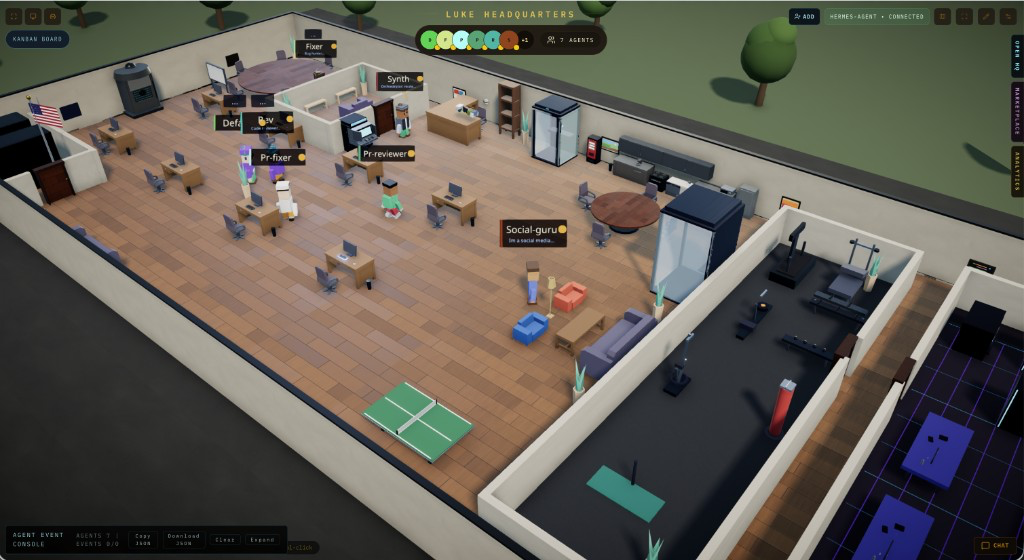
將 AI agents 的協作、standup、Pull Request 審查和 QA pipeline 放進同一個可行走的 3D 空間,Hermes3D 便是一個自建的 3D 虛擬辦公室項目,處理的是 AI 工作流程難以觀察和管理的問題。它把原本分散在 dashboard、GitHub、Jira 和 logs 的活動,集中到共享辦公室內呈現。

Hermes3D 本身只是 visualization and interaction layer,Gateway 則負責控制和連接後端。項目支援內置 Gateway adapter,讓 Hermes 透過 WebSocket 接入;亦可使用 direct HTTP custom runtime provider 連接其他 orchestrator-backed stacks,另有 built-in demo gateway,方便先探索辦公室功能而毋須接入真正的 agent framework。

使用者可先用 demo gateway 檢查 3D 辦公室、代理協作和介面流程,再按需要接駁 Hermes、GitHub、Jira 或自訂 HTTP runtime。README 暫未提供完整安裝步驟或效能基準,因此較適合視為仍在發展中的 self-hosted workspace,而不是可直接取代現有監控系統的成熟平台。

  • 以 3D 場景即時查看 AI agents 的工作狀態
  • 在辦公室內進行 standup、Pull Request 審查和 QA 監控
  • 透過 gym 訓練 agents 發展新技能
  • 以 janitor system 重設 session 和清理 context
  • 支援 Hermes、custom runtime 及 demo gateway

對管理多個 AI agents、需要追蹤程式碼交付流程,或希望資料留在自家基礎設施的個人開發者和小型團隊,Hermes3D 提供了比純文字 logs 更直觀的觀察方式。代價是 3D 顯示層會增加系統複雜度,是否適合正式工作流仍要以團隊自己的 runtime 和整合測試為準。

GitHub

Categories: 開源, Agentic, 框架, 3D

PhysiFormer 用座標預測物理運動

這是個用世界座標模擬3D物體運動的擴散模型。它把剛體、彈性體與多物件互動放進同一個生成框架。

Og image

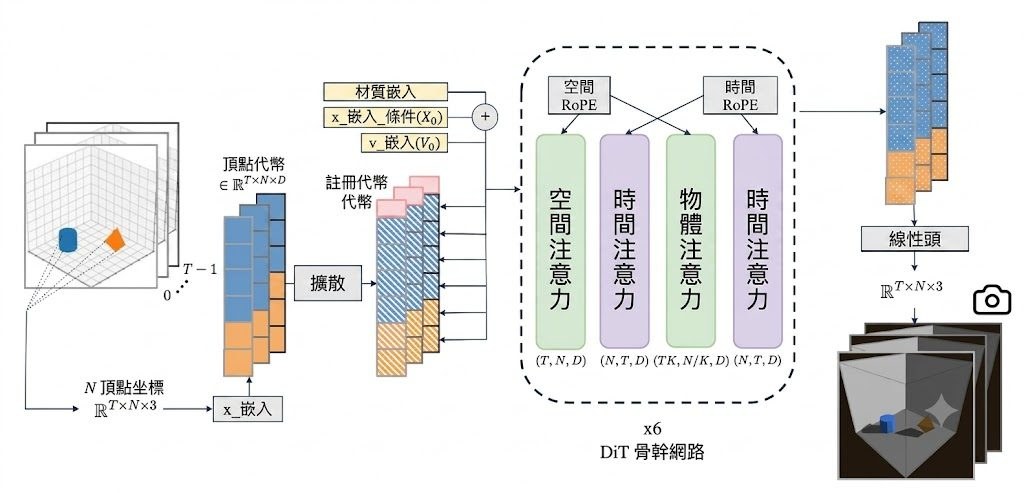
PhysiFormer 是一個 diffusion transformer 模型,用世界座標中的 3D mesh 直接模擬物體運動。它要處理的是在已知初始頂點位置、速度與材質條件下,生成之後一段時間內合理可信的 4D 動態軌跡。

它和常見 video world models 的分別,在於不是在視角相關的像素空間推測畫面變化,而是直接預測 world coordinates 裡的 vertex trajectories。論文指出,這個做法不依賴手動指定的模擬結構、shape latent,亦不需要明確加入 rigid-transform prediction 一類限制,改用單一步驟的去噪擴散過程學習完整時域軌跡。

模型同時支援 rigid 與 elastic 物件,亦能處理 mixed-material dynamics、碰撞,以及靜止與移動中的多個物件。為了提升效率,PhysiFormer 採用在時間、空間與物件三個維度分解的 attention,令多物件推理保留 permutation-invariant 特性,毋須額外手動編碼物件身份。

  • 以 3D coordinate diffusion 建模,重點是視角無關而且幾何結構清晰
  • 用超過 100k simulated trajectories 訓練,覆蓋多種剛體與彈性體運動
  • 可生成多個合理未來,而非只輸出單一路徑,適合存在未觀察不確定性的情境
  • 它在 trajectory accuracy、rigidity preservation 與 momentum-based physical consistency 上明顯優於 autoregressive baselines

這類項目較適合 robotics、graphics、physical design,以及需要幾何感知 world modelling 的工作流。現有資料顯示它對未見過的真實幾何形狀、更大的物件數量,以及混合材質場景有一定泛化能力,但內容主要來自模擬資料與論文結果,真實部署表現仍要配合具體場景再驗證。

項目主頁: https://yimingc9.github.io/physiformer/

Paper: https://arxiv.org/pdf/2606.27364

Categories: 開源, 模型, 世界模型, 模型訓練, Video, Robotic, 框架, Vibe Coding, Content Creator, 3D, 深度學習

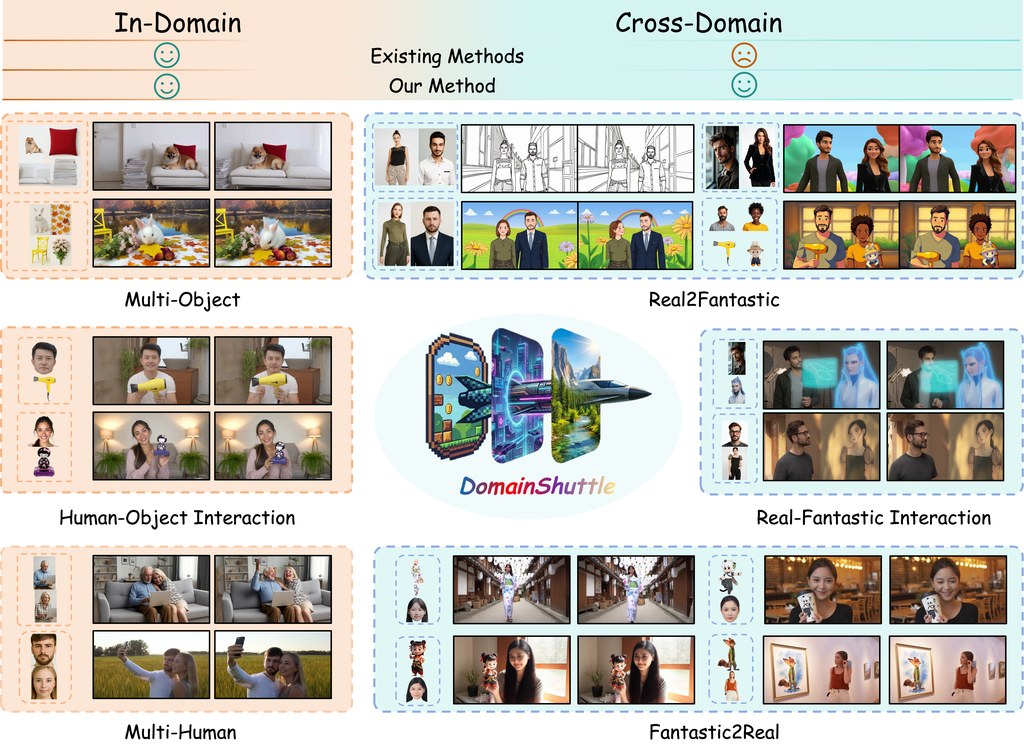
DomainShuttle 開源:把主角穿梭到任何風格的影片

香港科技大學 C4G 團隊發表 DomainShuttle,以 14B 參數規模實作跨域主體一致性影片生成,並釋出權重與推理代碼。

teaser

DomainShuttle 是一個以 Wan2.2-T2V-A14B 為基底的 subject-driven text-to-video(主體驅動文字轉影片)框架,目標是讓用戶提供一張參考圖後,能在不同視覺風格與場景中維持同一角色的身份一致性。過去的 subject-driven 方法多在 in-domain(與訓練資料同域)下能保留主體細節,但一旦跨域到風格差異大的場景,主體往往走樣或失去身份特徵;DomainShuttle 把參考特徵與影片特徵解耦,並引入 domain attribute 建模與 intrinsic subject representation,試圖兼顧 in-domain fidelity 與 cross-domain editability。

開發團隊來自香港科技大學 C4G 實驗室,作者群包括 Nan Chen、Yiyang Cai、Rongchang Xie、Junwen Pan、Cheng Chen、Weinan Jia、Zhuowei Chen、Wen Zhou(項目負責人)、Zhenbang Sun 以及通訊作者 Wenhan Luo。等貢獻作者共同發表技術報告,並同時釋出 14B 規模的非官方權重與推理代碼。

先以 conda 建立 Python 3.10 環境並安裝 PyTorch 2.5.1(CUDA 12.4),接著執行 build_env_conda.sh。模型準備分兩步:先用 huggingface-cli 下載 Wan-AI 的 Wan2.2-T2V-A14B 作為基底模型,再下載 CNcreator0331/DomainShuttle_weight,最後將 VAE、configuration.json 等檔案移入指定的 ./models/Diffusion_Transformers/Wan2.2-DomainShuttle-A14B/ 目錄。原始資料未提供完整推論指令片段,相關細節需參考技術報告與項目頁面的後續說明。

從示範結果看,DomainShuttle 能在寫實人物、動漫風、Ghibli 風、3D 動畫風等不同域之間切換,同時保留臉部與服飾特徵,跨域 personalisation 效果明顯。適合短片創作、角色 IP 化、廣告分鏡與動畫預覽等需要「同一角色穿梭多場景」的團隊。需注意目前釋出的是非官方實作,且依賴 14B 規模的基座模型,部署對顯存要求較高。

重點摘要:

  • 類型:subject-driven text-to-video 框架,建基於 Wan2.2-T2V-A14B
  • 開發團隊:香港科技大學 C4G 實驗室,Wen Luo 為通訊作者
  • 核心設計:解耦參考與影片特徵、加入 domain attribute 與 intrinsic subject representation
  • 與同類差異:強調 cross-domain editability,補足過往方法跨域走樣的缺陷
  • 資源:已釋出 14B 權重、技術報告與推理代碼,需 CUDA 12.4 環境

GitHub: https://github.com/HKUST-C4G/DomainShuttle

項目主頁: https://cn-makers.github.io/DomainShuttle/

模型: https://huggingface.co/CNcreator0331/DomainShuttle_weight

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Stable Diffusion, Video, 框架, 香港, Content Creator, IDE, 3D, Python NLP, Python, 動畫

FLAT:單次生成可即時互動的 3D 場景

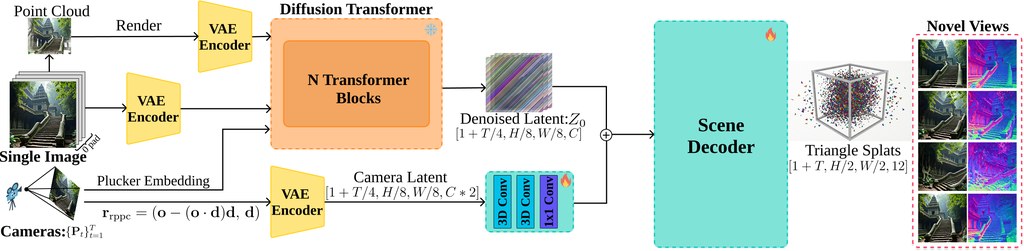
Google Research 與牛津大學團隊推出 FLAT,將影片擴散模型的潛在表示直接解碼為三角形面片,單次前向即可生成幾何準確的 3D 場景。

Architecture overview of FLAT from latent video features to triangle-splat scene geometry

FLAT(Feedforward Latent Triangle Splatting)是一個由 Google Research、牛津大學 Visual Geometry Group 與慕尼黑工業大學共同開發的 3D 場景生成項目,主打從影片擴散模型的潛在表示中,單次前向解碼出幾何準確的三角形面片場景。

開發團隊方面,FLAT 由 Orest Kupyn、Goutam Bhat、Philipp Henzler、Fabian Manhardt、Christian Rupprecht 與 Federico Tombari 等研究員共同發表,核心作者來自 Google Research,並與牛津大學 Visual Geometry Group 及慕尼黑工業大學合作完成。

與常見做法相比,FLAT 跳過了「先生成再優化」的兩階段流程,直接從壓縮的影片擴散潛在特徵預測三角形面片,而非 3D 高斯體素。這項差異讓輸出結果在幾何精度上更貼近真實表面,同時保留視覺品質,並能直接用簡單的三角形渲染器顯示。

重點摘要:

  • 直接三角形解碼:單次前向從影片擴散潛在特徵預測三角形面片,省去後續優化步驟。
  • 幾何專屬訓練設計:採用以視線為中心的三角形參數化與 product window 渲染函數,穩定三角形回歸的梯度流。
  • 輕量精修流程:經過簡單的測試階段精修,將三角形集合轉為完全不透明表示,適用於標準渲染與物理引擎。
  • 跨裝置即時瀏覽:輸出場景可用簡單三角形渲染器即時探索,在觸控裝置上支援拖曳與 WASD 移動操作。
  • 物理互動支援:精修後的資產可整合到遊戲引擎風格的物理交互流程中。

使用方法方面,FLAT 已在 HuggingFace 上發布模型權重,並提供網頁互動示範。讀者可透過 HuggingFace 頁面取得模型,或在官方項目網站(flat-splat.github.io)直接體驗瀏覽器內的互動 Demo,拖曳畫面或使用 WASD 鍵即可在場景中移動視角。

FLAT 適合需要快速生成可匯出 3D 資產的研究人員、開發者及遊戲或圖形相關工作者,尤其在需要幾何準確性與物理交互的場景中表現突出。

項目主頁: https://flat-splat.github.io/

Categories: 開源, 模型, 視覺模型, 視頻模型, Google, 3D

Page 11 of 15
1 … 9 10 11 12 13 … 15