GenCeption 單一模型多種視覺任務

同一個模型就想處理深度、分割、姿態同關鍵點。GenCeption 把影片生成預訓練轉成通用視覺能力,方向相當清晰。

Og image

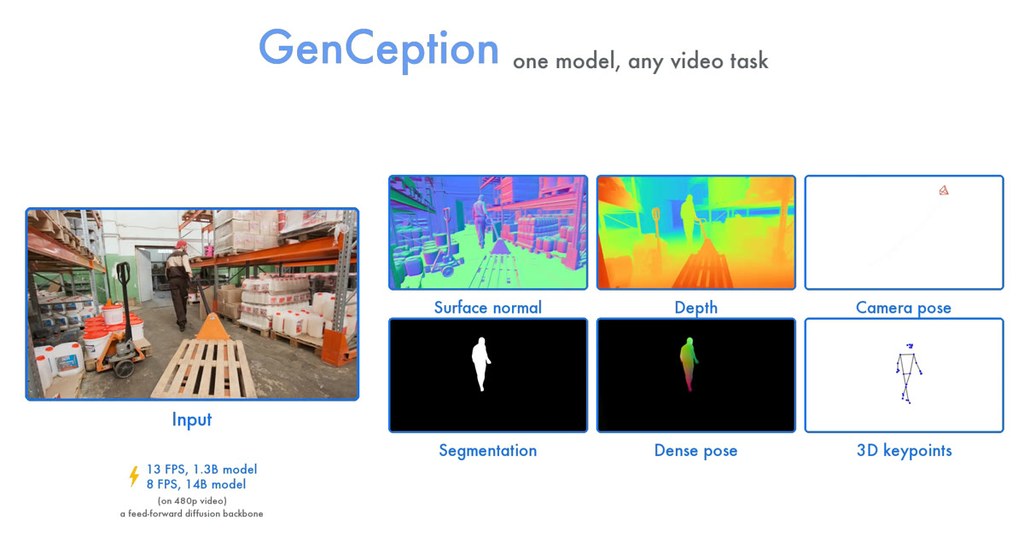
做影像理解時,很多人最頭痛的不是單一任務做唔到,而是每做一種任務就要換一套模型。GenCeption 屬於通用視覺模型,目標是把深度估計、法線、相機姿態、分割、2D/3D 關鍵點甚至 4D grounding 放入同一個流程,並且用文字指令控制輸出。

它處理的核心問題,是電腦視覺長期依賴任務專用模型,工作流容易分散、訓練與部署成本亦高。GenCeption 的做法,是先用 video generative diffusion model 做預訓練,吸收空間與時間上的 world priors,以及原生的 vision-language alignment,再經過 multi-task post-training,把原本偏生成式、多步驟的骨幹,改造成單步 feed-forward 推理模型。

這種路線跟常見做法最大分別,在於它不是為每個任務各自砌一個模型,而是用單一、task-agnostic architecture 應付 dense 與 sparse vision tasks。資料上亦以 synthetic data 為主,重點放在學習效率、sim-to-real transfer,以及遇到 out-of-distribution 物件類別時的泛化能力。

  • 支援多種視覺任務,包含 depth、surface normal、camera pose、segmentation、2D/3D keypoint prediction
  • 透過文字指令切換任務,保持同一模型介面
  • 把影片生成預訓練轉成 feed-forward 視覺推理,而不是停留在多步生成流程
  • 官方描述指它在多個任務上可與專用 SOTA 模型競爭,對比對象包括 DepthAnything3、D4RT、VGGT-Ω、SAM3、Sapiens、DAVID

對研究多模態模型、通用機械視覺,或者想整合複數感知任務的人來說,GenCeption 值得留意。現時公開內容仍以研究展示為主,Code 亦標示為 TBA,所以較適合先理解方法方向與能力邊界,再觀察後續開源與可重現程度。
項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Google, Video, 影像處理, 3D

ARDY 讓 3D 角色動作可即時受控

想像你一邊改文字指令,一邊即時見到角色順住路徑、姿勢同目標動起來。ARDY把可控性同即時回應拉到同一個工作流入面。

Og image

一邊輸入文字、一邊指定角色要去邊、幾時抬手或者身體要擺成咩姿勢,系統仍然可以即時生成自然動作;ARDY瞄準的正正是呢種互動式 3D human motion generation 場景。呢類能力對動畫、模擬同 humanoid robotics 都重要,因為傳統離線方法雖然控制精準,但速度未必跟得上互動需求;純即時方法又常常在語意理解、長距離目標同約束服從度上打折扣。

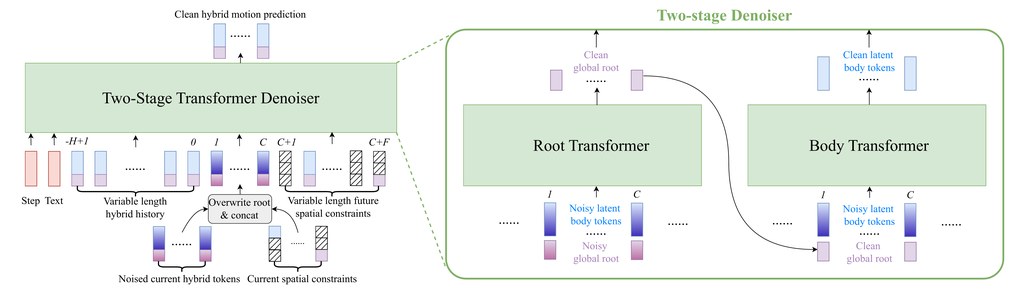
ARDY 採用 autoregressive diffusion model,同時配合 hybrid representation,把角色移動軌跡相關的 root features 同 latent body embedding 結合。咁樣做的用意很直接:一方面保留對路徑與朝向的明確控制,另一方面維持生成模型學習複雜全身動作時的效率與彈性。配合 two-stage autoregressive transformer denoiser,同一套框架可以處理 online text prompting,亦能接住較長時間範圍的 kinematic constraints。

它支援的約束方式幾完整,包括 root paths、waypoints、full-body keyframes,以及 sparse joint positions/rotations,亦可混合使用。更重要的是,約束唔一定只限當前生成視窗,較遠將來的目標都可以先講定,令角色更容易朝長程目標連續行動,而唔係每幾步就失去方向。

  • 支援 online text-to-motion generation,可即時改提示詞
  • 可加入 root paths、waypoints、full-body keyframes 同 sparse joint constraints
  • 兼顧即時反應、動作品質同長距離控制
  • 面向動畫、模擬、humanoid robotics 等互動工作流

資料提到,ARDY 以大型 motion capture dataset 訓練,並直接用文字標籤與來自真實姿勢抽樣的 kinematic constraints 作條件,令模型原生學會受控生成。研究團隊亦展示了互動式 demo,涵蓋動態文字控制、關鍵幀約束、路徑跟隨同即時 locomotion control;定位上,它較適合需要邊調邊看結果的內容製作與研究場景。

項目主頁 · 模型

Categories: Embedding, 世界模型, 模型訓練, NVIDIA, Video, VLA, 提示詞, Robotic, 框架, 軟件, 3D, 動畫, Dataset 數據集

SciReasoner 想把科學推理拉回結構本身

做蛋白質、分子同材料推理,只靠文字序列往往唔夠。SciReasoner把3D結構直接變成可推理證據,重點是答案背後的科學線索都盡量保留。

SciReasoner architecture overview

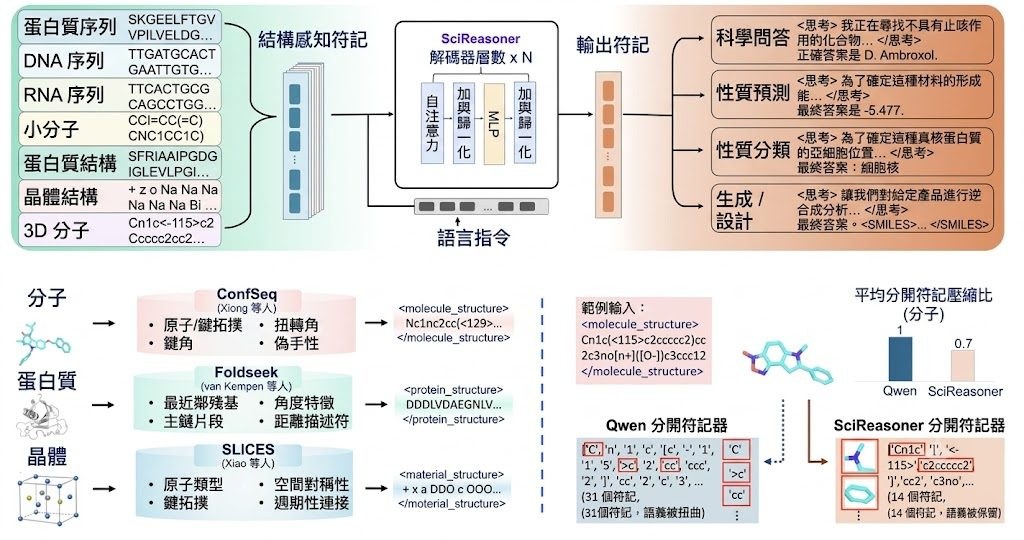
只看文字去判斷蛋白質功能、分子反應性或材料性質,經常會漏掉真正關鍵的空間結構。SciReasoner屬於多模態 scientific foundation model,針對的正是這個落差:把 protein structures、3D molecules、crystals、sequences、formulas 同 text 轉成可對照的 structure-aware evidence tokens,再用來做 scientific QA、prediction、classification 同 generation/design。

與科學資料先「文字化」再交畀大型語言模型處理的做法不同。作者明確押注 native structural reasoning,保留 Foldseek 3Di、ConfSeq、SLICES 呢類結構編碼,令模型唔係淨係讀描述,而係可以沿住 residues、fragments、conformers 甚至晶體配位環境去推理;官網展示的 traces 亦反映出,項目希望連推理路徑都可以檢查,而唔只係輸出答案。

GitHub 上的 models 同 demo 仍標示為 coming soon。換句話說,眼前較合理的理解方式係先把它當成研究型項目:閱讀 benchmark、看案例 traces,判斷它是否適合生物資訊、化學資訊或材料 AI 團隊之後的評測與整合方向,而唔係即刻下載部署到生產流程。

  • 在 86 個評測任務入面,67 個做到 state-of-the-art,對比 generalist LLM baselines 有 75 個任務表現最好
  • 與已發表的 specialist 方法相比,在 33 組比較入面有 26 組持平或更好
  • 範圍唔只化學,亦覆蓋 proteins、DNA/RNA、small molecules、3D molecular structures 同 inorganic crystals
  • traces 可檢查,雙盲專家評分中,與 DeepSeek-V4-Pro 相比有 98% 判斷屬 preferred 或 comparable

相關模型方面,SciReasoner以 Qwen3-14B 初始化,再對齊 domain-native structural vocabularies。對需要跨蛋白質、核酸、分子同材料做統一推理介面的團隊,呢個方向幾有吸引力;限制同樣明顯,因為公開模型與可直接測試的 demo 尚未提供,現階段更適合當成值得追蹤的研究項目,而唔係可即用工具。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 南京大學, 模型, 多模態模型, Qwen, DeepSeek, 香港, Medical醫學, 3D, 中國, Dataset 數據集

WildCity 把城市級空間智能拉回真實街道

想做城市級重建或模擬,最缺的往往不是模型,而是夠大、夠亂、又貼近真實道路的資料。WildCity正好補上這個缺口。

wild city

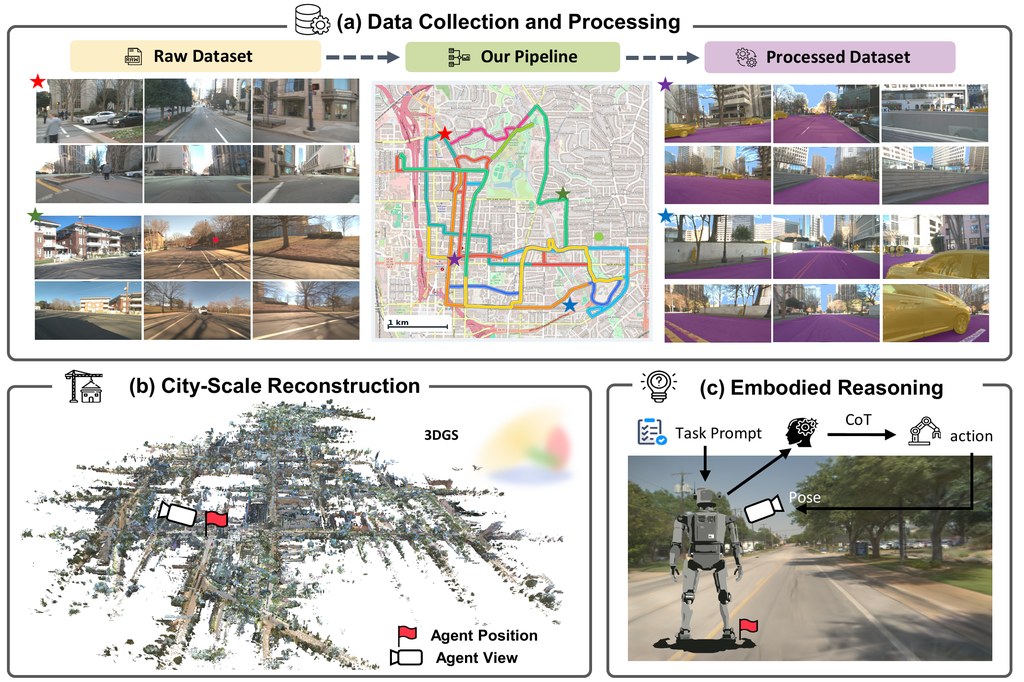
做城市級重建最麻煩的,不是把街景拼得靚,而是要在車流、光線變化、模糊影像同定位誤差同時存在時,仍然保留可用的空間結構。WildCity屬於Dataset 數據集兼研究測試平台,重點不是展示單一模型,而是提供一套面向真實城市環境的資料、重建基線與 closed-loop simulator,處理 rendering、simulation 同 spatial intelligence 之間長期脫節的問題。

這個項目的價值,在於資料規模同場景難度一齊拉高。,它覆蓋美國 6 個城市、18 段長距離行車軌跡、合共 1,507 公里,並整理成 3.01M synchronized keyframes,配合 6 個環視鏡頭、LiDAR、IMU 同 GPS。對研究團隊而言,這不只是多模態資料集,亦是一個可以檢查城市級 reconstruction、extrapolated rendering 與 embodied reasoning 能否真正落地的共同基準。

跟不少較乾淨、較短路段的資料集相比,WildCity的取向明顯更偏向「野外條件」:dynamic objects、lighting and appearance changes、motion blur、imperfect poses 都保留下來。代價是結果未必容易做得好看,但好處是更接近自動駕駛車隊、數碼孿生同機器人模擬會遇到的現實限制。它也不是即插即用型工具,因為 README 已寫明 code、dataset access 同 baseline 仍在準備釋出。

[ECCV26] WildCity: A Real-World City-Scale Testbed for Rendering, Simulation & Spatial Intelligence
  • 以真實車隊採集的城市級多模態資料為核心,而非單一演示場景
  • 除了資料集,亦規劃 urban-tailored 3D Gaussian Splatting baseline 與 closed-loop simulator
  • 適合測試大範圍 reconstruction、rendering 外推與 embodied reasoning
  • 現階段較適合先追蹤研究與評估設計,完整部署流程仍要等官方釋出

現時可以把 WildCity 理解為一個正在成形的基礎設施項目:資料已公開描述,Hugging Face 亦有資料集入口,而官方儲存庫之後會補上 loaders、evaluation scripts、reconstruction baseline 同 simulator。相關模型方向目前最明確的是 urban-tailored 3D Gaussian Splatting;若你做的是自動駕駛感知、城市數碼孿生、robotics simulation 或 spatial intelligence,這套基準值得提早留意,因為它測的不是理想條件下的漂亮結果,而是城市尺度下能否持續運作。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 世界模型, NVIDIA, Robotic, 3D, Dataset 數據集

3D HAMSTER 把機械臂規劃帶進真 3D

同樣是看圖加文字指令,3D HAMSTER唔再只畫2D路線,而是直接交出可落地的3D機械臂軌跡。對機械操作流程來講,呢個改動細節不多,影響卻很實際。

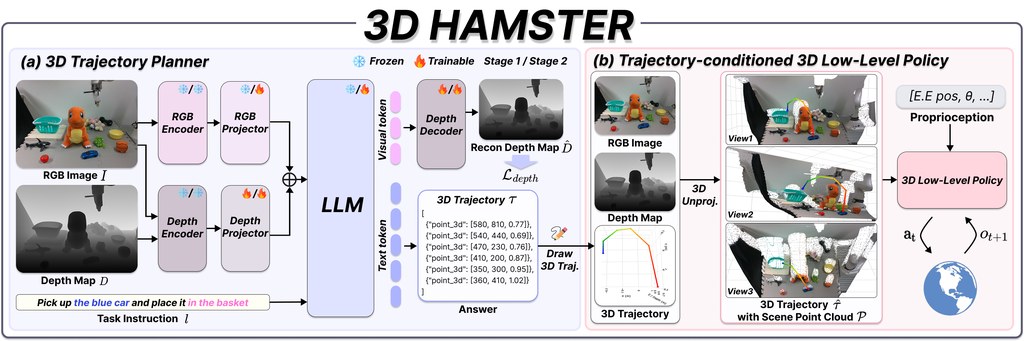
3D HAMSTER architecture: a depth-augmented VLM planner produces metric 3D waypoints that unproject into the point cloud

機械臂最怕規劃講得通,落到控制層卻對唔準空間位置。3D HAMSTER屬於 Vision-Language-Action 規劃模型/機械人研究項目,重點不是再產生螢幕上的 2D waypoint,而是根據單張 RGB 圖、metric depth map 同文字指令,直接輸出帶有深度的 3D end-effector trajectory,同時附上 gripper actions,格式亦整理成 JSON,方便接去後續控制流程。

它針對的矛盾很明確:不少 hierarchical Vision-Language-Action models 由高層 planner 先預測 2D 像素軌跡,再交給吃 point cloud 的低層 policy 執行。問題在於 2D waypoint 只會「借用」像素下方表面的深度,幾何上未必真是機械臂應走的位置。3D HAMSTER改成在 metric 3D 空間規劃,等高層輸出可以直接對接 point-cloud low-level policy,少了中間 2D 轉 3D 的失真。

模型骨幹用的是 Qwen3-VL-8B,再加上凍結的 LingBot-Depth geometry encoder,當中採用 DINOv2 ViT-L/14,並配合 dense depth-reconstruction objective 去強化深度感知。儲存庫目前提供的是 inference-only 版本,即是你可以安裝套件、下載 checkpoint 後直接跑推理或用 Gradio demo 測試;低層 point-cloud policy 屬於論文完整系統一部分,這個 GitHub 項目未有一併放出。

  • 直接輸出 [u, v, depth] waypoint,深度單位是米,較易接入真實機械臂流程
  • 走 RGB-D + language instruction 路線,不靠多視角觀察
  • checkpoint 已包含 geometry encoder 權重,載入時毋須再額外抓模型
  • 項目偏向展示 planner 能力,不等於完整可部署的機械人控制堆疊

,它的定位很適合做研究驗證、機械操作規劃比較,或者拿來觀察 2D planner 與 3D planner 在幾何一致性上的差異。作者在項目頁面強調這種做法對語言、空間與視覺分佈轉移更穩健,但這個儲存庫未有完整公開訓練流程與低層控制模組,所以較適合把它理解為一個清楚展示方向的 3D-native planner,而不是即裝即用的全套機械人方案。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Gemini, VLA, Robotic, 3D, Dataset 數據集

CGGS 把文字直接變成第一身 3D 場景

想由文字生成可自由觀看的第一身 3D 場景,CGGS處理得比一般全景路線更穩。它重點不是只做靚圖,而是連視角一致性與幾何結構都一併補強。

teaser

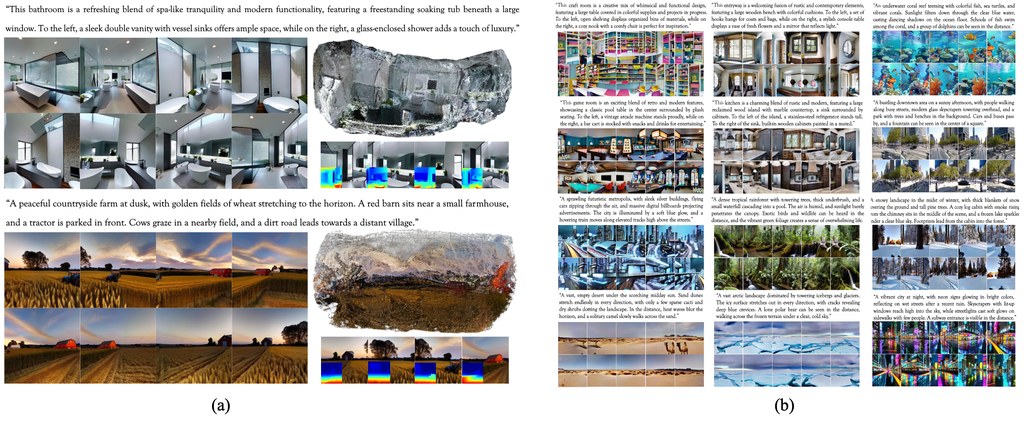
最值得留意的地方,在於 CGGS 沒有沿用單純全景生成再重建的路線,而是直接針對第一身視角 3D 場景去處理視角不連續、幾何變形和文字細節流失。它屬於一個文字轉 3D 的框架,目標是把文字描述變成可渲染的 ego-centric 場景,而不只是產出幾張彼此關係鬆散的圖片。

現有做法常見問題,是多視角之間重疊不足,或者 equirectangular projection 容易在上下邊界拉扯變形;DreamScene360 一類方法也會出現結構扭曲。CGGS 的取向是先用 MV-LDM 生成更一致的多視角 2D 內容,再配合 optical flow、point-track correspondence、深度估計與 3D Gaussian optimization,把粗略 layout 逐步修到可用的 3D Gaussian Splatting(3DGS)場景。

它的流程大致可理解為三段:Ego-centric Generator 負責貼近文字的多視角內容,Layout Decorator 由影像關係推回 dense point clouds,Geometric Refiner 再用 Mutual Information Depth Loss(MID)和 hierarchical optimization 修正幾何與畫質。部署和測試層面,儲存庫已提供實作,並可透過 prompt 檔、視角水平視野 --fov 與垂直軸旋轉角 --deg 控制生成條件,較適合研究、實驗室或要評估 text-to-3D 工作流的人。

  • 走的是 ego-centric 3D scene generation,不是單純全景貼圖
  • 核心差異在 MV-LDM 一致性訓練,加上 3D Gaussian 幾何優化
  • 提供可調視角參數,能用文字檔批量測試不同場景
  • 適合做 3D 內容生成、novel view synthesis 與方法比較

效能數字也有說服力。README 列出的結果中,CGGS 在 CLIP Score 26.253、Q-Align 0.839、PSNR 37.345、SSIM 0.977、LPIPS 0.0193 取得最佳表現,代表它不只文字對齊較好,重建品質與新視角渲染穩定度也更高;不過這仍然是研究型項目,離通用內容製作工具還有一段距離,較大的價值在於它清楚示範了如何把多視角生成與幾何重建更緊密地接起來。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 3D, 中國, Dataset 數據集

AlayaWorld 想做可玩式長時影片世界

它唔止係生成影片,重點係讓鏡頭可即時移動、途中改提示,場景仍盡量記得之前發生過乜。AlayaWorld瞄準的,是更接近「可探索」而唔只係「可觀看」的世界模型。

fig1 AlayaWorld

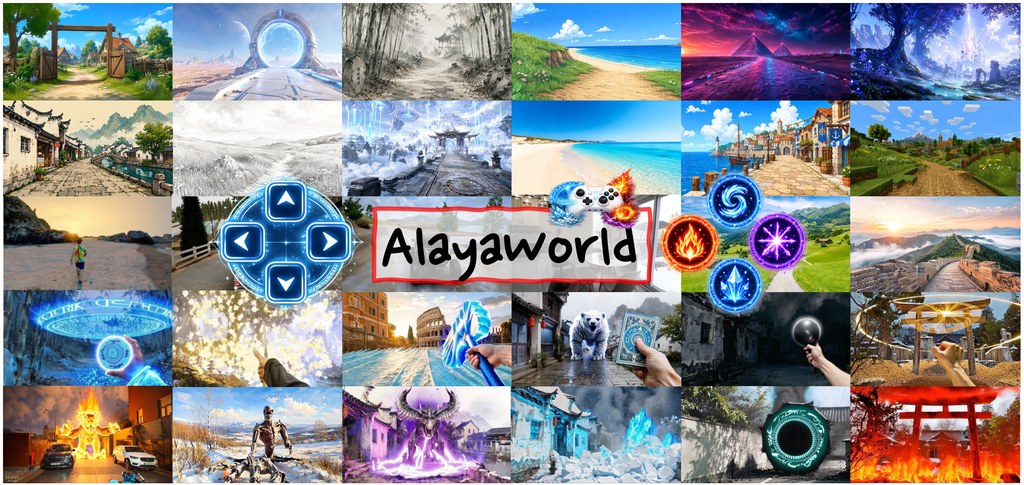
一段生成影片能否變成可探索空間,關鍵唔係畫面靚唔靚,而係鏡頭轉向、路徑改變、甚至中途加入新事件之後,個世界仲認唔認得自己。AlayaWorld屬於world model 研究項目,目標係處理長時間影片生成入面最麻煩的幾件事:互動控制、記憶一致性,同埋長序列愈滾愈走樣的問題。

而家不少影片生成做法偏向一次過出片,畫面可以吸引,但未必承受到持續探索;鏡頭一郁、提示一改,前後場景就容易斷裂。AlayaWorld明確反對呢種偏靜態範式,改用 interactive autoregressive world model 路線,把 3D cache、frame-history embedding,同 chunk-level prompt switching 組合起來,嘗試同時保住空間記憶、時間連續性,同中途插入事件的能力。

它最有辨識度的地方有幾個:一方面用 rendered 3D cache 配合輕量 AdaLN camera modulation,令 6-DoF 鏡頭控制更貼地;另一方面又用壓縮後的歷史影格表示,幫手維持 revisited places 的辨識度。為咗減少長時間 rollout 累積錯誤,團隊亦加入 drifted histories 訓練同 error bank,把已出現的瑕疵重新注入記憶與目標,避免失真一路放大。

  • 支援 real-time camera control,同時可在片段邊界切換 prompt
  • 以 3D cache 加 frame-history embedding 處理空間與時間記憶
  • 透過 few-step DMD distillation 爭取即時生成效率
  • 官方展示指向 720p、24 FPS、60s+ long-horizon、15B parameters
  • 目前公開的是 technical report、示範頁與影片,code 與 weights 尚未釋出

現階段較適合把它理解成研究原型,而唔係可立即部署的開源工具。想測試的人,暫時只能先睇 demo 同 technical report,重點觀察鏡頭移動、風格切換、事件插入後的連貫度;等 inference code 同 pretrained weights 釋出後,先有條件判斷佢喺內容製作、互動敘事、遊戲原型或世界模型研究工作流入面,究竟可以走到幾實用。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, 世界模型, 3D, Dataset 數據集

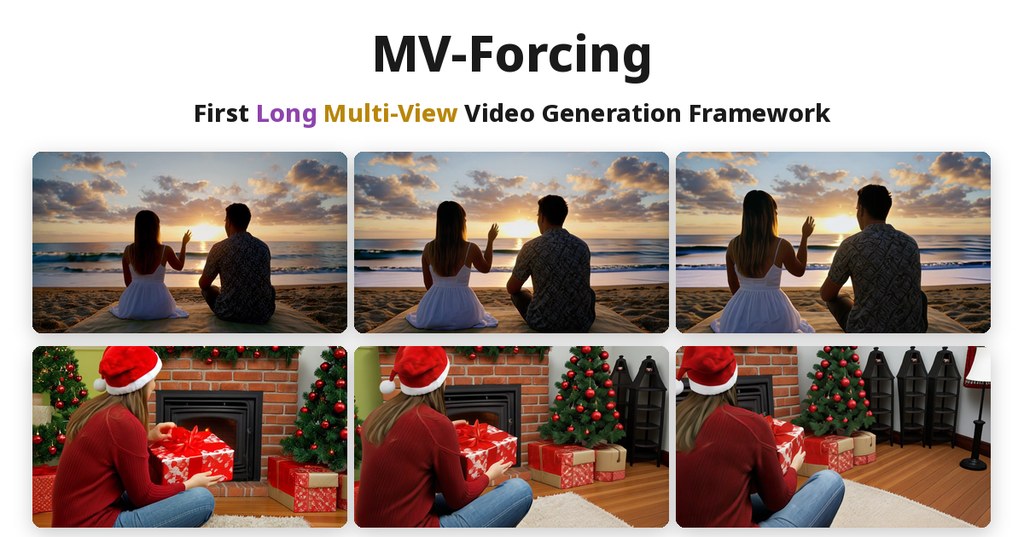
MV-Forcing 讓長時多視角影片更一致

同一段動態場景,要由多個角度連續生成而且唔穿崩,一直都好難。MV-Forcing想解決的,正正是長片段、多視角與幾何一致性三件事同時成立。

Og image

想像同一個人物動作,要由三個鏡頭角度一路接住生成,畫面不但要連戲,視角之間的位置關係都要講得通。MV-Forcing 屬於多視角影片生成框架,處理的正是長時段 dynamic scenes 在不同 viewpoint 下容易失真、跳位、前後不一致的問題。

它的取向,不是只顧單一視角拉長影片,也不是只做短片式多視角同步,而是把 temporal autoregression 同 view-wise autoregression 放入同一個 diffusion model。中間再加上一個 4D geometric prior 作橋樑:先從已生成的 source view 重建 3D 結構,再渲染出下一個 target view 的幾何先驗,最後交由模型細化成高質影片。

另一個關鍵在訓練方式。MV-Forcing 用 joint denoising,令兩個 view slots 訓練時都可由雜訊起步,避免模型只依賴固定 teacher temporal window,從而支援更長的生成。它亦加入 Distribution Matching Distillation 與 Spatio-Temporal Self-Forcing,盡量縮窄訓練與推理之間的 exposure bias,讓時間與視角兩條自回歸鏈接得更穩。

  • 能同時處理長影片與多視角一致性,而唔係二選一
  • 以 3D reconstruction 連接相鄰視角,補上幾何關係
  • 支援 arbitrary lengths 與 viewpoint counts,彈性較高
  • 用單一 few-step student model 完成生成,推理路徑較集中

現有資料提到,它已在 synthetic 與 real-world data 做大量實驗,重點成果是能生成幾何一致的多視角動態影片。不過公開內容暫時較像研究展示,Code 仍標示 coming soon;對內容創作、視覺敘事、虛擬攝影機規劃有興趣的人,會較容易看出這個項目的價值。

項目主頁 · Paper

Categories: 視頻模型, 模型訓練, Video, 框架, 3D

Deform360 補上可變形物體世界模型短板

做布料、繩索、海綿這類可變形物體研究,最缺的往往不是模型,而是夠完整的真實數據。Deform360把多視角影像、觸覺與3D標註放在同一套資料流程內,定位相當清晰。

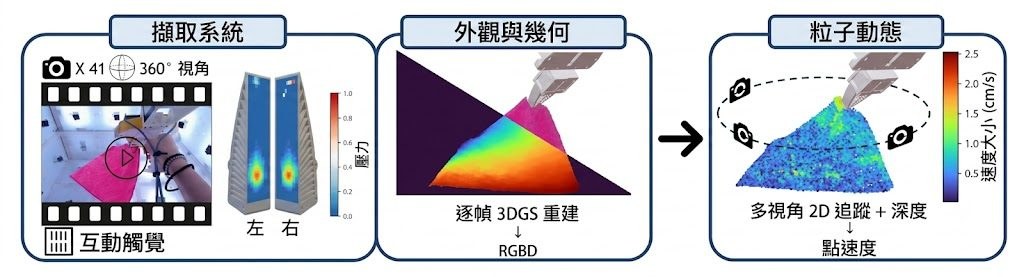
Deform360: per-frame 3D reconstruction alongside 360-degree multi-view capture.

一遇到布料、線材或柔軟玩具,很多世界模型很快就會暴露盲點:畫面看得到表面變化,卻未必掌握形變本身。Deform360屬於Dataset 數據集項目,集中處理的正是可變形物體研究長期缺少的真實多模態資料,讓2D video world models與3D particle world models可以放在同一基準下比較。

它的吸引力不只在於量大,還在於資料結構相當完整。項目收錄198件日常可變形物體、1,980段機械人互動、215.7小時累積錄製內容,配合41部同步720p RGB相機做360°拍攝,另有雙手UMI-based tactile grippers的四組16×32觸覺串流。對研究團隊來說,這代表不只是「有影片可看」,而是可以對齊視覺、觸覺、相機幾何與3D粒子標註去做分析。

跟不少只提供單視角影片、少量物件,或者只放最終標註的資料集相比,Deform360更重視重建與對齊流程。作者採用markerless visuotactile tracking pipeline,把ArUco calibration、3D Gaussian Splatting、CoTracker3與physics-informed refinement串起來,目的不是包裝成一鍵訓練工具,而是把可重用的資料契約、幾何工具、annotation I/O與multimodal alignment utilities公開。

  • 針對198件可變形物體,涵蓋多視角影像、觸覺與dense 3D particle annotations
  • 適合比較2D video world models與3D particle world models在真實形變上的差異
  • GitHub 目前主要釋出資料存取、preprocessing、geometry與對齊工具
  • 未附world-model baselines、training code、pretrained checkpoints或一鍵端到端流程

部署與測試的理解方式也要先講清楚:這不是拿來即刻訓練完整模型的全包框架。現有儲存庫提供Python 3.10以上的安裝入口,並連到 Hugging Face 資料集;你可以把它當成研究資料管線與讀取工具,用來下載資料、做相機去畸變、處理觸覺對齊、載入標註與幾何資訊。原始資料沒有提供完整基線訓練流程,因此較適合已有world model、tracking或robot learning流程的團隊接入。

性能方面,項目頁面有交代基準結論:ParticleFormer在held-out episodes預測較好,pretrained Cosmos在unseen objects的視覺指標領先,但可能偏離指令動作。這種結果也反映Deform360的價值不在於替某一類模型背書,而是把可變形動態、視覺觀測與觸覺證據放回同一個較公平的測試場。相關模型與方法脈絡包括2D video world models、3D particle world models、ParticleFormer、Cosmos,以及資料製備中用到的 CoTracker3 與 3D Gaussian Splatting。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 世界模型, 模型訓練, Video, Robotic, 3D, Python, Dataset 數據集

PixWorld 把 3D 重建與生成收在同一路線

想由幾張視角圖重建場景,或者直接做 text→3D、image→3D,PixWorld 把兩條路合併成同一個模型。它的吸引力不只在速度,亦在於訓練目標更貼近 3D 場景本身。

PixWorld teaser

做 3D 場景時,很多方法會把重建同生成分開處理,PixWorld 就反其道而行,把兩者收進同一個開源框架式研究項目:同一個 end-to-end pixel-space diffusion model,同一趟 forward pass,同時兼顧 reconstruction 同 generation。對想比較 text→3D、image→3D 同多視角重建流程的人來說,這種設計最大意義在於少一層轉換,也少一套彼此割裂的模型心智負擔。

它批評的舊範式很明確:不少做法先進 latent space,要經過 VAE/RAE,再由 3D decoder 還原成 3D 表示;PixWorld 則直接在 rendered multi-view images 上施加 pixel-space flow-matching loss,令優化目標更貼近 3D scene fidelity,而唔係先對準中介 latent target。作者再加上一個 geometry perception loss,借助 frozen 3D foundation model 的 π³ / VGGT feature space,補回純 2D photometric loss 同 perceptual loss 對 3D 結構監督不足的問題。

它會把 posed multi-view inputs 分成 clean views 同 noisy views:前者走 reconstruction,後者走 generation,並由 two-stream diffusion transformer 處理,最後解碼成 pixel-aligned 3D Gaussian representation。這個取向的好處,是把 3D reconstruction、text→3D 同 image→3D 放到同一個表示與訓練框架;代價則是項目目前仍偏研究原型,README 已提到 cleaned RealEstate10K、DL3DV、ACID datasets 以及 PixWorld-480P-4steps distilled weights 與 inference code 尚未完整釋出。

  • 類型定位:屬於模型導向的開源項目,處理 3D scene generation 與 reconstruction 分裂成兩套流程的問題。
  • 主要差異:直接在 pixel space 訓練,避開 VAE/RAE 中介表示,並加入 geometry-aware 監督。
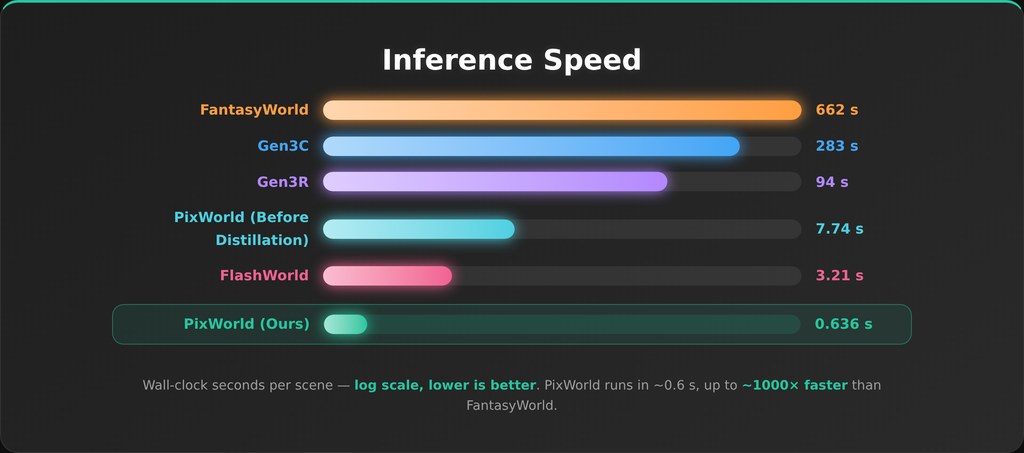
  • 已知表現:distilled 4-step 版本每個 scene 約 0.6 秒,官方稱相對 diffusion-based world generators 峰值可達約 1000× 加速。
  • 重建指標:提供 71.04 WorldScore average,以及 RealEstate10K 4-view reconstruction 的 26.21 dB PSNR。
  • 相關模型與模組:two-stream diffusion transformer、pixel-aligned 3D Gaussian、frozen 3D foundation model π³ / VGGT。

現階段較適合研究 3D world generation、3D Gaussian Splatting、multi-view reconstruction 的團隊先用來判斷方法價值,而唔係即刻當成完整生產工具部署。可惜目前公開資訊仍以論文、示範頁與方法介紹為主,未見完整安裝、評測腳本與權重發布,因此較合理的理解方式,是把 PixWorld 視為一條很有方向感的新路線:它不只是追求更快,還試圖重新定義 3D 生成與重建應該共用同一套訓練目標。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 模型訓練, Image, 3D

Page 10 of 15
1 … 8 9 10 11 12 … 15