VLM3:毋需設計專屬模型架構而達專家級 3D 模型的效果

Meta與Princeton提出VLM³,證明標準VLM不需改架構或加額外編碼器即可處理3D任務,於多項基準上媲美甚至超越專家模型。

teaser

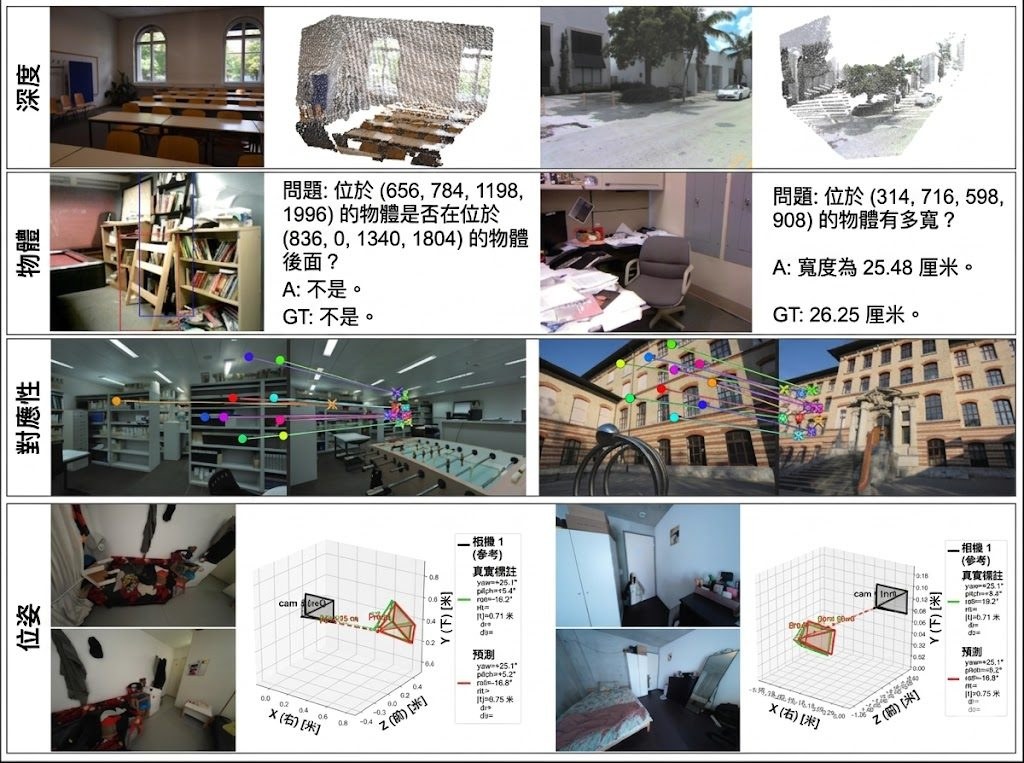
過往要讓AI理解3D場景,往往需要設計專屬的模型架構、複雜的損失函數,還要加上各種資料增強手段。Meta與Princeton合作提出的VLM³(Vision Language Models Are Native 3D Learners)卻反其道而行,主張標準VLM天生就是3D學習者。

有效的 3D 學習主要靠三點 —— 焦距統一(focal length unification)、文字式像素參照(text‑based pixel reference)、以及資料混合與擴展,而不是新架構、大模型、heavy augmentation 或複雜 regression loss。

VLM³會先把輸入影像縮放至相同焦距(以1000像素為例),解決相機內參歧義;需要指涉物件或像素時,就以文字配合標準化座標範圍(例如[0, 2000)或[0, 1000))來表達,整個過程不需更動架構或加額外編碼器,僅用標準的文本監督微調(SFT)訓練。

在效能上,VLM³於多個3D基準上繳出亮眼成績:在物件級3D理解上超越SpatialRGPT;於度量深度估計上比肩UnidepthV2與Moge-2,把DepthLM的準確度由0.84提升至0.9;在像素對應上勝過DKM與RoMa;相機姿態估計方面則與DepthAnything3持平並超越VGGT。

這套方法適合關注3D視覺的開發者與研究團隊,特別是希望以單一通用模型涵蓋深度、對應、姿態與物件理解等任務的人。對於想從規模化資料入手,而非投入大量工程設計特定模型的場景,VLM³提供了一條相當務實的路徑。模型目前尚未公開,讀者可先留意論文及官方項目頁面的後續更新。

重點摘要:

  • 焦距統一:把輸入影像縮放至同一焦距,免去相機內參歧義。
  • 文本式像素參考:以標準化座標文字指涉像素,不需加標記或新架構。
  • 資料規模化勝過複雜設計:證明擴展資料與標準SFT已足夠,不需任務專屬模型。
  • 多項指標比肩專家模型:深度、像素對應、相機姿態等任務達到頂尖水準。
  • 統一輸出域:以文字作為統一介面,讓通用模型同時處理多樣3D任務。

GitHub: https://github.com/facebookresearch/VLM3

Paper: https://arxiv.org/pdf/2605.30561

Categories: 開源, 模型訓練, 框架, 3D, Meta

YoCausal 用影片倒播測試模型因果感

YoCausal唔係教你生成影片,而係檢查模型有冇真正理解先後因果。它用真實影片倒播做基準,設計相當清晰。

YoCausal Logo

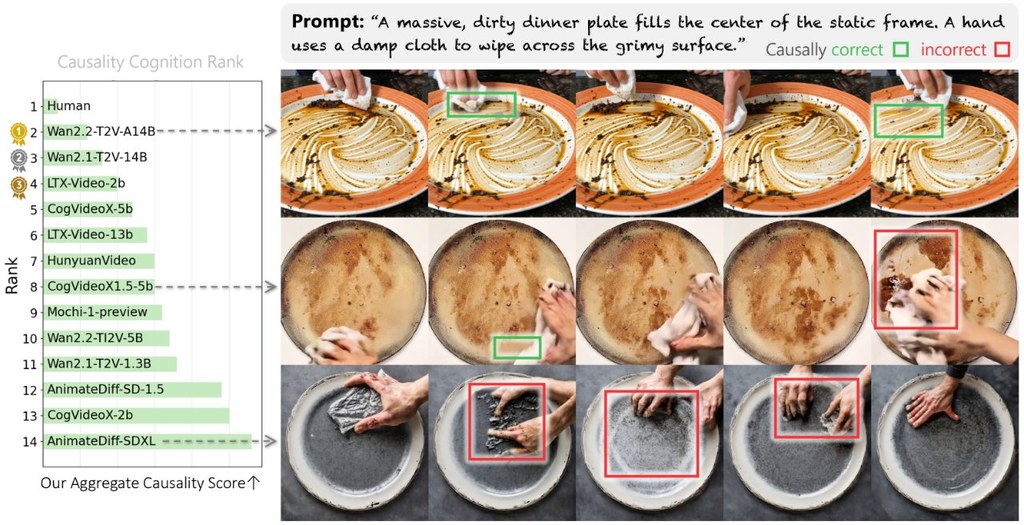
YoCausal 是一個用來評測 Video Diffusion Models(VDMs)嘅項目,核心問題好直接:模型見到一段影片時,究竟係理解事件因果,定只係記住畫面常見嘅時間模式。呢個項目用正播同倒播影片比較 denoising loss,若模型對正向影片分數更合理,代表它較能分辨自然因果關係。

它提出兩個關鍵指標:Reverse Surprise Index(RSI)同 Causality Cognition Index(CCI)。RSI 主要睇模型有幾多次偏好正向時間流;CCI 再進一步將「知道時間方向」同「真正理解因果」分開,避免只靠時間線索就被誤判為懂因果。

使用呢個項目時,重點唔係訓練新模型,而係替現有模型寫 evaluator,然後用指定資料集跑評測。項目亦提供 leaderboard 提交格式,會要求模型名稱、版本或 checkpoint、模型大小,以及 evaluation result JSON 檔案;若改動過預設設定或 preprocessing protocol,也要一併說明。

YoCausal: How Far is Video Generation from World Model? A Causality Perspective
  • 用真實世界影片倒播做 counterfactual,比純合成資料更貼近常見場景
  • 以 denoising loss 比較正播與倒播,測法清楚而且可擴充
  • RSI 測時間方向感知,CCI 嘗試拆出更接近因果理解嘅部分
  • 已評測 13 個 state-of-the-art VDMs,結果顯示時間感知不等於因果理解
  • 文件提到 Wan Model Evaluation(DiffSynth-Studio),亦支援排行榜提交流程

由論文內容看,YoCausal 最大價值係指出一個常被忽略嘅落差:影片生成愈靚,唔代表愈接近 world model。評測結果顯示,即使係表現較前嘅模型,例如 Wan2.2-A14B,與 human baseline 之間似乎仍有明顯差距;中後段模型如 CogVideoX1.5-5B、AnimateDiff-SDXL 則較易出現違反因果嘅畫面變化。

呢個項目適合研究 Video Diffusion Models(VDMs)、world model、影片理解與生成評測嘅人,也適合想比較不同模型因果能力嘅團隊。對一般開發者而言,它最有用之處係提供一套較有解釋力嘅檢查方法,幫你知道模型失分係因為唔懂因果,定只係對時間方向反應不足。

GitHub: https://github.com/youzhe0305/YoCausal

項目: https://www.youzhexie.me/papers/YoCausal/index.html

Categories: 開源, 視覺模型, 世界模型, 框架, 3D

contrastive-probing:拆解 VLM 空間判斷偏差的輕量診斷項目

這個項目不是再做一次答題測試,而是直接觀察 VLM 內部怎樣表示左右、高低與遠近。對想研究模型偏差的人很有參考價值。

Repository image for cheolhong0916/contrastive-probing

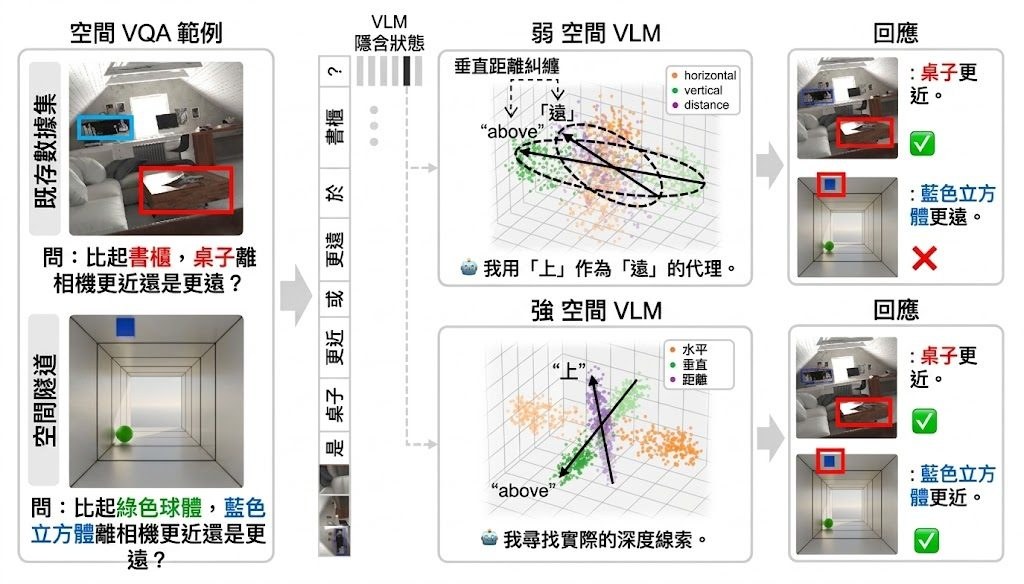
contrastive-probing 是一個用來檢查 Vision-Language Models(VLMs)內部空間表示的輕量項目,焦點不是模型答對幾多題,而是它腦內如何分開 left / right、above / below、far / close。它沿用論文《Why Far Looks Up: Probing Spatial Representation in Vision-Language Models》的 contrastive probing 方法,透過交換問題中的兩個物件,再比較 hidden states 差異,抽出 Δ vectors 作分析。

使用時,做法是把一張圖片配上一條原始空間問題,再生成一條交換 obj1 ↔ obj2 的對照問題,之後對同一個 VLM 跑兩次 forward,並在每層 transformer 擷取最後 token 的表示。這個流程可配合 🤗 transformers 載入的模型,然後輸出 Axis Coherence、6×6 Δ-similarity heatmap、2D/3D PCA 視覺化,以及 Vertical–Distance Entanglement Index(VD-EI)等結果。

這個項目解決的核心問題,是 benchmark accuracy 往往只告訴你模型有冇答中,卻未必揭示它是否用對了空間線索。論文與附帶說明指出,多個模型家族都出現 vertical-distance entanglement,也就是把畫面較高的位置誤當成較遠,反映自然照片常見的 perspective heuristic「higher in the image ⇒ farther away」。

  • 用最少對照設計觀察表示層,而不只看答題分數
  • 可比較不同 layer 的空間軸是否清晰分離
  • 能發現 vertical 與 distance 是否糾纏,幫助找出偏差來源
  • 適合分析 EmbSpatial-Bench、SpatialTunnel 這類空間推理資料

對研究者、模型分析人員,或者要檢查 multimodal assistant、robotics、embodied agents 背後空間推理可靠性的人,這個項目尤其有用。現有資料顯示,就算 benchmark 分數相近,不同 VLM 的內部表示也可能差很遠,而空間軸分得較清楚的模型,通常在不同測試上的穩健性會較好。

整體來看,這不是訓練新模型的項目,而是一套偏向診斷與解釋的工具。它的創新點在於用 minimal contrastive pairs 加上 representation-level analysis,把「模型為何會答對或答錯」拆成更具體的內部結構問題,對想深入理解 VLM 空間能力的人,價值比單看排行榜更高。

GitHub: https://github.com/cheolhong0916/contrastive-probing

項目: https://cheolhong0916.github.io/whyfarlooksup.github.io/

Categories: 開源, 視覺模型, 世界模型, 模型訓練, NVIDIA, 框架, 3D

WorldKV 點樣用較少記憶保留影片世界記憶

WorldKV用檢索加壓縮方式,令影片世界模型更慳記憶體又更快。重點是在不重新編碼下,盡量保留長期視覺記憶。

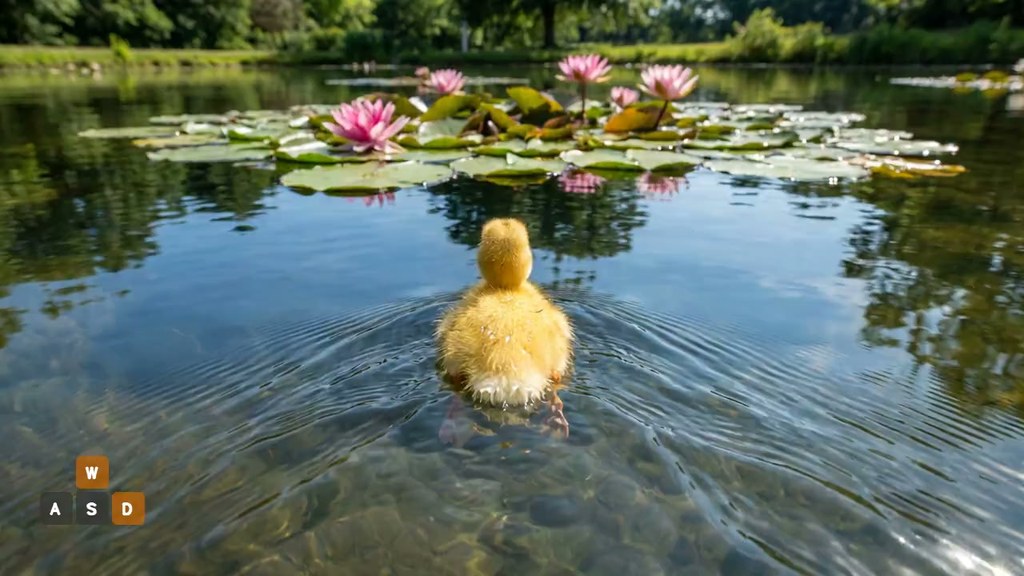
Input image: a yellow duckling swimming on a sunlit pond with water lilies

WorldKV 是一個針對自回歸影片世界模型的記憶管理項目,重點是用更少 KV cache 成本,保留模型對早前畫面與視角的長期記憶。頁面指出,它屬於免訓練框架,意思是不用重新訓練模型,就可以直接加到既有流程之中。

這個項目要處理的核心問題,是完整保留 KV cache 雖然有助模型記住之前見過的場景,但會很快吃光 GPU 記憶體,注意力計算亦會愈來愈慢。WorldKV 的做法是只在需要重訪某個視角或區域時,取回最相關的歷史片段,而不是永遠把全部內容放在作用中的視窗內。

它的設計有兩個關鍵部分:World Retrieval 會把被移出的 KV 片段按鏡頭或動作狀態建立索引,之後在合適時機取回最相關的 top-k 片段,而且不需要重新編碼;World Compression 則以每段首幀作錨點,利用 key-key cosine similarity 移除過於相似的 token,保留較能代表新區域或時間變化的資訊。

重點可留意:
– 屬於免訓練方法,較易接入現有模型流程
– 以檢索方式保留重訪所需記憶,而非硬性保存全部內容
– 以壓縮方式減少每段儲存量,頁面稱可減半
– 在 Matrix-Game 2.0 與 LingBot-World-Fast 上,吞吐量約提升至 2 倍,同時 KV cache 的 VRAM/RAM 佔用接近減半
– 頁面指記憶保真度可達到,部分情況甚至超過 Full KV

對想處理長影片生成、互動世界模擬,或需要模型記住先前視角與場景的人來說,這個項目特別值得留意。從頁面資訊看,它最適合受限於 GPU 記憶體、又希望維持即時或接近即時推理速度的情境;目前展示內容以項目頁與論文摘要為主,更細緻的限制與穩定性仍要留待論文與程式碼進一步確認。

*未有清楚列出完整基礎模型名稱。

項目: https://cvlab-kaist.github.io/WorldKV/

Categories: 視覺模型, 視頻模型, 3D

SplAttN:用可微分投影補強點雲補全的關鍵一環

SplAttN嘗試把2D影像線索真正帶進3D點雲補全,而不是流於形式的多模態輸入。

SplAttN logo

SplAttN 是一個面向影像引導點雲補全(Point Cloud Completion)的 PyTorch 研究專案,核心目標是讓稀疏的 3D 幾何與 2D 視覺先驗之間,維持可學習且可微分的連結。它對準的問題很明確:傳統把點雲硬式投影到影像平面後,往往只留下過度稀疏的對應訊號,導致影像資訊難以有效影響補全結果。

這個方法的亮點,在於以 Differentiable Gaussian Splatting 取代硬投影,將稀疏投影點轉成較連續、較稠密的影像平面表示,再透過注意力機制融合幾何特徵與視覺特徵。從論文描述來看,這不只是提升表現的工程技巧,更是在處理多模態學習中「影像到底有沒有真的被用上」的核心問題。

值得注意的是,SplAttN 還加入了反事實評估觀點,檢查模型是否真的依賴視覺線索,而不是把影像當成可有可無的附加輸入。README 提到它在 PCN、ShapeNet-55/34 與 KITTI 上做了驗證,並宣稱在部分基準上達到先進水準;其中 KITTI 被當作壓力測試,這點對評估真實場景泛化特別有參考價值。

重點摘要:
– 以可微分 Gaussian splatting 改善 2D 與 3D 的訊號連接
– 用注意力融合影像與幾何特徵,強化跨模態依賴學習
– 強調反事實評估,而非只看最終分數高低
– 提供官方 PyTorch 實作,適合研究重現與延伸

實際使用上,這個專案最適合拿來做多模態點雲補全研究、模型重現、方法比較,尤其適合想分析影像訊號在 3D 任務中是否真正發揮作用的研究者。若你的工作聚焦在 3D 視覺、自动駕駛感知或學術實驗設計,SplAttN 的價值不只在結果,還在它對跨模態連結機制提出了更可檢驗的做法。

Source: https://github.com/zay002/SplAttN

Categories: 開源, 模型, 3D

Moonlake AI 3D 建模代理

Moonlake AI 推出的 3D Agent 是其世界建模代理的重要更新,能直接在 Blender 中操作電腦,自動建立 3D 場景、關節資產與複雜環境。 主要功能 它能從單一圖像重建可編輯的室內外場景,無需預定義規則;同時建模具零件與關節的資產,並持續精煉數千步驟。代理像技術藝術家般運作,整合現有製作流程,支援資產管理系統並批量啟動任務。早期合作夥伴已用於模擬資產創作、遊戲世界建置與場景清理等重複工作自動化。 應用場景 適用於遊戲開發、3D 內容生成與生產線自動化,能加速互動世界建置達 100 倍。Moonlake AI 獲 NVIDIA 等投資,聚焦多模態推理模型與生成遊戲引擎。

Moonlake AI 推出的 3D Agent 是其世界建模代理的重要更新,能直接在 Blender 中操作電腦,自動建立 3D 場景、關節資產與複雜環境。

主要功能

它能從單一圖像重建可編輯的室內外場景,無需預定義規則;同時建模具零件與關節的資產,並持續精煉數千步驟。
代理像技術藝術家般運作,整合現有製作流程,支援資產管理系統並批量啟動任務。
早期合作夥伴已用於模擬資產創作、遊戲世界建置與場景清理等重複工作自動化。

應用場景

適用於遊戲開發、3D 內容生成與生產線自動化,能加速互動世界建置達 100 倍。
Moonlake AI 獲 NVIDIA 等投資,聚焦多模態推理模型與生成遊戲引擎。

Categories: Agentic, NVIDIA, 3D

SkinTokens 實現自動化骨骼綁定

SkinTokens 技術旨在自動化 3D 製作中繁瑣的「綁定」流程,解決傳統手動設置骨架與蒙皮權重的難題。其核心創新是將連續的蒙皮數據「標記化」,轉換為類似語言模型的離散代碼並有效壓縮。基於此開發的 TokenRig 框架利用生成式自回歸模型,能像寫文章般精確預測各種人類、動物或奇幻生物的運動結構。這項技術不僅具備高度通用性與精確度,更能應對複雜幾何形狀,實現高品質的自動化蒙皮與骨架生成,大幅提升動畫製作效率。 如果你是一位 3D 開發者、遊戲開發者或動畫師,這項技術可以大幅縮短你製作 3D 模型動畫準備工作的時間,並能跨多種不同類型的角色提供穩定、高品質的自動綁定結果。

SkinTokens 技術旨在自動化 3D 製作中繁瑣的「綁定」流程,解決傳統手動設置骨架與蒙皮權重的難題。其核心創新是將連續的蒙皮數據「標記化」,轉換為類似語言模型的離散代碼並有效壓縮。基於此開發的 TokenRig 框架利用生成式自回歸模型,能像寫文章般精確預測各種人類、動物或奇幻生物的運動結構。這項技術不僅具備高度通用性與精確度,更能應對複雜幾何形狀,實現高品質的自動化蒙皮與骨架生成,大幅提升動畫製作效率。

如果你是一位 3D 開發者、遊戲開發者或動畫師,這項技術可以大幅縮短你製作 3D 模型動畫準備工作的時間,並能跨多種不同類型的角色提供穩定、高品質的自動綁定結果。

Categories: 開源, 3D

Gen3R 影片資訊直接生成 3D 

Gen3R 是一個將基礎重建模型與視訊擴散模型結合的框架,目標是從單張或多張圖片生成包含 RGB 影片與幾何資訊的 3D 場景。如果你對於用影片資訊直接生成 3D 幾何感興趣,這是目前最接近「一鍵產出完整場景」的方案之一。 核心流程是:先把 VGGT 重建模型的 token 包成幾個幾何潛在變數,再用一個 adapter 把這些潛在值推向影片擴散模型的外觀潛在;兩種潛在同時生成,互相對齊後就能一次產出 RGB 影片 plus 完整的 3D 幾何資訊(相機姿態、深度圖、全局點雲)。 實驗顯示在單張或多張圖像條件下都能得到最佳的 3D 場景生成結果,而且透過擴散先驗提升了重建的穩定性。整體上是把重建跟生成模型「緊密」捆綁在一起,而不是分開處理。  

Gen3R 是一個將基礎重建模型與視訊擴散模型結合的框架,目標是從單張或多張圖片生成包含 RGB 影片與幾何資訊的 3D 場景。如果你對於用影片資訊直接生成 3D 幾何感興趣,這是目前最接近「一鍵產出完整場景」的方案之一。

核心流程是:先把 VGGT 重建模型的 token 包成幾個幾何潛在變數,再用一個 adapter 把這些潛在值推向影片擴散模型的外觀潛在;兩種潛在同時生成,互相對齊後就能一次產出 RGB 影片 plus 完整的 3D 幾何資訊(相機姿態、深度圖、全局點雲)。

實驗顯示在單張或多張圖像條件下都能得到最佳的 3D 場景生成結果,而且透過擴散先驗提升了重建的穩定性。整體上是把重建跟生成模型「緊密」捆綁在一起,而不是分開處理。  

Gen3R: 3D Scene Generation Meets Feed-Forward Reconstruction
Categories: 開源, 字節跳動, 影像模型, 影像處理, 3D

MVTracker 多視角 3D 點追蹤技術突破

在動態場景中精確追蹤物體,一直是電腦視覺領域的一大挑戰。傳統的單目追蹤器常受限於深度模糊和遮擋問題,而現有的多攝影機解決方案又往往需要多達20多個攝影機,並進行繁瑣的逐序列優化。然而,一項由ETH Zürich等機構開發的創新技術——MVTracker,正以其獨特的方法,為多視角3D點追蹤領域帶來革命性的突破。 引領多視角3D追蹤進入數據驅動新時代

在動態場景中精確追蹤物體,一直是電腦視覺領域的一大挑戰。傳統的單目追蹤器常受限於深度模糊和遮擋問題,而現有的多攝影機解決方案又往往需要多達20多個攝影機,並進行繁瑣的逐序列優化。然而,一項由ETH Zürich等機構開發的創新技術——MVTracker,正以其獨特的方法,為多視角3D點追蹤領域帶來革命性的突破。

引領多視角3D追蹤進入數據驅動新時代

(more…)
Categories: 開源, 視覺模型, 影像處理, 3D

LongSplat 三維高斯噴灑框架

LongSplat 是個用於從隨機拍攝的長影片中生成新穎視角的三維高斯噴灑(3D Gaussian Splatting)框架。它能夠解決從隨機拍攝、具有不規則攝影機運動和未知攝影機姿態的長影片中進行新視角合成的關鍵挑戰。

LongSplat 是個用於從隨機拍攝的長影片中生成新穎視角的三維高斯噴灑(3D Gaussian Splatting)框架。它能夠解決從隨機拍攝、具有不規則攝影機運動和未知攝影機姿態的長影片中進行新視角合成的關鍵挑戰。

Categories: 開源, 視頻模型, 影像處理, 3D

Page 9 of 10
1 7 8 9 10