NVIDIA 與 Black Forest Labs 合作,使用
NVIDIA TensorRT軟體開發套件和量化技術針對
NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],
從而以更低的 VRAM 要求提供更快的推理速度。

NVIDIA 與 Black Forest Labs 合作,使用NVIDIA TensorRT軟體開發套件和量化技術針對NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],從而以更低的 VRAM 要求提供更快的推理速度。
NVIDIA 與 Black Forest Labs 合作,使用
NVIDIA TensorRT軟體開發套件和量化技術針對
NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],
從而以更低的 VRAM 要求提供更快的推理速度。
MTVCrafter 是專門用來製作高品質的數字人動畫。現有方法依賴二維渲染的姿態影像進行運動引導,這限制了其泛化能力並丟棄了重要的三維資訊。MTVCrafter 有兩個厲害的設計:第一個是 4DMoT(4D 運動標記器),能夠將三維動作轉成 4D 運動標記,比二維圖片更精準地捕捉時間和空間的細節!第二個是 MV-DiT(運動感知影片 DiT),用了一個特別的 4D 位置編碼技術,讓動畫在複雜的三維世界裡也能流暢又生動。實驗結果的 FID-VID 分數達到 6.98,比第二名強了 65%,不管是單人、多人、全身或半身的角色,還是各種風格和場景,它都能輕鬆搞定!
MTVCrafter 是專門用來製作高品質的數字人動畫。現有方法依賴二維渲染的姿態影像進行運動引導,這限制了其泛化能力並丟棄了重要的三維資訊。MTVCrafter 有兩個厲害的設計:第一個是 4DMoT(4D 運動標記器),能夠將三維動作轉成 4D 運動標記,比二維圖片更精準地捕捉時間和空間的細節!第二個是 MV-DiT(運動感知影片 DiT),用了一個特別的 4D 位置編碼技術,讓動畫在複雜的三維世界裡也能流暢又生動。實驗結果的 FID-VID 分數達到 6.98,比第二名強了 65%,不管是單人、多人、全身或半身的角色,還是各種風格和場景,它都能輕鬆搞定!
Gemma 3n 是一款開源生成式 AI 模型,針對手機、筆記型電腦和平板電腦等日常設備進行了最佳化。包括逐層嵌入 (PLE) 參數快取和 MatFormer 模型架構,可靈活降低運算和記憶體需求。模型同時具備音訊輸入處理、文字和視覺資料處理等功能。 Gemma 3n 模型的參數在 E2B 模型的標準執行過程中,執行模型時會載入超過 50 億個參數。然而,使用參數跳過和 PLE 快取技術,該模型可以在有效記憶體負載略低於 20 億(19.1 億)個參數的情況下運行。Huggingface 下載
Gemma 3n 是一款開源生成式 AI 模型,針對手機、筆記型電腦和平板電腦等日常設備進行了最佳化。包括逐層嵌入 (PLE) 參數快取和 MatFormer 模型架構,可靈活降低運算和記憶體需求。模型同時具備音訊輸入處理、文字和視覺資料處理等功能。
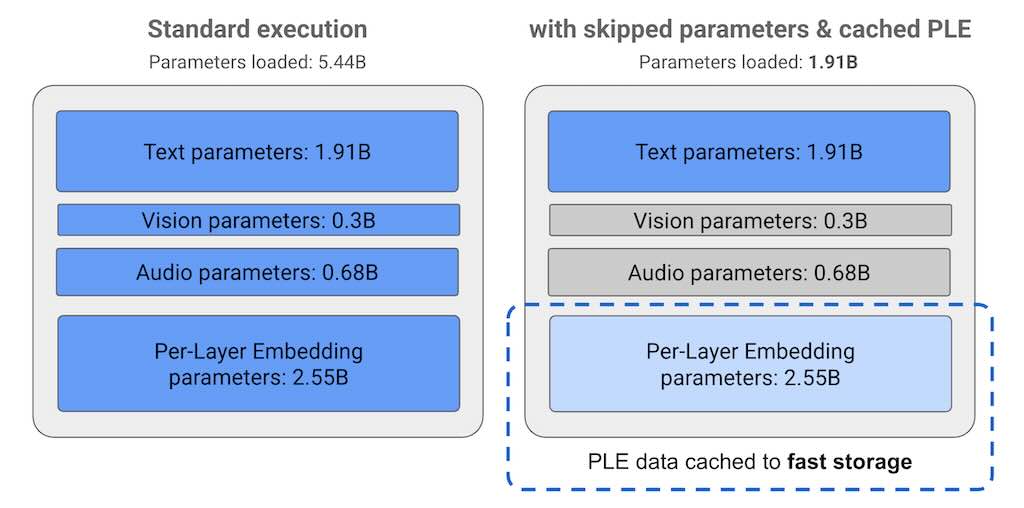
Gemma 3n 模型的參數在 E2B 模型的標準執行過程中,執行模型時會載入超過 50 億個參數。然而,使用參數跳過和 PLE 快取技術,該模型可以在有效記憶體負載略低於 20 億(19.1 億)個參數的情況下運行。Huggingface 下載

Google 推出了 Gemini CLI,一個免費的開源項目。它允許開發者透過自然語言指令在 Terminal 使用 Google 的 Gemini 2.5 Pro 模型。它可以編寫程式碼,亦能夠處理內容的生成、或者解決問題、甚至深入研究和任務管理等的多種任務。這個工具的設計目標是提升開發者在終端機中的工作效率,令 AI 成為日常工作流程的一部分。
Google 推出了 Gemini CLI,一個免費的開源項目。它允許開發者透過自然語言指令在 Terminal 使用 Google 的 Gemini 2.5 Pro 模型。它可以編寫程式碼,亦能夠處理內容的生成、或者解決問題、甚至深入研究和任務管理等的多種任務。這個工具的設計目標是提升開發者在終端機中的工作效率,令 AI 成為日常工作流程的一部分。
影片中,作者使用了 Google 的 embedding 模型和 ChromaDB 向量資料庫來實現這個架構。 影片強調動手實作的重要性,鼓勵觀眾親自寫一遍程式碼以加深理解。
影片中,作者使用了 Google 的 embedding 模型和 ChromaDB 向量資料庫來實現這個架構。
影片強調動手實作的重要性,鼓勵觀眾親自寫一遍程式碼以加深理解。

在 Anthropic 最近的研究中,引入了一種追蹤大型語言模型思想的新方法。今天,他們開放該方法的源代碼,以便任何人都可以藉鑑我們的研究成果。 您可以造訪 Neuronpedia 介面 來產生和查看您選擇的提示的歸因圖。對於更複雜的使用和研究,您可以查看 程式碼庫。此版本使研究人員能夠:
在 Anthropic 最近的研究中,引入了一種追蹤大型語言模型思想的新方法。今天,他們開放該方法的源代碼,以便任何人都可以藉鑑我們的研究成果。
您可以造訪 Neuronpedia 介面 來產生和查看您選擇的提示的歸因圖。對於更複雜的使用和研究,您可以查看 程式碼庫。此版本使研究人員能夠:

1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。 影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)
1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。
影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)

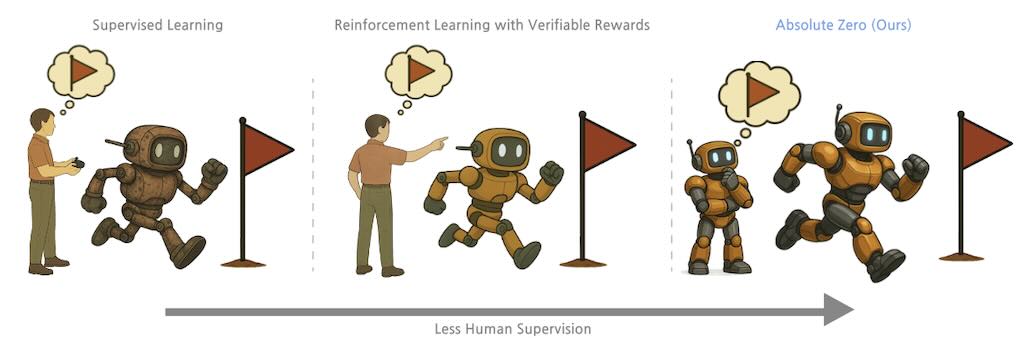
Absolute Zero 是由清華大學主導的一項創新語言模型訓練方法。這個方法最顯著的特點是不再需要由人類提供的數據進行訓練,而是自動生成問題,然後嘗試自動解決問題來進行學習。過往的監督學習,或者強化學習,一般都是由人類設定目標進行監管,而 Absolute Zero 可以透過自我對弈機制。能夠在數學和程式設計的領域中自動提升推理能力。研究顯示,這種模型不僅在這些領域達到了最先進的性能,甚至超越了由人類策劃的數據去訓練的模型。
Absolute Zero 是由清華大學主導的一項創新語言模型訓練方法。這個方法最顯著的特點是不再需要由人類提供的數據進行訓練,而是自動生成問題,然後嘗試自動解決問題來進行學習。過往的監督學習,或者強化學習,一般都是由人類設定目標進行監管,而 Absolute Zero 可以透過自我對弈機制。能夠在數學和程式設計的領域中自動提升推理能力。研究顯示,這種模型不僅在這些領域達到了最先進的性能,甚至超越了由人類策劃的數據去訓練的模型。
nanoVLM 是一種極簡輕量級的視覺語言模型 (VLM),專為高效的訓練和實驗而設計。使用純 PyTorch 構建,整個模型架構和訓練邏輯大約需要 750 行程式碼。它將基於 ViT 的圖像編碼器(SigLIP-B/16-224-85M)與輕量級因果語言模型(SmolLM2-135M)相結合,形成了一個緊湊的 222M 參數模型。該模型使用來自 cauldron 資料集的 170 萬個樣本在單一 H100 GPU 上訓練約 6 小時後,在 MMStar 上實現了 35.3% 的準確率,這使其成為低資源 VLM 研究的強大基線。
💥 FaceFusion 3.2.0 更新不僅帶來了全新的GPU加速,還提升了不少效能與真實感! 🔍 新功能1️⃣ YOLO NSFW過濾2️⃣ 多GPU支援3️⃣ FLAC音訊輸出4️⃣ 臉部選擇增強
💥 FaceFusion 3.2.0 更新不僅帶來了全新的GPU加速,還提升了不少效能與真實感!
🔍 新功能
1️⃣ YOLO NSFW過濾
2️⃣ 多GPU支援
3️⃣ FLAC音訊輸出
4️⃣ 臉部選擇增強