CNS 點樣改良擴散取樣效率

這項目用更聰明的雜訊分配方式,提升 diffusion models 生成影像的品質。重點是不改模型訓練,只替換取樣器。

CNS teaser

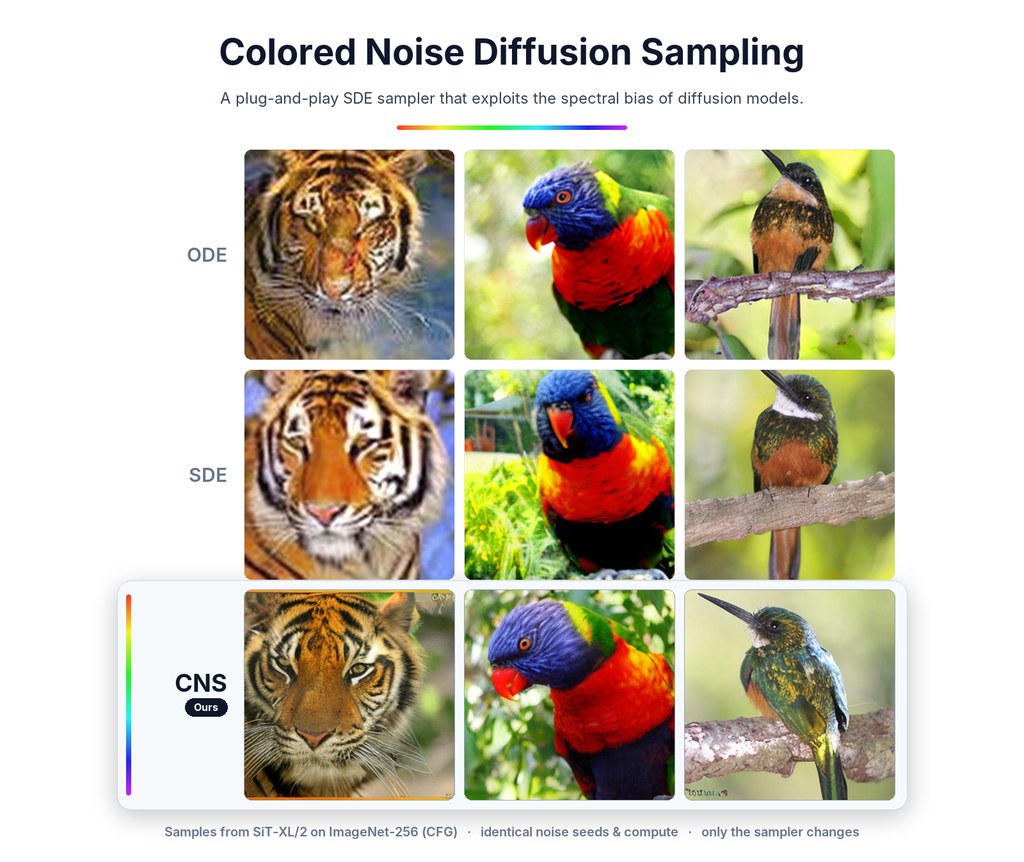
Colored Noise Sampling(CNS),核心想法是按影像頻率分配雜訊,而不是每一步都加入同樣的 white noise。對非研究背景讀者來說,可以把它理解成:模型早段已經大致砌好輪廓,就不必再把力氣花在這些部分,反而集中補足仍未成形的細節。

它要解決的問題很明確:傳統 Stochastic Differential Equations(SDE)取樣器會平均地把隨機能量灑向所有頻段,但 diffusion models 本身有 spectral bias,低頻結構較早完成,高頻細節較後才逐步補上。CNS 會利用預先計算好的 gamma matrix,判斷每個頻段在不同時間步的完成程度,再把雜訊導向仍然欠缺結構的部分。

這個設計吸引之處,在於它屬於 training-free,而且是 plug-and-play sampler substitution。換句話說,不用重新訓練原有模型,不用增加步數,主要改動只在 noise injection;對已經有生成流程的人,這比重建整個項目方便得多。

  • 保留原模型與原取樣步數,只改取樣時的雜訊策略
  • 依靠 gamma matrix 做頻率感知的動態分配
  • 支援多種架構,文件提到 SiT、JiT、FLUX
  • 在 ImageNet-256 的 FID 結果有明顯改善,尤其 unguided 設定較突出

項目提供了較具體數字:SiT-XL/2 的 unguided FID 由 8.26 降到 6.27,JiT-B/16 由 32.39 降到 26.69,JiT-H/16 由 11.88 降到 8.31;使用 Classifier-Free Guidance 時也有一致改善。這些結果顯示,CNS 並非單靠理論包裝,而是在多個模型上都有可量化的收益。

這項目較適合已經在研究或測試 diffusion models 生成品質的人,例如想比較 ODE 與 SDE 取樣差異、希望在不改訓練成本下提升輸出表現的開發者。若你只想快速理解概念,重點就是:CNS 不是換模型,而是把每一步加入的隨機能量分配得更精準。

GitHub: https://github.com/hadardavidson/colored-noise-sampling
Categories: 開源, 影像處理, 框架

Skill0.5 如何提升強化學習泛化力

這個項目嘗試平衡技能記憶與即場調用,改善新情境下的表現。重點在於分流難度與分開優化兩類技能。

Og image

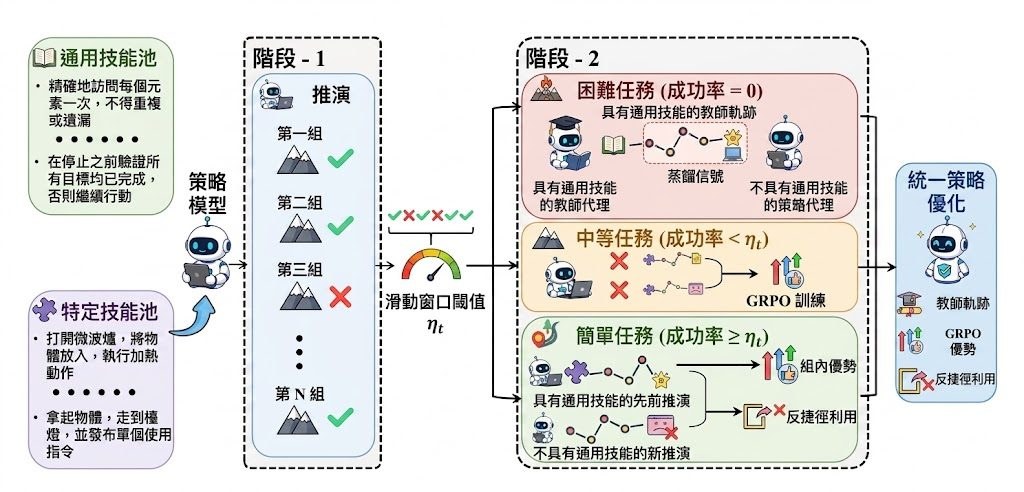
Skill0.5 是一個面向 Agentic Reinforcement Learning 的研究項目,聚焦處理 out-of-distribution generalization 問題。它指出傳統 skill-based RL 方法常要在 full externalization 與 full internalization 之間二選一,前者會帶來高昂的 context 開銷,後者則容易出現 overfitting 與知識衝突。

這項目把 general skill internalization 與 task-specific skill utilization 一同納入訓練,但用不同策略處理兩種性質不同的技能。系統會用 difficulty-aware router 按任務難度分流:Hard tasks 用 privileged distillation 內化通用技能,Medium tasks 用標準 RL 提升成功率,Easy tasks 則透過 diagnostic probing 懲罰走捷徑的行為,迫使模型忠實運用任務相關技能。

對初步理解這個項目的人來說,可先把它視為一種「按難度分工」的訓練框架,而不是單一模型結構。使用時要留意 context 開銷被視為問題之一,某程度上也反映較重的外部技能依賴可能增加資源壓力,包括 VRAM 與序列處理成本。

  • 解決 rigid choice 問題,避免只靠 externalization 或 internalization
  • 用 difficulty-aware router 把任務分成 Hard、Medium、Easy 三層
  • 分別結合 privileged distillation、標準 RL 與 diagnostic probing
  • 在 ALFWorld 與 WebShop 中,據摘要所述優於 memory-based 與 skill-based RL baselines

這類項目較適合研究智能代理、任務規劃與泛化能力的人參考,尤其是想改善模型在陌生情境下穩定性的團隊。

訓練和實現時使用 Qwen2.5-7B-Instruct 作為基礎模型。策略最佳化方面採用 GRPO 作為骨幹網絡,組別大小 G = 8,學習率為 1 × 10⁻⁶。訓練在 4 個 H800 GPU 上進行,每次迭代的批次大小為 16 個任務,最大互動範圍設定為 30 步。任務特定技能透過 Qwen3-Embedding-0.6B 取得。

GitHub: https://github.com/JasonZhujp/Skill0_5

Categories: 開源, 多模態模型, 影像模型, 影像處理

LaRA 用層級表示找出 RL 訓練污染

這篇論文提出 LaRA,以模型內部表示偵測 RL 後訓練的資料污染,比只看輸出更可靠。

Hero image preview

這篇論文介紹 LaRA(Layer-wise Representation Analysis),目的是找出 Reinforcement learning(RL)post-training 階段的資料污染問題。所謂污染,是指評估題目或基準資料混入訓練資料,令 Large Language Models(LLMs)看似表現很好,但其實可能只是記住答案,影響泛化能力與評估可信度。

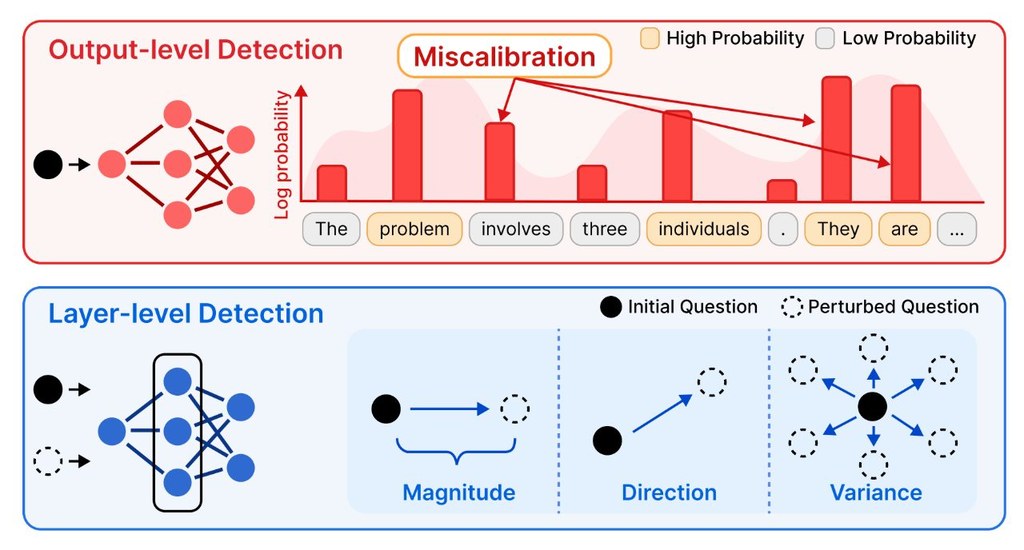
作者指出,現有方法多數只看輸出層面的訊號,例如 likelihood、entropy 或生成行為差異,但這類方法對 RL 訓練後的模型未必穩定。原因是 RL 重點在整條 reasoning trajectory 的 reward,而不是逐個 token 的機率,因此只靠輸出分佈,容易受 miscalibration 影響,未必能準確反映模型是否記住了評測資料。

LaRA 改為分析模型各層的內部表示,觀察受控擾動前後的幾何變化。論文提出三個互補指標:perturbation sensitivity、directional collapse、local representation rigidity,用來量度污染樣本在不同 layer 的異常反應;作者發現,受污染資料會在多層表示中逐步出現更高敏感度、更強方向收縮,以及更高局部剛性。

使用這個項目時,重點不是增加推理速度,而是作為檢測流程,協助研究人員審視 RL 訓練後模型的可信度。文中也提出一套偵測 protocol,把不同 layer 與不同指標的偏差整合起來;在 RL-trained reasoning models 的實驗中,這套方法表現優於現有 output-level baseline。

  • 解決 RL post-training 資料污染難以辨識的問題
  • 以 representation-level 訊號取代單看輸出機率
  • 結合三個指標,從多層 layer 分析污染痕跡
  • 適合用於 reasoning 模型評估、訓練審核與研究比較
  • 論文摘要未提供 VRAM 需求,較可能受模型大小、抽取 layer 數目與批次分析設定影響

如果你關心 VRAM 的應用,這篇內容沒有列出明確顯示卡記憶體需求,也沒有提供部署規格。不過按方法性質推測,LaRA 需要讀取多個 layer 的 hidden representations,使用時 VRAM 主要會花在模型載入、儲存中間層表示,以及對多個擾動版本做批次分析;模型越大、分析層數越多,VRAM 需求通常越高。

Paper: https://arxiv.org/pdf/2605.29888

Categories: 開源, 多模態模型, 影像模型, 影像處理

NAVA 點樣做好聲畫同步生成

NAVA 把影片與聲音一齊生成,重點放在聲畫同步與人聲控制。對想研究 AI 影片聲音生成的人,這個項目很有參考價值。

NAVA

NAVA 是一個主打音訊與影片同步生成的項目,目標不是先整好畫面再補聲,而是由一開始就把兩者放在同一個生成流程內處理。對非技術讀者來說,可以把它理解成一個較重視「畫面發生什麼,聲音就跟住發生什麼」的模型,因此打鬥、說話、環境聲這類時間配合會更自然。

這個項目的核心做法,是先在獨立空間建立 audio-video alignment,再用文字或其他 context 去引導生成,並採用 Align-then-Fuse MMDiT 架構。另一個亮點是 Timbre-in-Context Conditioning,能把參考 WAV 的音色對應到指定語音片段,適合多角色對白、指定聲線或旁白控制。

NAVA 有 6.3B 參數,可在 8 張 GPUs 配合 Ulysses sequence parallelism 下約 1 分鐘生成 720p 影片,這代表它主要面向高階 GPU 環境;VRAM 的作用是存放模型權重、推理中的中間特徵、音訊與影片 token,以及較高解像度生成所需的緩衝空間,VRAM 越充足,越有機會支援更高畫質、較長內容或較穩定的批次推理。

  • 支援 native stereo audio,畫面、場景聲與語音一併生成
  • 可用文字控制鏡頭構圖、運鏡與節奏
  • 支援 multi-timbre voice control,適合多角色配音場景
  • 同一 checkpoint 可輸出橫向、直向與正方形比例
  • 英文 TTS 表現較強,其他語言支援看來仍較有限

它在 Verse-Bench、Seed-TTS 及用戶研究中,於影片質素、聲畫同步和參考音色可控性有明顯優勢,音訊質素亦具競爭力。若你關注開放式 audio-video generation、TTS、虛擬角色影片、短片內容製作,或者想研究 6.3B 級別模型如何平衡同步效果與運算需求,NAVA 是一個很值得細看的項目。

GitHub: https://github.com/ernie-research/NAVA

Categories: 開源, 多模態模型, 影像模型, 影像處理

GenClaw 用寫程式方式改造 AI 生成圖

GenClaw 不只改提示詞,而是先用程式起草畫面再生成圖片。這種做法令構圖、文字與場景控制更清晰。

teaser

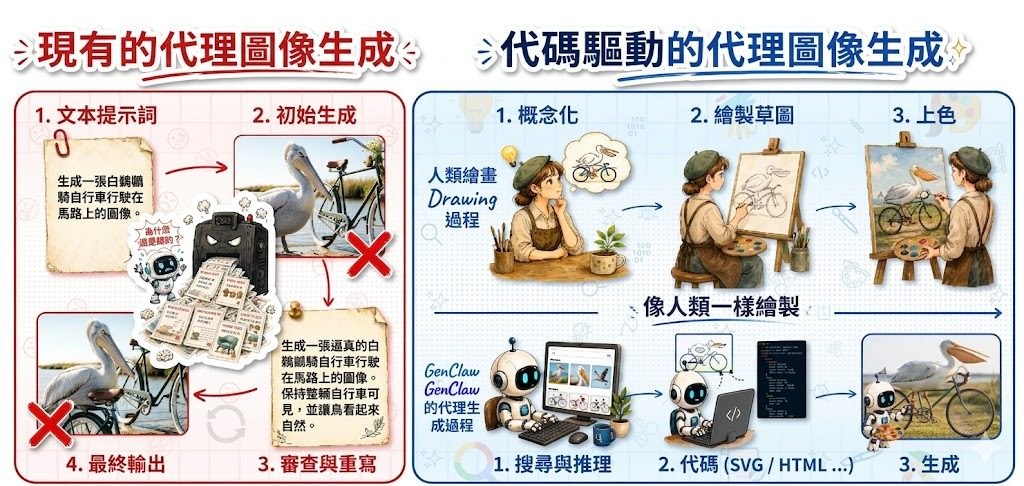
GenClaw 是一個研究中的項目,核心不是不停改 prompt,而是把程式碼變成可控制的視覺草稿,再交給圖像模型完成渲染。對一般讀者來說,可以把它理解成先畫草圖、定位置、排文字,之後才交由 AI 上色和補質感。

這個項目想處理的痛點很明確:很多 image generation 流程仍然像黑盒,生成失敗時只能反覆重寫提示詞碰運氣。GenClaw 將流程拆成 concept、sketch、render 幾步,令畫面中的物件數量、空間配置,甚至文字排版,都有機會透過可執行程式直接調整。

這做法結合搜尋、推理與程式繪圖,使用 SVG、HTML/CSS、Python,亦提到 Three.js 這類輕量 3D 方式來建立中間畫布;最後再調用 image generation model 補上材質、光影與真實感。這種設計比單次生成更容易檢查、修改,亦較貼近人類由草稿到完稿的創作步驟。

  • 把程式碼當成視覺畫筆,而非只靠文字提示
  • 適合複雜場景、海報文字、空間佈局等要求較高的畫面
  • 中間結果可檢查與回退,降低黑盒生成的不確定性
  • 論文提到可配合 GPT-Image、Qwen-Image、Nano-Banana 一類模型理解其定位

現階段要留意的是,儲存庫已公開 technical report,但 code 和 demo 仍在準備中,所以目前較適合先讀論文了解方法,再觀察後續釋出。從論文描述看,它較適合做視覺生成研究、代理系統開發,或者需要高控制度圖像流程的團隊;至於效能評估,公開頁面以方法與示例為主,較完整的量化表現仍需以論文內容和日後程式發布為準。

GitHub: https://github.com/yejy53/GenClaw

Paper: https://arxiv.org/pdf/2605.30248

Categories: 開源, 香港中文大學, 清華大學, Agentic

MobileGym:手機操作測試搬到瀏覽器

項目把手機操作測試搬到瀏覽器,重點是可重設、可驗證、又能大規模並行。對研究手機 GUI 代理的人來說,方向相當清晰。

MobileGym — Program Mobile Worlds. Train GUI Agents. Verify by State. A verifiable and highly parallel simulation platfo

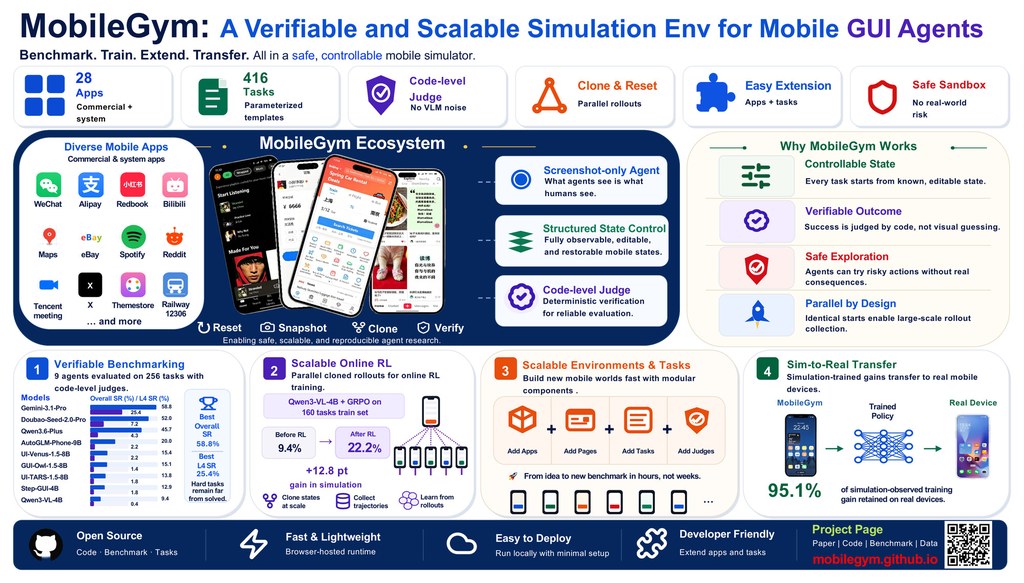
MobileGym 是一個放在瀏覽器內運行的手機模擬環境,重點不是做出一部「像真手機」,而是讓研究者可以穩定測試手機操作代理。它針對真機與模擬器常見的難題,例如狀態難以重現、評分不穩、成本高,提供一套較可控的做法。

使用相當直接:先開啟模擬環境,再把代理接上去執行任務,之後用內建評分函式檢查有沒有完成目標。這個項目提供 28 個模擬 app、416 個任務模板,也支援把整個環境狀態存成 JSON,方便重設、比較與重跑同一組測試。

MobileGym 在「結果驗證」不靠模糊文字比對,也不依賴視覺模型做人手味很重的判斷,而是直接檢查結構化狀態。這代表系統不止能知道任務是否成功,還能發現副作用,例如錯誤追蹤了某個帳戶,或誤發訊息,這類情況在真機流程往往較難完整看見。

  • 支援 256 個並行實例,同一台伺服器可同時跑大量測試
  • 每個實例約 400 MB 記憶體,冷啟動約 3 秒
  • 評分為可程式化且具決定性,官方稱可達亞毫秒級
  • 已展示模擬到真機的轉移效果,保留約 95.1% 的訓練增益

性能數字是這個項目的另一個賣點:官方資料指 256 個任務的完整評估可在約 6 分鐘完成,而且 CPU 佔用不高。對需要反覆訓練、比較不同策略或模型的人,例如 Qwen3-VL-4B 搭配 GRPO 這類流程,這種可並行、可重現的設計比單靠真機測試更實際。

整體來看,MobileGym 適合做手機 GUI 代理研究、評測流程設計,以及強化學習訓練驗證。它未必取代真機,但作為前期迭代與大規模評估平台,定位十分明確;尤其當你重視可重現性、成本控制,以及能否清楚知道代理到底做對了甚麼、又做錯了甚麼,這個項目值得留意。

GitHub: https://github.com/Purewhiter/mobilegym

Categories: 開源, 香港中文大學, 北京大學, 框架

Lens:更慳算力的高質文字生圖

Lens 主打用較少訓練資源,做出接近大型文字生圖模型的效果。這個 GitHub 項目則提供最精簡的圖片生成功能。

Lens Teaser

Lens 是 Microsoft 推出的文字生成圖片模型,規模約 3.8B 參數,重點不只是畫質,還包括「用較少訓練成本做到接近甚至追上更大模型」。這個 GitHub 項目目前定位清晰,主要提供推論用途的最小程式碼,方便直接用現成 checkpoint 生成圖片。

動手方式很直接:準備好 Lens 的權重後,利用這個項目的推論程式輸入文字提示,便可生成圖像。它特別適合想快速試畫面風格、測試長提示詞效果,或者比較不同文字生圖模型輸出的人;若要完整訓練或微調流程,現有儲存庫資訊顯示並不是這個項目的重心。

它解決的核心問題,在於近年文字生圖模型愈做愈大,訓練成本高得驚人。Lens 嘗試從資料密度、模型結構和解析度學習方式入手,在較緊湊的 3.8B 規模下,仍保持不錯的提示理解、高解析度輸出,以及多種長寬比生成能力。

較值得留意的地方有幾個:它用長篇密集描述的圖文資料預訓練,配合 mixed-resolution learning,令模型一次學到更多內容;文字理解方面則結合 GPT-OSS 多層特徵與 FLUX.2 semantic VAE。官方亦提到有 Lens-Turbo 這類後續變體,主打 4-step 快速生成,另有 RL 調整版本用來改善畫質與壓低瑕疵。不過仍需要 A100/V100 GPU。

  • 3.8B 參數規模,定位是高效率文字生圖模型
  • 支援約 1:2 至 2:1 長寬比,最高可到 1440×1440
  • 相關模型包括 Lens、Lens-Turbo,以及經 RL 調整的變體
  • 官方論文指出 1024×1024 輸圖可達約 3.15 秒,Turbo 4-step 約 0.84 秒

整體來看,這個項目最吸引之處不是功能包山包海,而是把焦點放在「精簡推論」與「高效率模型設計」上。對研究生成式 AI 趨勢、想評估新一代文字生圖效率,或需要高解析度輸出的開發者與創作者來說,Lens 是一個值得留意的項目;不過涉及基準細節與全面比較時,仍建議一併參考論文與模型頁面。

GitHub: https://github.com/microsoft/Lens

Paper: https://arxiv.org/pdf/2605.21573

Categories: 開源, 模型, 微軟, 影像模型

AIQ 為代理工具加上深度研究能力

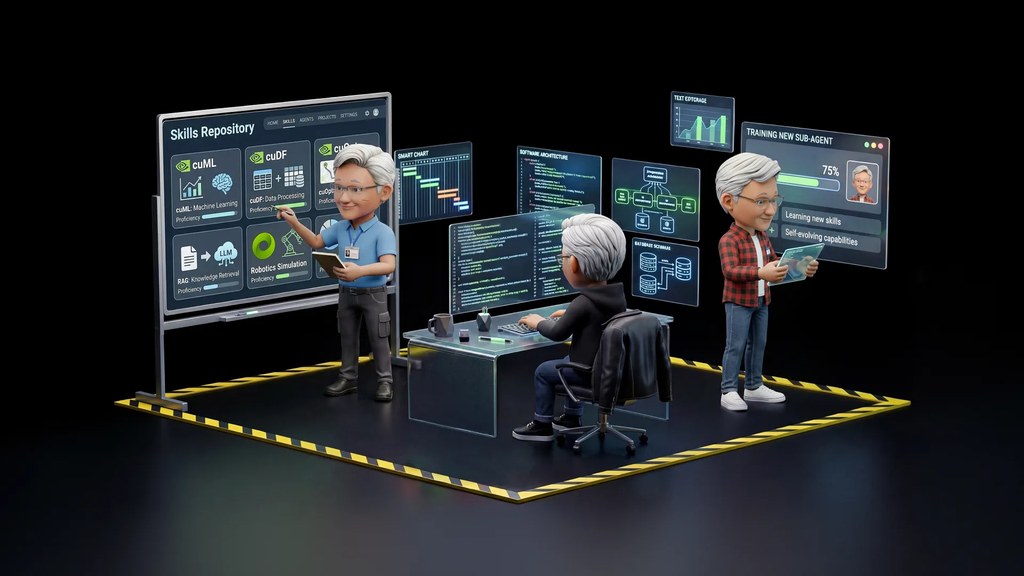
NVIDIA AI-Q把深度研究流程封裝成可重用技能,讓代理工具更易處理多來源分析。

Og image

不少代理工具本身已很擅長協調流程,例如管理對話、串接工具和執行程式碼;但一到需要整合多份文件、引用來源、或根據企業資料整理長篇分析,開發團隊往往要自行處理大量繁瑣工作。這篇內容介紹的 NVIDIA AI-Q,重點正是把這類深度研究能力封裝成可攜的項目技能,讓代理工具直接調用。

它解決的問題很明確:團隊不用再為每個項目重建檢索、規劃、整理、引用與評估流程。代理工具可把研究任務交給本機或託管的 AI-Q 伺服器,之後收回一份有結構、附引用的報告;而敏感資料亦可留在企業內部環境,對醫療、金融、政府及國防等重視資料管控的場景尤其重要。

上手方式亦相對直接。這個項目提供 SKILL.md 說明檔,以及一個輔助腳本去處理請求路由、提交工作、輪詢進度和取回結果。使用前需要 Python 3.10 或以上,並準備一個可連線的 AI-Q Blueprint 伺服器;預設會連到本機位址,也可透過環境變數改寫。

Give Codex a Deep Research Skill With NVIDIA AI-Q

重點可概括如下:
– 把深度研究流程包裝成代理工具可調用的技能
– 支援多來源資料整合,並輸出附引用的報告
– 減少每個項目重複搭建研究流程的工作
– 讓敏感資料可保留在企業內部環境
– 可配合 Claude Code、Codex 等通用代理工具使用

這個項目的創新之處,在於它不是只提供單一工具函式,而是把意圖分類、澄清問題、淺層研究、深度研究與評估整合成較高層的能力。換句話說,代理工具只需學會如何委派,便可利用完整研究管線,較適合想快速為現有代理系統加入研究能力的團隊。文中未見具體效能數字或基準測試,因此現階段較適合把它理解為一個工程整合與工作流程簡化方案。

模型列表:Claude Code、Codex

GitHub: https://github.com/NVIDIA-AI-Blueprints/aiq/tree/v2.1.0

項目: https://developer.nvidia.com/blog/add-a-specialized-deep-research-skill-to-agent-harnesses/

Categories: 開源, Agentic, NVIDIA, 框架

SpaceDG 評測:模糊影像下的空間推理

SpaceDG把「影像變差後,模型仲識唔識睇位」變成可量化問題。呢個項目特別適合關注多模態模型穩定性的人。

logo

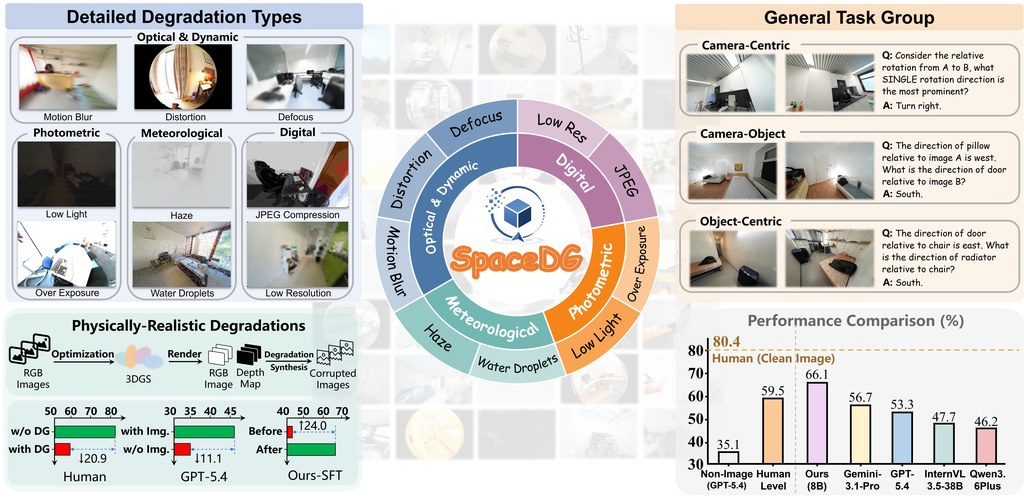
SpaceDG是一個圍繞空間理解而設的評測項目,重點不在「清晰圖片答得幾好」,而是進一步檢查圖片出現模糊、低光、壓縮失真、天氣干擾或鏡頭變形之後,模型仲能否判斷方向、位置同物件關係。這點很貼近真實環境,因為不少現場影像本來就未必完美。

動手方式相當清楚:先按項目提供的 EASI 流程準備環境,再下載 SpaceDG-Bench 數據,之後便可把自己的多模態模型放入同一套評測框架比較表現。對研究或產品測試來說,這比單看一般 VQA 分數更有參考價值,因為它專門檢查模型在「睇得唔清楚」時會點樣失準。

這個項目的特別之處,在於它不是隨便加噪聲,而是把九種影像退化效果納入 3D Gaussian Splatting 渲染流程,令退化更接近物理成因。公開資料顯示,整體數據規模約有 100 萬組問答,覆蓋接近 1,000 個室內場景,另有人工驗證的 SpaceDG-Bench,包含 1,102 條問題、11類推理任務與超過 1 萬個 VQA 例子。

  • 已評測 25 個開源及閉源模型,覆蓋面算廣
  • 影像退化會普遍拉低空間推理表現,人類亦同樣受影響
  • 退化監督微調可同時改善乾淨與受干擾圖片的表現
  • 物件計數等細節感知,似乎比部分幾何推理更易受影響
  • 文中提到的相關模型包括 GPT-5.4、Gemini-3.1-Pro、Qwen3.6Plus、InternVL 3.5-38B 及作者的 8B 版本

整體來看,SpaceDG最適合做模型評估、穩健性研究,以及需要處理監控、機械人、室內導航等場景的團隊。若你關心的不只是模型「最好情況」有幾叻,而是它在普通甚至較差畫面下是否仍可靠,這個項目相當值得留意;至於個別分數與完整設定,仍建議配合論文與基準頁面一併閱讀。

GitHub: https://github.com/Visionary-Laboratory/SpaceDG

Paper: https://arxiv.org/pdf/2605.22536

Categories: 開源, 上海人工智慧實驗室, 框架

Spreadsheet-RL:讓 AI 真正學識用 Excel

這個項目不只是叫模型答題,而是訓練它在 Excel 內逐步完成工作。對需要表格自動化研究的人來說,方向相當清晰。

overview

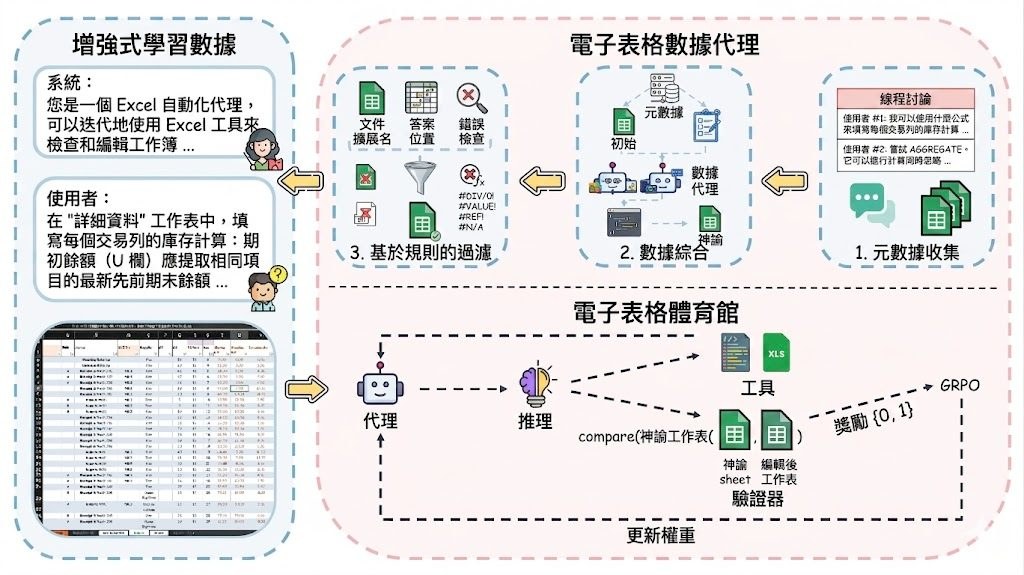
Spreadsheet-RL 是一個針對試算表工作的強化學習項目,重點不是單次輸出答案,而是讓大型語言模型在 Microsoft Excel 環境中分步操作,最後再用整份活頁簿的結果判斷做得對不對。對比一般只靠提示詞的方法,這種設計更貼近日常表格整理、計算和修正流程。

它解決的核心問題,是模型面對多步驟試算表任務時,往往容易中途出錯,或者只懂講做法但未必真的完成。這個項目把資料建立、互動環境、獎勵機制串連起來,令訓練目標不只是「說得像」,而是「做得啱」。當系統會重新計算並比對最終活頁簿,評分方式就比純文字答案更實在。

上手方向也算清楚:研究者可用它提供的訓練與評估堆疊,配合 Excel 獎勵服務、沙盒程式執行,以及多輪互動環境,去訓練或測試自己的試算表代理。內容明顯較適合具備機器學習、叢集運算或代理系統背景的人,普通用家未必會直接部署,但很適合拿來理解「AI 幫你做 Excel」背後需要哪些能力。

幾個值得留意的位包括:
– 以公開試算表論壇題目自動整理訓練資料,論文提到有 5,928 個經篩選任務
– 支援多輪 Excel 互動,而不只是一次生成答案
– 內建試算表原生工具、沙盒執行程式碼,以及獨立工作空間
– 以最終活頁簿正確性作為獎勵,較貼近真實工作成果
– 已公開 Spreadsheet-RL-4B,基於 Qwen/Qwen3-4B-Thinking-2507 訓練

表現方面,論文提到 Qwen/Qwen3-4B-Thinking-2507 經完整流程後,SpreadsheetBench 的 Pass@1 由 12.0% 提升到 23.4%,另一個 Domain-Spreadsheet 評估則由 8.4% 升至 17.2%。幅度相當明顯,但仍屬研究型結果,使用時也要留意其環境依賴較重,包括 Excel 服務、沙盒與訓練基建。

整體來看,Spreadsheet-RL 最有價值的地方,是它把「試算表代理」由提示工程推前一步,變成可訓練、可評估、可重現的完整項目。相關模型方面,文中可見 Qwen3-4B-Thinking-2507、Qwen3-4B Instruct、Qwen3-8B、Qwen3-14B、Qwen3-32B,以及 GPT-4o、OpenAI o3 等比較基線;對想研究 AI 自動處理表格工作的人,這是一個很值得留意的參考。

GitHub: https://github.com/Spreadsheet-RL/Spreadsheet-RL

Paper: https://arxiv.org/pdf/2605.22642

Categories: 開源, Meta, Dataset 數據集

Page 86 of 118
1 … 84 85 86 87 88 … 118