Bayesian-Agent:讓代理流程愈跑愈準

這不是另一個大型代理框架,而是把成功與失敗軌跡轉成可重用 Skills 與 SOPs 的演化層。它也支援跨執行環境接入,方便逐步改良既有項目。

Bayesian-Agent banner

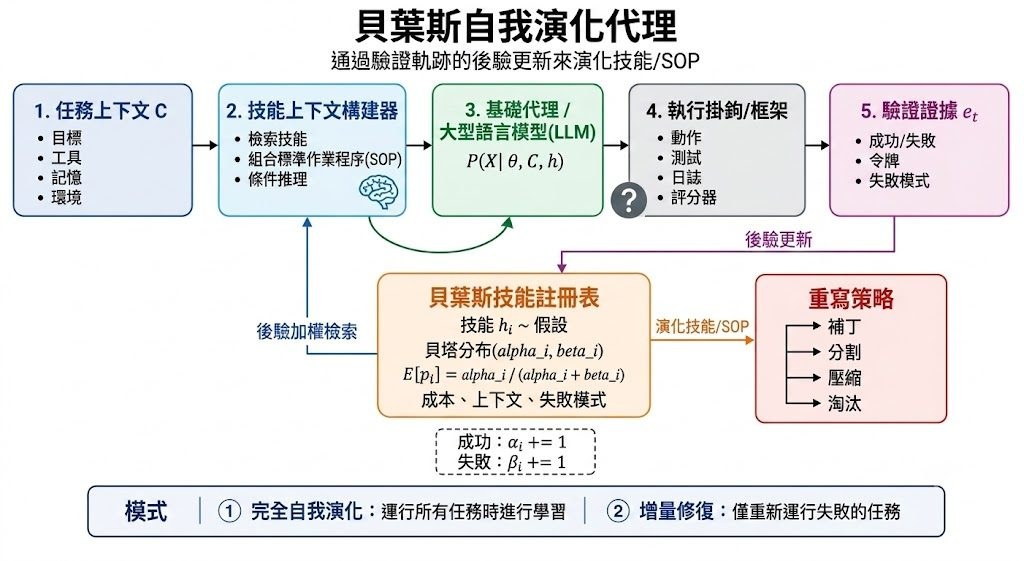
Bayesian-Agent 是一個 Bayesian self-evolving agent framework,更準確地說,它像是疊在代理系統之上的演化層:把已驗證的 agent trajectories 整理成可重用、帶證據權重的 Skills 與 SOPs。它不改動底層模型參數,而是調整推理階段可見的證據、失敗模式與流程選擇,目標是令代理在有限樣本下也能持續修正決策。

這個項目最實用的地方,在於它不要求你由零重建整套系統。文件顯示它支援三種路線:從零開始跑完整任務、接到既有代理後只修補失敗軌跡、以及在不同 execution harness 之間轉接。對手上已有 agent workflow 的團隊來說,這比重新訓練模型更貼近日常維護需要。

v0.5 加入 first-party native harness,內含自己的 LLM loop、workspace tools、三層記憶與 trajectory capture;同時保留 GenericAgent、mini-swe-agent、Claude Code 等 compatibility backends。這表示項目的重點不是綁死某一套框架,而是用可攜的 trajectory schema 和 adapter boundary,令 Skills 演化結果能跨環境沿用。

  • 核心定位是 Bayesian Skill Evolution,不是單純聊天模型
  • 可把 verified success/failure evidence 轉成可重用 Skills 與 SOPs
  • 支援 full-run evolution、incremental repair、cross-harness adaptation
  • 內建 Bayesian Evidence Model,亦保留 Beta-Bernoulli backend 作 ablations
  • 適合已有代理流程、想減少重試成本與修復失敗任務的團隊

表現方面,公開資訊提到 SOP-Bench、Lifelong AgentBench、RealFin-Bench 的實驗結果,並列出 deepseek-v4-flash 與 deepseek-v4-pro 的 native-harness 測試,但這裡未見完整數字,較穩妥的判斷是:項目已朝可比較、可驗證的方向整理實驗,而不是只停留在概念。若你正管理會反覆執行任務的 agent 項目,尤其需要判斷何時停止、重試或重寫流程,Bayesian-Agent 的價值會比一次性 Demo 更明顯。
GitHub: https://github.com/DataArcTech/Bayesian-Agent

項目: https://dataarctech.github.io/Bayesian-Agent/

Categories: 開源, 香港科技大學, Agentic, 框架

CoVEBench 檢查影片編輯模型的真功夫

這是用來驗證影片編輯模型表現的基準項目。它特別擅長揭出複合指令下常被忽略的失誤。

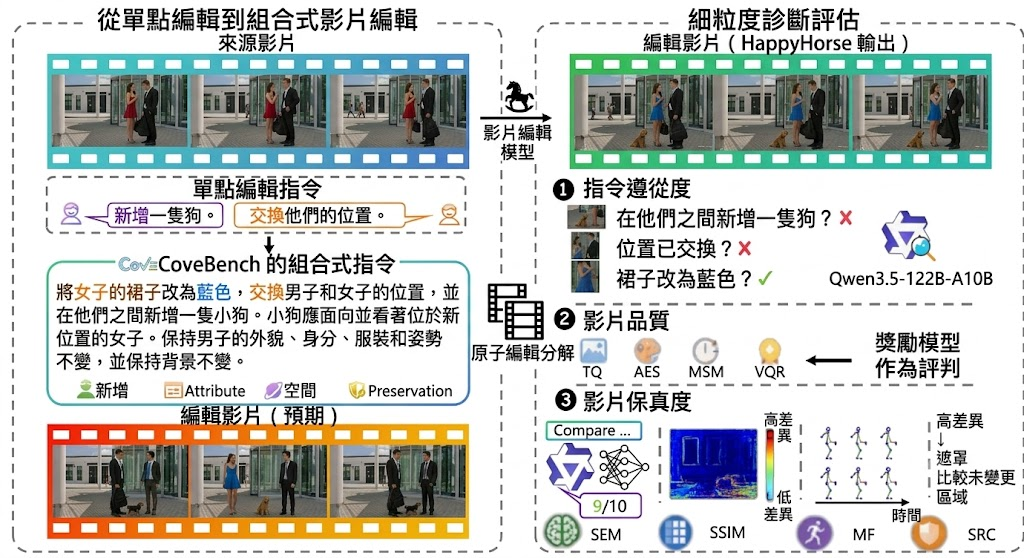
近年不少影片編輯模型已能根據文字改片,但一遇到多個要求同時出現,例如一邊改主體、一邊保留背景與動作連貫,表現就容易失準。CoVEBench 是一個診斷型 benchmark,專門檢查 compositional instruction-guided video editing 在複雜條件下是否真的做得到。

這項目的判斷方法比一般「整體看起來差不多」更嚴格。它把表現分成指令完成度、畫質與來源保真度三條線來看,並用細緻 checklist 檢查多個編輯點有沒有同時成立;就算模型個別要求做到幾項,只要無法通過 union criterion,分數仍然不高,這種設計能更早看出模型短板。

如果想了解它的內容,較合適的做法是先看示範頁與資料集規模,再對照評估指標。CoVEBench 收錄 416 段來源影片、626 條多重指令、9,990 個細項檢查點,預設會抽取 10 張等距 frame 做 frame-level metrics;AES、VQR、MSM 則只針對 edited videos 計算,方便把「改得夠不夠」與「有沒有改壞其他地方」分開分析。

  • 核心用途是評測 video editing models,不是直接拿來剪片
  • 主要指標包括 Union Accuracy(UAS)、Instruction Following Score(IFS)、Video Realism Score(VRS)、Semantic Consistency(SEM)
  • 設計重點在細粒度 checklist,而非只看單一總分
  • 結果顯示強模型未必兼顧保留原片內容,編輯力度與保真度存在拉扯
  • 項目亦比較了 joint editing 與 stepwise decomposition 的差異,前者表現更好

從公開資訊看,CoVEBench 的價值在於它把失敗原因拆得夠清楚,適合研究團隊、評測人員,以及想比較閉源與開源方案的人參考。相關模型包括 Wan2.7 與 HappyHorse1.0;即使領先系統在複合編輯上較強,UAS 仍未算高,反映這個領域離穩定可靠還有一段距離。

GitHub: https://github.com/NJU-LINK/CoVEBench

項目: https://nju-link.github.io/CoVEBench/

Categories: 開源, 影像處理, 框架

Echo-Memory 讓世界模型認得回家的路

當 AI 影片模型控制鏡頭離開某個場景再折返時,常常會「認錯地方」——同一條街、同一件家具,回來時卻變成另一個看起來合理、但其實陌生的世界。

Echo-Memory paper teaser and workflow

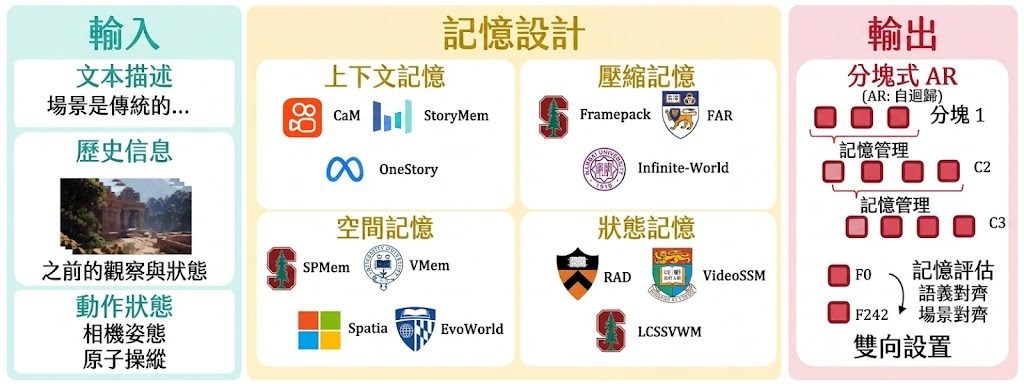
當 AI 影片模型控制鏡頭離開某個場景再折返時,常常會「認錯地方」——同一條街、同一件家具,回來時卻變成另一個看起來合理、但其實陌生的世界。Echo-Memory 想解的,正是這個讓生成影片失去一致性的老問題。整個研究的設計非常克制:只更換「記憶模組」,其餘一概不動。

Echo-Memory 以同一套 Wan 2.1 1.3B 動作到影片(action-to-video)模型作為共用底座,把記憶方式分成四大類——Context(原始幀滑窗)、Compression(壓縮後的學習 token)、Spatial(顯式空間讀寫狀態)、State-Space(區塊式 SSM 遞迴更新)。所有變體都掛在相同的寫入—讀取介面上,差別只在於「存什麼」和「怎麼取回」。這種單一變因的設定,讓四種記憶家族的表現可以乾乾淨淨地比較。

對研究員和工程師而言,項目提供了開發者指南。Echo-Team 已把訓練到 30,000 步的 Wan 2.1 1.3B 權重放在 Hugging Face 的 Echo-Team/Echo-Memory,並附上 SpatialVID 子集的動態訓練池設定文件,開發者指南亦提供中英雙語流程。評測方面,項目提供 GT replay、in-domain 180 度折返,以及 open-domain 編輯式回訪三種探測腳本,涵蓋靜態回放和場景重訪兩個維度。

要注意的是,目前的權重僅限 Wan 2.1 1.3B(epoch-0),Wan 2.2 以及 5B/14B 多尺度底座、以及超越靜態重訪的動態評測,仍列在路線圖上等待補齊。對於研究世界模型長期一致性、做可控影片生成,或是想在 LoRA/記憶外掛(memory adapter)方向動手的人,這個項目提供了一個難得的可重現基準;對一般讀者來說,它也示範了當鏡頭「回家」時,AI 為何會迷路、又該怎麼讓它記路。

重點摘要:

  • 統一底座、只換記憶:以 Wan 2.1 1.3B 為共用骨幹,比較 Context、Compression、Spatial、State-Space 四種記憶家族。
  • 可控變因設計:所有模組共享寫入—讀取介面,差異集中在「存什麼、怎麼取回」。
  • 完整可重現資源:公開 30,000 步權重、SpatialVID 訓練池設定、雙語開發者指南與評測腳本。
  • 三種回訪探測:GT replay、in-domain 180 度折返、open-domain 編輯式回訪,分別檢驗重播與折返記憶。
  • 未來路線:Wan 2.2、5B/14B 多尺度底座與動態評測仍待補齊。

GitHub: https://github.com/Echo-Team-Joy-Future-Academy-JD/Echo-Memory

項目: https://echo-team-joy-future-academy-jd.github.io/Echo-Memory/

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 框架

LatentSpatialMemory:Mirage 影片世界模型:把 3D 記憶藏在潛在空間裡

微軟與浙江大學等團隊發表 Mirage,把 3D 場景以潛在 token 形式持久保存,讓影片世界模型兼顧一致性與效率。

Latent Spatial Memory logo

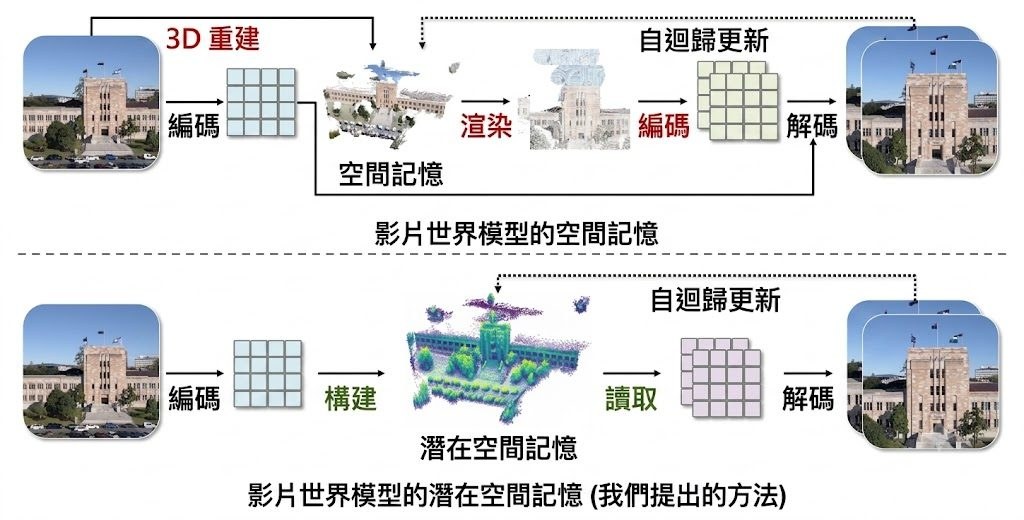
由微軟研究院、浙江大學、阿德萊德大學及 Monash University 共同發表的 Mirage,主打一個名為「Latent Spatial Memory」的方法,目標是讓 AI 影片世界模型在長序列生成時,仍能維持空間一致性。傳統做法會把 3D 場景快取為點雲,再反覆渲染成 RGB 影像重新編碼,Mirage 則直接把靜態場景以 3D latent tokens 儲存,於潛在空間中完成讀取、去噪與更新,繞開了 RGB 來回轉換的開銷。

這個項目想解決的問題很明確:影片世界模型在長時間生成下,3D 快取會愈來愈大、速度愈來愈慢,但場景內容其實變化有限。 Mirage 把「場景記憶」與「生成流程」解耦,用一套 Initialize、Read、Denoise、Update 的記憶生命週期,讓模型在生成每個 chunk 時直接讀寫一份共享的潛在快取,省下重複編碼的成本。

依據官方項目頁公布的 World-R1 基準數據,Mirage 達到約 70.36 的 WorldScore 平均成績,生成速度達到 10.57 倍提升,3D 快取記憶體用量則降低約 55 倍。論文亦提供與 Spatia、Voyager、Gen3C、VMem 等四個基準的定性比較,覆蓋同一軌跡下的條件輸入結果。官方程式碼則標示為「Coming Soon」,目前較適合研究員先閱讀論文與項目頁示範影片。

這個項目特別適合研究影片世界模型、3D 場景理解或擴散模型加速的團隊與學生,亦可作為 generative world model 課程的延伸閱讀。 對一般讀者而言,它展示了把「記憶」留在潛在空間而不還原成像素,是兼顧一致性與效率的可行方向。

重點摘要:

  • 核心方法:以 3D latent tokens 儲存靜態場景,避免 RGB render-and-reencode。
  • 記憶生命週期:Initialize、Read、Denoise、Update 四個步驟跨 chunk 共享快取。
  • 效率數據:World-R1 上生成速度約 10.57 倍、3D 快取記憶體降約 55 倍、WorldScore 70.36。
  • 比較基準:Spatia、Voyager、Gen3C、VMem。
  • 目前狀態:論文已公開,程式碼尚未釋出。

GitHub: https://github.com/microsoft/LatentSpatialMemory

項目: https://microsoft.github.io/LatentSpatialMemory/

Categories: 開源, 模型, 框架

SWE-Explore-Bench:拆解編碼代理如何理解你的程式碼

這個基準將編碼代理的探索能力獨立評分,以 848 個真實議題為基礎,衡量代理能否在動手修改前找對行級上下文。

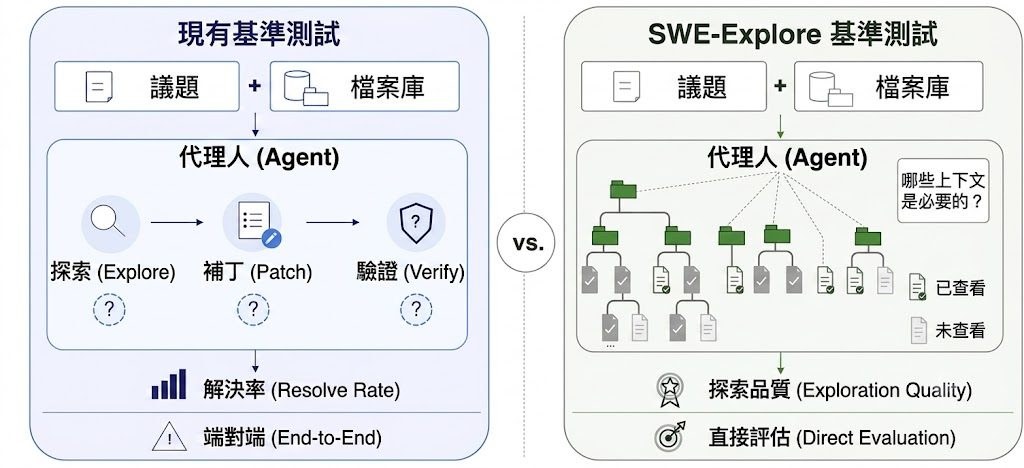
SWE-Explore evaluates repository exploration directly instead of only end-to-end repair.

SWE-Explore-Bench 由上海交通大學、香港中文大學等團隊推出,專門考核編碼代理在「真正落筆修改前」探索程式碼庫的表現。現有的 SWE-bench 等基準只給出最終通過與否的二元結果,難以分辨代理是因為找對位置而成功,還是碰巧蒙對。這個項目把探索這一步抽離出來單獨計分,更貼近診斷代理能力的本質。

具體做法是收集同一議題的多條成功修復軌跡,從中抽取代理實際讀取的程式碼行範圍,整合出共識的核心上下文,再保留部分模型獨有的可選上下文。代理需要輸出一份按行範圍排序的程式碼區域清單,評分涵蓋覆蓋率、排序品質、上下文效率,以及下游受限修補驗證四個維度。這種行級監督比傳統的檔案級定位更細緻,能揭示代理的真正瓶頸。

資料集涵蓋 10 種程式語言、203 個開源項目中的 848 個議題,並提供 OpenAI 相容的端點,方便接駁不同 LLM 進行行範圍精修。實測結果顯示,具備代理能力的探索器明顯領先傳統檢索器,現代方法在檔案層級已相當成熟,但行級覆蓋與高效排序仍是區分頂尖方案的分水嶺。

適合關注 SWE-agent、AutoCodeRover、OpenHands 等代理框架的研究者、開發者及基準設計者使用。對想了解自家代理「讀碼環節」強弱的團隊而言,這是一個值得放入評測管線的參考項目。

GitHub: https://github.com/Qiushao-E/SWE-Explore-Bench

Paper: https://arxiv.org/pdf/2606.07297

Categories: 開源, 香港中文大學, 框架, 編程

GENEB 統整基因組模型評測:跨 100 個任務的統一比較框架

GENEB 以 100 個分類任務、13 個功能類別,統一評比 40 個基因組基礎模型的表徵能力,揭露排行榜不穩定、規模效益有限等關鍵發現。

Repository image for darlednik/GENEB

基因組機器學習近十年快速擴張,但模型之間的比較長期處於碎片化狀態。DARLEDNIK/GENEB 正是針對這項痛點設計的統一評測基準,收錄 100 個分類任務、橫跨 13 個功能類別,並透過線性探測(linear probe)方式,在完整、10-shot 與 1-shot 三種情境下評估預訓練模型凍結後的表徵品質。

這個項目最大的特色是統一了過往各家模型各自為政的評測協議。你只需在 harness/extractors/ 撰寫一個小型 embedding extractor,就能用 run_GENEB.py 在固定的 GENEB 任務資料上產生提交檔,並由 CI 自動驗證後合併到排行榜。提交的模型權重並不儲存在儲存庫內,僅保留評測結果與模型卡片,設計上兼顧了可重現性與第三方權重規範。

它可以支援訓練後的評估,例如你訓練完不同 genomic foundation models,拿 GENEB 來比較它們在多任務、多類別上的表現。

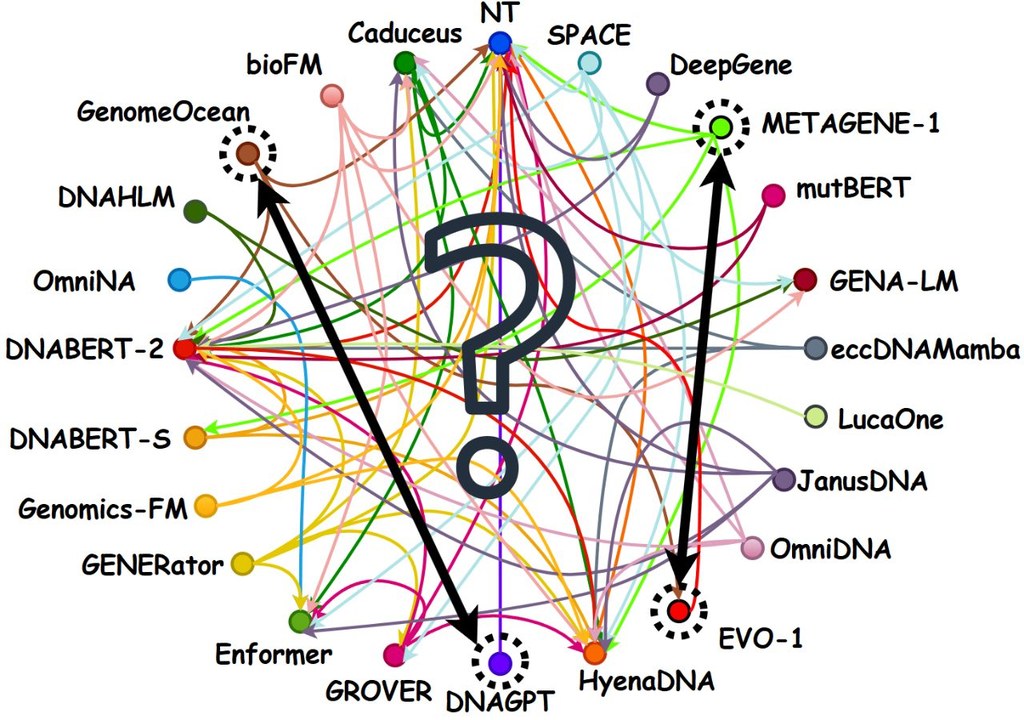
GENEB 對 40 個基因組基礎模型進行了系統性比較,包括 DNA-GPT、GENOMEOCEAN、EVO 等知名模型。研究發現,聚合排行榜其實相當不穩定:模型在不同任務類別的排名會大幅擺動,單一總分容易掩蓋細節差異。論文也指出,模型規模帶來的提升有限且不一致,架構與預訓練資料的對齊程度,往往比參數量更影響下游表現。這些結論對領域內「愈大愈好」的直覺提出了務實的提醒。

這個項目特別適合基因組學領域的研究者、模型開發者,以及需要為下游應用挑選合適表徵的工程團隊。對於想了解現有基因組模型相對強弱的人,Hugging Face Space 上的排行榜提供了 macro 分數與單任務分數兩種視角,方便依功能類別做選擇。

重點摘要

  • 涵蓋 100 個任務、13 個功能類別,並支援 full、10-shot、1-shot 三種評測設定。
  • 採用線性探測協議,統一比較 40 個基因組基礎模型的凍結表徵。
  • 透過 embedding extractor 介面與 CI 流程,確保新模型提交的可重現性。
  • 論文分析顯示聚合排行榜不穩定,模型排名隨任務類別大幅變動。
  • 規模效益有限,架構與預訓練對齊對表現的影響往往大於參數量。

GitHub: https://github.com/darlednik/GENEB

項目: https://huggingface.co/spaces/darlednik/geneb-leaderboard

Categories: 開源, 框架, Medical醫學

SoCRATES:量度 LLM 調解能力的新基準

SoCRATES 用真實衝突場景測試 LLM 調解表現,重點看它能否因應情緒、背景與互動變化作出介入。

Data Intelligence System Lab

SoCRATES 是一個用來評估 Large Language Models(LLMs)在社會衝突中擔任主動調解者的 benchmark。它關注的不是單次答題表現,而是調解過程:兩方在對話中情緒、意圖與情境會不斷改變,模型需要判斷何時介入,以及應該說甚麼,並且不能偏幫任何一方。

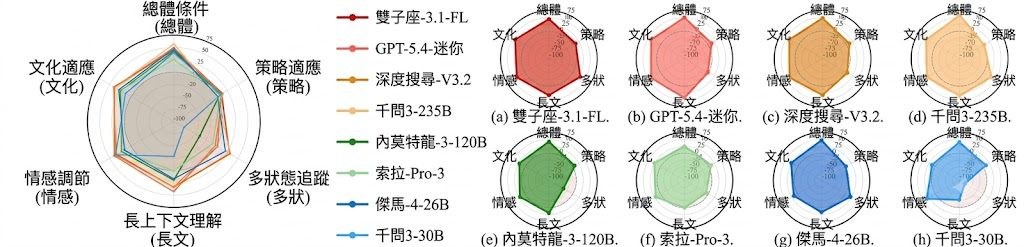
現有測試環境太單一,很多只涵蓋少量由專家撰寫的場景,或者把每一句對話都拿去對照所有議題評分,令結果混入不相關訊號。SoCRATES 則以 agentic pipeline 把真實公開爭議整理成場景,覆蓋八個衝突領域,並沿五條 socio-cognitive axes 測試模型在不同條件下的調整能力。

評分部分採用 topic-localized evaluator,只會在真正推進某個議題的回合上計分,並以三個 metrics 量度調解貢獻,減少離題內容影響結果。

  • 以真實公開衝突建立場景,不限單一領域
  • 測試 strategic posture、party composition、history length、emotional reactivity、cultural identity 五種變化
  • topic-localized evaluator 與人類專家的一致度達 0.82
  • 測試八個 frontier LLMs,最強模型亦只填補約三分一未調解時的共識落差

從目前結果看,SoCRATES 適合研究 LLM 調解能力、社會互動能力與多情境適應性的團隊使用,也適合用來比較不同模型在複雜對話任務中的穩定性。數據顯示,表現會因 socio-cognitive axis 明顯波動,說明這類項目的關鍵不只是語言生成,而是能否隨不同人、不同情緒與不同背景作出合適調整。

項目: https://disl-lab.github.io/SoCRATES/

Categories: 開源, 框架

PhaseLock:用兩步鎖住影片物理感

這項目用免訓練方法,改善影片生成中的不合理動作,同時盡量保留高畫質。

yonsei emblem

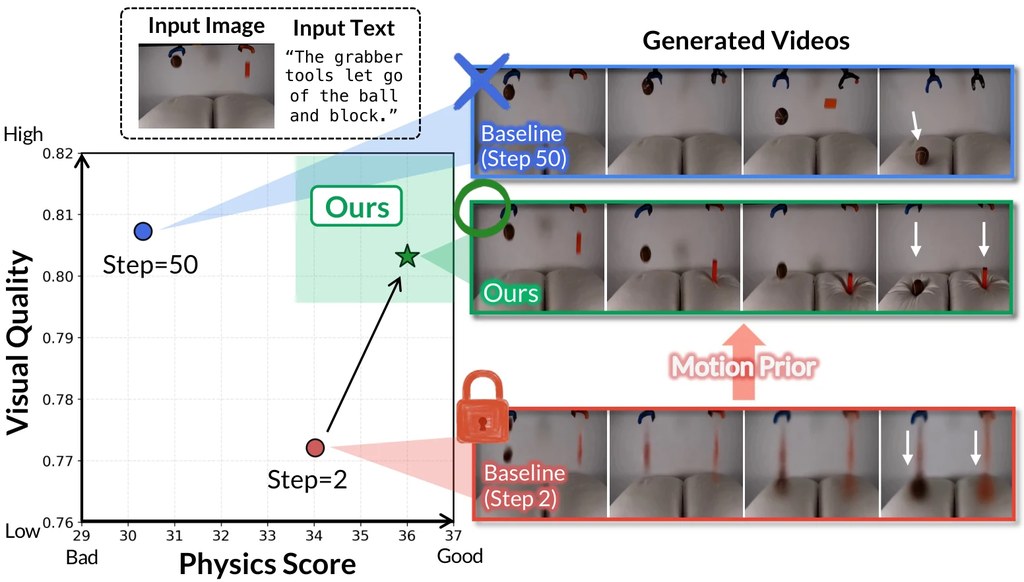
PhaseLock 是一個針對 Image-to-Video diffusion models 的方法,重點是修正影片生成中常見的物理錯誤。主要是針對 inference-time method / sampling strategy。模型在完整 50 步去噪時雖然畫面更細緻,但動作反而可能偏離物理規律;相對地,只做 2 步去噪時,動作先驗更可信,只是質感較粗糙。

項目的核心做法是兩階段流程,而且不需要額外訓練。它會先用 2 步去噪抽出 motion prior,文中以 Δ phys 表示,再在 50 步完整生成期間以 Latent Delta Guidance 重新注入,目標是在高保真畫面中保留較合理的動態結果。

例子很直觀,例如非磁性的網球不應被帶磁的籃子吸起。基線結果會產生違反常識的動作,PhaseLock 則較能維持物件應有的移動方式。這類情況很適合用於需要基本物理合理性的影片生成項目,例如物件互動、掉落、抓取或接觸場景。

重點可歸納為:
– 以 training-free 方式改善影片中的物理一致性
– 發現 2-step generation 的 physics 可能比 50-step output 更好
– 透過 Latent Delta Guidance 把早期 motion prior 鎖回最終結果
– 報告指出 physical consistency 平均提升 +6.2 points
– 額外成本相對有限,約 1.06× time1.02× memory

如果你本身已在用影片擴散模型,這個項目的使用概念不算複雜:先跑短步數結果取出動作訊號,再配合完整步數生成。從現有內容看,PhaseLock 的價值不在於更換主模型,而是在同一模型之上補回被後期去噪「磨走」的動作先驗。文中提到測試用的模型包括 Wan 2.1

GitHub: https://github.com/dnwjddl/phaselock

項目: https://dnwjddl.github.io/phaselock/

Categories: 開源, NVIDIA, Robotic, 框架

OmniDreams:NVidia 點樣重塑自駕模擬

OmniDreams把單張畫面、文字提示與地圖軌跡結合,實時生成多鏡頭擬真影片。這類 world model,正改變自動駕駛模擬的可擴展性。

Repository image for nv-tlabs/omni-dreams

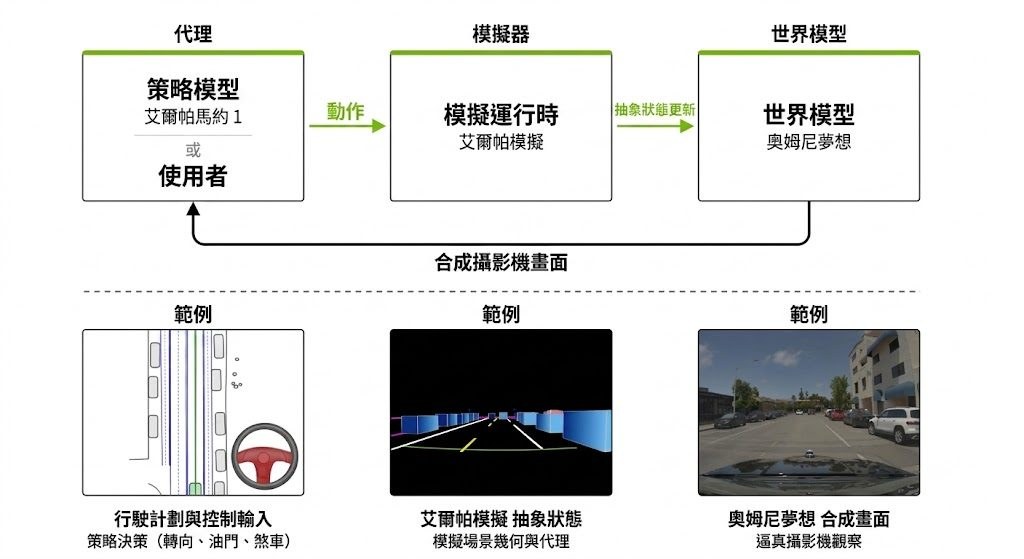
NVIDIA OmniDreams 是一個用於自動駕駛模擬的 world model,重點不在重播已錄好的路面片段,而是在系統提供條件後,持續生成多鏡頭、近乎寫實的影片畫面。它吃進一張真實 RGB 起始影像、文字提示,以及每幀的 coarse HD map image 和 trajectory poses,再以分段方式推進後續畫面。

這個項目想處理的核心問題,是傳統神經模擬器雖然可以很像真,但通常受限於原本拍到的資料,遇到少見天氣、突發交通行為或未見過的場景時,彈性不足。OmniDreams 走的是自回歸生成路線,會根據過往畫面、模擬器狀態與即時駕駛動作,繼續生成下一段感測畫面,較接近 closed-loop simulation 的需要。

從公開資料看,它的創新點在於把 Cosmos diffusion model 的視覺先驗,延伸成可即時反應動作的生成式 world model,並且支援 multi-camera photorealistic video。論文亦提到它曾在 21k 小時駕駛場景上做 mid-training 與 post-training,目標是覆蓋更多傳統模擬器難以刻畫的情境。

使用這個項目時,較適合把它視為研究與後訓練樣本發佈點;互動式推論與 live driving demo 則放在配套項目 FlashDreams。倉庫亦提供 post-training 樣本,圍繞 Cosmos2 SV-HDMap world model 微調,並提到 student-init、bidirectional teacher 與 self-forcing distillation 等訓練路線,但硬件門檻不低,官方列明最低為單個 8-GPU Ampere/Hopper 節點。

  • 可從單張真實畫面開始,生成連續多鏡頭影片
  • 輸入條件清晰,包括文字提示、HD map 與 trajectory poses
  • 重點場景是 closed-loop autonomous vehicle simulation
  • 相關模型與系統包括 Cosmos diffusion model、Cosmos2 SV-HDMap、FlashDreams、Alpamayo 1、AlpaSim、WAM
  • 論文初步結果指出,從 OmniDreams 後訓練出的 WAM 在 Physical AI Autonomous Vehicles NuRec 上表現不俗,且總參數量少於 VLA-based Alpamayo 1.5 的五分之一

整體來看,OmniDreams 不是一般開箱即用的消費級工具,而是面向自動駕駛研究、模擬平台與生成式 world model 開發流程的關鍵項目。對研究團隊、模擬系統工程師,或者想追蹤 NVIDIA 在 Physical AI 與 AV simulation 方向的人來說,這個項目很有參考價值。

GitHub: https://github.com/nv-tlabs/omni-dreams

項目: https://research.nvidia.com/labs/sil/projects/omnidreams-blog/

Categories: 開源, 世界模型, NVIDIA

Magenta RealTime 2:即時生成音樂的開放模型

DeepMind 為 Apple 帶來即時音樂生成的桌面創作流程。由模型、推論庫到 DAW 插件示例都已準備好。

Repository image for magenta/magenta-realtime

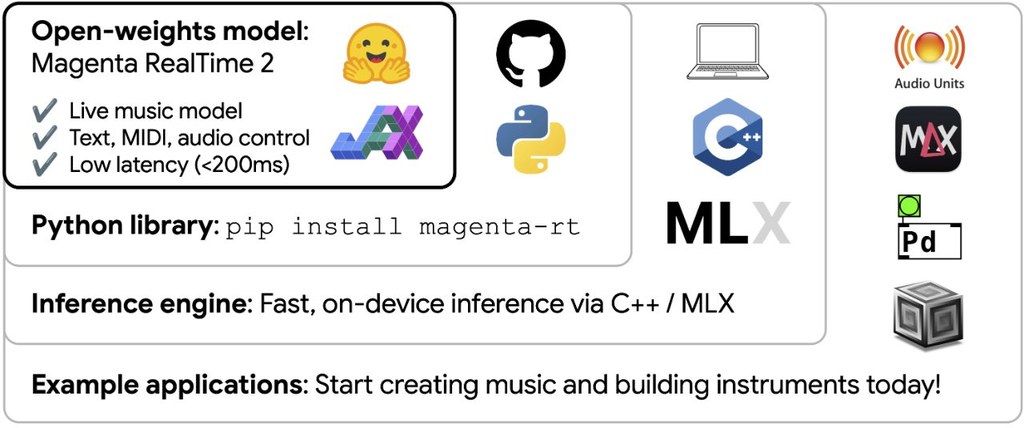
Magenta RealTime 2(MRT2)是個即時音樂生成的 open-weights model,重點不只是一個模型,還連同 Python 推論庫 magenta-rt、C++ 推論引擎 magentart::core,以及可直接延伸成應用程式的示例一併提供。對想將生成式音樂放入創作工具、互動程式或聲音實驗的人來說,這個項目比單純放出模型更完整。

不少音樂生成模型可以離線產出內容,但要做到邊播邊生成、能配合演奏或介面互動,系統延遲、串流效率與硬件限制都會變成關鍵。MRT2 直接針對 real-time streaming 設計,並且把 Apple Silicon MacBook 的串流音訊生成列為核心場景,令開發者較容易把模型接入 DAW、獨立 app 或其他音樂工具。

Magenta RealTime 2 可按需要選擇 Python 或 C++ 路線:想試模型行為,可用 magenta-rt 配合 JAX 或 MLX;想做較高效率的音訊串流,則可留意 magentart::core;要接近成品流程,儲存庫內亦有 AUv3 plugin、standalone macOS app、note control 與 prompt space 探索工具。這種由底層推論到示例應用都齊備的安排,對建立原型特別有幫助。

  • 提供兩個模型:mrt2_small(230M)與 mrt2_base(2.4B)
  • mrt2_small 可在多款 Apple Silicon Mac 即時運行,Air 系列亦可支援
  • mrt2_base 音質定位較高,但即時串流需 Pro Max 級別晶片
  • Python 路線支援 JAX、MLX,亦提到可在 NVIDIA GPU 做 offline inference
  • 內附 AUv3、standalone app 與互動示例,方便延伸成創作工具

性能資訊在這個項目中算是寫得具體:即時串流明確依賴 Apple Silicon(M 系列),而且不同晶片對 mrt2_base 的支援有清楚區分。從已公開資料看,mrt2_small 較適合大部分開發與測試場景,mrt2_base 則偏向追求更高品質、且手上有較高階 Mac 的用家。若你正在做音樂科技項目、DAW 擴充、互動聲音裝置,或者想研究生成模型如何接入即時工作流,這個項目相當值得留意。

GitHub: https://github.com/magenta/magenta-realtime

Categories: 開源, Google, 音樂, 蘋果

Page 52 of 90
1 50 51 52 53 54 90