Orchestra-o1:多智能體協作框架拆解複雜多模態任務

由香港中文大學等團隊研發的 Orchestra-o1 採用 MainAgent + SubAgent 架構,在 OmniGAIA 基準上以 72.8% 準確率領先對手 10.3 個百分點。

Orchestra-o1 Framework

Orchestra-o1 由香港中文大學(CUHK)計算機科學與工程學系的 Fan Zhang 領銜,聯同北京大學、清華大學、同濟大學及 LIGHTSPEED 團隊共同開發。模型權重同步開源於 Hugging Face。

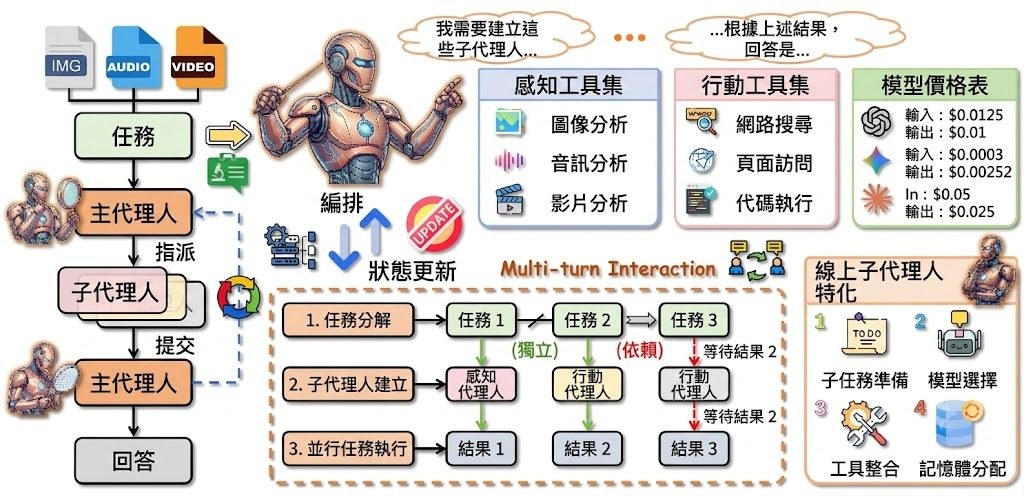
這個項目的定位是多智能體協作框架,針對文字、圖像、音訊、影片並存的「全模態」(omnimodal)場景,自動把複雜任務拆解成多個子任務,再分配給專責的 SubAgent 執行。MainAgent 負責規劃與協調,SubAgent 則配備搜尋、執行程式碼、影音分析等工具獨立運作,獨立子任務可同步執行以提升效率。

重點摘要:

  • 層級式架構:MainAgent 統籌拆解任務,SubAgent 各司其職,避免單一模型疲於應付多模態輸入。
  • 平行執行:無依賴的子任務同步進行,加快整體處理速度。
  • DA-GRPO 訓練法:以 Qwen3-8B 為基礎,搭配 Decision-Aligned Group Relative Policy Optimization 與 LLM-as-judge 獎勵機制微調。
  • OmniGAIA 表現:在 OmniGAIA 基準測試取得 72.8% 準確率,領先第二名 10.3 個百分點。
  • 開源生態:基於 Python 3.10+ 與 verl 框架,訓練需 8 張 H20 (96GB) GPU 單節點。

Orchestra-o1 的創新在於把「模態感知拆解」與「線上子智能體特化」結合,讓多模態協調不再依賴線性流程。適合需要處理多媒體資訊的研究團隊、Agent 開發者,以及關注 Computer-use agents(CUAs)與多模態模型應用的工程師。

效能方面,作者將 Orchestra-o1-8B 定位為同類開源全模態代理中最先進(SOTA),同時在商用模型(例如 GPT-5)推理腳本中亦提供整合,方便研究人員比較開源與閉源路線的差距。
GitHub: https://github.com/zfkarl/Orchestra-o1

Paper: https://arxiv.org/pdf/2606.13707

Categories: 開源, 香港中文大學, Agentic, 模型, 框架, OpenClaw, 深度學習

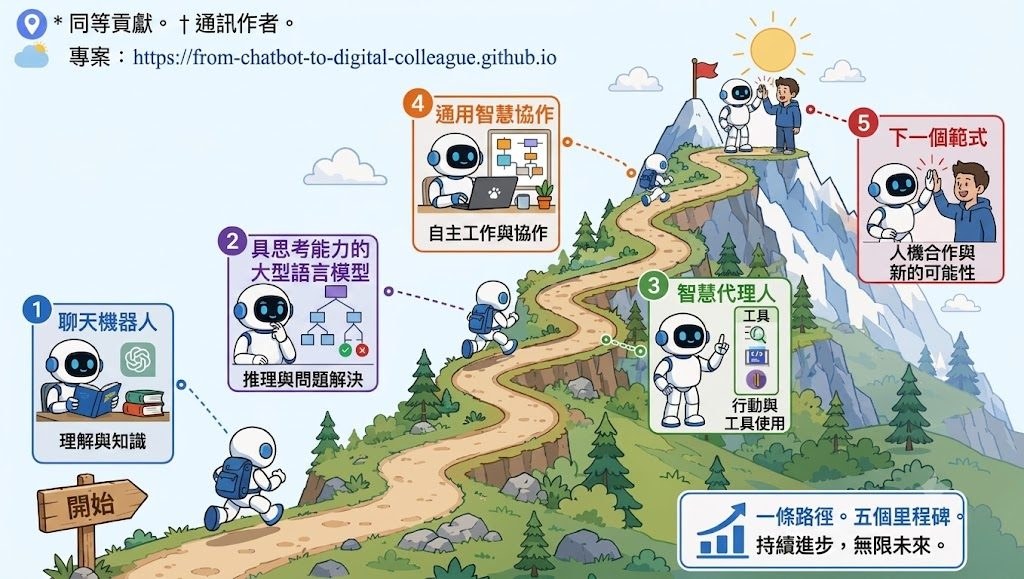
[技術文章] 從聊天機械人到數碼同事:AI 怎樣學會「持續工作」

一篇文章帶你了解 AI 從只懂回答問題,進化到能像同事般持續完成任務的關鍵轉變。

Hero image preview

這項文章由騰訊優圖實驗室、清華大學、中山大學、中南大學及伊利諾大學芝加哥分校的研究團隊共同撰寫,提出一個核心觀點:大語言模型(Large Language Models, LLMs)正從「聊天機械人」邁向「數碼同事」,關鍵差異在於能否持續完成工作,而非只給出對話式回應。

團隊將這個轉變拆成兩個互相牽引的維度。第一個是「認知核心」的進化:LLMs 從依賴下一個詞預測的「快思維」,走向會運用推理時間計算、長思維鏈(Chain-of-Thought)、反思及強化學習的「思考型 LLM」,讓推理過程更謹慎可靠。第二個是「工具輔助任務執行」的進化:從臨時呼叫外部工具的 Agent,走向類似 OpenClaw 風格的工作站系統,配備持久化的工作區(Workspace)、可重用的技能(Skill)、驗證迴圈及治理機制。

文章特別強調「Workspace + Skill」這個範式是關鍵躍升。它讓原本零散的工具操作,變成像同事般有狀態記憶、可重用流程、能完成任務並累積經驗的工作模式。數據結構也從簡單的指令—回應配對,演進為「狀態—動作—觀察」的軌跡記錄;評估方式則從靜態基準測試,轉向沙盒化、可審計、能自我進化的 AI 生態系統。

這份內容適合關注 AI Agent 發展、想了解 LLM 下一代形態的研究者與產品設計者。讀者可透過項目網站(from-chatbot-to-digital-colleague.github.io)取得完整論文與相關資源。

重點摘要:
– 由騰訊優圖實驗室主導,聯同清華、中山、中南及 UIC 共同研究
– 提出從「聊天機械人」到「數碼同事」的範式轉移
– 認知層面:從快思維走向推理驅動的「思考型 LLM」
– 執行層面:從臨時工具呼叫走向持久化 Workspace + Skill 系統
– 評估方式同步轉向沙盒化、可審計的 AI 生態系統

Paper: https://arxiv.org/pdf/2606.14502

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, 框架

VISTA 準確提升 GUI grounding

VISTA 不是通用聊天模型,而是用來訓練 GUI grounding 的方法。它針對畫面定位學習訊號不足的問題,效果有明顯提升。

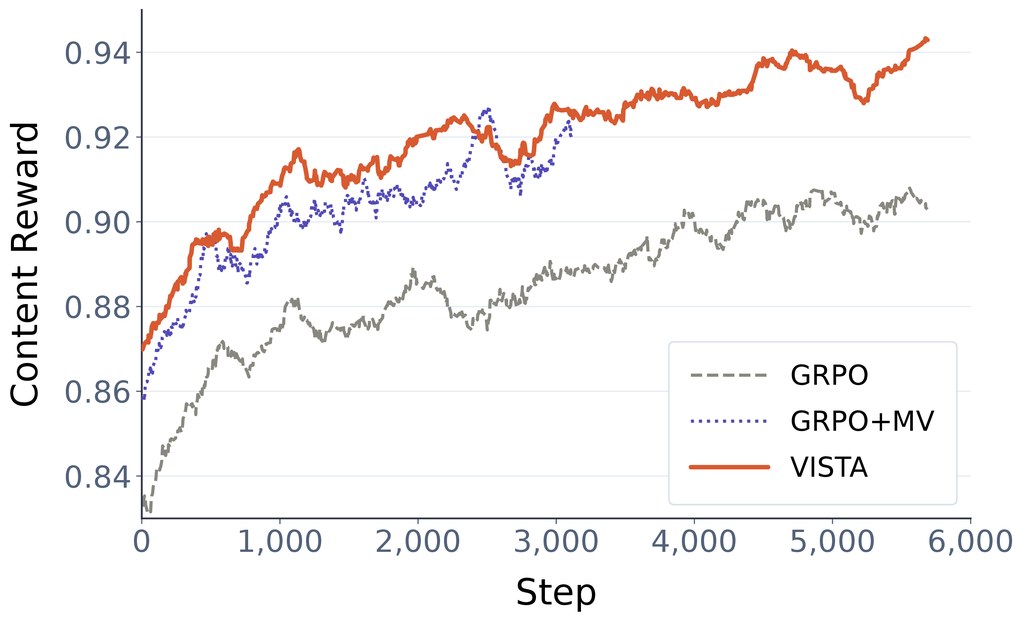
ScreenSpot-Pro accuracy curve

VISTA 是一個面向 GUI grounding 的訓練框架,核心目標是令模型更準確地在螢幕截圖中找出應該點擊的位置。它處理的不是一般文字理解,而是讓模型根據指令,在複雜介面上輸出座標,減少按錯按鈕、點錯輸入框這類問題。

這個項目的重點,在於它不是只從同一張截圖反覆抽樣,而是把同一個 GUI 畫面裁成多個仍保留目標元素的 view,再用這些 view 建立 GRPO 比較組。由於每個 crop 都會精確重映射座標,模型等於在語意相同、幾何位置不同的畫面上學習,能改善單一視角下「全部答錯」或「全部答中」而缺乏學習訊號的情況。

另一個關鍵設計是 self-verified cross-view anchor。它只會在目前 policy 已經產生 maximum-reward rollout 時,才加入 oracle coordinate,避免把訓練直接變成無條件模仿;這點對 GUI 座標生成尤其重要,因為短座標輸出很容易受微小偏差影響。從描述來看,這種做法比標準 GRPO 更重視穩定性,也更保留 reinforcement learning 的比較學習特性。

  • 這是一個訓練方法項目,不是最終應用程式,主要用來提升 GUI grounding 模型表現
  • 核心改動包括 view-consistent GRPO groups 與 self-verified cross-view anchor
  • 在 ScreenSpot-Pro 上,Qwen3-VL 4B/8B/30B-A3B 由 55.5/52.7/53.7 提升至 63.4/65.8/67.0
  • 以 Qwen3.5 初始化的 4B/9B/35B-A3B backbone,亦比 standard GRPO 再高 +2.0/+0.9/+1.2
  • 已公開相關模型包括 VISTA-4B、VISTA-9B

如果你本身有做 Computer-use agents(CUAs)、GUI 自動化、螢幕操作代理,這個項目特別值得留意。它較適合研究人員、模型工程師,或者正在調整 Qwen3-VL、Qwen3.5 視覺語言 backbone 的團隊;一般用家未必會直接部署這個項目,但可以把它視為提升介面定位能力的一套訓練方案。

就公開資料看,VISTA 的說服力主要來自基準分數與訓練動態變化:content reward、更高的 informative group ratio,以及 ScreenSpot-Pro 準確度同步上升。再加上論文提到五個 GUI-grounding benchmarks、較高 worst-view accuracy 和較低 prediction flip rates,整體判斷是:這個項目不是靠包裝取勝,而是針對 GUI grounding 訓練訊號退化問題,提出了相當對症的改法。

GitHub: https://github.com/ZJUSCL/VISTA

Paper: https://arxiv.org/pdf/2606.14579

Categories: 開源, 模型, 模型訓練, 框架

Surflo 用全域狀態重建一致 3D 表面

Surflo把多張未對位影像壓成固定狀態,再生成一致的3D表面。它兼顧彈性輸入與高解析輸出。

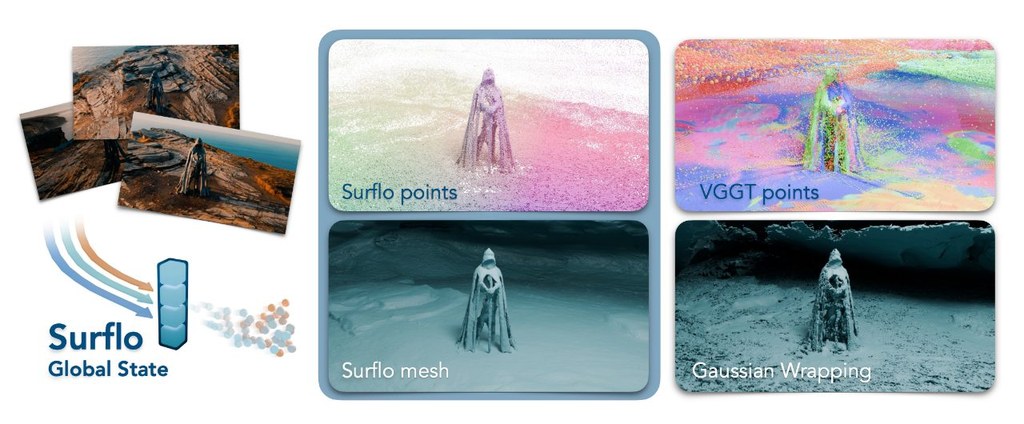
Surflo: a single coherent surface decoded from one global state

Surflo 是一個由多張未對位影像重建 3D 表面的項目。它先把數量可變的輸入視角整合成單一 global latent state,再用 flow-matching ODE 逐點生成表面,目標是避免傳統每個視角各自輸出、最後難以拼合的問題。

這個項目的核心做法,是把 N 張影像壓縮成固定大小的全域狀態 z,當中只有 K=128 tokens,之後再按需要解碼任意數量的表面點。因為每個點可獨立生成,同一次編碼之後便能輸出不同解析度,最高提到可處理 M up to 10^6 oriented points。

為了令獨立生成的點仍然保持同一個連貫表面,Surflo 加入 communication guidance 機制,利用 shared rendering loss 在 ODE 積分過程中協調鄰近點。系統會把點轉成 3D Gaussians,再用 Gaussian Splatting 渲染,藉此減少局部表面互相矛盾的情況。

Surflo: Consistent 3D Surface Flow from a Global State

重點項目:
– 支援 variable number of unposed images,不要求固定視角數量
– 以單一 global state 取代 per-view tokens 堆疊,控制表示大小
– 可按需要解碼任意表面解析度,不必重新編碼
– 在 8 個 benchmarks、2 到 32 views 條件下報稱達到 state of the art performance
– 另提供真實場景資料集,約 10.5K DL3DV scenes,包含 full scene meshes

這類項目較適合做多視角 3D 重建、場景數碼化,或者需要由少量到多量視角靈活輸入的研究工作。文中亦點名對比現代 feed-forward 3D 模型如 VGGT(https://huggingface.co/facebook/VGGT-1B)、DUSt3R、DepthAnything-3;若你關心的是如何由多張相片穩定得到同一個完整表面,Surflo 的全域狀態設計值得留意。

模型列表:VGGT(https://huggingface.co/facebook/VGGT-1B)、DUSt3R、DepthAnything-3。

項目: https://anttwo.github.io/surflo/

Categories: 開源, Agentic, 框架, 3D, Meta

graphify:把雜亂資料變成可查詢知識圖譜

graphify 是給 Claude Code 用的技能項目,會把多種格式內容整理成知識圖譜。對經常在文件、程式碼與截圖之間來回找資料的人特別有幫助。

Graphify

graphify 是一個給 AI coding assistant 用的 skill,能把你的 codebase、文件、PDF、圖片、影片轉成可查詢的 knowledge graph。

它支援多種 AI 工具與 IDE,包括 Claude Code、Codex、Cursor、Gemini CLI、OpenCode、OpenClaw 等。

它較有新意的地方,在於 fully multimodal 與持久化設計同時出現。graphify 會用 Claude vision 從圖片、白板相片、示意圖抽取概念,再跟文字與程式碼內容接起來;同時用 SHA256 cache 只重跑變更過的檔案,令更新流程不會每次由零開始。

Graphify: Turn Your Codebase into a Queryable Knowledge Graph for Claude Code
  • 支援 code、PDF、markdown、screenshots、diagrams、whiteboard photos 等多種輸入
  • 輸出不只一種,包含互動圖譜、Obsidian vault、wiki 頁面與報告檔
  • 官方描述提到每次查詢可比直接讀原始檔案減少 71.5x tokens
  • 提供 --update--mode deep,適合持續整理變動中的資料集

這個項目較適合幾類人:長期維護大型 codebase 的開發者、要整理研究材料的人、會把文件與截圖混在一起存檔的知識工作者。若你的資料本來就很少、結構清楚,它的優勢未必會完全發揮;但對資訊來源分散、跨格式混雜的情境,graphify 顯得相當對症。

性能資料目前公開重點以 token 節省為主,屬於效率導向的訊號,不等於完整基準測試。相關技術與依賴可直接見到 Claude Code、Claude vision、Obsidian,以及知識圖譜輸出流程;若你想為 AI coding assistant 建立可追蹤、可累積的內容索引,這個項目有明顯可試價值。

支援工具表

工具 / 平台安裝或啟用指令
Claude Codegraphify install
CodeBuddygraphify install --platform codebuddy
Codexgraphify install --platform codex
OpenCodegraphify install --platform opencode
Kilo Codegraphify install --platform kilo
GitHub Copilot CLIgraphify install --platform copilot
VS Code Copilot Chatgraphify vscode install
Aidergraphify install --platform aider
OpenClawgraphify install --platform claw
Factory Droidgraphify install --platform droid
Traegraphify install --platform trae
Trae CNgraphify install --platform trae-cn
Gemini CLIgraphify install --platform gemini
Hermesgraphify install --platform hermes
Kimi Codegraphify install --platform kimi
Ampgraphify amp install
Kiro IDE/CLIgraphify kiro install
Pi coding agentgraphify install --platform pi
Cursorgraphify cursor install
Devin CLIgraphify devin install
Google Antigravitygraphify antigravity install

GitHub: https://github.com/safishamsi/graphify

Categories: 開源, Agentic, 框架

SpatialClaw:用程式碼推動空間推理代理

SpatialClaw把程式碼變成代理的動作介面,主攻複雜空間推理。它在20個基準上交出明顯領先的平均成績。

SpatialClaw logo

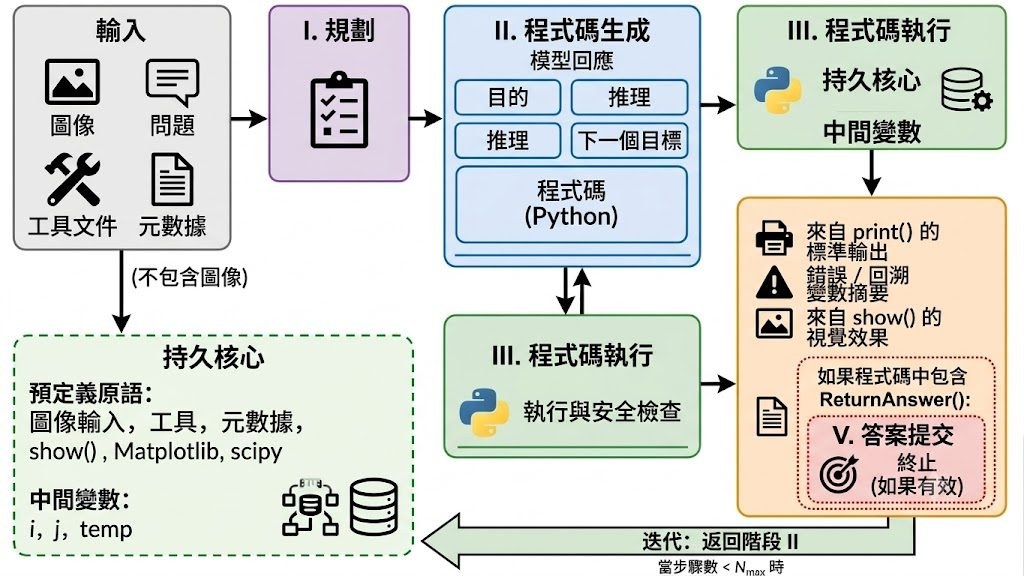
SpatialClaw 是一個免訓練的空間推理框架,重點不是再加更多工具,而是改寫代理如何調用工具。它把程式碼當成動作介面,讓 Vision-Language Model 代理逐步寫入 Python cell,在同一個持續運行的 Jupyter kernel 內查看中間結果、再調整下一步判斷,目標是處理 3D、4D 以及影片場景中的空間理解問題。

這個項目的新意,在於它避開單次執行整段程式或僵硬的 tool-call 方式。代理每次只提交一格程式,能結合 SAM3 segmentation、Depth-Anything-3 reconstruction、geometry utilities,以及 NumPy、SciPy、Matplotlib 這類科學運算庫,分析過程更像逐步查證,而不是一次過猜答案。

如果你想測試它,較合適的做法是用多視角圖片、影片片段,或需要判斷位置、距離、遮擋、移動關係的題目來跑。文件亦提到部署模型有明確硬件要求:FP8 版本需要 Linux 與 NVIDIA Hopper(H100)或更新 GPU;若手上是 A100 或 L40S,則可改用 models.json 內列出的 AWQ 或 GPTQ Int4 條目,並沿用相同 served_name,模型設定毋須重改。這也反映 NVIDIA 近年在 Robotic 與 World Model 相關項目上的投入相當積極。

成績方面,公開資料指出它在 20 個空間推理基準取得 59.9% 平均準確率,比先前最佳空間代理高 11.2 個百分點。更重要的是,這個結果據稱在相同 system prompt、工具組合與 hyperparameters 下完成,覆蓋六個 VLM 骨幹,代表它的提升未必只靠特定 benchmark 微調。

  • 屬於空間推理代理框架,解決 VLM 在 3D/4D 關係判斷上不夠靈活的問題
  • 核心方法是以程式碼作為動作介面,逐步執行與修正分析
  • 支援的感知模組包括 SAM3 segmentationDepth-Anything-3 reconstruction 與 geometry utilities
  • 公開結果涵蓋 20 個 benchmarks,平均準確率為 59.9%
  • 相關模型家族包括 Qwen3.5、Qwen3.6、Gemma4,規模由 26B 至 397B

這個項目特別適合研究 Computer-use agents、空間智能、機械人感知,或者想比較 tool-augmented agent 與 VLM 推理流程的人。若你關心的不是聊天表現,而是模型能否一步步觀察畫面、調工具、修正推論,SpatialClaw 展示了一條幾有說服力的路線。

GitHub: https://github.com/NVlabs/SpatialClaw

項目: https://spatialclaw.github.io/

Categories: 開源, Agentic, 模型, 視覺模型, NVIDIA

InterleaveThinker 多步生成變得可控

多代理圖像生成流程,重點不在畫得更靚,而是把多步圖文內容排得更準。它特別適合故事分鏡、教學指引與機械操作描述。

logo

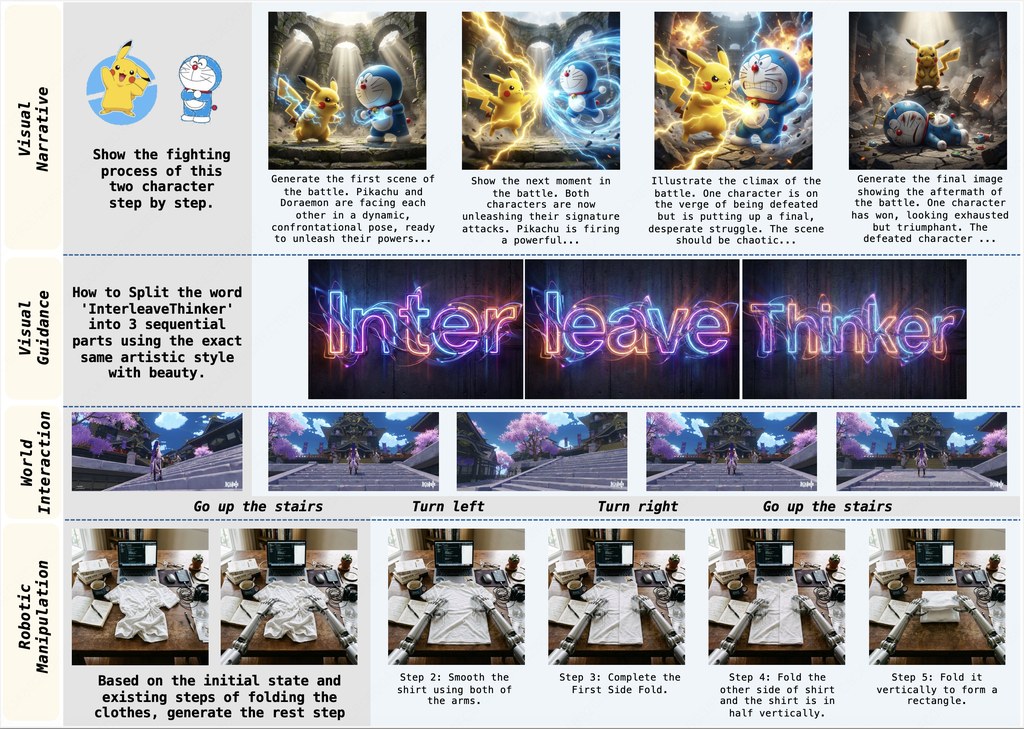
InterleaveThinker 是一個多代理生成流程工具,目標是替現有圖像生成器加入 interleaved generation 能力,即按步輸出文字與圖片交錯的內容。它想處理的,不是單張圖夠不夠精美,而是多個步驟之間是否連貫、是否跟指令一致。

這個項目的核心做法,是把工作拆成 planner agent 與 critic agent。前者先安排圖文序列和每一步任務,後者再檢查生成結果、有偏差就修正指令再生成,做法比單次提示更像一個會反覆校對的流程。

如果你想試它,方向很明確:先接上它已支援的生成器,再用多步任務測試,例如故事場景連續變化、視覺教學、摺衫步驟、角色互動或 embodied manipulation。儲存庫已列出多個可配合的模型端口,包括 Qwen-Image、Qwen-Image Lightning、FLUX.1-Krea-dev、Qwen-Image-Edit Lightning、FLUX.1-Kontext-dev Edit 與 FLUX.1-Fill-dev Fill。

公開資料顯示,它在 interleaved generation benchmark 的表現可與 Nano Banana 及 GPT-5 接近;在推理導向基準也有明顯提升,例如 WISE 由 0.47 升至 0.73,RISE 由 13.3 升至 28.9(4-step FLUX.2-klein)。這些數字反映它的價值主要在「多步一致性與修正能力」,不是單靠底層模型硬撐。

  • 重點不在訓練全新生成器,而是增強現有 image generator
  • 以 planner agent + critic agent 處理多步圖文任務
  • 適合 visual narratives、guidance、embodied manipulation、long-horizon sub-task annotation
  • 已公開相關模型:InterleaveThinker-Planner-8B、Critic-SFT-8B、InterleaveThinker-Critic-8B
  • 另有訓練資料集:Interleave-Planner-SFT-80k、Interleave-Critic-SFT-112k、Interleave-Critic-RL-13k

對研究圖文代理、工作流編排,或者想把現有出圖模型拉進多步任務的人,這個項目很有參考價值。若你只想單次生成一張圖,它未必是最直接的選擇;但若你要的是連續幾步都講得通、畫面不走樣,InterleaveThinker 的定位相當清楚。

GitHub: https://github.com/zhengdian1/InterleaveThinker

項目:https://zhengdian1.github.io/InterleaveThinker-proj/

Categories: 開源, 香港中文大學, 模型, 影像模型, 影像處理

WeaveBench:測試 CUA 真本事的基準

WeaveBench 不只是題庫,而是專門檢驗 Computer-use agents 能否跨 GUI 與 CLI 完成長流程工作的基準項目。

Click to watch: an agent managing a RabbitMQ dead-letter-queue topology end-to-end

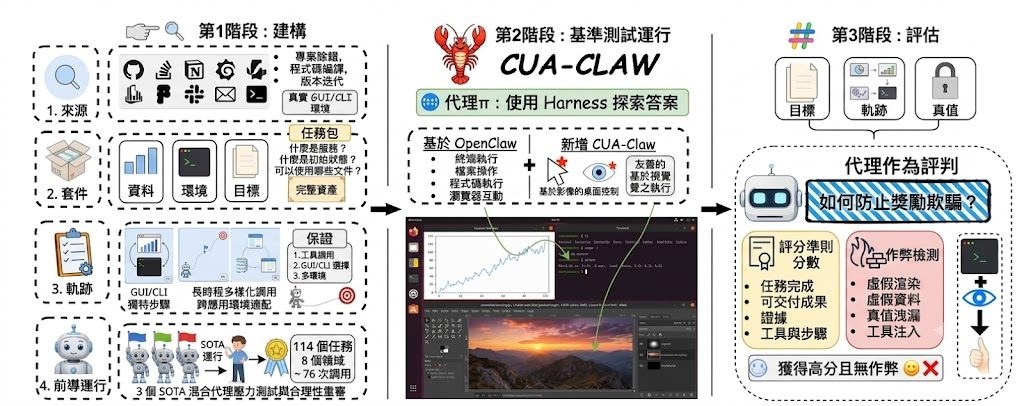
WeaveBench 是一個 benchmark 基準項目,聚焦測試 Computer-use agents(CUAs)在真實桌面環境中,能否把 GUI 點擊、shell 指令與程式碼編修串成同一條工作流程。它處理的不是單一步驟準確率,而是長流程、多介面協作這類更接近日常工作的問題。

這個項目的判分方式比常見的「有沒有生成某個檔案」嚴格得多。它使用 trajectory-aware Agent-as-Judge,會閱讀 chat trace、交付物,並按條款提供證據;論文亦指出,只看最終結果會高估代理表現,這點對研究 CUAs 的人很有參考價值。

如果想先了解它怎樣運作,可以先看離線 demo,直接觀察 score.json、judge model 回應和逐項證據,再決定是否下載完整資料集與 qcow2 執行環境。完整流程需要 Linux、KVM、Docker 及相當多記憶體與磁碟空間,較適合研究團隊、模型評測人員,或正在建構代理系統的工程師。

  • 114 個長流程任務,涵蓋 8 個工作領域
  • 每個任務都要求 GUI 與 CLI/code 交替操作
  • 最佳公開結果為 41.2% PassRate,顯示難度仍然很高
  • 提供 OSWorld hybrid-scoring experiment,可對照不同評分與執行框架
  • 資料集、runtime 與 qcow2 已放在 🤗 wanlilll/WeaveBench

相關模型與組合方面,公開結果包括 Claude Opus 4.7 + Claude Code、Claude Opus 4.7 + OpenClaw、GPT-5.5 + Codex CLI、GPT-5.5 + OpenClaw、GPT-5.4 + OpenClaw,以及 Gemini 3.1 Pro + OpenClaw。若你關心代理是否真的懂得跨介面完成工作,而不是只會在單一測試集刷分,這個項目很有研究價值。

GitHub: https://github.com/weavebench/WeaveBench

項目: https://weavebench.github.io/

Categories: 開源, 清華大學, 微軟, 框架

MoVerse 把單張相變成可遊走 3D 世界

MoVerse 想處理的,不只是補畫面,而是由一張相片生成可移動視角的 3D 場景。它把全景、3D 結構與影片細化拆開處理,方向相當清晰。

MoVerse

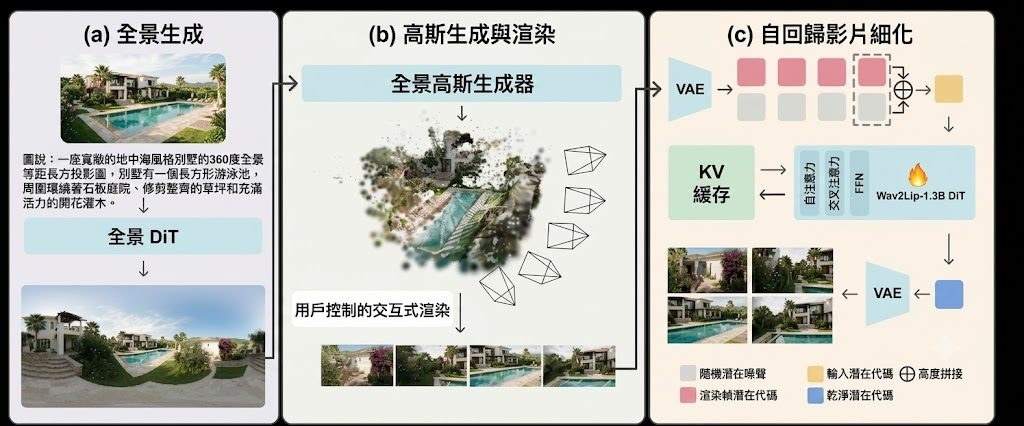
MoVerse 是一個偏研究型的方法項目,目標是把一張 narrow-field-of-view image 轉成可導航的 3D 世界,並輸出可互動影片。它想解決的問題,是單張相片通常只得一個視角,但很多生成系統一移動鏡頭就容易穿崩、閃爍,或者空間結構不連貫。

這個項目的核心做法分成三段:先由單張圖生成 360° ERP panorama,再建立 Panoramic 3D Gaussian Scaffold,最後用 Autoregressive Video Refinement 按指定鏡頭路徑補成寫實影片。把「世界建構」同「觀察畫面生成」分開,的確比直接由單張圖硬推整段漫遊影片更有條理,也較容易維持時間連續性。

如果你想了解它表現如何,現階段最合適是先看 Project Page 的示範影片、360 度瀏覽內容與 3D Gaussian scaffold 視覺化。原因很簡單:GitHub 頁面已說明程式碼與 pretrained models 仍在 corporate compliance and security review,中短期內較像一個可追蹤的研究項目,而不是即刻下載就能本地測試的工具。

從公開資料看,MoVerse 有幾個重點值得留意:
– 只需單張 NFOV image 作輸入
– 支援 user-controlled camera trajectories,自由漫遊場景
– 官方稱可在單張 RTX 4090 上做到 8 FPS
– 場景涵蓋室內、室外,以及較風格化畫面如 anime landscapes
– 相關方向可留意 PanoWorld 等世界模型研究

它較適合關注 Computer Vision、3D generation、video world modeling 的研究者與內容技術團隊參考,也適合想評估單圖建場景能力的人。若你要的是即裝即用生產工具,這個項目暫時未到那一步;但如果你在看新一代由 2D 走向可漫遊 3D 的生成路線,MoVerse 的方法、效能數字與分段式架構,都有相當高的參考價值。

GitHub: https://github.com/Orange-3DV-Team/MoVerse

項目: https://orange-3dv-team.github.io/MoVerse/

Categories: 開源, 世界模型

ARM:把生圖與修圖收進同一模型

ARM 用離散 visual tokens 統一理解、生成與編輯,RL 亦為修圖與生圖帶來量化提升。

Institute of Trustworthy Embodied AI logo

ARM 是一個 AutoRegressive Large Multimodal Model(ARM)類型的多模態模型,把圖像轉成離散 visual tokens,再以同一套 next-token prediction 處理理解、text-to-image 和指令式編輯,目標是把三種能力收進單一流程。

它的核心新意,是用 shared visual token space 連接看圖、生成與修圖,再以純 autoregressive multimodal modeling 處理交錯的文字與圖像 tokens。對一般讀者來說,可理解成「把圖片也變成語言模型可續寫的內容」。

• 7B 規模,重點在統一表示
• reinforcement learning(RL)結合 preference optimization
• WISE overall 由 0.50 升至 0.56
• GEdit-Bench-EN overall 由 5.75 升至 6.68

現階段較適合先讀論文和 benchmark。儲存庫節錄未見完整安裝、推理或權重說明,因此目前看來更像研究項目,不一定適合立即部署。

如果你關注 Large Multimodal Models(LMMs)、image editing,或想比較 unified autoregressive models,這個項目有參考價值。可對照的相關模型路線,包括 unified autoregressive models 與主流 image generation systems;論文亦提到它在 GenEval、DPG、WISE 具競爭力。

GitHub: https://github.com/wdrink/ARM

Paper: https://arxiv.org/pdf/2606.11188

Categories: 開源, 字節跳動, 模型, 影像處理, 框架

Page 50 of 90
1 48 49 50 51 52 90