PerceptionBench:Moonshot AI 教你測試 MLLM 視覺盲點

不少多模態模型答得似模似樣,但未必真係睇得準。PerceptionBench 把問題拆到最細,專門量度 MLLM 最基本的視覺感知能力。

kimi small

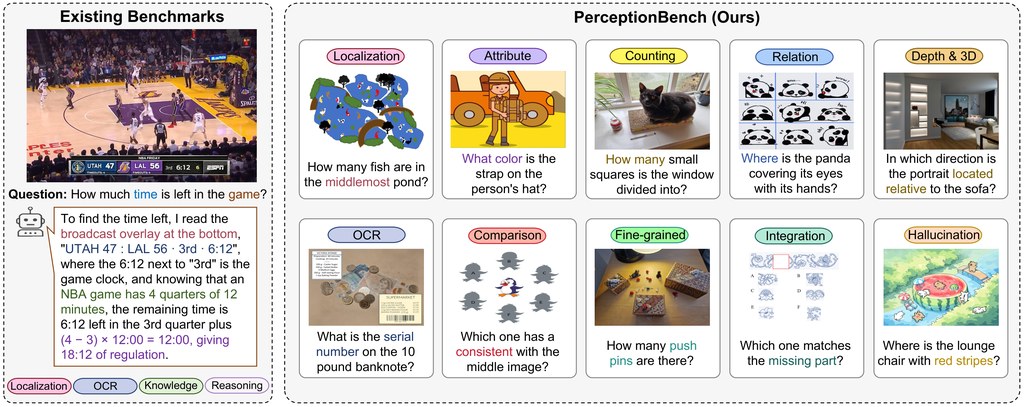
不少 Multimodal Large Language Models(MLLMs)表面上回答完整,但錯誤未必來自推理,往往早在「看圖」那一步已經出現。PerceptionBench 就是一個評測資料集兼 benchmark,專門把視覺感知拆成最細單元,檢查模型究竟係讀錯字、看漏關係,還是出現 perception-related hallucination(Hallu)。

它的價值,在於不再用一個總分掩蓋問題。團隊先分析 42 個現有 benchmarks 的失敗案例,再整理出一套錯誤分類,當中視覺感知分支包含十種 atomic perceptual capabilities,之後用這個框架建立 3,000 條經驗證題目,每題只測一種能力,答案亦刻意保持簡短而明確,盡量避免把推理或背景知識混入結果。

對做模型評估、資料標註或多模態產品調校的人來說,這個項目最有用的地方,是你可以更早定位問題源頭。它不是教你部署模型的工具,而是用來比較模型能力輪廓的尺;資料已放上 Hugging Face,程式碼亦公開,較適合拿來跑 benchmark、重現論文結果,或者把自家模型放入同一套題目做橫向比較。

  • 以 3,000 條 verified questions 測十種 atomic visual perception 能力
  • 題目刻意隔離單一能力,減少推理與知識干擾
  • 共評測 16 個 frontier MLLMs,使用統一 prompts
  • 沒有模型準確率超過 60%,Hallu 表現平均最弱
  • 相近總分之下,不同模型的能力分佈可以差很遠

所有題目都採用開放式短答案,再由 GPT-oss-120B 依參考答案判分,官方指它與人工審核在 300 個樣本上的一致率達 99.7%。這類設計未必等同真實產品場景,但很適合做能力層面的診斷;當你想知道模型到底「唔識答」還是「睇錯圖」,PerceptionBench 提供的資訊比一般綜合排行榜更有分析價值。
GitHub

Categories: 開源, 多模態模型, Dataset 數據集, Kimi

DeepSeek-V4-Flash-0731:輕量化 Agent 模型追上大模型

想要較少啟動參數,又保留強 Agent 表現,DeepSeek-V4-Flash-0731 就係呢類取向。它把重點放在工具調用、編碼同自動化任務,速度與能力之間取得幾實際的平衡。

Og image

要兼顧回應速度、部署成本同 Agentic 能力,DeepSeek-V4-Flash-0731 走的是「較少啟動參數換取高效任務表現」的路線。頁面已清楚寫明它與 DeepSeek-V4-Flash-DSpark 採用相同模型結構,並且附帶 speculative decoding module,所以它不只是一般聊天模型,而是明顯朝工具使用、自動化操作與程式任務優化的版本。

它屬於 DeepSeek-V4-Flash 官方正式發布版,取代 preview 版本,並強調 agentic capabilities 有明顯提升。模型卡同時指出它的模型結構與 DeepSeek-V4-Flash-DSpark 一致,代表推理流程很可能圍繞主模型加速草稿模組來設計。

效能數字是最值得留意的部分。它在 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon-Verified、Agents’ Last Exam、AutomationBench Public 等基準上,普遍明顯高於 DeepSeek-V4-Flash(Preview),部分項目亦超過 DeepSeek-V4-Pro(Preview)。這種進步集中在 terminal 操作、程式庫理解、資安演練、軟件修復同工具鏈任務,反映它更像為 Computer-use agents、程式代理與自動化流程而調整,而不只是追求一般問答分數。

  • 與 DeepSeek-V4-Flash-DSpark 同結構,並附帶 speculative decoding module
  • 官方正式版取代 preview,重點提升 agentic capabilities
  • 多個 Agent/編碼基準明顯優於 DeepSeek-V4-Flash(Preview)
  • 啟動參數較少,但表現可與部分強勢閉源模型接近

部署資訊方面,內容只提供一則討論帖,提到可用兩台 DGX Spark 配合 ghcr.io/bjk110/vllm-spark:unholy-fusion-prod-ready 作最少設定部署;但模型頁面片段未列出上下文長度、GGUF 格式量化檔、mmproj、檔案大小、chat template 注意事項或 v2 檔名變更,因此不能推斷 llama.cpp、Ollama、LM Studio 的支援細節,也不能提供 Q4_K_M 一類量化建議。現有資料較適合把它理解成一個偏向高效率 Agent 任務的 DeepSeek 模型發布,而不是本地 GGUF 部署導向的模型。

模型

Categories: 開源, Agentic, 模型, DeepSeek, LLaMa, Ollama

See2Think 驗證多模態模型有冇「睇圖再諗」

多模態模型會畫輔助線、標示區域,未必代表後續推理真係依賴咗呢些中間視覺狀態。See2Think想量度的,正正就是這段常被忽略的過程。

See2Think — Do Multimodal Models Really Use Intermediate Visual States?

見到模型會畫線、裁圖、標記物件,很多人自然會當它「有睇過先答」。See2Think屬於基準測試加診斷框架,焦點不是只看最後答啱幾多,而是拆開檢查中間視覺狀態有冇被真正用到、渲染是否忠實,以及後續推理有冇因此改變,這點對多模態模型(Multimodal Models)尤其關鍵。

它的核心設計分成兩部分:See2ThinkBench 收錄 1,200 條 visually dependent 問題,涵蓋 2D structured reasoning、3D scene reasoning 同 real-world visual reasoning;另一部分是 Visual Action-of-Thought(VAoT)流程,會把文字思路、structured visual actions、rendered states 同之後的推理串連起來。這種做法比單看 final-answer accuracy 更有診斷力,因為可以分辨模型是在「做出圖像」還是在「依賴圖像」。

同類研究常停留在結果分數,See2Think較著重受控比較。它設有 CoT、NoRender、Full、WrongRender 等 matched comparisons,又會檢查 render-benefit、corrupted-feedback sensitivity,以及 process judging 裡的 relevance、faithfulness、uptake,換句話說,不只問模型答得對不對,還會問中間那一步是否相關、是否被正確執行、以及模型有沒有吸收回來的視覺資訊。

  • 適合研究多模態推理、agent 行為分析、視覺工具鏈設計的團隊
  • 強項在於把「中間圖像是否有用」變成可觀察、可干預的測試問題
  • 覆蓋圖表、幾何、符號結構、3D 空間關係到真實圖片場景
  • GitHub 已公開程式與 quick start 線索,但論文仍標示為 coming soon,細部實驗設定仍要以後續正式文件核對

對模型評估要求較細緻的情境,這個項目很有參考價值;想拿它直接當應用工具就未必是同一回事。它更像研究型基礎設施,幫團隊判斷多模態系統的推理鏈是否可信,而不是單純追求更高答題分數。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 上海人工智慧實驗室, Agentic, 多模態模型, 3D, Dataset 數據集

OpenRSI 實現 AI 可控的自我進化流程

OpenRSI唔只放出模型,而係連訓練、任務、搜尋流程一併公開。對想研究 AI4AI 同 Machine Learning Engineering 的團隊來說,它更像一套可重跑的實驗場。

OpenRSI by Frontis

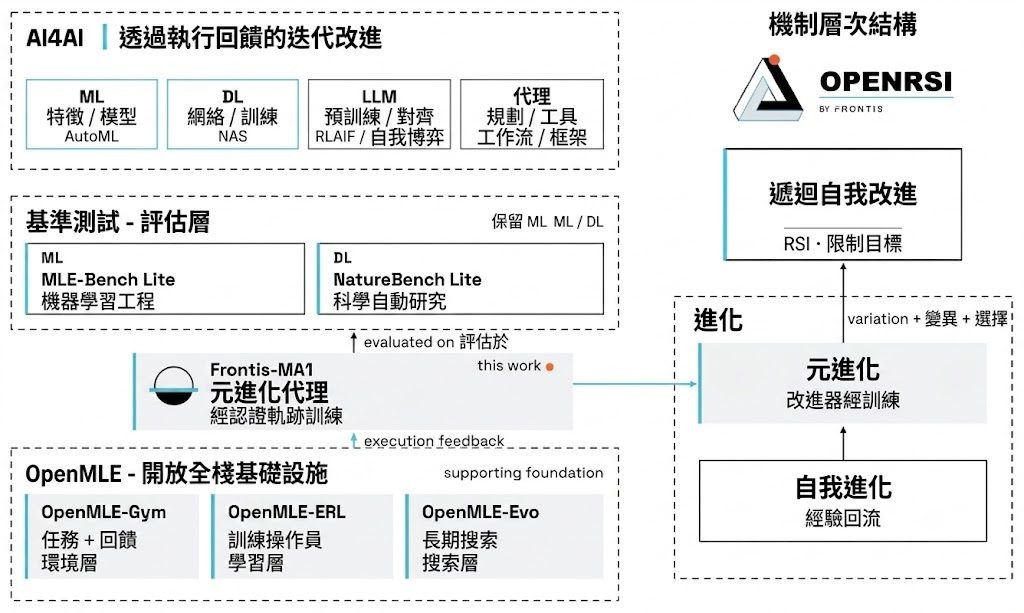
OpenRSI(Recursive Self-Improvement) 唔係單獨放出一個模型,而係把「AI improving AI」拆成可以執行、量度同重現的整套機械學習工程流程。它屬於開源研究框架加模型組合,核心想處理的是:點樣令 AI 不只寫程式,而係能夠持續改良建立 AI 的方法本身。

OpenRSI 由 OpenMLE 同 Frontis-MA1 連動組成。OpenMLE 負責提供可驗證任務環境、執行回饋、RL 與 evolutionary search;Frontis-MA1 則是一個 post-trained AI4AI model,圍繞 Draft、Improve、Debug、Crossover 四種程式演化操作運作,將訓練到的能力接到長步驟搜尋流程之中。呢種做法的取捨很明顯:它追求可重跑與可評測,所以系統較完整,也比只放模型權重的項目更講究環境與任務設計。

項目較適合研究 Agentic workflow、Machine Learning Engineering、自動化實驗搜尋,或者想分析 execution-grounded learning 點樣落地的團隊。資料已列出 Hugging Face 模型、GGUF 衍生版本、Tasks 同 SFT traces,亦有專屬 project page;但目前公開資訊著重系統構成與結果展示,README 摘錄未完整交代詳細安裝步驟,部署前仍要配合原始倉庫與外部連結自行核對。

  • OpenMLE 提供 gym、RL、Evo 等完整堆疊,不只是一組 benchmark
  • Frontis-MA1 把 operator learning 同 long-horizon search 接埋,重點在可執行研究循環
  • 公開內容包括模型、任務資料集、SFT traces,同時照顧訓練與評測重現
  • 提供 GGUF 格式在本地執行推理 的衍生版本,方便不同部署路線

效能方面,項目頁面列出 Frontis-MA1 在 MLE-Bench Lite 由 39.39 提升到 71.21,設定為每個 task 12 小時、單張 RTX 4090 並限制 12 GB VRAM,成績高於 GPT-5.5 + Codex。呢個結果反映它強項在於把執行回饋、後訓練同演化搜尋接成一個閉環;不過現階段它仍主要面向 Machine Learning Engineering,較像一個為 RSI 研究而建的開放實驗平台,而唔係通用型開發工具。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, Dataset 數據集

OpenRSI 想把 AI 研發流程變成可執行系統

OpenRSI唔只放出模型,而係連訓練、任務、搜尋流程一併公開。對想研究 AI4AI 同 Machine Learning Engineering 的團隊來說,它更像一套可重跑的實驗場。

OpenRSI by Frontis

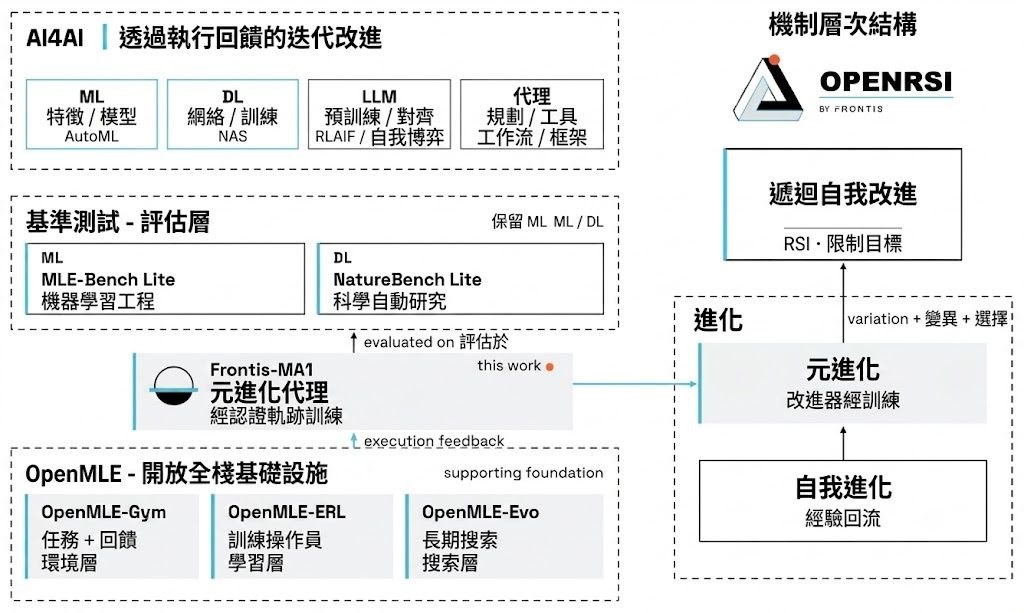
OpenRSI(Recursive Self-Improvement) 唔係單獨放出一個模型,而係把「AI improving AI」拆成可以執行、量度同重現的整套機械學習工程流程。它屬於開源研究框架加模型組合,核心想處理的是:點樣令 AI 不只寫程式,而係能夠持續改良建立 AI 的方法本身。

OpenRSI 由 OpenMLE 同 Frontis-MA1 連動組成。OpenMLE 負責提供可驗證任務環境、執行回饋、RL 與 evolutionary search;Frontis-MA1 則是一個 post-trained AI4AI model,圍繞 Draft、Improve、Debug、Crossover 四種程式演化操作運作,將訓練到的能力接到長步驟搜尋流程之中。呢種做法的取捨很明顯:它追求可重跑與可評測,所以系統較完整,也比只放模型權重的項目更講究環境與任務設計。

項目較適合研究 Agentic workflow、Machine Learning Engineering、自動化實驗搜尋,或者想分析 execution-grounded learning 點樣落地的團隊。資料已列出 Hugging Face 模型、GGUF 衍生版本、Tasks 同 SFT traces,亦有專屬 project page;但目前公開資訊著重系統構成與結果展示,README 摘錄未完整交代詳細安裝步驟,部署前仍要配合原始倉庫與外部連結自行核對。

  • OpenMLE 提供 gym、RL、Evo 等完整堆疊,不只是一組 benchmark
  • Frontis-MA1 把 operator learning 同 long-horizon search 接埋,重點在可執行研究循環
  • 公開內容包括模型、任務資料集、SFT traces,同時照顧訓練與評測重現
  • 提供 GGUF 格式在本地執行推理 的衍生版本,方便不同部署路線

效能方面,項目頁面列出 Frontis-MA1 在 MLE-Bench Lite 由 39.39 提升到 71.21,設定為每個 task 12 小時、單張 RTX 4090 並限制 12 GB VRAM,成績高於 GPT-5.5 + Codex。呢個結果反映它強項在於把執行回饋、後訓練同演化搜尋接成一個閉環;不過現階段它仍主要面向 Machine Learning Engineering,較像一個為 RSI 研究而建的開放實驗平台,而唔係通用型開發工具。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, Dataset 數據集

VideoCoCo 先用代碼演物理再出片

想要影片動得合理,又唔想一開始就靠像素生成碰運氣,VideoCoCo提供咗另一條路。它先把物理過程寫成可執行草稿,再交畀影像模型做寫實化。

cot paradigm

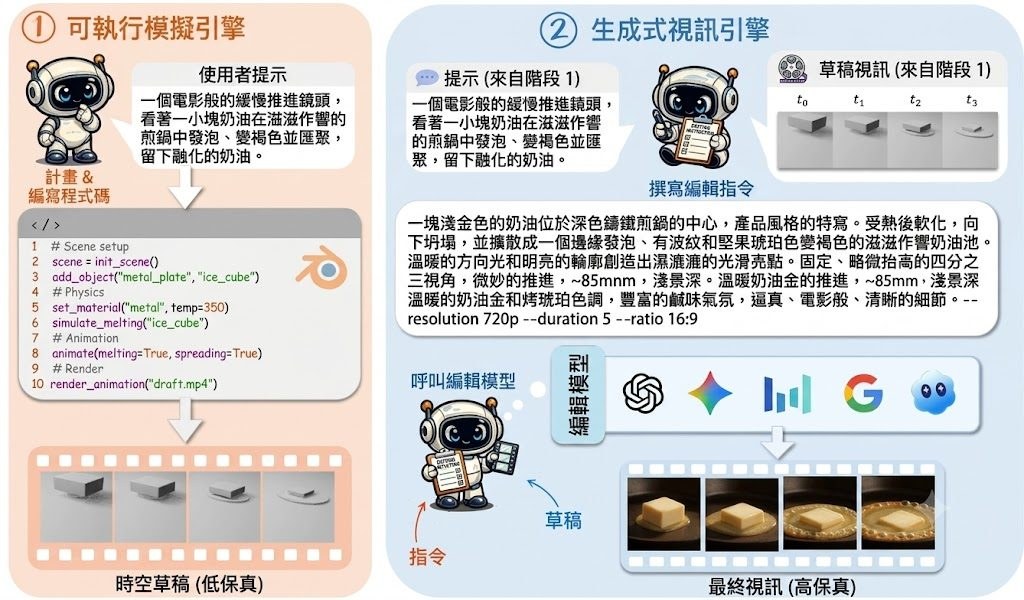
一段影片要做到「似真」並不只靠畫面細緻,動作因果同物理變化站唔站得住腳更關鍵。VideoCoCo屬於視頻生成管線,處理的正是這個問題:先用 code as a chain-of-thought 寫出物理草稿,再把中性白模影片轉成寫實結果,減少模型直接由像素猜測運動時常見的失真。

VideoCoCo 不是一步生成最終影片,而是先由 code agent 產生 Blender 可執行模擬,輸出灰白、近似 clay render 的 proxy video,讓形狀、透明度、變形、遮擋與運動先承載物理意義,之後再檢查這段草稿是否符合 physical plan,最後才用編輯指令把 proxy restyle 成 photorealistic video。這種雙階段流程換來較強的可控性,但也代表整體鏈路比單段式生成更長,對中間草稿品質有依賴。

目前 GitHub 已放出五個 Agent Skills、batch inference 腳本、對上游 OmniWeaving 的 patch,以及 Hugging Face 上的 tuned transformer;另有 8 組 hand-checked 的 video-to-video triplets 可用來理解資料格式與輸入輸出關係。README 停在 Inference 章節開頭,未見完整安裝與執行細節,所以現階段較適合把它視為可檢查流程設計與推理組件的研究型項目,而不是即裝即用的成品。

  • 先做物理草稿,再做寫實化,把運動因果同畫面風格拆開處理
  • 以 Blender 可執行代碼承載 process-level CoT,重點不在文字解釋,而在可驗證的模擬結果
  • toy dataset 只有 8 個案例,涵蓋 buoyancy、melting、surface tension、boiling 等現象,較像格式樣本
  • 已提供 tuned transformer、inference 腳本與 OmniWeaving patch,但公開資訊未足以完整重建部署流程

受益最大的會是研究 Agentic video generation、多步驟 controllable generation,或者想把物理先驗帶入視頻模型工作流的團隊。現有資料未見完整量化指標或大規模評測結果,優勢主要來自方法設計與中介表示的可檢查性;想判斷生成穩定度與泛化能力,仍要等更完整實驗或自行測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 視頻模型, Video, Dataset 數據集, Skill 技能

RefCaptioner:參考圖綁定對應影片字幕

RefCaptioner唔只寫影片字幕,仲會清楚標示句中描述對應邊張參考圖。對要處理多視角人物或混入干擾圖的情境,呢種做法實用得多。

RefCaptioner grounds local caption phrases to relevant reference images while rejecting distractors.

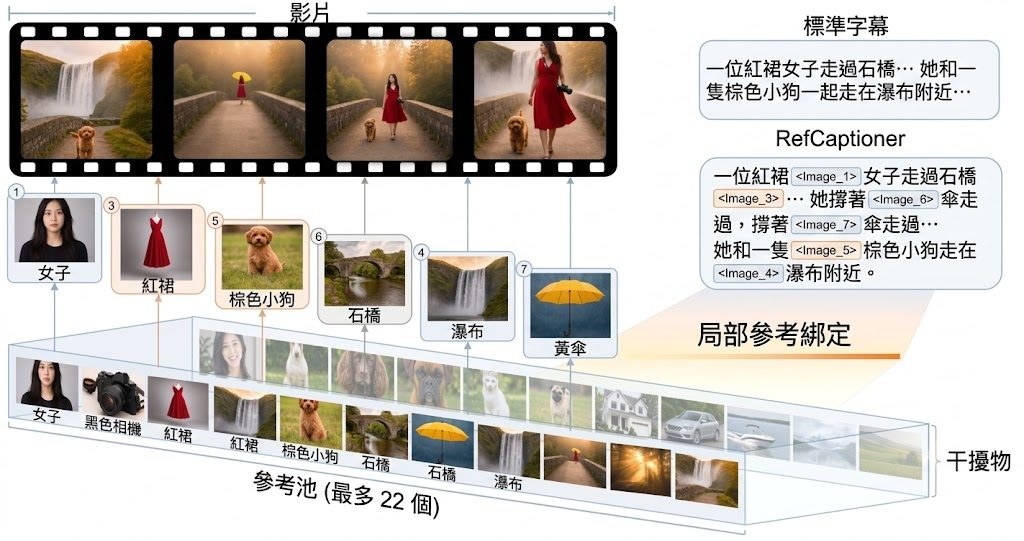
做影片描述時,最易出錯唔係句子寫得唔夠長,而係講到某個人、物件或角度時,無法交代文字究竟對應邊張參考圖。RefCaptioner屬於影片字幕生成模型項目,集中處理 multi-reference image-grounded video captioning:一邊保留細節與事實準確度,一邊將局部描述同候選參考圖明確綁定。

RefCaptioner 不只是把所有參考圖塞入輸出,而係會挑選真正有用的圖,將對應片語加上 <Image_N> 標籤,遇到同一主體的不同視角又會做分組,影片根本無出現的內容就直接略過。呢種設計減少錯配同誤導,比起只追求流暢字幕,更著重可核對性。

技術上,RefCaptioner用兩段式 post-training。先以 capability-preserving SFT 學會 grounded caption 格式,同時盡量保留一般 captioning 能力;之後再用 Hierarchical Coverage-Discounted GRPO(HCD-GRPO)同時優化 factual-caption 分支與 multi-reference grounding 分支,並加入 deterministic guards,避免產生格式錯誤或指向不存在圖片的標籤。

  • 提供官方 inference pipeline、SFT 資料準備、HCD-GRPO 訓練同 MRVBench evaluation pipeline
  • 已公開論文與模型權重,亦有 Data Format、Training、Evaluation 文件可跟進
  • 環境分成主環境與 GRPO 專用 veRL/vLLM 環境,代表訓練流程較完整但配置亦較講究
  • 適合做影片理解、資料標註、多鏡頭人物敘述同需要檢查圖文對應的研究團隊

部署與測試:推理、SFT、評估共用主環境,GRPO 另設一套環境,並且要對指定 veRL 版本套用 patch,反映佢較偏研究型工作流,而唔係下載即用的小工具。效能數字在提供的內容未見完整展開,但既然已附 MRVBench evaluation pipeline,至少表示作者有把「字幕寫得對」同「圖文對得準」分開檢驗,較適合重視可解釋輸出的團隊採用。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Video, Image, 影像模型

MPIE-Bench:多人修圖基準

多人影像編輯最易出事的,往往不是畫質,而是人物關係、肢體接觸同身份一致性。MPIE-Bench 把這些難題拆開量度,適合用來判斷模型到底可靠到哪一步。

apple pie icon

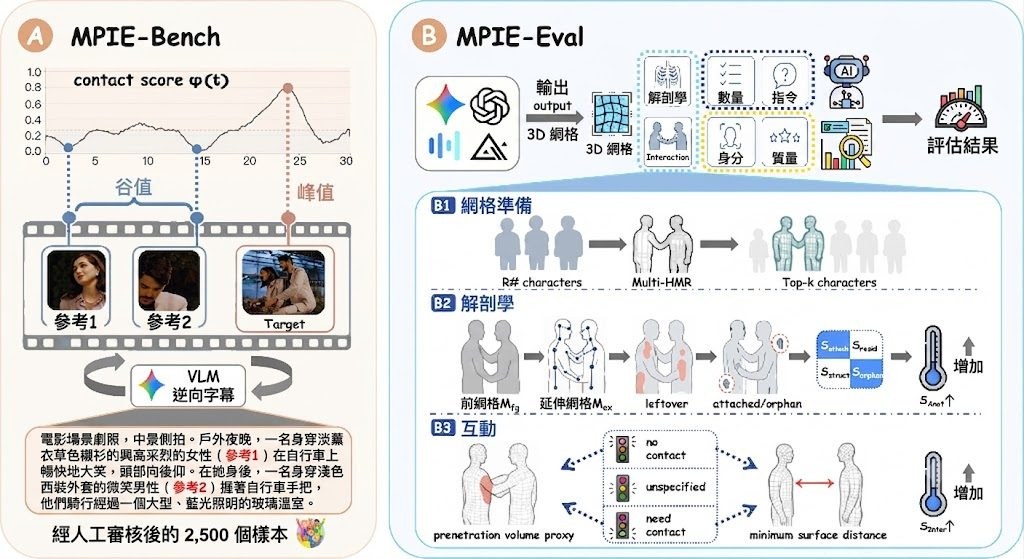
當多人影像編輯開始涉及互動動作、身體接觸,例如擁抱、攜帶或擒抱,同多角色參考圖,模型最常翻車的地方就不只是一張圖靚唔靚。MPIE-Bench 屬於基準測試資料集與評分工具,焦點是檢查編輯模型能否在跟從指令之餘,同時保住人物數量、身份一致性、肢體結構同互動幾何是否合理。

MPIE-Bench 不是再做一個生成模型,而是替多人編輯建立較完整的檢查方法。測試集有 2,500 個案例,並按接觸密度分成 C0 到 C3,意思是由沒有接觸到高密度接觸場景都會覆蓋;這種切法有助分辨模型是單純怕多人,還是特別怕擁抱、扶持、碰撞這類複雜互動。

評分設計亦有取向。六個軸線,除了身份、指令遵從、人物數量與整體畫質,亦把 anatomy 和 interaction 拉成重點,並用 mesh-anchored Anatomy / Interaction 來處理較難主觀判斷的部份。對研究團隊或做產品評測的人來說,這比只看美感分數更有參考價值,因為它直接對應多人編輯最容易出錯的位置。

  • 官方提供 2,500-sample test set、evaluation protocol 同 scoring code
  • 重點量度多人編輯中的身份保持、人物數量、動作互動同整體質素
  • 測試案例按接觸密度 C0–C3 分類,方便看清模型失誤模式
  • 可把模型輸出放到指定資料夾,再跑 E2E scorer 完成整體評分

部署資訊已有基本方向,安裝細節放在 docs/INSTALL.md,而且評分流程需要額外權重、環境設定,以及 AI_GATEWAY_URL、AI_GATEWAY_KEY 等配置;單靠儲存庫首頁未足以完整重現全部步驟。另有三個 closed-source baseline 的 frozen judgments,可作對照,但 open-source model dumps 沒有公開,這表示它更適合拿來評測自己的輸出,而不是直接比較所有現成模型結果。

對開發多人影像編輯、角色一致性編輯,或要驗證 VLM、影像生成模型在複雜人物互動表現的團隊來說,MPIE-Bench 的價值在於它把「多人」這件事拆成可追蹤的失敗類型。它未必能代替最終人工審美判斷,但很適合放進模型迭代流程,幫你更早發現哪些能力其實只在簡單場景先成立。

GitHub

Categories: 開源, 視覺模型, 影像處理

PALATE 改寫角色扮演 AI 才算演得好

現有角色扮演評測用固定對話歷史加統一評分尺,難以反映真實用戶體驗。PALATE 改為訓練專屬用戶模擬器並生成個人化評分準則,讓評估貼近每個用戶的真實感受。

Overview of the PALATE evaluation pipeline

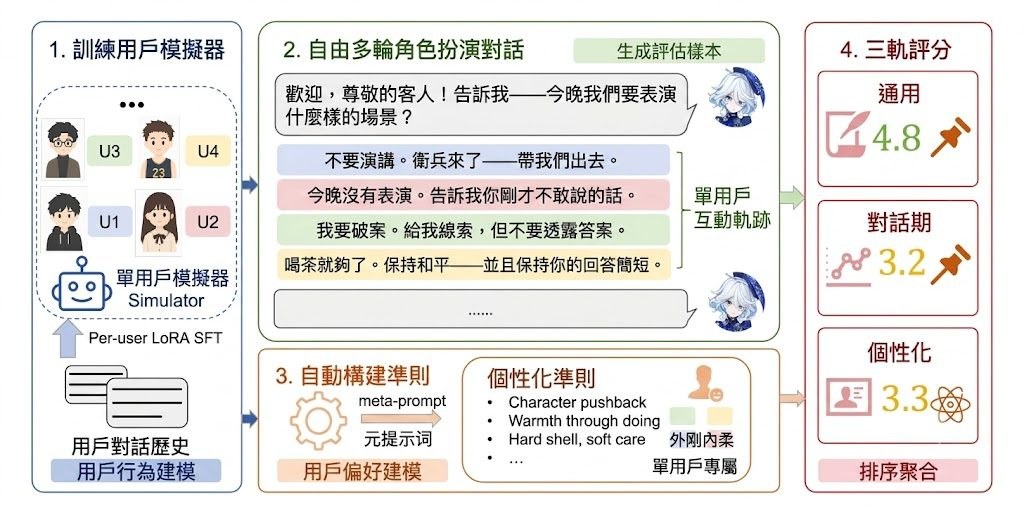
PALATE(Person-Aligned LLM-Simulated-User Assessment with Tailored Evaluation)的核心做法,是為每位參與者訓練一個專屬的 LoRA 用戶模擬器,讓模擬器和候選角色扮演 AI 自由多輪對話,再從該用戶的歷史數據自動生成一套個人化評分尺。評估拆成三條軌道:針對特定用戶–AI 配對的個人化體驗品質、跨用戶通用的回合級角色扮演品質,以及整個對話過程的連貫性與發展。

角色扮演 RPAs(Role-playing agents ) 的表現好不好,往往不只是模型本身的問題,而是和它對話的那個用戶決定。現有基準普遍要求模型接續一段預寫好的「借用對話」,再用統一的評分尺去評那段回應,結果把模型能力、前置對話品質、個人偏好混在一起打分。中國科技大學與 MetaStone 的團隊指出,這種做法忽略了用戶之間的巨大差異,也無法在真正的多輪場景下做科學評估。

團隊用 16 個候選系統生成 1,600 條獨立軌跡進行評測。個人化軌跡上,Qwen3-Max 領先;GPT-5.4 在通用軌跡表現最佳;Claude Sonnet 4.6 則主導會話軌跡。值得注意的是,沒有任何模型在所有五位用戶上都勝出,反映出個人化評測的必要性。個人化評分尺與人類判斷的一致性達到 0.613,高於通用評分尺。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 框架, 中國, Dataset 數據集

SpatialCLI 用空間工具補強視覺推理

模型唔係睇唔明圖,而係成日差半步先答得準。SpatialCLI 想補上的,正正係定位、分割、深度與姿態判斷呢類容易失手的細節。

A comparison between a general VLM and a general VLM augmented with SpatialCLI tools

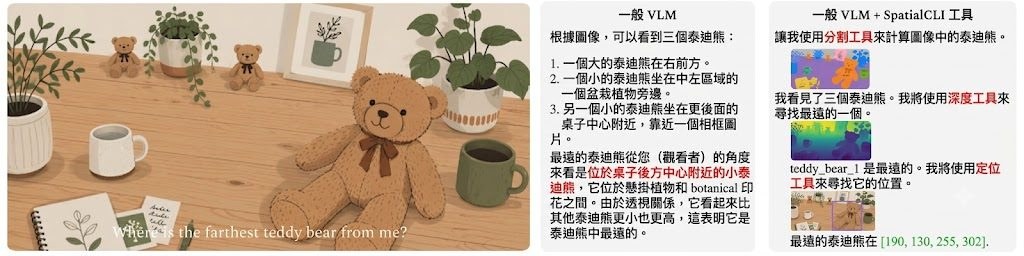
一到要指出物件位置、分清遮擋關係,或者估計深度與姿態,純 Vision-Language Model 往往會答到有方向但未夠準。SpatialCLI 把呢個落差處理得幾直接:它不是單靠一個大模型硬撐,而是把空間能力拆開,先讓模型懂得呼叫工具,再進一步把這些能力學回自己身上;整體定位更像一個結合模型、工具鏈與訓練方法的研究項目。

它最有意思的地方,在於三段式 Call-Learn-Internalize。第一步先接上做 localization、segmentation、metric depth、pose 的 specialist vision models,第二步用 Cold-Start SFT 與 agentic RL 訓練模型判斷幾時要用哪個工具、怎樣整合結果,第三步再把成功軌跡轉回模型能力。取向很清楚:寧願先借助外部工具拿到更可靠的局部感知,再追求把能力內化,減少每次推理都依賴外掛模組。

對研究團隊或做多模態 Agentic 工作流的人來說,這個項目值得留意,因為它同時放出 SpatialCLI code、SpatialCLI-8B 與 SpatialCLI-Data,不只是概念展示。理解它的部署方式也不難:代碼庫負責工具調用與訓練流程,Hugging Face 上的模型與資料集則對應推理、微調和重現實驗的核心材料;要完整驗證效果,通常要連同外部空間工具一併配置。

  • 類型上屬於模型加框架的研究項目,目的是提升多模態模型在空間推理上的準確度與工具使用能力。
  • 重點不只在「可呼叫工具」,而是進一步把工具使用經驗轉化成模型本身的能力。
  • 已公開論文、SpatialCLI-8B 與 SpatialCLI-Data,方便重現與延伸訓練。
  • 適合要處理定位、分割、深度、姿態等視覺任務的人員參考其工作流設計。

現有資訊未見 README 完整列出量化結果細節,但評測章節與 specialist models 章節已預留,顯示作者不是把它包裝成單一模型升級,而是把「何時調工具、如何學會不用工具也保留能力」當成核心問題。這種做法的代價也很明顯:系統整合與訓練鏈會比單純跑一個 VLM 複雜,不過換來的是更貼近真實空間任務的推理穩定性。

GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, 影像處理

Page 53 of 118
1 … 51 52 53 54 55 … 118