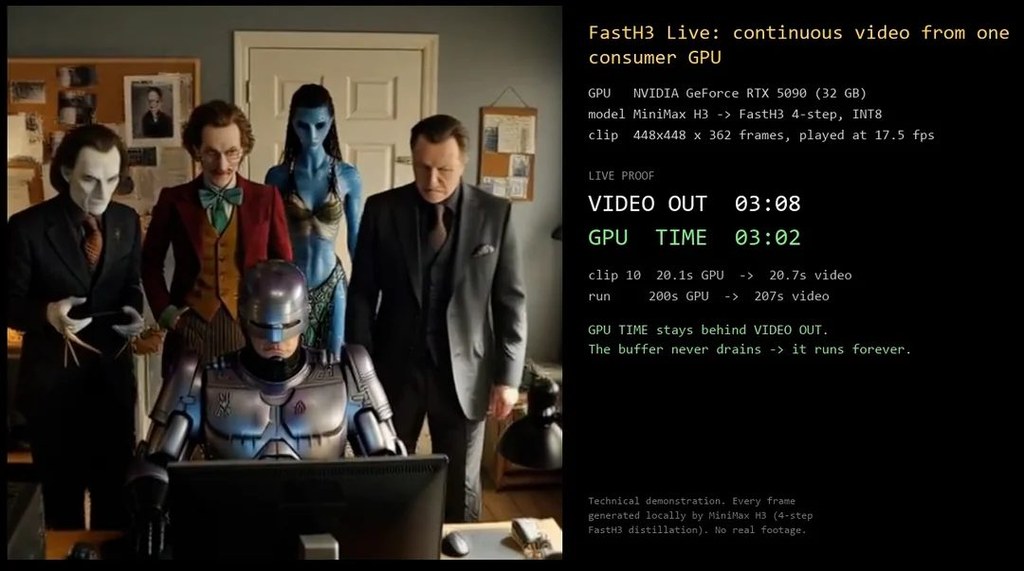
FastH3 Live:單張消費級 GPU 跑出無限 AI 直播

FastH3 Live 將 MiniMax-H3 蒸餾成 4 步模型,配合重定時與 ComfyUI 串流伺服器,用一張 RTX 5090 就能長開 448×448 18fps 嘅無限影片加音訊直播。

Hero image preview

喺消費級硬件上長開一段無止境嘅 AI 影片頻道,一直係文字轉視頻工作流嘅痛點——雲端成本高、本地生成速度慢,仲要面對提示詞同角色一致性嘅限制。FastH3 Live 就係圍繞呢個矛盾設計:佢將 MiniMax-H3 經過 4 步 DMD2 蒸餾成 FastH3,配合一套本地串流伺服器,令生成同播放可以同步進行,前一段影片播放期間,模型已經喺度產出下一段。

整個項目以 ComfyUI 作為運行環境,並喺單張 RTX 5090(32GB、Windows 11)上完成測試。v1.1.0 版本將解析度提升至 448×448、幀率達到 18fps,相比 v1.0.0 嘅 512×288 12fps 有明顯進步。音訊部分亦同步串流,用戶只要用 VLC 指向本地 URL,就可以一直接收新嘅短片,支援多位觀眾同時連線同斷線重連。

對於內容創作者、ComfyUI 用戶或者想試文字轉視頻嘅人來說,呢套工具最直接嘅吸引力係「無限直播」呢個使用場景。項目內附 321 個場景提示詞、503 個已驗證可用嘅角色清單,使用時可以快速組合出唔同長度嘅段落,唔需要每次由零開始寫 prompt。

需要注意嘅限制亦都幾清楚:相關權重屬於 MiniMax-H3 社群授權,適用範圍排除歐盟、英國、韓國同美國,下載前需要確認所在地。
項目主頁 · 數據集

Categories: 開源, ComfyUI, Agentic, 視頻模型, Video, Dataset 數據集, MiniMax

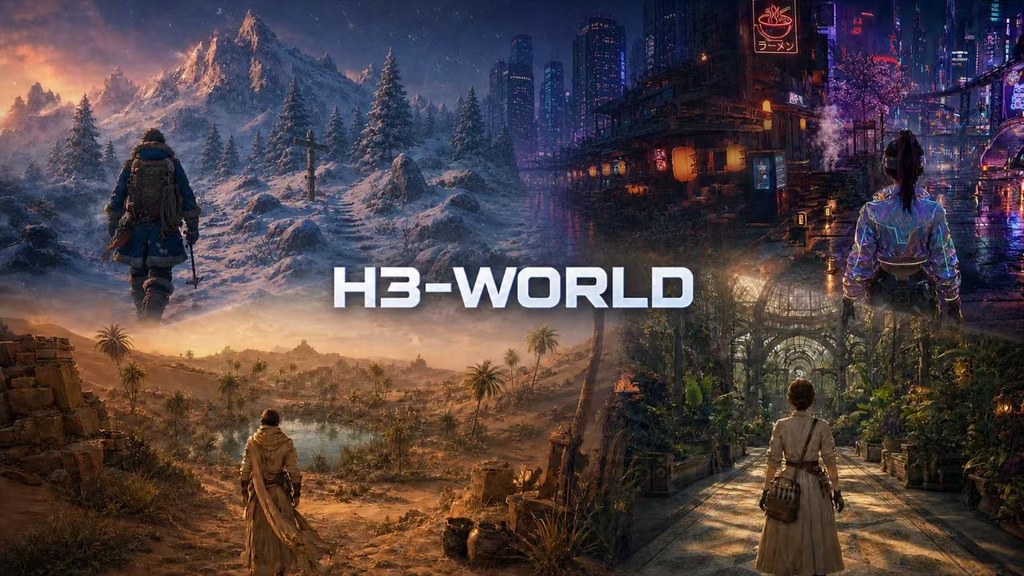
H3-World 讓鍵盤控制生成影片世界

H3-World把鍵盤輸入轉成可控制的未來畫面,展示互動式世界模型由理解指令走向操控環境。

Repository image for Danzer1xxxxChan/H3-World

按下 W、A、S、D 控制角色,或以 I、J、K、L 操控鏡頭,H3-World 便會由初始畫面生成相應的動作影片。這個項目屬於互動式世界模型,實際處理的是角色與鏡頭動作如何連貫地影響後續畫面,適合遊戲代理、視覺模擬及 Computer-use agents(CUAs)相關研究。

H3-World 建基於 MiniMax-H3,將每個鍵盤狀態轉換成對應未來 video latent 的語言指令,再透過 directed attention routing 把指令綁定到相應的 latent 區間。模型以 8,000 段 ABot-World-Explorer-500h gameplay clips 訓練,只學習 65.6M 個 Low-Rank Adaptation(LoRA)參數,約佔 33B backbone 的 0.199%,在保留大型模型能力與控制專用訓練成本之間取得折衷。

目前資料提供的重點包括:
– 角色控制使用 W、A、S、D;鏡頭控制使用 I、J、K、L,F 代表快速鏡頭移動。
– H3-World LoRA 是 MiniMax-H3 的 delta,不能直接套入未修改的 MiniMax-H3 pipeline。
– 推理需要約 135 GB 的 MiniMax-H3 base weights,以及 H3-World 的 directed-attention patch。
– 公開資料沒有列出明確的畫質、延遲或成功率比較,因此未能判斷它在不同世界模型之間的性能差距。

儲存庫提供 Python 3.10、CUDA 12.8、PyTorch 2.10.0 和指定版本 DiffSynth-Studio 的配置要求;模型權重及 LoRA checkpoint 則分別放在 Hugging Face 指定位置,訓練另需 ABot-World-Explorer-500h。研究團隊、遊戲代理開發者及需要可控影片生成的視覺模擬項目較容易受益,但硬件容量、專用 patch 和模型授權條款都是採用前必須核對的條件。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 多模態模型, 視頻模型, 模型訓練, NVIDIA, Video, Python, MiniMax

LayerRecall 讓長影片生成記得返之前嘅角色

長影片 AI 最怕隔咗一段就認唔返角色同場景,LayerRecall 用記憶路由加選擇性注入,只喺敏感層補返歷史 K/V,效果贏過 MemoBench 同 MovieBench。

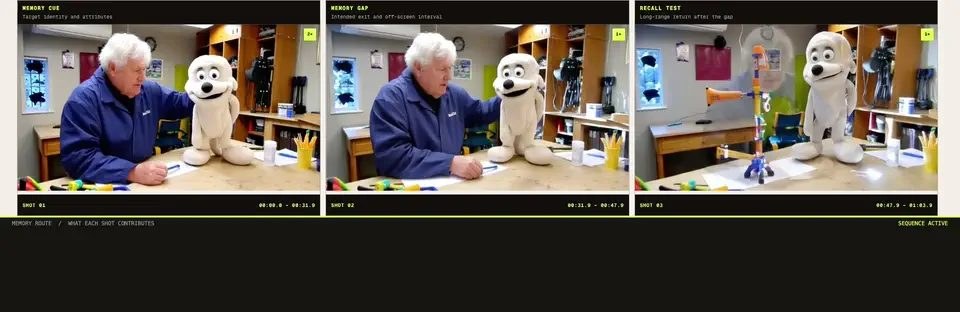
Memory Cue Recall animated preview

用 autoregressive 方式逐段砌長片,視窗一滑過去就會連角色同場景都一齊唔見——LayerRecall 就係針對呢個痛點。佢屬於記憶路由模組,唔係新模型,定位係加喺現有影片 DiT 上面做補強。當一段 chunk 入面出現需要回憶嘅元素(例如主角、服飾、場景)時,佢會用 current-conditioned 嘅方式去 historical candidate pool 做 cosine retrieval,搵到相關嘅 K/V state 之後再注入返去揀過嘅記憶敏感層,例如 4、9、10、12、13、15、16、17、18、26 等。其餘本地 attention 就照舊行,唔會因為補歷史資料而擾亂局部連貫性。

想理解點解要分層注入,研究發現唔同 layer 對「當下」「近期」「遠距」context 嘅依賑差好遠,所以亂餵歷史 token 反而會害咗本地一致性。配合嘅 KV cache budget 大約係 80 個 latent frames,本地 attention 32 幀,當中 8 幀做 sink、8 幀做 current chunk。訓練上仲用咗 Cross-Horizon Prediction Matching(CHPM),由一段長 context reference 喺 prediction space 監督呢個有界嘅 router,等佢喺稀缺長片數據下都學到幾時去 recall 乜嘢。

100 條多 shot prompt 評估入面,LayerRecall 喺 MemoBench 同 MovieBench 攞到最佳綜合結果,VBench-Long 維持返 backbone 水準,可見長距離回復做得好而本地連貫無受犧牲。論文仲展示咗 memory-guided self-correction,模型會主動糾正返之前嘅錯處。

重點摘要

  • 屬於記憶路由模組,設計上要喺現有影片 DiT 上加掛
  • 只喺 memory-sensitive 層注入歷史 K/V,其他層保持本地 attention
  • 訓練用 CHPM,用長 context reference 喺 prediction space 監督 router
  • MemoBench 同 MovieBench 綜合表現領先,VBench-Long 維持 backbone 水準
  • 適合做多鏡頭、跨時間角色同場景一致性嘅長影片生成工作

呢類工具對做長片創作、廣告分鏡或者角色需要反覆出場嘅團隊會幾實用;研究人員亦可以睇佢點樣將「selective injection」呢個取捨由啟發式變成可學習路由。

項目主頁 · GitHub

Categories: 開源, 香港大學, 視頻模型, 香港

四步生成同步音畫:FastH3 預覽模型拆解

非官放加速 MiniMax FastH3 以四次 Transformer forward 生成同步影片與音訊,但需要專用 VSA-H3 後端及多張高階 GPU。

Og image

文字提示輸入後,FastVideo-FastH3-4-step-Preview-v1-VSA-DataFree 可在四次 Transformer forward 內生成同步影片與音訊,適合測試快速 text-to-audio-video 工作流程。模型明確基於 MiniMaxAI/MiniMax-H3 微調及蒸餾,並以 data-free DMD2 和 VSA-H3 訓練至 step 1300,在 90% sparsity 下換取較少取樣步驟。

模型需要 FastVideo 的 VSA-H3 attention backend,不能只下載權重後以一般推論工具直接執行。官方測試配置使用四張 B200 GPU;其他多 GPU CUDA 系統可改用 Triton kernel,但 GPU 數量必須能整除 H3 的 56 個 attention heads。頁面沒有提供 llama.cpp、Ollama 或 LM Studio 支援,也沒有列出 GGUF 檔案、量化級別、檔案大小或 mmproj 附加檔案,因此不能據此建議 Q4_K_M 或其他量化方案。

  • 四次 forward 生成音訊與影片,速度取向明確
  • DMD2、VSA-H3 及 90% sparsity 用於 data-free 蒸餾
  • 目前只支援 text-to-audio-video,FL2VA 和 Ref2VA 尚未蒸餾
  • 困難動作、細節及部分音訊可能不及 MiniMax H3 base model
  • 頁面未提及 MTP draft speculation、v2 更新或檔名變更

這個 Preview checkpoint 仍可能在動態、細節和音訊穩定度上落後原始 MiniMax H3,定位較接近快速生成與研究測試版本。使用時要留意 MiniMax H3 Community License,以及 FastVideo 安裝流程對 CUDA 13、Blackwell 路徑和專用 kernel wheel 的要求。

模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, MiniMax

Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

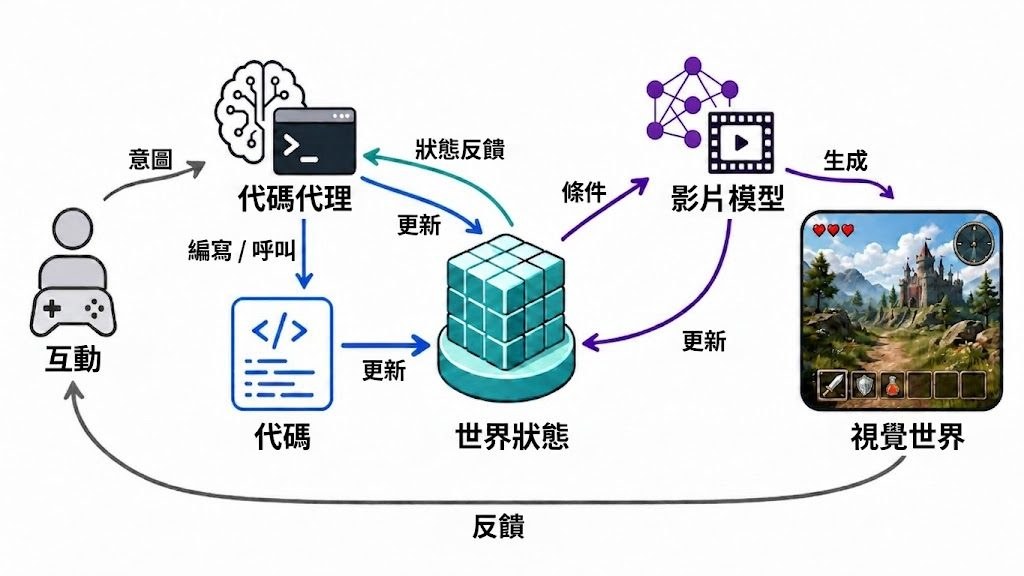
Pipeline of the proposed Code World Model

當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。

項目主頁 · Paper

Categories: 開源, Agentic, 視頻模型, 世界模型, 模型訓練, Video, 框架, Vibe Coding, 編程, AGI, 動畫, MiniMax

阿里巴巴 PAI 以 PDD 加速 MiniMax-H3 影片生成

阿里巴巴 PAI 團隊把 MiniMax-H3 變成少步數就能出片的版本。你可以把它理解成針對影片生成速度做加速的 LoRA。

Og image

阿里巴巴 PAI 團隊針對 MiniMax-H3 做了 Parallel Decoding Distillation(PDD),目標是用更少推理步數完成影片生成。這份項目同時保留 MiniMax-H3 的兩條路線,分別對應 FL2VA 和 Ref2VA,方便按不同基礎版本套用加速 LoRA。

兩個官方 8-step Acc LoRA,檔名分別是 MiniMax-H3-FL2VA-Acc-8Step.safetensors 和 MiniMax-H3-Ref2VA-Acc-8Step.safetensors,兩者都標示 rank=64、network_alpha=64,並以 BF16 形式提供。這表示它們不是完整底模,而是掛在對應 base model 上的加速適配器。

8-step Acc LoRA 可配合 768p 生成流程,並對比 baseline、Turbo 4-step 版本和 8-step Acc LoRA。

實務上,8-step Acc LoRA 代表在速度和畫面穩定度之間做取捨,重點是把影片生成的推理成本壓低,而不是追求最長流程。相較原始 MiniMax-H3,這類 LoRA 的用途更偏向快速出樣和迭代,適合需要較短等待時間的影片生成工作流。

  • 開發團隊是 Alibaba-PAI,並以 MiniMax-H3 做 PDD 加速
  • 提供兩個 8-step 官方 Acc LoRA,分別對應 FL2VA 和 Ref2VA
  • 檔案以 BF16、rank=64、network_alpha=64 方式發布
  • 頁面有 768p Demo,但未交代 GGUF、mmproj 或硬體需求

項目主頁 · 模型

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, 視頻模型, Video, MiniMax

MiniMax-H3 一次生成 120 秒長影片

它把單次輸出的 MiniMax-H3 變成可接續的長片段影片流程,連音效也一併處理。角色、服裝和道具都會沿鏡頭延續,減少畫面在鏡頭交界處走樣。

Og image

H3-LongVideos 針對的是 MiniMax-H3 在長片段生成時最容易出現的問題:每個 shot 各自生成,角色外觀、服裝和道具很容易在鏡頭交界處漂移。這個 ComfyUI 節點把一段文字拆成多個 beats,再把每個 beat 變成一個 shot,並以前一鏡最後一幀接到下一鏡,令整條影片可以維持連貫。

這個項目是基於 ComfyUI 的 H3 支援來做,不是獨立模型訓練;因此只能確認它面向 MiniMax-H3 工作流。它同時處理 FL2VA 與 REF2VA 兩種條件方式,前者用一幀作為鏡頭錨點,後者用參考圖描述角色外觀,方便同一角色在多個 shot 裡保持一致。

輸出最長可到約 120 秒,並提供 soundscape、latent 和 info 等輸出。soundscape 會帶出場景實際使用的環境聲床,latent 則是按時間軸串接的 sampled latents,但在多 shot 情況下,它不是 images 的等價 latent 版本,因為 trim_seam 和 handoff_offset 截的是已解碼影格,H3 又會壓縮時間,所以 seam 附近的畫面仍會存在;只有單 shot 時才會完全對齊。

有用的是工作流層面的控制:prompt 第一段做 anchor,後續段落一段對應一個 shot;character_memory 管角色和服裝;resolution 與 megapixels 分開控制形狀和尺寸;shot_seconds 是上限而不是固定長度,先用 plan_only 預覽拆鏡、時長和警告,會比直接渲染更穩陣。

  • 以 ComfyUI 把單次 shot 的 H3 生成改成多鏡頭串接,重點在長片段連貫性。
  • 同時處理角色、衣著、道具和旁白/環境聲,減少鏡頭切換時的漂移。
  • plan_only 可以先檢查拆鏡結果和警告,不用先燒算力。
  • 頁面沒有提供 GGUF、量化版本、base model 或推論框架清單。
  • latent 輸出只在單 shot 時可視作等價結果,多 shot 時要留意 seam 與時間壓縮。

項目主頁

Categories: 開源, ComfyUI, 視頻模型, Video, MiniMax

VA-Judger 生成更貼近人類偏好的影片與聲音

VA-Judger 以人類偏好比較影片和聲音生成結果,改善單靠獨立指標造成的失真與獎勵錯配。

VA-Judger training pipeline

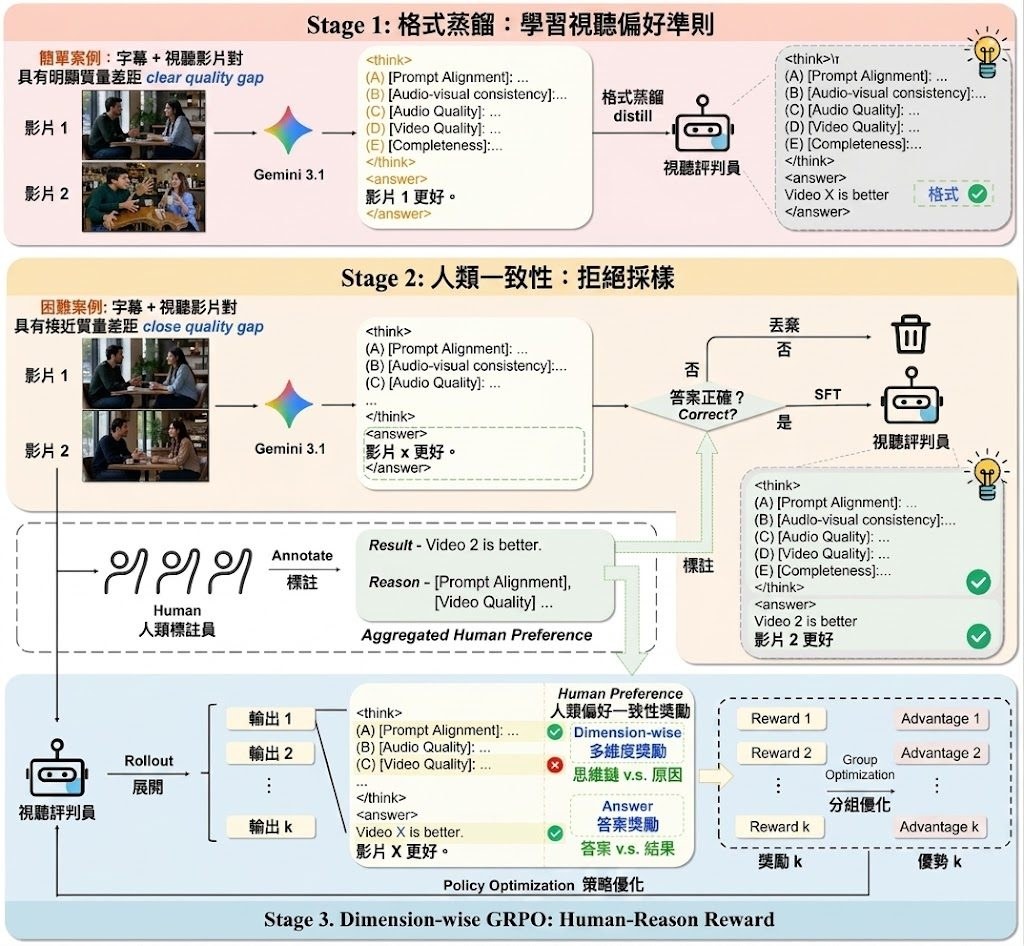
同一個提示詞產生兩段影音內容時,VA-Judger會比較哪一段更符合人類偏好,並拆解提示詞對齊、影音一致性、音質、畫質及內容完整度。它屬於聯合影片與音訊生成的 Reward Model,處理傳統指標難以捕捉整體連貫性的問題。

模型以 Qwen3-Omni 為基礎,先從品質差距明顯的配對學習比較準則,再透過拒絕採樣處理接近的結果,最後以 dimension-wise Group Relative Policy Optimization(GRPO)把人類回饋分配到不同品質維度。這比把音質、畫質及同步指標簡單相加更貼近觀看者的整體判斷,也減少生成模型鑽指標漏洞的機會。

VA-Judger-Bench包含同領域及跨領域模型比較,用來測試 Reward Model 是否能對齊人類選擇;研究結果指向它優於多項指標基線。VAPref-10K則包含9K提示詞及10.3K組細緻的影音配對比較,但資料集及部分訓練程式仍未發布。

項目提供 Reward Model 推理、Video Model 推理、模型 SFT,以及以 VA-Judger 分數優化 LTX-2 的流程;README亦列出合併已發布 RL LoRA 的 LTX-2 checkpoint。提供的資料沒有列出完整安裝步驟,使用者需要按項目頁面、checkpoint及程式碼狀態自行確認環境。

  • 適合場景:研究影音生成、偏好對齊及 RL post-training 的團隊
  • 可評估內容:提示詞對齊、影音一致性、音質、畫質及內容完整度
  • 主要取捨:比較人類偏好的方法較全面,但需要配對資料及額外訓練流程
  • 目前限制:dimension-wise GRPO 程式碼及 VAPref-10K 仍列為待發布項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 視頻模型, 模型訓練, Qwen, Video, LTX, Dataset 數據集

JoyAI-Echo: 拓展長音訊視訊生成技術

它把文字轉影片做成可跨鏡頭延續的音畫生成流程,重點不只是一段片,而是人物、聲音同場景連貫下去。ComfyUI 節點版本可配合官方推理管線,方便逐鏡調整。

JoyAI-Echo generated video gallery

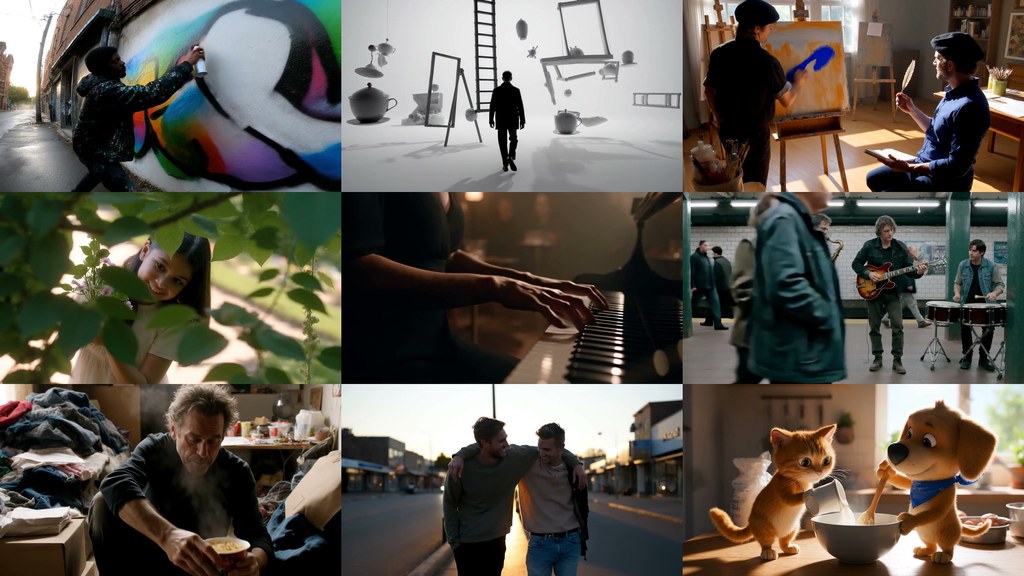
JoyAI-Echo 是一個面向 text-to-video(T2V)同多鏡頭長片段生成的模型項目,處理的是短提示詞難以撐住長篇敘事、角色外觀與聲音容易斷裂的問題。它的做法不是單段出片,而係用跨鏡頭 memory 去維持故事連貫,連動音畫一致性。

官方說明強調它走 full bf16 precision,唔採用 GGUF quantization,目標係貼近正式推理管線的輸出。現階段支援 T2V,同多鏡頭長視頻;image-to-video(I2V)未支援。另有 ComfyUI_JoyAI_Echo 節點包,適合想喺工作流入面逐鏡改 prompt、即時預覽、再串接後續鏡頭嘅人。

  • 可做長篇音畫故事,展示例子去到 10 分鐘
  • 支援少步數生成,長片與 causal world model 都偏向快速推理
  • cross-shot memory 會保留角色外觀、聲線同連貫性
  • ComfyUI 版本方便分鏡調整,同官方管線保持一致
  • 目前重點在 T2V,多鏡頭長片段,未覆蓋 I2V

它和一般單段影片模型最大分別,在於將「一段生成得像」推進到「多段接得住」。如果要放進實驗室、內容團隊,或者做互動世界、長敘事原型,這種可續接的記憶機制會比只看單次輸出更實用;但代價是對 GPU 記憶體要求高,官方節點提到 48GB VRAM 同 GPU memory hot-swap 才較穩陣。

項目主頁 · GitHub

Categories: 開源, ComfyUI, 多模態模型, 視頻模型, 世界模型, Video, Image, Audio

4DAnyone 把單鏡頭影片重建 4D 多視角

由一段普通單鏡頭人物影片開始,4DAnyone 生成具一致性的多視角影片,再交由 4DGS 重建可動人物。

4DAnyone

由未校準的 monocular video 出發,4DAnyone 可以為同一個人物生成多個目標視角,接着交給 4D Gaussian Splatting(4DGS)建立可渲染的 4D 人物。這個 GitHub 項目屬於 4D 人物重建工具,處理的是拍攝時沒有多部相機、相機內參或姿態資料,卻想取得多視角動態素材的問題。

它不只把畫面轉成另一個角度,而是嘗試維持不同視角之間的時間和外觀一致性,讓後續 4DGS 重建不必直接面對單鏡頭資料的視角缺口。相較於需要 rig、校準相機或固定三腳架的流程,這個方法換來的是對輸入影片質素和人物動作的依賴。

使用 inference.py 讀取影片,再以 views_per_layer、layer_pitches、start_yaw 和 yaw_span 控制相機層數、上下角度及水平覆蓋範圍。儲存庫提供 Python 3.11、requirements 和第三方 GVHMR 元件的安裝安排,缺少的模型及例子會在首次使用時自動取得;原始資料沒有交代硬件需求、推理時間或量化性能,因此不能把速度表現視為已被驗證。

  • 支援全身或上半身、畫面只包含一人的影片
  • 可生成 6、24、48 個或自訂數量的目標視角
  • 兼容輕微鏡頭移動,以及未知相機內參和姿態的素材
  • 可選 FlashAttention-3 或 SageAttention 加快推理

研究展示內容集中於不同人物影片、動作和場景的泛化能力。需要製作 4D 人物、研究自由視角影片,或建立動態人像資料的團隊;只想快速套用濾鏡或要求即時輸出的使用者,仍要先確認硬件、模型取得方式和影片條件是否符合要求。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 數字人, 視頻模型, Video, Python, 語音

Page 4 of 18
1 2 3 4 5 6 … 18