VideoChat3 一個睇得耐又睇得準的影片模型

要同一個模型同時處理細微動作、長片理解同直播回應,一向好難。VideoChat3 把重點放在時序理解同效率,定位相當清晰。

VideoChat3 logo

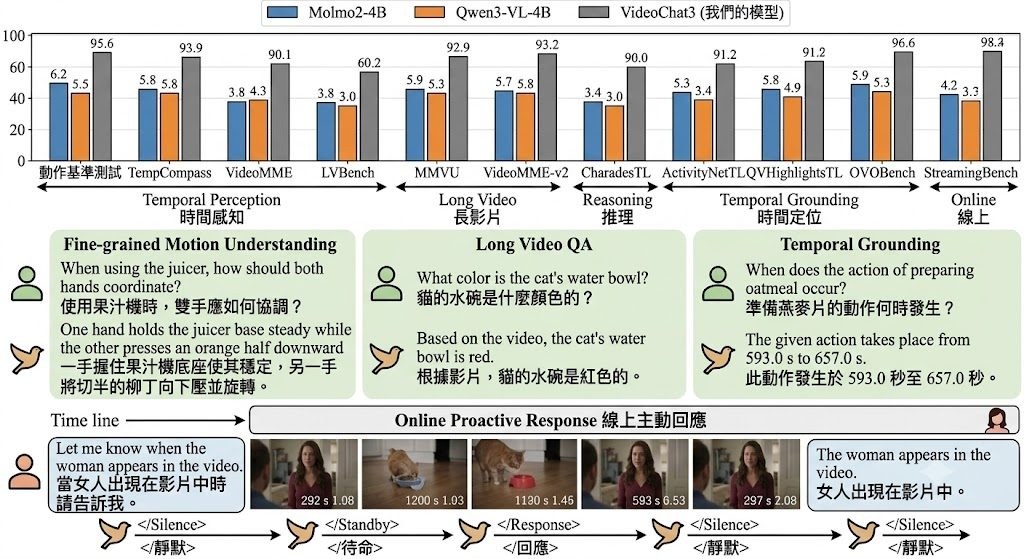
影片理解最麻煩的地方,往往唔係「識唔識睇」,而係要一邊保留動作細節,一邊捱得住長時間片段。VideoChat3 就係朝住呢個矛盾落手:它屬於多模態模型(Multimodal Large Language Model, MLLM),目標係用同一個 4B 模型處理細微動作、長片推理、temporal grounding 同 live streaming 回應。

同類項目好多時只會專注其中一段工作流,例如短片動作辨識,或者長片問答。VideoChat3 的取向係做 generalist video understanding,代價就唔係追求單一場景最極致的規格,而係用 I3D-ViT 同 Adaptive Frame Resolution 平衡 token 成本、時序證據同延遲,令模型唔需要全程用高成本方式讀完整段影片。

  • 重點唔只係睇單格畫面,而係保留跨時間的證據
  • I3D-ViT 提供 16× spatiotemporal compression,主打效率
  • Adaptive Frame Resolution 會按需要提高畫面解析度,較適合 streaming 場景
  • 已公開 model weights 同完整訓練數據,但 training code 仍未釋出

部署同測試的理解方式幾直接:現階段較接近研究釋出與模型體驗,適合先經 Hugging Face 取用 models & data,再按示範場景驗證長片問答、時間定位同串流回應表現。README 已列明完整訓練資料包括 Academic2M、LV116K、OL617K,對研究團隊、做 video agent、或者要建構影片檢索與監察流程的團隊最有參考價值。

公開資訊亦交代咗幾個關鍵數字:4B parameters、3M curated instruction samples、2,048 frames 下約 20.4s latency。呢啲數據未必代表所有環境都會有同樣效果,但至少講清楚它想證明的方向:唔靠超大模型,都可以把影片中的時間線索、事件關聯同即時反應放入同一套架構。相關模型與模組則以 VideoChat3、I3D-ViT、Adaptive Frame Resolution 為核心,整體更似一個面向研究與進階應用的開源影片理解項目。
項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, 模型, 視覺模型, 多模態模型, Video, 框架, 3D

KeyFrame-Compass:關鍵幀尺度評測

想知道影片生成有沒有跟住關鍵畫面,KeyFrame-Compass 就把這個矛盾拆開量度。它同時看畫面有沒有到位、順序有沒有跟足,還會檢查整體影片質感。

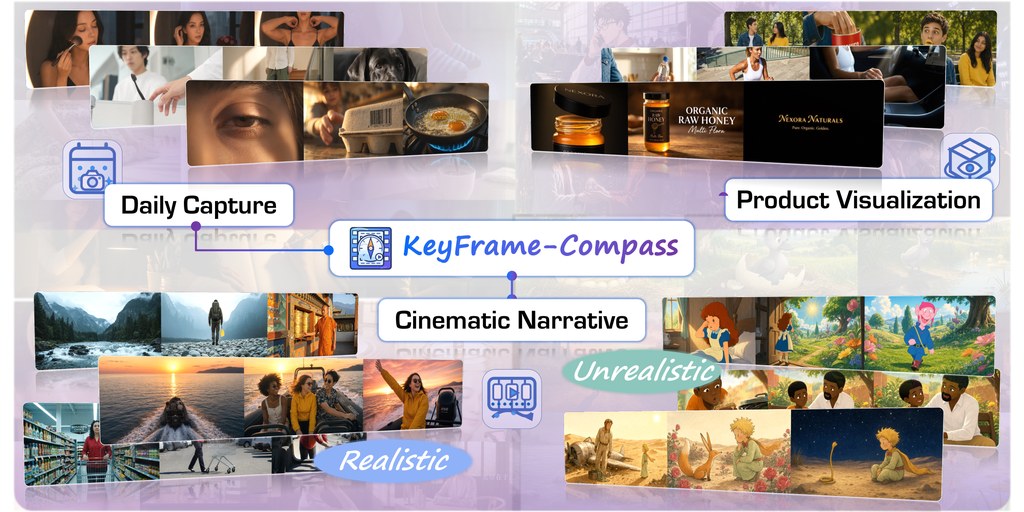
KeyFrame-Compass benchmark domains and examples

KeyFrame-Compass 是一個用來評測 keyframe-conditioned video generation 的基準項目,重點在於檢查模型能否同時跟住文字提示同一組按順序排列的 keyframes 生成影片。對做影片生成的人來說,這類測試最有價值的地方,是它不只看成片好不好看,還會追問畫面有沒有真係按要求出現、順序有沒有走樣。

這個項目把評測拆成兩層:一層看 keyframe execution,包括關鍵畫面存在、視覺還原、時間順序、定位、持續性同回應唯一性;另一層看 overall video quality,會用 evidence-grounded MLLM(Multimodal Large Language Model, MLLM)判斷,加上專門的感知模型去量度視覺質素、時間連貫性、指令遵從同音訊表現。這種分法比單純比對整體分數更清楚,因為它能分辨出模型係「畫得靚」定「跟得準」。

官方提供 386 個案例,涵蓋三個應用領域,亦分有 multi-shot 同 one-take 片段,配合四種 keyframe 密度。安裝上需要 Linux、Conda 或 Mamba、NVIDIA GPU,同埋可用的 VLM API;倉庫亦提供 envsassetsall 三種設定模式,方便只建環境、只拉資產,或者一次過做完整驗證。

  • 把影片生成的「跟畫面」同「成片質感」分開量度,結果較容易解讀
  • 支援不同 keyframe 密度,較適合比較模型對控制力的穩定度
  • 適合做影片生成模型、研究原型或產品 demo 的質量驗證
  • 需要 GPU 同外部 VLM API,部署門檻唔算低
  • 相關模型類別可歸到 Video、視覺模型、多模態模型、模型、工具

GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Gemini, API, Video, 工具, Linux

EgoSteer:用第一身影片教機械人靈巧操作

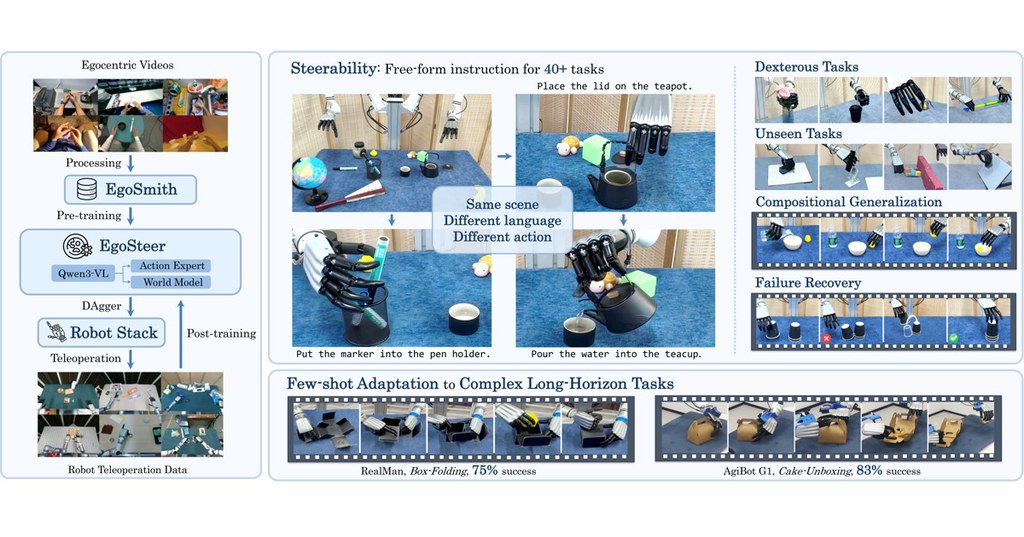
EgoSteer 讓機械人按自然語言調整動作,並以單一模型應付逾 40 種真實機械人任務。

Og image

面對不同物件與操作要求,機械人毋須為每項任務切換獨立模型。EgoSteer 結合第一身視角影片(Egocentric Videos)與自由形式語言指令,處理可控制的靈巧操作(Steerable Dexterous Manipulation)。

系統的核心取向,是讓使用者以日常語句改變機械人的操作方式,而不只觸發預先固定的動作。這種設計適合需要頻繁轉換物件、步驟或操作目標的機械人工作流程。

  • 單一模型支援超過 40 項真實機械人任務
  • 接受自由形式語言指令
  • 從第一身視角影片學習操作資訊
  • 重點在於按指令引導靈巧動作,而非只重播示範

相較每項任務各自訓練模型的常見做法,EgoSteer 着重跨任務共用能力,可減少模型切換帶來的流程負擔。現有資料未交代成功率、延遲、硬件配置及訓練數據規模,因此暫時未能判斷它在未見物件或全新環境中的穩定程度。

研究機械人模仿學習、人機協作或以語言控制操作流程的讀者,會較容易理解它的價值;其後仍需完整技術資料,才能評估部署成本與泛化能力。

項目主頁 · GitHub · 模型

Categories: 模型, 視覺模型, Robotic, Dataset 數據集

ABot-N1 點樣令導航模型更穩更易懂

ABot-N1瞄準機械人導航最難搞的斷層:一邊要理解場景與指令,一邊又要即時控制移動。它把思考與動作拆開處理,令跨場景導航更穩定,也較容易追蹤模型點樣作決定。

AMAP CV Lab

做室內外導航時,最麻煩往往不是單純避障,而是模型要同時理解語言、辨認目標,再即時走出合理路線。ABot-N1屬於 VLA(Vision-Language-Action)navigation model,焦點放在處理黑盒式策略常見的座標漂移、長尾語意理解不足,以及決策過程難以解釋的問題。

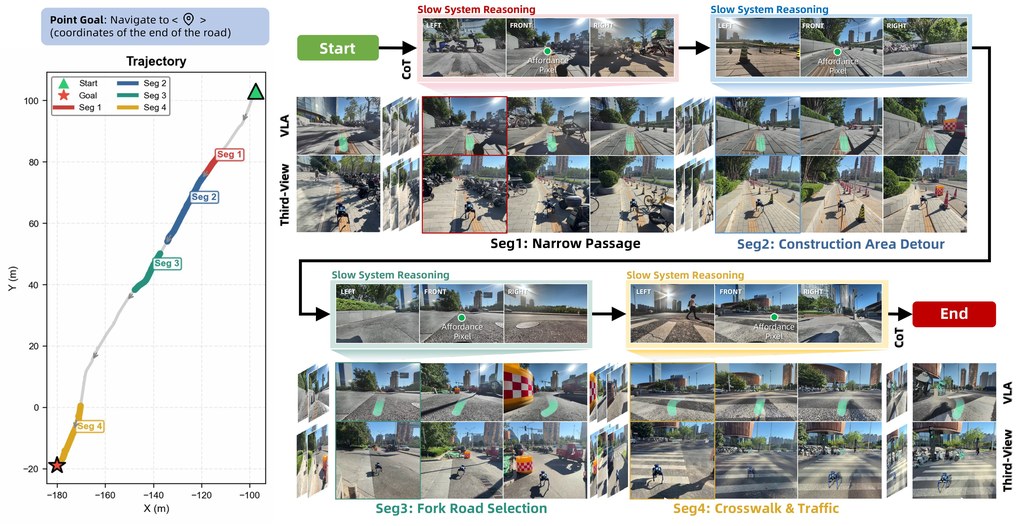
它的做法不是把所有事塞進同一個控制器,而是用 slow-fast 架構把認知與控制分開。較慢的 vision-language reasoner 會讀取歷史畫面與任務提示,產生明確的 Chain-of-Thought reasoning,並輸出 pixel goals 作為通用的影像空間錨點;較快的 action expert 再結合文字線索與 pixel guidance,持續生成 waypoint,將高層意圖接到低層移動控制。

這種設計的好處,在於同一套框架可以覆蓋多種導航任務,而不只是單一路徑跟隨。現有資料提到它支援 point-goal、POI-goal、object-goal、instruction-following 同 person-following,當中 POI-goal 需要由戶外走到實際入口,特別能反映語意理解與跨場景移動是否連得上。

  • 把 cognition 與 control 非同步拆分,減少黑盒式端到端策略的不透明問題
  • 用 dual visual-language signals 連接推理與動作,核心輸出包括 Target Pixel 與 Affordance Pixel
  • 涵蓋 point-goal、POI-goal、object-goal、instruction-following、person-following 等任務
  • 成績上錄得新 state-of-the-art,POI arrival 提升 35.0% 至 77.3%
  • 複雜室內與室外場景分別達到 95.4% 與 92.9% SR,亦同步開源新 benchmark

整體來看,ABot-N1最值得留意的不是單一指標,而是它試圖把「看得懂、講得清、走得穩」放進同一個導航模型。對做 embodied AI、robotics 或通用導航工作流的人來說,這個項目提供了一條比純黑盒控制更可分析、也更容易擴展到不同任務的路線。

項目主頁

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 多模態模型, 模型訓練, Image, VLA, Robotic, 3D, Dataset 數據集

MedPMC 把醫學圖文資料做成可訓練基座

想做醫學影像與文字理解,卡位通常唔係模型,而係乾淨又夠大的圖文配對。MedPMC 把這件事連同訓練流程一併開放,方向相當務實。

Repository image for Yale-BIDS-Chen-Lab/MedPMC

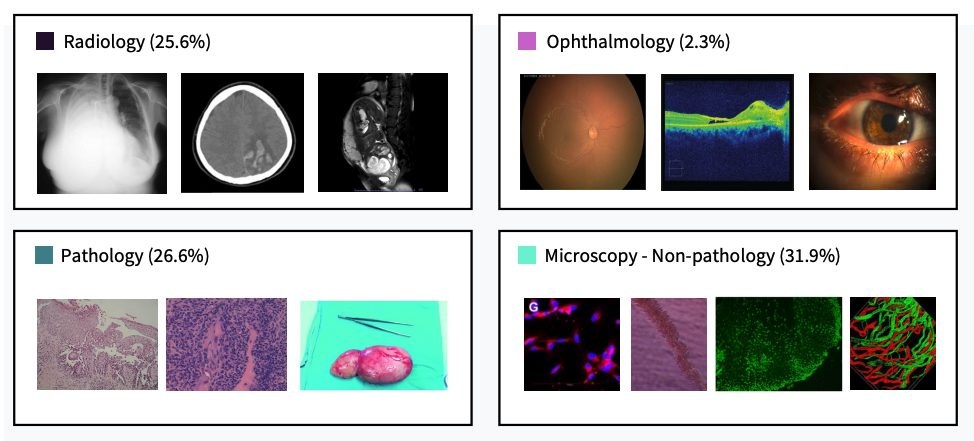
做醫學多模態模型,最難往往不是再堆一個新架構,而是先整理到可用的圖文資料。MedPMC 屬於Dataset 數據集加模型訓練程式碼項目,核心價值是把 PubMed Central (PMC) 文獻中的醫學圖片與文字抽取、清理,再接上訓練與評估流程,處理的是醫學 vision-language 資源長期分散、難重現的問題。

目前最值得留意的是 MedPMC Dataset 首個版本,提供約 1,100 萬組 medical image-text pairs;同時亦有基於 MedPMC-11M 訓練的 MedPMC-CLIP。這種做法與不少只放模型權重、或只交出資料連結的項目不同,它把 dataset curation、preprocessing、model training、evaluation 放在同一個代碼庫,較適合研究團隊沿住同一條流程再做微調或重跑實驗。

部署與測試的理解方式很直接:資料集與模型都已放到 Hugging Face,現階段較像給研究者先下載資料、檢查抽樣品質、再接入自家訓練管線。README 未提供很完整的操作文件,dataset viewer 亦未必可直接預覽,所以短期內它比較偏向有 Python 與資料處理能力的團隊,而不是即開即用的線上服務。

  • 約 1,100 萬組來自 PMC 的醫學圖文配對,是項目現時最重要資產
  • 連同 MedPMC-CLIP 一併釋出,方便由資料走到模型驗證
  • 重點不在花巧介面,而在可重現的資料整理與訓練流程
  • 文件仍在補完中,benchmarks 與更多 training recipes 尚待發布

以現有資訊看,MedPMC 的強項是規模與研究流程整合,限制則是文件與基準結果仍未齊備,暫時較難單靠公開頁面判斷模型表現上限。對醫學 AI、視覺模型、RAG 前處理,或需要建立醫學圖文檢索基座的團隊來說,這個開源項目已有不錯參考價值;相關模型現時可確認的是 MedPMC-CLIP

項目主頁 · GitHub · 模型

Categories: 開源, RAG, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Image, Medical醫學, Python, Dataset 數據集

GenCeption 單一模型多種視覺任務

同一個模型就想處理深度、分割、姿態同關鍵點。GenCeption 把影片生成預訓練轉成通用視覺能力,方向相當清晰。

Og image

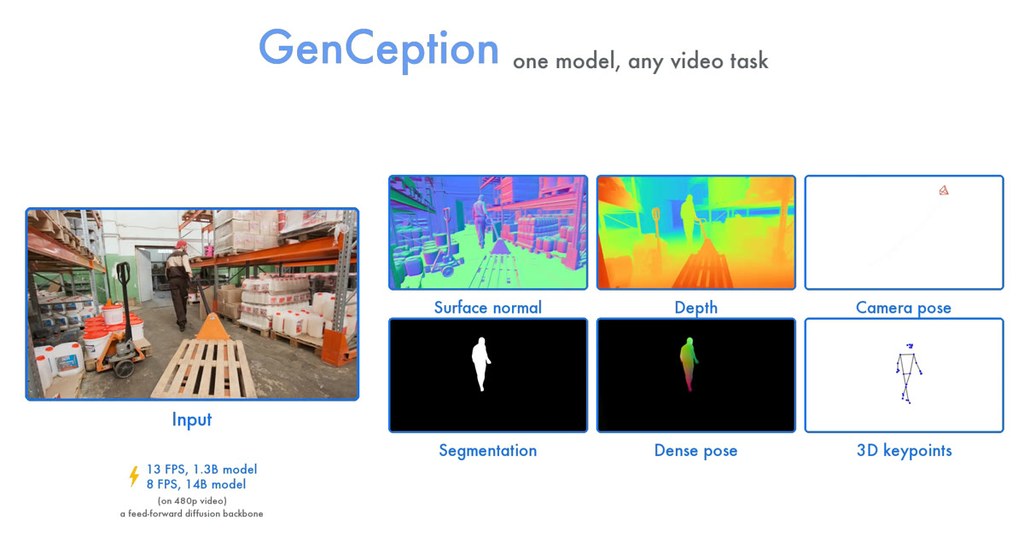
做影像理解時,很多人最頭痛的不是單一任務做唔到,而是每做一種任務就要換一套模型。GenCeption 屬於通用視覺模型,目標是把深度估計、法線、相機姿態、分割、2D/3D 關鍵點甚至 4D grounding 放入同一個流程,並且用文字指令控制輸出。

它處理的核心問題,是電腦視覺長期依賴任務專用模型,工作流容易分散、訓練與部署成本亦高。GenCeption 的做法,是先用 video generative diffusion model 做預訓練,吸收空間與時間上的 world priors,以及原生的 vision-language alignment,再經過 multi-task post-training,把原本偏生成式、多步驟的骨幹,改造成單步 feed-forward 推理模型。

這種路線跟常見做法最大分別,在於它不是為每個任務各自砌一個模型,而是用單一、task-agnostic architecture 應付 dense 與 sparse vision tasks。資料上亦以 synthetic data 為主,重點放在學習效率、sim-to-real transfer,以及遇到 out-of-distribution 物件類別時的泛化能力。

  • 支援多種視覺任務,包含 depth、surface normal、camera pose、segmentation、2D/3D keypoint prediction
  • 透過文字指令切換任務,保持同一模型介面
  • 把影片生成預訓練轉成 feed-forward 視覺推理,而不是停留在多步生成流程
  • 官方描述指它在多個任務上可與專用 SOTA 模型競爭,對比對象包括 DepthAnything3、D4RT、VGGT-Ω、SAM3、Sapiens、DAVID

對研究多模態模型、通用機械視覺,或者想整合複數感知任務的人來說,GenCeption 值得留意。現時公開內容仍以研究展示為主,Code 亦標示為 TBA,所以較適合先理解方法方向與能力邊界,再觀察後續開源與可重現程度。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Google, Video, 影像處理, 3D

Canvas360 把全景生成拉回可用水平

全景圖最易穿崩嘅位置,往往唔係畫質,而係左右接縫同空間感。Canvas360 針對呢個痛點落手,想令文字生成同後續修補都更連貫。

teaser

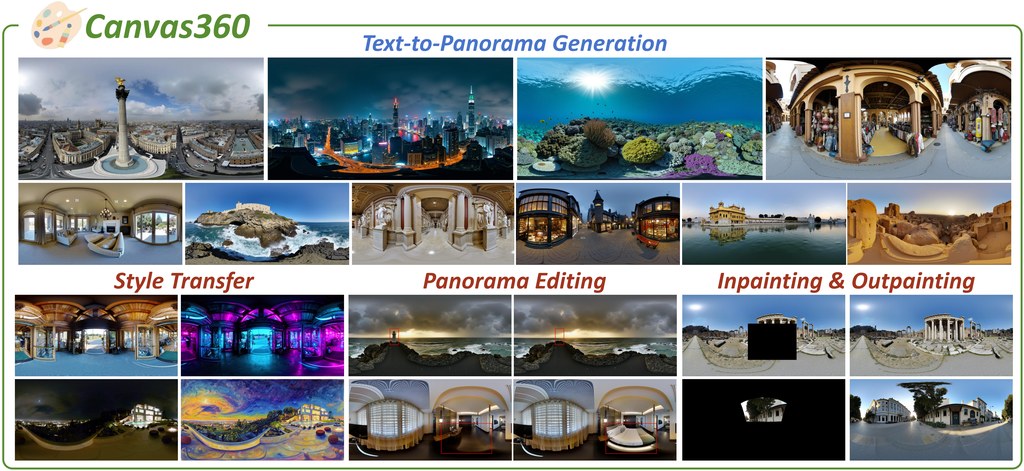
最值得留意嘅地方,在於佢唔只想生成一張闊圖,而係想處理 360 度全景最常見嘅破綻:左右邊界接唔上、透視變形唔自然、補圖後空間結構散開。Canvas360 屬於影像生成框架,建基於 FLUX,處理嘅係 text-to-panorama image generation,同時延伸到 inpainting、outpainting、editing 同 style transfer 呢類全景工作流。

現有做法多數先把全景當成一般平面圖片生成,再靠後處理減少接縫;作者認為呢種範式忽略咗 panoramic projection 本身嘅幾何特性,所以容易喺邊界、深度關係同局部結構出現錯位。Canvas360 用 two-stage framework 重組呢件事:先做 geometry-aware pretraining,引入 parallel RGB-depth pretraining,再配合 continuous position encoding、circular latent padding 同 per-block feature synchronization,將 360 度連續性直接放入模型學習過程。

同類項目相比,Canvas360 嘅取向唔係單純追求更華麗嘅畫面,而係優先修正全景生成最影響可用性嘅一致性問題。項目亦補上 Canvas360Dataset,提供 1M paired panoramic samples,支援 style transfer、inpainting、outpainting 同 editing,反映作者唔止做單一模型改良,仲想連訓練資料結構一併補強。

  • 核心定位係 FLUX-based framework,主打 text-to-panorama image generation 同全景補全
  • 關鍵方法包括 geometry-aware pretraining、continuous position encoding、circular latent padding
  • 已公開 inference code 同 training code,但 model weights 與 online demo 仍然未釋出
  • 需要 base model black-forest-labs/FLUX.1-dev,並可配合自備 LoRA 跑生成或下游任務
  • 相關比較對象包括 PanFusion、SMGD、PAR、WorldGen、HunyuanWorld、DiT360,以及 FLUX.1-Kontext-dev、FLUX.2-dev、Qwen-Image-Edit

測試同現階段較接近研究型項目而唔係即開即用服務。儲存庫已提供 inference.py 同 inference_downstream.py,代表你可以在本地環境配好 PyTorch、依賴套件、FLUX.1-dev 存取權同 LoRA 後,直接驗證文字生成全景,或者試全景補圖與延展;不過權重未公開,所以現時更適合研究團隊、全景影像工具開發者,或者想研究 360 度生成方法嘅人先行閱讀同跟進。現有介紹強調結果比多個舊方法更少接縫瑕疵、結構更清晰,但儲存庫內容未見完整量化指標表,判斷性能仍要等論文與權重進一步公開後先更穩陣。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型, 視覺模型, 模型訓練, Stable Diffusion, Image, 影像模型, 框架, Python, Dataset 數據集

Video-Oasis 想重做影片理解評測

不少影片 benchmark 分數看似漂亮,其實未必真係考到影片理解。Video-Oasis 把焦點放回評測本身,專門拆解捷徑題與真正需要時序證據的題目。

video native challenges

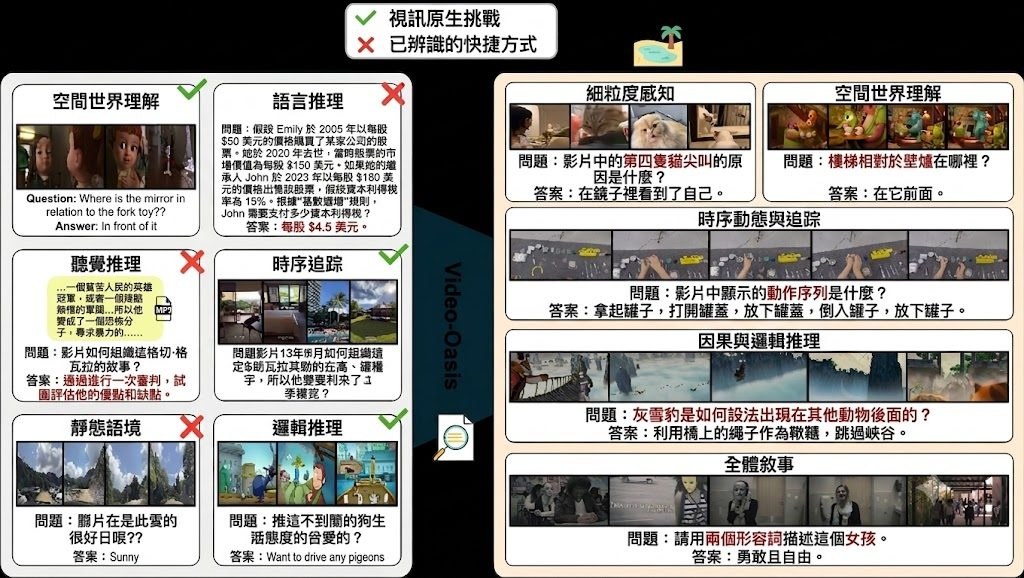
高分未必代表模型真係睇得懂影片,呢個項目正正針對呢個落差。Video-Oasis 屬於資料集與評測項目,重點不是再加一份題庫,而是重新檢查現有 video benchmark 到底有幾多題目真的需要 visual grounding 與 temporal reasoning,避免模型只靠文字線索、單幀畫面或靜態背景就答中。

普遍做法是把不同影片問答 benchmark 直接合併比較,作者認為這種固定範式忽略了「是否真係需要影片」這個前提。Video-Oasis 先整理 14 個 benchmark、24,416 個 QA samples,再用共享的 visual 與 temporal criteria 審視題目,結果指出約 55% 樣本可被 non-video shortcuts 解開,之後再萃取出 11,033 個較具代表性的 Video-Native 挑戰。

它和同類 benchmark 最大分別,在於不是追求覆蓋更多題型,而是先清理評測污染。官方資料提到五類 video-native challenges 才是核心難點,而現時模型在這部分表現仍然偏弱,最佳模型 Gemini-2.5 Pro 只有 46.7%,接近 chance 25.63% 之上不遠,說明這套評測更能拉開「答得中」與「真理解」之間的差距。

  • 涵蓋 14 個 benchmark,任務由 perception 延伸到 reasoning,片段長度由幾秒到數小時
  • 以 shared visual and temporal criteria 重新審核題目,不是單純拼接舊 benchmark
  • 約 55% QA samples 可用 non-video shortcuts 解答,真正 video-native 部分約佔 45%
  • 評測流程建基於 lmms-eval,並支援透過 huggingface_hub 下載模型
  • README 已提供資料下載、影片修復與目錄整理方式,但完整程式碼仍標示為 coming soon

部署理解上,它較像一個研究型 benchmark workflow:你要先準備 Python 3.12、CUDA-compatible GPUs、torch、vllm 0.11.0 與 transformers 4.57.0,再下載各 benchmark 影片、用 ffmpeg 腳本修復損毀檔案,之後透過內建 lmms-eval 跑 vqa_total 或 v_oasis 任務。現階段較適合做模型評測、研究比較,或者幫團隊檢查自家 video model 是否只是在 benchmark 上「識考試」,未必適合作為即裝即用的應用工具。

項目預設支援可由 huggingface_hub 下載的模型,示例提到 Eagle2.5-8B;成績說明中則點名 Gemini-2.5 Pro 為目前最佳表現者。整體來看,Video-Oasis 最有價值的地方不是再造一個排行榜,而是把影片理解評測裡最容易被忽略的捷徑問題公開化,令後續模型比較更可信。

項目主頁 · GitHub · Paper

Categories: 開源, AI productions, 視覺模型, 視頻模型, NVIDIA, Gemini, Video, Python, Dataset 數據集

Vidu S1 把即時互動影片拉近一步

對住數碼角色直接開聲指揮,畫面仲可以一路生成一路改,Vidu S1瞄準的正是這種近乎通話式的影片互動。它未必是最通用的影片模型,但在即時控制這件事上明顯有自己路線。

Vidu S1 Experience Preview

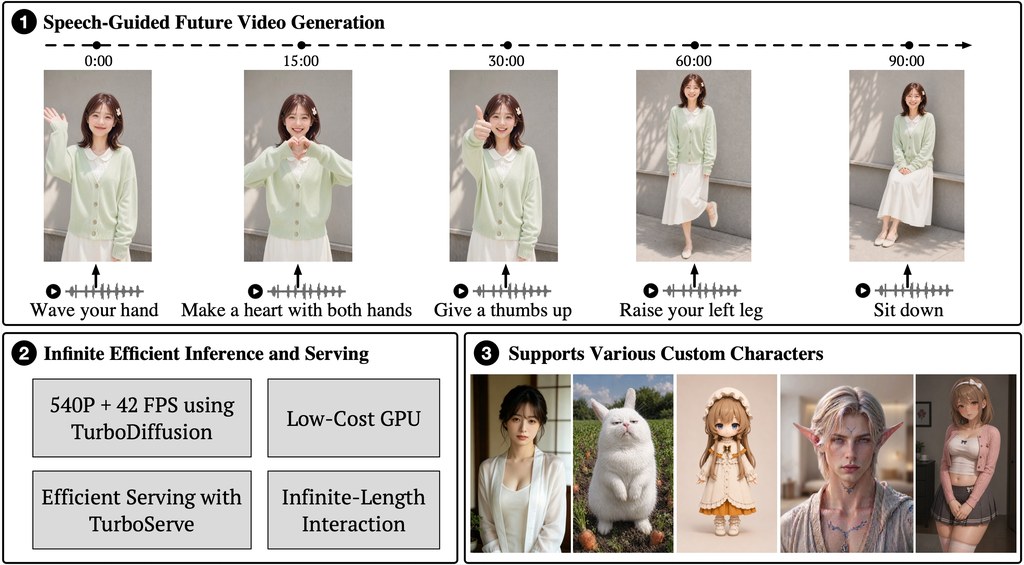
比起先寫好提示詞再等片段輸出,Vidu S1更接近一種可對話的視頻模型:你一邊講,數碼角色一邊跟住反應,處理的是「影片生成能否即時被人打斷、改向、持續延長」這個卡位。項目把重心放在 voice-controlled digital characters,而不是一次過產出完整短片,定位很清楚是互動內容而非傳統文生影片。

現有做法多數仍是 prompt-driven、片段式生成,用戶先提交指令,再等待固定長度輸出;作者主張這種範式難以支援 live interaction。Vidu S1改用 real-time speech control 與 infinite-length real-time interactive generation,讓角色在生成途中持續接受 spoken instructions,方向上更接近直播角色、虛擬主播和即時陪伴互動,而不是 cinematic clip 製作。

  • 支援以語音即時控制角色動作,重點在連續互動而非單次出片
  • 可自訂角色形象與 voice tones,涵蓋真人、二次元、寵物等 avatar
  • 官方資料提到 540p、最高 42 FPS,並可在 consumer GPUs 運行
  • 除了網頁體驗,也提供 API 文件,較適合接入互動產品流程

現有公開資訊較偏向服務化體驗:可先在 Vidu Stream 網頁建立角色、選擇或 clone 聲線,再開啟麥克風與鏡頭進行 live call;團隊要接入自家產品,則更可能經 API 而非直接本地完整重建。GitHub 儲存庫目前公開了論文、說明文件與入口,但未見完整本地訓練或推理流程,較像展示能力與提供接入方式的研究/產品型開源項目。

取捨也很明顯:它強調流暢、低延遲、可長時間互動,代表優先次序未必是最高解析度或最複雜鏡頭語言。受益最大的會是做虛擬主播、互動陪伴、角色扮演、品牌數字人和即時內容演示的團隊;要做電影感分鏡、長敘事剪輯或高度後期控制,現階段未必是它最強的一面。相關模型則包括 Vidu S1 本身,以及同一服務脈絡下的 Vidu Stream 互動入口。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 數字人, 視覺模型, 多模態模型, 視頻模型, API, Clone, 語音, Dataset 數據集

OpenCoF 用影片學會推理

推理未必只靠文字一步步寫出來,OpenCoF 把重點放到影片幀與幀之間的連續變化。它想證明,生成影片本身都可以成為推理過程。

Repository image for xinyan-cxy/OpenCoF

文字 Chain-of-Thought (CoT) 之外,OpenCoF 把推理搬到影片時間軸上,主打 Chain-of-Frame (CoF) reasoning:模型不是靠外部工具拆步驟,而是在連續生成的畫面裡理解因果、規則同狀態變化。這屬於一個研究型框架,核心想處理的問題,是現有影片生成模型多數只見過一般影片資料,未必學到穩定的時序推理能力。

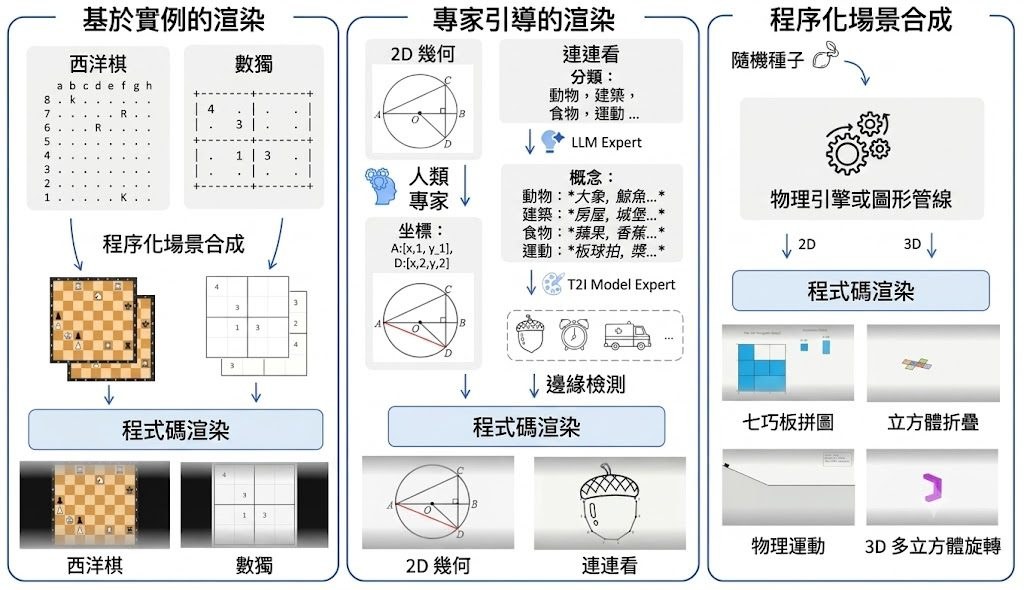
作者對既有做法的批評很明確:以往影片模型通常用通用影片語料訓練,缺少專門針對 CoF reasoning 的監督,因此即使畫面能動起來,都未必真係「識推」。OpenCoF 於是補上兩層東西:先有 OpenCoF-17K 這個包含 17,312 段影片、覆蓋 11 類任務的資料集,再用它把 Wan2.2-I2V-A14B 經 LoRA 微調成 Wan-CoF,之後再加上 Visual Reasoning Tokens (vt) 與 Textual Reasoning Tokens (tt) 兩種設計。

OpenCoF 先用資料監督驗證影片推理能否被教出來,再用 token 設計補強中間推理狀態,而不是一開始就堆很多複雜推理機制。公開資訊顯示,Wan-CoF 單靠資料監督,已經在 MME-CoF、Gen-ViRe、VIPER、RULER-Bench 四個外部 benchmark 全面勝過基線;Wan-CoF vt 與 Wan-CoF tt 則再向前一步,但兩者偏重不同,vt 較擅長低階視覺線索,tt 較著重高階語意先驗。

  • OpenCoF-17K 由四條資料整理流程建成,兼顧規則型任務、程序生成場景與真實影片多樣性
  • Wan-CoF 以 Wan2.2-I2V-A14B 為底,靠 LoRA 微調驗證資料本身已可提升推理表現
  • Wan-CoF vt / Wan-CoF tt 分別從視覺 latent 與文字條件序列加入 reasoning tokens,走兩條互補路線
  • 評測覆蓋 MME-CoF、Gen-ViRe、VIPER、RULER-Bench,結果指向同一件事:時序監督對影片推理有明顯幫助

OpenCoF 適合研究團隊、做視覺推理評測的人,或者關注 Video reasoning 與 Video generation 交界的開發者參考:儲存庫已公開論文與方法框架,但 code、dataset 同 model checkpoints 仍在內部審核,暫時未能直接下載測試;現時較合理的理解方式,是先把 OpenCoF 視為一個針對 CoF reasoning 的資料與訓練範式,等正式釋出後再判斷重現成本與落地價值。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 字節跳動, 視覺模型, 多模態模型, 視頻模型, Video, 蘋果, Dataset 數據集

Page 7 of 20
1 5 6 7 8 9 20