CrossViewTokenFusion:乳房 X 光雙視角分類新路線

同一個病灶在兩張乳房 X 光角度入面,線索未必一致。CrossViewTokenFusion 想處理的,正正是點樣保留兩個視角各自訊息,再逐層交換關鍵證據。

Repository image for PartAI-Projects/CrossViewTokenFusion

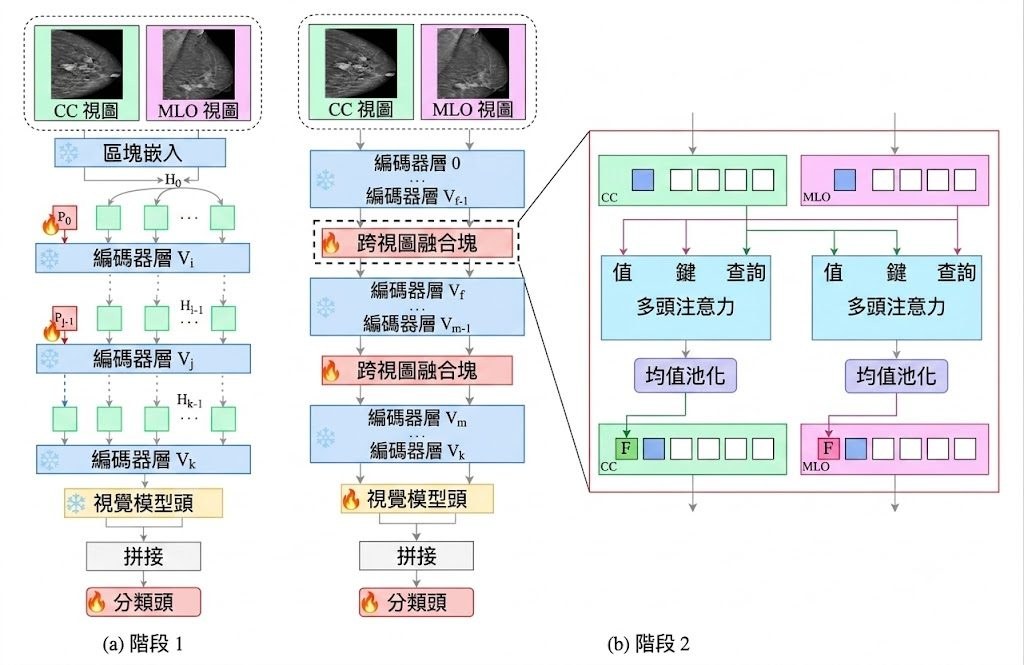
臨床判讀乳房 X 光唔會只望單一角度,但不少多視角方法仍然偏向把特徵提早合併,或者只做一次 cross-attention,結果容易把 view-specific 線索同共享資訊混埋。CrossViewTokenFusion 屬於醫學影像分類模型/研究原型,針對 dual-view mammography classification,重點係讓 CC 與 MLO 兩個視角以 token 為單位逐步交換資訊,而唔係一開始就粗略融合。

項目建基於 frozen MedSigLIP vision model,採用兩階段流程:先做 deep prompt learning 適配,再做 cross-view token-based fusion。作者批評既有 multi-view learning 常見的 feature-level aggregation 同 single-stage cross-attention 互動太淺,於是改用 dedicated fusion tokens 作為中介,透過 cross-attention 在多個 transformer 深度反覆傳遞雙向訊息,之後再把 fusion tokens 放回 token sequence 繼續細化。

部署要求先準備 VinDr-Mammo 或 CMMD(Chinese Mammography Database),再做 preprocessing、stage 1 訓練、stage 2 訓練,最後載入 checkpoint 測試。

它比較適合做醫學影像研究、醫療 AI 團隊驗證多視角融合設計,未見到直接面向臨床系統的封裝介面。

  • 舊範式多數用 feature-level aggregation 或單層 fusion;這個項目改為 multi-depth token 互動
  • 以 frozen vision transformer backbone 配合 prompt learning,取向係少改主幹、多做適配
  • 公開資料集包括 VinDr-Mammo 同 CMMD,方便學術重現與橫向比較
  • VinDr-Mammo BI-RADS classification 達到 50.40% F1-score、0.8090 AUC
  • 相比 dual-view fusion baseline,二分類設定下 AUC 提升 0.10

它的價值係重新定義雙視角點樣溝通:保留各自結構,再用 fusion tokens 逐層傳遞互補證據。
GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Medical醫學

LingBot-Video 想做懂物理的生成影片

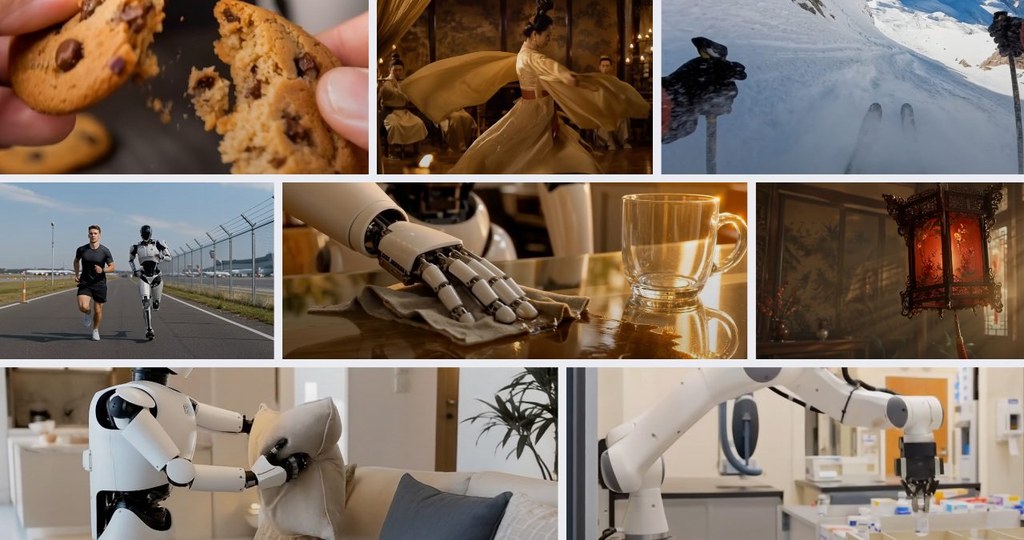
首个面向具身智能的大规模开源 MoE 视频基础模型。一般影片模型擅長畫面氣氛,未必處理到動作同物理合理性。LingBot-Video把重點放到具身智能場景,取向相當鮮明。

T2V Quality Score

生成影片要做到「似真」,唔只係畫面靚,仲要交代到動作、物件同物理世界之間嘅關係。LingBot-Video屬於開源視頻模型,主打 embodied intelligence,想補足一般 T2V 只重視視覺效果、但對任務過程同物理合理性掌握較弱呢個缺口。

呢個項目的取向幾清楚:唔係單純追求更大參數,而係用 MoE(Mixture-of-Experts)架構去平衡容量同推理成本,官方說法指推理可快約 3 倍。訓練資料亦唔只靠網絡影片,仲加入超過 70,000 小時 embodied data,再配合 multi reward system,同時兼顧美感、physical rationality 同 task completion。

部署理解上,它已提供完整模型下載入口,同時覆蓋 Hugging Face、ModelScope 以及文件站;推理路線分成 diffusers 同 SGLang Diffusion,代表團隊唔只放權重,亦有考慮不同推理堆疊。README 亦列出 rewriter,當中包括以 Qwen3.6-27B 為基礎嘅版本,以及 Qwen3.6-27B LoRA adapter,表示提示詞改寫都係整個工作流一部分。

  • 提供 LingBot-Video-DenseLingBot-Video-MoE,前者較像基線路線,後者加入 Refiner
  • 任務覆蓋 T2I、T2V、TI2V,唔只限純文字轉影片
  • 以 embodied data 同多重獎勵機制強化動作合理性
  • 有文件、模型頁同技術報告,較適合研究團隊同進階內容生成流程測試

受益最大嘅,會係想做機械人模擬、具身智能研究、動作導向影片生成,或者需要比較「任務是否完成」而唔只係「畫面是否好睇」嘅團隊。現有資訊未見到完整基準分數整理,所以性能判斷暫時仍要配合官方技術報告同實測;不過以開源定位、MoE 架構、Refiner 同 rewriter 一併公開嚟睇,LingBot-Video明顯係朝住較完整嘅研究與部署鏈路去設計。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, Qwen, Video

Rank-Then-Act 點樣用影片學出獎勵

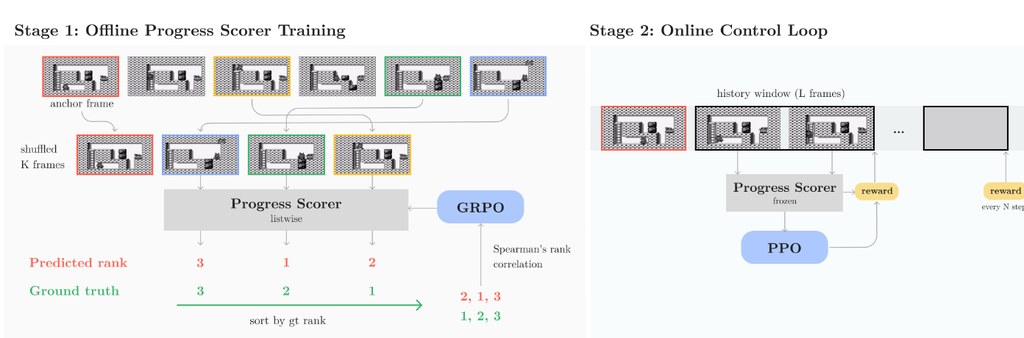
想像你只得示範影片、冇現成 reward function,Rank-Then-Act 就係針對呢個卡位而來。它先學會判斷進度,再把次序感轉成強化學習可用的訊號。

Screenshot

做強化學習最麻煩的地方,往往不是訓練本身,而是根本冇一個好用的 reward function。Rank-Then-Act 針對的正正是這個缺口:它屬於一個以 Vision-Language Model (VLM) 為核心的強化學習框架,目標是在沒有環境獎勵的情況下,從示範影片推回任務進度,再把這種進度感變成 agent 可學習的 dense reward。

同類方法很多時會直接學一個 scalar reward,或者預測成功與否,但作者刻意避開這條路。RTA 先用 GRPO 微調 VLM,要求模型在打亂次序的畫面序列中估計 task-completion 百分比與排序,再用 VOC 這個 rank-correlation reward 去約束模型真的理解時間進展,而不是偷看絕對時間線索;之後在第二階段,系統不是直接輸出分數當 reward,而是用 Spearman rank correlation 比較預測進度排序與真實時間索引,得到一個 bounded、scale-invariant 的學習訊號。

這種取向的好處,是 reward 較不容易因尺度漂移而失真,亦較有機會跨任務重用同一個 progress scorer。現有資料指出,它在離散環境如 PyBoy 上的 Catrap、Kirby,以及連續控制環境如 MetaWorld、PointMaze 都有不錯表現,對 unseen tasks 亦有泛化能力;不過這仍然是研究型項目,重點在方法驗證,未算是即裝即用的成品工具。

  • 重點不是直接預測分數,而是先學會判斷畫面進度排序
  • 第一階段用 GRPO 訓練 VLM,第二階段用 PPO 訓練策略
  • reward 來自 VOC 與 Spearman rank correlation,訊號範圍固定在可控區間
  • 已覆蓋 Game Boy 模擬器 PyBoy 與 MetaWorld 這類不同控制場景
  • 需要 Python 3.10+、CUDA GPU,第二階段還要 xvfb、ROM 與 save state

理解和測試這個項目,最合理的方式不是把它當普通套件安裝,而是當成兩階段實驗流程來看:先在 stage1 用 gameplay videos 訓練 progress scorer,再到 stage2 把該模型凍結成 reward model,放進 PPO 訓練流程。儲存庫已把資料處理、Hydra 設定、多 GPU 配置、PyBoy 包裝器與 VOC 計算分開整理好,適合研究團隊、做 video-based RL 的人,或者想比較 ordinal reward 與 scalar reward 差異的讀者深入追蹤。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Python

3D HAMSTER 把機械臂規劃帶進真 3D

同樣是看圖加文字指令,3D HAMSTER唔再只畫2D路線,而是直接交出可落地的3D機械臂軌跡。對機械操作流程來講,呢個改動細節不多,影響卻很實際。

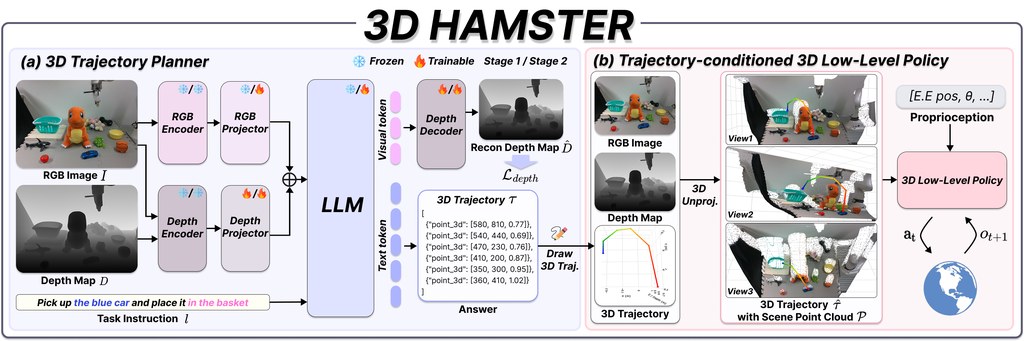
3D HAMSTER architecture: a depth-augmented VLM planner produces metric 3D waypoints that unproject into the point cloud

機械臂最怕規劃講得通,落到控制層卻對唔準空間位置。3D HAMSTER屬於 Vision-Language-Action 規劃模型/機械人研究項目,重點不是再產生螢幕上的 2D waypoint,而是根據單張 RGB 圖、metric depth map 同文字指令,直接輸出帶有深度的 3D end-effector trajectory,同時附上 gripper actions,格式亦整理成 JSON,方便接去後續控制流程。

它針對的矛盾很明確:不少 hierarchical Vision-Language-Action models 由高層 planner 先預測 2D 像素軌跡,再交給吃 point cloud 的低層 policy 執行。問題在於 2D waypoint 只會「借用」像素下方表面的深度,幾何上未必真是機械臂應走的位置。3D HAMSTER改成在 metric 3D 空間規劃,等高層輸出可以直接對接 point-cloud low-level policy,少了中間 2D 轉 3D 的失真。

模型骨幹用的是 Qwen3-VL-8B,再加上凍結的 LingBot-Depth geometry encoder,當中採用 DINOv2 ViT-L/14,並配合 dense depth-reconstruction objective 去強化深度感知。儲存庫目前提供的是 inference-only 版本,即是你可以安裝套件、下載 checkpoint 後直接跑推理或用 Gradio demo 測試;低層 point-cloud policy 屬於論文完整系統一部分,這個 GitHub 項目未有一併放出。

  • 直接輸出 [u, v, depth] waypoint,深度單位是米,較易接入真實機械臂流程
  • RGB-D + language instruction 路線,不靠多視角觀察
  • checkpoint 已包含 geometry encoder 權重,載入時毋須再額外抓模型
  • 項目偏向展示 planner 能力,不等於完整可部署的機械人控制堆疊

,它的定位很適合做研究驗證、機械操作規劃比較,或者拿來觀察 2D planner 與 3D planner 在幾何一致性上的差異。作者在項目頁面強調這種做法對語言、空間與視覺分佈轉移更穩健,但這個儲存庫未有完整公開訓練流程與低層控制模組,所以較適合把它理解為一個清楚展示方向的 3D-native planner,而不是即裝即用的全套機械人方案。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Gemini, VLA, Robotic, 3D, Dataset 數據集

SIEVE 點樣揀出更值錢的機械人示範數據

示範數據愈多,未必代表 VLA 訓練效果愈好。SIEVE 想做的,是先拆開動作結構,再挑出更值得保留的片段與軌跡。

Repository image for ChangtiWu/SIEVE

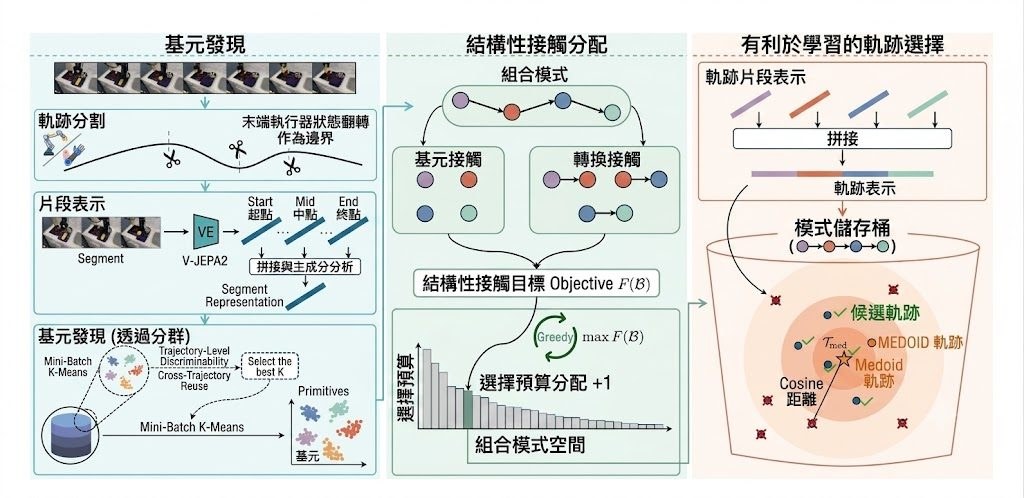
機械人示範資料最常見的問題,不是數量不夠,而是重複、嘈雜,甚至長段任務其實只是不斷重演相似動作。SIEVE 屬於一個面向 imitation learning 的資料篩選工具,同時帶有研究方法性質,重點不是逐條 trajectory 粗略評分,也不是只看 state-action,而是把長任務拆成可重用的 visuo-motor primitives 與 transition interfaces,再決定哪些 episode 更值得留下來訓練 VLA 模型。

它批評的舊範式相當明確:現有 data selection 方法多數只在 trajectory level 或 state-action level 做判斷,因而忽略長時序行為內部可重用的結構。SIEVE 的做法是先用 end-effector pose 與控制訊號做 segmentation,再抽取 V-JEPA 特徵、用 PCA 壓到預設 256 維、以 MiniBatchKMeans 找出 primitive pattern,之後按 cluster-sequence pattern 做兩階段 episode selection,最後可以匯出回 LeRobot 格式,方便直接接回原本訓練流程。

這種取向的好處,在於它不是單純挑「最好」或「最乾淨」的示範,而是優先保留結構覆蓋度與可重用性。論文提供的訊息亦相當直接:SIEVE 在多個 datasets、benchmarks 與 VLA models 上,都比競爭性的 baseline 更穩定,甚至在只用 50% demonstrations 和 50% training steps 的情況下,表現可以超過 full-data training。當然,這也代表它較適合已有一定規模示範資料、並且願意先跑一輪離線整理流程的團隊,而不是追求即插即用的小型腳本。

  • 以 LeRobot v2 資料根目錄作輸入,支援單一或多個 dataset
  • 流程由 segmentation、feature extraction、dimensionality reduction、clustering、selection 組成
  • 特徵抽取依賴 V-JEPA,輸出中間結果到 Zarr,再匯出選中的 LeRobot episodes
  • 核心差異是按 reusable structure 揀數據,不是只按整條 trajectory 或逐步 state-action 打分

部署理解上,這個項目更像一條可重複執行的離線資料處理 pipeline,而不是一個直接提供推理服務的套件。適合用來整理大型 robot demonstration corpus、為 VLA imitation learning 減少冗餘訓練樣本;相關模型與技術脈絡包括 Vision-Language-Action (VLA) models、V-JEPA,以及輸出端相容的 LeRobot。

GitHub · Paper

Categories: 開源, 香港科技大學, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, 影像處理, Robotic, 香港, 中國, Dataset 數據集

SaMer 壓縮視覺檢索成本

想保留圖像檢索的細節判斷,又不想被海量 visual tokens 拖慢,SaMer正正處理這個矛盾。它用較聰明的合併方式壓縮 token,同時盡量守住檢索準確度。

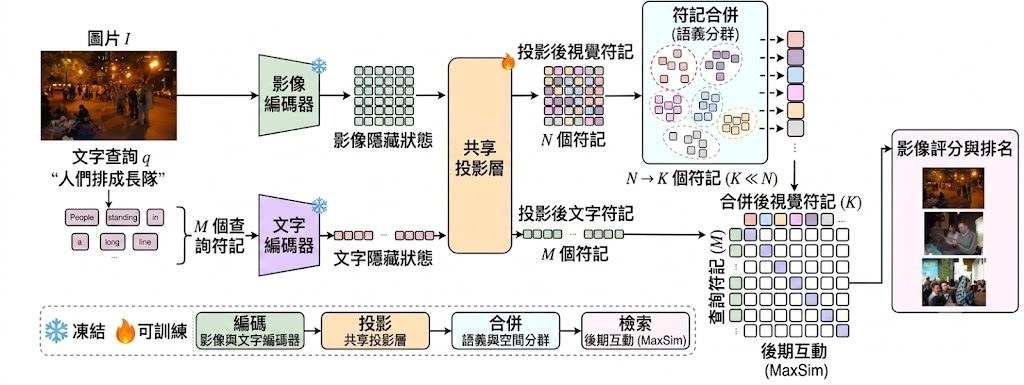
SaMer overview

圖文檢索做得細緻,往往要保留大量 image-side tokens,但儲存與比對成本也會跟住升。SaMer屬於開源框架/研究原型,針對 ColPali-style multi-vector retrievers 的 token 壓縮問題而來,重點不是單純刪減,而是盡量保住之後查詢仍可能用得着的 object-level evidence。

現有壓縮做法多數偏向 pruning、pooling,或者只按 feature 合併,代價是物件與區域證據容易被混在一起,令 MaxSim late interaction 原本可選取的細節訊號流失。SaMer的取向明確:保留原本 MaxSim retrieval objective,不改 late-interaction 介面,只在 image side 做 object-aware merge,修正「壓縮後證據變鈍」這個問題。

它的方法有三個關鍵步驟:先用 feature similarity 加 spatial proximity 做 Feature-Spatial Merging,再在訓練階段利用 Flickr30k-Entities 的框標註加入 Object-Aware Assignment,避免不同實例被錯誤合併,最後採用 Projection-Only Adaptation,只訓練 shared projection layer,vision encoder 同 language backbone 都維持 frozen。到 inference 時就不再依賴 bbox,這點令部署比一些需要 detector 或額外 grounding loss 的做法簡潔。

  • 以 ColPali-style multi-vector retrieval 為核心場景,重點是減 storage 與 scoring 成本
  • K=64 時可移除超過 93% image-side tokens,ColPali 儲存量下降 16.09×
  • 在 Flickr30K 與 MSCOCO,README 與項目頁指出 R@1 有提升
  • 相關模型權重包括 vidore/colpali-v1.3-hf,另有 Hugging Face 的 SaMer models 集合

測試與重現路線算清楚:資料要先準備 Flickr30k-Entities,之後訓練 adapter、建立 compressed retrieval cache,再做 inference。原始資料列出 Python 3.10+、CUDA-enabled PyTorch,以及單 GPU/多 GPU 腳本流程,但 evaluation 章節在提供內容中未完整展開,所以更細的 benchmark 設定與完整數字仍要以論文與項目頁為準。

這類做法最適合需要多向量圖文檢索、又在意記憶體與延遲的團隊,例如做 large-scale image retrieval、phrase-level grounding,或者要把 ColPali 類系統壓到較可部署規模的研究與工程項目。它的取捨亦很清晰:不是追求最少 token,而是用較低成本保留日後查詢仍有機會選中的視覺證據。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, Qwen, NVIDIA, Image, Python, Dataset 數據集

InternVLA-A1.5:機械人策略一體化新路線

想像同一個模型既睇得明畫面與指令,又會預想下一步場景,再直接輸出動作。InternVLA-A1.5吸引之處,正正在於它把這三件事收在同一套機械人政策裡。

InternVLA-A1.5 teaser

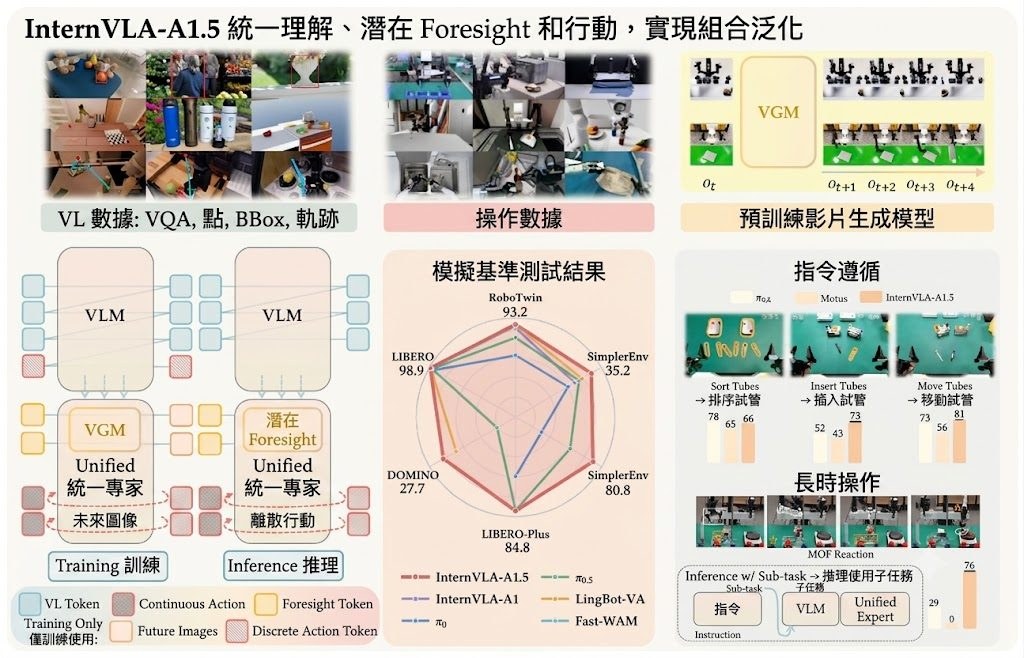
機械人操作最麻煩的地方,往往不是單純辨認畫面,而是要同時理解指令、估計接下來會發生什麼,再穩定地做出連續動作。InternVLA-A1.5屬於開源框架兼機械人政策模型,焦點放在把 vision-language understanding、latent visual foresight 與 action generation 合併,減少多模組串接帶來的延遲與協調成本。

它的取向很清楚:不少做法會把感知、未來預測、控制分開訓練或分開部署,InternVLA-A1.5則把 foresight 放進同一條政策路徑,在訓練期間借助凍結的 WAN2.2-5B video generation model 提供未來動態監督,但推理時丟棄 video branch,只保留動作預測。這個設計的好處是保住「先想一步」的能力,同時避免部署到真實機械人時推理太重。

模型骨幹建基於 Qwen3.5-2B VLM,透過 shared full-attention layers 接上一個輕量 unified action expert,並保留 modality-specific Gated DeltaNet processing;動作輸出則用 flow matching 預測 continuous action chunks。README 亦提到它可用於部署、數據收集和評估真實機器人上訓練有素的操作策略,但公開資訊較集中在模型與 benchmark,具體安裝流程與真機部署步驟未見完整展開。

  • 舊路線常把理解、預測、控制拆開,這個項目改為單一 policy 統一處理
  • 訓練用 WAN2.2-5B 學未來動態,推理時移除相關分支,換取較實際延遲
  • 已在 LeRobot V2.1 dataset 微調,亦結合大規模機械人與多模態資料
  • 基準成績突出:RoboTwin 2.0 為 93.2,LIBERO 為 98.9,LIBERO-Plus 為 84.8
  • 可取得的相關模型包括 InternVLA-A1.5-base、InternVLA-A1.5-RoboTwin、InternVLA-A1.5-Libero

從定位來看,它較適合想把研究原型推近真機驗證的團隊,尤其是同時重視語言理解、視覺泛化與操作成功率的人。現階段最值得留意的,不只是分數高,而是它示範了一種更接近完整機械人工作流的整合方式;限制則是公開說明仍偏研究導向,真正落地前仍需自行補足部署細節與硬件整合資訊。

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, 視覺模型, 多模態模型, 視頻模型, Qwen, Video, VLA, Robotic, Dataset 數據集


VLA-Corrector 補救機械人動作失誤

這是一個為 Vision-Language-Action 政策加入即時修正能力的推理框架。重點不在重訓模型,而是在偏差出現時及時截斷舊動作。

VLA-Corrector logo

VLA-Corrector 是一個面向 Vision-Language-Action(VLA)政策的輕量推理框架。它用來處理由 action chunking 帶來的開環盲點:環境已經變了,機械人卻仍照住排隊中的舊動作繼續做。

它的做法不是改寫整個 VLA 模型,而是把 backbone 凍結,再外掛一個 latent dynamics corrector。系統先用 Latent-space Vision Monitor(LVM)監察預測中的視覺特徵變化,當觀察到的畫面持續偏離預測,就會截斷過時動作,並透過 Online Gradient Guidance(OGG)重新規劃下一步。

這種取向與每一步都重算一次動作的 closed-loop 方法不同,重點是保留長 action horizon 的效率,同時在偏差累積時才介入。代價是它依賴 latent mismatch 偵測是否可靠,較像在效率與反應速度之間取平衡,而不是追求全程最敏捷控制。

  • 項目定位:屬於機械人控制推理框架,針對 action-chunked VLA policies 的修正與重規劃。
  • 部署理解:現有資訊顯示它應接在既有 VLA policy 後面運作,較像推理期增強模組,不是獨立基礎模型。
  • 適合場景:接觸密集 manipulation、抽屜對位、抓放物件這類容易受干擾的任務較能受益。
  • 核心組件:Latent-space Vision Monitor(LVM)負責偵測偏差,Online Gradient Guidance(OGG)負責觸發後的修正重規劃。

公開資料提到 real-robot demonstrations,例如抽屜對位與把積木放入不同碗中,並展示人在執行途中施加干擾後的恢復能力。不過 README 片段未列出完整數字指標、安裝步驟或支援哪些 VLA backbone,因此較合理的理解是:這是一個研究原型,已清楚展示方法與效果,但整合到不同機械人堆疊前,仍需自行確認相容性與評測流程。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 多模態模型, VLA, Robotic

LiveEdit:串流影片編輯走向即時化

LiveEdit 把文字指令變成串流影片編輯,重點放在速度與畫面穩定。它嘗試兼顧即時反應,以及背景與非編輯區域的保留。

Image 1

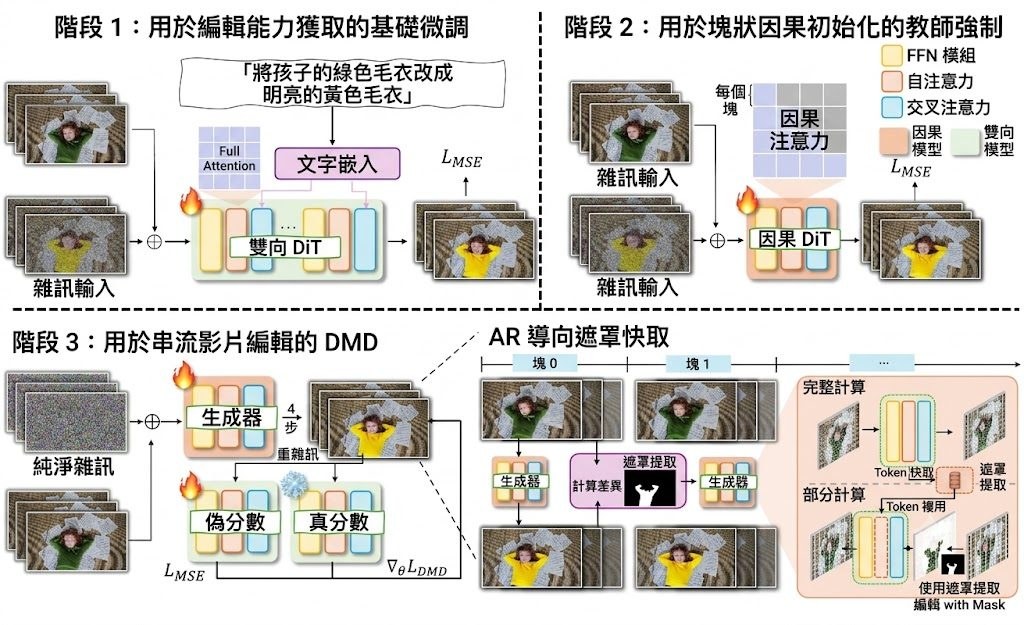
LiveEdit 是一個 diffusion-based streaming video editing 系統,屬於影片編輯模型與方法項目。它的核心任務是根據來源影片加上文字指令,逐段完成 causal chunk-by-chunk editing,並盡量保留背景與沒有修改的區域。

這個項目不是追求離線影片慢慢算到最靚,而是針對接近即時的串流編輯。它建基於 Wan2.1 和 Self-Forcing codebase,並用 three-stage distillation,把雙向編輯 teacher 的能力轉移到串流 student,再配合 AR-oriented Mask Cache 減少重複運算,換來較低延遲。

部署與測試資訊算是完整,提供 inference scripts、training code、checkpoint instructions,也講明建議在 Linux 配合 NVIDIA GPUs 執行;單 GPU 可做 inference,多 GPU torchrun 主要用於訓練。輸入方式是準備一個 JSON,填入 source video 路徑和 instruction,然後配合已釋出的權重與 Wan2.1 base model 進行推理。

有一個相當關鍵的參考值:項目頁列出 12.66 FPS,並表示透過 4-step distilled diffusion generation 達成 real-time streaming inference。這個成績對互動式影片編輯很重要,不過公開資訊未見更完整的硬件條件、顯存需求或不同解析度下的比較,因此判斷效能時仍要保留一點。

  • 重點不是一般文字生片,而是保留原片內容的串流影片編輯
  • 主要技術包括 three-stage distillationCausal DiTAR-oriented Mask Cache
  • 已公開 inference 與 training 程式碼,也提供 Hugging Face checkpoint 指引
  • 已知較適合 Linux、NVIDIA GPU 環境,研究團隊或影像生成工程師較易受益
  • 相關模型與基礎包括 Wan2.1-T2V-1.3B、bidirectional editing teacher、streaming student

整體來看,LiveEdit 的價值在於把 streaming video editing 做得更接近可互動系統,而不只是展示級效果。它較適合研究即時影片編輯、互動內容製作、直播視覺處理或需要低延遲生成的團隊;一般用家若想直接在圖形介面一鍵開用,現有資料未提供管理後台整合、免手動設定流程,仍然比較像面向研究與開發者的項目。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Video, 框架, Linux, 蘋果

Page 8 of 20
1 6 7 8 9 10 20