CosmoH2G 將人手示範轉成機械夾具軌跡

CosmoH2G 針對旋轉、翻轉等複雜空間動作,把人手示範轉換成機械夾具可執行的軌跡;其資料集包含 6,189 組配對示範。

dataset

人手示範雖然直觀,但當動作包含旋轉、翻轉或複雜空間路徑時,機械夾具往往難以直接模仿。CosmoH2G 是一套面向機械人操作的資料集與基準方法,專門處理 hand-to-gripper transfer:研究團隊同步記錄人手和手持機械夾具的動作,建立可配對的 RGB-D、3D 物件點雲、手部網格及夾具動作資料。

資料集共有 6,189 個配對示範、涵蓋 1,254 件物件,規模足以支援複雜空間操作的研究。與只適合平面移動的做法相比,CosmoH2G 把重點放在細緻的手部姿勢和空間運動,並以手持夾具示範減少人與機械裝置之間的動作轉換落差。

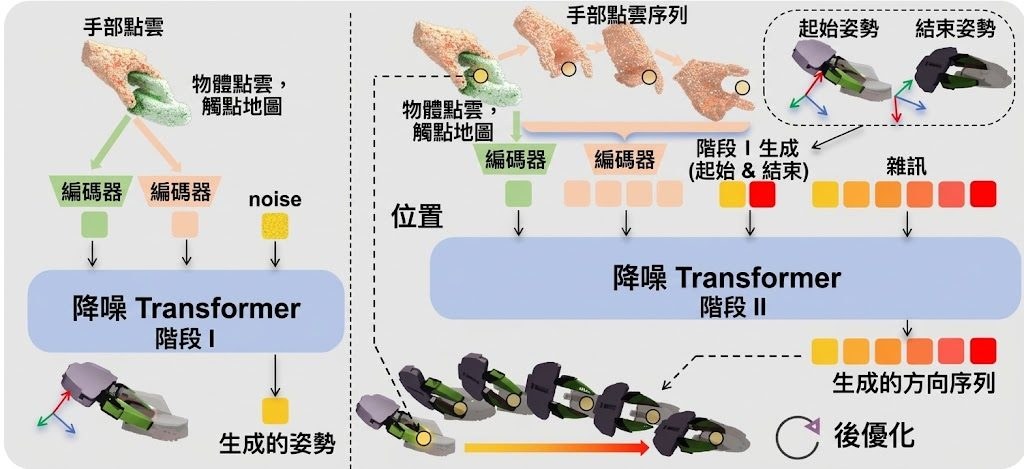
方法分兩階段處理完整軌跡。Stage I 先預測起點和終點等稀疏關鍵幀,把複雜動作濃縮成較容易學習的目標;Stage II 再以關鍵幀為條件生成連續的夾具姿態序列。系統亦保留夾具姿態的學習結果,再利用抓取啟發式與運動學一致性修正位置,減少旋轉和翻轉過程中的累積偏差。

在模擬及真實機械人實驗中,能穩定轉移旋轉等複雜動作,並明顯勝過傳統基準。適合研究機械人模仿學習、操作資料集、3D 手部追蹤,以及需要處理非平面夾具運動的團隊。程式碼和資料集在項目網站標示為即將推出,現階段較適合先評估方法和收集流程,部署細節仍要等官方發佈。

  • 6,189 組人手與夾具配對示範,涵蓋 1,254 件物件。
  • 專注旋轉、翻轉和其他細緻空間軌跡,而非平面搬運。
  • 兩階段先學關鍵幀,再生成完整連續動作。
  • 以抓取啟發式和運動學一致性降低累積漂移。
  • 適合機械人模仿學習、資料集研究及操作策略開發。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 視覺模型, 模型訓練, Robotic, 3D, Dataset 數據集

OmniEvalKit:唔使重新訓練 VLM 都可以聽聲答問題

MBZUAI Oryx 團隊把 OmniEvalKit 開源出嚟,主打唔使改動 VLM 任何參數,就為佢加掛語音理解能力。對於想評估或部署多模態模型嘅團隊,可以直接拎現成骨幹即試。

Training-Free Omni

想為一個視覺語言模型加入語音理解,但又唔想重新訓練?MBZUAI Oryx 團隊開源嘅 OmniEvalKit(Training-Free Omni)就正正針對呢個痛點。它把語音先經 Whisper 抽取成帶時間戳、語言同信心分數嘅結構化文字,再連同圖片或影片幀一齊餵俾凍結嘅 VLM,所有推理都沿用原本嘅 prompt 接口,骨幹權重全程不動。換句話講,任何新嘅視覺骨幹都可以即插即用,毋須再做語音—視覺對齊微調。

它同時係一個統一嘅多模態評測框架,支援文字、圖片、影片、音頻同音視頻任務,並預載 118 個資料集適配器,涵蓋 Qwen、Gemma、MiniCPM、VILA、OmniVinci 等模型,方便做公平對齊測試。對研究人員同部署團隊而言,最直接嘅好處係可以一次過跑 56 個 benchmark、21 種語言,直接比較凍結骨幹同原生 omni 模型之間嘅差距,睇下語音能力究竟係新加出嚟定係由舊能力交換得嚟。

如果你關心 VLM 加掛語音後會唔會「失憶」,呢套框架正正提供 matched comparison,可以量化評估圖像理解、視覺定位、編碼、數學等原有強項有冇被削弱。額外支援嘅 CosyVoice3 文字轉語音輸出,亦令文本答案可以直接變成語音回覆。

要本地跑得起嚟,需要 Python 3.10+、ffmpeg,再針對 CPU、CUDA 或 ROCm 安裝對應嘅 PyTorch。之後透過 eval.sh 配環境變數指定模型同資料集即可開跑,加 MAX_SAMPLES=3 可以做煙霧測試,中斷後設 RESUME=True 可以接返。

以下係幾個值得留意嘅重點:

  • 凍結骨幹、零微調:所有 VLM 權重完全不變,語音理解透過 Whisper 抽取文字證據再加 prompt 融合達成。
  • 即插即用嘅 omni 能力:支援 Qwen2.5-Omni、Gemma、MiniCPM、VILA、OmniVinci 等多個模型適配器,方便横向比較。
  • 覆蓋廣嘅評測矩陣:內置 118 個資料集適配器,涵蓋 56 個 benchmark 與 21 種語言。
  • 原生 omni 同凍結骨幹嘅 matched 對照:可以清晰分辨新增能力同保留能力,避免重訓帶嚟嘅 capability drift。
  • 可選語音回覆:透過 CosyVoice3 把文字答案合成語音輸出,適合對話式場景。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, 框架, Python, 語音, Dataset 數據集

VDN-H3 開源:14 秒 MiniMax 影片生成只花 11 秒

OpenVDN 團隊將 softmax 與線性注意力混合架構(hybrid attention)套用到 MiniMax H3 影片生成模型,在 8 張 B200 上以 8 步去噪產出 14.4 秒 768p 影片,速度比播放還快。

Repository image for OpenVDN/vdn-minimax-h3

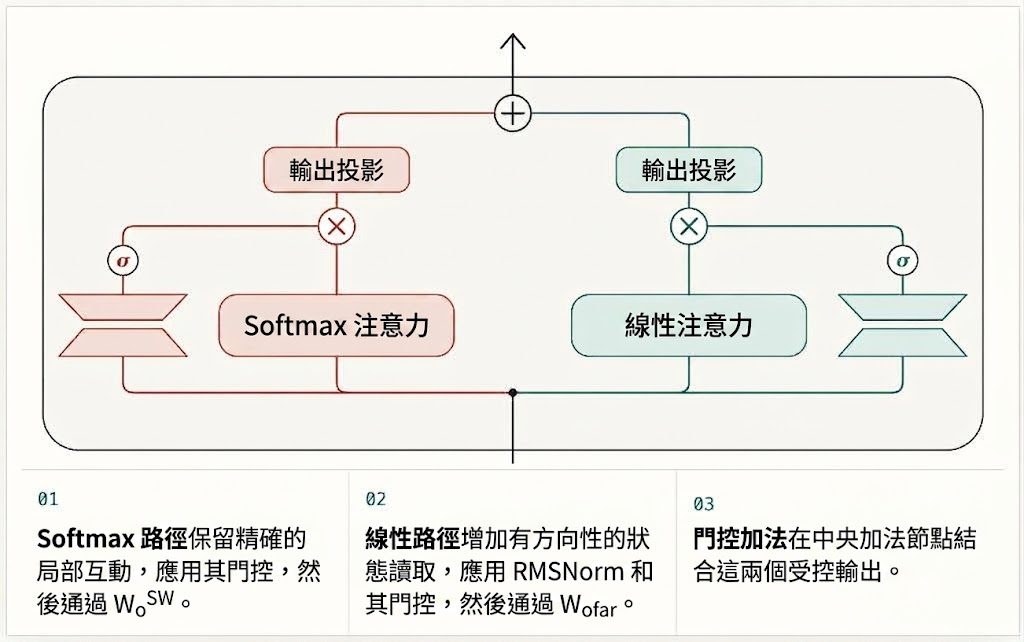
影片生成最貴的部分往往不是參數量,而是長序列上的 softmax attention。VDN-H3 針對這個痛點,把 MiniMax H3 骨幹拆成兩條互補分支:滑窗 softmax 負責鄰近幀之間的精細對齊,線性注意力則接手長距離語境與主體一致性,並用 4 向邊界錨點補強全域結構。最終在 8 張 NVIDIA B200 上,用 8 步去噪就能在 11.23 秒內生成 14.4 秒 768p 片段,生成速度比播放還快。

與同類做法的差異在於「近乎無損」這個定位。純線性注意力雖然快,但長序列下容易丟失主體身份、場景佈局與時序依賴;VDN-H3 透過混合架構把這部分成本交回給局部 softmax,線性分支只負責長程記憶,因此視覺品質與原版 H3 幾乎難以區分,也比 MiniMax FastH3 有更好的指令跟隨能力。對需要高吞吐量同時不犧牲一致性的團隊,這個取捨相當實用。

部署面需要 PyTorch 2.13、CUDA 12.9 與 FlashAttention 4(含 nvidia-cutlass-dsl 預釋版依賴),另外還要安裝一份修補過的 Diffusers;骨幹權重不需更動,兩條 LoRA adapter 可在推理時合併進去,等同 plug-and-play 替換。程式碼、訓練流程與優化後的推理 stack 一併開源,研究者與影片生成產品團隊都能直接複用。

重點摘要

  • 8 步去噪、8 張 B200,11.23 秒生成 14.4 秒 768p 影片,生成快過播放。
  • 混合 attention:滑窗 softmax 保留局部細節,線性分支負責長距離語境。
  • 視覺品質與原版 MiniMax H3 近乎無損,比 FastH3 指令跟隨更佳。
  • LoRA adapter 可合併進骨幹推理,不需更動原始權重。
  • 權重、推理 stack 與訓練程式碼同步開源。

項目主頁 · GitHub · 模型· ComfyUI 節點

Categories: 開源, AI productions, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, Python, MiniMax

KBMR 視覺問答檢索帶向實體語義

KBMR 針對 KB-VQA 容易搵錯相似圖片的問題,以 MLLM 將檢索焦點由外觀匹配轉向實體語義。

KBMR method overview

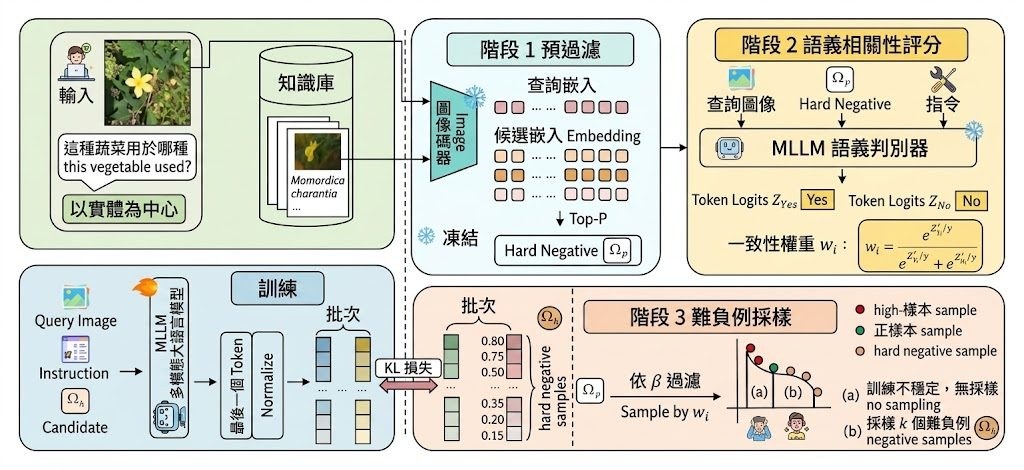
面對人物、地點或物件,KB-VQA 若只按圖片外觀搜尋,容易因視角、年代和風格變化搵錯資料。KBMR 屬於面向 Knowledge-Based Visual Question Answering(KB-VQA)的多模態模型檢索器,實際處理的是「畫面相似但實體不同」的證據搜尋問題。

KBMR 先由 EVA-CLIP-8B 篩選候選,再以 MLLM-based Semantic Discriminator 為查詢與候選產生連續的 entity-consistency weights。Qwen2-VL-7B 以這些語義訊號訓練 embedding retriever,並透過 symmetric KL distillation,令 cosine similarity 得出的 retriever posterior 與 discriminator weights 形成的 semantic prior 對齊。

重點整理為:
– 由 surface-level visual matching 改為 entity-aligned semantic retrieval。
– 連續權重可支援較可靠的 hard-negative mining 和 soft supervision。
– 替換原有 first-stage retriever,毋須改動下游 reasoning 或 reranking。
– 不同 KB-VQA pipeline 的端到端答案準確率最高提升 9.4 個百分點。

這種取捨適合已有 KB-VQA、外部知識庫和後續推理流程的研究團隊,因為 KBMR 主打 plug-and-play 替換檢索器,而不是重新設計整條系統。KBMR 列出 Python 3.10+、EVA-CLIP-8B 及 Qwen2-VL-7B 等準備項目,亦包括訓練和評估章節;目前已提供完整安裝指令、模型取得方式及獨立推理流程。

GitHub

Categories: 開源, Embedding, 視覺模型, 多模態模型, Qwen, Python

SimLoss 用單次生成多階段圖像描述

由 UMass Amherst 與 Adobe Research 團隊開發,SimLoss 想解決圖像描述太籠統的老問題。它把細節監督搬到 embedding space,換來更快推理與更高描述精細度。

Repository image for srynsh/SimLoss-Image-Captioning

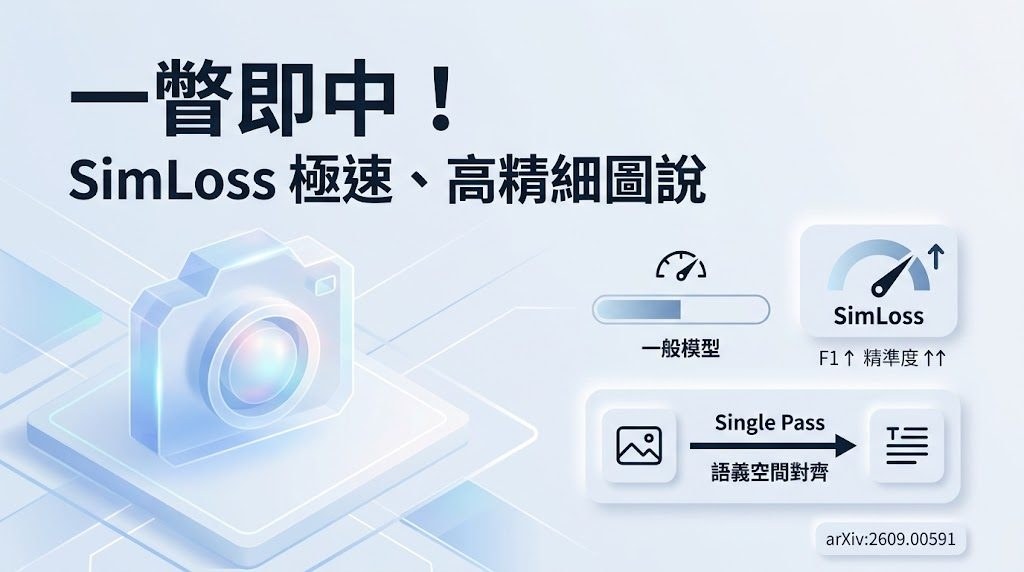
UMass Amherst 與 Adobe Research 團隊,瞄準的是圖像描述常常只講到大意、漏掉材質、數量、紋理同位置關係的問題。SimLoss 屬於影像 captioning 模型訓練方法,核心不是再加一條冗長後處理流程,而是令 Vision-Language Model 在單次生成前,先把隱藏狀態對齊影像 embedding,直接補回細節監督。

它的技術關鍵,在於用 reference-free 的 embedding-space objective 取代人手撰寫細粒度 captions,亦唔需要先跑多階段系統去製造 pseudo-captions。SimLoss 列出兩條路線:SimLoss FFT 會透過本地可用的 Qwen3-VL-Embedding-2B 反向傳播;SimLoss GRPO 則把 Gemini Embedding 2 當成 black-box reward。兩者都建基於 Qwen2.5-VL-7B-Instruct captioning policy,但前者偏向直接做表徵對齊,後者更接近以獎勵訊號微調。

同類方法常見做法,是生成、拆解、驗證、重寫逐步修補描述內容;SimLoss 揀的是保留 single-pass inference,換取更低延遲,再用對比式學習補回細節。代價是它仍然依賴外部 embedding 模型品質,而且項目展示的是研究基準與訓練框架,不是即裝即用的成品服務。

IIW-400 測試中,SimLoss FFT 配合 Qwen2.5-VL-7B backbone,把 precision 由未調整 backbone 的 0.788 提升到 0.849,F1 與多階段 CapMAS 接近到難以區分,同時推理速度約快 20 倍;SimLoss GRPO 則拿到最強 recall。呢個取捨幾實際:想要更準確地講出畫面細節,又唔想接受多步驗證延遲的團隊,會比一般 captioning fine-tune 更感受到差別。

  • 同一儲存庫放入 SimLoss、CapMAS、PAPO、DCScore RL 等基線,方便直接比較
  • 單次生成保留低延遲,同時補足 attributes、counts、textures、materials、spatial relations
  • 提供方法分目錄、資料與 checkpoint 說明,但大型資料與模型檔案未隨儲存庫附上

研究、內容理解、影像搜尋標註,甚至要為電商圖片或視覺資產建立更細緻描述的團隊,都會較容易受益。安裝與執行入口在儲存庫內有 setup 與各方法,但目前公開資訊主要指向研究復現流程;想完整重跑訓練或延遲基準,仍要另外處理資料集、checkpoint 同對應運行環境。

項目主頁 · GitHub

Categories: 開源, Embedding, 視覺模型, 多模態模型, Qwen, Gemini, Image

LightNav-0:一句說話驅動四種機械人零樣本導航

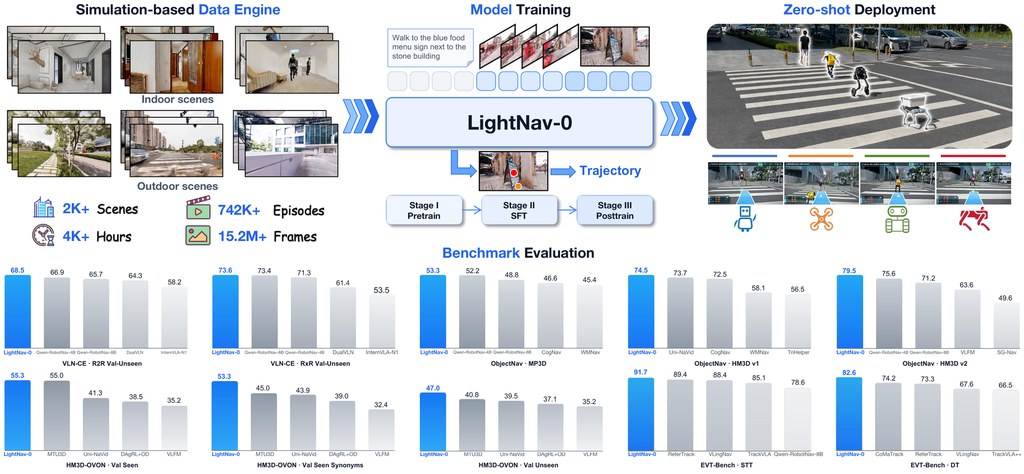
LightNav-0 是一個通用導航模型,把預訓練視覺語言模型 Qwen3-VL 的空間認知能力對齊到導航任務,無需任務專用頭即可同時處理指令跟隨、開放詞彙物件導航與視覺追蹤,並零樣本遷移到人形、四足、輪式及空中機械人。

LightNav-0 overview: a simulation-based data engine, three-stage model training, zero-shot deployment onto four robot em

你叫一部機械人「去到公園入口嗰張長椅」,佢就要自己搵到、避開障礙、仲要處理自己對眼睇到嘅畫面——LightNav-0 就係針對呢類跨場景、跨形態嘅導航需求。佢屬於模型類項目,核心想解決嘅問題係:傳統導航系統每換一種機械人或場景就要重新訓練或加任務頭,零樣本泛化能力薄弱。LightNav-0 選擇唔加 waypoint predictor、唔加任務專用動作頭,淨係擴展詞表,加入雙通道指向 token 同 RVQ 動作 token,等空間推理同動作編碼都直接由 Qwen3-VL-4B-Instruct 原有嘅自回歸 LM head 解碼。

要做到呢點,訓練數據係關鍵。項目用咗一套 Real2Sim2Real 數據引擎,將 2,000 幾個互聯網收集嘅真實場景轉成可重複使用嘅模擬環境,產生 4,000 幾個鐘嘅視覺語言動作經驗,再分三階段訓練:Embodied Reasoning 中訓練、Embodied SFT、Online RL。呢種做法繞過咗真實遙操作收集速度慢、成本高嘅瓶頸。

同典型做法比,差異在於用模擬合成代理真實經驗,再透過統一 token 介面讓指令跟隨、開放詞彙物件導航、視覺追蹤共享同一模型,部署時直接零樣本落地到四種機械人形態,唔需要逐個微調。結果方面,官方指 LightNav-0 喺十個模擬設定上取得 state-of-the-art,並喺人形、四足、無人機同輪式機械人上完成真實遷移測試。

做機械人通用導航研究嘅團隊、要做具身 AI 落地嘅初創,或者關注 Physical AGI 路線嘅研究者,會最容易從中受惠。對一般開發者嚟講,理解入口係 Hugging Face 上嘅模型權重、論文同項目頁提供嘅模擬評測結果。

重點摘要:

  • LightNav-0 係以 Qwen3-VL-4B-Instruct 為骨幹嘅通用導航模型,無任務專用預測頭
  • 用統一 token 介面同時覆蓋指令跟隨、開放詞彙物件導航同視覺追蹤
  • Real2Sim2Real 數據引擎將 2,000+ 真實場景轉化為 4,000+ 小時訓練經驗
  • 三階段訓練流程:Embodied Reasoning 中訓練、Embodied SFT、Online RL
  • 零樣本遷移至人形、四足、輪式及空中機械人,喺十個模擬基準宣稱達到 SOTA

項目主頁 · GitHub

Categories: 開源, 視覺模型, 多模態模型, Qwen, World-Action Model, Robotic, AGI

Lucida:用「解析、生成、放置」三步把實景變成可編輯的模擬場景

字節跳動 Seed 團隊把真實室內環境拆解成獨立物件資產,透過閉環姿態修正讓重建結果能直接用於模擬。

Og image

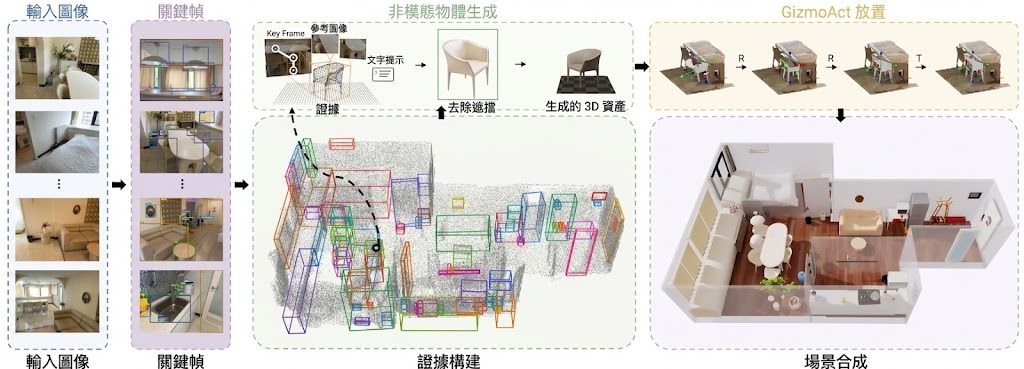
從一段真實拍攝的室內影片,要還原成可以模擬、可逐個編輯嘅場景,一直都係 3D 重建嘅痛點:擺位、遮擋同殘缺幾何往往令資產難以重用。Lucida 就係針對呢個矛盾提出嘅方案,屬於實景到模擬(real-to-sim)類嘅場景建模系統。

整個流程分成三步。第一步 Parse 揀選有用嘅關鍵幀,跨視角對應實例並建立場景圖,輸出遮擋、局部點雲同參考視圖等證據。第二步 Generate 利用每組證據合成無遮擋嘅物件影像,再提升成完整、可編輯嘅 3D 資產。第三步 Place 先粗略初始化,再用 GizmoAct 喺閉環中反覆執行姿態編輯,直到渲染結果同觀察對齊。

GizmoAct 係呢套系統嘅核心控制器,由視覺語言模型(VLM)操作 3D 編輯器,每一步根據渲染觀察、點雲疊加同正交視圖等線索,落一個可執行嘅姿態修正。同一條策略可應付由 Boxer、Any6D* 到 SAM 3D 等不同初始化,並以最多 4 個視圖同 12 步修正完成對齊。

Lucida 喺 R2S、CA-1M 同 Aria Digital Twin 數據集上都提升咗場景級 3D 物件檢測、姿態估計同完整場景重建指標。重建出嚟嘅場景以一組獨立、可編輯嘅 mesh 呈現,每件物件都準備好進入模擬階段。

對從事機器人模擬、室內數據合成或場景理解嘅團隊,呢套閉環做法比起傳統單次擬合更能容忍幾何誤差同遮擋問題,令實景資產更易直接落落去模擬器使用。

重點摘要

  • 三步流程:Parse、Generate、Place 把實景拆解成可重用物件資產
  • GizmoAct 閉環修正:VLM 操作 3D 編輯器,反覆落姿態編輯直到對齊
  • 初始化容忍度高:同一策略兼容 Boxer、Any6D*、SAM 3D 等不同起點
  • 輸出可直接模擬:每件物件係獨立、可編輯 mesh
  • 多數據集提升:喺 R2S、CA-1M、Aria Digital Twin 都有指標改進

項目主頁

Categories: 北京大學, 字節跳動, 視覺模型, Video, Image, 3D

VLA 模型只學動作不夠,INDI 把「意圖」蒸進解碼器

POSTECH 提出的 INDI 框架,將行為意圖從凍結的教師視覺語言模型蒸餾到 VLA 動作解碼器,讓機器人部署時不需教師也能自主推斷行為目標。

Repository image for Leesangoh/INDI

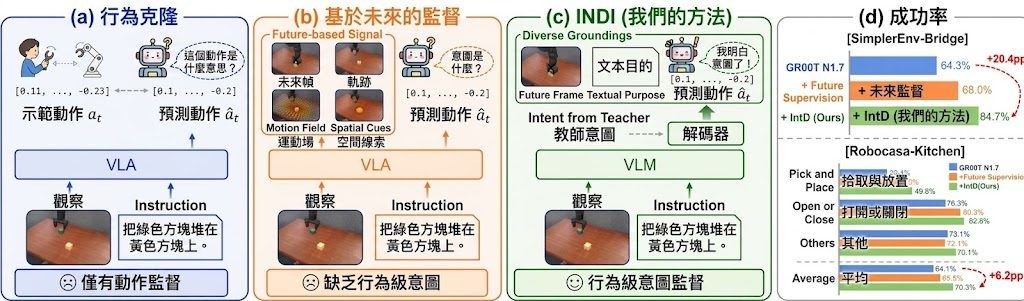
機械人模仿學習長期面對一個老問題:VLA(Vision-Language-Action)模型靠行為克隆訓練時,往往只學到「要做出什麼動作」,卻忽略了「為什麼要做這個動作」。POSTECH 團隊提出的 INDI(Intention Distillation),正正想修補這個缺口。

做法上,訓練期間會有一個凍結的教師視覺語言模型(VLM),負責將示範片段解讀為意圖表徵;動作解碼器則在中間層同時學習還原這個意圖與預測動作。部署階段不需要帶著教師模型,策略網絡自己就能從標準 VLA 輸入還原意圖並執行。對比傳統行為克隆或加入未來幀、軌跡這類「未來監督」做法,INDI 蒸餾的是行為背後的共同語義目標,而非某一種可能的實現。

實驗結果顯示,INDI 將 GR00T-N1.7 在 SimplerEnv-Bridge 的成功率由 64.3% 提升至 84.7%,在 RoboCasa Kitchen 也由 64.1% 升至 70.3%,π0.5 兩個基準皆有穩定增長。真實機械人任務平均成功率由 62.0% 提升至 68.7%,長時序任務最高有 12 個百分點的改善。研究團隊亦驗證還原出的潛在變量確實被解碼器使用,並能捕捉行為目標與執行進度。

對從事機械人基礎模型、VLA 微調,或關注長時序操作任務的團隊而言,INDI 提供了一條不增加部署成本、只改訓練目標的改良路徑。

INDI 重點摘要:

  • 意圖蒸餾而非動作模仿:用凍結教師 VLM 把行為意圖蒸進解碼器中間層
  • 部署零負擔:推理階段不需要教師模型,策略網絡自行還原意圖
  • 跨基準穩定提升:GR00T-N1.7 與 π0.5 在 SimplerEnv-Bridge、RoboCasa 皆有增長
  • 真實場域驗證:真機任務平均成功率提升約 6.7 個百分點,長時序任務最高 +12pp
  • 潛在變量可解讀:還原出的中間表徵與行為目標、執行進度高度相關

項目主頁 · GitHub

Categories: 開源, 視覺模型, 多模態模型, VLA, Robotic, 框架

GeoNeXt 把影片生成模型當幾何學習:統一深度與法向量估計

GeoNeXt 把現成的影片生成模型改造成單一架構,同時預測單目深度與表面法向量;只需五萬九千筆訓練樣本,就能做到跨場景的零樣本遷移。

GeoNeXt framework

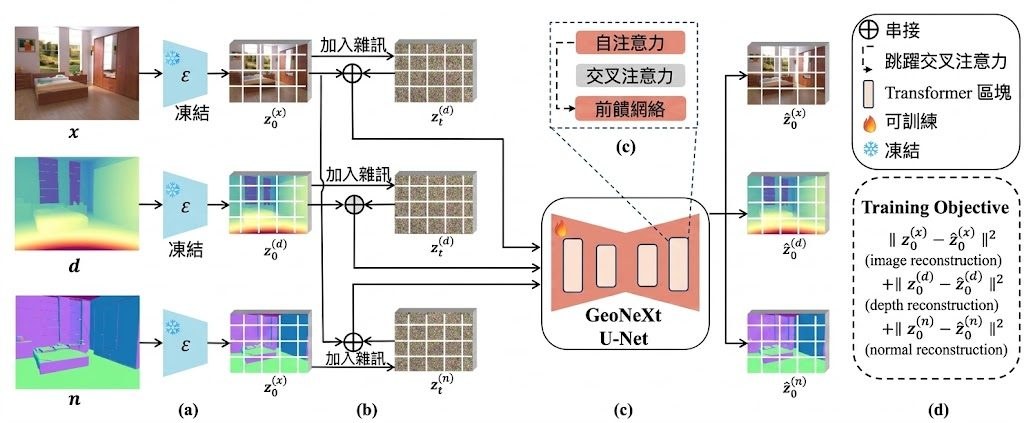
過往要從一張 RGB 影像同時取得深度圖與表面法向量,往往要靠兩個獨立網路串接,幾何一致性也容易在接縫處走樣。GeoNeXt 的切入點是把這些幾何訊號當成影片生成模型的「下一幀」:以 Stable Video Diffusion 為骨幹,把 RGB、深度、法向量一起送進 VAE 潛空間,在同一條去噪軌跡上共同生成,讓外觀與幾何從訓練開始就互相對齊。

兩個權重版本都放在 Hugging Face:GeoNeXt-Wan 約 1.42B 參數,GeoNeXt-SVD 約 1.52B 參數,兩者都能輸出深度與法向量。本地跑推論需要一張 24 GB VRAM 的 CUDA GPU,並透過 Conda 建立獨立環境;首次執行會自動從 Hub 下載所需的 checkpoint、base model 與 VAE,之後會從本地快取載入,因此斷網或重複測試時可直接用 –checkpoint、–base-model、–vae-model 指向本地檔案。

從應用角度,3D 重建、AR/VR 場景理解、機器人視覺等需要一致幾何的工作流都會受惠;研究員也能把它當作零樣本基準,與 GeoWizard 等專用模型直接比較深度、法向量及重建網格品質。

重點摘要:

  • 新意:把幾何估計重新表述為影片模型的下一幀預測,讓 RGB、深度、法向量共享同一條去噪軌跡。
  • 規模:以 Stable Video Diffusion 為基礎,提供 Wan 與 SVD 兩組約 1.4B–1.5B 參數的權重。
  • 數據效率:只用 59K 訓練樣本,就在多個基準上做到強健的零樣本泛化。
  • 硬體門檻:24 GB VRAM 的 CUDA GPU 即可推論,兩個版本需分開建立 Conda 環境。
  • 差異:相比串接兩個專用網路,單一模型同時輸出深度與法向量,有助於改善跨通道的一致性。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 世界模型, Video, Robotic, 3D, Dataset 數據集

ABot-Recon 用 12 幀極簡局部記憶重建 3D

AMAP CVLab 提出的 ABot-Recon 放棄複雜的長程記憶機制,改用固定的 12 幀局部上下文,逐步拼接出穩定的長影片 3D 重建結果。

ABot-Recon long-horizon reconstruction teaser

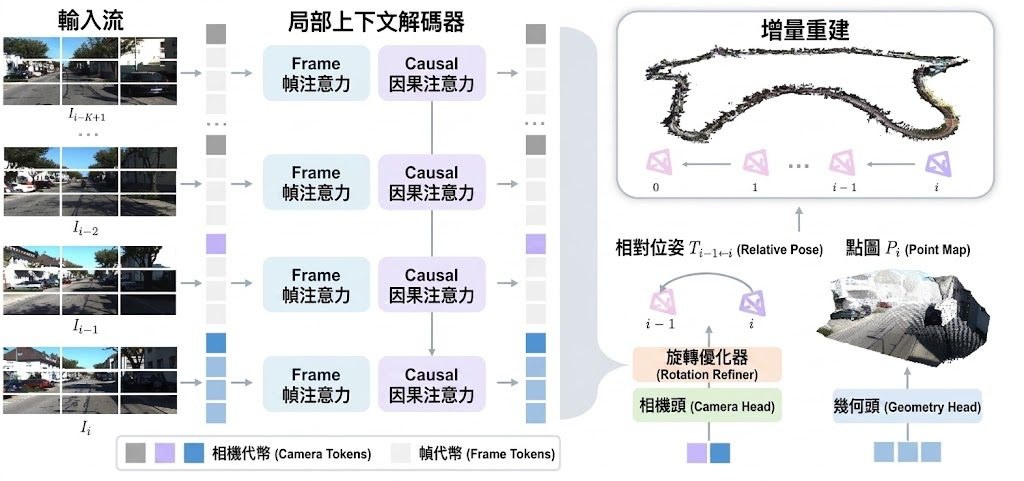
ABot-Recon 是一款專為長影片流(streaming)設計的 3D 重建框架,來自阿里 AMAP CVLab。它選擇了一條反潮流的路線:不堆疊長程記憶模組,而是用固定的 12 幀局部上下文,邊看邊重建。對於自駕車、機器人或 AR 導航這類需要持續處理長影片的場景,直接解決了「序列越長、記憶越爆」的核心痛點。

運作上,模型每一幀只參考前 11 幀的 KV 特徵,預測當前幀的點圖(point map)與相鄰幀的相對位姿,再透過位姿串接逐步還原出全域軌跡與點雲。這意味著模型狀態記憶與單幀計算量都不會隨影片長度增長,硬體門檻更容易控制。

與傳統做法相比,ABot-Recon 刻意避開了持久學習式長程記憶,用一個輕量的 motion-visual rotation refiner 和 composition-aware pose loss 來壓制位姿累積誤差,把「記憶」的責任還給幾何拼接本身。

這套做法適合需要長時間穩定重建、又不想被龐大 GPU 記憶體綁架的團隊,例如自駕資料處理、機器人 SLAM 或城市級掃描項目。Hugging Face 與 ModelScope 已有現成 Demo 可即時試玩,模型權重同步開源;訓練代碼與完整訓練方案預計於 9 月 30 日前釋出。

重點摘要:
– 固定 12 幀局部上下文,拒絕堆疊長程記憶
– 記憶與單幀計算量與序列長度解耦
– 以位姿拼接 + 旋轉優化抑制長距離誤差累積
– Hugging Face / ModelScope 提供線上 Demo
– 訓練代碼與配方預計 9 月 30 日前開源

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 世界模型, Robotic, 3D

Page 5 of 23
1 … 3 4 5 6 7 … 23