四步生成同步音畫:FastH3 預覽模型拆解

非官放加速 MiniMax FastH3 以四次 Transformer forward 生成同步影片與音訊,但需要專用 VSA-H3 後端及多張高階 GPU。

Og image

文字提示輸入後,FastVideo-FastH3-4-step-Preview-v1-VSA-DataFree 可在四次 Transformer forward 內生成同步影片與音訊,適合測試快速 text-to-audio-video 工作流程。模型明確基於 MiniMaxAI/MiniMax-H3 微調及蒸餾,並以 data-free DMD2 和 VSA-H3 訓練至 step 1300,在 90% sparsity 下換取較少取樣步驟。

模型需要 FastVideo 的 VSA-H3 attention backend,不能只下載權重後以一般推論工具直接執行。官方測試配置使用四張 B200 GPU;其他多 GPU CUDA 系統可改用 Triton kernel,但 GPU 數量必須能整除 H3 的 56 個 attention heads。頁面沒有提供 llama.cpp、Ollama 或 LM Studio 支援,也沒有列出 GGUF 檔案、量化級別、檔案大小或 mmproj 附加檔案,因此不能據此建議 Q4_K_M 或其他量化方案。

  • 四次 forward 生成音訊與影片,速度取向明確
  • DMD2、VSA-H3 及 90% sparsity 用於 data-free 蒸餾
  • 目前只支援 text-to-audio-video,FL2VA 和 Ref2VA 尚未蒸餾
  • 困難動作、細節及部分音訊可能不及 MiniMax H3 base model
  • 頁面未提及 MTP draft speculation、v2 更新或檔名變更

這個 Preview checkpoint 仍可能在動態、細節和音訊穩定度上落後原始 MiniMax H3,定位較接近快速生成與研究測試版本。使用時要留意 MiniMax H3 Community License,以及 FastVideo 安裝流程對 CUDA 13、Blackwell 路徑和專用 kernel wheel 的要求。
模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, MiniMax

MMLVE-Agent 點樣唔再搞亂多鏡頭影片

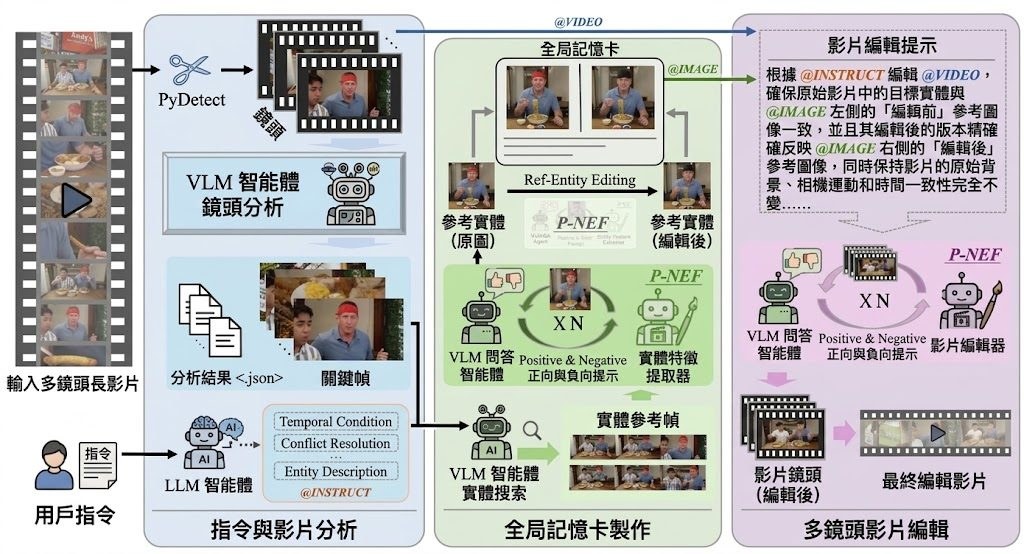
過往 AI 影片編輯碰到多鏡頭長片就容易認錯人、漏改背景。MMLVE-Agent 用 LLM 與 VLM 協作,把每個鏡頭拆開處理,再靠全局記憶鎖住主體身份。

MMLVE-Agent framework

用一句「將男人嘅紅色衫變成藍色」就改完成條片、每個鏡頭都認得返同一個人——呢個係南開大學同騰訊團隊提出嘅 MMLVE-Agent 想要解決嘅痛點。過往影片編輯模型主要處理單鏡頭或幾秒短片,落到幾分鐘、橫跨多個鏡頭嘅長片就容易出現主體身份斷裂、編輯幻覺同時間連續性受損。呢個項目本質係一個異構多智能體框架,結合 LLM 做指令解析、VLM 做鏡頭級拆解同評估,再透過全局記憶卡(Global Memory Card)將 top-k 關鍵幀合成統一參考,確保主體身份唔會跨鏡頭走樣。

團隊同時定義咗 MMLVE 任務嘅三個核心目標:跨鏡頭編輯一致性(CSEC)、多指令解耦(MID)以及對非目標區域嘅零破壞(ZDSS)。其中 Pos-Neg Editing Feedback(P-NEF)令 VLM 評估器可以同時輸出負向提示同正向提示,主動修正錯誤同時保留應有細節,取代坊間常見嘅單向反饋機制。佢哋亦同步推出 MMLVE-Bench 數據集,涵蓋密集異質指令同稀疏隨機分佈嘅實體,對應真實影片剪接場景。

團隊聲稱喺呢個基準上超越咗 Seedance 2.0 等閉源方案,特別喺消除編輯幻覺同保持時空連貫性方面。不過要留意,原始資料只提供項目頁、論文同 benchmark 數據集,並無公開模型權重或安裝入口,想實際部署嘅讀者需要留意後續開源進度。

重點摘要:

  • MMLVE-Agent 係一個多智能體影片編輯框架,專門處理多鏡頭長片嘅自然語言指令編輯
  • 核心創新在於全局記憶卡同正負反饋機制,前者鎖定跨鏡頭主體身份,後者主動修正編輯錯誤
  • 同步推出 MMLVE-Bench 數據集,涵蓋高密度指令同稀疏實體分佈等真實場景
  • 團隊報告在自建基準上超越 Seedance 2.0 等閉源方案
  • 原始資料未提供模型下載或部署方式,實際可用性有待後續開源進度確認

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 視覺模型, 影像處理, Dataset 數據集

Video-IFBench:跟足要求的影片評測

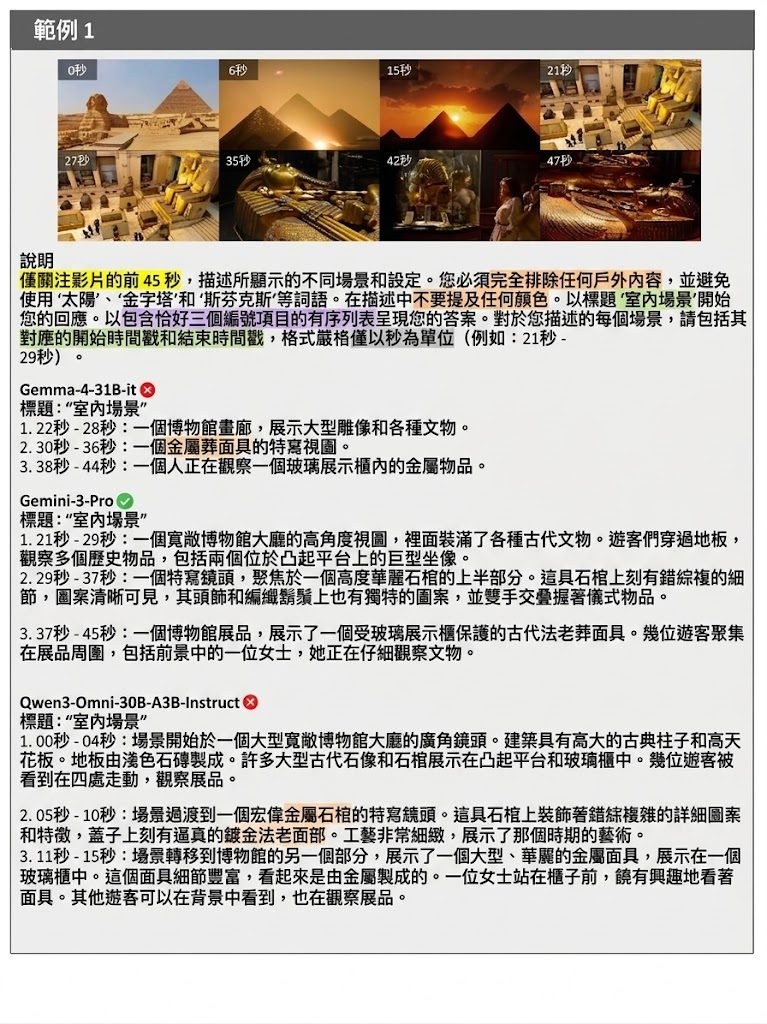
Video-IFBench 用來量度多模態大語言模型在影片理解場景中的指令跟隨能力。它把單步、多步、選擇和嵌套指令拆開測,直接看模型能否按條件做對。

Overview of the Video-IFBench construction and evaluation pipeline

Video-IFBench 是一個用來評測多模態大語言模型(Multimodal Large Language Models, MLLMs)在影片理解場景中是否跟足指令的資料集與基準。它處理的不是單純看懂影片,而是模型能否在複雜限制下,依照影片證據作出正確分支判斷、完成多重要求,並保持輸出格式一致。

這套基準把任務分成 Single、Multi、Selection 和 Nested 四類,覆蓋由簡單到層層加條件的情境。項目建構流程結合影片標註、任務與限制採樣、複雜指令生成、checklist、程序化處理和人工驗證,適合拿來測試模型在真實工作流裡會否因為條件一多就失手。

和一般只看整體問答正確率的影片基準相比,Video-IFBench 更著重嚴格遵循指令的程度。資料集同時提供 TCSR 和 TISR 兩種指標,結果顯示即使是頂級商用模型,遇到條件累積或需要按證據選分支的題目,分數也會明顯下滑;開源模型的差距更大,尤其在 Nested 類別。

對做影片理解、視覺問答、agent 評測,或者需要檢查模型能否按規則輸出內容的團隊,這個基準很有參考價值。它不只看模型「知唔知」,而是看模型「有冇照做」,這正是很多落地應用最容易出問題的位置。

  • 覆蓋影片理解中的四種指令型態,從單步到嵌套條件都有測。
  • 以 checklist 和人工驗證強化標註可靠度。
  • 用 TCSR 與 TISR 分開看內容命中與指令跟隨。
  • 商用模型整體較強,但複雜條件下仍有明顯失分。
  • 開源模型在多條件、分支選擇和格式遵循上差距更大。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 字節跳動, 騰訊, Agentic, 視覺模型, 多模態模型, Video, Dataset 數據集

StreamPI 機械人模型的記憶系統

StreamPI 為單幀 Vision-Language-Action 模型加入記憶與幾何線索,並將多幀推理的延遲增幅壓至較低水平。

Overview of the StreamPI architecture and streaming inference workflow

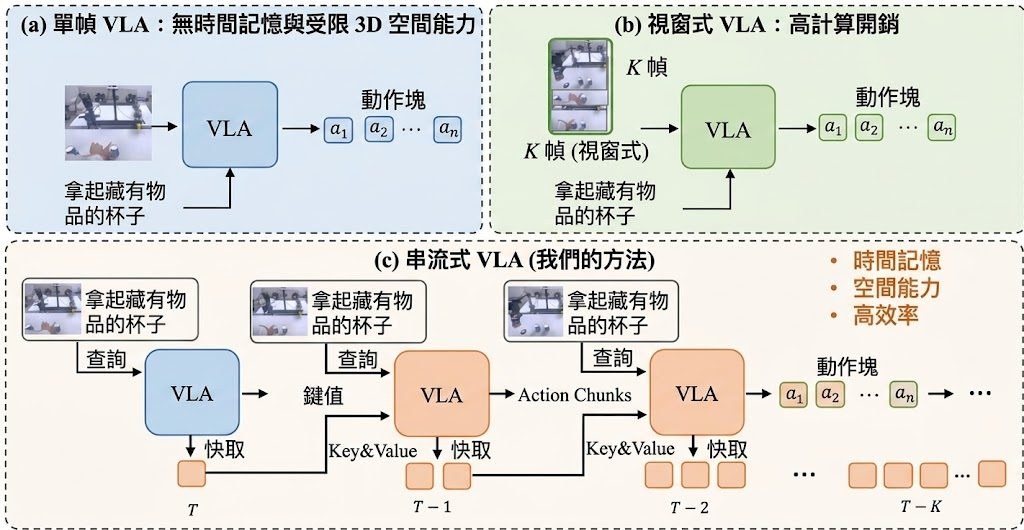
機械人執行抓取、插入等連續任務時,只看當前畫面容易失去物件位置變化;StreamPI 將每組視覺觀察與語言指令視為一個時序單元,屬於為 Vision-Language-Action (VLA) 模型加入串流時序推理能力的框架,針對的正是單幀 π₀.₅ 無法保留歷史觀察的限制。

它沒有額外加入模型參數,而是把多組 token 接在同一序列,再用 block-wise attention mask 控制資訊流。每個單元內採用雙向注意力,讓視覺與語言充分融合;單元之間採用因果注意力,配合 KV cache 保留過去內容,避免每次重新處理完整歷史。重複放入語言指令亦可令任務目標在視覺內容增加後保持清晰。

  • 以預訓練單幀模型延伸至單幀或多幀推理
  • 不增加參數,支援彈性上下文長度
  • 以 random-interval sampling 配合 temporal masking,模擬非固定觀察時間
  • KV cache 適合串流推理及非同步機械人控制
  • RTX 4090 由一幀增至五幀,平均延遲只由 94.4 ms 升至 103.6 ms

訓練時加入隨機幀間隔,讓模型接觸不同觀察節奏;研究資料亦提到每三幀取樣可令動作更快、更平順。這比固定時間同步的訓練更貼近真實機械人環境,但效果仍取決於感測器頻率、控制週期及任務本身,不能只以幀數推斷所有場景都會改善。

項目建基於 openpi,並提供 JAX multi-node distributed training 的額外支援;README 同時列出 real-robot 任務及示範影片。現有資料未提供完整安裝流程、可直接下載的模型權重或測試指令,官方項目頁只表示程式碼及權重預定於 2026 年 8 月 30 日公開,因此目前較適合機械人研究團隊參考其架構和評測方向,而非當作即時可用的套件。

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, 香港, Dataset 數據集

GigaBrain-0.7 讓機械人跨場景理解並執行任務

由家居整理到工業操作,GigaBrain-0.7嘗試令機械人適應更多身體形態與工作環境。

GigaBrain-0 Overview

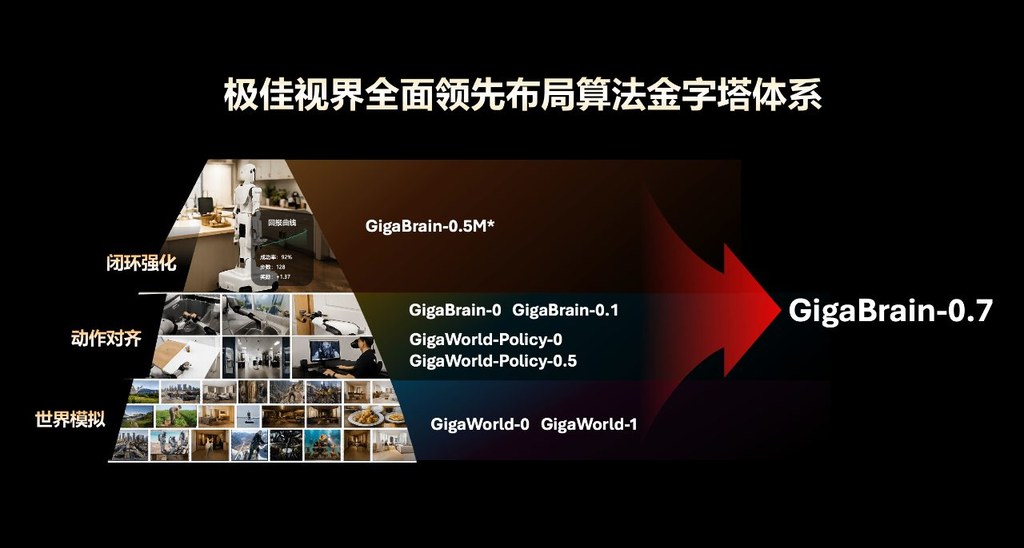
由家居整理到工業操作,機械人要面對的不只是看懂畫面,還要理解指令、預測下一步並控制不同硬件。GigaBrain-0.7 屬於 Vision-language-action (VLA) embodied foundation model,透過統一 understanding、prediction 與 action,處理跨任務及跨機械人形態的泛化問題。

項目以 three-system architecture 組織模型能力,並把預訓練資料擴展至超過 37,000 小時的異質 embodied data,再以 one-stage alignment training 同時優化 vision-language understanding 和 multi-embodiment action generation。相比 GigaBrain-0 系列及包括 π 0.5 在內的先進模型,開發團隊聲稱它在 foundation zero-shot capabilities、language-conditioned instruction following 及 post-training task success rates 均有明顯提升。

GigaBrain-0.7 已提供程式碼、模型和 sample data,模型及資料亦連接至 Hugging Face;但 VLM evaluation code、RoboColiseum、RoboTwin2.0 和 EBench benchmark code 仍列在待辦清單。這代表項目適合研究團隊先重現流程及測試資料管線,未必已具備完整、即插即用的標準化評測環境。

讀者可從以下幾點理解其價值與取捨:
– 支援多種機械人形態,目標是提升跨硬件泛化能力。
– Maker H01 及主流機械人平台涵蓋家居和工業場景。
– 大規模異質資料有助擴闊任務範圍,但亦提高訓練及硬件需求。
– 開放程式碼、模型與樣本資料,方便研究及二次開發。

對機械人研究、具身智能及需要跨平台控制的團隊,GigaBrain-0.7提供了較完整的模型、資料與訓練實作入口;商業落地仍需自行驗證安全性、硬件兼容性、延遲及長時間任務穩定度。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, Dataset 數據集

VA-Judger 生成更貼近人類偏好的影片與聲音

VA-Judger 以人類偏好比較影片和聲音生成結果,改善單靠獨立指標造成的失真與獎勵錯配。

VA-Judger training pipeline

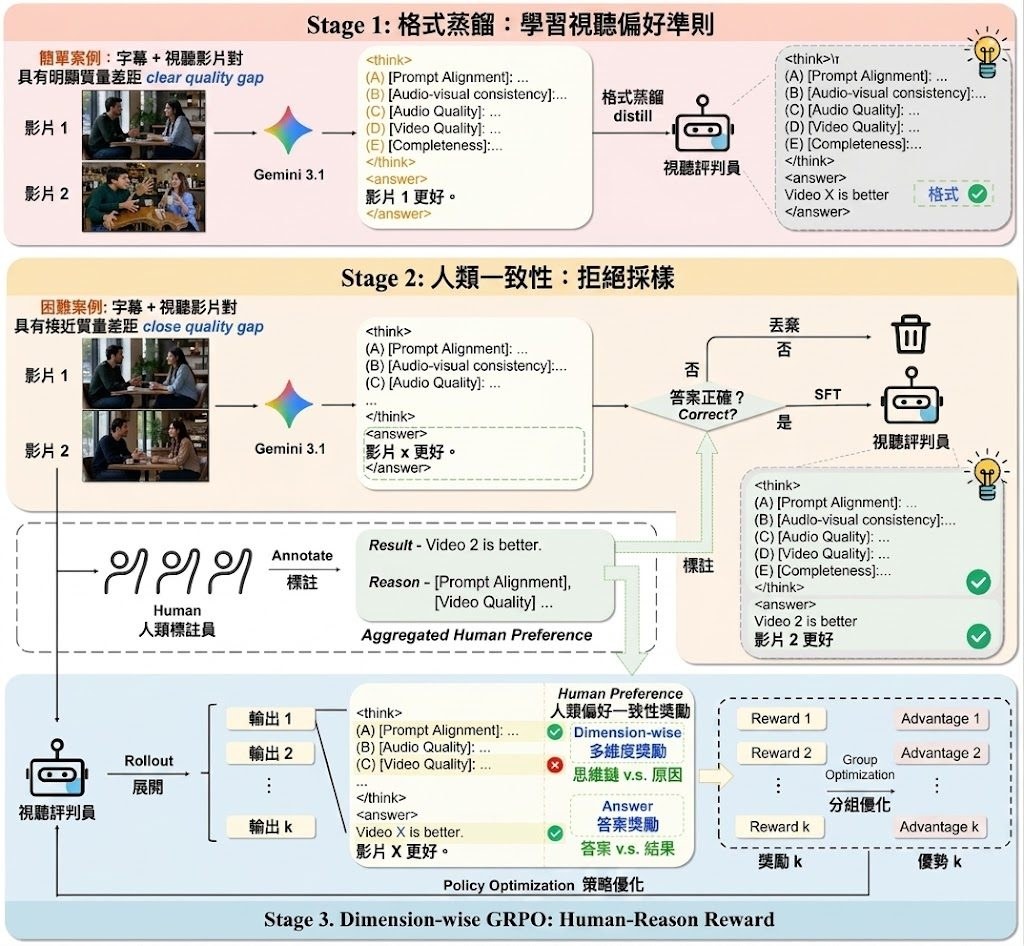
同一個提示詞產生兩段影音內容時,VA-Judger會比較哪一段更符合人類偏好,並拆解提示詞對齊、影音一致性、音質、畫質及內容完整度。它屬於聯合影片與音訊生成的 Reward Model,處理傳統指標難以捕捉整體連貫性的問題。

模型以 Qwen3-Omni 為基礎,先從品質差距明顯的配對學習比較準則,再透過拒絕採樣處理接近的結果,最後以 dimension-wise Group Relative Policy Optimization(GRPO)把人類回饋分配到不同品質維度。這比把音質、畫質及同步指標簡單相加更貼近觀看者的整體判斷,也減少生成模型鑽指標漏洞的機會。

VA-Judger-Bench包含同領域及跨領域模型比較,用來測試 Reward Model 是否能對齊人類選擇;研究結果指向它優於多項指標基線。VAPref-10K則包含9K提示詞及10.3K組細緻的影音配對比較,但資料集及部分訓練程式仍未發布。

項目提供 Reward Model 推理、Video Model 推理、模型 SFT,以及以 VA-Judger 分數優化 LTX-2 的流程;README亦列出合併已發布 RL LoRA 的 LTX-2 checkpoint。提供的資料沒有列出完整安裝步驟,使用者需要按項目頁面、checkpoint及程式碼狀態自行確認環境。

  • 適合場景:研究影音生成、偏好對齊及 RL post-training 的團隊
  • 可評估內容:提示詞對齊、影音一致性、音質、畫質及內容完整度
  • 主要取捨:比較人類偏好的方法較全面,但需要配對資料及額外訓練流程
  • 目前限制:dimension-wise GRPO 程式碼及 VAPref-10K 仍列為待發布項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 視頻模型, 模型訓練, Qwen, Video, LTX, Dataset 數據集

NVidia Hydra-0 以人類動作統一機械人訓練

Hydra-0把機械人動作轉成畫面上的像素流,讓同一個世界模型學習不同機械人形態,並支援模擬、策略評估及真機控制。

Og image

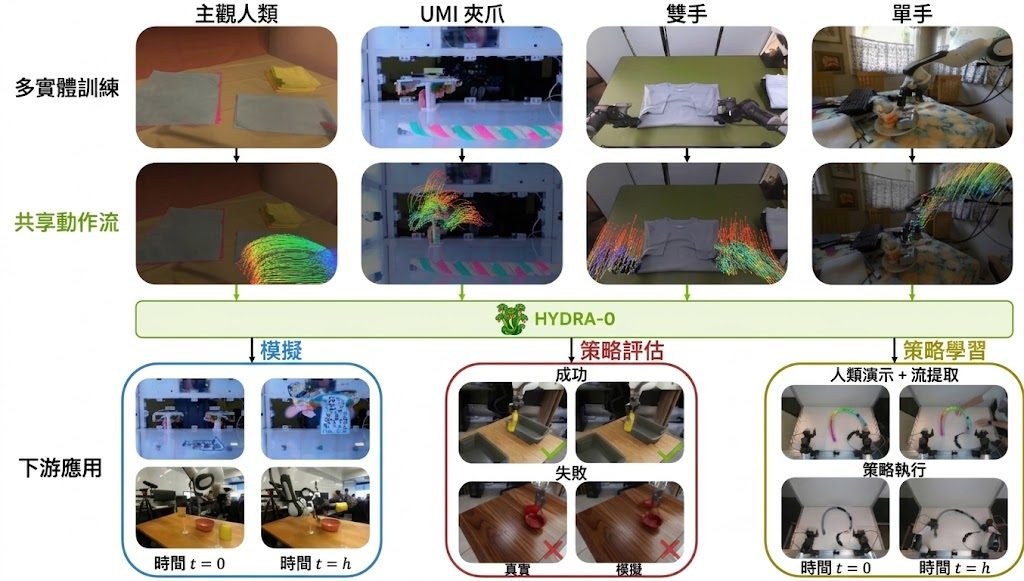
機械人面對不同手臂結構、夾具和操作環境時,動作通常以各自的關節或末端執行器座標表示,令資料難以共用。Hydra-0以 Action Flow 將可見的機械人運動表示成影像平面上的像素流,建立跨形態、任務和環境的共同控制介面,屬於面向通用控制的 world model。

Hydra-0在運行時採用 hybrid simulator:physics engine 負責移動機械人,learned video model 則預測動作對場景造成的變化。模型可從 egocentric human demonstrations、handheld UMI grippers、single-arm robots 和 bimanual robot arms 等互動影片學習,減少依賴單一機械人平台資料的限制。

Forward mode會根據 gripper flow 預測未來場景,生成的結果可用於 open-loop policy evaluation;inverse mode則由目標物件的 flow 推導相容的機械人運動,再透過 supervised readout 轉換成可執行動作。把模擬、策略測試和控制放進同一套模型流程。

• 以像素流統一四種不同 embodiment 的互動資料
• 同時支援世界預測、策略評估及機械人控制
• 以 physics engine 和 learned video model 組成 hybrid simulator
• 最佳配置令 robot-motion error 降低90.4%,object-motion error 降低60.2%,比較基準為 action-conditioned baseline

Hydra-0適合需要整合多來源示範影片、先在模擬環境測試策略,再連接真實機械人的研究和開發工作。它仍然依賴動作影片、像素流表示和模型預測的準確度,跨形態轉移能否在更多任務中保持穩定,仍要配合完整數據和真機測試判斷。

項目主頁

Categories: 視覺模型, 世界模型, NVIDIA, Video, Image, World-Action Model, Robotic

[技術文章] RecVerse 讓購物代理更像真人行為

RecVerse以分層記憶和整段軌跡訓練,模擬更貼近真人的網上購物流程。

Hero image preview

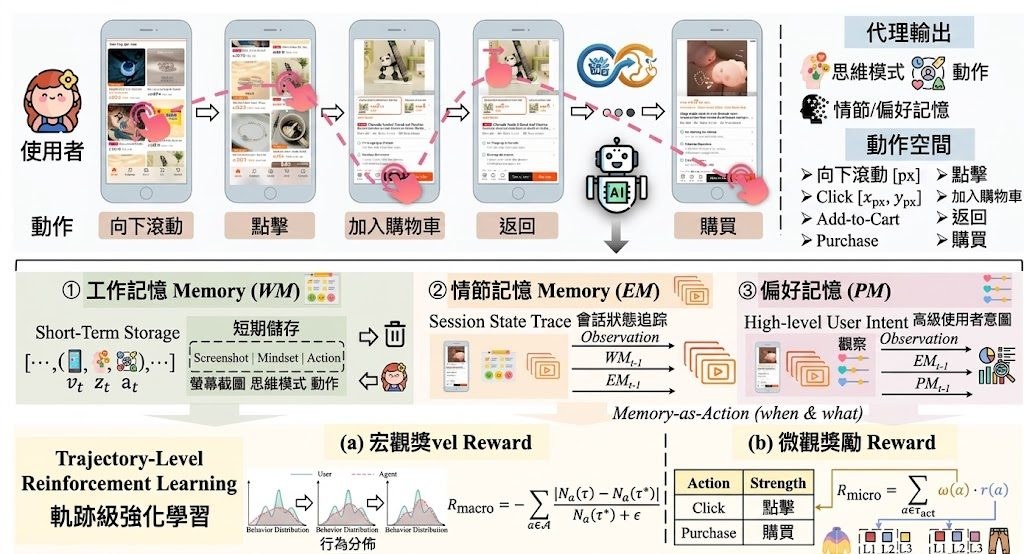
網上購物模擬器要重現真人由瀏覽、比較到購買的連續決定,才能支援推薦系統的離線測試和 Reinforcement Learning(RL)訓練。RecVerse 是一個以 GUI 為基礎的模擬代理,透過螢幕截圖理解頁面,生成多輪購物軌跡,處理長時間瀏覽中用戶狀態不斷變化的問題。

現有做法各有缺口:Rule-based simulators 依賴向量化商品特徵和預設行動空間,難以涵蓋複雜的電商介面;Large Language Models(LLMs)和 Vision-Language Models(VLMs)代理雖然加入推理及 persona 建模,長會話仍可能丟失早期觀察,或者把所有歷史硬塞進 context window。逐步模仿每個已記錄行動,亦可能令整段流程出現過度探索或過分被動等不自然模式。

RecVerse以認知啟發的分層記憶處理長期資訊,包括短期焦點用的 Working Memory、保存本次會話軌跡的 Episodic Memory,以及記錄高層次意圖的 Preference Memory。記憶更新本身被視為行動,代理可以按情況學習何時及應該保存哪些資訊。

訓練時,系統改用 trajectory-level RL,直接為完整購物會話評分,同時對齊真人的宏觀行動類型分佈和微觀購物意圖。研究團隊亦發布 USB(UserSimulationBenchmark)互動式電商 GUI 軌跡數據集;實驗結果指 RecVerse 在行為忠實度和意圖一致性上均優於現有基線。

  • 以螢幕截圖理解電商 GUI,生成多輪購物行為
  • 透過三層記憶保留短期焦點、會話經歷和用戶偏好
  • 用完整軌跡目標修正逐步模仿帶來的不自然行為
  • USB 提供互動式電商 GUI 軌跡數據集
  • 可用於推薦策略的離線及反事實測試

Paper

Categories: 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, 中國

RapidLiDAR:單次前向傳播做到 10 Hz 嘅 LiDAR 場景補全

佢將稀疏嘅部分點雲一次性還原成稠密場景,主打即時同可調速度,適合對延遲敏感嘅自動駕駛同機器人開發者。

Repository image for AzharSindhi/RapidLiDAR

對做自動駕駛或機械人感知嘅人嚟講,LiDAR 場景補全最頭痛嘅唔係質素,而係慢——好多現有方法要幾百毫秒先出一幀,根本追唔上車規或即時反應嘅需求。RapidLiDAR 嘅定位就喺呢度:佢設計成一個端到端、單次前向傳播嘅補全模型,目標係跑到接近 10 Hz,同時保留可調速度同可調節輸出密度嘅彈性。

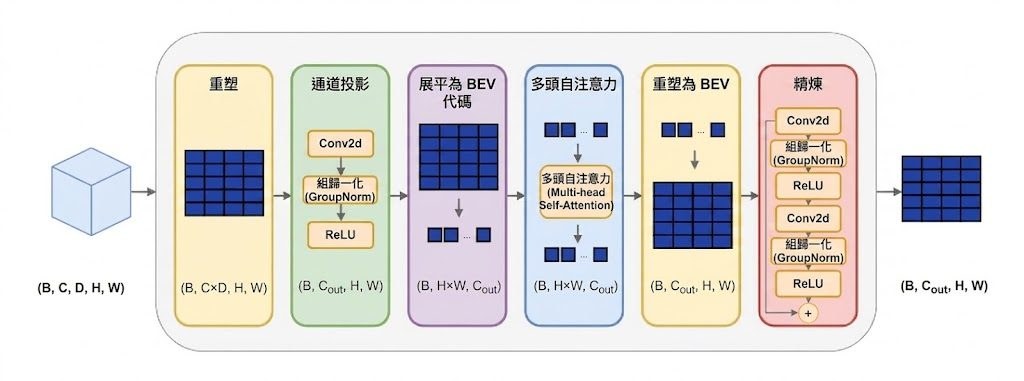
做法上,佢先用體素化抽取多尺度 3D 特徵,再透過一個自注意力 BEV 頭產生密集 2D 特徵圖。Adaptive Initialization Module 會預測一個空間變化嘅位移,把稀疏點雲「撐開」做粗略初始化;之後 Multi-Scale Reconstruction Module 用可變形注意力(deformable attention)將每點特徵同多尺度 BEV 特徵對齊做精修。如果想再稠密仲可以加一個可選嘅 Refinement Network 喺凍結嘅主模型上做上採樣,倍率為 κ。

換句話講,舊方法通常分開做初始化同迭代 refinement,或者用兩階段網絡先粗後細;RapidLiDAR 將呢幾步壓入一次前向,靠 BEV 座標化同可變形注意力同時兼顧效率同幾何一致性。代價係依賴 SemanticKITTI 風格嘅資料 loader,需要 .npy 格式嘅 GT 同 input 配對,唔係 out-of-the-box 處理原始 Velodyne 掃描。

適合做自動駕駛 stack、實時 SLAM、機械人感知原型,或者想喺邊緣裝置上試稠密 LiDAR 預測嘅團隊。原文強調即時性為 10 Hz,具體 mIoU 或 Chamfer distance 等數字未在 README 完整列出,安裝需 CUDA 12.4 同 PyTorch 2.4.1,並要自行 JIT 編譯 Chamfer distance CUDA extension。

GitHub · Paper

Categories: 開源, 模型, 視覺模型, NVIDIA, Robotic, 3D, Python, Dataset 數據集

SemComp-Bench:影片生成評測由「似樣」走向真正完成任務

SemComp-Bench 不只看生成影片是否逼真,還檢查指定結果有否完成,以及關鍵語義是否仍然保留。

Repository image for Kelly372/SemComp-Bench

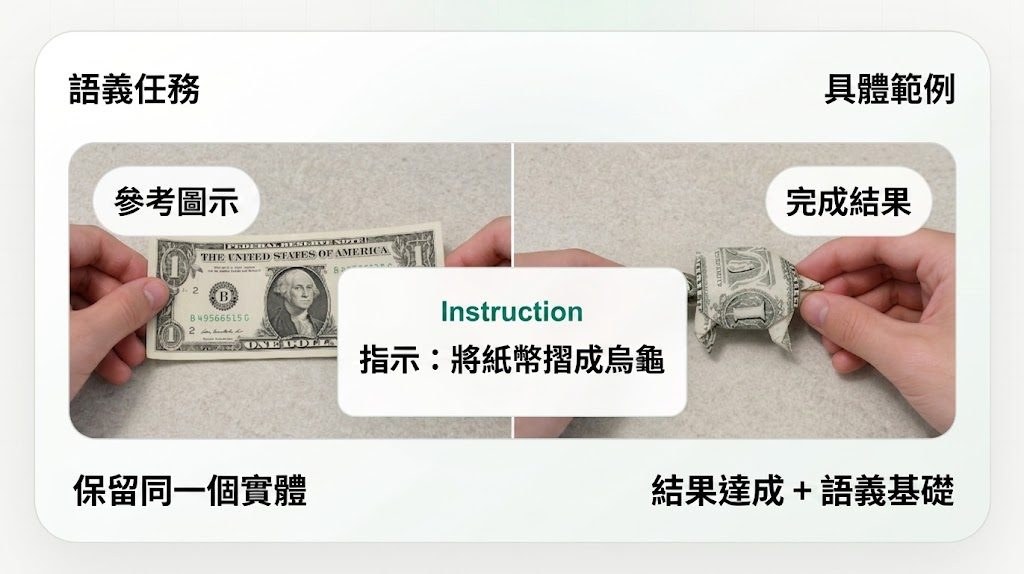
一段影片畫面流暢、物件外觀相近,不代表它真的完成了指令。SemComp-Bench(Benchmarking Semantic Task Completion in Video Generation)把評測焦點放在「結果有否做到」和「是否仍然保留與任務相關的語義」;GitHub 項目則是一套用來建立 SemComp-Data 的資料處理管線,處理影片篩選、狀態定位、指令整理和結果標註。

由原始影片到可評測資料,流程分成 9 個階段:先按標題過濾及分類任務,再定位 reference frame 與 outcome state,檢查畫面質素和狀態順序,產生中英雙語的簡短及詳細指令,最後抽取 outcome-centric clips、標註 semantic alignment types,並描述結果狀態。這種做法把評測所需的參考畫面、指令和完成結果放在同一段真實影片脈絡中,較適合檢查模型是否真的做到指定改變,而不只是產生看似合理的畫面。

項目屬於影片生成評測的資料集建構工具,實際解決的是把零散影片整理成可驗證、可重複評分的任務樣本。SemComp-Bench 目前提供 1,273 個結構化樣本、6 個真實世界領域、60 個 SemComp-Core cases,平均 outcome-centric clip 約 4.03 秒,並配有兩種指令、四類 reference alignment types,以及 27 個評測取樣畫面。

使用者需要 Python 3.10 或更新版本、ffmpeg、ffprobe,以及供第 2 至第 5 和第 7 至第 9 階段使用的 multimodal model service;第 6 階段的 ImageBind inference 建議使用支援 CUDA 的環境。原始影片、模型權重、服務憑證和執行輸出均不隨儲存庫提供,因此較適合研究團隊按自己的影片及模型服務重建資料,而不是下載後即時取得完整數據集。

  • 以 outcome achievement 配合 semantic grounding,避免只用畫質或 prompt alignment 判斷成功
  • 透過 reference frame、outcome state 和短片建立完整評測三元組
  • 1 至 7 階段通常會輸出 snapshot、excluded set,技術失敗另有 error.parquet
  • 可用 tests/ 的離線回歸測試檢查處理流程
  • splitting/ 含改編自 Panda-70M 和 ImageBind 的元件,非商業授權限制需要先審閱

對研究生成影片、製作評測數據,或需要分析任務完成率的團隊而言,這套管線提供了清楚的重建入口;但它依賴外部多模態模型服務和本地媒體資源,資料建立成本與授權審查仍是採用前必須計算的部分。

項目主頁 · GitHub · 數據集

Categories: 開源, 視覺模型, 多模態模型, NVIDIA, Video, Python, Dataset 數據集

Page 6 of 23
1 … 4 5 6 7 8 … 23