PANORAMA 把場景描述逐個詞對應到像素

Inria 與捷克理工合作開源的 PANORAMA,能為整個場景生成描述並把每個實體精確對應到像素遮罩,並同步釋出近全幅覆蓋的人工標註基準 PanoCaps。

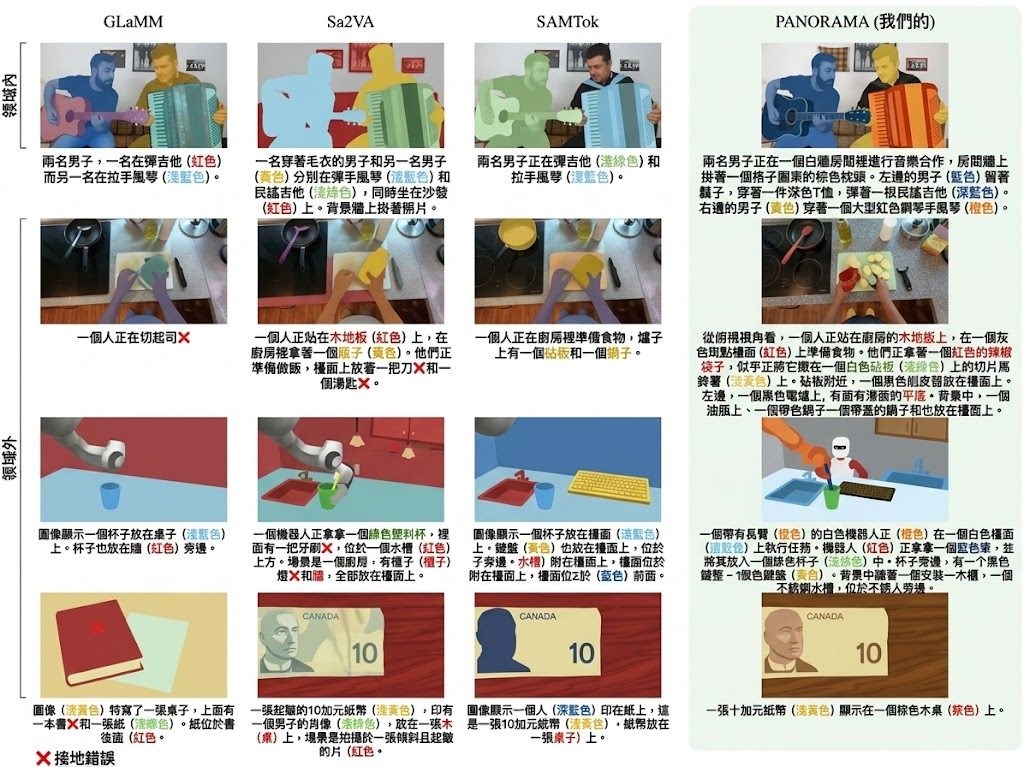
PANORAMA compared with prior grounded captioning models, in and out of domain

現時的視覺語言模型(VLM)寫得出漂亮描述,卻往往無法把句子裡的物件真正對到像素,導致「說的是一回事、畫出來又是另一回事」。PANORAMA 想處理的是 panoptic grounded captioning:模型要不只描述前景物件,還要連背景區域都講清楚,並為每個提到的實體給出像素級遮罩。

做法上,它把短語定位(phrase grounding)重新定義成「從短語條件化的遮罩提案池中挑選」。預訓練分割器根據每個短語的上下文表徵生成候選遮罩,模型再從中選出真正對應的那一塊,無論是單一區域、多個實例,或根本沒有對應都涵蓋在內。這樣把分割與語言生成用同一介面聯合訓練,文字與遮罩就不再各說各話。

配套資源同樣在 Hugging Face 公開:PanoCaps 約有 3.5K 張圖片、34K 個遮罩和 17.9K 條獨立短語,參照區域覆蓋近 99% 像素;COCONut-PanCap-Recaptioned 提供 118K 張訓練圖的重新標註;MRSeg-Referring-Expressions 則帶來約 101K 條改編自 SegLLM 的單輪指代表達。評估端還提出 generalized Panoptic Quality(gPQ),把文字與遮罩的一致性納入單一指標。實驗結果顯示,PANORAMA 在 PanoCaps 上整體定位表現最佳,並在多個像素級任務上與專門模型持平或更強。

這個項目適合以下情境:

  • 做機器人感知或場景理解的研究團隊:需要模型同時提供自然語言描述與實例級遮罩,減少對接多個模型的成本
  • 訓練數據匱乏的多模態團隊:PanoCaps 與兩份重新標註集合計逾十萬張圖,可直接用作訓練或微調
  • 需要精細指代(referring expression)任務的工作:MRSeg-Referring-Expressions 提供多粒度指代表達,比單一句式更有助泛化
  • 對 VLM 評測有疑慮的研究者:gPQ 指標把文字與遮罩綁定,避免「描述漂亮但對錯位置」的高分陷阱

對想直接跑實驗的人,訓練、微調與評估程式碼已隨倉庫釋出;模型權重則透過 Hugging Face 取得。如果你關心的是 VLM 能否真正「看懂」場景而不只是寫句子,這套統一框架比多數把描述與分割拆開處理的方案更接近落地需求。
項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Image, 框架, 庫, Dataset 數據集

ActionPiece:設計動作分詞器,幫機械人學得更穩

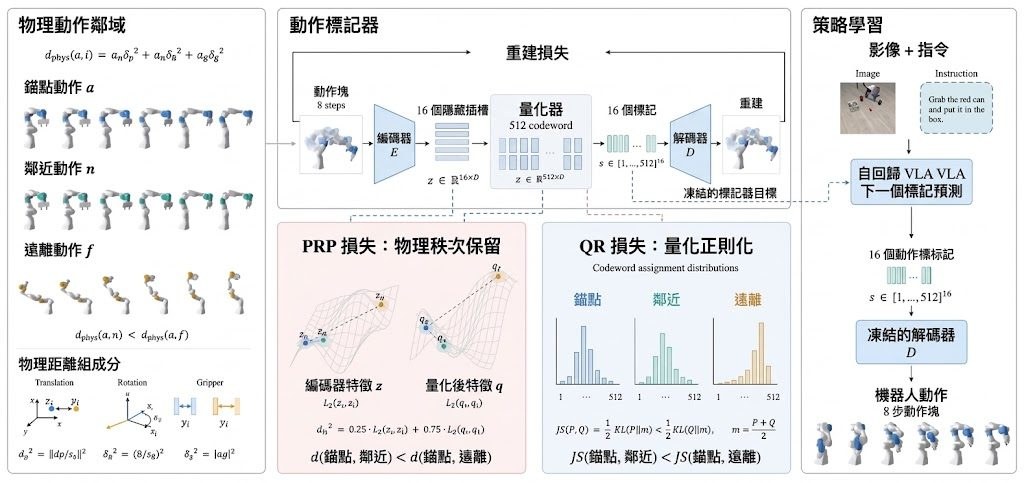
可以把 ActionPiece 理解為一個專給視覺語言動作模型用的動作編碼器,特別針對自回歸生成時動作細節流失的問題,強調保留物理距離的先後關係。

DeepCybo, Zhongguancun Academy, and Zhongguancun Institute of Artificial Intelligence

當自回歸視覺語言動作模型(VLA)把機械人動作切成離散 token 再一個個吐出來,最大的隱性成本往往不是單一動作的誤差,而是相鄰動作之間的物理距離被打亂。ActionPiece 正是針對這個卡位設計:它把動作切成一塊八步的短序列,每塊壓成 16 個離散 token,並要求 tokenizer 不只重建動作,還要保留「物理排序一致性」(physical rank consistency, PRC)。換句話,兩個本來很接近的動作,編碼後的距離也要維持接近;兩個本來很遠的動作,編碼後也要維持較遠。這種監督讓 token 表徵本身帶有物理結構,而不是純粹的重建損失。

在 Libero、Libero-Plus、SimplerEnv 與 VLA-Arena 四組基準上,ActionPiece 配合 Qwen3-VL-4B 作為策略骨幹,跑出 94.8%、68.8%、71.9%,以及 VLA-Arena L0 至 L2 平均 51.5% 的成功率。Libero-Plus 的訓練刻意排除其示範數據,因此這項成績更能反映遷移表現,而不是單純記住示範。從結果可以看到,重建保真度與 PRC 之間並非完全等價:有些 tokenizer 重建得很好,但鄰近關係一塌糊塗,部署成功率也跟著掉。ActionPiece 把「物理排序保留」與「碼字分配的量化正則化」綁在一起訓練,正好同時壓住這兩個問題。

這個項目的實際意義,是給正在做 VLA 研究的團隊一個可直接替換的動作 tokenizer,無需重寫策略架構。對關注 SimplerEnv 真實遙操作或 VLA-Arena 跨平台泛化的工程師來說,這類保留物理關係的分詞方式,會比純重建式 tokenizer 更貼近控制任務的需求。PhysBrain 1.5 也採用了 ActionPiece 作為動作 tokenizer,顯示它已不只在論文層面,而是走進實際模型發佈。

要真正評估它,比較合理的做法是把它接進自己的 VLA 流程,比對換 tokenizer 前後的策略成功率與 PRC;單看 Libero 94.8% 容易被低估,因為重建誤差小的 tokenizer 不一定保留鄰近結構。原始程式碼與 PhysBrain 1.5 的權重將在官方頁面釋出,想搶先試的人可以先讀論文並鎖定後續更新。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, VLA, Robotic, Dataset 數據集

AlayaVista:全景潛態驅動嘅可串流世界模型

AlayaVista 從一張透視圖出發,建立 360° 全景先驗,再隨鏡頭動態演化作為視點潛態,逐區塊渲染並局部精煉所選畫面,做流暢且高保真嘅可控影片生成。

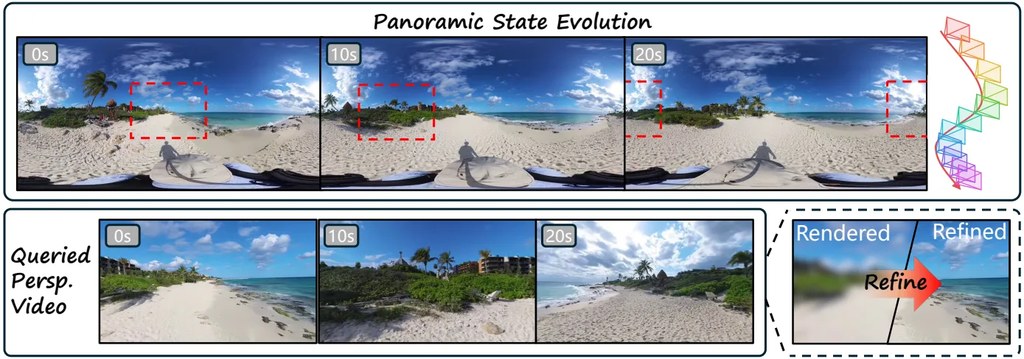
AlayaVista evolves panoramic states under camera control and renders and refines the requested perspective views.

想由一張普通圖片,邊拉鏡頭邊即時生成高質影片,而又唔丟失 360° 場景記憶?AlayaVista 就係為呢個矛盾而設計——佢屬於世界模型(World Model)類研究原型,處理嘅係可控、可串流嘅影片生成問題。

核心做法分三步:先用一張透視圖估出完整 360° 全景先驗,模擬出 VR 風格嘅場景記憶;之後鏡頭控制訊號會驅動呢啲全景潛態持續演化,保持全局一致性;最後系統只渲染用戶當前視角所在嘅區域,並用潛態視口渲染與局部精煉做高保真合成。為咗兼顧速度與質素,佢採用 chunk-autoregressive 逐區塊自迴歸生成,配合少步蒸餾(few-step distillation),令串流過程唔使逐幀重頭計,全部運算力集中在真正需要輸出嘅視窗。

比起傳統逐幀擴散或全景一次性輸出嘅做法,呢種「全景當記憶、視口當輸出」嘅分工換嚟兩個明顯取捨:視窗畫面更銳利、代價係鏡頭一轉就要重新做視口對齊;同時間全景一致性同幀率都受惠於 chunk 邊界設計,對長鏡頭平移類場景特別友好。

幾個重點摘要:

  • 全景記憶 + 局部渲染:以 360° 全景潛態維持場景上下文,鏡頭視口獨立精煉,避免整段重算。
  • 鏡頭可控串流:支援 user-controlled camera 訊號輸入,邊互動邊生成適合遊戲引擎、VR 預覽或 cinematic pre-vis。
  • 效率設計:chunk-autoregressive 加 few-step distillation,專注運算力於選定視窗。
  • 仍屬研究階段:roadmap 列明推理代碼同預訓練權重尚未釋出,目前只可睇 paper 與 project page 嘅 demo。

呢類模型對做互動敘事、VR 內容預覽、遊戲關卡 walkthrough 嘅團隊最有直接參考價值,因為佢直接處理「鏡頭會行、背景要穩」呢個常見卡位。對純做離線一鍵出片嘅用家嚟講,呢類串流設計嘅優勢未必即刻見效,但對需要低延遲、長時序一致嘅創作流程,呢條技術路線值得留意。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視覺模型, 視頻模型, 世界模型, Video, Image, 框架, 教學

LLaDA-UI 首個開源擴散 GUI Agent 16.7B MoE 力壓 Qwen3-VL

Inclusion AI 把 block-wise 擴散語言模型搬進螢幕操作場景,推出約 16.7B 參數的 LLaDA-UI,在六個 GUI 基準上贏 Qwen2.5-VL-7B,部分項目更超越 Qwen3-VL-8B。

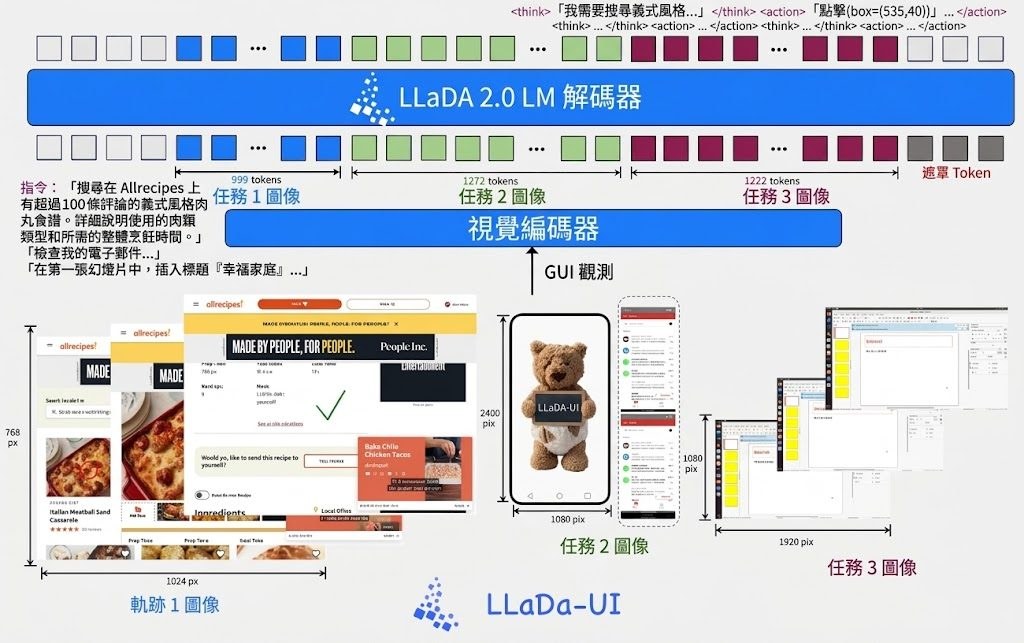
LLaDA-UI GUI-agent benchmark comparison and animated qualitative diffusion decoding

一般講 GUI Agent,都預設底層係自回歸 VLM;Inclusion AI 同螞蟻集團 Venus Team、西湖大學合作推出的 LLaDA-UI,偏偏選擇用 block-wise 擴散語言模型做骨幹,直接從遮罩 token 逐塊 denoise 出推理同動作,配合原生動態解像度視覺編碼器,覆蓋手機、桌面、網頁同 grounding 任務。模型全段約 16.7B 參數嘅 MoE 架構,訓練分兩階段,先做大規模多模態預訓練對齊 LLaDA2.0-mini-base,再做 GUI 監督微調。

喺 ScreenSpot-Pro、AndroidWorld、MobileWorld、WebVoyager 等六個基準上,LLaDA-UI 全部贏過 Qwen2.5-VL-7B,其中 ScreenSpot-Pro 52.9、AndroidWorld 53.5、WebVoyager 56.9,喺呢四項仲壓過 Qwen3-VL-8B;官方同時提到 API 速度最高有 8.95 倍 mean speedup。佢仲針對擴散解碼做咗一輪分析,包括動作合法性、軌跡長度、EOS 處理、denoising 步數同 block size 對表現嘅影響。

如果你做開手機或桌面自動化、需要 GUI Agent 處理長步驟任務又想避開自回歸延遲,LLaDA-UI 提供咗一套唔同嘅技術路線選擇;研究擴散語言模型落地嘅人,亦可以直接拎佢嘅 block-parallel 解碼行為做案例。

重點摘要

  • 約 16.7B 參數 MoE 擴散 GUI Agent,由 Inclusion AI、Ant Group Venus Team 與西湖大學共同發表
  • 骨幹為 LLaDA2.0-mini-base 配合 SigLIP 初始化嘅動態解像度 ViT
  • 六個 GUI 基準全部超越 Qwen2.5-VL-7B,ScreenSpot-Pro 等四項高過 Qwen3-VL-8B
  • 訓練涵蓋 100+ 中文與 70+ 英文手機 App,覆蓋 mobile、desktop、web、grounding
  • 附帶針對 block-wise 擴散解碼嘅分析,包括結構化動作有效性、EOS、denoising 步數等

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, UI/UX

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bash 同 frames,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, 庫, Anthropic, 動畫, Dataset 數據集

MaP-WAM:把記憶變成計劃

MaP-WAM 將機械臂長任務拆成「記憶 → 計劃 → 行動」三步,先保留稀疏視覺證據,再壓成固定長度的計劃執行,讓 executor 不再因歷史增長而越來越慢。

Repository image for aipixel/MaP-WAM

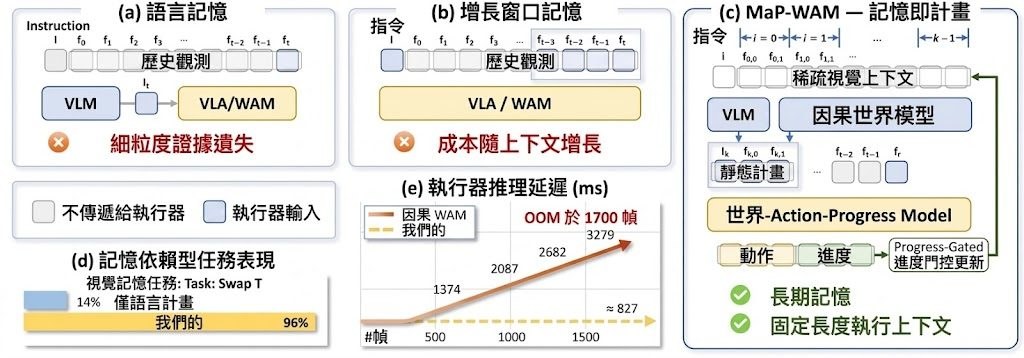
做過長任務的 robot policy 都知道,當動作序列拉長,模型要嘛靠語言摘要回憶過去,要嘛硬把一堆畫面塞進上下文,結果前者丟失精確視覺證據,後者則隨步數累積越來越慢。MaP-WAM 走的第三條路:把記憶視為「規劃時的證據」,而非「執行時的負擔」。它由哈爾濱工業大學、南洋理工大學及山東大學等團隊共同提出,屬於 VLA 框架與 World-Action Model 思路的延伸。

主流機器人策略通常採用馬可夫公式,但許多複雜的現實世界操縱任務本質上是非馬可夫的,需要超越當前觀察的長視野記憶。MaP-WAM 的核心分三層:每完成一段任務,便把該段的語言指令與少量真實執行幀打包成 episodic memory;之後由視覺語言模型生成下一段的語言計劃,並由因果世界模型補出對應的視覺引導;最後由 World-Action-Progress(WAP)模型在同一上下文內同時輸出動作 chunk 與進度,再以 plan-observation alignment 校正遞迴估計、以 progress-gated transitions 決定何時更新記憶並請求下一段計劃。由於已完成片段的 episodic 證據與當前計劃都可被 cache,executor 的上下文長度保持固定。

在 RMBench 上達到 83.3% 成功率、真機實驗約 78.0%,同時 executor 維持近似常數的 per-chunk 延遲。在三個長任務記憶方案中,這套設計拿來對比的恰是「語言記憶丟視覺證據」與「滑動視窗記憶吃 GPU」這兩個老毛病,並以固定上下文的方式直接拆解效率與覆蓋率的取捨。

適合關注機器人長任務、World-Action Model、VLA 框架的研究團隊與工程團隊參考。模型 checkpoint 標示為 Coming Soon,現階段只能讀 paper 與項目頁理解思路。

重點摘要:

  • Memory-as-Plans:將長任務記憶拆成「已完成片段的稀疏視覺證據 + 語言計劃」,而非把所有歷史塞回 executor。
  • WAP 模型:在同一上下文內同時輸出動作 chunk 與任務進度,並透過 plan-observation alignment 校正遞迴估計。
  • 固定上下文執行:已完成片段與當前計劃皆可 cache,executor 上下文長度不再隨歷史增長。
  • 對比清晰:直接挑戰語言記憶丟失視覺證據、滑動視窗吃 GPU 記憶體兩種主流做法。
  • 現況限制:訓練與推理程式碼、模型 checkpoint 均未釋出,目前僅有 paper 與項目頁可參考。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, VLA, World-Action Model, Robotic, 框架

TempCloze:揭開 Video-LLM 的時間盲區

TempCloze 是一個專門測試 Video-LLM 視覺時間推理能力的影片填空基準,從七個來源收集 1,521 條長鏡頭與第一人稱影片,挑戰模型能否在四選一中找回正確的「消失中段」。它直接揭示現有模型在時間對齊上的明顯短板。

Overview of the TempCloze benchmark

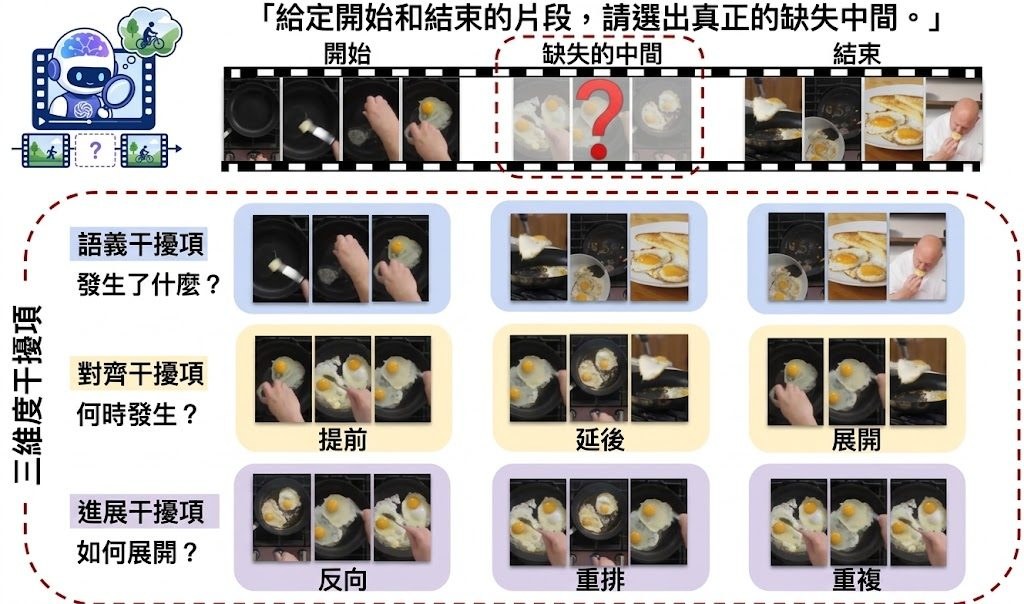
TempCloze 的玩法相當直觀:給一段影片的開頭與結尾,要求模型從四段候選片段中挑出真正屬於中間缺失的那一段。四個選項全部來自同一條影片的素材,連文本線索都壓到最低,等於逼模型只能用眼睛去判斷時間先後與事件流暢度。

這套基準特別針對三個時間維度:語義(Semantic,考「發生了什麼」)、對齊(Alignment,考「應該在何時發生」)、推進(Progression,考「事件如何展開」)。對齊的干擾選項設計得很巧妙,例如把同一段內容前移、後移或拉長;推進維度則把片段倒播、重排、重複,看模型能否識破。題目素材刻意挑選長鏡頭與第一人稱影片,避免靠剪輯或場景切換就能蒙混過關。

跑完 31 個 Video-LLM(10 個閉源加 21 個開源)後結果很殘酷:無論是 GPT 類還是開源權重,模型在對齊任務上的準確率幾乎腰斬,閉源平均從語義 70.73% 跌到對齊 48.13%,開源平均更只剩 26.54%。相比之下,人類在嚴格協議下仍能達到 97% 平均正確率。換言之,現在的 Video-LLM 對畫面在時間軸上的位置幾乎沒概念,只能靠語義關聯硬猜。

對於做影片理解、embodied AI、多模態基準研究的人來說,這份工具包很值得關注。它提供統一抽幀協議(每段 16 幀,六片段題 96 幀),評測流程可直接套用,重點在於指出時間對齊才是視頻推理的真正瓶頸,數字與圖表都已經整理好。

重點摘要:

  • 任務設計:四選一影片填空,所有干擾項來自同一條原片,消除文本捷徑
  • 三維度考核:語義、對齊、推進,分別測事件、位置、展開方式
  • 數據規模:1,521 條影片,長鏡頭與第一人稱為主,七個公開來源
  • 核心發現:對齊維度是最大瓶頸,開源模型跌至 26.54%,閉源亦僅 48.13%
  • 工具價值:統一抽幀協議與評測腳本,可直接比較現有 Video-LLM 在時間推理上的差距

GitHub

Categories: 開源, Agentic, 模型, 視覺模型, Video, 影像處理, 框架, 工具

Show-Harness:VLM 極簡語意操縱機械臂

Show-Harness 把機械人控制壓縮成一組離散語意動作單位,讓視覺語言模型直接負責物理決策,省去針對特定硬件的預訓練與額外參數。

Show-Harness

機械人領域一直有個尷尬落差:底層視覺語言模型(VLM)識睇識講,但要佢實際控制一隻機械臂,往往要再預訓練、加 VLA 頭或寫一大堆適配層。Show-Harness 嘗試用另一種方式切入──直接把動作壓縮成一組細粒度、離散的語意單位(例如 MV_FWD、GRASP、ROTATE_CW),由 VLM 逐個 token 推理,再交俾硬件專屬嘅 interpreter 去 deterministically 落地成實際機械動作。換句話,VLM 唔再需要理解「毫米」或「關節角度」,只需揀語意單位。

你可以用兩種方式跑:直接接駁前沿閉源 VLM 做 zero-shot 控制,又或者拎幾個 GPU 小時微調小型開源 VLM,產出每秒 12 至 33 Hz 嘅本地執行版本。Franka、AgileX Piper(單臂同雙臂)、ManiSkill、Isaac Lab 都共用同一套詞彙同一個 prompt,唔使逐隻 robot 寫 prompt。項目同時附帶 GUMI:一個瀏覽器內嘅 GUI 操作介面,等你可以用鍵盤滑鼠親身「玩」機械人收 demonstration,完全唔需要專業遙操作硬件。

  • 極薄中介層:VLM 只負責揀語意 token,所有 metric 細節由 interpreter 處理,避免額外模型容量開支
  • 跨硬件共用詞彙:Franka、AgileX、ManiSkill、Isaac Lab 共用同一套動作字典與 prompt
  • 兩種部署路徑:前沿閉源 VLM zero-shot,又或者 LoRA 微調小型開源 VLM,本地即可執行
  • GUMI 無硬件收數據:瀏覽器內 GUI 操作即收 demonstration,省去 teleoperation 設備
  • 插件式消融設計:一個目錄、一個 boolean flag,閂咗就等同冇裝

相對於 π0.5 同 GR00T 呢類 VLA 路線,Show-Harness 嘅取捨偏向「interface 解耦」──唔再要求模型本身內化硬件物理量,而是把 metric 還返俾環境層解讀。對做具身研究、想快速換 embodiment 驗證嘅團隊,或者資源有限、要靠 LoRA 微調部署嘅實驗室都幾實用;研究 embodied agent 同 VLM 接駁嘅開發者都可以直接拎去試 prompt 同詞彙設計。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 模型訓練, VLA, Robotic, Dataset 數據集

RoboSPA 用 280 個難度變體幫你壓力測試

RoboSPA 是浙江大學團隊針對 Vision-Language-Action 模型推出的診斷式基準,透過逐步拉高空間歧義與程序步數,揭開現有機器人策略在精準定位與長程規劃上的短板。

Repository image for fanzhenxuan/RoboSPA

當 VLA(Vision-Language-Action)模型在乾淨、短任務的環境中跑出不錯的成功率,要怎樣才知道它是真正「理解」指令,還是只是剛好蒙對?RoboSPA 給出的答案是:把場景弄得更亂、把步驟拉得更長,然後看模型從第幾關開始崩潰。這是一個基準與數據集項目,建基於 RoboTwin 2.0 模擬框架(SAPIEN + CuRobo),由浙江大學主導,已獲 EMNLP 2026 收錄。

它把 56 個基礎任務各衍生出五個難度級別(L1–L5),共 280 個變體,覆蓋五種機械臂實體(Franka、Piper、UR5、Aloha-AgileX、ARX-X5),總計 527K 條軌跡、約 108M 步數、997 小時互動影片。Spatial 維度持續加入外觀相近的候選物,Procedural 維度則逐步疊加子目標、執行順序、重複次數與記憶需求。

與只看最終二元成敗的傳統做法相比,RoboSPA 額外提供兩個診斷指標:空間任務用 ONTA(Object-Normalized Target Accuracy) 衡量模型能否在「看起來都像」的物件中選對目標,並以 chance-corrected 方式扣掉隨機命中;程序任務則用 Progress Score(PS) 計算實際完成的子目標比例,反映模型在中途卡住或跳步的真實狀況。

適合機器人實驗室、VLA 模型開發者,以及需要評估策略可擴展性的團隊。支援自帶策略接入,數據與代碼均已公開。研究端在多個代表性 VLA 模型上的結果顯示,空間關係、低階精細動作與長程記憶仍然是明顯瓶頸。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, Video, VLA, 框架, 中國, Dataset 數據集

TANGO:人形機器人穿越凌亂房間,全靠語言指令

TANGO 是一個讓人形機器人聽到自然語言指令後,自動調整手腳、軀幹與步態避開雜物的全身控制框架,可以理解成把機械人導航從「會走」升級成「會穿過沙發底下」。

TANGO architecture and data-generation pipeline.

如果叫一部人形機械人從客廳走到廚房,但途中堆滿紙箱、雜物、窄縫,一般導航演算法只懂「規劃路徑」,對它來說幾乎等於廢武功,因為雙腳、雙手、腰部其實要邊行邊配合地形郁動。TANGO(whole-body Vision-Language-Action model)正正為這種場景而設計:收到一句自然語言指令,加上前置與向下望的 RGB 影像後,模型直接輸出 29 個自由度(29-DoF)的全身關節角度,配合 6D 底盤旋轉表示,令機械人能夠一邊行、一邊擺手收腹避開障礙。

訓練數據全部來自模擬器,背後有一套名為 Plan-Edit-Track 的流水線:先用全局路徑規劃,再做全身逆向運動學(Kinematics)動作生成,接住用障礙感知編輯避開擺位,最後用強化學習追蹤確保動作真實做得出嚟。訓練集基於 VLNVerse 與 SAGE-3D 場景,再加入側向、貼地、頂部等多類障礙,務求貼近真實家居亂況。

TANGO💃🏻 Humanoid Navigation in Cluttered Environments with a Whole-Body Vision-Language-Action Model

模型結構本身亦幾講究:底層係一個 70 億參數(7B)的視覺語言骨幹,配搭一個用 flow-matching(流匹配)訓練嘅 MM-DiT(Multi-Modal Diffusion Transformer,多模態擴散 Transformer)動作專家,再加一個低階全身追蹤器負責即時執行。部署時 VLA(Vision-Language-Action,視覺語言動作)模型喺伺服器低頻運行,追蹤器喺機械人 onboard 高頻運行,做到實時反應。

實驗結果方面,TANGO 喺模擬與真機測試都提升咗語言導航表現,最重要係零樣本遷移(zero-shot transfer)直接落 Unitree G1(宇樹 G1)人形機械人,唔使額外真實數據再訓練。對研究 VLA、機器人導航或人形機械人部署嘅團隊嚟講,呢套 pipeline 連數據生成到模型結構都幾值得拆解。

重點摘要:
– 語言指令直接對應全身 29-DoF 動作,涵蓋手、軀幹、步態協調
– Plan-Edit-Track 流水線全模擬訓練,配合 VLNVerse 與 SAGE-3D 場景生成
– 採用 7B 視覺語言骨幹 + flow-matching MM-DiT 動作專家雙模組設計
– 伺服器跑 VLA、機械人 onboard 跑追蹤器,支援實時控制
– 零樣本遷移至 Unitree G1,無需真實訓練數據

項目主頁

Categories: 香港大學, 模型, 視覺模型, 多模態模型, 模型訓練, Video, VLA, Robotic, 框架, Dataset 數據集

Page 4 of 23
1 2 3 4 5 6 … 23