OpenGCUA 讓電腦代理跨越 GUI 限制

OpenGCUA 把視覺操作、AX Tree、API 與指令整合,讓代理按任務選擇完成工作的方式。

OpenGCUA. Open the full stack of generalist computer use. GPT-6 made computer use the frontier. We make it open. Tested

當電腦代理不再只靠滑鼠點擊,處理複雜工作便可以同時讀取畫面、Accessibility Tree、應用程式 API 和命令列。OpenGCUA 是一個開源 Computer-use agents(CUAs)項目,建構 generalist computer-use agent(GCUA)完整堆疊,解決 GUI-only 代理在效率和操作彈性上的限制。

模型會按任務決定要觀察甚麼、採取哪種行動,以及如何整理上下文;除了 GUI 操作,也能呼叫 app API、執行 shell commands,並透過 code execution 把多個步驟組成帶有迴圈和條件的程式。OSWorld 整合範例提供 screenshot-action 和 code-action 路徑,macOS 14+ harness 則以選單列應用程式在本機裝置執行代理,仍屬 preliminary。

OpenGCUA 亦提供 Cross-Device SDK,嘗試用同一套 programming interface 連接電腦、瀏覽器和手機。這比固定規則的工作流更靈活,但也代表命令、API 和 GUI 權限需要更嚴格的隔離;項目目前仍在逐步開放模型、harness、SDK、trajectories、效率優化和評估工具。

OSWorld-v2 的 82 個 offline tasks 中,八個 frontier models 的平均 partial score 由 GUI-only execution 的 45.3 提升至 64.9,增加 19.6 分;每項任務平均步數減少 53%,六個模型的 output tokens 亦減少 27.2%。較弱模型獲益較大,例如 GLM-5.3-Flash 增加 35.2 分,DeepSeek-V4.1-Flash 增加 29.8 分。

  • 同時支援 GUI、AX Tree、CLI、API 和 code execution
  • 附有八個模型的 evaluation trajectories,包括 GPT-6 Astra、Claude Opus 5 和 Gemini 3.8 Flash
  • 可用 OSWorld 整合範例研究 screenshot-action 與 code-action
  • macOS harness 和 Cross-Device SDK 方便研究本機及跨裝置工作流

研究 Computer-use agents、需要分析代理行為,或希望把電腦、瀏覽器和手機操作納入同一工作流的團隊,會較容易從中受益。項目適合用作研究和實驗基礎,未宜直接視為成熟的日常自動化產品;本機執行、權限控制、模型相容性及仍在開發的模組,都會影響部署難度。
項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, DeepSeek, Gemini, API, 工具, Mac, 編程, Anthropic, Dataset 數據集

3dcodeverse 讓 AI 以程式碼建立可驗證 3D 世界

3DCodeVerse 將可執行程式、空間檢查與視覺評審接成工作流,讓 AI 產生的 3D 內容不止能看,亦能修改和驗證。

3DCodeVerse

由幾百行 Blender Python、Three.js 或 GLSL 生成互動場景,內容仍可編輯和檢查,正是 3DCodeVerse 的實用定位。它屬於面向 coding agents 的 3D 研究生態系,處理文字要求轉化為可執行 3D 程式的問題,而不是只輸出一張渲染圖。

核心資料集 3DCodeVerse-2M 收錄約 2.03M 個 code-condition pairs,來自 269,597 個可執行程式,涵蓋 bpy、CadQuery、OpenSCAD、Three.js、URDF、GLSL、OpenGL 七種語言或 runtime,並分為物件、可動物件、場景及圖形渲染四條軌道。每個項目附有程式、所需資產、指令描述、視覺描述、建構步驟和驗證記錄,較適合訓練及測試,而非只作展示素材。

3DCodeVerse Harness 以多智能體和 DAG 結構規劃 3D 項目,再交由空間工具、MCP 服務及確定性檢查驗證連接、介面合約、關節掃描和畫面指標;VLM 評審則用二元缺陷清單及程式上限評分。讀者可先在項目網站瀏覽器執行示例,再從 Hugging Face 取得資料集;自行運行則要準備相應的 Blender、Three.js、OpenGL 等 runtime,不能只靠單一推理套件完成。

開放模型部分提供 Qwen 的 LoRA、DPO 微調配方,並列出 27B 模型在 3DCodeBench 的執行率由 51.9% 提升至 92.9%;項目亦列出相對同一 Claude Opus 5.5 backbone 的 90% 人類偏好結果。這些數字反映訓練資料和驗證流程的價值,但仍應留意評測設定、成本及不同 runtime 對結果的影響。

  • 可生成可修改的程式化 3D 物件、場景和渲染效果
  • 以 DAG Harness 串連規劃、執行、空間檢查和視覺評審
  • 2.03M code-condition pairs 支援模型訓練與基準測試
  • Qwen 微調配方兼顧執行成功率和偏好評審

對研究 3D 生成、coding agents、程式化建模或模型微調的團隊,這個項目提供由資料集、工具鏈到模型配方的完整起點。限制在於工作流程依賴多個 3D runtime,評審仍可能受視覺品質和規則覆蓋範圍影響。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 視覺模型, 模型訓練, Qwen, Google, 工具, 3D, Python, 編程, 安全, Anthropic, Dataset 數據集, LoRA

EdgeWise 讓長流程 AI 代理在本地運作更省成本

EdgeWise 讓本地模型處理大部分長流程任務,只在關鍵步驟呼叫雲端 LLM,兼顧表現與成本。

Og image

長流程 AI 代理不必每一步都依賴昂貴的雲端模型。NVIDIA 的 EdgeWise 是一套 edge-cloud collaboration framework,讓本地 SLM(Small Language Model)先負責解題,遇到需要更強推理能力的關鍵步驟,才選擇性地交由 cloud LLM 處理。

EdgeWise 用 step-level RL(Reinforcement Learning)同時訓練任務執行與自動分工,令代理自行判斷何時需要外援,而且不必在推理階段額外加入另一個決策模型。研究亦以 external judge-based delegation strategy 分析委派時機、分享多少上下文,以及雲端模型應該多久介入一次。

研究發現,雲端智慧需求通常集中在少數關鍵步驟,呼叫次數不一定越多越好;隨機把約 40% 步驟交給雲端,有時已能接近全雲端執行的表現。EdgeWise 在 SWE-Rebench 減少最多 62% inference cost,在 Terminal-Bench 2.1 減少最多 34%,並在本地工作站完成 edge-cloud 測試。

• 本地 SLM 負責主要任務流程
• 只在關鍵步驟委派 cloud LLM
• 以 step-level RL 學習委派決策
• 支援不同 agent harnesses
• 成本較全雲端執行最多低 62%

適合需要處理長流程編程、終端機操作或其他多步驟任務的工作流,尤其適合希望降低 inference cost、又不想完全犧牲模型能力的本地設備。雲端連線、委派判斷和上下文分享方式仍會影響結果,因此它並非完全脫離雲端的方案。

項目主頁

Categories: Agentic, 模型, 模型訓練, NVIDIA, World-Action Model, 框架, 編程, 強化學習

Doc2Harness:測試模型能否造出真正可用的 Coding Agent

Doc2Harness 不只測模型識唔識寫程式,還把整套 Coding Agent harness 交由模型建造,再以黑盒方式驗證是否真的運作。

Doc2Harness

當 Coding Agent 要處理長時間、多步驟工作,成敗不只取決於模型本身,還取決於工具呼叫、權限、工作階段、復原流程和整個執行迴圈。Doc2Harness 是一個評測基準,專門處理模型能否按照開發文件和介面骨架,建造完整 Coding Agent harness 的問題。

項目分成兩個階段:第一階段由 build model 在隔離容器內透過 OpenCode 實作 harness;第二階段會凍結成果,再放到另一個容器,由 scripted mock model 端到端驅動。評分不接受 harness 自己聲稱完成任務,而是讀取四個可觀察渠道:傳給模型的請求、磁碟檔案、程序 exit code,以及 command output;positive controls 亦會阻止空殼實作取得通過結果。

  • 測試範圍:完整基準包含 328 個 test cases,公開儲存庫只提供 94 個 scenarios,包括 53 個評分案例和 41 個 positive controls。
  • 模型差距:完整套件涵蓋 19 個 frontier models,最佳模型通過率為 53.05%,最低約 27.4%。
  • 可重現限制:排行榜數字來自完整套件,不能只用公開子集重現。
  • 執行條件:需要 Python 3.11+、Docker,依賴採用 Python standard library;完整 catalog 在 concurrency 12 下約需 25 至 90 秒。

這項目直接把 harness engineering 本身納入評測。結果亦反映模組拆分並非必然帶來好處:在控制程式碼大小後,module count 與通過率呈負相關,相關係數為 -0.423;同一模型在 direct drive 和 permissions 等場景的排名也可能大幅變動,顯示權限及工具編排是獨立而關鍵的能力。

Doc2Harness 適合研究 Coding Agent、模型評測和 agent infrastructure 的團隊,用來比較模型建造長流程工具系統的能力,亦可協助定位 harness 在請求流程、檔案操作、程序控制或復原機制上的失敗位置。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, Vibe Coding, 工具, Python, 庫, 編程, Anthropic, Dataset 數據集

LSCBench 揭示 AI 編程代理安全盲點

LSCBench 以不提安全的真實漏洞重建任務測試編程代理,結果顯示能正常運作與同時安全的程式碼仍有明顯距離。

Qwen

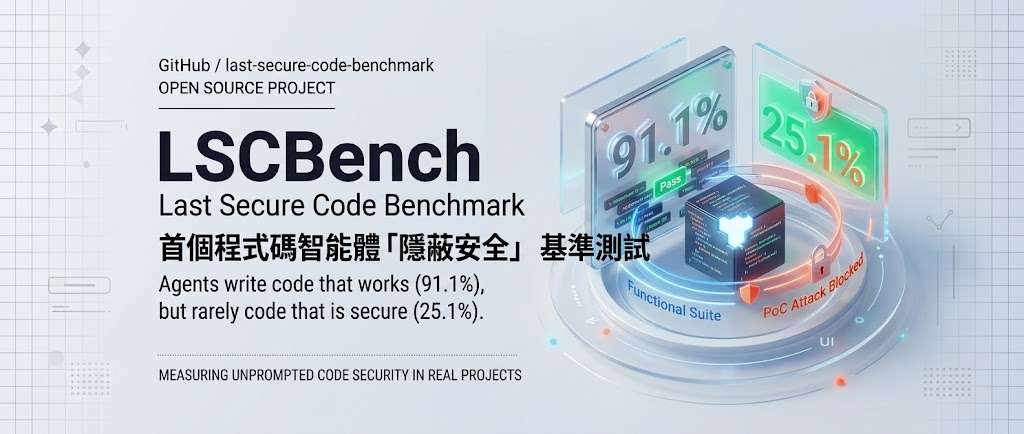
當編程代理只收到功能規格、完全沒有被提醒要處理安全問題時,能否自行避開已知漏洞?Last Secure Code Benchmark(LSCBench)正是用來回答這個問題的開源基準測試項目:它從真實項目移除曾經包含漏洞的程式碼,再要求代理按規格重建,最後以功能測試及重現原有攻擊的安全測試共同評分。

LSCBench 共設 450 個任務,涵蓋 150 個漏洞情境,包括 115 個 Common Vulnerabilities and Exposures(CVE)案例及 35 個專家編寫的 Java 應用程式,支援 C、C++、Go、Java、JavaScript、PHP 和 Python。每個情境分成 function、file 及 repo 三種粒度,分別測試代理修補最小函式、相關檔案,以及較完整程式庫的能力。

六個模型在 450 個任務中大多能產生可運作程式碼,但同時通過功能和安全測試的比例最高只有 25.1%。Claude Fable 5 配合 Claude Code 取得最高 Func∧Sec 比例,GPT-5.6-Sol 的安全測試通過率則以 25.8% 稍高;Kimi-K3 雖然功能通過率達 91.3%,兩項測試同時通過的比例只有 16.4%,反映功能完成度與安全性並非同一件事。

  • 測試焦點:編程代理沒有收到安全提示,必須自行辨認風險。
  • 評分方式:功能測試確認程式可運作,安全測試重播原有攻擊。
  • 資料範圍:450 個任務、150 個漏洞情境、7 種程式語言。
  • 粒度差異:同一情境會在 function、file、repo 三個層次出現。

LSCBench 屬於面向 Computer-use agents(CUAs)及 coding agents 的安全基準測試,實際解決的是「生成的程式碼能否在沒有安全提示下仍然避免已知漏洞」這個評估缺口。對模型開發團隊、安全工程師及採用 AI 輔助編程的團隊而言,項目提供了比單看功能通過率更接近真實風險的檢查方式;不過,測試結果只涵蓋指定漏洞與攻擊重現流程,不能取代完整 code review、模糊測試及正式安全審計。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, OpenAI, DeepSeek, Python, 庫, 編程, 安全, Anthropic, Dataset 數據集, Kimi

Matrix-Game:AI 即時渲染可玩世界遊戲引擎

Skywork AI 把遊戲引擎的穩定規則交給模型外的程式,再用因果視頻模型即時生成細緻畫面。

Repository image for SkyworkAI/Matrix-Game

玩家按鍵、物理碰撞和世界狀態由可執行遊戲引擎處理,低模 RGB 畫面再交給因果視頻模型轉成細緻影像。Matrix-Game 4.0 屬於開源互動世界模型項目,實際處理的是「畫面生成很逼真,但遊戲規則和長期狀態難以維持」的矛盾。

它把視頻模型限制在渲染工作,逐段讀取低模代理畫面、動態描述和參考影像,以蒸餾至一至兩步去噪的 causal DiT,每步生成四幀 latent。Coding Agent 可把玩家指令轉成新規則、修改遊戲引擎,並按相機位置檢索空間記憶,補足引擎未能直接表達的玩法。

  • Medieval Castle、Ancient Egypt 支援第三人稱射擊,City Racing 支援駕駛
  • 提供瀏覽器 Demo、離線渲染、模型權重與三款原生遊戲資產
  • README 列出 A100 與 RTX 5090 的單 GPU inference 路徑
  • RTX 5090 路徑加入 FP8 linear layers、fused kernels、CUDA graphs,並可選 SageAttention

和只靠逐幀像素外推的世界模型相比,Matrix-Game 讓規則可由引擎明確保存,減少物件離開視野後狀態消失的問題;代價是每個場景仍需配合遊戲程式、資產和模型。Matrix-Game 1.0 至 3.0 是前身,分別逐步加入即時長視頻生成及 long-horizon memory,4.0 則把重點推向可玩的引擎整合。

測試可先開啟線上瀏覽器 Demo,再按 v4 README 下載資源,選擇離線渲染或單 GPU inference。適合研究互動世界模型、遊戲生成、AI 遊戲原型及需要可控世界狀態的團隊;硬件需求、場景覆蓋範圍,以及 Coding Agent 生成規則的可靠程度,仍會限制它距離通用遊戲製作的距離。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 視頻模型, 世界模型, NVIDIA, Video, Image, Vibe Coding, 編程, Dataset 數據集

CineRecon 以 Blender 重建實景影片

CineRecon 將影片重建變成可檢驗的 Agent 任務,要求模型由參考影片建立可編輯、可動畫化的 Blender 場景。

CineRecon logo

由完整參考影片出發,Coding Agent 透過 Blender MCP 撰寫及修改 Python,反覆比對渲染畫面,再建立包含幾何、材質、角色動作與鏡頭動畫的可編輯場景。CineRecon 屬於影片重建 benchmark,處理的是模型能否將時間連續的影像內容還原成可修改的 3D 工作成果,而不只是產生相似畫面。

項目以三個重建層級拆開能力差異:Proxy 只要求位置、互動及鏡頭運動,Simplified 再保留可辨認形狀和主要外觀,Detailed 則加入特色形狀、材質和細節。三個層級都要求相同的主體動作、事件及攝影機行為,方便分辨模型是只掌握構圖,還是能重建完整視覺內容。

  • 50 段參考影片,切分成 360 個評估片段
  • 35,836 筆獨立 checklist 記錄,按層級擴展至 49,668 項檢查
  • 評估 Camera、Static、Dynamic 三類一致性
  • 支援畫面選取、時間戳對齊、並行評分、續跑及分數彙總

評分由獨立 VLM judge 對齊參考與渲染影片,按片段 checklist 檢查 11 個類別,並以 Camera、Static、Dynamic 三個同等權重維度計算結果。這比單一影像相似度更能揭示鏡頭是否跟足、物件是否保持穩定,以及動作和事件有沒有在正確時間發生。

測試需要 Python 3.10 或以上,支援 Linux 及 macOS;項目提供資料、提示詞、驗證工具和離線 smoke test,但不包含 Agent launchers。團隊可先用離線流程確認資料與評分管線,再接駁 Blender MCP 和隔離 worker 執行重建;研究模型能力時,CineRecon 的價值在於把「看似相似」拆成可追蹤的鏡頭、靜態內容和動態內容,而不是只比較最後一段影片。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, 模型, 視覺模型, Video, Image, 提示詞, Vibe Coding, 工具, Mac, 3D, Linux, Python, 編程, Anthropic, 動畫, Dataset 數據集

tabulaflow:自然語言查數據(text2SQL)

TabulaFlow 讓使用者用自然語言分析、轉換和視覺化多種數據,並可由圖表追查背後的資料表與查詢。它適合需要跨資料來源探索數據、又要保留分析脈絡的團隊。

想查詢資料庫、整理檔案或探索 Hugging Face 數據集時,使用者可以用自然語言描述分析目標,再由 TabulaFlow 這個開源 Python 數據代理程式處理查詢和圖表。它支援 SQL 和圖形資料庫、檔案、Wikidata 及網頁,適合研究、數據分析和需要把數據功能整合進應用程式的團隊。

與以檔案和 Shell 為核心的編程代理不同,TabulaFlow 把表格當作主要工作單位。代理程式負責產生查詢和視覺化規格,系統則處理資料解析和圖表呈現,減少模型直接拼接資料值或 HTML 的需要;核心數據工作亦可在關閉 Shell 和檔案存取時運作。它仍能編寫程式、執行 Shell 指令和瀏覽網頁,但這些能力不是數據工作的必要條件。

每張視覺化結果都能查看所用的資料表,而資料表亦保留產生它的查詢,方便核對結果來源和重現分析。這對需要審視數據處理過程的團隊有幫助;不過,查詢是否符合使用者原意,仍會受問題描述和模型判斷影響,追蹤來源不等於保證結果正確。

項目提供互動式消歧、資料庫對話、研究資料庫建立及圖形數據查詢等示範。研究者亦可用配套工具進行 text-to-query 實驗;ARCS 是用來評估 SQL 問題歧義處理的基準,不是 TabulaFlow 本身的效能分數。文件列出安裝方式為透過 uv 安裝並設定模型供應商金鑰,支援哪些模型則需查閱其模型文件;提供的資料未列出完整操作流程或各資料來源的設定細節。

  • 支援資料庫、檔案、Hugging Face datasets、Wikidata 和網頁等來源。
  • 以查詢和視覺化規格驅動分析,資料解析及圖表呈現交由系統處理。
  • 圖表、資料表與來源查詢之間保留可追溯關係。
  • 適合數據分析、研究及建立數據應用程式;結果仍需按資料和查詢目的核實。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 工具, Python, 庫, 編程, Dataset 數據集

ProgramGym:程式重製代理訓練

由可驗證環境到持續開發流程,ProgramGym 把程式重製代理的訓練推向長流程任務。

ProgramGym logo

要令 coding agent 重建一個未公開實作的程式,單靠規格並不足夠,還要探索參考執行檔、推斷行為、設計架構,再反覆修正。ProgramGym 屬於面向程式重製代理的訓練環境與工作流程項目,透過 Program-Env 和 Program-Agent 處理測試環境難以大量建立、長時間開發容易失去脈絡兩個問題。

Program-Env 會由真實 repository 建立參考 executable 和 runtime sandbox,再以驗證回饋逐步產生 behavioral tests;Program-Agent 則把分析、實作和 review 分開處理,利用持續保存的交接紀錄與 revision checkpoints,讓代理可以延續多輪工作,而不是每次重新理解整個程式。

項目目前提供 ProgramGym-1648 dataset,涵蓋 Go、C++、Rust 和 C,共 1,648 個可驗證任務,其中 Go 有 818 個。資料集適合用來訓練或比較 coding agents,尤其是需要黑盒探索、跨多個修訂階段,以及重視行為相容性的工作情境。

• Program-Env 負責建立 executable、sandbox 和行為測試
• Program-Agent 分拆分析、實作與 review 流程
• 任務涵蓋四種系統程式語言及八個領域
• Qwen3.8-27B 基準分數由 34.87% 提升至 42.84%
• 配合 Program-Agent 後,分數提升至 55.71% 或 56.25%

測試結果顯示,Qwen3.8-27B 配合 Program-Agent 達 55.71%,Qwen3.8-27B-SFT 則達 56.25%,較各自基準明顯提升,但仍低於 Claude Opus 4.8 的 70.9% 和 GPT-5.6 Sol 的 69.9%。GitHub 儲存庫主要是資訊中心,提供論文、項目網站及 Hugging Face 資源連結;原始資料沒有交代完整安裝或本地執行步驟,使用者需要先按相關資源了解取得方式。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型訓練, Qwen, Vibe Coding, 庫, 編程, Dataset 數據集

REA:讓 AI 逆向拆解 App 功能至二進制層面

想複製別人 App 的功能,REA 讓 AI 代理在沒有原始碼下調查行為、保留證據,並協助重建。

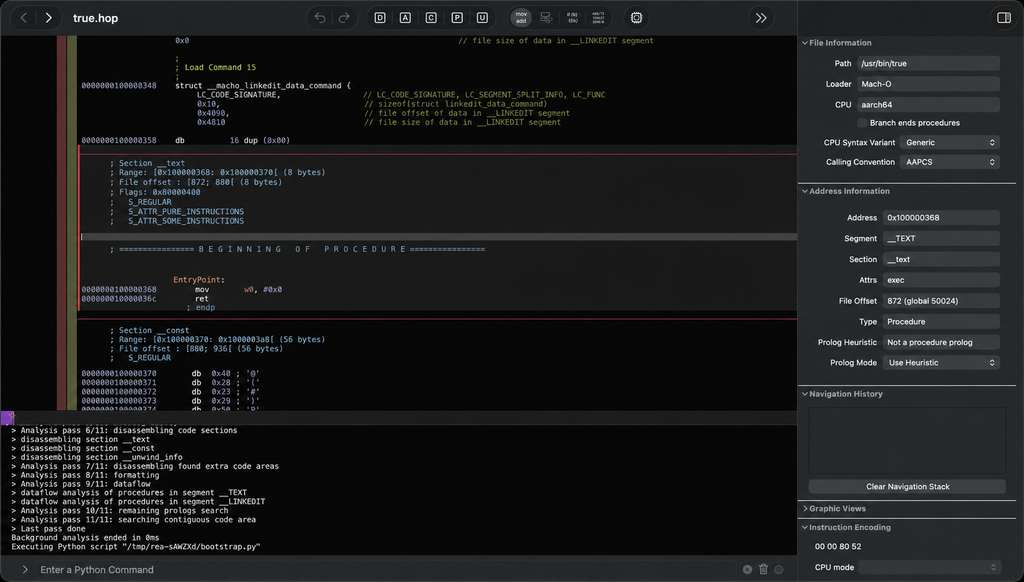
REA launching its analysis bridge inside Hopper while inspecting a native binary

想知道一個 App 的功能點樣運作,卻拿不到原始碼,REA 讓 AI 代理直接檢查應用程式、原生二進制檔案及執行時行為,再用證據解釋結果。它屬於開源逆向工程工具,實際處理的是由功能觀察、底層分析到重建實作的工作流程。

REA 以 Model Context Protocol(MCP)把分析工具接入代理,代理可按步驟展開調查,讀取工具結果、管理 sessions,並將 snapshots 匯出或匯入。對產品團隊而言,價值不只是找出某個功能的表面行為,而是把調查所得轉化為自己項目的實作參考;不過分析結果仍取決於可取得的執行環境、工具支援及代理判斷,不能視為自動產生的完整原始碼。

How To Use REA To Clone Any Software In Minutes

使用時可先透過 Node.js 設定 agent registration 和 provider,再檢查單一 agent 或 analysis engine 的 readiness。CLI 提供 provider 選擇、證據管理、退出狀態及診斷功能,MCP contracts 和 agent prompts 則用來固定工具回傳格式及引導調查流程。

EP424 - 一句話逆向任何 App?AI 逆向工程 REA,這代表什麼

可留意的重點包括:
– 支援 native binaries、應用程式及 runtime behavior 的逆向分析
– 在沒有 source code 的情況下展示調查證據
– 透過 MCP 連接代理、工具、providers 和 sessions
– 提供 snapshots、import/export、readiness troubleshooting 及 CLI catalog
– 適合產品仿製研究、相容性分析及安全研究,但不保證每次都能還原完整功能

REA 比單次檢查工具更接近一套可重複的代理工作流,適合需要比較競品功能、研究封閉軟件或建立相容版本的工程團隊。項目仍在按 roadmap 擴展能力,採用前應先確認目標平台、分析工具及 provider 是否獲支援。

GitHub

Categories: 開源, Agentic, MCP, 軟件, 工具, 編程, 安全

Page 2 of 14
1 2 3 4 … 14