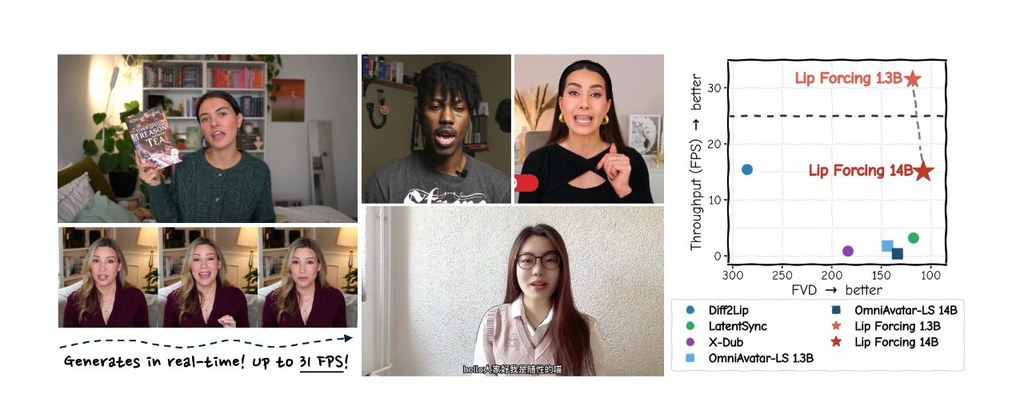
Lip Forcing:把唇形同步推進即時串流

只需兩步生成影片片段,兼顧唇形準確度與速度。目標是在低延遲情況下做到即時 lip synchronization。

Hero image preview

Lip Forcing 是一個針對 video-to-video(V2V)lip synchronization 的研究項目,重點是把 diffusion 模型原本昂貴的推理流程,大幅壓縮到適合即時串流使用。它希望在保留人物身份、頭部姿勢與背景一致性的同時,令口型更準確貼合目標音訊。

現有 diffusion-based 唇形同步方法畫質和聲畫對齊表現不錯,但通常要看完整段影片、再經過很多次 denoising steps,速度和延遲都難以配合直播翻譯、virtual avatars、interactive agents 這類場景。Lip Forcing 改用 autoregressive diffusion,把影片分段逐塊生成,並把 50-step teacher 壓縮成 two-step streaming student,減少計算負擔。

對 lip-sync 任務,本身不是單純套用通用加速技巧。作者指出 CFG 會在 reference fidelity 與 synchronization 之間出現取捨,並據此設計出 Sync-Window DMD、two-step inference schedule,以及以 SyncNet 為基礎的 reward,目標是在少步數下仍維持可用的唇形同步效果。

兩個 student 模型都由 14B teacher 蒸餾而來。1.3B student 可達 31 FPS,速度比同規模 bidirectional model 快 17.6 倍;14B student 則比 teacher 快 39.8 倍,並維持相近的 reference fidelity。兩個版本的 time-to-first-frame 都低於 1 毫秒,顯示它特別適合低延遲串流情境。

  • 支援即時串流,最高可達 31 FPS
  • 每個 chunk 只需 two denoising steps,毋須 inference-time CFG
  • 採用 autoregressive diffusion,降低全序列注意力帶來的成本
  • 針對 lip synchronization 設計蒸餾方法,不是一般加速改裝
  • 適合 live translation、virtual avatars、interactive agents 等場景

如果你關注的是即時嘴型同步、低延遲影片生成,或想了解 few-step autoregressive diffusion 如何落地到影音任務,這個項目相當有參考價值。文中可確認引用與比較的技術脈絡包括 Computer-use agents、CUAs、LoRA、OSWorld 以外的影音生成方向;就本頁內容可明確列出的模型,主要是 14B audio-conditioned bidirectional video diffusion teacher、1.3B student、14B student,以及 SyncNet。

Paper: https://arxiv.org/pdf/2606.11180

Categories: 開源, 模型, 語音

Gemma 4 12B (QAT 量化感知訓練)

Gemma 4 12B 這波某程度上算是在回應那個「手機級模型和大模型之間,會補一個中階模型」的傳聞。不過真正讓人眼睛一亮的,還是 QAT (Quantization Aware Training,量化感知訓練)真的做上來了。再加上現在也支援 MTP,Gemma 4 這代在本地模型的能力和效能上,整體都往前推了不少。總算看到除了 Qwen 之外,其他實驗室開始打出像樣的競爭了;最近的 local AI,真的很像一直都是 Qwen 在 carry。

Gemma 4 12B 這波某程度上算是在回應那個「手機級模型和大模型之間,會補一個中階模型」的傳聞。不過真正讓人眼睛一亮的,還是 QAT (Quantization Aware Training,量化感知訓練)真的做上來了。再加上現在也支援 MTP,Gemma 4 這代在本地模型的能力和效能上,整體都往前推了不少。總算看到除了 Qwen 之外,其他實驗室開始打出像樣的競爭了;最近的 local AI,真的很像一直都是 Qwen 在 carry。

Google Just Found a Loophole in AI Hardware Limitations
Categories: 模型

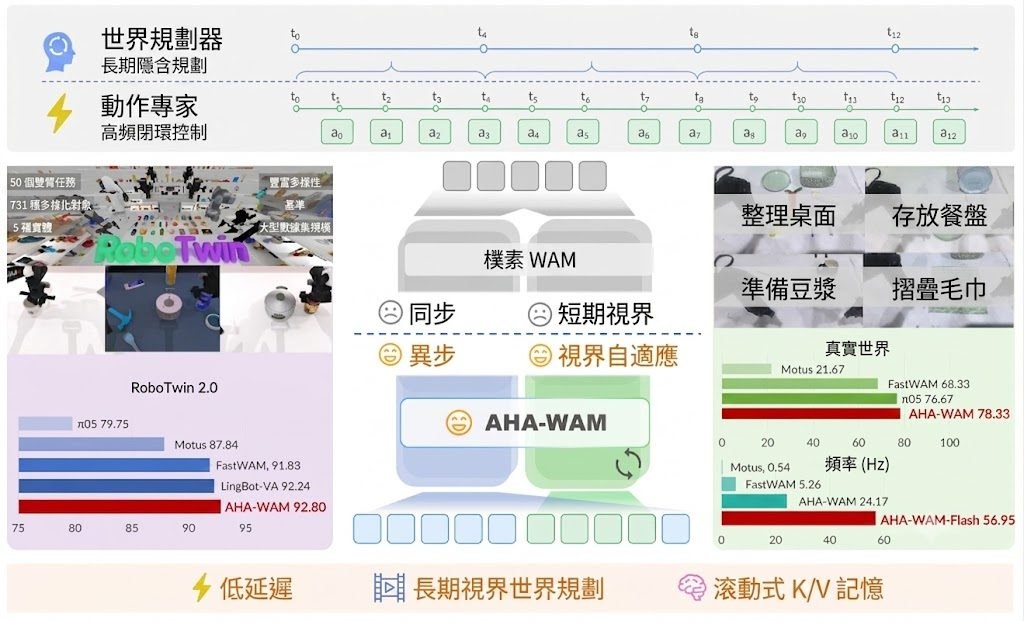
AHA-WAM:讓機械人決策一致的世界動作模型

AHA-WAM 透過分離長程規劃與高頻動作執行,解決機械人策略中節奏錯位的難題,並在模擬與真實環境均創下新高成功率。

PDF

機械人學習操作技能時,往往要把「預測未來畫面」和「即時輸出動作」綁在同一個節奏上,導致規劃與控制互相拉扯。上海交通大學、百度智能雲及上海人工智能實驗室等團隊提出的 AHA-WAM(Asynchronous Horizon-Adaptive World-Action Modeling)項目,就是要把兩者拆開來處理。

核心架構:雙分支異步運作

AHA-WAM 採用兩個 Diffusion Transformer(DiT)分支:低頻的 video DiT 負責長程的視覺世界規劃,並利用滾動式 K/V 記憶體儲存可重用的上下文;高頻的 action DiT 則接收本體感覺訊號,向 video DiT 查詢所需上下文後,即時產生短時閉環動作區塊。兩者各司其職,避免互相拖累。

兩項關鍵訓練與推論機制

  • Horizon-Adaptive Offset Training(水平自適應偏移訓練):讓執行器在規劃器與執行器出現相位差時仍能穩定運作。
  • Observation-Guided Video-Context Routing(觀察引導的視覺上下文路由):根據最新觀察調整快取的規劃上下文,無需重新運行 video DiT 即可對齊當下狀態。

實測表現亮眼

在 RoboTwin 2.0 模擬環境的 50 項雙臂任務中,AHA-WAM 達到 92.80% 平均成功率,且無需任何機械人數據預訓練;在四項原始設定的真實雙手任務中則取得 78.33% 成功率。控制頻率方面,閉環頻率達 24.17Hz;經 ODE 蒸餾的輕量版 AHA-WAM-Flash 更可達 56.95Hz,相比 Fast-WAM 提升約 10.82 倍。

AHA-WAM 適合研究世界模型、機械人操控策略,以及追求高頻閉環控制的開發團隊;其異步架構亦為離線規劃與即時控制分離的設計思路提供新參考。

項目: https://serene-sivy.github.io/aha-wam/

Categories: 開源, 香港大學, 上海人工智慧實驗室, 模型, 視頻模型, 世界模型, 百度

SwiftVR:低清、模糊影片實時修復

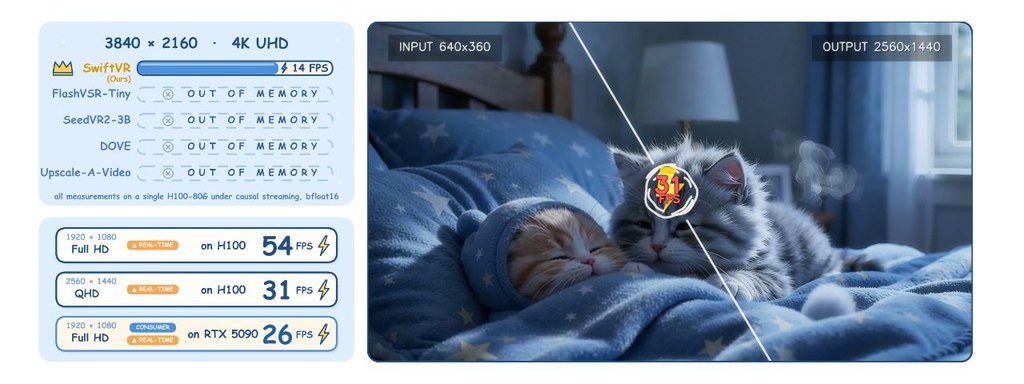
SwiftVR 以單步生成式框架在 RTX 5090 達到 1080p 即時修復,並在 H100 上一路衝到 4K,挑戰了擴散式影片修復的延遲與記憶體極限。

SwiftVR qualitative comparison

把低清、模糊的影片即時變成清楚版本,一直是擴散式(diffusion-based)影片修復(VR, Video Restoration)模型的痛點:畫質漂亮,卻慢得跑不動。SwiftVR 是一個以單步生成(one-step generative)路線設計的串流修復框架,主打把高解析度延遲壓到可即時播放的範圍,同時保持擴散模型的視覺品質。

為何能跑得這麼快? 項目作者從兩個瓶頸下手。第一是空間注意力在高解析度下的二次方成本:SwiftVR 引入 MFSWA(Mask-free shifted-window self-attention),把每個空間窗口預先重排成稠密張量,讓每次注意力呼叫都走標準的 SDPA(Scaled Dot-Product Attention)路徑,省掉遮罩、循環位移、稀疏 kernel,吞吐量比全注意力教師模型提升約 1.62×。第二個瓶頸是傳統 3D VAE 解碼太笨重:他們改用一個輕量級的 ReAE(Restoration-aware Autoencoder),與 DiT(Diffusion Transformer)聯合在像素空間微調,讓分塊解碼不再卡住流水線。

數字上多誇張? 同一個權重檔,在單張 H100 上,QHD(2560×1440)24 幀約 31 FPS、4K(3840×2160)約 14 FPS,而所有比較的擴散式 VR baseline 在 4K 都 OOM(Out-of-Memory,記憶體溢位)。換到消費級的單張 RTX 5090,1080p 可達約 26 FPS,達到即時串流門檻,且全程不需重寫 kernel 或重新訓練。所有推理走預設 PyTorch SDPA 與 bfloat16。

誰適合關注? 需要為直播、視訊會議、老片修復平台做即時前處理的研究員與工程師;對 DiT、串流推理、邊緣部署有興趣的開發者;以及想找一個 open-source 起點、把生成式 VR 推上消費硬體的團隊。

與同類相比的相對位置: 對照組 DOVE、SeedVR2-3B、FlashVSR-Tiny 在 QHD 下分別約 0.85、1.39、9.61 FPS,SwiftVR 約 31.32 FPS,速度差距明顯。論文亦宣稱在無參考感知品質指標上具競爭力,但具體分數請以原論文表格為準。

重點摘要:

  • 單步生成路線:放棄多步擴散,以一步生成換取低延遲。
  • MFSWA 注意力:把窗口預聚集成稠密張量,繞過稀疏 kernel。
  • ReAE 解碼器:取代 3D VAE,解放分塊解碼的瓶頸。
  • 因果分塊串流:無滾動 KV、快取即可限制時間軸成本。
  • 消費級硬體可達即時:RTX 5090 1080p 約 26 FPS,H100 一路到 4K。

GitHub: https://github.com/H-oliday/SwiftVR

項目: https://h-oliday.github.io/SwiftVR/

Categories: 開源, 模型, 視頻模型, 影像處理

LatentSpatialMemory:Mirage 影片世界模型:把 3D 記憶藏在潛在空間裡

微軟與浙江大學等團隊發表 Mirage,把 3D 場景以潛在 token 形式持久保存,讓影片世界模型兼顧一致性與效率。

Latent Spatial Memory logo

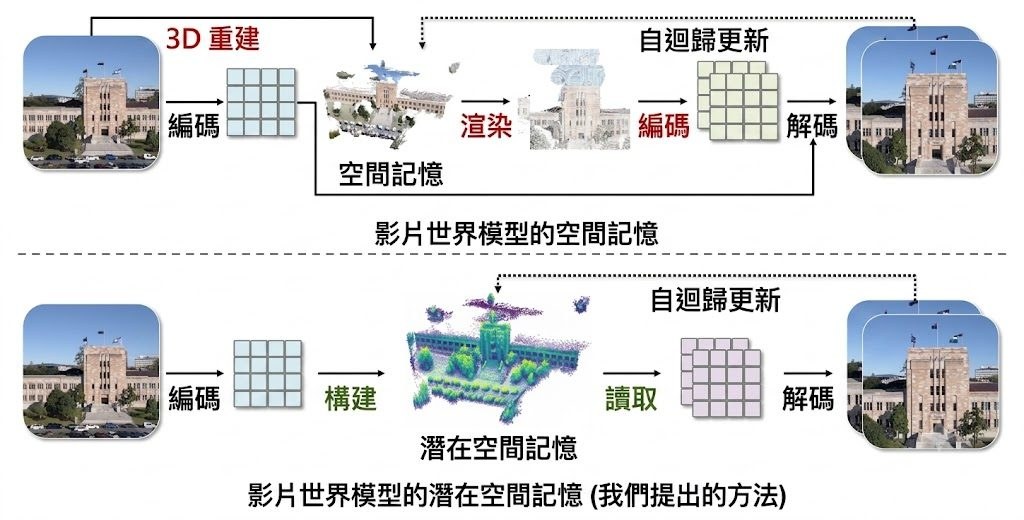
由微軟研究院、浙江大學、阿德萊德大學及 Monash University 共同發表的 Mirage,主打一個名為「Latent Spatial Memory」的方法,目標是讓 AI 影片世界模型在長序列生成時,仍能維持空間一致性。傳統做法會把 3D 場景快取為點雲,再反覆渲染成 RGB 影像重新編碼,Mirage 則直接把靜態場景以 3D latent tokens 儲存,於潛在空間中完成讀取、去噪與更新,繞開了 RGB 來回轉換的開銷。

這個項目想解決的問題很明確:影片世界模型在長時間生成下,3D 快取會愈來愈大、速度愈來愈慢,但場景內容其實變化有限。 Mirage 把「場景記憶」與「生成流程」解耦,用一套 Initialize、Read、Denoise、Update 的記憶生命週期,讓模型在生成每個 chunk 時直接讀寫一份共享的潛在快取,省下重複編碼的成本。

依據官方項目頁公布的 World-R1 基準數據,Mirage 達到約 70.36 的 WorldScore 平均成績,生成速度達到 10.57 倍提升,3D 快取記憶體用量則降低約 55 倍。論文亦提供與 Spatia、Voyager、Gen3C、VMem 等四個基準的定性比較,覆蓋同一軌跡下的條件輸入結果。官方程式碼則標示為「Coming Soon」,目前較適合研究員先閱讀論文與項目頁示範影片。

這個項目特別適合研究影片世界模型、3D 場景理解或擴散模型加速的團隊與學生,亦可作為 generative world model 課程的延伸閱讀。 對一般讀者而言,它展示了把「記憶」留在潛在空間而不還原成像素,是兼顧一致性與效率的可行方向。

重點摘要:

  • 核心方法:以 3D latent tokens 儲存靜態場景,避免 RGB render-and-reencode。
  • 記憶生命週期:Initialize、Read、Denoise、Update 四個步驟跨 chunk 共享快取。
  • 效率數據:World-R1 上生成速度約 10.57 倍、3D 快取記憶體降約 55 倍、WorldScore 70.36。
  • 比較基準:Spatia、Voyager、Gen3C、VMem。
  • 目前狀態:論文已公開,程式碼尚未釋出。

GitHub: https://github.com/microsoft/LatentSpatialMemory

項目: https://microsoft.github.io/LatentSpatialMemory/

Categories: 開源, 模型, 框架

Stream3D-VLM 把串流影片變成 3D

處理的不只是影片,而是邊看邊理解空間。Stream3D-VLM把串流畫面、幾何資訊與語言回應連起來。

Stream3D-VLM Logo

Stream3D-VLM 是一個 online 3D vision-language model,重點是直接從串流影片做即時空間理解,而不是等整段影片或整個場景收集完才分析。對想研究機械人、空間問答,或 3D 場景互動的人來說,這個項目處理的是「模型可否一邊看、一邊建立場景概念,再即時回答問題」這件事。

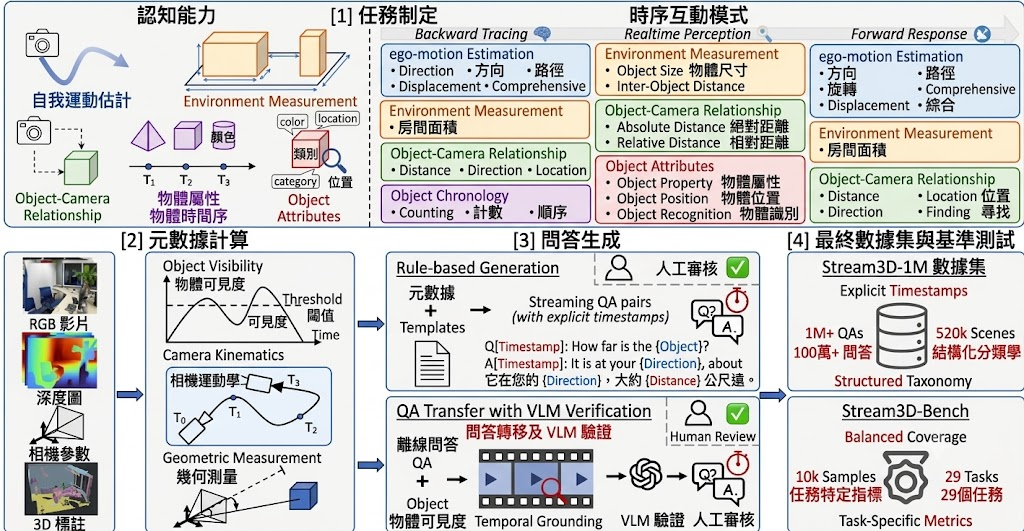
使用這個項目時,核心資源包括已公開的 Stream3D-VLM-4B 模型、Stream3D-1M Dataset,以及 Stream3D-Bench。資料方面未有直接釋出原始媒體,但有提供標註、GLB 與 RRD 等重建結果;GLB 可放入一般 3D viewer 逐步查看點雲,RRD 則可配合相機姿態與點雲記錄觀察完整重建流程。

Stream3D-VLM 加入 incremental geometry priors,令模型隨時間吸收對齊的 3D 幾何線索。項目亦提出 Visual-Spatial Feature Integration(VSFI)模組,以及 Geometry-Adaptive Voxel Compression(GAVC)模組,前者負責把幾何資訊逐步注入視覺串流,後者用 3D 結構去壓縮 visual tokens,減少長序列推理負擔。

團隊亦建立了可擴展的資料生成流程,整理超過 1M online spatio-temporal 3D QA pairs,並設計涵蓋 29 項任務的基準。項目聲稱在 online 與 offline 的 3D spatial understanding、reasoning、grounding 任務上,表現優於部分 proprietary 與 open-source models;不過文章未在這份資訊中列出完整數字,閱讀結果時仍要配合論文與實驗頁面一起看。

  • 解決痛點:傳統 3D Large Multimodal Models 多數依賴離線處理,這個項目改為面向 streaming video。
  • 主要方法:結合 autoregressive streaming control、VSFI 與 GAVC。
  • 資料與基準:提供 Stream3D-1M Dataset 標註及 Stream3D-Bench,涵蓋 29 項任務。
  • 可視化資源:支援 GLB 與 RRD,方便檢查增量重建與相機軌跡。
  • 相關模型:已公開 Stream3D-VLM-4B,可作為了解整體能力的主要入口。

整體來看,Stream3D-VLM 最適合用來觀察 3D 多模態模型如何由「看完整段再答」走向「邊看邊答」。它未必是一般開發者即裝即用的輕量工具,但對研究串流場景理解、3D 問答、空間推理流程的人,這個項目有相當清晰的方向與實驗野心。

GitHub: https://github.com/hanxunyu/Stream3D-VLM

項目: https://stream3d-vlm.github.io/

Categories: 香港科技大學, 騰訊, 模型, 視覺模型, 多模態模型, NVIDIA, Robotic

Stable-Layers:靠 VLM 評分強化學習,毋須配對數據也能改良圖層分離

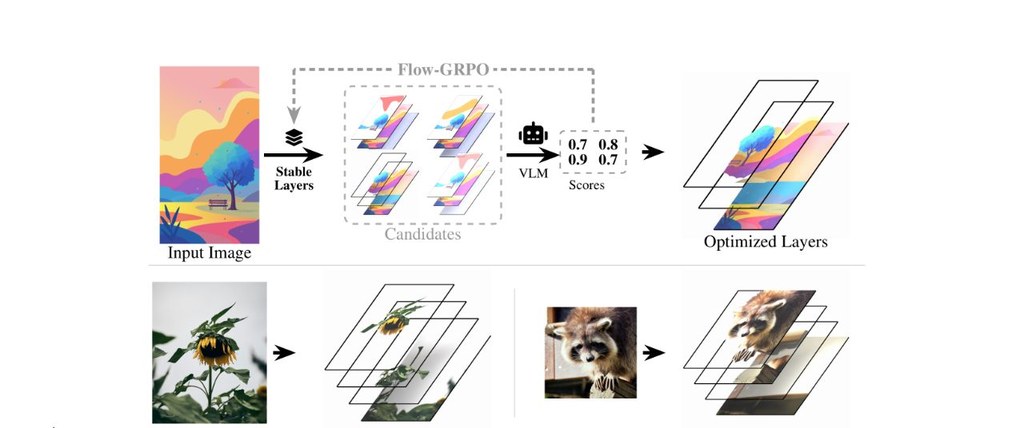
Stability AI 提出 Stable-Layers 框架,利用 VLM 評分與 Flow-GRPO 微調圖層分解模型,解決配對數據不足的限制。

Hero image preview

圖像圖層分解(image layer decomposition)是指把一張圖分成幾層可獨立編輯的 RGBA 影像,再合併回原本的畫面。這個技術是專業修圖與合成工作流的基本工序,但要訓練模型做這件事並不容易:同一張圖往往存在多種合理分層方式,而且品質好壞取決於下游是否好用,例如語意分層是否清晰、alpha 遮罩是否乾淨、是否有冗餘層,以及被遮擋的部分能否被合理填回。

傳統做法會用合成的配對數據集(即同一張圖同時提供「原圖」與「正確分層」)來監督模型學習,但這會帶來先天限制:當多種分層都同樣合理時,強迫模型擬合單一標準答案,等於懲罰了其他可行的解法。Stable-Layers 嘗試繞過這個限制,改用強化學習(reinforcement learning)讓模型直接朝「看起來品質好」的方向優化,監督訊號只來自一個視覺語言模型(vision-language model,VLM)。

具體而言,項目以 Qwen-Image-Layered 為起點,結合 Flow-GRPO 與 LoRA(Low-Rank Adaptation,低秩適應)微調,針對每張圖採樣多個候選分層,再用 VLM 評分,從群組相對優勢(group-relative advantages)來更新策略。當中最大的挑戰是設計可靠的獎勵訊號:VLM 單獨評分時容易把所有樣本擠進一個狹窄的分數區間,導致 GRPO 缺乏組內變化可以學習。為此,Stable-Layers 採用兩階段評估流程——先按五個編輯向標準逐項評分,再把所有候選並排放在標記好的比較網格上重新評分一次,藉此取得更細緻的相對校準。

Stable-Layers 重點摘要:

  • 毋須配對數據:在完全沒有標註的圖像上訓練,解決合成數據集帶來的偏誤問題
  • VLM 擔任評審:利用視覺語言模型就五個編輯標準打分,提供獎勵訊號
  • 兩階段評估:先獨立評分,再以比較網格重新校準,避免分數過度集中
  • 強化學習微調:結合 Flow-GRPO 與 LoRA,從 Qwen-Image-Layered 開始改良
  • 實測表現:在 Crello 數據集上,圖層分離度更高、空白或帶瑕疵的層更少、每層重建誤差也較低

適用場景與對象:這個項目適合做圖像編輯、合成或設計工具的研究者與工程師,尤其是手上沒有大量配對分層數據、又想提升分層品質的團隊。對強化學習應用於視覺生成感興趣的人,也能從它處理「組內變化不足」的設計中得到啟發。

效能與評估:團隊在 Crello 數據集上測試,結果顯示 Stable-Layers 相比基礎模型,圖層分離更明確、出現空白或帶雜訊的層更少,而且每層的重建誤差也更低。論文獲 NeurIPS 2026 接收(arXiv:2605.30257v1)。

引用的模型:Qwen-Image-Layered(基礎分層模型)、Flow-GRPO(強化學習算法)、LoRA(高效微調方法)、視覺語言模型評審。

項目: https://stability-ai.github.io/stable-layers.github.io/

Categories: 開源, 模型, 影像模型, 影像處理, 深度學習

VideoKR:為影片理解補上「知識與推理」拼圖

一個專為知識密集影片理解而設的大型訓練語料庫,搭配專家標註評測集,挑戰模型真正看懂影片而非依賴文字捷徑。

overview

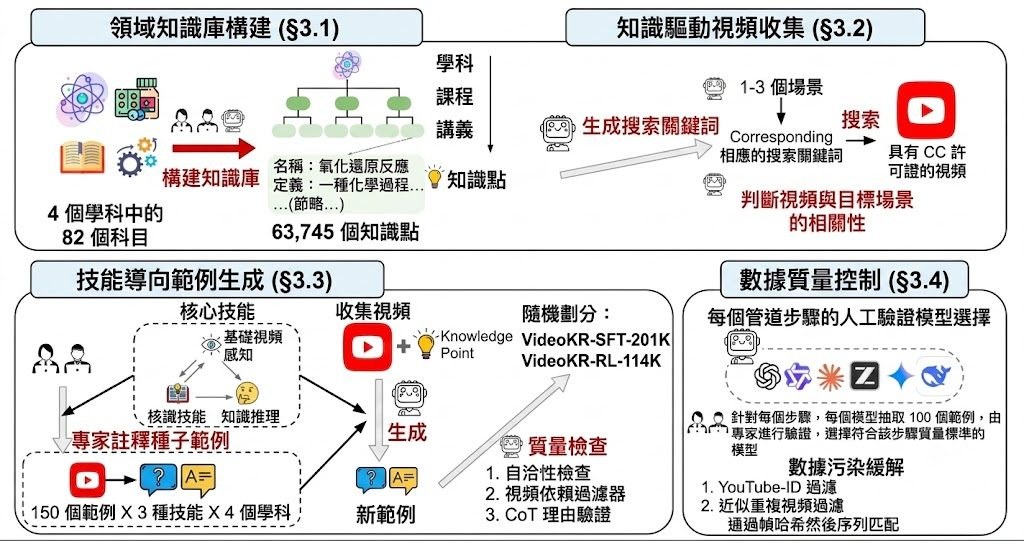
過往的影片問答模型,往往只在畫面表層打轉,碰上需要專業背景的內容就顯得吃力。VideoKR 正是針對這個缺口而設計,被稱為首個專為知識與推理密集型影片理解打造的大規模訓練語料庫,內含 31.5 萬條影片推理範例,橫跨 14.5 萬段以 CC 授權新蒐集的專業領域影片。

整個語料庫採用「人機協作、技能導向」的生成流程,刻意提升題目難度、題材多元性,以及 Chain-of-Thought(CoT)推理過程的品質。換句話說,模型不只是被餵大量影片,還要學會「怎樣一步步推論出答案」,而這個訓練流程分為監督式微調(SFT)與 GRPO 強化學習兩個階段,使用了 LLaMA-Factory 與 verl 兩個框架。

評測方面,項目同時釋出 VideoKR-Eval,由專家人工標註,要求模型真正理解影片內容,不能靠文字提示取巧。完成訓練後釋出的權重包括 VideoKR-Qwen2.5-VL-7B-SFT、VideoKR-Qwen3-VL-8B-SFT,以及對應的 GRPO 版本 VideoKR-Qwen2.5-VL-7B 與 VideoKR-Qwen3-VL-8B,涵蓋兩款主流視覺語言模型,方便不同算力門檻的研究團隊選用。

這個項目適合從事多模態研究、需要領域知識影片分析的團隊,以及關注 SFT-GRPO 訓練管線效果的工程師。對教學與科研機構而言,CC 授權的素材也可作為延伸應用的起點。

重點摘要

  • 首個大規模語料庫:31.5 萬條推理範例、14.5 萬段 CC 授權專業影片。
  • 人機協作生成流程:兼顧難度、多元性與 CoT 推理品質。
  • 專家標註評測集 VideoKR-Eval:避免模型依賴文字捷徑作答。
  • SFT 與 GRPO 雙階段訓練:使用 LLaMA-Factory 與 verl 框架。
  • 開源權重齊備:涵蓋 Qwen2.5-VL-7B 與 Qwen3-VL-8B 兩個規模。

GitHub: https://github.com/Fu-Fu-Fu-Fu/VideoKR

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練

AffordanceVLA:為機械臂加入「先想再做」的能力

這項目把視覺、語言與動作三者之間的落差,透過三段式可供性預測串起來,讓機械臂在執行指令前先理解該碰哪裡、怎麼碰。

AffordanceVLA overview

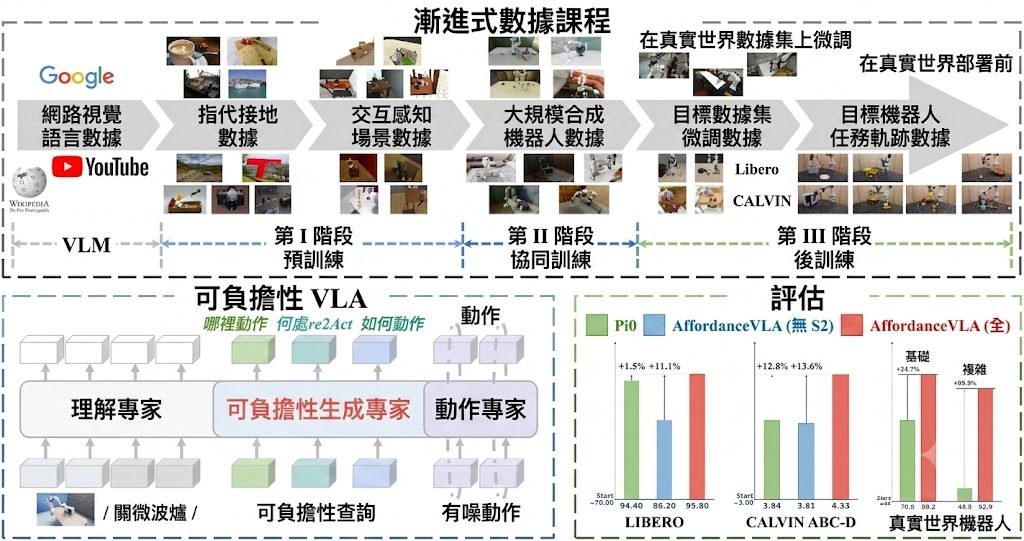
機械臂聽到「把杯子拿起來」這類指令時,傳統的視覺語言動作模型(Vision-Language-Action Model, VLA)往往要直接把影像和文字翻譯成關節角度,中間欠缺一個「思考」步驟。AffordanceVLA 嘗試在這個鴻溝上架一道橋:先讓模型預測結構化的可供性(affordance),再據此生成動作。

整個框架由三個專家模型組成,按單向的 UAA 注意力串接。Understanding Expert(M_und)以 PaliGemma(SigLIP + Gemma)為骨幹,把畫面、指令與機械臂自身狀態融合成統一的語意表示。Affordance Generation Expert(M_gen)以 Gemma 搭配可學習查詢,把上述表示解碼為三種可供性標記:Which2Act 判斷要操作的物件、Where2Act 標出二維互動熱區、How2Act 則推估三維幾何資訊。最後 Action Expert(M_act)以 flow matching 方式輸出整段動作序列(action chunk)。這個設計呼應了論文「Affordances serve as a perfect bridge」的核心想法。

由於現成機器人數據集中缺乏密集的可供性標註,作者額外提供了一條自動化標註管線,並以三階段漸進式課程訓練 MoT 架構。訓練時須留意 model.chunk_size 與 data.chunk_size 保持一致,否則動作 attention mask 會錯位;Which2Act 的 Flux loss 預設為 MSE,可在 src/models/which2act_decoder.py 頂端切換。

這個項目適合研究 VLA、機器人操作策略,或對可供性表示有興趣的開發者。需要一支能跑 PaliGemma 與 flow matching 的 GPU 環境,並準備好仿真或實機評測流程。論文中的模擬與真機實驗橫跨多種操作場景,顯示加入可供性中間層能提升泛化與精確度,但具體數字仍以官方報告為準。

重點摘要

  • 以 Which2Act、Where2Act、How2Act 三段式可供性作為視覺、語言與動作之間的中間橋樑。
  • 採用 MoT 架構,串接 PaliGemma 為基礎的 Understanding、Gemma 為基礎的 Affordance 與 Action Expert。
  • 配套自動化可供性標註管線,緩解機器人數據標註不足的問題。
  • 訓練採三階段漸進式策略,flow matching 輸出整段動作序列。
  • 模型、訓練與標註腳本皆隨開源項目釋出,歡迎社群延伸。

GitHub: https://github.com/Skywalker-yqz/AffordanceVLA

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, 模型, 多模態模型, 模型訓練

用 20 萬小時訓練的開源語音合成:PilotTTS 強在哪?

高德地圖旗下團隊發佈的 LLM-based 文字轉語音項目 PilotTTS,以精簡架構配合嚴謹的資料工程,在 Seed-TTS 基準取得頂尖成績,並完整開源資料處理流程與模型權重。

Introduction

PilotTTS 是高德地圖(Amap)團隊在 GitHub 上開源的文字轉語音(text-to-speech, TTS)項目,主打以 LLM-based 架構配合嚴謹的資料工程,用較少資源做出具競爭力的合成品質。對想研究語音生成、卻沒有百萬小時資料和龐大算力的團隊來說,這是一個值得關注的選擇。

這個項目要解決的問題很直接:現今最頂尖的 TTS 系統往往依賴數百萬小時的私有資料和複雜的多階段架構,進入門檻極高。PilotTTS 反其道而行,僅以 20 萬小時、以全開源工具處理的資料集進行訓練,並釋出從品質評估、標註到過濾的完整資料管線(data pipeline),讓其他研究者能重現並改良。

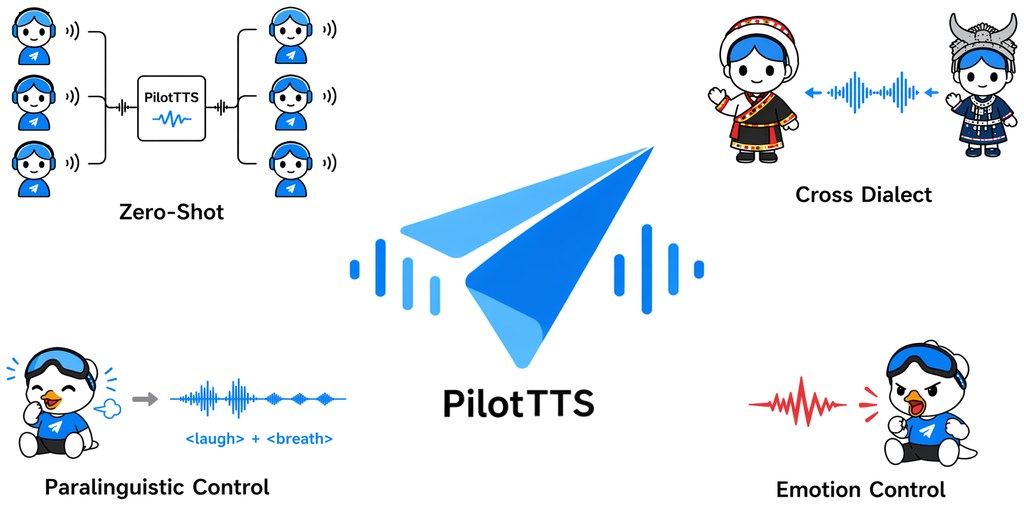
在功能面上,項目涵蓋四個面向:零樣本聲音複製(zero-shot voice cloning)、11 種情緒合成、4 種副語音效果(如笑聲、呼吸、咳嗽、哭聲),以及 14 種中文方言的跨方言合成。模型方面,權重分為 pilot_tts.pt(基礎模型)與 pilot_tts_instruct.pt(指令控制版本),可從 HuggingFace 或 ModelScope 下載,配合 w2v-bert-2.0 等開源特徵提取器即可運作。

評估結果方面,團隊在 Seed-TTS Eval 基準上報出了亮眼數字:英文測試集 WER 1.50%、中文 CER 0.87%,兩組測試的說話人相似度(speaker similarity)分別達到 0.862 與 0.815,勝過多個以更大資料集訓練的系統。模型採用 Q-Former-based conditioning,透過跨樣本配對訓練把說話人身份與語氣風格解耦,這是它在精簡架構下仍能保持高表現的關鍵設計之一。

對一般讀者而言,這個項目較適合從事語音合成、LLM 多模態應用或中文方言研究的開發者與學生;對想打造有聲內容、配音工具或無障礙語音介面的產品團隊,它也提供了可直接整合的開源權重與推理流程。

重點摘要

  • 極簡架構:LLM-based 自迴歸模型,以 20 萬小時開源資料處理後的訓練集達到頂尖基準成績。
  • 完整資料管線:品質評估、標註、過濾全部使用公開工具,可重現且成本較低。
  • 多維度控制:支援 11 種情緒、4 種副語音、14 種中文方言的跨方言合成。
  • 頂尖指標:Seed-TTS Eval 取得最高說話人相似度,中文 CER 僅 0.87%。
  • 完整開源:模型權重、處理管線與程式碼均於 GitHub、HuggingFace、ModelScope 釋出。

GitHub: https://github.com/AMAPVOICE/PilotTTS

項目: https://amapvoice.github.io/PilotTTS/

Categories: 開源, 阿里巴巴, 數字人, 模型

Page 45 of 59
1 … 43 44 45 46 47 … 59