OmniDirector:免配對數據的多鏡頭運鏡克隆技術

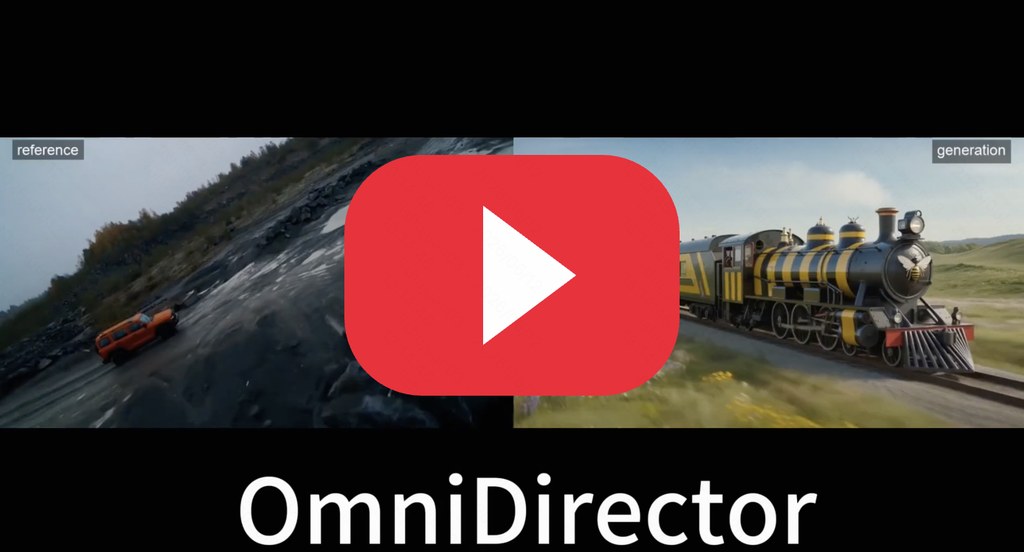
OmniDirector 透過「相機網格」表示法,從多鏡頭影片中克隆運鏡動作,驅動靜態圖像生成動態影片,無需交叉配對數據訓練。

Play video

OmniDirector 由清華大學(Yu-Shen Liu 為北京清華大學團隊)與 Kling Team(快手科技)的研究團隊,共同開發,成員包括 Jiwen Liu、Shujuan Li、Zhixue Fang 等人,團隊來自多個機構,橫跨學術界與業界。研究團隊提出一種無需交叉配對數據的通用多鏡頭相機克隆方法,解決從參考影片中複製運鏡來驅動靜態圖像的難題。

傳統相機控制方法往往依賴大量成對數據進行訓練,而 OmniDirector 的核心創新在於提出「相機網格」(camera grid)表示法。將參考影片的相機姿態渲染為三維空間中的運動軌跡,形成統一的網格表示。配合階層式提示詞擴展代理(hierarchical prompt expansion agent),把多模態控制信號整合成協調的指令。

使用時,使用者只需提供一張源圖像和一段參考影片,OmniDirector 便能克隆其中的運鏡動作,生成動態影片。多鏡頭場景下,新方法支援鏡頭之間的連貫過渡與一致的內容呈現,保持原始的視覺語言。特殊運鏡方面,涵蓋希區柯克式變焦、子彈時間與鏡頭畸變效果,適用的場景類型包括人像、動物、建築及 AIGC 內容等。

OmniDirector: General Multi-Shot Camera Cloning without Cross-Paired Data

OmniDirector 適合從事影片創作、動畫製作或需要快速生成動態素材的內容創作者,以及研究相機控制技術的開發者。經過與其他頂尖相機控制方法的對比,新方法在控制穩定性與物件形變方面表現出色。

重點摘要:
– 核心創新為「相機網格」表示法,免依賴交叉配對數據
– 支援極端運鏡、多鏡頭連貫過渡與特殊相機效果
– 場景泛化能力強,涵蓋人像、動物、建築及 AIGC 內容
– 開源提供論文與程式碼,方便研究與應用

目前 github.com/lisj575/OmniDirector 這個倉庫是空的,沒有 source code 或 model 。
項目: https://ymlinfeng.github.io/OmniDirector.github.io/

Categories: 北京大學, 清華大學, AI productions, 數字人, 模型, 視覺模型, Video, 框架

Orchestra-o1:多智能體協作框架拆解複雜多模態任務

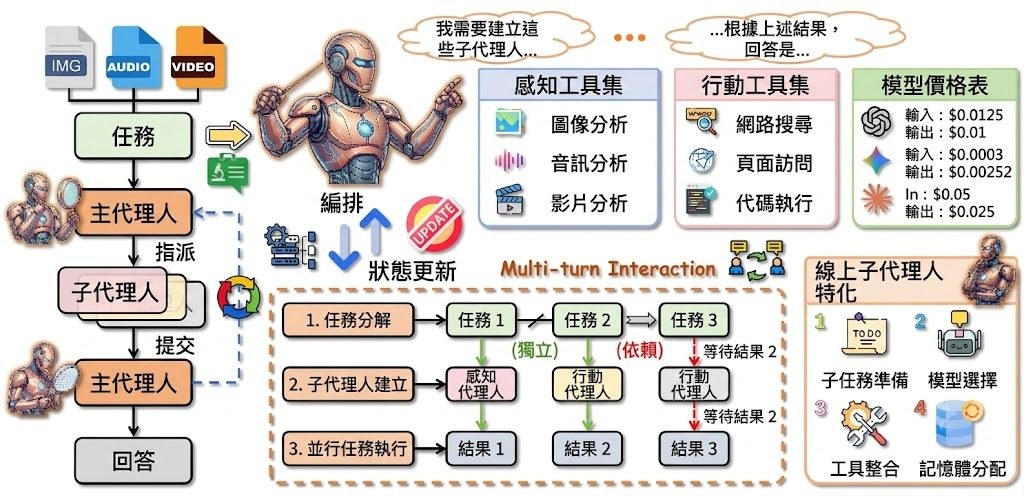
由香港中文大學等團隊研發的 Orchestra-o1 採用 MainAgent + SubAgent 架構,在 OmniGAIA 基準上以 72.8% 準確率領先對手 10.3 個百分點。

Orchestra-o1 Framework

Orchestra-o1 由香港中文大學(CUHK)計算機科學與工程學系的 Fan Zhang 領銜,聯同北京大學、清華大學、同濟大學及 LIGHTSPEED 團隊共同開發。模型權重同步開源於 Hugging Face。

這個項目的定位是多智能體協作框架,針對文字、圖像、音訊、影片並存的「全模態」(omnimodal)場景,自動把複雜任務拆解成多個子任務,再分配給專責的 SubAgent 執行。MainAgent 負責規劃與協調,SubAgent 則配備搜尋、執行程式碼、影音分析等工具獨立運作,獨立子任務可同步執行以提升效率。

重點摘要:

  • 層級式架構:MainAgent 統籌拆解任務,SubAgent 各司其職,避免單一模型疲於應付多模態輸入。
  • 平行執行:無依賴的子任務同步進行,加快整體處理速度。
  • DA-GRPO 訓練法:以 Qwen3-8B 為基礎,搭配 Decision-Aligned Group Relative Policy Optimization 與 LLM-as-judge 獎勵機制微調。
  • OmniGAIA 表現:在 OmniGAIA 基準測試取得 72.8% 準確率,領先第二名 10.3 個百分點。
  • 開源生態:基於 Python 3.10+ 與 verl 框架,訓練需 8 張 H20 (96GB) GPU 單節點。

Orchestra-o1 的創新在於把「模態感知拆解」與「線上子智能體特化」結合,讓多模態協調不再依賴線性流程。適合需要處理多媒體資訊的研究團隊、Agent 開發者,以及關注 Computer-use agents(CUAs)與多模態模型應用的工程師。

效能方面,作者將 Orchestra-o1-8B 定位為同類開源全模態代理中最先進(SOTA),同時在商用模型(例如 GPT-5)推理腳本中亦提供整合,方便研究人員比較開源與閉源路線的差距。

GitHub: https://github.com/zfkarl/Orchestra-o1

Paper: https://arxiv.org/pdf/2606.13707

Categories: 開源, 香港中文大學, Agentic, 模型, 框架, OpenClaw, 深度學習

[技術文章] 從聊天機械人到數碼同事:AI 怎樣學會「持續工作」

一篇文章帶你了解 AI 從只懂回答問題,進化到能像同事般持續完成任務的關鍵轉變。

Hero image preview

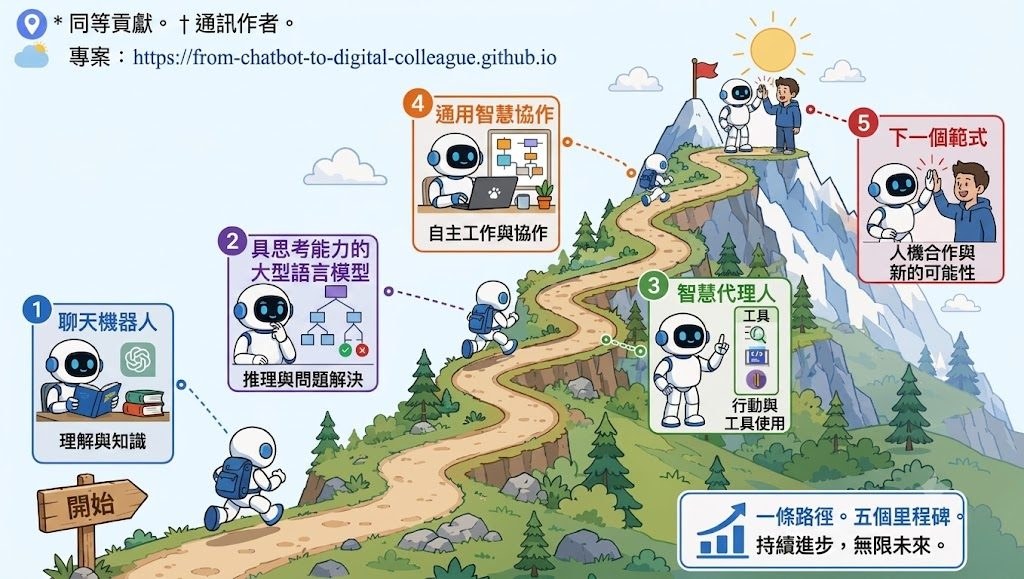
這項文章由騰訊優圖實驗室、清華大學、中山大學、中南大學及伊利諾大學芝加哥分校的研究團隊共同撰寫,提出一個核心觀點:大語言模型(Large Language Models, LLMs)正從「聊天機械人」邁向「數碼同事」,關鍵差異在於能否持續完成工作,而非只給出對話式回應。

團隊將這個轉變拆成兩個互相牽引的維度。第一個是「認知核心」的進化:LLMs 從依賴下一個詞預測的「快思維」,走向會運用推理時間計算、長思維鏈(Chain-of-Thought)、反思及強化學習的「思考型 LLM」,讓推理過程更謹慎可靠。第二個是「工具輔助任務執行」的進化:從臨時呼叫外部工具的 Agent,走向類似 OpenClaw 風格的工作站系統,配備持久化的工作區(Workspace)、可重用的技能(Skill)、驗證迴圈及治理機制。

文章特別強調「Workspace + Skill」這個範式是關鍵躍升。它讓原本零散的工具操作,變成像同事般有狀態記憶、可重用流程、能完成任務並累積經驗的工作模式。數據結構也從簡單的指令—回應配對,演進為「狀態—動作—觀察」的軌跡記錄;評估方式則從靜態基準測試,轉向沙盒化、可審計、能自我進化的 AI 生態系統。

這份內容適合關注 AI Agent 發展、想了解 LLM 下一代形態的研究者與產品設計者。讀者可透過項目網站(from-chatbot-to-digital-colleague.github.io)取得完整論文與相關資源。

重點摘要:
– 由騰訊優圖實驗室主導,聯同清華、中山、中南及 UIC 共同研究
– 提出從「聊天機械人」到「數碼同事」的範式轉移
– 認知層面:從快思維走向推理驅動的「思考型 LLM」
– 執行層面:從臨時工具呼叫走向持久化 Workspace + Skill 系統
– 評估方式同步轉向沙盒化、可審計的 AI 生態系統

Paper: https://arxiv.org/pdf/2606.14502

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, 框架

VISTA 準確提升 GUI grounding

VISTA 不是通用聊天模型,而是用來訓練 GUI grounding 的方法。它針對畫面定位學習訊號不足的問題,效果有明顯提升。

ScreenSpot-Pro accuracy curve

VISTA 是一個面向 GUI grounding 的訓練框架,核心目標是令模型更準確地在螢幕截圖中找出應該點擊的位置。它處理的不是一般文字理解,而是讓模型根據指令,在複雜介面上輸出座標,減少按錯按鈕、點錯輸入框這類問題。

這個項目的重點,在於它不是只從同一張截圖反覆抽樣,而是把同一個 GUI 畫面裁成多個仍保留目標元素的 view,再用這些 view 建立 GRPO 比較組。由於每個 crop 都會精確重映射座標,模型等於在語意相同、幾何位置不同的畫面上學習,能改善單一視角下「全部答錯」或「全部答中」而缺乏學習訊號的情況。

另一個關鍵設計是 self-verified cross-view anchor。它只會在目前 policy 已經產生 maximum-reward rollout 時,才加入 oracle coordinate,避免把訓練直接變成無條件模仿;這點對 GUI 座標生成尤其重要,因為短座標輸出很容易受微小偏差影響。從描述來看,這種做法比標準 GRPO 更重視穩定性,也更保留 reinforcement learning 的比較學習特性。

  • 這是一個訓練方法項目,不是最終應用程式,主要用來提升 GUI grounding 模型表現
  • 核心改動包括 view-consistent GRPO groups 與 self-verified cross-view anchor
  • 在 ScreenSpot-Pro 上,Qwen3-VL 4B/8B/30B-A3B 由 55.5/52.7/53.7 提升至 63.4/65.8/67.0
  • 以 Qwen3.5 初始化的 4B/9B/35B-A3B backbone,亦比 standard GRPO 再高 +2.0/+0.9/+1.2
  • 已公開相關模型包括 VISTA-4B、VISTA-9B

如果你本身有做 Computer-use agents(CUAs)、GUI 自動化、螢幕操作代理,這個項目特別值得留意。它較適合研究人員、模型工程師,或者正在調整 Qwen3-VL、Qwen3.5 視覺語言 backbone 的團隊;一般用家未必會直接部署這個項目,但可以把它視為提升介面定位能力的一套訓練方案。

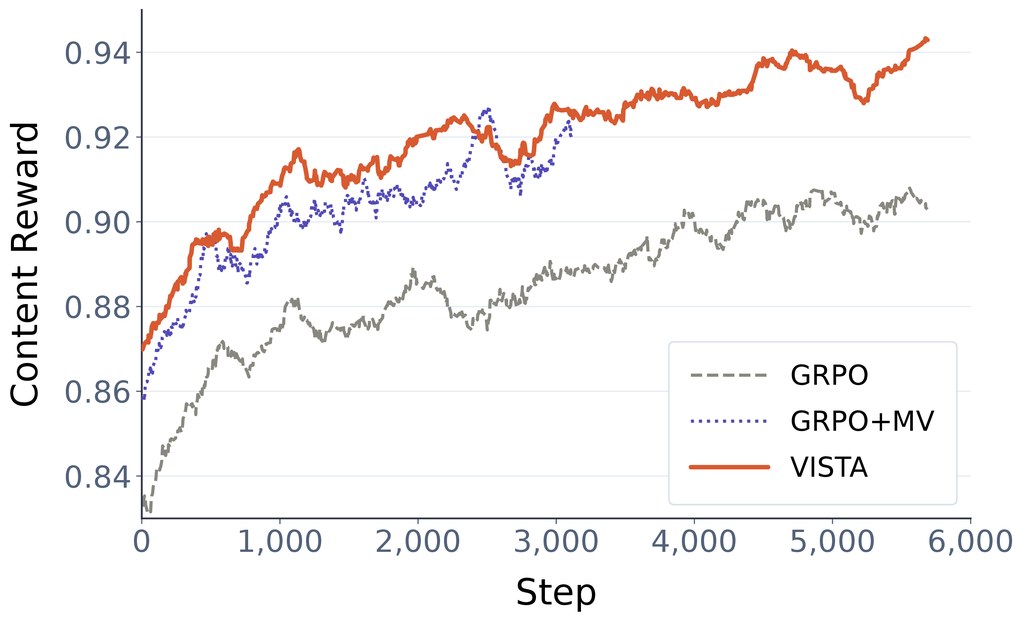
就公開資料看,VISTA 的說服力主要來自基準分數與訓練動態變化:content reward、更高的 informative group ratio,以及 ScreenSpot-Pro 準確度同步上升。再加上論文提到五個 GUI-grounding benchmarks、較高 worst-view accuracy 和較低 prediction flip rates,整體判斷是:這個項目不是靠包裝取勝,而是針對 GUI grounding 訓練訊號退化問題,提出了相當對症的改法。

GitHub: https://github.com/ZJUSCL/VISTA

Paper: https://arxiv.org/pdf/2606.14579

Categories: 開源, 模型, 模型訓練, 框架


SpatialClaw:用程式碼推動空間推理代理

SpatialClaw把程式碼變成代理的動作介面,主攻複雜空間推理。它在20個基準上交出明顯領先的平均成績。

SpatialClaw logo

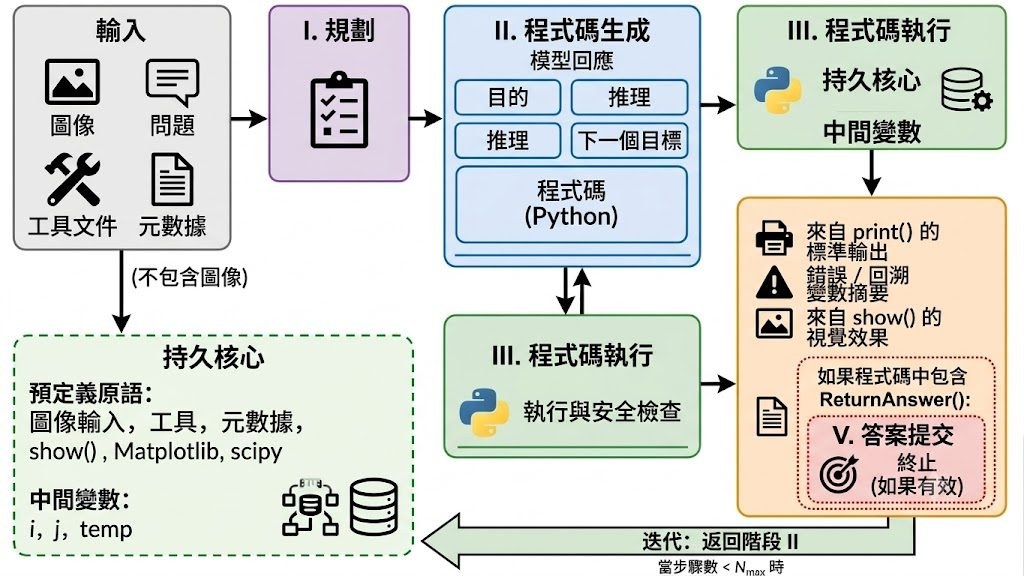
SpatialClaw 是一個免訓練的空間推理框架,重點不是再加更多工具,而是改寫代理如何調用工具。它把程式碼當成動作介面,讓 Vision-Language Model 代理逐步寫入 Python cell,在同一個持續運行的 Jupyter kernel 內查看中間結果、再調整下一步判斷,目標是處理 3D、4D 以及影片場景中的空間理解問題。

這個項目的新意,在於它避開單次執行整段程式或僵硬的 tool-call 方式。代理每次只提交一格程式,能結合 SAM3 segmentation、Depth-Anything-3 reconstruction、geometry utilities,以及 NumPy、SciPy、Matplotlib 這類科學運算庫,分析過程更像逐步查證,而不是一次過猜答案。

如果你想測試它,較合適的做法是用多視角圖片、影片片段,或需要判斷位置、距離、遮擋、移動關係的題目來跑。文件亦提到部署模型有明確硬件要求:FP8 版本需要 Linux 與 NVIDIA Hopper(H100)或更新 GPU;若手上是 A100 或 L40S,則可改用 models.json 內列出的 AWQ 或 GPTQ Int4 條目,並沿用相同 served_name,模型設定毋須重改。這也反映 NVIDIA 近年在 Robotic 與 World Model 相關項目上的投入相當積極。

成績方面,公開資料指出它在 20 個空間推理基準取得 59.9% 平均準確率,比先前最佳空間代理高 11.2 個百分點。更重要的是,這個結果據稱在相同 system prompt、工具組合與 hyperparameters 下完成,覆蓋六個 VLM 骨幹,代表它的提升未必只靠特定 benchmark 微調。

  • 屬於空間推理代理框架,解決 VLM 在 3D/4D 關係判斷上不夠靈活的問題
  • 核心方法是以程式碼作為動作介面,逐步執行與修正分析
  • 支援的感知模組包括 SAM3 segmentation、Depth-Anything-3 reconstruction 與 geometry utilities
  • 公開結果涵蓋 20 個 benchmarks,平均準確率為 59.9%
  • 相關模型家族包括 Qwen3.5、Qwen3.6、Gemma4,規模由 26B 至 397B

這個項目特別適合研究 Computer-use agents、空間智能、機械人感知,或者想比較 tool-augmented agent 與 VLM 推理流程的人。若你關心的不是聊天表現,而是模型能否一步步觀察畫面、調工具、修正推論,SpatialClaw 展示了一條幾有說服力的路線。

GitHub: https://github.com/NVlabs/SpatialClaw

項目: https://spatialclaw.github.io/

Categories: 開源, Agentic, 模型, 視覺模型, NVIDIA

InterleaveThinker 多步生成變得可控

多代理圖像生成流程,重點不在畫得更靚,而是把多步圖文內容排得更準。它特別適合故事分鏡、教學指引與機械操作描述。

logo

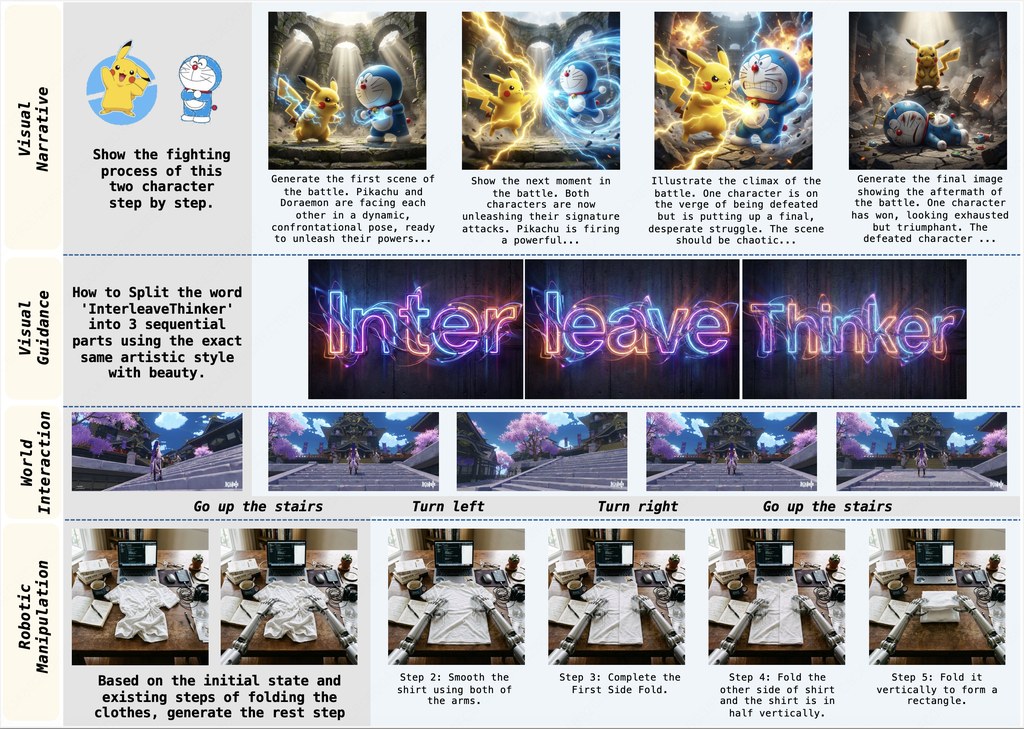
InterleaveThinker 是一個多代理生成流程工具,目標是替現有圖像生成器加入 interleaved generation 能力,即按步輸出文字與圖片交錯的內容。它想處理的,不是單張圖夠不夠精美,而是多個步驟之間是否連貫、是否跟指令一致。

這個項目的核心做法,是把工作拆成 planner agent 與 critic agent。前者先安排圖文序列和每一步任務,後者再檢查生成結果、有偏差就修正指令再生成,做法比單次提示更像一個會反覆校對的流程。

如果你想試它,方向很明確:先接上它已支援的生成器,再用多步任務測試,例如故事場景連續變化、視覺教學、摺衫步驟、角色互動或 embodied manipulation。儲存庫已列出多個可配合的模型端口,包括 Qwen-Image、Qwen-Image Lightning、FLUX.1-Krea-dev、Qwen-Image-Edit Lightning、FLUX.1-Kontext-dev Edit 與 FLUX.1-Fill-dev Fill。

公開資料顯示,它在 interleaved generation benchmark 的表現可與 Nano Banana 及 GPT-5 接近;在推理導向基準也有明顯提升,例如 WISE 由 0.47 升至 0.73,RISE 由 13.3 升至 28.9(4-step FLUX.2-klein)。這些數字反映它的價值主要在「多步一致性與修正能力」,不是單靠底層模型硬撐。

  • 重點不在訓練全新生成器,而是增強現有 image generator
  • 以 planner agent + critic agent 處理多步圖文任務
  • 適合 visual narratives、guidance、embodied manipulation、long-horizon sub-task annotation
  • 已公開相關模型:InterleaveThinker-Planner-8B、Critic-SFT-8B、InterleaveThinker-Critic-8B
  • 另有訓練資料集:Interleave-Planner-SFT-80k、Interleave-Critic-SFT-112k、Interleave-Critic-RL-13k

對研究圖文代理、工作流編排,或者想把現有出圖模型拉進多步任務的人,這個項目很有參考價值。若你只想單次生成一張圖,它未必是最直接的選擇;但若你要的是連續幾步都講得通、畫面不走樣,InterleaveThinker 的定位相當清楚。

GitHub: https://github.com/zhengdian1/InterleaveThinker

項目:https://zhengdian1.github.io/InterleaveThinker-proj/

Categories: 開源, 香港中文大學, 模型, 影像模型, 影像處理

ARM:把生圖與修圖收進同一模型

ARM 用離散 visual tokens 統一理解、生成與編輯,RL 亦為修圖與生圖帶來量化提升。

Institute of Trustworthy Embodied AI logo

ARM 是一個 AutoRegressive Large Multimodal Model(ARM)類型的多模態模型,把圖像轉成離散 visual tokens,再以同一套 next-token prediction 處理理解、text-to-image 和指令式編輯,目標是把三種能力收進單一流程。

它的核心新意,是用 shared visual token space 連接看圖、生成與修圖,再以純 autoregressive multimodal modeling 處理交錯的文字與圖像 tokens。對一般讀者來說,可理解成「把圖片也變成語言模型可續寫的內容」。

• 7B 規模,重點在統一表示
• reinforcement learning(RL)結合 preference optimization
• WISE overall 由 0.50 升至 0.56
• GEdit-Bench-EN overall 由 5.75 升至 6.68

現階段較適合先讀論文和 benchmark。儲存庫節錄未見完整安裝、推理或權重說明,因此目前看來更像研究項目,不一定適合立即部署。

如果你關注 Large Multimodal Models(LMMs)、image editing,或想比較 unified autoregressive models,這個項目有參考價值。可對照的相關模型路線,包括 unified autoregressive models 與主流 image generation systems;論文亦提到它在 GenEval、DPG、WISE 具競爭力。

GitHub: https://github.com/wdrink/ARM

Paper: https://arxiv.org/pdf/2606.11188

Categories: 開源, 字節跳動, 模型, 影像處理, 框架

SCAIL-2 把動畫角色控制再推前一步

SCAIL-2 是一個開源角色動畫模型,主打直接用影片條件驅動角色動作。它想解決骨架與遮罩中介帶來的資訊流失。

Teaser

SCAIL-2 是一個用於 End-to-End Character Animation 的開源模型,重點是把驅動影片的視覺資訊直接送入模型,減少依賴 skeleton、mask 這類中介表示。它要處理的問題很明確:傳統角色動畫控制在複雜動作、多角色互動、跨角色替換時,容易因中介資訊過少或含糊而失真。

這項目在於把多種角色動畫子任務合併成同一套流程,並以 Unified Motion Transfer Interface、in-context mask conditioning 與 mode-specific RoPE 作統一控制。根據公開說明,模型還利用 MotionPair-60K 這類合成動作配對資料訓練,並支援 cross-identity replacement、multi-character animation,甚至 animal-driving 與 mesh-based control 這些 zero-shot 能力。

可調參數包括 denoising steps、flow-matching scheduler shift、classifier-free guidance scale、solver,以及是否啟用 offload model;這些設定會影響生成速度、顆粒感與顯示資源負擔,較適合已有 GPU 環境、想比較不同動畫控制效果的人。

  • 用模型來把驅動動作轉到指定角色身上
  • 不再把 skeleton map 當核心依據,目標是減少資訊流失
  • 已列出相關模型:SCAIL-Preview、Wan-Animate、MoCha、SAM3D-Body
  • 可處理多角色、角色替換、跨身份動畫等場景
  • 推論可調整 steps、guide scale、solver 等參數

如果你是做 AI 影片、虛擬角色內容、動畫研究,或者正留意角色動作遷移技術,SCAIL-2 有一定參考價值。至於效能表現,項目明確表示它在多項任務上優於既有 state-of-the-art approaches。

GitHub: https://github.com/zai-org/SCAIL-2

項目: https://teal024.github.io/SCAIL-2/

Categories: 開源, 模型, 視覺模型, 視頻模型, 影像處理, 框架

Bernini:影片生成與編輯的新路線

Bernini 是統一式的影片生成與編輯框架,目標是令生成與修改片段更可控。硬件要求不低,但定位相當鮮明。

Bernini

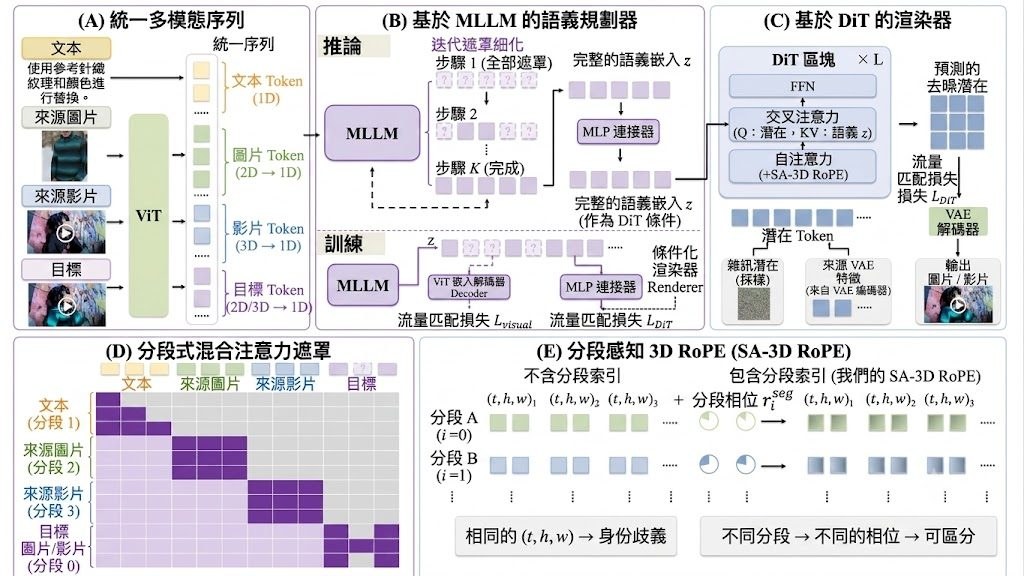
Bernini 是一個影片生成與編輯框架,核心是把 MLLM-based semantic planner 與 DiT-based renderer 組合起來,處理一般影片擴散模型常見的內容漂移、指令跟從不穩定,以及長片段規劃鬆散等問題。從定位看,它不是單純再堆大模型,而是先做語意規劃,再交由生成器落實畫面。

這個項目的關鍵想法,在於「Latent Semantic Planning」:先在潛在空間安排語意,再做 video diffusion。對非研究背景讀者來說,可以理解為先寫分鏡草稿,再逐格畫面化,這比直接由文字一步到位生成影片,更有機會保持故事連貫和編輯意圖一致。

如果想試,較合理的切入點是影片編輯任務,例如風格轉換、字幕或水印移除、局部修改,再觀察輸出有沒有跟足指令。倉庫列出的環境偏高階,建議準備 CUDA 12.4、Python 3.11.2,以及 torch==2.5.1+cu124、diffusers==0.35.2、accelerate==0.34.2、transformers==4.57.3;若有 H100、H800、H200 可配合 FlashAttention-3,其他 CUDA GPU 則退回 FlashAttention-2 或 PyTorch SDPA。

Bernini 在 video editing 的表現進入部分主流 closed-source commercial models 的第一梯隊,評分來自其自建 arena,以人工盲選、Bradley-Terry score 及 pairwise win-rate matrix 彙整。這類結果有參考價值,但暫時主要反映編輯場景;若你關心更複雜的人物生成,官方也提到 1.3B 的 Bernini-R 在簡單任務接近 14B 版本,面對複雜任務仍有差距。

Bernini: Latent Semantic Planning for Video Diffusion
  • 核心組成是 MLLM-based semantic planner + DiT-based renderer
  • 已公開 Bernini-R 權重,包含 1.3B 版本
  • 適合研究影片生成、影片編輯流程,或想比較規劃式生成方法的人
  • 硬件門檻偏高,Multi-GPU sequence parallel 亦需要 Open-VeOmni
  • 相關模型可先留意 Bernini-R-1.3B-Diffusers,以及文中提到的 14B 變體

整體來看,Bernini 最有價值的地方不是「再一個影片模型」,而是把規劃與渲染拆開處理,令可控性成為主要賣點。若你想找可直接在普通電腦輕鬆跑的項目,它未必合適;但如果你重視研究方向、編輯質素與系統設計,這個項目相當值得細看。

GitHub: https://github.com/bytedance/Bernini

Categories: 開源, 字節跳動, 模型, 視覺模型, 視頻模型, 影像模型, 影像處理, 框架, 語音

Page 44 of 59
1 … 42 43 44 45 46 … 59