MiniMax-H3 Orbit LoRA 360° Bullet Time 環繞鏡頭

一張相片配合同一張首尾關鍵幀,鏡頭可繞主體 360°移動,場景保持凝固並回到原始畫面。

Og image

想把靜態相片製成可循環播放的環繞鏡頭(Bullet Time),MiniMax-H3 360° Orbit LoRA 針對的正是首尾畫面難以對齊、場景容易變形的問題。它是基於 MiniMaxAI/MiniMax-H3、FL2VA variant 的 LoRA adapter,配合同一張圖片作為 first frame 與 last frame,令鏡頭完成連續 360°orbit,而人物和物件維持原本位置、姿勢及形狀。

模型的 instance prompt 明確要求只移動相機,利用 camera parallax 產生視覺變化;模型不應加入縮放、切鏡、變形或新物件。影片末端回到開始畫面,因此多段 orbit 可以串接,減少循環接點出現跳變。

  • 適合產品展示、人物定格、場景掃視,以及需要無縫循環的短片項目。
  • LoRA 屬於附加權重,不能單獨取代 MiniMax-H3;頁面未提供參數規模、上下文長度或訓練細節。
  • MTP draft speculation、v2 更新、檔名變更及 chat template 注意事項亦未有資料,不能據此推斷推論效能或資源需求。

結果比較採用相同 seed、prompt、解析度和 step count,但展示內容仍屬範例,未有量化的畫質、穩定性或速度指標。對需要精確幾何還原、長片一致性或非環繞運鏡的項目,頁面資料不足以證明效果。
模型

Categories: AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 3D, MiniMax, LoRA

WorldPlay2 即時控制互動世界模型

WorldPlay2嘗試令世界模型在多樣場景中持續演化,同時保留即時反應與細緻控制,代價是系統仍未準備好供外部重現。

Repository image for WorldPlay2/WorldPlay2

想令場景隨鏡頭、角色動作和語意事件持續發展,世界模型往往要在即時反應、控制彈性與長時段一致性之間取捨。WorldPlay2 屬於互動世界模型,處理的正是這個矛盾:它可以跨越不同場景與角色生成連貫內容,並回應多種控制訊號。

模型把控制拆成兩層:一層是與影格對齊的連續動作,例如相機俯仰;另一層是結構化語意控制,分開處理場景外觀、角色身份和動態語意事件。這樣做比只依賴單一動作介面更容易表達複合指令,但亦令控制學習和資料整理更複雜。

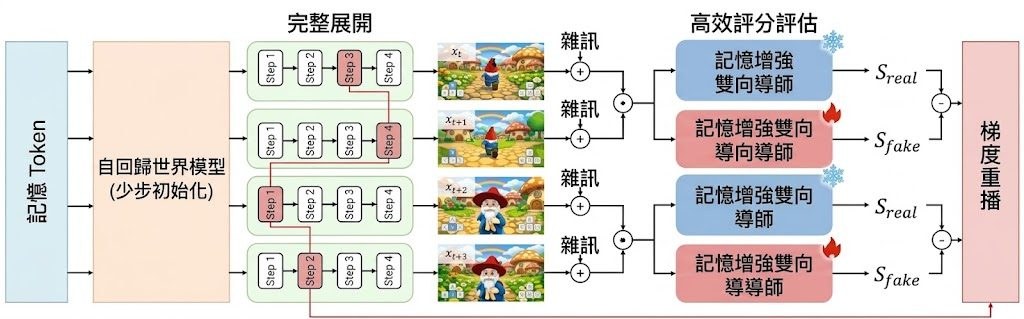
長時段生成由壓縮記憶和 Stable Forcing 支撐。歷史影格會被壓成緊湊的 memory tokens,供自回歸 student 與雙向 teacher 共用,蒸餾時改以分片、受記憶條件約束的分數評估,避免每次都處理整段 rollout;Stable Forcing 則先以少步策略初始化 student,再透過完整 rollout replay 維持長序列品質。

  • 可跨多樣場景與角色保持較長時間的一致性
  • 同時支援影格對齊動作與結構化語意控制
  • 以壓縮記憶降低長時段蒸餾開銷
  • 實驗聲稱整體表現優於既有方法,但未提供可核對的詳細指標

研究者、互動遊戲原型團隊和需要可控視頻生成的開發者較容易從中受益,尤其適合研究鏡頭控制、角色持續性及長期世界演化。儲存庫仍在整理程式碼與權重,README 沒有提供安裝、下載或測試流程,現階段較適合先觀看展示影片和研究方法;正式重現仍要等待相關檔案公開。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, 庫

Audio8 ASR Infinite:持續運行語音轉錄

Audio8 ASR Infinite 以可調音訊時鐘和延遲,處理長時間串流轉錄的反應速度與記憶體增長問題。

Repository image for Edge0-AI/Audio8-ASR-Infinite

長時間錄音、直播字幕或語音助理最怕轉錄愈跑愈慢,甚至因上下文累積而出現漂移。Audio8 ASR Infinite 屬於原生串流語音識別模型,透過 rolling KV cache 將記憶體和延遲維持在有界範圍,支援 24/7 連續轉錄;目前支援中文及英文。

模型可在 80、120、160 ms 音訊時鐘之間選擇,每秒作出 12.5、8.3 或 6.25 次決策,並可將 transcription delay 設於 240 至 560 ms。延遲愈低,回應愈快;較長延遲則有較多時間累積語境。Semantic VAD 亦會分辨思考停頓、口吃和真正句末,減少傳統 acoustic VAD 過早截斷語句的問題。

架構承接 Voxtral realtime audio architecture 和 DSM-style streaming:Causal Audio Tower 以 Voxtral Realtime 4B 為初始權重,Audio Projector 及 Frame Length Embedding 由隨機初始化訓練,Decoder 和 LM Head 則採用 Qwen2.5-3B-Instruct。項目仍屬 preview release,後續會在同一 frame grid 加入即時語義感知。

  • 適合直播字幕、長時間會議紀錄及持續運行的語音介面
  • 可按硬件資源和回應要求調整音訊時鐘及延遲
  • 目前資料未提供完整安裝流程、硬件需求或公開 benchmark 數據
  • 使用 adapted vLLM build 才能對應無限長度串流運行

對需要低延遲、不中斷轉錄的團隊,這個模型的價值在於把速度、延遲可調性和長時間穩定運行放在同一個架構內,但正式採用前仍要自行測量廣東話支援、GPU 佔用及不同時鐘組合的辨識準確度。

項目主頁 · GitHub · 模型

Categories: 開源, Embedding, 模型, 模型訓練, Audio, 語音, Dataset 數據集, 廣東話

LightMIS 以輕量化架構推進醫學影像分割

LightMIS以精簡多尺度編碼器取代傳統逐階解碼器,嘗試在減少模型參數與運算量的同時,維持醫學影像分割表現。

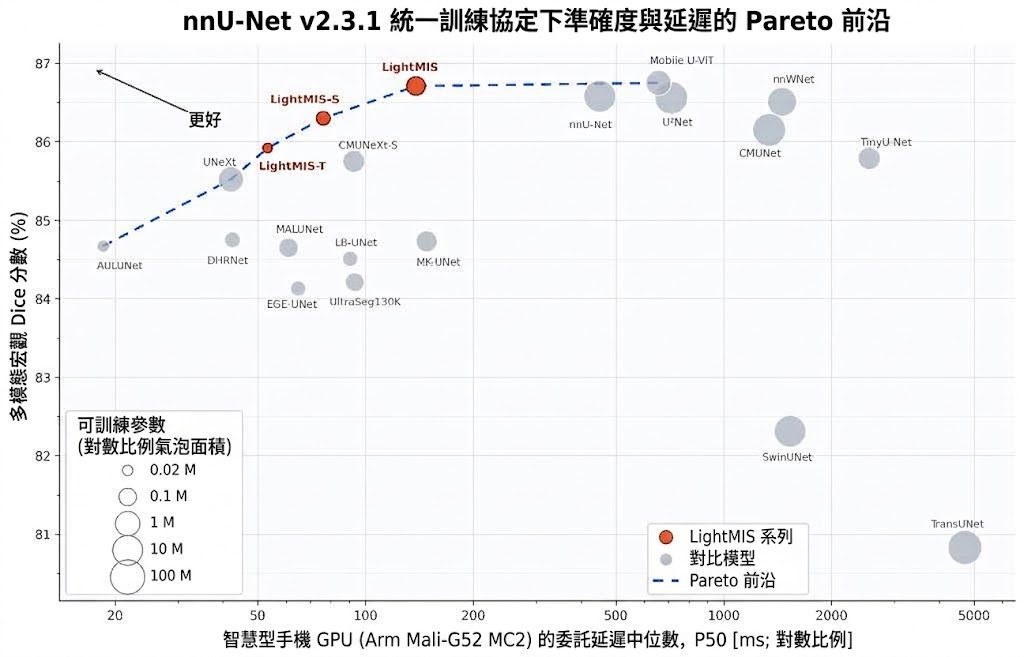
LightMIS accuracy–latency Pareto front

在手機 GPU 上執行醫學影像分割,模型大小與處理速度都會影響部署選擇。LightMIS 是一款面向 2D 二元醫學影像分割的輕量模型,透過精簡多尺度編碼器和聚合式輸出頭,減少傳統逐階解碼器帶來的重複上採樣及特徵融合運算。

模型在每個空間尺度使用 Adaptive Fusion Cascade(AFC)處理特徵;其中的 Progressive Receptive Fusion(PRF)會暫時擴展通道,配合不同深度卷積感受野及分支間逐步傳遞資訊,補足窄通道特徵的表達能力。編碼器各層輸出再由 Scale-Aligned Projection(SAP)對齊至相同解析度與通道寬度,融合後交由最後一個 AFC refinement,毋須沿用逐層上採樣的解碼結構。

在 nnU-Net v2.3.1 的共同測試流程下,研究以六個資料集、五個影像領域及五折交叉驗證評估模型。LightMIS 的區域重疊指標與明顯更大的 Mobile U-ViT、nnWNet 和 nnU-Net 接近,邊界距離結果亦具競爭力;參數量少 90.58% 至 99.61%,GFLOPs 少 82.54% 至 96.14%。

在配備 Arm Mali-G52 MC2 GPU 的手機上,各版本都達到 100% GPU 算子覆蓋率;LightMIS-T 的委派中位延遲為 53.31 毫秒,LightMIS 為 138.31 毫秒。這些結果適合參考於需要控制模型體積、運算量或手機端推理的研究與開發工作,但不代表所有裝置和醫療場景都會有相同速度或準確度。

要重現測試,需配置 nnU-Net v2.3.1,將 DRIVE、Kvasir-SEG、DSB18、BUSI、ISIC-2017 或 ISIC-2018 等資料集轉成 nnU-Net 格式,再執行 2D 規劃、預處理及五折訓練。儲存庫提供資料轉換腳本和訓練器檔案;文章草稿所據內容未包含完整命令及硬件部署流程,不能據此推斷安裝後即可直接在手機執行。

  • 適用任務: 2D 二元醫學影像分割。
  • 核心做法: AFC 與 PRF強化多尺度特徵,SAP 對齊並聚合編碼器輸出。
  • 主要取捨: 減少參數量與 GFLOPs,並省去傳統逐階解碼器。
  • 評估範圍: 六個資料集、五個影像領域,採用五折交叉驗證。
  • 部署參考: 手機 Arm Mali-G52 MC2 上各版本達到完整 GPU 算子覆蓋,但延遲因版本而異。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Image, Medical醫學, 庫

tactile:讓電子皮膚學懂接觸位置的拓撲感知模型

Tactile-JEPA 把分散式觸覺感測器的連接關係納入預訓練,令同一套表徵可支援力量、姿態及動作判斷。

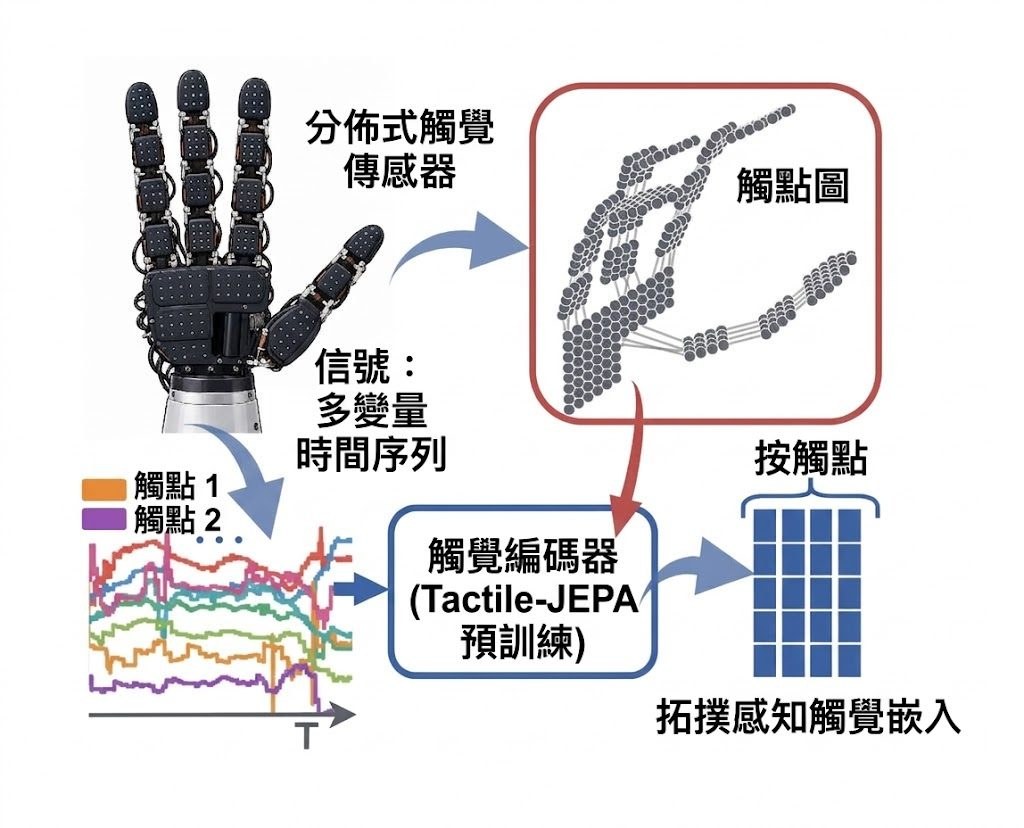
Tactile-JEPA maps distributed tactile signals to topology-aware per-taxel embeddings using the taxel graph during pretra

電子皮膚面對的難題,不只是讀取感測數值,而是要理解哪些 taxel 彼此相鄰、接觸訊號如何在感測表面分布。Tactile-JEPA 屬於觸覺表徵學習模型,透過感測器拓撲預測被遮蔽的 taxel embedding,將原本分散的時間序列轉成可供下游任務重用的表示。

它沒有把感測面硬套成規則影像網格,而是沿着 sensor connectivity graph 抽取局部及全局遮罩;預設組合包含兩個 local masks 和兩個 global masks,兼顧局部接觸細節與整個表面的狀態。模型由 context encoder、exponential-moving-average (EMA) target encoder 和 predictor 組成,predictor 預測隱藏 embedding,再以 mean squared error 對齊 target encoder 輸出;預訓練完成後,凍結的 target encoder 可配合 task-specific heads 使用,而下游編碼不再需要圖結構。

項目涵蓋 Xela magnetic hand skins、piezoresistive tactile socks,以及雙手 DECO-50 等不同感測器形態,支援 force estimation、in-hand 及 full-body pose estimation、object/action classification 和 visuo-tactile policy learning。首頁報告指,模型相對各任務最強基線,in-hand orientation error 減少 20.8%,force estimation error 減少 6.3%,但預訓練模型及論文連結仍標示為 TBD,結果重現程度要視乎後續資源是否補齊。

測試需要 Linux、Conda 及具 CUDA-compatible driver 的 NVIDIA GPU,並由儲存庫建立環境、以 editable package 方式安裝。三個資料集合共涉及數百個 taxels,下載及整理成本不低,較適合研究觸覺感知、機械人操作或 visuo-tactile learning 的團隊;只需要單一感測器分類器的工作,未必能抵銷圖結構整理及 GPU 預訓練成本。

  • 以拓撲遮罩取代影像式規則遮罩,貼近不規則電子皮膚的實際排列。
  • Local 與 global targets 同時捕捉接觸細節及整體感測狀態。
  • 預訓練 encoder 可服務力量、姿態、物件及動作等多種下游任務。
  • 圖結構只參與預訓練,之後的編碼流程較容易接入不同任務。

項目主頁 · GitHub · 模型

Categories: 開源, Embedding, 模型, 模型訓練, Robotic, 庫, Dataset 數據集

Maestro:本地一鍵 AI 創作工作室,把導演、剪接、生成模型打包

Maestro 把 LTX-2.5、MiniMax H3 等本地模型整合成一個創作介面,配合 LLM 編寫分鏡並自動生成音樂影片與短片,適合想在自己機器上完成後期的人。

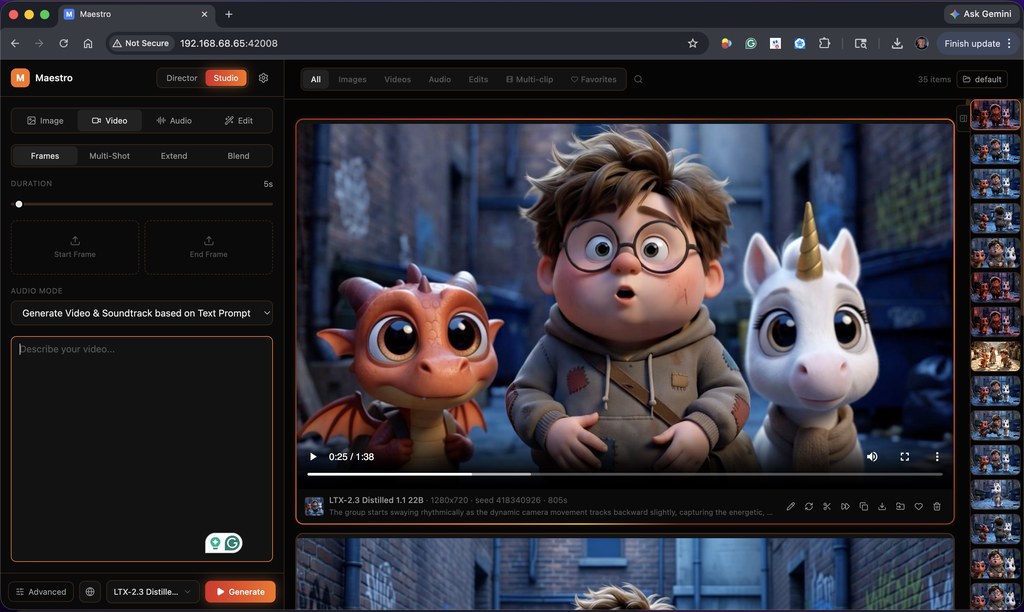
Maestro UI

用 LTX-2.5 或 Hunyuan 這類本地模型做創作時,最麻煩的往往不是模型本身,而是要自己串接腳本、分鏡、剪輯和多軌音訊。Maestro 直接把這條工作流收進一個桌面介面:LLM 先讀懂你的音訊或劇本,再交由圖像、影片、音訊模型接力生成。Director Mode 同時支援 Music Video(節拍感知分鏡)同 Short Film(劇本連戲)兩種套路,前者會分析 BPM 與段落(主歌、副歌、橋接),再把鏡頭對齊落拍;後者靠 pacing-bias slider 控制剪接密度,並維持角色與對白的一致性。Auto Mode 可以一鍵跑完整條 analyze → plan → generate → combine 流程,Manual Mode 則保留每一步檢查點。

Director v2 架構把編劇、結構化分鏡、模型格式化分成三層,H3 路徑直接走自家編譯器,其他模型則用 per-model polish。Studio 那邊亦提供適應性寫作與連戲指引,並對源動作、對白歌詞做一致性檢查。對比逐個 CLI 工具拼接的傳統做法,Maestro 的差異在於把 director 邏輯、prompt 優化同非破壞性多軌剪輯綁定在一處,省下不少膠水程式。

硬件門檻方面,Performance Auto-Tune 會在首次啟動時偵測 GPU、VRAM、RAM,並自動選取量化、VAE tiling 與 VRAM 安全係數;OOM 時還會彈出建議橫幅,一鍵降 headroom。Qwen Image 2.1 7B 支援最多十張參考圖、透明 PNG 輸出與專屬 prompt 增強,但屬研究/評估授權,商用要另外處理 Qwen 的授權。

重點摘要

  • 整合 LTX-2.5、MiniMax H3、Wan、Hunyuan、SCAIL-2 等本地模型作影片生成、延伸、混合、重拍、上色與 upscale
  • Director Mode 用本地 LLM 自動規劃音樂影片分鏡或短片劇本,並維持角色與對白連戲
  • Auto Mode 全自動、Manual Mode 每步可審;Performance Auto-Tune 依硬件自動選 profile
  • Qwen Image 2.1 7B 支援十張參考圖、透明 PNG,但僅研究/評估授權
  • 原始資料未提供具體安裝步驟或下載連結,需自行到倉庫頁查閱

內容生成後想拿來做音樂 MV、自媒體短片或概念分鏡的獨立創作者、小型工作室,會較容易受惠;商業團隊則要留意 Qwen 等模型的授權細節。Maestro 在 JavisBench、V ABench 等基準上對 LTX-2.3 的對比屬同捆支援模型本身的表現,工具層並未自稱有獨立 benchmark。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, 騰訊, AI productions, 模型, Qwen, NVIDIA, Video, Image, Audio, 香港, 工具, Content Creator, LTX, 音樂, MiniMax

AV-GRPO 把音訊影片聯合模型訓練門檻壓到 8 張 A800

這個項目把 GRPO 強化學習帶進多模態模型,並透過「模態錨定解耦」大幅降低跨模態訊號干擾,連 LoRA 微調都能在 8 張 A800 上完成 22B 模型訓練。

Repository image for zhiyuxu03/AV-GRPO

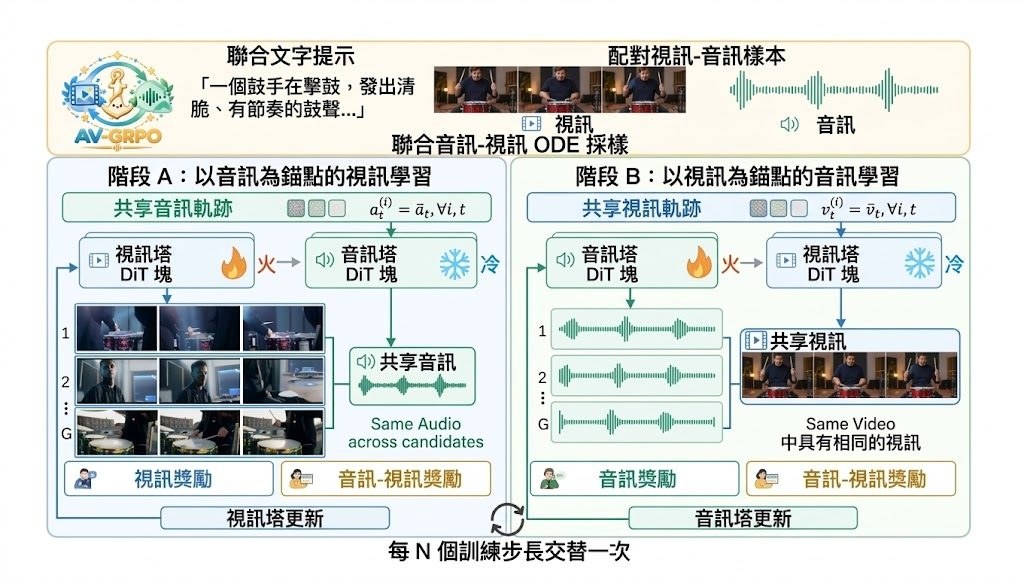
聯合音訊與影片生成一直有個麻煩:模型做出來的影像與聲音品質、文字對齊度、長度同步性常常此消彼長。AV-GRPO 直接把 GRPO 強化學習框架搬進 LTX-2.3 這類 22B 級的雙流模型,並用「模態錨定解耦」的方式,把音訊與影片兩路的學習訊號分開計算,避免強化學習的獎勵把兩個模態的功勞混在一起算不清。配套的 5DAV 數據集同樣沿五個維度拆解,方便精準控制訓練難度。

作者最在意的是算力門檻,這套框架支援全參數微調與 LoRA 微調兩種模式,只要 8 張 A800 就能跑得起來,並整合了模態錨定 rollout、凍結其中一路做軌跡鎖定優化、依模態特性調整擾動強度三個機制,把原本耦合的多模態偏好學習拆成條件式單模態子問題,使獎勵歸因與同步優化都更精準。

在 JavisBench 與 VABench 評測中,AV-GRPO 不論 LoRA 或全參數設定,於生成品質、語意對齊、跨模態同步三項都穩定超越 LTX-2.3 基準。對需要「一次到位」產出高同步影音的團隊、短片創作工具開發者、以及想在有限 GPU 資源下微調大型影音模型的實驗室,吸引力都很高。

重點摘要:

  • 首個針對音訊影片聯合生成設計的 GRPO 框架,解決強化學習獎勵訊號在異質模態間糾纏的問題。
  • 模態錨定解耦讓影片與音訊各自計算 rollout 與獎勵,顯著改善獎勵歸因。
  • 22B 模型在 8 張 A800 上支援 LoRA 或全參數微調,大幅降低硬體門檻。
  • 5DAV 數據集沿五個維度解耦,方便調節難度與做消融實驗。
  • JavisBench 與 VABench 結果顯示生成品質、文字對齊與跨模態同步全面優於 LTX-2.3。

官方尚未提供一鍵安裝或開箱即用的 inference 腳本,整合進 LTX-2 推論流程時仍需自行處理權重合併與路徑替換;對於想直接做線上服務的團隊,整合成本仍是主要取捨。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Audio, 框架, 香港, 工具, LTX, Dataset 數據集, LoRA

阿里 WanPE 用 397B 參數重寫電影級提示詞

阿里 Wan Team 推出 397B 參數嘅電影級提示詞增強模型 WanPE,專門幫影片生成模型把簡單描述擴寫成導演級腳本。

Wan logo

用文字寫出導演水準嘅提示詞係一道高牆。普通用戶多數只會輸入「一個人喺森林行」,但頂級模型需要更細緻嘅鏡頭語言、動作編排同節奏控制,先至能夠生成高質素嘅 30 秒成片。阿里 Wan Team 推出嘅 WanPE,正正瞄準呢個痛點:佢會將用戶輸入嘅簡短描述,自動擴寫成包含鏡頭運動、燈光變化、動作節奏嘅電影級分鏡腳本,再交俾下游影片模型執行。

WanPE 採用「Video-grounded reverse construction」做法,先從真實影片反向建構出鏡頭規劃,再學習點樣由提示詞出發重建同樣嘅結構,比起由前向改寫提示詞更能保留導演意圖。同時,佢透過 Semantic-Consistency GRPO(SC-GRPO)訓練方法,確保長鏡頭、多分鏡之間嘅語意唔會走樣。整個模型以約 105 萬條真實影片訓練而成,參數量達到 397B。

沒有 WanPE

使用 WanPE 之後

團隊構建咗人類標註嘅 WanPEval 測試集,覆蓋 5 至 30 秒唔同時長同意圖粒度,並用約 11,000 組盲測配對評分做對比。當配搭 Wan3.0 影片生成器時,WanPE-397B 喺 5 至 15 秒影片將人類偏好分數提升 10.7 至 18.8 分;喺 30 秒嘅長片場景,偏好分數更大幅躍升 50.9 分。喺 5 至 15 秒組別,佢領先所有受測嘅商業方案;30 秒組別則與 Seedance 2.5 保持競爭水平。

對內容創作者、短影片團隊或者想做 AI 廣告片嘅人嚟講,呢類自動「導演助手」能夠省卻大量分鏡草稿時間;對開發者而言,佢亦可作為外掛增強模組,套用到 LTX-2.5、MiniMax-H3 等其他生成器身上做格式適配。

重點摘要

  • 397B 參數專職寫分鏡:WanPE 將用戶簡短提示擴寫為導演級電影腳本,再交俾下游影片模型執行
  • 逆向建構 + SC-GRPO:從真實影片反向學習鏡頭規劃,並透過強化學習保持長片語意一致
  • WanPEval 評測:人類標註、5 至 30 秒覆蓋、約 11,000 組盲測配對評分
  • 30 秒長片偏好激升:搭配 Wan3.0 時,人類偏好分數提升 50.9 分
  • 可遷移:經格式適配後,可應用於 LTX-2.5、MiniMax-H3 等其他生成器

項目主頁 · Paper

Categories: 南京大學, 清華大學, 阿里巴巴, AI productions, 模型, 模型訓練, Video, 提示詞, Content Creator, LTX, 中國, Dataset 數據集, MiniMax

OmniEcho:讓智能體真正「聽聲辨位」的全方位音視覺模型

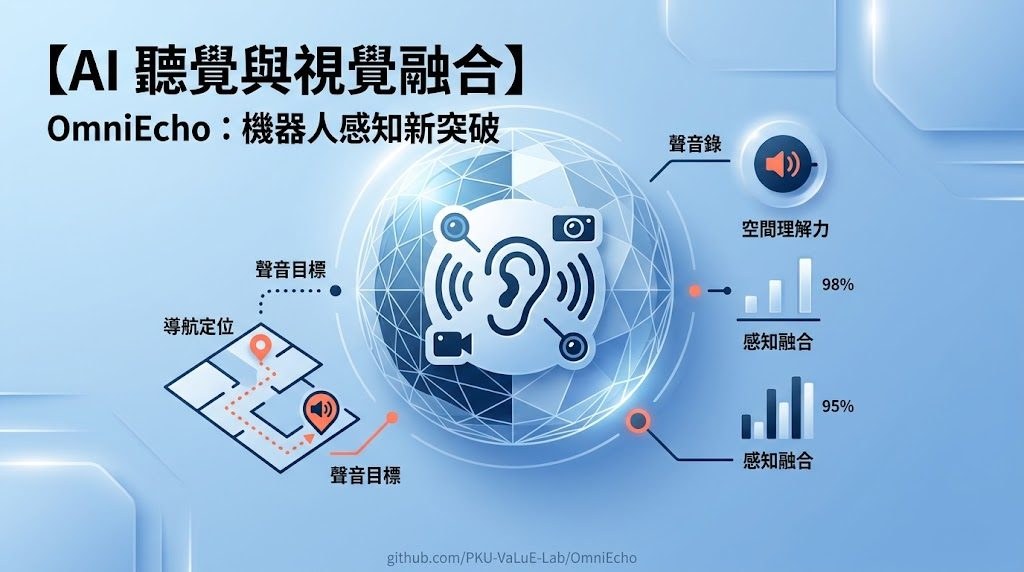
聲音從哪個方向來、距離多遠,是人類憑本能就能判斷的事,對機器人卻是一道難題。OmniEcho 把一階 Ambisonics 空間音訊、視覺與語言整合到同一個智能體,專門研究這類空間感知與聲源導航。

Repository image for PKU-VaLuE-Lab/OmniEcho

OmniEcho 是一個面向 embodied agent 的音視覺空間感知項目,由北京大學 PKU-VaLuE-Lab 開源。它要解決的問題很直觀:當一個智能體同時聽到聲音、看到畫面,它能否判斷聲源在哪個方向、距離多遠,並進一步循聲走去?這件事對人類毫不費力,但要讓 AI 真正做到,過去並不容易。

項目同時提供三樣東西:統一基準 OmniEchoBench、可控的空間音訊渲染管線,以及基於 Qwen3-Omni 改進的 OmniEcho 模型。後者最關鍵的設計,是在 Qwen3-Omni 既有語意音訊通路之外,加掛一個專門處理 FOA(一階 Ambisonics)空間資訊的編碼器,讓模型同時理解「聽到什麼」和「聲音從哪來」。

基準涵蓋六類任務,合共 197 個真實音視覺場景、2,972 條 QA 與 900 條導航樣本,全部由人工核對標註。OmniEcho 在空間音視覺感知上達到 state-of-the-art,而循聲導航的表現已經逼近傳統「靠文字指示」的視覺語言導航。不過細粒度的方位判定與距離估計,仍被作者列為尚未解決的難題。

對做機器人導航、音視覺融合研究,或需要智能體在真實場景中聽聲定位的團隊,這套項目提供了一個可以直接拿來跑評測、訓練、再挑戰的起點。原文並未附上完整的安裝或下載流程,相關代碼與模型權重目前標示為即將釋出。

重點摘要

  • 空間音訊加視覺語言:以 FOA 為輸入,與視覺、語言一起餵進 omni-modal agent。
  • 雙編碼器設計:在 Qwen3-Omni 之上新增 FOA 空間編碼器,保留原有語意音訊能力。
  • 真實世界基準 OmniEchoBench:六類任務、近 3,000 條 QA 與 900 條導航樣本,人工核對。
  • 循聲導航貼近文字導航:在 Nav 任務上接近傳統 VLN 水平,但方位與距離仍偏弱。
  • 代碼與權重待發佈: 標示 Coming Soon,暫無公開安裝步驟。

GitHub

Categories: 開源, 北京大學, Agentic, 模型, 視覺模型, 模型訓練, Qwen, VLA, Audio

object-permanence:讓世界模型學識記住被遮擋嘅物件

透過 150 個 Blender 任務同 150 萬條訓練樣本,訓練一個 16B 世界模型喺物件被遮擋時仍能保持記憶,處理視頻生成中常見嘅「物件消失」問題。

Training Object Permanence in World Models

當一件物件被屏幕或牆壁擋住再出現時,現時嘅世界模型往往會「忘記」佢原本嘅樣貌同位置。PWM-WROP 正正針對呢個限制:佢係一個基於 NVIDIA Cosmos3-Nano 微調嘅 16B 多模態世界模型(Multimodal World Model),專門訓練物件永續性(object permanence)——即係物件即使被遮擋都要喺內部表示中保留落去。

訓練數據嚟自一個 Blender 渲染嘅數據工廠,包含 150 個任務生成器,涵蓋六大認知家族,例如 turntable_behind_screen_task 等。每個樣本會輸出五件檔案:input_video、target_video、prompt、trajectory.npz 同 metadata.json,方便用嚟做 video-to-video 監督學習。整個訓練用原生 PyTorch(避免 XLA graph tracing)喺 AWS Trainium2 上跑,透過 tensor parallel × FSDP2 跨 64 個 NeuronCore。

對於從事物理推理、機器人模擬或影片生成嘅團隊呢個項目特別有用——佢直接提供可生成嘅訓練數據、預訓練權重(BF16,約 15B 參數)同 benchmark(WROP 300 題),減少由零建立物件永續性測試嘅成本。Hugging Face 上面已有模型。

重點摘要:

  • 數據規模:150 個 Blender 任務生成器,每個 20 條樣本,合共約 150 萬條 video-to-video 訓練數據
  • 模型規模:PWM-WROP 為 16B 參數(FP16 約 15B),基於 Cosmos3-Nano 微調
  • 硬件要求:訓練需要 AWS Trainium2(trn2.48xlarge,64 NeuronCore),推論則視乎部署方式
  • 授權限制:採用 CC BY-NC 4.0,僅限非商業使用,商用需另行聯絡作者
  • 生態整合:配搭 WROP 300 題 benchmark,可以量化唔同影片模型嘅物件永續性表現

同一般只做外觀預測嘅世界模型相比,PWM-WROP 強調「被遮擋都要記得」,並透過軌跡數據(trajectory.npz)提供逐幀 ground truth 做監督,對於需要物件級別一致性嘅應用場景(例如機械臂操作預演、視頻預測品質提升)會有明顯幫助。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 視頻模型, 世界模型, NVIDIA, Video, Python, Dataset 數據集

Page 19 of 59
1 … 17 18 19 20 21 … 59