Google AI Studio’s Interactions API

Interactions API 讓開發者用同一介面連接 Gemini 模型與 agents。它重點解決多種互動方式分散、整合複雜的問題。

Og image

Gemini Interactions API 是實驗性 API,可讓開發人員使用 Gemini 模型建構生成式 AI 應用程式。Gemini 是 Google 最強大的模型,打從設計之初就具有多模態的特質。可歸納內容,完美解讀、操作及結合語言、圖片、音訊、影片和程式碼等不同類型的資訊。您可以使用 Gemini API 處理各種用途,例如:跨文字和圖片進行推論、生成內容、對話式代理程式、摘要和分類系統等。

這是一個供開發者使用的 API,屬於 Google AI Studio 的 Interactions API。它的主要用途,是用一個統一介面去操作 Gemini models 與 agents,方便把模型回應、工具呼叫和代理人流程放在同一套工作流內處理。

和一般逐步拼接多個端點的做法相比,較值得留意的是它主打「統一」:同時面向模型和 agents,減少來回切換不同介面的負擔。這對要做多步驟互動、工具協調、或需要把 AI 行為包成穩定流程的團隊會更實用。

  • 統一處理 Gemini models 與 agents
  • 適合原型、整合與工作流測試
  • 方便把模型回應與工具呼叫串接
  • 較適合開發者與 agent 應用場景

項目主頁: blog.google

Categories: Agentic, AI productions, 模型, Google, OpenAI, Gemini, API, 軟件, 工具, 編程

dots.tts:支持廣東話的連續式語音合成

dots.tts 係一個 2B 參數 TTS 項目,主打直接由文字生成自然語音。它同時強調聲線模仿、情感表達同多語言表現。

dots.tts

dots.tts 是一個文字轉語音(Text-to-Speech, TTS)模型,主要用來將輸入文字轉成自然語音,並兼顧聲線模仿同情緒表達。它採用全連續、端到端的自回歸(Autoregressive, AR)設計,整條流程都唔用離散 token,這點同不少傳統 TTS 做法有明顯分別。

項目提供本地模型目錄或 Hugging Face repo id 載入方式,亦有 CLI、Python API 同 Gradio 網頁示範可試。用 --prompt-audio 配合 --prompt-text 可以做延續式 cloning;只給 --prompt-audio 時則走 x-vector-only cloning;而 --language 可幫多語言或 code-switching 文字鎖定語言標籤。

这开源TTS 太狠了:3 秒复刻音色+情绪迁移,还能实时朗读!

它的取向偏向高保真同穩定生成,而唔係只追求速度。官方數據顯示,dots.tts 在 Seed-TTS-Eval 取得較佳平均表現,zh / en / zh-hard 的 WER 分別係 0.94% / 1.30% / 6.60%,MiniMax multilingual benchmark 亦有 83.9 的平均 speaker similarity,反映它在聲音相似度同多語言能力上都有競爭力。

較適合做語音產品原型、配音流程、虛擬人聲、以及需要少量參考音去複製語氣嘅團隊。要留意參考音大約 10 秒較合適,而且 --prompt-text 必須同參考錄音內容一致,否則穩定性會下降。

  • 2B 參數、全連續 AR TTS,核心目標係文字轉自然語音
  • 支援 voice cloning、多語言同情感表達
  • 提供 CLI、Python API、Web Demo,方便測試同部署
  • 評測上在 Seed-TTS-Eval 同 MiniMax multilingual 都有強勢成績
  • 相關模型包括 dots.tts-base、dots.tts-soar、dots.tts-mf

GitHub: https://github.com/rednote-hilab/dots.tts

模型: https://huggingface.co/collections/rednote-hilab/dotstts

Categories: 開源, 文字轉語音, 模型, API, Audio, Clone, Python NLP, Python, 語音

PhoneBuddy:訓練手機代理的雙路徑做法

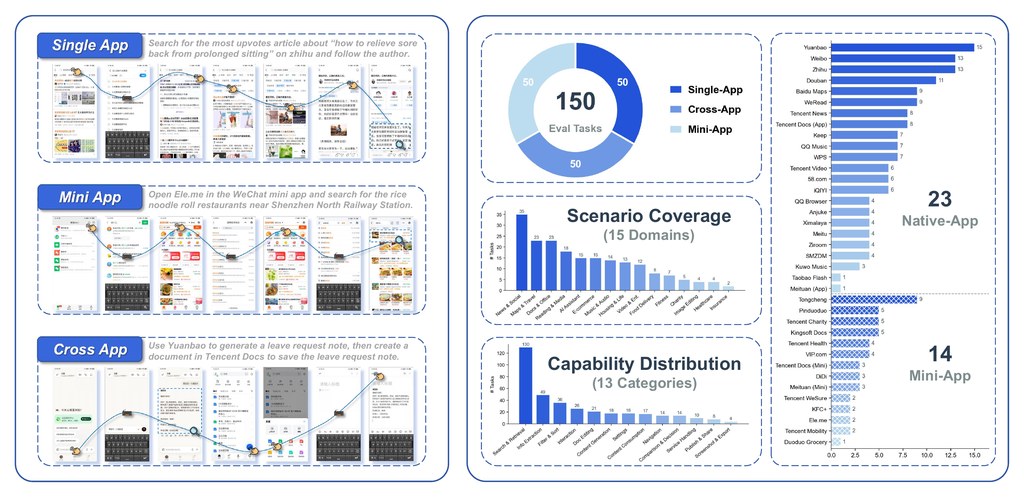
PhoneBuddy 是訓練開放式手機代理的研究項目,重點在結合真實 App 與模擬環境。它想解決手機代理難以同時兼顧真實性與可擴展訓練的問題。

PhoneBuddy logo

PhoneBuddy 是一個開放式 phone-use agent 訓練研究項目,也是面向手機操作代理的模型訓練配方。它主要解決的問題,是讓代理不只會看畫面點擊與輸入,還能同時從真實手機執行回饋與可重設、可驗證的模擬環境中持續改進。

現有 mobile agents 常被當成 GUI controller 來訓練或評測:看螢幕、點擊、輸入、滑動,再重複下一步。PhoneBuddy 指出,單靠真實 App reinforcement learning(RL)雖然更貼近真機,但成本高、難重設、驗證麻煩;只靠 PhoneWorld 風格的 mock-app RL 又較易擴展,卻未必完全反映真實手機情境,所以它採用 real-app RL 加 mock-app RL 的混合路線。

這個取向的重點,不是單純把資料加多,而是把兩種訊號分工:真實執行提供 realism,模擬環境提供 resettable 與 verifier-backed tasks。根據公開頁面,PhoneBuddy-4B 在 Real+Mock RL 後,AndroidWorld 成功率達 83.2%,比只做 real-app RL 平均高 5.0;不過 cross-app 任務只有 18.0,反映跨 App 長流程仍是明顯短板。

現階段較適合把它理解成研究原型加公開模型,而不是完整可即裝即用產品。公開資訊顯示已有 Hugging Face 模型,包括 PhoneBuddy-4B、PhoneBuddy-4B-RealApp 與 PhoneBuddy-0.8B;但 code release、evaluation documentation 仍在補,dataset 亦未公開,所以目前較合理的測試方式,是先比較不同 checkpoint 的能力定位,再配合 PhoneWorld、PhoneHarness、PhonePrivacy、PhoneSafety 這條研究線一併理解。

  • 核心差異:把 real-app RL 的真實性,與 mock-app RL 的可驗證擴展性結合
  • 已公開模型:PhoneBuddy-4B、PhoneBuddy-4B-RealApp、PhoneBuddy-0.8B
  • 公開成績:AndroidWorld 83.2%,平均比 real-app RL only 高 5.0
  • 主要限制:cross-app 表現偏低,資料集未公開,程式與評測文件仍未齊備
  • 較適合人群:研究 Computer-use agents(CUAs)/手機代理、做 agent training、benchmark 或安全與私隱分析的團隊

想了解「手機代理怎樣訓練得更像真機、又不至於每次都要真人手動重置環境」,PhoneBuddy 的判斷相當清晰:真實世界負責可信度,模擬世界負責規模。它未必已經提供完整部署流程,但作為 open phone-use agents 的訓練方向,取捨、限制和下一步研究空間都表達得很明確。

GitHub: https://github.com/PhoneBuddyAI/phonebuddy

項目主頁: https://phonebuddyai.github.io/

項目: https://huggingface.co/PhoneBuddyAI/PhoneBuddy-4B

Categories: 開源, 香港中文大學, 騰訊, Agentic, 模型, 模型訓練, Qwen, OpenAI, Gemini, 香港, 安全, 中國, Dataset 數據集

SkillHarness:幫 CUA 學得更安全

一篇聚焦 Computer-Use Agents 安全技能學習的研究原型。它針對動態介面與 prompt injections,重做技能學習與重用方式。

Repository image for YurunChen/SkillHarness

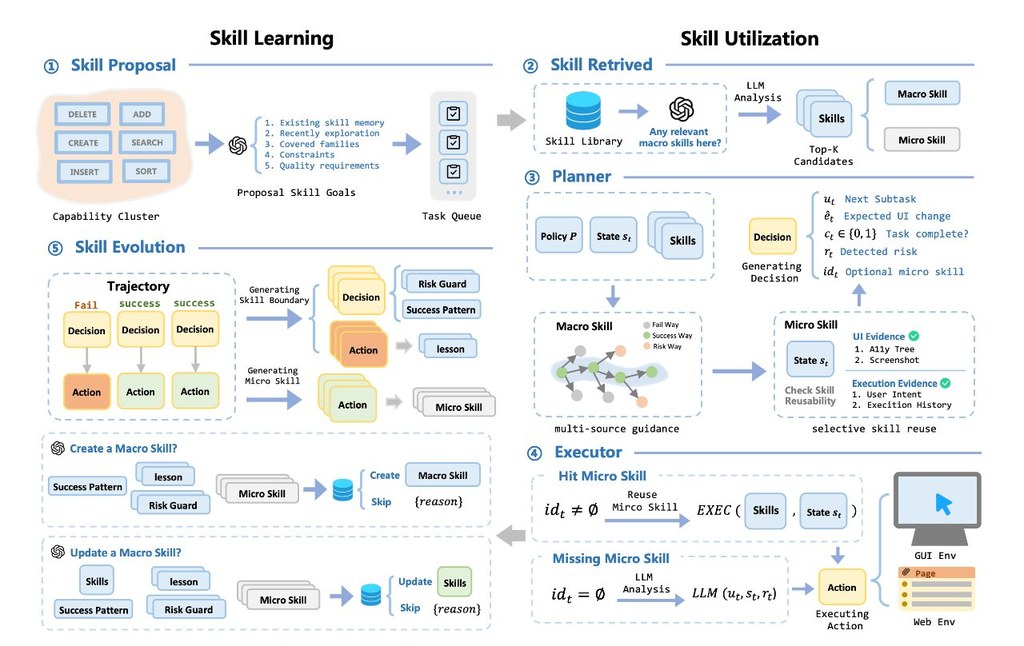
這是一個研究原型,現時 GitHub 儲存庫主要提供 SkillHarness 論文 PDF。它要解決的是 Computer-Use Agents(CUAs)在動態電腦介面中學習與重用技能時,容易受 prompt injections、彈窗與環境變化影響,令已學到的技能變得危險或不穩定。

現有做法多數沿用「從成功軌跡抽取可重用技能」這個範式,常見表達形式包括函式或 API,但作者認為這類方法預設環境是 static and safe。SkillHarness 改用 safety-constrained interaction process 去看待技能的學習與使用,核心不是多學幾個技能,而是先判斷哪些技能在當下情境仍然安全。
論文提出兩個辨識度很高的設計:一是 skill boundary,用 multi-source supervision signals 從互動軌跡中找出 safe skills;二是 selective skill reuse,按當前情境拆解任務,只啟動部分技能,而不是整包照搬。這種取向的代價,是系統設計會比單純收集成功軌跡更複雜,但換來的是在動態環境下更穩定的行為。

現有儲存庫未附程式碼,所以暫時不能直接部署或重跑實驗;較合理的理解方式,是先把它當成一套 CUA 安全技能框架來讀。若之後作者釋出實作,最需要觀察的會是它怎樣接入代理的軌跡資料、怎樣建立 safety constraints,以及能否在 OSWorld 一類電腦操作基準以外維持效果。

  • 類型屬於框架/研究論文項目,重點在安全技能學習,不是即裝即用工具
  • 主要批評舊方法依賴 static and safe environment 假設,放到動態場景會學到不安全技能
  • 論文聲稱 learned skills 的 unsafe rate 降低 57.1%,並提升動態環境下的 execution stability
  • 較適合研究 Computer-Use Agents、代理安全、桌面自動化與長流程任務的團隊留意
  • 相關脈絡模型與方法包括 Computer-Use Agents(CUAs)、Voyager、ASI,以及以函式/API 形式封裝技能的路線

GitHub: https://github.com/YurunChen/SkillHarness

Paper: https://arxiv.org/pdf/2606.20636

Categories: 開源, Agentic, 模型, API, 框架, 工具, , 安全, Skill 技能

BioMatrix 把生物序列與 3D 結構放進同一模型

BioMatrix 嘗試用同一個模型同時理解分子、蛋白質、3D結構與文字。它的重點不只是多模態,而是連生成方式都統一起來。

BioMatrix

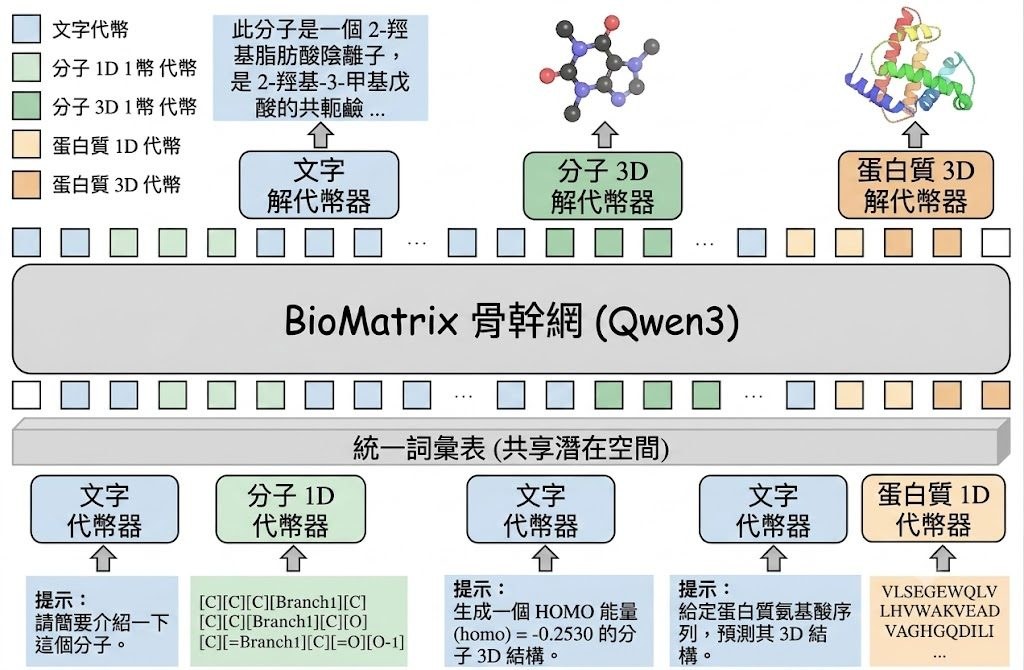
BioMatrix 是一個多模態 foundation model,建立在單一 decoder-only 架構之上。它要解決的問題,是把 molecules、proteins、1D sequences、3D structures 與自然語言放進同一套生成流程,令模型不只可讀取不同資料,也可用同一個 next-token prediction 目標處理與輸出它們。

現有 biological foundation models 通常分成兩類:一類可在共享目標下融合多模態,但多數只集中單一 entity type;另一類雖然覆蓋 molecules 與 proteins,卻常常欠缺顯式 structural modeling,或者依賴 adapter-based designs、external encoders、projection adapters 與 modality-specific output heads。BioMatrix 的取向很鮮明:直接把 SMILES、SELFIES、分子 3D、蛋白質序列、蛋白質 3D 同自然語言映射到 shared discrete token space,將「可讀」與「可生成」統一。

技術上,這個項目最值得留意的是 unified tokenization scheme。分子 3D 用改良版 MolStructTok,蛋白質 3D 用 GCP-VQVAE,並以 description-based embedding initialization 把新增 token 先對齊到 pretrained Qwen3 embedding space,再做 continual pretraining;這種做法比起後加模態接頭更完整,但訓練成本亦明顯更高,官方資料提到曾用 64 張 NVIDIA H100 GPUs 配合 LLaMA-Factory 訓練。

從 GitHub 與 Hugging Face 現有資訊看,這個項目較適合當作模型下載與研究評測基線使用,目前可找到 BioMatrix-1.7B-Base、BioMatrix-4B-Base、1.7B-SFT、4B-SFT 等版本。若你想測試,較合理的理解方式是先用已發佈模型做推理或任務比較,再按需要研究其 tokenizer,例如 MolStructTok 與 GCP-VQVAE;完整重訓對一般團隊門檻很高。

  • 模型定位:多模態 biological foundation model,不是單一分子模型或單一蛋白質模型
  • 核心差異:把 sequences、structures、language 放入同一 shared discrete vocabulary,而非靠外掛式模態模組拼接
  • 相關模型:Qwen3 1.7B、Qwen3 4B、BioMatrix-1.7B-Base、BioMatrix-4B-Base、BioMatrix-1.7B-SFT、BioMatrix-4B-SFT
  • 數據與訓練:涵蓋 text、PubChem、MolTextNet、UniRef50、RCSB PDB、UniProt/Swiss-Prot、AFDB 及 cross-entity interleaved data
  • 表現指標:論文稱 instruction tuning 後涵蓋 80 個 tasks、6 個類別,當中 77 個 tasks 達到 state-of-the-art 或具競爭力

這個項目最受惠的會是做 drug discovery、protein engineering、生物資訊研究,或者想把文字問答、分子表示與結構生成放進同一工作流的團隊。它的野心很大,優勢是統一表示與任務泛化,限制則是部署與訓練門檻高,而且論文聲稱的廣泛表現仍要看你手上的任務是否屬於那 80 個測試範圍。

GitHub: https://github.com/QizhiPei/BioMatrix

項目主頁: https://huggingface.co/collections/QizhiPei/biomatrix

Paper: https://arxiv.org/pdf/2606.22138

Categories: 開源, 上海人工智慧實驗室, Embedding, 模型, 多模態模型, 模型訓練, Qwen, Medical醫學, 3D, 中國

DataClaw0 想把雜亂多模態資料變成可訓練資產

DataClaw0 不是普通標註工具,而是把原始多模態資料主動整理成可用訓練資料的研究原型。它瞄準的是資料太亂、太長、太難重用的老問題。

DataClaw

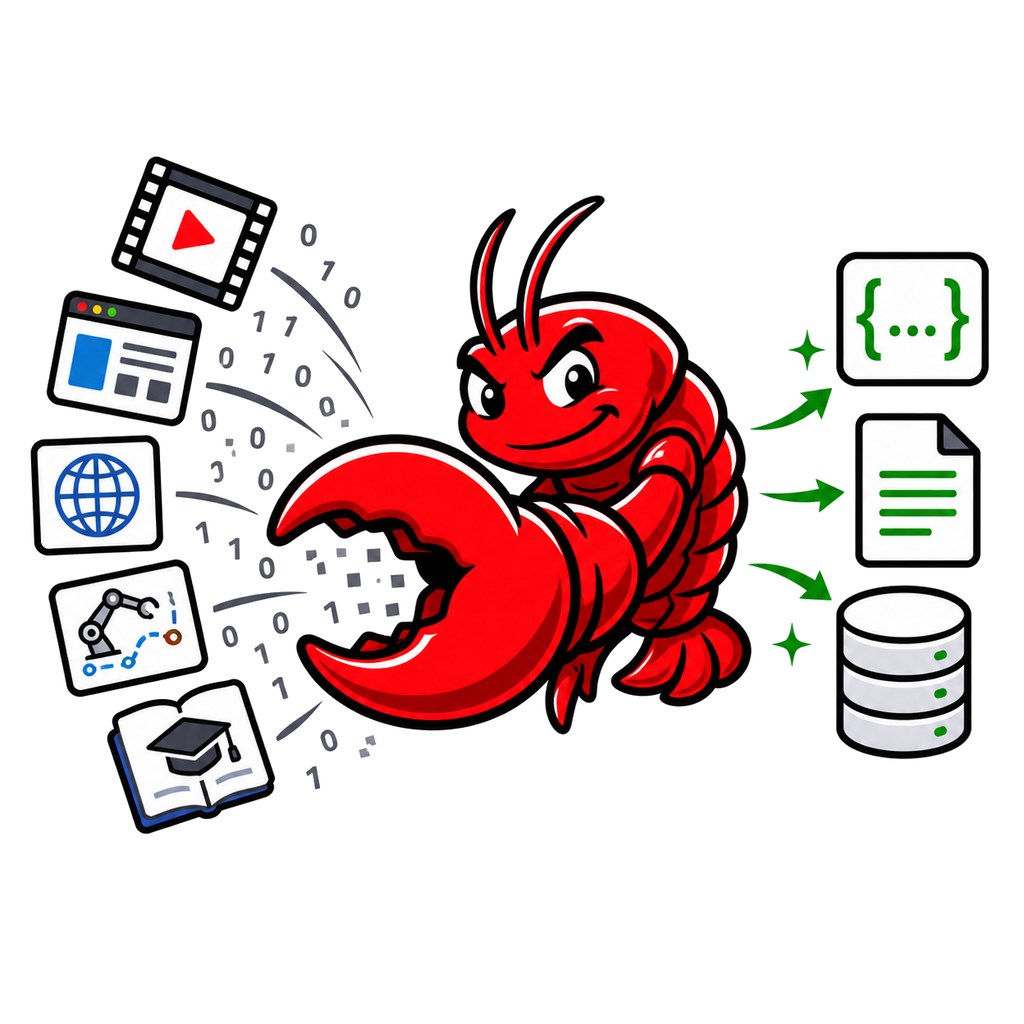
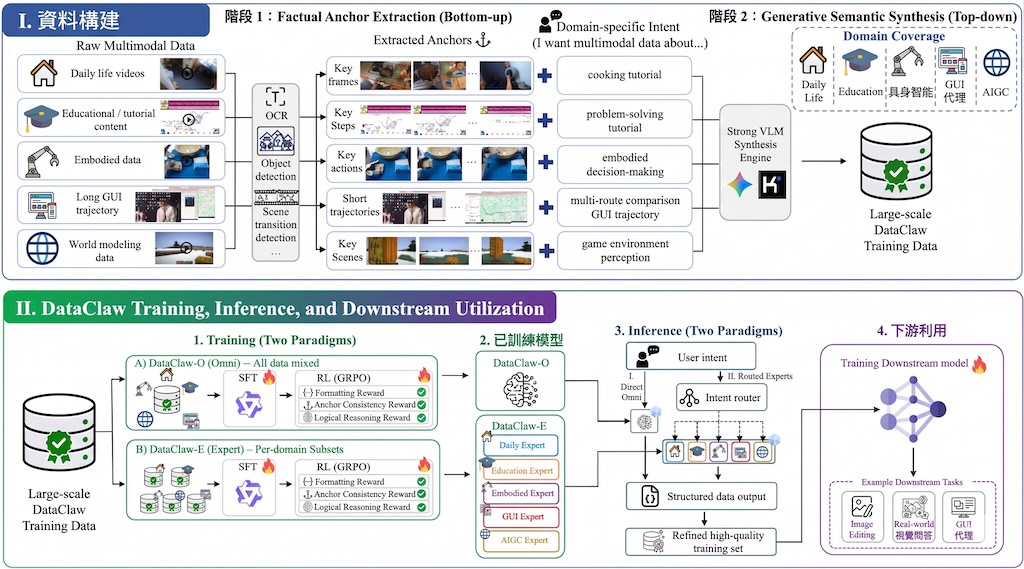
這是一個面向多模態資料整理的研究原型兼框架,核心是用 Agentic Data Tailoring 把原始串流資料重組成有結構、可驗證、可直接用於訓練的 supervision。它要解決的不是「再做一次標註」,而是長影片、GUI traces、embodied trajectories 與 editing sequences 太雜亂、資訊密度不均,令人和模型都難以有效吸收。

現有做法多數依賴 passive annotation paradigms,用 heuristic rules 或 general VLMs 被動加標籤;作者認為這類方式成本高、內容單調,亦抓不到原始資料入面的 procedural logic。DataClaw0 改用「Bottom-up Factual Anchors → Top-down Semantic Synthesis」兩段式流程,先抽取較確定的 factual anchors,再按意圖生成結構化語意,重點在於它不是只描述內容,而是按 downstream objective 重寫資料。

模型層面,項目提出 DataClaw-9B,並以 Supervised Fine-Tuning(SFT)加 rule-driven Group Relative Policy Optimization(GRPO)做對齊;部署上分成 unified Omni model 的 DataClaw-O,以及分領域 Experts 的 DataClaw-E。這種取向的取捨很明顯:Omni 較方便統一處理多域資料,Experts 則較可能在特定場景保留更細緻的領域表達。

現階段先看論文與案例再判斷是否值得追蹤,因為 code、model weights、dataset 和 DataClaw-val benchmark 仍未正式釋出。已公開資訊顯示,它的評測不只看生成是否通順,還會檢查 JSON validity,以及 schema-aware 的 Field、Semantic、Sequence 指標,並再用 video generation、real-world VQA、GUI navigation 的下游 post-training 效果驗證資料整理是否真的有用。

  • 項目類型:研究原型/資料整理框架,重點是把原始多模態串流轉成意圖對齊的訓練資料
  • 主要差異:不是被動標註,而是主動 refinement,並保留 schema-conformant、verifiable 輸出
  • 相關模型:DataClaw-9B、DataClaw-O、DataClaw-E,訓練結合 SFT 與 rule-driven GRPO
  • 適合情境:做多模態 post-training、GUI agents、VQA、影片或 embodied 資料整理的團隊

如果你關心的是建立資料引擎,而不只是找一個模型做推理,DataClaw0 比一般 VLM 標註流程更有方向性。限制也很直接:目前公開內容以論文與項目頁案例為主,能否重現效果、部署成本多高、不同領域泛化有多穩,仍要等正式釋出的資料與基準再作判斷。

GitHub: https://github.com/vancyland/DataClaw0

項目主頁: https://czjdsg.github.io/MakeAnyData/#cases

Paper: https://arxiv.org/pdf/2606.21337

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Qwen, Gemini, Video, 影像模型, 影像處理, 框架, 工具, IDE, Dataset 數據集

Unlimited-OCR:長文件 OCR 新取向

這是一個主打長篇文件解析的 OCR 模型項目。它針對多頁、長輸出內容時速度與記憶體壓力變大的問題作出調整。

Baidu Inc.

Unlimited-OCR 是一個 OCR 視覺文字辨識模型項目,也可視為一個針對長文件解析而改造的研究原型。它主要用來把圖片或 PDF 內的大量文字與版面內容一次過轉成可輸出的解析結果,重點是處理多頁文件時盡量減少記憶體負擔。

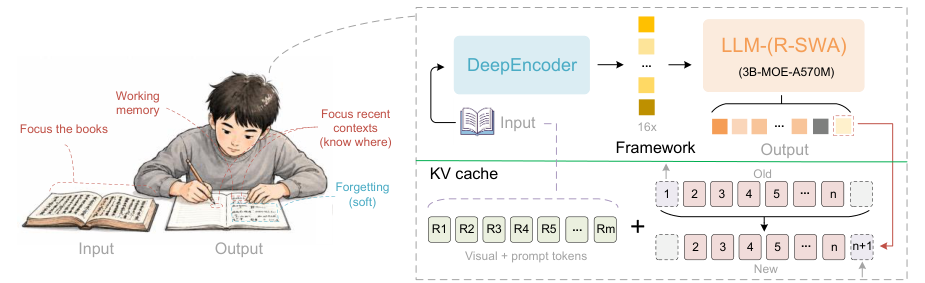
現有 end-to-end OCR 做法以 DeepSeek-OCR 為代表,會用 large language model(LLM)作 decoder,優點是能借助語言先驗提升辨識效果,但輸出一長,KV cache 會一路累積,令顯存需求上升、生成愈來愈慢。Unlimited-OCR 的做法是保留高壓縮 encoder,再把 decoder 的 attention 層改成 Reference Sliding Window Attention(R-SWA),讓每個 token 持續關注 reference tokens 與有限長度的前文,目標是把 KV cache 維持在常數規模。

這個取向最值得留意的地方,不是單純追求單頁最高精度,而是把「one-shot long-horizon parsing」放在核心位置。跟一般 full attention 比,它犧牲的是傳統全域注意力形式,換來多頁文件在 32K 長度下仍可做單次 forward pass;跟 vanilla SWA 比,它又保留 visual tokens 作為穩定參照,避免狀態傳遞後愈來愈模糊。

部署路線相當明確:項目提供 Hugging Face Transformers 推理方式,測試環境寫明需 NVIDIA GPU,並以 Python 3.12.3、CUDA 12.9 為基礎;單張圖片可在 gundam 與 base 兩種設定中選擇,多頁與 PDF 則使用 base 配置。想先了解效果,也可直接看 Hugging Face Spaces demo 或 ModelScope 版本,再決定是否自行落地。

  • 類型定位:OCR 模型/研究原型,解決長文件、多頁解析時記憶體與速度惡化問題
  • 核心差異:以 Reference Sliding Window Attention(R-SWA)取代 decoder 全部 attention layers
  • 適合情境:長 PDF、批量文件數碼化、需要版面解析與長輸出的團隊
  • 相關模型:DeepSeek-OCR、Unlimited-OCR;文中亦提到 R-SWA 可延伸到 ASR、translation
  • 限制判斷:目前公開資訊主力放在推理與方法設計,具體評測數字仍要回看 arXiv 論文原文才適合作更細比較

對需要處理保單、報表、掃描檔、書籍或多頁行政文件的團隊,這個項目的吸引力會比一般單頁 OCR 更高。若你的工作重點是短文字截圖、手機快拍辨識,Unlimited-OCR 的優勢未必完全發揮,但對長輸出穩定性與部署在 GPU 環境的可行性,它展示了一條很清楚的改良路線。

GitHub: https://github.com/baidu/Unlimited-OCR

Paper: https://arxiv.org/pdf/2606.23050

Categories: 開源, 模型, 視覺模型, NVIDIA, DeepSeek, Image, Python NLP, Python, Meta, 百度

UniverSat:一個模型食晒多種衛星影像

UniverSat 想解決地球觀測資料格式五花八門的老問題。它用單一權重處理多種感測器,方向相當進取。

UniverSat — one model, many sensors

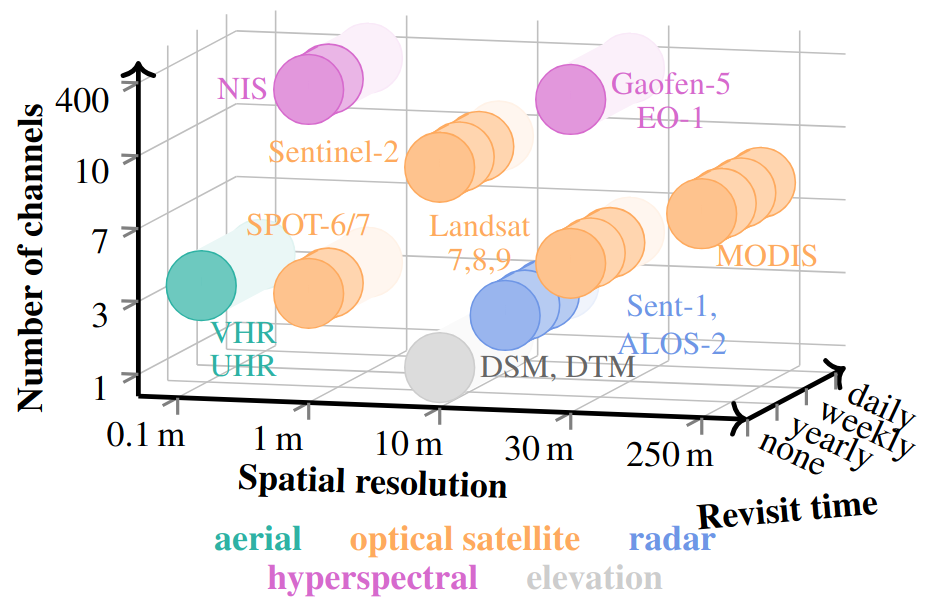
UniverSat 是一個面向 Earth Observation 的 ViT-style backbone 研究原型。它的主要用途,是用單一模型處理不同感測器、不同解析度、不同光譜通道與不同時間長度的遙測影像,減少每種資料都要分開建模的麻煩。

現有做法多數沿用 ViTs 的 fixed input format,先把資料重採樣、挑選通道,或者替每個 sensor 準備獨立 encoder;作者認為這種範式會犧牲原始資訊,也令跨資料來源整合變得繁複。UniverSat 改用 Universal Patch Encoder (UPE),把任意 spatial、spectral、temporal 形狀的 patch 映射到共享 embedding space,核心取向是 一組權重處理多種輸入

這個項目現階段更像可直接試驗的研究模型,而不是包辦整條流程的完整產品。公開資訊顯示可經 torch.hub 載入 pretrained weights,也有 demo notebook;理解方式不難,把它視為可插入 EO pipeline 的 backbone,輸入可用你手上的 sensors 組成 dict,再讀出 dense embeddings 供下游分類、分割或檢索任務使用。

它最值得留意的差異,在於不依賴 input resampling、channel selection、per-sensor encoder,並聲稱對未見過的 sensors 也能泛化。代價是這類通用 backbone 通常更依賴訓練資料覆蓋範圍;目前已知訓練橫跨 7 個 datasets、13 個 sensors,涵蓋 optical、radar、hyperspectral、elevation,空間解析度由厘米級到數百米,光譜由 1 band 到 396 channels,時間上亦可由單次觀測到 150+ revisits。

  • 項目類型:地球觀測用的模型 backbone/研究原型,不是單純資料集或標註工具
  • 解決問題:把多來源遙測資料放進同一模型,減少逐一調校感測器流程
  • 部署理解:可用 pretrained weights 作推論與特徵抽取,較適合接到既有 PyTorch 流程
  • 受益情境:研究團隊、遙測分析、跨感測器項目,尤其適合資料格式混雜的工作
  • 相關模型與技術詞:Vision Transformers (ViTs)、Universal Patch Encoder (UPE)、PyTorch、Lightning、Hydra

以研究角度看,UniverSat 的價值不只在「多模態」,而是重新挑戰 Earth Observation 一直遷就模型輸入格式的習慣。若你正面對多個衛星或航測來源,又不想為每種資料各自維護一套 encoder,這個項目很值得跟進;不過基準細節與不同任務上的強弱,仍要回到論文與 benchmark 結果再細看。

GitHub: https://github.com/gastruc/UniverSat

項目主頁: https://gastruc.github.io/universat

項目: https://huggingface.co/g-astruc/UniverSat

Categories: 開源, Embedding, 模型, 視覺模型, 工具, Python, Dataset 數據集

SpatialAvatar-0:人像重建高質 4D 頭像

用一張或少量人像,重建可動態呈現的4D頭像。這個項目同時兼顧跨場景泛化與快速個人微調。

SpatialReal

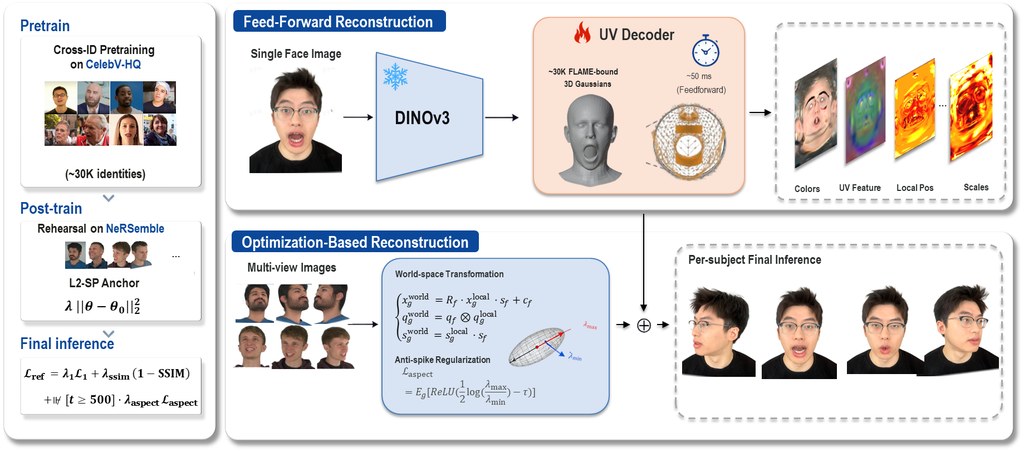
SpatialAvatar-0 針對的是 4D head avatar 重建:只靠一張或少量 source portraits,就生成可配合時間變化的頭像表示,適合 telepresence、AR/VR 同 digital-human interaction。它採用 FLAME-mesh-bound Gaussian 表示,核心是把 feed-forward generator 同 per-subject refinement 放入同一套結構,減少以往兩類方法各自為政的問題。

常見做法通常分成兩路:一類是可直接預測的模型,速度快,但容易受訓練數據領域限制;另一類是按單一人物慢慢微調,質素高但迭代很長,還會因 adaptive densification 打亂原本 Gaussian 佈局。SpatialAvatar-0 的差異,在於加入 parameter-free K-source mean-pool,支援可變數量輸入,並用 monocular-temporal 到 multi-view-spatial 的兩階段訓練,嘗試減少 identity-prior collapse。

微調部分也有明顯取向:它不是走 300K 至 600K iterations 的長流程,而是保留佈局的 10K-iter refinement loop,凍結 FLAME 綁定與 Gaussian 數量,再以 three-component anti-spike regularization 取代 densification。對想保留上游表示、又想做人物級細修的工作流,這種設計會較容易接軌。

已公開資料顯示,它在 VFHQ、HDTF 的 cross-domain zero-shot 測試中,PSNR 比 GAGAvatar 高 1.5 dB,而且模型未有在這兩個測試領域訓練;在 SplattingAvatar monocular benchmark,亦全面領先已報告指標,較 300K-iter 的 GeoAvatar 高 1.3 dB PSNR,同時把單人物微調流程縮短至最多 60 倍。數字反映它著重的是泛化能力與重建效率的平衡,但具體效果仍要視輸入人像質素與場景條件而定。

  • 支援一張或多張人像輸入,重建高質 4D 頭像
  • 統一 feed-forward generator 與 per-subject refinement 的表示方式
  • 10K-iter 微調流程,比常見長迭代方法短得多
  • 在 VFHQ、HDTF、SplattingAvatar 基準上有明確成績提升

頁面暫未提供 Code 與 🤗 Model 入口。對 3D Gaussian Splatting(3DGS)、數字人、AR/VR 內容製作有興趣的讀者,可以先從示範效果理解它的輸出風格,再留意它如何處理少樣本輸入與跨資料域表現。文中引用模型包括 GAGAvatar、GeoAvatar。

項目主頁: https://spatialwalk.github.io/SpatialAvatar-0/

Paper: https://arxiv.org/pdf/2606.15659

Categories: 開源, 數字人, 模型, 視覺模型, Image, 3D

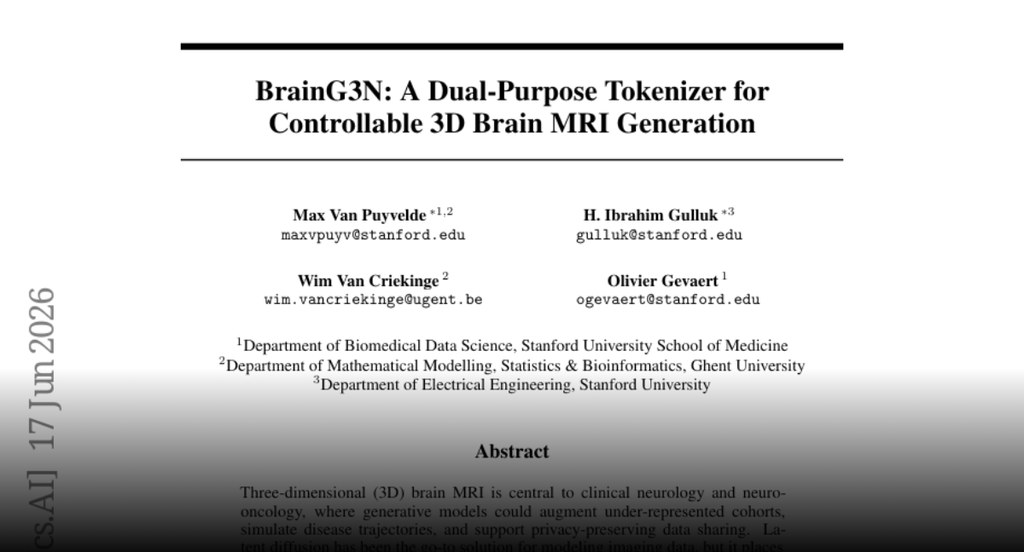
可控制生成 3D 腦 MRI 的 BrainG3N

BrainG3N把3D腦MRI生成放進具臨床意義的潛在空間,兼顧可控生成與表徵能力。

Og image

BrainG3N是一個面向3D腦部 MRI 的生成模型,重點不只是「生成影像」,而是按指定條件產生帶有臨床訊息的合成掃描。它先用凍結的 3D MAE encoder 處理資料,再由 conditional flow-matching DiT 在潛在空間生成新樣本,最後用 fine-tuned CNN decoder 轉回 voxel 影像。

這類方法要解決的,是醫學影像生成常見的「生成到,但控制不準」問題。BrainG3N聲稱可按 disease、age、sex、modality、site、IDH1 status 等條件控制輸出,亦支援病人縱向變化預測,對研究病程模擬與稀有群組補數據尤其有用。

和一般直接在像素或 voxel 空間生成的做法相比,它把生成放在 clinically grounded latent space 內進行,目標是令合成結果更容易保留指定屬性。頁面列出的結果顯示,從生成掃描中可重新探測出目標條件,例如年齡相關性達 Pearson r=0.93,反映控制訊號並非只停留在文字或標籤層面。

同一個 frozen encoder 本身亦被當作 foundation model 使用,在 21/23 個 linear-probing tasks 上達到或超過 BrainIAC、BrainSegFounder、MedicalNet;其中 IDH1 AUC 0.937、brain-age MAE 4.43 years,而且無需 fine-tuning。對醫學 AI 研究者來說,這代表同一套架構可同時支援表徵學習與合成數據生成。

  • 可控制條件包括 disease、age、sex、modality、site、IDH1 status
  • 支援 patient-specific longitudinal forecasting
  • 生成流程包含 3D MAE encoder、conditional flow-matching DiT、CNN decoder
  • 可用於 under-represented cohorts 補充、counterfactual disease trajectories、privacy-preserving synthetic data sharing

目前頁面只提供論文簡介,model、code 與 synthetic dataset 尚未釋出,所以現階段較適合先了解方法設計與指標表現。若你關注 Medical醫學影像、合成數據或可控生成,這個項目很值得留意。

項目主頁: https://huggingface.co/papers/2606.19651

Paper: https://arxiv.org/pdf/2606.19651

Categories: 模型, 模型訓練, Image, Medical醫學, 3D, Dataset 數據集

Page 17 of 37
1 15 16 17 18 19 37