AutoGUIWorld:跨平台 GUI Agent 訓練場景及模型

以圖像生成模擬 GUI 狀態轉換,降低建立跨平台對真實軟件環境的依賴。

GUI Agent 要學懂跨平台操作,往往受限於收集資料時能夠安裝和重設的軟件環境。AutoGUIWorld 會生成 Windows、macOS、Ubuntu、Chrome、Android 或 iOS 的 GUI 場景,再由模型規劃點擊、開啟、切換等動作,透過圖像編輯生成每一步的畫面。它屬於面向 Computer-use agents 的資料生成框架,在毋須逐一啟動真實應用程式的情況下,建立有畫面、有動作、有座標標註的訓練軌跡。

AutoGUIWorld 把語意規劃和畫面轉換分開。Meta Planner 先按場景建立任務及動作序列,Voyager 讀取最新的乾淨截圖,描述下一個視覺狀態,再交由獨立的模型 adapter 處理文字、視覺和圖像生成或編輯;grounding backend 則負責找出指向目標的位置。每條軌跡會保留 obs_k.png、帶有目標框的 act_k.png,以及記錄任務、計劃、動作、畫面對應、grounding boxes 和 provenance 的 meta.json,方便日後檢查和重用。

  • 覆蓋 Windows 11、macOS、Ubuntu 24.04、Chrome、Android 和 iOS 場景
  • 技術報告使用的 AutoGUIWorld 訓練集包含 79,266 個 grounded and filtered examples
  • 支援 LocateAnything-3B、MAI-UI 或視覺語言 backend 進行 pointing grounding
  • 固定 random seed 可重現結構化場景,但模型輸出的文字和像素仍可能改變
  • 生成資料不會在真實桌面執行動作,也不會自行驗證任務是否完成

雖然 AutoGUIWorld 以視覺生成換取更快的場景擴展和較低的環境管理成本。代價是生成畫面未必等同真實軟件狀態,圖像模型也可能產生不合理的介面轉換,因此項目提供 scene validity、action alignment 和 transition fidelity 等品質檢查,但不能把這些檢查視為真實執行結果。

目前公開結果集中在資料生成和模型訓練流程。用家可隨時以軌跡微調 Qwen3.5-35B-A3B ,建立合成訓練資料。對只需要真實操作成功率、而且不能接受模擬畫面偏差的工作流程,仍應把真實環境測試放在資料生成之後。
GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Image, 框架, 軟件, Mac, Linux, Win, Dataset 數據集, UI/UX

Cloudflare Clef 多模態決策模型:直接輸出分類、路由與審核概率

Clef 將文字、JSON、影像或影片轉成結構化概率,毋須生成答案再解析。

Og image

面對發票分類、服務故障分流或影像核查等工作,Clef 可以直接為每條問題的可選答案計算概率,省去生成自由文本及再解析輸出的步驟。這個 27B 多模態決策模型基於 Qwen/Qwen3.8-27B 微調而成,能同時處理文字、JSON、影像及影片,並以單次 forward pass 回傳結果。

模型保留 Qwen/Qwen3.8-27B 的語言及視覺 backbone,再接上 joint schema head。這個小型 Transformer head 會讀取 backbone 的最終 hidden states,把狀態中的證據路由到每條問題,然後聯合計算所有選項的 logits;每條問題獨立套用 softmax 後,便可取得各選項概率。輸出不是自然語言,而是 choice、score 或 noul(true/false)等結構化結果,適合交由工作流程或 API 直接使用。

  • state 可接受字串或 JSON,問題支援 choice、有序的 score 及 noul。
  • images 和 videos 可與文字資料混合,文字及多模態記錄亦可放在同一批次處理。
  • encode_record 預設 max_length 為 16,384 tokens,亦可透過 max_state_tokens 限制狀態長度。
  • 模型檔案包括分片 safetensors、joint_head.safetensors、處理器設定及 joint_schema_model.py。

官方測試環境是單張 H200,配合 torch 2.11、transformers 5.10.2 及 pillow。

Clef 的取捨在於輸出控制性高,但用途受制於預先定義的問題、選項及 criteria,並非通用聊天模型。它與原始 Qwen/Qwen3.8-27B 的差異,是加入 joint schema head、記錄編碼及 SystemOne 介面,將生成式模型改造成可批量回答固定決策問題的模型;較小、較快的 Clef-Flash 則另行提供,頁面沒有交代兩者的參數規模或精度差異。Apache-2.0 授權及 Jev/SystemOne 相容 API,令它較適合整合到分類、路由、合規檢查及多模態審核流程。

模型

Categories: 模型, 多模態模型, Qwen, Tokenize

SoL-Refiner 高解像度影片生成加速 27 倍

先完成低解像度草稿,再用一次去噪提升至高解像度,SoL-Refiner 大幅縮短影片生成時間。

Og image

高解像度影片生成往往受限於大量時空 tokens,SoL-Refiner 以影片精修模型處理這個瓶頸:先由不同基礎生成器製作較低解像度草稿,再用一次目標解像度去噪輸出最高 4K 影片,毋須進行多步精修。

NVIDIA Research 的訓練流程結合高解像度持續訓練、frame-based RL post-training,以及 one-step distribution-matching distillation,並支援 bidirectional 和 streaming inference。方案可接駁 MiniMax H3、SANA-Video、Cosmos-Nano 和 WAN 等不同生成器,令精修模組毋須綁定單一模型。

  • 一次高解像度去噪,減少第二階段採樣成本
  • 支援多個影片生成器,改善跨模型工作流程
  • 在 2K 保持具競爭力,4K 指標優於 LTX-2.3
  • WAN 和 Cosmos-Nano 測試中,平均質素亦有所提升

以五秒、1344×768、24 fps 影片測試,MiniMax H3 直接生成高解像度版本需 152.3 秒;低解像度生成加 SoL-Refiner 的兩階段流程只需 5.6354 秒,量得 27.03 倍牆鐘速度提升。測試使用 NVIDIA GB200,每個階段各佔用一張 GPU,實際速度仍會受硬件、基礎生成器和影片設定影響。

SoL-Refiner 適合需要大量高解像度影片、但又要控制推理延遲的內容製作流程。它以額外的低解像度生成階段換取更快的高解像度輸出,質素和速度之間的取捨仍取決於輸入草稿及所選生成器。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Image, 教學, Python, LTX, MiniMax

MiniMax H3 的雙用途 X2 Detail VAE 實驗

一個 VAE 同時處理影片 2 倍解碼與參考圖細節增強,但仍依賴指定 ComfyUI 節點。

Og image

由 MiniMaxAI/MiniMax-H3 作為 base model,呢個實驗型 video VAE 將兩條工作流程放入同一個模型:一條負責生成影片 latent 的 2 倍解碼,另一條則提升 image-reference 的空間細節,適合 ComfyUI 影片生成項目使用。

影片模式會以 MiniMax-H3-X2-Detail-v1.safetensors 解碼,再將 packed 12-channel 輸出交給 PixelShuffle ×2,產生 2 倍 RGB 影片幀。參考圖模式則透過 MiniMax H3 VAE 2X (Detailed Upscale) 節點,從 encoder 的 down.1.block.1 抽取額外 B32 空間細節;因此必須有現成 RGB 參考圖,並非只處理 latent。

檔案附有 ComfyUI 節點、workflow 及研究報告。影片解碼需要 ComfyUI-MiniMaxH3_LatentUpscaler 的 MiniMax H3 VAE Decode (fast),示範設定包括 tiling=true、tile_size=256、tile_overlap=64、output_device=cpu,以及 temporal_tiling=false;節點依賴令流程不能直接用標準 VAE Decode 取代。

  • 模型檔案:MiniMax-H3-X2-Detail-v1.safetensors
  • 定位:2X VAE Decode 加參考圖 Detail Enhancement
  • 已知取捨:B32 細節路徑只適用於 RGB 參考圖
  • 頁面未提供參數規模、上下文長度、GGUF、量化版本或 mmproj 檔案

項目作者將成果描述為一次未達預期的 HQ-VAE 實驗,但保留了可工作的 2-in-1 發布版本。適合作為實驗性 ComfyUI 工具,而非已完成全面效能驗證的通用 VAE。

模型

Categories: 開源, ComfyUI, AI productions, 模型, Video, MiniMax

JEV 以結構化決策加速大規模 AI 資料處理

面對海量合約、日誌或文字資料,JEV 以結構化輸出換取更快速度與較穩定的程式整合。

處理數萬份合約、系統日誌或其他非結構化資料時,逐字生成文字容易帶來延遲、格式錯誤和難以判斷的信心。JEV 是由 TypeSafe AI 開發的 System One Model(系統一模型),透過 API 直接輸出預先定義的結構化決策,針對大規模資料分類與資料抽取而設計。

JEV 不以自由文字作為主要輸出,而是採用 Parallel Sampling(平行採樣)一次產出多項結果,端到端反應時間約為 70 至 500 毫秒。Type-safe 結構可限制欄位、數值範圍和可選項目,減少傳統 Large Language Model (LLM) 常見的解析、重試及幻覺風險;輸出亦會附帶校準後的信心分數。

它採用 RLCD(Reinforcement Learning for Calibrated Decisions,機率校準決策強化學習),讓程式可按信心分數安排自動處理或人工覆核。以併購盡職調查為例,系統可批次分析 50,000 份合約,抽取控制權變更條款、司法管轄區和風險等級,再把低信心結果交由律師檢查。

• 適合批次分類、標籤及結構化資料抽取
• 輸出格式預先定義,方便接入資料流水線
• 可用信心分數設計人機協作分流
• 取捨是它不負責撰寫長篇法律意見書等自由文字內容

JEV 的輸入價格約為每百萬 Token 0.042 美元,輸出 Token 免費;速度、成本和格式穩定性仍需按資料類型及 API 工作量驗證,不能直接視為所有 LLM 工作的替代品。

項目主頁

Categories: 模型, 模型訓練, 工具

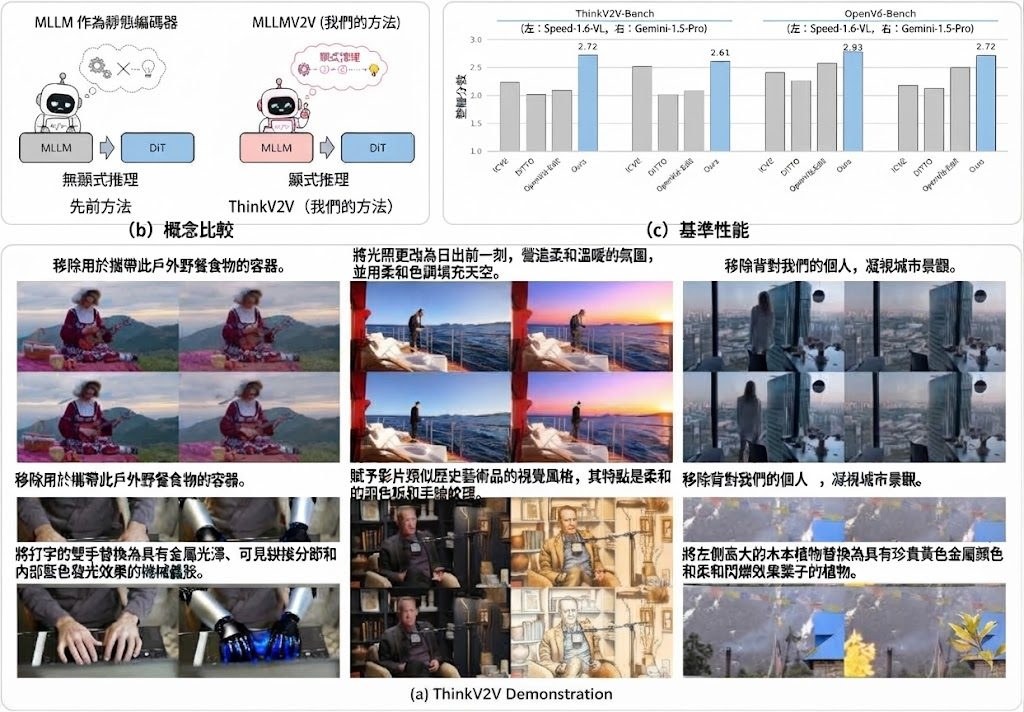
ThinkV2V 讓影片編輯先思考再生成

ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

ThinkV2V Overview

面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

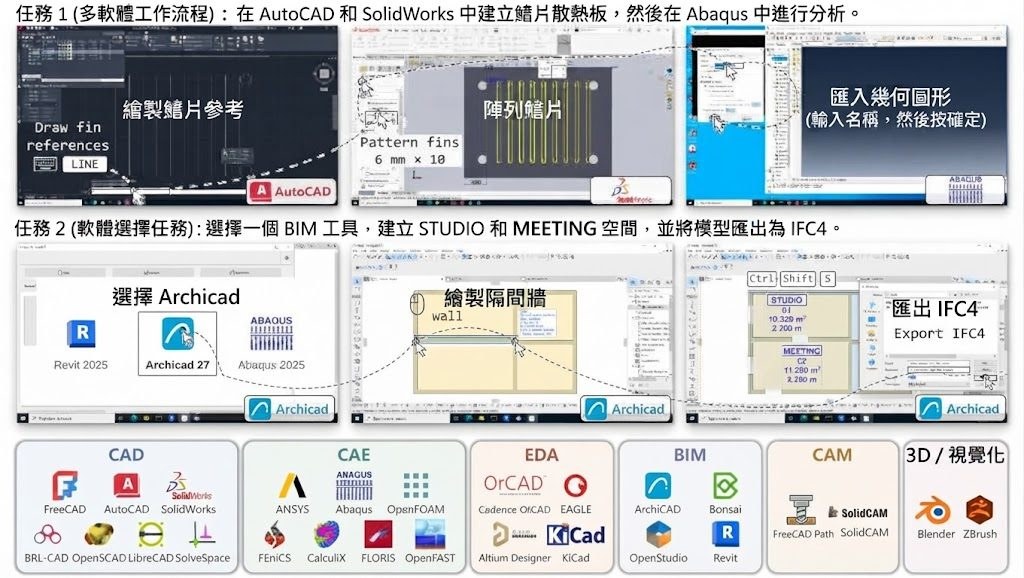
EngiWorld 把工程代理接入真實軟件工作流

EngiWorld 不只測試代理人能否操作介面,更檢查它能否交付合乎工程規範的成果。

EngiWorld task examples and engineering software coverage

代理人要在 CAD、CAE、CAM、BIM、EDA 和 3D 視覺化軟件中完成工作,難點不只是點擊按鈕,而是要維持幾何、物理條件及跨軟件流程的正確性。EngiWorld 屬於工程代理人評測基準,實際處理的是「能否由指令一路產出可驗證工程成果」這個問題。

項目收錄 1,301 個專家編寫任務,涵蓋 26 個軟件平台、6 個工程領域及 6 類任務,支援 GUI 和 CLI。評測會檢查最終及中間工程文件的幾何有效性、物理可行性和規則符合度,數值設計任務亦會按規格達成程度連續計分,而非只分成功或失敗。

  • 提供完整任務、驗證器及 GUI/CLI 評測執行環境
  • 主實驗採用 300 個任務,清單位於 task/splits/main-300.txt
  • 本地環境以 Linux、Docker 及虛擬機器執行,預設每個環境使用 4 個 CPU 和 16 GB RAM
  • 七個前沿模型中,最高 EngiScore 只有 44.3;多軟件嘗試成功率為 3.6%

同類 Computer-use agents 評測多集中於一般桌面操作,EngiWorld 把判斷標準推到可交付的工程 artifact,因此更能揭示模型在長流程、跨軟件依賴及專業規範上的不足。代價是執行門檻較高:需要 x86_64 Linux、Python 3.10、Docker Engine 和環境映像,沒有 /dev/kvm 時亦可運行,但軟件模擬會較慢。

研究團隊、工程軟件開發商,以及想比較 GUI agent、CLI agent 或多模態模型能力的團隊,都可以用它重現測試並保存評測結果。它目前更適合作為嚴格的研究及模型比較工具,而非即插即用的生產自動化方案;最高分數與多軟件成功率反映,代理人距離穩定完成專業工程流程仍有明顯距離。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, 多模態模型, 軟件, 工具, 3D, Python, Dataset 數據集

VoxMem 測試音訊模型的記憶盲點

VoxMem 不只測模型記得講過甚麼,還檢查能否辨認說話者、語氣與背景聲音,直面多輪語音記憶的缺口。

VoxMem logo

當語音助手要回想幾次對話之前的內容,答案未必藏在文字轉錄稿內:誰說過一句話、當時的語氣,以及背景傳來甚麼聲音,同樣可能決定答案。VoxMem 屬於語音記憶評測基準,透過多次會話測試 Large Audio Language Models(LALMs)能否保留及運用這些非文字資訊。

項目把測試拆成兩條軸線:需要找回的聲音證據包括 speech semantics、speaker identity、paralinguistic cues 和 environmental sound;記憶操作則涵蓋 information extraction(IE)、multi-session reasoning(MSR)、temporal evolution tracking(TET)及 answer refusal(AR)。這個安排比只問模型能否找回一句原話更接近長期語音助手的工作情境。

VoxMem 提供 3,196 個評測實例,涵蓋 34,743 段、共 177小時的語音會話,並固定問題及證據,只改變8K、16K、32K 和 64K tokens的上下文長度。測試者可從 GitHub 項目取得程式碼,再配合 Hugging Face上的資料集重現評測;Python 3.9 或以上是已列出的基本環境,但不同 LALM仍可能需要各自的模型存取設定。

結果指出,15個 LALMs 在 32K 上下文下沒有模型達到 40% 整體準確率;模型記住文字內容的能力明顯高於辨認說話者、語氣及環境聲音,而且歷史越長,差距越大。這令VoxMem 更適合用來找出語音記憶系統的失效位置,而非單純作為模型排名工具。

• 同時測試聲音證據與記憶操作,涵蓋15個有效組合
• 以多會話歷史取代單一錄音,檢查跨場景整合能力
• 包含證據不足時拒絕回答,能檢視模型是否過度猜測
• 非文字聲音資訊在長上下文下明顯較難保留

研究語音代理、會話記憶、音訊模型或長上下文系統的團隊,能用這套基準分辨問題究竟出在聲音理解、跨會話推理、狀態追蹤,還是拒答判斷。資料採用 CC BY-NC 4.0,程式碼則使用MIT授權,商業產品整合前仍要獨立檢查資料使用條件。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, Audio, 工具, Python, 語音, Dataset 數據集

NVIDIA LongLive 把長片生成推向即時互動

NVIDIA 將三階段長片生成研究整合到同一個項目,涵蓋即時互動、量化推理及可重用蒸餾能力。

LongLive logo

NVIDIA 開發團隊把長片生成帶入即時互動、低精度推理和跨模型重用場景。LongLive 屬於開源影片生成研究項目,處理長時間生成容易變慢、下游模型需要重複蒸餾,以及互動控制成本偏高等問題。

項目分成三代,並各自放在獨立目錄,附有程式碼、文件和模型權重。LongLive 1.0 聚焦即時互動長片生成;LongLive 2.0 以 NVFP4 量化和 sequence parallelism 加速訓練及服務;LongLive-Plug 則把 few-step、CFG 和 long-context 能力蒸餾成可重用 LoRA,讓同一模型家族的下游模型減少重新訓練。

LongLive 2.0 支援 T2V/I2V AR training、multi-shot 或 single-shot videos,以及 NVFP4 inference、NVFP4 KV Cache 和 TorchAO FP8 PTQ inference,取捨是需要配合量化及平行化基礎設施。

  • LongLive-Plug:一次蒸餾能力,再在同一 backbone family 的下游模型重用
  • LongLive 2.0:以 NVFP4、BF16 和 sequence parallelism 支援長片訓練及推理
  • LongLive 1.0:讓使用者輸入提示詞後即時觀看並逐步控制長片生成
  • DreamForge-World 0.1:加入 residual action pathway,面向低算力、即時可控 world modeling

研究展示包括互動示範、長片 rollout 和不同 backbone family 的配對例子,但提供資料未載有可直接比較的統一 benchmark 分數。具備 NVIDIA GPU、需要研究影片生成系統,或希望在 Wan2.1、Wan2.2、MiniMax-H3 等模型家族上重用蒸餾能力的團隊,較容易找到合適切入點;一般使用者則要先接受它偏研究項目,操作細節仍取決於所選目錄。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, 提示詞, 語音, Dataset 數據集, MiniMax, LoRA

WorldLine 讓機械人先看見動作後果

WorldLine 把機械人動作轉成影像及空間訊號,預測場景如何變化,再協助評估策略及規劃操作。

Repository image for Zhengsh123/WorldLine

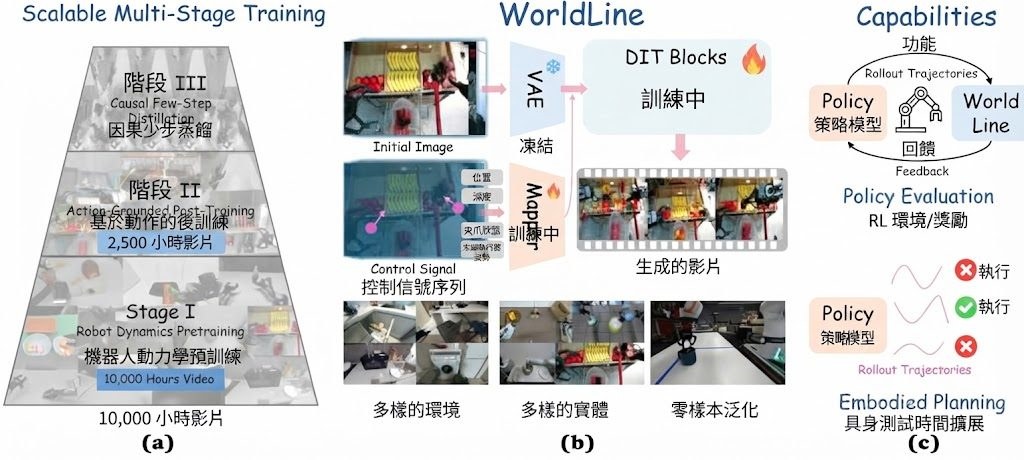
機械人要搬動物件前,WorldLine 可以先在視覺模擬中預測動作會如何改變場景,減少每次都依賴實體試錯。它屬於面向機械人操作的世界模型及視覺模擬器,處理的是「控制指令如何造成可觀察結果」這個核心問題,而不是按照任務文字生成畫面。

WorldLine 先用超過10,000小時的無動作標註機械人影片學習機械人與物件的互動,再把末端執行器的位置、深度、方向及夾爪狀態投影到經校準的相機視角。這些 image-space actions 成為不同機械人之間的共同介面;另外超過2,000小時、涵蓋10多種 embodiments 的動作軌跡,負責把通用 dynamics 對應到個別控制方式。

WorldLine 把 action grounding 分開處理,較有利於跨機械人及跨鏡頭遷移,代價是需要校準相機、動作軌跡及失敗案例。模型以 block-autoregressive 方式因果 rollout,每個區塊用四步 denoising 生成,兼顧互動速度與預測細節,但不代表能取代真實環境驗證。

  • 用於 policy evaluation、embodied planning 及實體操作前的預測
  • 以 image-space action 統一不同機械人的視覺控制介面
  • 透過 multi-view、failure-enriched training 及 relational regularization 強化互動敏感度
  • 以 few-step distillation 減少 rollout 所需計算

研究團隊包括香港科技大學、Joy Future Academy、北京大學及香港中文大學。較適合研究機械人學習、視覺規劃及模擬器的團隊先按程式碼建立推理環境,再以不同 camera view、embodiment 和失敗動作測試預測穩定性;需要即時控制的人員則應同時量度延遲、動作偏差及真實機械人的遷移落差。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, AI productions, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 香港, Dataset 數據集

Page 18 of 59
1 … 16 17 18 19 20 … 59