MiniMax H3 Semantic Bridge:單卡煉成的極輕量視頻生成適配器

約 11 MB 的小型適配器,可在不改動 H3 權重的情況下,把跨架構語意信號融入 MiniMax H3 的視頻生成流程。

Og image

由社群開發者 speach1sdef178 發佈的 MiniMax H3 Semantic Bridge,基於 MiniMaxAI 嘅 MiniMax-H3 進行延伸,定位係一個輕量嘅 conditioning-space 適配器,主要服務於標準 H3 FL2VA 文字生成視頻流程,整個項目僅用單張 NVIDIA RTX 3090 Ti 24 GB 完成訓練,並無動用多 GPU 叢集。

這並非 LoRa、checkpoint 合併或傳統的參數轉接。此適配器在影片Transformer之前轉換原生H3條件,並將學習到的語意表示以可控強度融合回H3。佢嘅核心做法係將原本用於 SenseNova U1.5 嘅語意表示,透過跨架構遷移與蒸餾,壓縮成一個獨立嘅小型檔案(MiniMaxH3_SemanticBridge_v1.safetensors)。使用時 SenseNova 完全唔需要載入,適配器會喺視頻 transformer 之前轉換 H3 嘅原生 conditioning,再以可控強度將學到嘅語意信號混合返入 H3。檔案本身只有約 11 MB,並唔係 LoRA、權重合併或者傳統參數嫁接,安裝方法係將 MiniMax_H3_Semantic_Bridge_v1.0.zip 解壓至 ComfyUI 自訂節點目錄,再將適配器放入新增嘅 ComfyUI/models/semantic_bridge/ 資料夾即可。

目前 v1 只支援文字條件嘅標準 FL2VA 流程,Ref2VA 參考圖生成或參考音訊工作流並唔適用。官方亦提到,喺參考音訊場景插入呢個適配器時,唱歌同嘴型同步表現會明顯下降,因此使用前要留意任務邊界,避免硬套落唔支援嘅流程。呢個項目提供咗 examples/ 對照素材、workflow JSON 同研究文章,方便用家直接喺 ComfyUI 內做 Native H3 同 Semantic Bridge 嘅 A/B 比較。

重點摘要:

  • 基礎模型:MiniMaxAI/MiniMax-H3,定位係 H3 嘅 conditioning-space 適配器而非權重合併。
  • 檔案規模:約 11 MB 嘅獨立 .safetensors,外加 ComfyUI 自訂節點 zip 同 workflow JSON。
  • 訓練條件:單張 RTX 3090 Ti 24 GB 完成,無需多 GPU 叢集,SenseNova 只用於訓練階段。
  • 支援範圍:適用於 H3 FL2VA 文字生成視頻,Ref2VA 同參考音訊流程未獲支援。
  • 整合方式:放入 ComfyUI custom nodes,並透過新增節點將 conditioning 同 latent 注入原有 H3 流程。
項目主頁

Categories: 開源, ComfyUI, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Audio, MiniMax

RoboTok:用 YouTube 影片教機械手做家務

RoboTok 把網上大量的人手操作影片變成機器人訓練素材,對應一段示範就能自動撈出動作相似的影片做模仿學習,等 AI 機械手多了一條低成本數據來源。

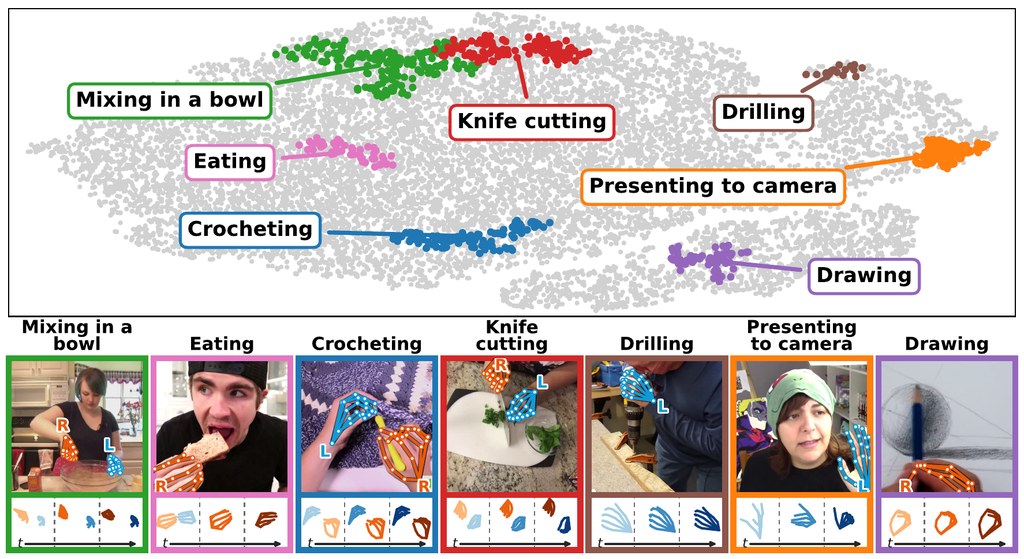
Retrieval embedding space and example clips

想訓練機械手做家務,最貴的部分往往不是模型,而是數據。RoboTok 由 Rice University 及 NVIDIA 合作開發,直接從海量網絡影片中撈取人手操作片段,再交給擬人機械手學習。它屬於一種數據引擎兼策略學習框架,把「找對數據」這一步自動化掉。

核心做法是把人手動作抽成以軀幹為基準的 3D 手部軌跡,再學一個嵌入空間,用 DTW(Dynamic Time Warping)相似度作監督,令同一種操作(例如倒水、摺衫)在不同鏡頭、不同人、不同場景下都能對齊。查詢時只要給一段示範影片,系統就用 cosine similarity 找出動作最相近的網絡片段。

  • 以軌跡為單位做檢索:避開外觀差異,直接比動作本體,所以鏡頭變、場景變、人變都唔會影響配對。
  • 配套軀幹估計模型:用雙手軌跡反推出身體/軀幹參考框,減少裁切與遮擋帶來的偏差。
  • FAISS + GPU DTW:向量檢索用 FAISS,DTW 內核用 numba CUDA,跑大規模影片庫唔會慢到難以迭代。
  • 機械人策略學習閉環:檢索結果直接餵下游模仿學習,做擬人機械手 policy 訓練,並已在仿真及真機任務做評估。

同類做法多數只用影片幀或粗糙動作標籤做檢索,容易被背景雜訊干擾。RoboTok 走 3D 手部軌跡嵌入這條路,換來更精準的動作匹配,但代價是 pipeline 較重:要裝 MANO/SMPL-H 體模、CUDA 環境,再跑一套自帶的訓練與評估流程。

最受惠的是做擬人機械手、靈巧操作(dexterous manipulation)研究的團隊,以及想用低成本網絡影片取代部分遙操作數據的工作小組。對只想要開箱即用機械人策略的人來說,門檻仍然偏高;對做數據策展與 representation learning 的人,呢套引擎本身就值得參考。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型訓練, NVIDIA, Robotic, 3D

Atlas 世界模型一次處理文字、圖片、影片與 3D

World Labs 推出 Atlas,聲稱是目前首個原生同時處理文字、圖像、影片與 3D 的「omni」世界模型,能從一張相機路徑推算未見過的視角,並重建真實場景。

Og image

World Labs 公開了新一代世界模型 Atlas。它的特別之處在於從訓練階段就同時處理四種輸入——文字、圖像、影片、3D——並把它們整合到同一個空間脈絡裡,再以多模態自迴歸擴散 Transformer 推算下一個畫面。這意味著 Atlas 不只是「看得更多」,而是嘗試理解世界怎樣呈現、怎樣變化,並把想像中的場景渲染出來。

從使用場景來看,Atlas 主要涵蓋四類工作:相機控制生成、空間重建、空間時間模擬,以及純文字生圖與 360 度全景。其中相機控制生成支援 1 至 6 張輸入圖片,可輸出最高 1440p、最長約 1 分鐘的影片,並以像素級精度的相機幾何作為輸入,而不只是粗略的文字描述。

重建方面,Atlas 只需要 1 張到幾十張相片,就能還原真實場景並產出新視角的影像幀與明確的 3D 輸出。團隊指出,這項表現優於專門做 3D 重建的同類模型。空間時間模擬則可從影片重新取景,生成電影級視覺效果,並支援 Real-to-Sim 流程,供機器人規劃動作。

以下幾點值得留意:

  • 原生多模態:文字、圖片、影片、3D 一開始就共享同一空間脈絡,並非後期拼接。
  • 像素級相機控制:把精確相機幾何列為原生輸入,能逐格構圖、逐段運鏡。
  • 超越專用模型:3D 重建表現優於專門訓練的模型。
  • 支援 Real-to-Sim:能把真實影片轉成可模擬的世界,供機器人規劃。
  • 規模持續擴展:團隊表示表現會隨訓練算力提升,並預期這個趨勢會延續下去。

World Labs 表示,Atlas 將驅動他們自家 Marble 的未來版本及其他產品,現已開放早期使用的申請。

項目主頁

Categories: AI productions, 多模態模型, 世界模型, 模型訓練, API, Video, Image, 影像模型, Robotic, 3D

SolarWM 開放視頻世界模型全流程基建

SolarWM 不只公開模型權重,連數據處理、訓練流程和長時推理方法一併開放,目標是降低互動式視頻世界模型的研究門檻。

SolarWM teaser: one framework for diverse interactive worlds

從數秒訓練片段推演出長達數分鐘甚至更長時間的互動視頻,一直是世界模型(World Model)發展中的難題。SolarWM 把焦點放在整個研發鏈條,而不只是單一模型,結合開放數據管線、訓練框架與推理流程,形成一個面向互動式視頻世界模型的完整研究基礎設施。

項目屬於世界模型訓練框架與開放研究基建,處理的問題是如何把不同來源的視頻資料整理成一致格式,並在不同模型骨幹之間建立可擴展的長時推理能力。團隊將來自 14 個資料集、約 143 萬段影片統一整理,讓資料準備與訓練配方可以分離,研究人員毋須重複建立資料處理流程。

與許多只圍繞單一架構設計的方法不同,SolarWM 強調保留原生骨幹能力,同時支援 Wan2.2、LTX-2.5 與 MiniMax-H3 等不同模型家族,涵蓋 5B 至 33B 規模。研究團隊提出三階段訓練流程,包括雙向適應、結合 AnyFlow 的教師強制訓練,以及長時互動推理策略,希望在不依賴超長訓練影片的情況下維持世界演化一致性。

  • 開放釋出資料處理管線、資料集及模型權重
  • 支援多個主流視頻生成骨幹,而非綁定單一架構
  • 利用約五秒片段訓練,目標達成分鐘級甚至小時級推理
  • 涵蓋 143 萬段影片與約 25TB 數據規模
  • 提供可重組資料配方與不同訓練策略組合

適合世界模型研究團隊、互動式模擬系統開發者,以及探索 World-Action Model 與長時視頻生成的學術機構。SolarWM 的價值不只在單次生成效果,而在於把過往難以重現的資料處理和訓練步驟公開,讓不同研究單位更容易比較方法與建立可重複驗證的實驗流程。長時間推理的一致性仍有待更多公開基準驗證,但這套框架已經把世界模型研究由單一模型競賽推向完整基礎設施層面。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, 世界模型, 模型訓練, NVIDIA, World-Action Model, 3D, LTX, Dataset 數據集, MiniMax

H3-World 讓鍵盤控制生成影片世界

H3-World把鍵盤輸入轉成可控制的未來畫面,展示互動式世界模型由理解指令走向操控環境。

Repository image for Danzer1xxxxChan/H3-World

按下 W、A、S、D 控制角色,或以 I、J、K、L 操控鏡頭,H3-World 便會由初始畫面生成相應的動作影片。這個項目屬於互動式世界模型,實際處理的是角色與鏡頭動作如何連貫地影響後續畫面,適合遊戲代理、視覺模擬及 Computer-use agents(CUAs)相關研究。

H3-World 建基於 MiniMax-H3,將每個鍵盤狀態轉換成對應未來 video latent 的語言指令,再透過 directed attention routing 把指令綁定到相應的 latent 區間。模型以 8,000 段 ABot-World-Explorer-500h gameplay clips 訓練,只學習 65.6M 個 Low-Rank Adaptation(LoRA)參數,約佔 33B backbone 的 0.199%,在保留大型模型能力與控制專用訓練成本之間取得折衷。

目前資料提供的重點包括:
– 角色控制使用 W、A、S、D;鏡頭控制使用 I、J、K、L,F 代表快速鏡頭移動。
– H3-World LoRA 是 MiniMax-H3 的 delta,不能直接套入未修改的 MiniMax-H3 pipeline。
– 推理需要約 135 GB 的 MiniMax-H3 base weights,以及 H3-World 的 directed-attention patch。
– 公開資料沒有列出明確的畫質、延遲或成功率比較,因此未能判斷它在不同世界模型之間的性能差距。

儲存庫提供 Python 3.10、CUDA 12.8、PyTorch 2.10.0 和指定版本 DiffSynth-Studio 的配置要求;模型權重及 LoRA checkpoint 則分別放在 Hugging Face 指定位置,訓練另需 ABot-World-Explorer-500h。研究團隊、遊戲代理開發者及需要可控影片生成的視覺模擬項目較容易受益,但硬件容量、專用 patch 和模型授權條款都是採用前必須核對的條件。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 多模態模型, 視頻模型, 模型訓練, NVIDIA, Video, Python, MiniMax

UI-Venus:多平台介面的高性能代理

UI-Venus 是一個針對手機、桌面和網頁介面的 GUI agent,重點處理視覺定位與互動導航。它用 35 萬筆專業標註資料和 RFT 提升長流程操作與跨平台泛化。

UI-Venus Performance Across Datasets

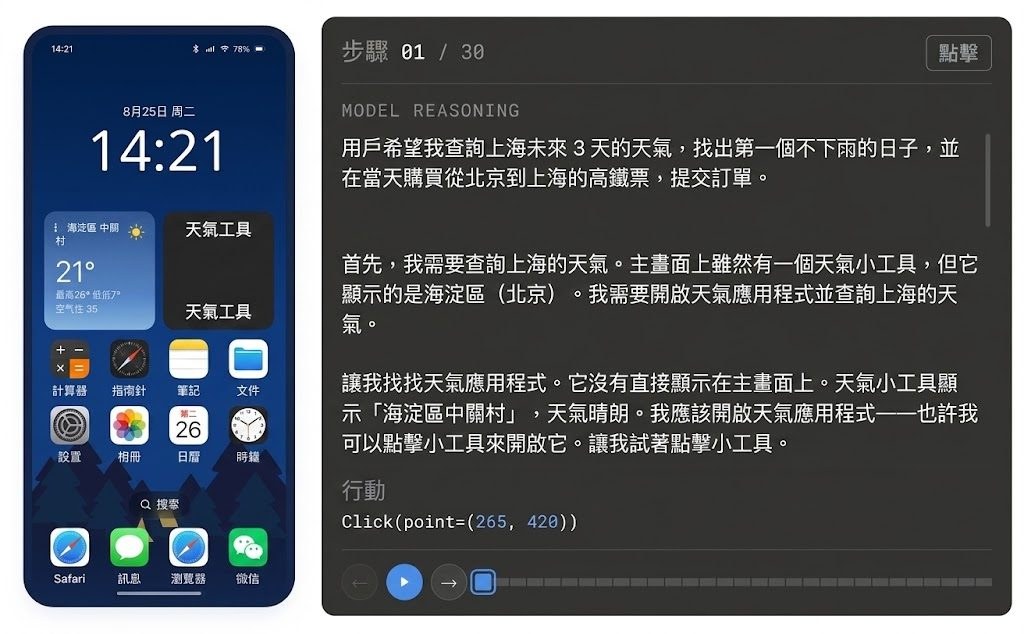
UI-Venus 是一個 GUI agent,直接面向手機、桌面和網頁介面,目標是解決看得懂畫面、點得準位置、又能沿著多步驟流程完成任務這幾個卡位。它把 Reinforcement Fine-Tuning(RFT)放進訓練流程,令動作預測不只是識判斷,仲可以連住環境回饋去修正下一步。

項目提供 7B 同 72B 兩個 checkpoint,亦交代咗評估流程同推理腳本,方便按截圖、標註檔同模型路徑去做測試。不過原始資料未提供完整安裝細節同實際部署步驟,較合理的理解係先用它的推理與評估流程驗證在 ScreenSpot-Pro、OS-World-G、AndroidWorld 等基準上的行為。

它的賣點不只是識辨認介面元件,而係把 credit assignment 放到長鏈路任務入面處理,令代理在連續操作時較易對齊目標。官方聲稱它在 AndroidWorld、ScreenSpot-v2、UI-Vision 同相關跨平台基準有競爭力,對需要自動化操作、界面導航同複雜任務拆解嘅團隊會較有吸引力。

  • 針對 GUI 理解同 action prediction,覆蓋 mobile、desktop、web 三類場景
  • 以 350K 高質量、專業標註樣本訓練,並加入 RFT
  • 提供 7B 與 72B checkpoint,以及評估和推理腳本
  • 強調長流程任務的 credit assignment,適合多步驟互動工作
  • 基準表現覆蓋 AndroidWorld、ScreenSpot-Pro、OS-World-G 等項目

對要做介面代理、手機自動化、網頁操作或桌面工作流整合的團隊,UI-Venus 比較像一個可以直接拿去評估能力邊界的基礎模型。它的限制亦清楚:原始資料未交代完整安裝與落地流程,實際接入時仍要按你手上的環境、介面類型同任務難度再做驗證。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, UI/UX

StudentSim:為每個學生建立模擬器,令輔導教學更準

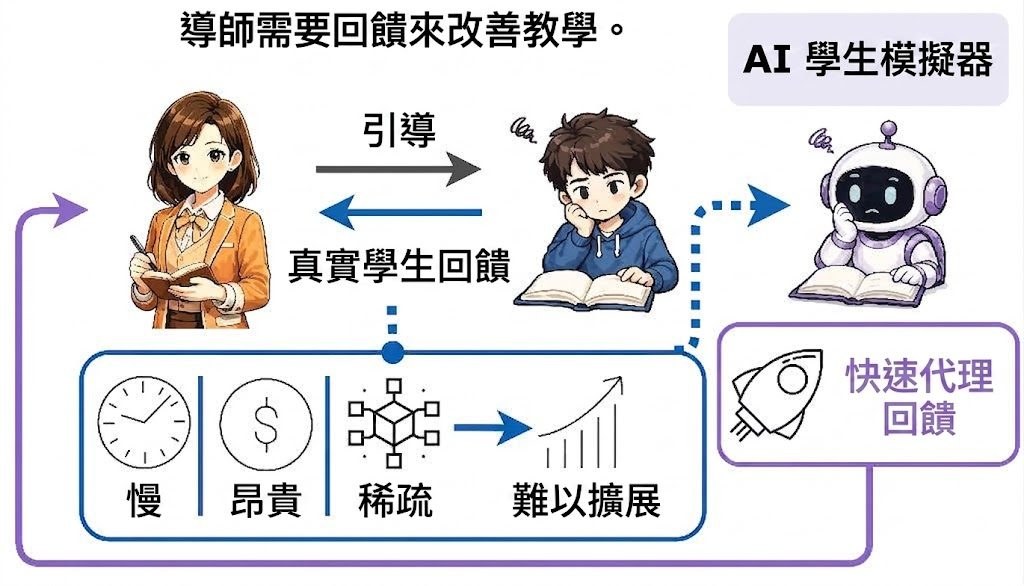
StudentSim 把稀疏的學生紀錄轉成個人化模擬器,用來測試哪種提示或輔導真正改變答案。它同時處理答題相似度與對指導的反應,適合做教學策略比較。

fig motivation

StudentSim 是一個由 Microsoft 研究的工具套件,核心是替每位學生建立獨立模擬器,解決「真實學生回饋太慢、太少、太貴」這個輔導優化難題。它先從多名學生的資料做 pooled training,再針對單一學生做 specialization,讓模擬器不只答得像,還要在收到指導後出現和原學生相近的變化。

它涵蓋 chess、second-language English writing (L2) 和 middle-school mathematics 三個場景,安裝時可按需要選擇 chess、l2、math、inference、tutor_rl 或 baselines 等 extras。訓練與評估可以在本地按模組跑起來,若要做 tutor reinforcement learning,還需要 libcairo 供棋盤繪製;涉及語言模型的步驟則要設定 AZURE_OPENAI_ENDPOINT 和 AZURE_OPENAI_API_KEY。

和一般只模仿答案的做法相比,StudentSim 更重視兩件事:一是 behavioral fidelity,二是 guidance responsiveness。前者看模擬器有沒有保留學生的能力層次與弱點,後者看學生收到輔導後會不會像真實紀錄那樣改變答案;在 chess 裡,它還示範了把 student simulator 當成 reward 來源,直接訓練 AI tutor 產生更有效的指導。

  • 可用來比較不同輔導語句對同一學生模型的影響
  • 適合教學科技、學習分析和 AI tutor 研究團隊
  • 支援多領域資料,方便觀察模型在不同學科的差異
  • 提供 closed-model baselines,方便和角色扮演式提示做對照
  • 評估不只看答對率,也看指導後是否真的改變行為

項目主頁 · GitHub

Categories: 開源, 模型訓練, 微軟

Microduck:細小雙足機械鴨的 RL 控制腦

Microduck 把雙足行走、拾取、起身與遙控操作收進同一套控制系統。它更像一個可落地的機械人控制項目,而不只是展示動作的樣機。

Repository image for pollen-robotics/microduck

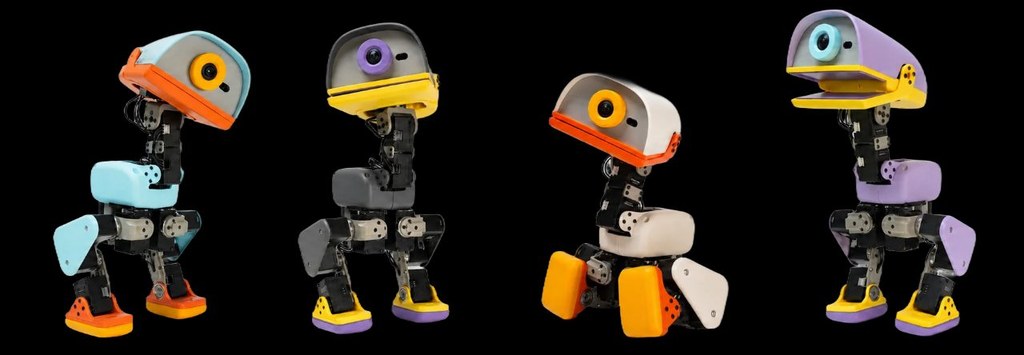
Microduck 係一個機械人控制項目,核心係為約 25 厘米、800 克嘅雙足機械鴨提供執行層,解決步行、起身、拾取同模式切換呢類動作控制問題。它唔只做單一演示,而係把無線電、相機、更新流程同 50 Hz 控制迴圈一齊放入同一個執行環境。

呢個項目嘅做法係喺 Rockchip RK3566 上跑幾個 daemon,並用神經策略驅動 15 個伺服。策略本身喺另一個項目 microduck_rl 訓練,採用 MuJoCo、PPO 同 sim2real,再匯出做 ONNX 俾這邊載入;原始資料未提供完整安裝或部署步驟,只能確認佢有 cheat sheet 同 duckctl 等操作入口。

同一般遙控機械人相比,Microduck 將控制、感知同更新機制綁得更緊,重點係讓細小雙足平台可以穩定接收新軟件,而唔會刷壞機器。它亦支援兩套行走形態,行走同輪式模式可以切換,顯示出硬件形態同策略之間嘅配合。

  • 以 RL policies 驅動雙足動作,而唔係只靠固定腳本
  • 在 RK3566 上運行,控制迴圈為 50 Hz
  • 由 microduck_rl 提供訓練與 ONNX 匯出
  • 具備相機、無線電同更新管理
  • 目標場景偏向機械人開發、控制驗證同現場操作

對做機械人研究、控制系統整合,或者想測試 sim2real 流程嘅團隊,呢個項目會較有參考價值。評估數字喺提供資料入面唔多,但已經可以見到它把「細體積、雙足、可更新」呢幾個限制同時處理。

項目主頁 · GitHub · 項目

Categories: 開源, 模型訓練, Robotic

[技術文章] 淘寶直播 AI 主播團隊提出 HAT 訓練法 解決小模型難以跟上快速更新的張力

淘寶直播 AIGC 團隊針對直播帶貨 AI 主播的實時互動需求,提出 Harness-Aware Training(HAT)框架,令小模型能在頻繁更新的策略環境中保持低延遲與高適應力。

Hero image preview

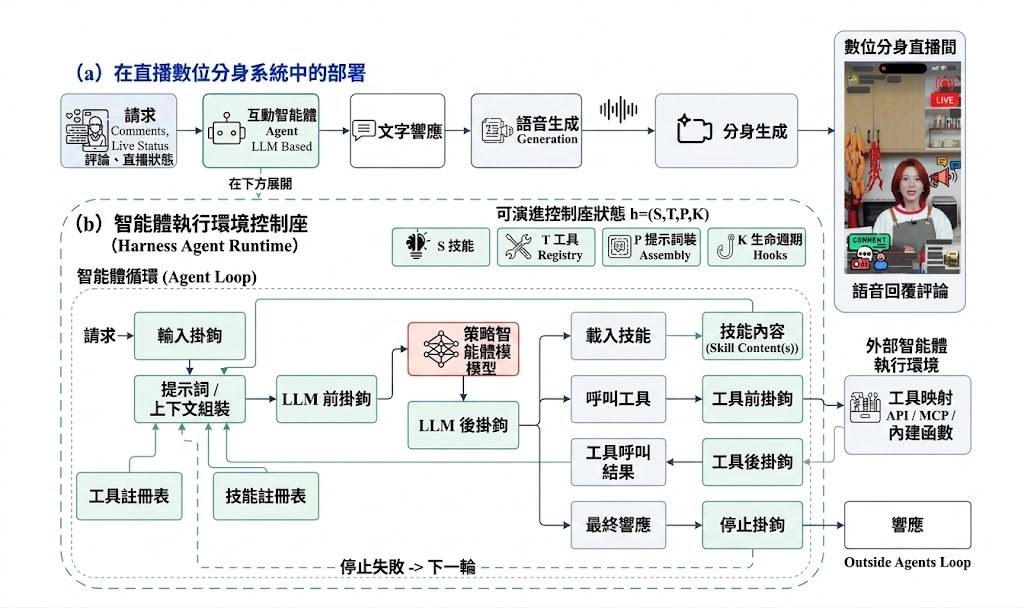
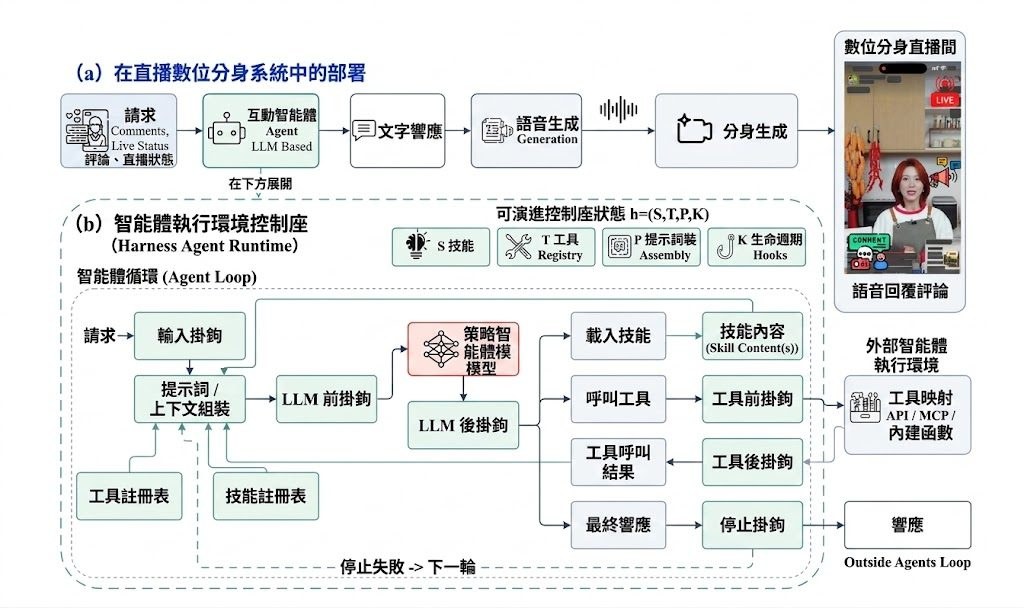
淘寶直播旗下的 TaoLive AIGC LLM 團隊發表技術報告,提出一套名為 Harness-Aware Training(HAT)的訓練方法,專門用於訓練能在直播帶貨場景中即時回答商品問題、與觀眾互動並執行營銷策略的數字人主播。團隊指出,直播帶貨對延遲極為敏感,同時行銷規則與商戶偏好又會持續變動,因此業界普遍採用「可演化 Harness」設計,把 Skills、Hooks、prompts 和 tools 與模型參數解耦,策略改動時不必重新訓練模型。然而這種做法帶來明顯取捨:大模型雖然泛化能力強,能夠零樣本適應 Harness 變動,但延遲太高;小模型延遲符合實時要求,卻容易過拟合到固定的 Harness 設定,一旦配置更新就需要重新訓練。

HAT 的核心思路是在訓練階段就讓模型接觸大量不同的 Harness 配置,使它學會「讀懂當前的 Harness」,而非記住某一個固定版本。具體做法引入 Harness-State Augmentation(HSA),對 Skill 識別碼、Skill 內容、工具 schema、prompt 結構及 Hook 函數施加保留任務語義的轉換。訓練分為三個階段:HSA-SFT 讓小模型從強模型生成、在多樣化環境中收集的高質量軌跡學習,直接提升推理與工具調用能力;General OPD 透過 On-Policy Distillation 在通用從基礎模型學習,恢復 SFT 過程中受損的泛化能力;HSA-RL 則在經 HSA 增廣的多樣化環境中做強化學習,進一步強化模型對變動 Harness 的理解與工具調用穩定性。

HAT 訓練的模型在 Live-Stream QA 上平均得分 94.8,明顯高於基礎模型的 80.3 和最強通用 LLM 的 93.0;在 Harness-Variant QA 上亦達到 94.6,遠超基礎模型的 75.4。傳統 Fixed-Harness SFT 會令 IFEval 分數較基礎模型下跌 7.7 分,而 HAT 不單避免這種下跌,更取得 83.5 分。在部署層面,模型可在單張 NVIDIA H20 GPU(啟用優化)上運行,P50 延遲 3.4 秒、P95 8.1 秒,已滿足實時互動門檻。系統已落地至淘寶直播的生產環境,線上 A/B 測試顯示相對 ReAct 對照組,Harness 實驗組在確認收貨 GMV 上帶來 4.33% 的 UV 標準化提升、商品頁瀏覽量提升 0.91%。

對需要快速疊代策略、又受制於延遲與算力的實時對話代理團隊而言,這份報告展示了一條可落地的工程路徑。

重點摘要
– 淘寶直播 AIGC 團隊針對直播帶貨 AI 主播提出 HAT 訓練框架
– 解決小模型過拟合固定 Harness、無法跟上策略更新的核心矛盾
– 透過 HSA 增廣與三階段訓練兼顧延遲、泛化與工具調用穩定性
– IFEval 分數避免傳統 SFT 出現的 7.7 分下跌,反升至 83.5
– 已在淘寶直播生產環境上線,A/B 測試帶來 GMV 與瀏覽量提升

Paper

Categories: 阿里巴巴, Agentic, 模型訓練, 框架, Skill 技能

[技術文章] 淘寶直播 AI 主播團隊提出 HAT 訓練法 解決小模型難以跟上快速更新的張力

淘寶直播 AIGC 團隊針對直播帶貨 AI 主播的實時互動需求,提出 Harness-Aware Training(HAT)框架,令小模型能在頻繁更新的策略環境中保持低延遲與高適應力。

Hero image preview

淘寶直播旗下的 TaoLive AIGC LLM 團隊發表技術報告,提出一套名為 Harness-Aware Training(HAT)的訓練方法,專門用於訓練能在直播帶貨場景中即時回答商品問題、與觀眾互動並執行營銷策略的數字人主播。團隊指出,直播帶貨對延遲極為敏感,同時行銷規則與商戶偏好又會持續變動,因此業界普遍採用「可演化 Harness」設計,把 Skills、Hooks、prompts 和 tools 與模型參數解耦,策略改動時不必重新訓練模型。然而這種做法帶來明顯取捨:大模型雖然泛化能力強,能夠零樣本適應 Harness 變動,但延遲太高;小模型延遲符合實時要求,卻容易過拟合到固定的 Harness 設定,一旦配置更新就需要重新訓練。

HAT 的核心思路是在訓練階段就讓模型接觸大量不同的 Harness 配置,使它學會「讀懂當前的 Harness」,而非記住某一個固定版本。具體做法引入 Harness-State Augmentation(HSA),對 Skill 識別碼、Skill 內容、工具 schema、prompt 結構及 Hook 函數施加保留任務語義的轉換。訓練分為三個階段:HSA-SFT 讓小模型從強模型生成、在多樣化環境中收集的高質量軌跡學習,直接提升推理與工具調用能力;General OPD 透過 On-Policy Distillation 在通用從基礎模型學習,恢復 SFT 過程中受損的泛化能力;HSA-RL 則在經 HSA 增廣的多樣化環境中做強化學習,進一步強化模型對變動 Harness 的理解與工具調用穩定性。

HAT 訓練的模型在 Live-Stream QA 上平均得分 94.8,明顯高於基礎模型的 80.3 和最強通用 LLM 的 93.0;在 Harness-Variant QA 上亦達到 94.6,遠超基礎模型的 75.4。傳統 Fixed-Harness SFT 會令 IFEval 分數較基礎模型下跌 7.7 分,而 HAT 不單避免這種下跌,更取得 83.5 分。在部署層面,模型可在單張 NVIDIA H20 GPU(啟用優化)上運行,P50 延遲 3.4 秒、P95 8.1 秒,已滿足實時互動門檻。系統已落地至淘寶直播的生產環境,線上 A/B 測試顯示相對 ReAct 對照組,Harness 實驗組在確認收貨 GMV 上帶來 4.33% 的 UV 標準化提升、商品頁瀏覽量提升 0.91%。

對需要快速疊代策略、又受制於延遲與算力的實時對話代理團隊而言,這份報告展示了一條可落地的工程路徑。

重點摘要
– 淘寶直播 AIGC 團隊針對直播帶貨 AI 主播提出 HAT 訓練框架
– 解決小模型過拟合固定 Harness、無法跟上策略更新的核心矛盾
– 透過 HSA 增廣與三階段訓練兼顧延遲、泛化與工具調用穩定性
– IFEval 分數避免傳統 SFT 出現的 7.7 分下跌,反升至 83.5
– 已在淘寶直播生產環境上線,A/B 測試帶來 GMV 與瀏覽量提升

Paper

Categories: 阿里巴巴, Agentic, 模型訓練, 框架, Skill 技能

Page 19 of 38
1 … 17 18 19 20 21 … 38