MoCha 成角色替換

MoCha 是一個專注於視頻角色替換的開源框架,旨在只需要單一參考即可完成角色替換,且不依賴任何結構化指導(如骨骼、深度圖或逐幀分割)。傳統的重建式方法往往必須提供完整的逐幀遮罩與額外的結構資訊,面對遮擋、複雜姿態或多角色互動時容易產生視覺雜訊與時間不穩定,而 MoCha 的設計則把這些限制全部排除,取而代之的是把不同條件統一為單一的 token 流,並通過條件感知的 RoPE(Rotary Positional Embedding)結合多參考圖像,支撐可變長度的影片生成。

MoCha 是一個專注於視頻角色替換的開源框架,旨在只需要單一參考即可完成角色替換,且不依賴任何結構化指導(如骨骼、深度圖或逐幀分割)。傳統的重建式方法往往必須提供完整的逐幀遮罩與額外的結構資訊,面對遮擋、複雜姿態或多角色互動時容易產生視覺雜訊與時間不穩定,而 MoCha 的設計則把這些限制全部排除,取而代之的是把不同條件統一為單一的 token 流,並通過條件感知的 RoPE(Rotary Positional Embedding)結合多參考圖像,支撐可變長度的影片生成。
Categories: 開源, 數字人, 視頻模型

DreamID-V 開源換臉

DreamID-V 是一個專門為高保真度臉部交換設計的技術,它旨在縮短圖像到視頻之間的差距。這技術在處理各種挑戰性場景時表現出色,包括頭髮遮擋、複雜光照、多樣化的種族和顯著的臉型變化。DreamID-V 的應用範圍廣泛,可以應用於娛樂、廣告和電影製作等領域,考慮到了實際應用中的多種需求和挑戰。提供更加逼真的臉部交換效果。 對於使用者來說,DreamID-V 提供了單 GPU 和多 GPU 推理的選項,並且有詳細的安裝和使用指南。使用者需要準備好相應的模型文件和依賴庫,然後根據提供的腳本進行操作。此外,DreamID-V 還支持不同的模型版本,例如 DreamID-V-Wan-1.3B-DWPose,這進一步提升了姿態檢測的穩定性和魯棒性。

DreamID-V 是一個專門為高保真度臉部交換設計的技術,它旨在縮短圖像到視頻之間的差距。這技術在處理各種挑戰性場景時表現出色,包括頭髮遮擋、複雜光照、多樣化的種族和顯著的臉型變化。DreamID-V 的應用範圍廣泛,可以應用於娛樂、廣告和電影製作等領域,考慮到了實際應用中的多種需求和挑戰。提供更加逼真的臉部交換效果。

對於使用者來說,DreamID-V 提供了單 GPU 和多 GPU 推理的選項,並且有詳細的安裝和使用指南。使用者需要準備好相應的模型文件和依賴庫,然後根據提供的腳本進行操作。此外,DreamID-V 還支持不同的模型版本,例如 DreamID-V-Wan-1.3B-DWPose,這進一步提升了姿態檢測的穩定性和魯棒性。

Categories: 開源, 字節跳動, 數字人, 視頻模型

PersonaLive 安裝教學 (12G VRAM)

影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。

影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。

用 AI 即時變身女神|免費
Categories: 開源, 數字人, 影像模型, 影像處理, Python

輕鬆製作超逼真 AI 說話頭像影片

InfiniteTalk 完全免費、支援長影片,唇同步自然但需調參避免誇張;HeyGen 更親民但付費,兩者差異不大,InfiniteTalk 性價比高。 適合 IT 顧問用於快速製作教程或演示影片,節省攝影成本。

InfiniteTalk 完全免費、支援長影片,唇同步自然但需調參避免誇張;HeyGen 更親民但付費,兩者差異不大,InfiniteTalk 性價比高。 適合 IT 顧問用於快速製作教程或演示影片,節省攝影成本。

Create Realistic AI AVATARS That Look And Talk EXACTLY Like You! | FREE ComfyUI Tutorial
Categories: ComfyUI, AI productions, 數字人, 影像處理, Python

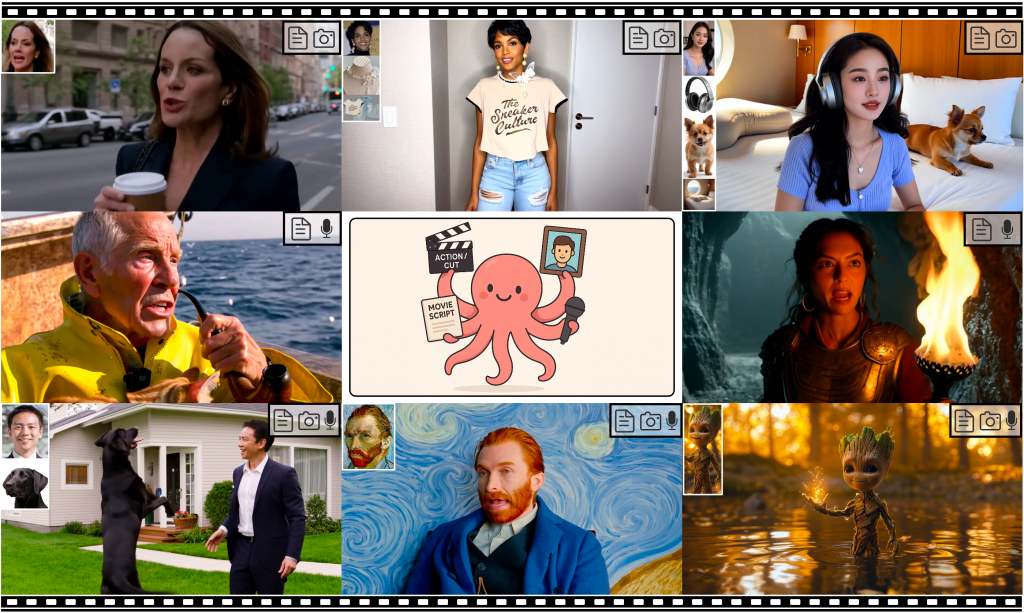
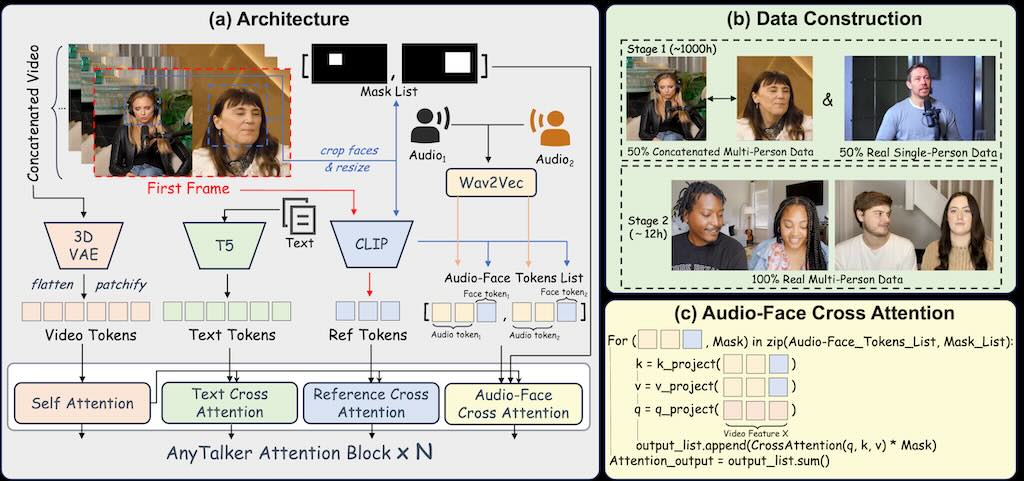
AnyTalker 多人對話唇形同步影片

AnyTalker,一個基於音訊的多人對話的開源視訊生成框架。它採用靈活的多流結構,既能擴展身份規模,又能確保身份之間的無縫互動。

AnyTalker,一個基於音訊的多人對話的開源視訊生成框架。它採用靈活的多流結構,既能擴展身份規模,又能確保身份之間的無縫互動。

Categories: 開源, 香港科技大學, 數字人, 影像處理

OVI 11B 低 VRAM 顯卡上做 10 秒影片

影片教你怎樣用「ComfyUI + OVI 11B」在低 VRAM 顯示卡上做 10 秒有畫又有聲嘅影片生成功能,重點係一步步教你放啱模型檔、設定 workflow,同埋用 LoRA 喺低 steps 都保持畫質。 主要功能

影片教你怎樣用「ComfyUI + OVI 11B」在低 VRAM 顯示卡上做 10 秒有畫又有聲嘅影片生成功能,重點係一步步教你放啱模型檔、設定 workflow,同埋用 LoRA 喺低 steps 都保持畫質。

ComfyUI OVI Workflow: Text & Image to 10s Video on Low VRAM

主要功能

  • 用 ComfyUI 的 OVI workflow,一套 graph 就可以同時支援「text to video」同「image to video」,唔需要兩個 workflow。​
  • 支援 OVI 11B FP8 或 BF16,針對低 VRAM / 中高 VRAM 有唔同精度選擇。​
  • 一次 render 就生成 10 秒影片連同步音訊,包括對白同環境聲。
Categories: 阿里巴巴, 數字人, 影像模型, 教學

Ovi 生成視頻、對嘴音頻

Ovi 使用了專屬預訓練 5B 音頻分支,架構設計類似 WAN 2.2 5B,同時提供了 1B 融合分支,支持純文本或文本+圖片輸入,自動生成視頻、對嘴音頻,以及匹配場景的背景音效和音樂。

Ovi 使用了專屬預訓練 5B 音頻分支,架構設計類似 WAN 2.2 5B,同時提供了 1B 融合分支,支持純文本或文本+圖片輸入,自動生成視頻、對嘴音頻,以及匹配場景的背景音效和音樂。

Finally, open-source AI video with SOUND! Ovi tutorial
OVI ComfyUI Workflow: Image & Text-to-Video with Sound (2025) — Is It Better Than Veo 3?
Categories: 開源, ComfyUI, 數字人

Paper2Video 論文自動生成視頻系統

Paper2Video 能從輸入的論文(LaTeX源碼)、一張圖片和一段音頻,生成完整的學術報告視頻。集成了幻燈片生成、字幕生成、游標定位、語音合成、講者視頻渲染等多模態子模塊,實現一條龍的演示視頻製作流程。支持並行處理以提升視頻生成效率,推薦GPU為NVIDIA A6000(48G顯存)及以上。 需要設定 GPT-4.1 或 Gemini2.5-Pro 等大型語言模型 API Key,支持本地 Qwen 模型。

Paper2Video 能從輸入的論文(LaTeX源碼)、一張圖片和一段音頻,生成完整的學術報告視頻。集成了幻燈片生成、字幕生成、游標定位、語音合成、講者視頻渲染等多模態子模塊,實現一條龍的演示視頻製作流程。支持並行處理以提升視頻生成效率,推薦GPU為NVIDIA A6000(48G顯存)及以上。

需要設定 GPT-4.1 或 Gemini2.5-Pro 等大型語言模型 API Key,支持本地 Qwen 模型。

Categories: 開源, 數字人, Gemini, Python, 語音

HuMo:文本、圖片和音訊三種輸入

HuMo 是一個以人類為核心的多模態條件影片生成框架,能夠根據文本、圖片和音訊三種輸入產生高品質且可精細控制的人物影片。專案由清華大學與字節跳動智創團隊聯合開發 主要特色 快速安裝及使用

HuMo 是一個以人類為核心的多模態條件影片生成框架,能夠根據文本、圖片和音訊三種輸入產生高品質且可精細控制的人物影片。專案由清華大學與字節跳動智創團隊聯合開發

主要特色

  • 支援 文本-圖片、文本-音訊 及 文本-圖片-音訊 的多模態影片生成,可自由設計角色造型、服裝、道具和場景。
  • 文字指令的高遵循度、角色連貫性,以及音訊帶動的動作同步。
  • 可生成 480P 或 720P 的高規格影片,並支援多 GPU 計算。

快速安裝及使用

  • 透過 Conda 及 pip 安裝相關依賴(Python 3.11、Torch 2.5.1 等),並下載模型檔。
  • 支援直接輸入文本、參考圖片和音訊檔案,根據三種模式(TA、TIA)選擇推理腳本運行生成。

Categories: 開源, 字節跳動, 數字人, 視頻模型

LIA-X 肖像動畫器

LIA-X (Interpretable Latent Portrait Animator)強調其控制性,適合 AI 研究者和內容創作者使用,旨在將臉部動態從驅動影片遷移到指定的頭像,並實現精細控制。 LIA-X 功能列表 LIA-X 的可解釋性與細粒度控制能力,使其支援多種實際應用: 圖像動畫 (Image Animation):能夠將驅動影片的臉部動態轉移到來源肖像上,並可透過控制面板進行編輯。使用者可以上傳來源圖像和驅動影片,然後使用控制面板編輯來源圖像,並生成動畫影片。 圖像編輯 (Image Editing):允許使用者上傳來源圖像,並透過控制面板對其進行精確編輯。這包括對臉部細節的控制,例如偏航 (yaw)、噘嘴 (pout)、閉眼和眼球移動。 影片編輯 (Video Editing):支援使用者上傳影片,並透過控制面板編輯影片的第一幀,以產生新的編輯後影片。同樣支援細粒度控制,例如頭部偏航和閉眼。 線性操控 (Linear Manipulation):可以進行諸如偏航 (yaw)、俯仰 (pitch)、眼睛閉合與張開,以及眼球移動等臉部動態的線性控制。 3D 感知肖像影片操控 (3D-aware Portrait Video Manipulation):這是一個更進階的應用,LIA-X 的可控性質支援此類應用。 動畫化個人資料 (Animating Your Own Data):支援使用者自行準備圖像和影片資料(例如裁剪),然後進行動畫化處理。 細粒度、使用者引導的圖像和影片編輯:作為其可解釋和可控性質的直接結果,LIA-X 能夠實現這種精確的編輯。

LIA-X (Interpretable Latent Portrait Animator)強調其控制性,適合 AI 研究者和內容創作者使用,旨在將臉部動態從驅動影片遷移到指定的頭像,並實現精細控制。

LIA-X 功能列表

LIA-X 的可解釋性與細粒度控制能力,使其支援多種實際應用:

  • 圖像動畫 (Image Animation):能夠將驅動影片的臉部動態轉移到來源肖像上,並可透過控制面板進行編輯。使用者可以上傳來源圖像和驅動影片,然後使用控制面板編輯來源圖像,並生成動畫影片。
  • 圖像編輯 (Image Editing):允許使用者上傳來源圖像,並透過控制面板對其進行精確編輯。這包括對臉部細節的控制,例如偏航 (yaw)、噘嘴 (pout)、閉眼和眼球移動。
  • 影片編輯 (Video Editing):支援使用者上傳影片,並透過控制面板編輯影片的第一幀,以產生新的編輯後影片。同樣支援細粒度控制,例如頭部偏航和閉眼。
  • 線性操控 (Linear Manipulation):可以進行諸如偏航 (yaw)、俯仰 (pitch)、眼睛閉合與張開,以及眼球移動等臉部動態的線性控制。
  • 3D 感知肖像影片操控 (3D-aware Portrait Video Manipulation):這是一個更進階的應用,LIA-X 的可控性質支援此類應用。
  • 動畫化個人資料 (Animating Your Own Data):支援使用者自行準備圖像和影片資料(例如裁剪),然後進行動畫化處理。
  • 細粒度、使用者引導的圖像和影片編輯:作為其可解釋和可控性質的直接結果,LIA-X 能夠實現這種精確的編輯。

Categories: 開源, 數字人, 視頻模型, 影像模型, 影像處理, 動畫

Page 4 of 6
1 2 3 4 5 6