OmniTry,這是一個由昆位元人工智慧和浙江大學開發的虛擬試穿框架。該系統旨在擴展虛擬試穿功能,使其不僅限於服裝,還能應用於各種可穿戴物品,例如珠寶和配飾,並且支援無遮罩設置,更適合實際應用。OmniTry 採用了兩階段訓練管道,首先利用大量不成對的圖像進行無遮罩定位訓練,然後再利用成對圖像進一步精細調整以確保外觀一致性。該專案的程式碼、模型權重和評估基準都已公開發布,供研究人員和開發者使用。
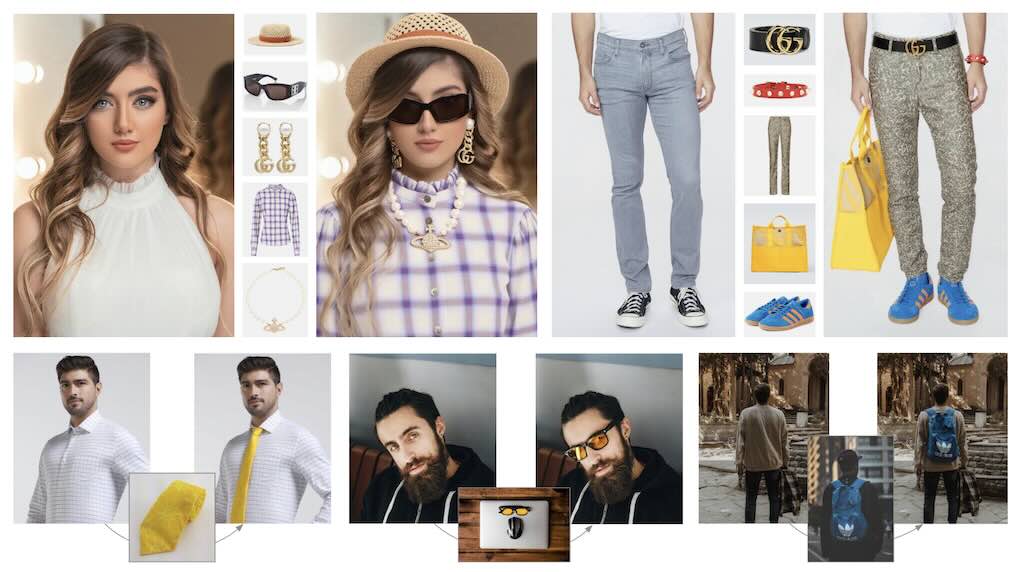
OmniTry,這是一個由昆位元人工智慧和浙江大學開發的虛擬試穿框架。該系統旨在擴展虛擬試穿功能,使其不僅限於服裝,還能應用於各種可穿戴物品,例如珠寶和配飾,並且支援無遮罩設置,更適合實際應用。OmniTry 採用了兩階段訓練管道,首先利用大量不成對的圖像進行無遮罩定位訓練,然後再利用成對圖像進一步精細調整以確保外觀一致性。該專案的程式碼、模型權重和評估基準都已公開發布,供研究人員和開發者使用。
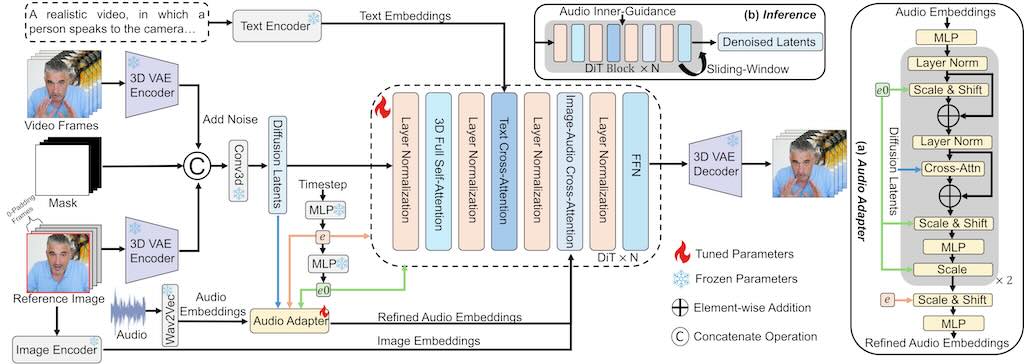
用於音訊驅動頭像視訊產生的擴散模型難以合成具有自然音訊同步和身份一致性的長視訊。基於 Wan2.1-1.3B 的 StableAvatar 音訊驅動的頭像視訊效果,是首個端到端視訊擴散變換器,無需後製即可合成無限長的高品質視訊。
用於音訊驅動頭像視訊產生的擴散模型難以合成具有自然音訊同步和身份一致性的長視訊。基於 Wan2.1-1.3B 的 StableAvatar 音訊驅動的頭像視訊效果,是首個端到端視訊擴散變換器,無需後製即可合成無限長的高品質視訊。
FantasyPortrait 支援使用多個單人影片或單一多人影片驅動多個角色,產生細緻的表情和逼真的肖像動畫。 從靜態圖像中製作富有表現力的臉部動畫是一項極具挑戰性的任務。現有方法缺乏對多角色動畫的支持,因為不同個體的驅動特徵經常相互幹擾,使任務變得複雜。FantasyPortrait 提出了 Multi-Expr 資料集和 ExprBench,它們是專門為訓練和評估多角色肖像動畫而設計的資料集和基準。大量實驗表明,FantasyPortrait 在定量指標和定性評估方面均顯著超越了最先進的方法,尤其是在具有挑戰性的交叉重現和多角色情境中表現出色。
FantasyPortrait 支援使用多個單人影片或單一多人影片驅動多個角色,產生細緻的表情和逼真的肖像動畫。
從靜態圖像中製作富有表現力的臉部動畫是一項極具挑戰性的任務。現有方法缺乏對多角色動畫的支持,因為不同個體的驅動特徵經常相互幹擾,使任務變得複雜。FantasyPortrait 提出了 Multi-Expr 資料集和 ExprBench,它們是專門為訓練和評估多角色肖像動畫而設計的資料集和基準。大量實驗表明,FantasyPortrait 在定量指標和定性評估方面均顯著超越了最先進的方法,尤其是在具有挑戰性的交叉重現和多角色情境中表現出色。

這個教程介紹如何使用 Flux Kontext 和 VACE 第一幀/最後一幀在 ComfyUI 中創建基於關鍵幀的高級動畫!Kontext 瞭解完整的圖像上下文,而 VACE 允許在起始幀和完全不同的最終姿勢或角色之間無縫移動。無論您是將一個人變形為另一個人,還是為角色的姿勢製作跨時間的動畫,這都是 AI 視頻生成的一個突破。
這個教程介紹如何使用 Flux Kontext 和 VACE 第一幀/最後一幀在 ComfyUI 中創建基於關鍵幀的高級動畫!Kontext 瞭解完整的圖像上下文,而 VACE 允許在起始幀和完全不同的最終姿勢或角色之間無縫移動。無論您是將一個人變形為另一個人,還是為角色的姿勢製作跨時間的動畫,這都是 AI 視頻生成的一個突破。

由音訊驅動的人體動畫技術,以面部動作同步且畫面吸睛的能力,已經有很顯著的進步。然而,現有的方法大多專注於單人動畫,難以處理多路音訊輸入,也因此常發生音訊與人物無法正確配對的問題。 MultiTalk 為了克服這些挑戰,提出了一項新任務:多人對話影片生成,並引入了一個名為 MultiTalk 的新框架。這個框架專為解決多人生成過程中的難題而設計。具體來說,在處理音訊輸入時,我們研究了多種方案,並提出了一種**標籤旋轉位置嵌入(L-RoPE)**的方法,來解決音訊與人物配對不正確的問題。香港科技大學數學與數學研究中心及電子與電腦工程系有份參與。
由音訊驅動的人體動畫技術,以面部動作同步且畫面吸睛的能力,已經有很顯著的進步。然而,現有的方法大多專注於單人動畫,難以處理多路音訊輸入,也因此常發生音訊與人物無法正確配對的問題。
MultiTalk 為了克服這些挑戰,提出了一項新任務:多人對話影片生成,並引入了一個名為 MultiTalk 的新框架。這個框架專為解決多人生成過程中的難題而設計。具體來說,在處理音訊輸入時,我們研究了多種方案,並提出了一種**標籤旋轉位置嵌入(L-RoPE)**的方法,來解決音訊與人物配對不正確的問題。香港科技大學數學與數學研究中心及電子與電腦工程系有份參與。
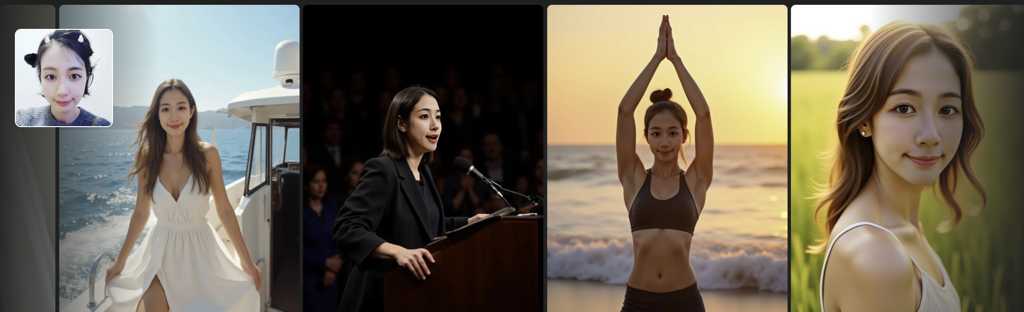
OmniAvatar 是一種創新的音訊驅動全身視訊生成模型,它透過提高唇形同步精度和自然動作來增強人體動畫。 OmniAvatar 引入了一種逐像素多層音訊嵌入策略,可更好地捕捉潛在空間中的音訊特徵,從而增強不同場景下的唇形同步效果。為了在有效融合音訊特徵的同時保留基礎模型的提示驅動控制能力,我們採用了基於 LoRA 的訓練方法。大量實驗表明,OmniAvatar 在臉部和半身視訊生成方面均超越現有模型,能夠提供基於文字的精準控制,用於創建播客、人機互動、動態場景和歌唱等各個領域的影片。
OmniAvatar 是一種創新的音訊驅動全身視訊生成模型,它透過提高唇形同步精度和自然動作來增強人體動畫。 OmniAvatar 引入了一種逐像素多層音訊嵌入策略,可更好地捕捉潛在空間中的音訊特徵,從而增強不同場景下的唇形同步效果。為了在有效融合音訊特徵的同時保留基礎模型的提示驅動控制能力,我們採用了基於 LoRA 的訓練方法。大量實驗表明,OmniAvatar 在臉部和半身視訊生成方面均超越現有模型,能夠提供基於文字的精準控制,用於創建播客、人機互動、動態場景和歌唱等各個領域的影片。

MTVCrafter 是專門用來製作高品質的數字人動畫。現有方法依賴二維渲染的姿態影像進行運動引導,這限制了其泛化能力並丟棄了重要的三維資訊。MTVCrafter 有兩個厲害的設計:第一個是 4DMoT(4D 運動標記器),能夠將三維動作轉成 4D 運動標記,比二維圖片更精準地捕捉時間和空間的細節!第二個是 MV-DiT(運動感知影片 DiT),用了一個特別的 4D 位置編碼技術,讓動畫在複雜的三維世界裡也能流暢又生動。實驗結果的 FID-VID 分數達到 6.98,比第二名強了 65%,不管是單人、多人、全身或半身的角色,還是各種風格和場景,它都能輕鬆搞定!
MTVCrafter 是專門用來製作高品質的數字人動畫。現有方法依賴二維渲染的姿態影像進行運動引導,這限制了其泛化能力並丟棄了重要的三維資訊。MTVCrafter 有兩個厲害的設計:第一個是 4DMoT(4D 運動標記器),能夠將三維動作轉成 4D 運動標記,比二維圖片更精準地捕捉時間和空間的細節!第二個是 MV-DiT(運動感知影片 DiT),用了一個特別的 4D 位置編碼技術,讓動畫在複雜的三維世界裡也能流暢又生動。實驗結果的 FID-VID 分數達到 6.98,比第二名強了 65%,不管是單人、多人、全身或半身的角色,還是各種風格和場景,它都能輕鬆搞定!
1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。 影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)
1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。
影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)

InfiniteYou 的獨特之處在於其強大的身份保留技術!透過核心組件 InfuseNet,即使在生成全新場景或是不同風格的相片,也能精準保留相片中的人物特徵。您可以僅以文字描述,就能讓同一人物出現在不同情境、穿著不同的衫,甚至呈現不同的風格。它亦支援 ControlNet 和 LoRA 的進階控制,令創意揮灑的同時,也能精細調整生成結果,直至符合您需要的獨特內容!(ByteDance)
InfiniteYou 的獨特之處在於其強大的身份保留技術!透過核心組件 InfuseNet,即使在生成全新場景或是不同風格的相片,也能精準保留相片中的人物特徵。您可以僅以文字描述,就能讓同一人物出現在不同情境、穿著不同的衫,甚至呈現不同的風格。它亦支援 ControlNet 和 LoRA 的進階控制,令創意揮灑的同時,也能精細調整生成結果,直至符合您需要的獨特內容!(ByteDance)
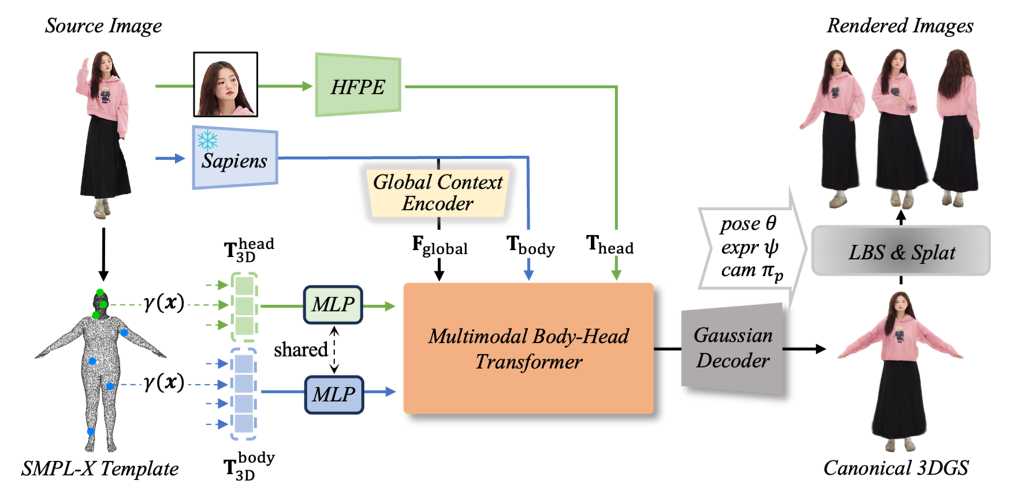
LHM (Large Animatable Human Reconstruction Model) 是一個高效及高質量的 3D 人體重建方案模型,能夠在幾秒鐘內生成影片。模型利用了多模態的 Transformer 架構,以注意力機制,對人體特徵和影像特徵進行編碼,能夠詳細保存服裝的幾何形狀和紋理。為了進一步增強細節,LHM 提出了一種針對頭部特徵的金字塔型編碼方案,能夠生成頭部區域的多種特徵。(阿里巴巴)
LHM (Large Animatable Human Reconstruction Model) 是一個高效及高質量的 3D 人體重建方案模型,能夠在幾秒鐘內生成影片。模型利用了多模態的 Transformer 架構,以注意力機制,對人體特徵和影像特徵進行編碼,能夠詳細保存服裝的幾何形狀和紋理。為了進一步增強細節,LHM 提出了一種針對頭部特徵的金字塔型編碼方案,能夠生成頭部區域的多種特徵。(阿里巴巴)