PhyMotion點樣令人物動作更似真

這個專案不是直接生影片,而是幫模型判斷人物動作是否合乎物理。對想提升人像影片自然度的人特別有參考價值。

teaser image

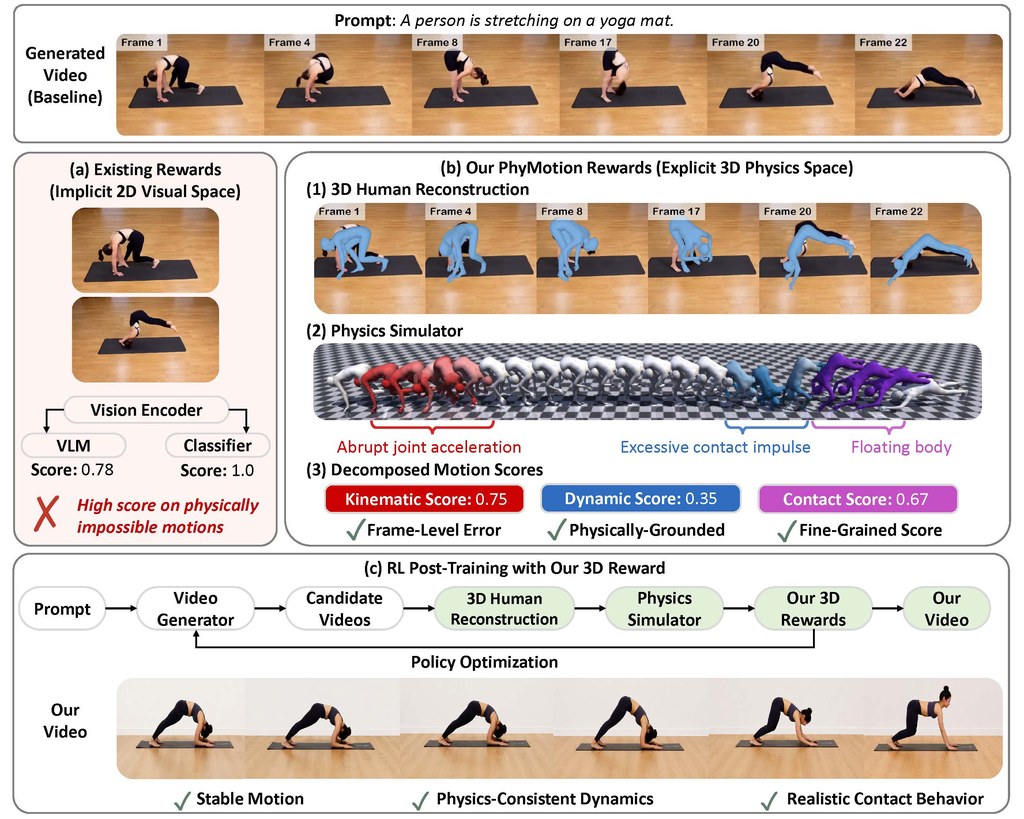
做人物影片生成,最難往往不是畫面靚唔靚,而係人郁動時有冇「似真」。PhyMotion針對的正是這個痛點:它提供一套較細緻的評分方法,專門檢查生成影片中的人體動作是否合理,例如會否出現腳步飄浮、失去平衡,或者動作雖然順眼但其實不合物理常識。

它的做法幾有意思。團隊先從影片還原出3D人體網格,使用SMPL表示身體,再把動作轉到MuJoCo的人形物理模擬環境內,從三方面評估:關節運動是否自然、接觸與平衡是否一致、以及整體動態是否可行。比起只靠2D畫面觀感打分,這種方法更能指出問題究竟出在哪一層。

如果你想上手,較合理的方式不是把它當成一般剪片工具,而是當成研究或訓練流程中的「動作評審」。儲存庫提供有 PhyMotion-CausalForcing-1.3B 相關權重與 LoRA 形式檢查點,較適合已經在做人像影片生成、後訓練或獎勵設計的人逐步接入。

  • 重點不在直接生成影片,而在替影片中的人體動作評分
  • 結合 SMPLMuJoCo,比純2D評估更重視身體結構與物理性
  • 適用於自回歸與雙向類型的影片生成訓練流程
  • 相關資源包括論文、模型、資料集,以及 PhyMotion-CausalForcing-1.3B

整體來看,PhyMotion最有價值的地方,是把「睇落順眼」進一步拆成可分析的幾個部分,令改進方向更清楚。它特別適合研究員、AI 影片開發者,或者想提升人物動作真實感的團隊;對一般用家來說,未必是即裝即用,但作為理解下一代人物影片質素點樣提升,這個項目相當值得留意。

網址: https://github.com/h6kplus/PhyMotion

Categories: 開源, 數字人, 影像模型, 影像處理


LumosX 精準個性化數字人

LumosX 是一個針對 個性化多主體視訊生成(personalized multi‑subject video generation)提出的框架,重點在: 簡單說:一樣可以做 text‑to‑video + ID conditioning,但對多個人物、每個人對應什麼屬性,控制得更精細、更一致「可控視訊生成」與「多主體個性化內容」場景,例如多角色劇本生成、廣告、虛擬試衣、多角色 VTuber 相容演出等。

LumosX 是一個針對 個性化多主體視訊生成(personalized multi‑subject video generation)提出的框架,重點在:

  • 讓每個「身份」(例如不同人物)和其對應的屬性(年齡、外貌、服飾、動作等)有明確、精準的對齊;
  • 用關係性注意力機制來強化「組內一致性」(同一組人物屬性一致)和「組間區分度」,減少多主體時的屬性糾纏(attribute entanglement)。

簡單說:一樣可以做 text‑to‑video + ID conditioning,但對多個人物、每個人對應什麼屬性,控制得更精細、更一致「可控視訊生成」與「多主體個性化內容」場景,例如多角色劇本生成、廣告、虛擬試衣、多角色 VTuber 相容演出等。

Categories: 開源, 阿里巴巴, 數字人, 視頻模型

daVinci‑MagiHuman 單流數字人

daVinci‑MagiHuman 是一個 15B 參數、專注數字人(human‑centric)的文本到視頻生成模型,同時支援視頻與音頻 token 的聯合生成,主打「人類主體」表現力。daVinci‑MagiHuman 由 SII‑GAIR Lab(中國上海人工智慧實驗室 SII‑GAIR)與 Sand.ai 這兩方聯合開發

daVinci‑MagiHuman 是一個 15B 參數、專注數字人(human‑centric)的文本到視頻生成模型,同時支援視頻與音頻 token 的聯合生成,主打「人類主體」表現力。daVinci‑MagiHuman 由 SII‑GAIR Lab(中國上海人工智慧實驗室 SII‑GAIR)與 Sand.ai 這兩方聯合開發

  • 單流 Transformer — 一個統一的 150 億參數、40 層的 Transformer,僅透過自註意力機制即可聯合處理文字、視訊和音訊。無需交叉注意力,也無需多流處理。
  • 🎭卓越的以人為本的品質— 富有表現力的面部表情、自然的語音表達協調、逼真的身體動作以及準確的音視頻同步。
  • 🌍多語言— 支援中文(國語和粵語)、英語、日語、韓語、德語和法語。
  • 超快推理-在單一 H100 GPU 上,可在2 秒內產生 5 秒 256p 視頻,在38 秒內產生5 秒 1080p 影片。
  • 🏆最先進的結果—在超過 2,000 次的成對人工評估中,與 Ovi 1.1 的勝率達到80.0% ,與 LTX 2.3 的勝率達到60.9% 。
  • 📦完全開源— 我們發布完整的模型堆疊:基礎模型、精煉模型、超解析度模型和推理程式碼。
Categories: 開源, 數字人, 模型, 視頻模型

InteractAvatar 互動數字人

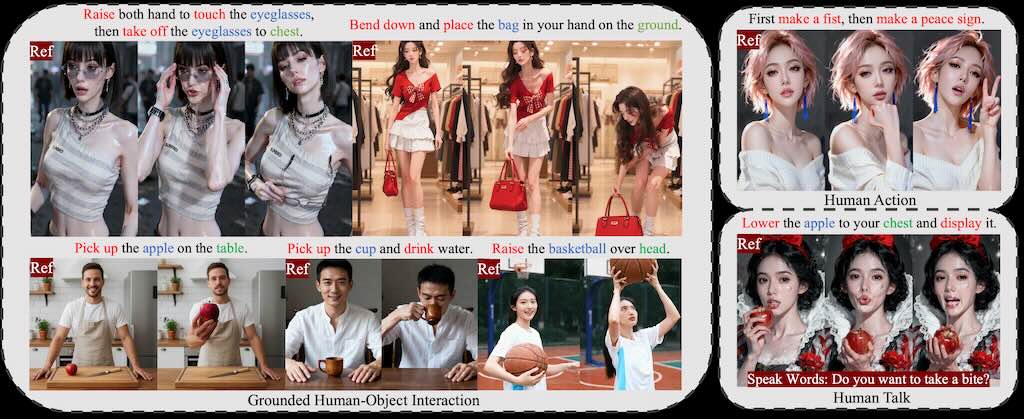
InteractAvatar 能從一張靜態參考圖生成「人與物體互動」的視頻,同時保持音畫同步(lip‑sync + co‑speech gestures)。同時能夠執行基於場景的人機互動 (GHOI)。與以往僅限於簡單手勢的方法不同,我們的模型可以從靜態參考圖像中感知環境,並產生複雜的、文本引導的與物體的交互,同時保持高保真度的唇部同步。 雙流 Diffusion Transformer(DiT)架構:一個分支做「感知與互動規劃」(Perception and Interaction Module, PIM),負責理解圖片裡的物體位置與關係,並生成對齊文字指令的動作序列。另一個分支做「音訊‑互動感知生成」(Audio‑Interaction Aware Generation Module, AIM),把動作與語音融合成高品質視頻。

InteractAvatar 能從一張靜態參考圖生成「人與物體互動」的視頻,同時保持音畫同步(lip‑sync + co‑speech gestures)。同時能夠執行基於場景的人機互動 (GHOI)。與以往僅限於簡單手勢的方法不同,我們的模型可以從靜態參考圖像中感知環境,並產生複雜的、文本引導的與物體的交互,同時保持高保真度的唇部同步。

雙流 Diffusion Transformer(DiT)架構:一個分支做「感知與互動規劃」(Perception and Interaction Module, PIM),負責理解圖片裡的物體位置與關係,並生成對齊文字指令的動作序列。另一個分支做「音訊‑互動感知生成」(Audio‑Interaction Aware Generation Module, AIM),把動作與語音融合成高品質視頻。

Categories: 開源, 騰訊, 數字人, 視頻模型, 影像模型, 影像處理

MoCha 成角色替換

MoCha 是一個專注於視頻角色替換的開源框架,旨在只需要單一參考即可完成角色替換,且不依賴任何結構化指導(如骨骼、深度圖或逐幀分割)。傳統的重建式方法往往必須提供完整的逐幀遮罩與額外的結構資訊,面對遮擋、複雜姿態或多角色互動時容易產生視覺雜訊與時間不穩定,而 MoCha 的設計則把這些限制全部排除,取而代之的是把不同條件統一為單一的 token 流,並通過條件感知的 RoPE(Rotary Positional Embedding)結合多參考圖像,支撐可變長度的影片生成。

MoCha 是一個專注於視頻角色替換的開源框架,旨在只需要單一參考即可完成角色替換,且不依賴任何結構化指導(如骨骼、深度圖或逐幀分割)。傳統的重建式方法往往必須提供完整的逐幀遮罩與額外的結構資訊,面對遮擋、複雜姿態或多角色互動時容易產生視覺雜訊與時間不穩定,而 MoCha 的設計則把這些限制全部排除,取而代之的是把不同條件統一為單一的 token 流,並通過條件感知的 RoPE(Rotary Positional Embedding)結合多參考圖像,支撐可變長度的影片生成。

Categories: 開源, 數字人, 視頻模型

DreamID-V 開源換臉

DreamID-V 是一個專門為高保真度臉部交換設計的技術,它旨在縮短圖像到視頻之間的差距。這技術在處理各種挑戰性場景時表現出色,包括頭髮遮擋、複雜光照、多樣化的種族和顯著的臉型變化。DreamID-V 的應用範圍廣泛,可以應用於娛樂、廣告和電影製作等領域,考慮到了實際應用中的多種需求和挑戰。提供更加逼真的臉部交換效果。 對於使用者來說,DreamID-V 提供了單 GPU 和多 GPU 推理的選項,並且有詳細的安裝和使用指南。使用者需要準備好相應的模型文件和依賴庫,然後根據提供的腳本進行操作。此外,DreamID-V 還支持不同的模型版本,例如 DreamID-V-Wan-1.3B-DWPose,這進一步提升了姿態檢測的穩定性和魯棒性。

DreamID-V 是一個專門為高保真度臉部交換設計的技術,它旨在縮短圖像到視頻之間的差距。這技術在處理各種挑戰性場景時表現出色,包括頭髮遮擋、複雜光照、多樣化的種族和顯著的臉型變化。DreamID-V 的應用範圍廣泛,可以應用於娛樂、廣告和電影製作等領域,考慮到了實際應用中的多種需求和挑戰。提供更加逼真的臉部交換效果。

對於使用者來說,DreamID-V 提供了單 GPU 和多 GPU 推理的選項,並且有詳細的安裝和使用指南。使用者需要準備好相應的模型文件和依賴庫,然後根據提供的腳本進行操作。此外,DreamID-V 還支持不同的模型版本,例如 DreamID-V-Wan-1.3B-DWPose,這進一步提升了姿態檢測的穩定性和魯棒性。

Categories: 開源, 字節跳動, 數字人, 視頻模型

PersonaLive 安裝教學 (12G VRAM)

影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。

影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。

用 AI 即時變身女神|免費
Categories: 開源, 數字人, 影像模型, 影像處理, Python

輕鬆製作超逼真 AI 說話頭像影片

InfiniteTalk 完全免費、支援長影片,唇同步自然但需調參避免誇張;HeyGen 更親民但付費,兩者差異不大,InfiniteTalk 性價比高。 適合 IT 顧問用於快速製作教程或演示影片,節省攝影成本。

InfiniteTalk 完全免費、支援長影片,唇同步自然但需調參避免誇張;HeyGen 更親民但付費,兩者差異不大,InfiniteTalk 性價比高。 適合 IT 顧問用於快速製作教程或演示影片,節省攝影成本。

Create Realistic AI AVATARS That Look And Talk EXACTLY Like You! | FREE ComfyUI Tutorial
Categories: ComfyUI, AI productions, 數字人, 影像處理, Python

Page 3 of 5
1 2 3 4 5