RVC WebUI:低門檻變聲框架的實用與代價

這個語音音色轉換框架把訓練、推理和即時變聲放進同一個網頁介面,重點是讓少量語音資料也能做出可用效果。它的強項在於速度、易用性和模型融合,代價是硬件與延遲條件仍會影響體驗。

Repository image for RVC-Project/Retrieval-based-Voice-Conversion-WebUI

RVC(Retrieval-based Voice Conversion)WebUI 把語音音色轉換、變聲推理和即時變聲收進同一套 Web 介面,適合要快速做 AI 歌聲、配音修音或聲音風格替換的人。它不是單純展示效果,而是把訓練、檢測、推理和即時輸出串成一條可操作流程,降低了進入門檻。

這個項目主打少量資料也能訓練出可用模型,官方建議至少準備 10 分鐘低底噪語音。它採用 top1 檢索去替換輸入特徵,減少音色洩漏,並用 InterSpeech2023-RMVPE 做人聲基頻提取,處理哑音問題時速度快、資源占用也較小。

支援 Python 3.12 x64;Ubuntu 24.04、Windows 與 Linux 都有對應路徑,A 卡和 I 卡則走 CPU 依賴方案,Windows 亦可用 DirectML。即時變聲延遲官方標示可達端到端 170ms,配合 ASIO 輸入輸出設備時可進一步降到 90ms,但對硬件驅動支援要求較高。

  • 可用少量語音資料訓練,門檻比傳統聲音模型低
  • WebUI 同時覆蓋訓練、推理與即時變聲
  • ckpt-merge 允許用模型融合去調整音色
  • 可接入 pymss/MSST 分離人聲與伴奏
  • 更適合配音、歌聲轉換、直播變聲與聲音原型測試

GitHub

Categories: 開源, 數字人, 模型, Linux, Python, 語音, 中國

LeapTalk:1 步生成會話數字人

講人像相片同語音,就能連續生成對嘴影片。LeapTalk把速度拉到接近即時,同時盡量守住人臉一致性。

teaser

想做會話數字人?卡位通常唔係能否生成,而係夠唔夠快、個樣會唔會愈播愈走樣。LeapTalk屬於開源 talking-head generation 項目,針對的正是即時串流、人臉一致性同嘴型同步三件事一齊要兼顧的難題。

它的吸引力在於每個影片片段只用 1 NFE 就可推進,在 Lite 設定下標示可達 200 FPS,而且 Web Demo 已經做成可載入人像圖、用文字或咪高峰對話的介面。底層並非單靠硬推速度,而是建基於 SoulX-FlashHead-1_3B,再配合 LoRA、audio_proj_step_*.pt、wav2vec2-base-960h,用 audio-driven classifier-free guidance 強化對嘴。

  • 以 chunk-by-chunk streaming pipeline 連續生成長片
  • 用 Brownian bridge 同 Bridge Forcing 減少長片身份漂移
  • README 已交代需另外下載 base model、語音模型與 LeapTalk 權重
  • 推論前要自行填入 COND_IMAGE、AUDIO_PATH 等本地路徑

同類做法常見取捨是速度快但畫面累積誤差,或畫質穩定但延遲高;LeapTalk明顯站在「先把延遲壓到可互動」這一邊,再用 reference-anchored data-to-data transport 補回穩定度。

現適合做數字人互動、虛擬主播、即時內容生成的團隊。200 FPS 與單張 H200 GPU 的說法來自項目提供資訊,普通硬件能否複製同樣效果、Web Demo 的完整部署細節是否齊備,仍要等更多實測佐證。

項目主頁 · GitHub

Categories: 開源, AI productions, 數字人, 視頻模型, 影像處理, Audio

SwanTale 以場景佈局生成

SwanTale 把語音與音訊研究集中成一個入口,重點放在更有表達力的生成能力。

swan logo

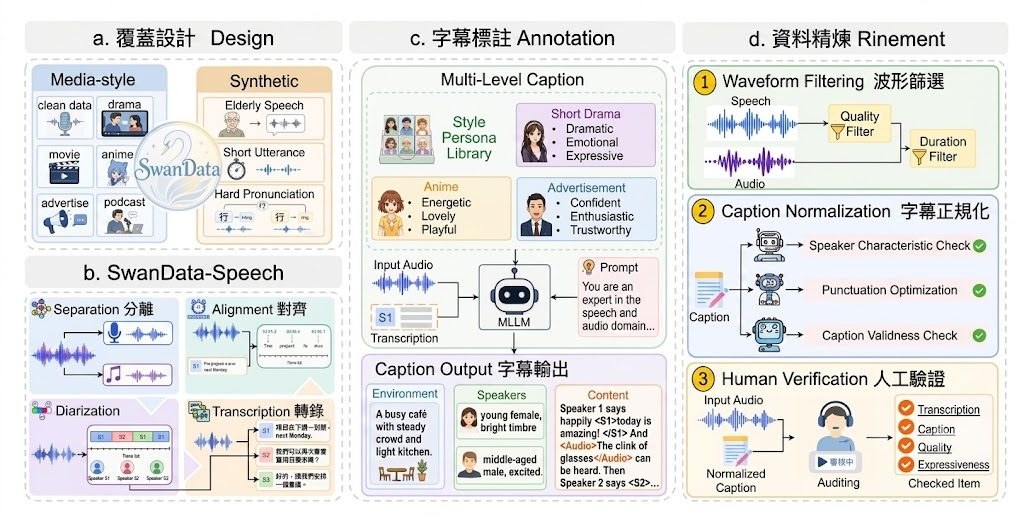
比起只追求把字讀出來,字節跳動的 SwanTale 更著重聲音是否自然、有情緒,亦能否處理多人說話生成。這個由 ByteDance 推出的研究項目,焦點放在 expressive audio、speech 與 multi-speaker generation。

現有資料不算多,但已見到它不是單一模型頁,而是一個集合式研究入口,整合 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere 等子項目。對做語音產品、數字人、配音內容與語音互動工作流的人來說,這類整理方式較易追蹤同一研究線的進展。

  • 聚焦 expressive audio、speech 與 multi-speaker generation
  • 由 ByteDance 發佈,定位偏研究整合入口
  • 站內列出 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere
  • 目前公開資訊有限,性能與方法細節仍要逐個子項目再看

它的價值在於把聲音生成從「可用」推向「更像真人表達」,同時覆蓋多人語音場景。現階段較適合先把它視為字節跳動音訊與語音研究的總覽入口,而不是已完整公開規格的單一產品頁面。

項目主頁

Categories: 字節跳動, 數字人, Audio, 語音

Latent-Identity Tuning 人像身份細緻微調

人像生成最怕改少少就變成另一個人。Latent-Identity Tuning 嘗試把臉部特徵拆得更細,令同一身份可在不同提示詞下保持一致。

teaser site

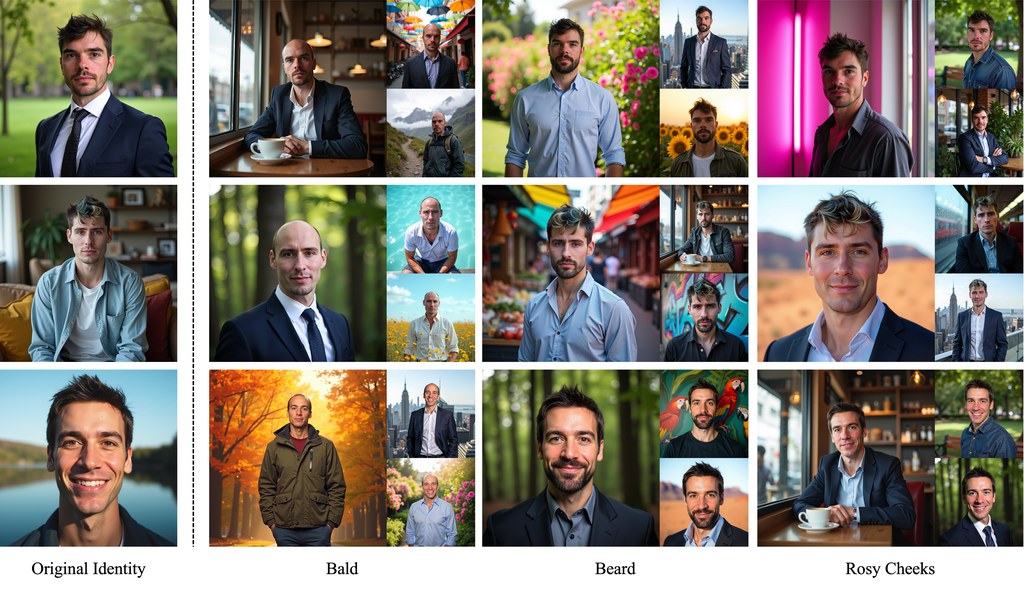
想修改鼻形、加鬍鬚或雀斑,同時又保留同一個人的辨識度,對 text-to-image (T2I) 個人化生成來說一直很難。Latent-Identity Tuning in Text-to-Image Personalization Models 聚焦在這個卡位:不只是改一張圖,而是調整某個人的身份表示,之後可在不同場景中生成同一個經過微調的人。

做法上,輸入人像會先經由預訓練 personalization encoder 轉成一組 identity tokens。研究發現,不同 token 會偏向捕捉眼、鼻、口、頭髮等不同區域或語義特徵,因此可以在這個 identity space 入面尋找有意思的方向,例如鬍鬚、捲髮或其他面部屬性,再沿着方向調整。

  • 直接微調 identity tokens,而不是只在單張圖片上修圖
  • 可做局部、細緻,而且語義較一致的人臉改動
  • 修改後的身份可配合不同 prompts 生成新圖
  • 透過 attention maps 觀察 token 與臉部區域的關係
  • 使用定性與定量實驗檢查局部編輯及跨圖身份一致性

和常見 image editing 相比,這個方法的差異在於它處理的是「身份的潛在表示」。換言之,改動不是鎖死在原圖姿勢、背景或光線,而是把編輯後的身份交給 T2I 模型,在新場景、新描述下仍盡量維持同一個人。

這類方法會較適合需要穩定角色形象的創作者、視覺設計工作流,以及研究人像個人化生成的人。限制上,資料未交代可直接使用的產品化介面或完整模型名單;引用模型方面,內容只提到預訓練 personalization encoder 與 text-to-image model,未列明具體基礎模型名稱。

項目主頁 · Paper

Categories: 數字人, Image, txt2img, 框架

Vidu S1 把即時互動影片拉近一步

對住數碼角色直接開聲指揮,畫面仲可以一路生成一路改,Vidu S1瞄準的正是這種近乎通話式的影片互動。它未必是最通用的影片模型,但在即時控制這件事上明顯有自己路線。

Vidu S1 Experience Preview

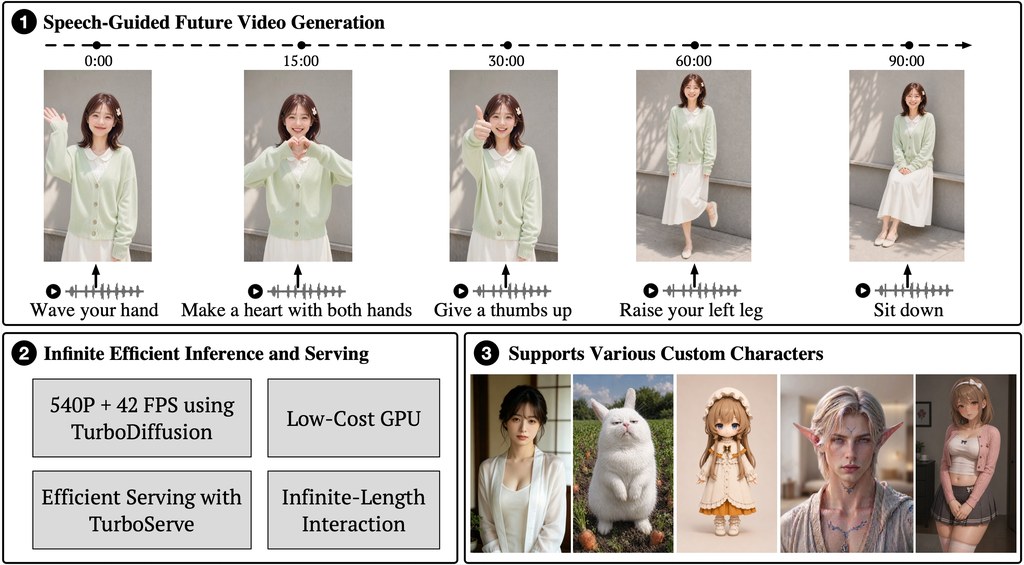
比起先寫好提示詞再等片段輸出,Vidu S1更接近一種可對話的視頻模型:你一邊講,數碼角色一邊跟住反應,處理的是「影片生成能否即時被人打斷、改向、持續延長」這個卡位。項目把重心放在 voice-controlled digital characters,而不是一次過產出完整短片,定位很清楚是互動內容而非傳統文生影片。

現有做法多數仍是 prompt-driven、片段式生成,用戶先提交指令,再等待固定長度輸出;作者主張這種範式難以支援 live interaction。Vidu S1改用 real-time speech control 與 infinite-length real-time interactive generation,讓角色在生成途中持續接受 spoken instructions,方向上更接近直播角色、虛擬主播和即時陪伴互動,而不是 cinematic clip 製作。

  • 支援以語音即時控制角色動作,重點在連續互動而非單次出片
  • 可自訂角色形象與 voice tones,涵蓋真人、二次元、寵物等 avatar
  • 官方資料提到 540p、最高 42 FPS,並可在 consumer GPUs 運行
  • 除了網頁體驗,也提供 API 文件,較適合接入互動產品流程

現有公開資訊較偏向服務化體驗:可先在 Vidu Stream 網頁建立角色、選擇或 clone 聲線,再開啟麥克風與鏡頭進行 live call;團隊要接入自家產品,則更可能經 API 而非直接本地完整重建。GitHub 儲存庫目前公開了論文、說明文件與入口,但未見完整本地訓練或推理流程,較像展示能力與提供接入方式的研究/產品型開源項目。

取捨也很明顯:它強調流暢、低延遲、可長時間互動,代表優先次序未必是最高解析度或最複雜鏡頭語言。受益最大的會是做虛擬主播、互動陪伴、角色扮演、品牌數字人和即時內容演示的團隊;要做電影感分鏡、長敘事剪輯或高度後期控制,現階段未必是它最強的一面。相關模型則包括 Vidu S1 本身,以及同一服務脈絡下的 Vidu Stream 互動入口。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 數字人, 視覺模型, 多模態模型, 視頻模型, API, Clone, 語音, Dataset 數據集

UnityShots:多鏡頭影音生成的記憶驅動新方案

由快手 Kling Team(快手) 與學界合作推出,UnityShots 把單鏡頭擴散模型改造成可保持人物、場景與聲音一致的多鏡頭敘事系統,並釋出 200 段基準測試集。

UnityShots Logo

UnityShots 是一個研究性質的多鏡頭影音生成框架,核心任務是解決現有方法在長序列多鏡頭影片中難以維持人物、場景與聲音一致性的問題。它基於已有的單鏡頭影音擴散模型 LTX-2.3(22B 參數)建構,從一段結構化提示詞直接生成 3 至 9 個鏡頭的連續 .mp4 影片,確保角色容貌、場景光影與配音語音在各鏡頭間保持連貫。

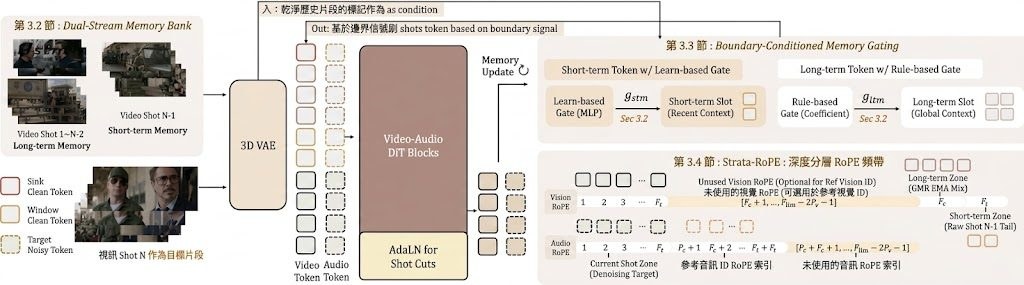
現有做法通常依賴三種路線:端到端訓練固定長度序列但難以擴展、以記憶庫逐鏡頭生成但容量隨鏡頭數線性膨脹,或用大型語言模型規劃器調度預訓練生成器而缺乏多鏡頭感知骨幹。UnityShots 的切入點是引入邊界感知門控(Boundary-Aware Gating)與雙槽記憶機制:影片流維持兩個固定大小記憶槽,長期記憶(LTM)錨定開場鏡頭,短期記憶(STM)保留前一鏡頭尾部,兩者在每次剪接時由門控網路更新;音訊流則在每個鏡頭注入參考說話者 token,避免滑動音訊庫的負擔。另一個辨識度高的設計是透過 AdaLN 學習離散剪接類型先驗(cut-type prior),讓使用者可在推論階段調整轉場強度。

以下為重點摘要:

  • 類型:多鏡頭影音生成研究框架,附帶資料集與基準測試。
  • 核心差異:用固定大小雙記憶槽取代線性增長的記憶庫,並加入參考語者 token 維持聲音一致性。
  • 控制能力:剪接類型先驗成為推論時可調旋鈕,使用者可指定轉場強弱。
  • 相關模型:以 LTX-2.3 22B 為基座,整合 AdaLN 門控機制。
  • 資料集:釋出 UnityShotsBench,涵蓋六大文化區域、13 種語言的 200 段多鏡頭序列。

現有評估涵蓋 I2V、T2V、R2V 三種條件模式,UnityShots 在跨鏡頭一致性與音畫品質上與開源及閉源基準相當。對從事多鏡頭敘事、短影音自動化或數位人內容生成的團隊而言,這套框架提供了較完整的記憶與控制設計思路。原始資料庫明確指出,檢查點、訓練程式碼與代理系統尚未釋出,因此目前無法從儲存庫直接取得安裝指令或模型權重;讀者若有興趣部署,需等待官方後續發布。資料集本身可從 Hugging Face 的 KlingTeam/UnityShotsBench 下載,供研究者評測自家模型。授權為 CC BY-NC 4.0,僅限非商業學術用途。

GitHub: https://github.com/JIA-Lab-research/UnityShots

項目主頁: https://jackailab.github.io/Projects/UnityShots/

Paper: https://arxiv.org/pdf/2606.21661

Categories: 開源, 香港中文大學, 香港科技大學, 清華大學, 字節跳動, 數字人, 模型, 視頻模型, Video, 提示詞, 框架, 香港, 庫, 語音, LTX

TryOnCrafter:首個鏡頭可控的影片虛擬試穿框架

TryOnCrafter 是首個支援鏡頭軌跡控制的影片虛擬試穿框架,以 4D 代理模型分離人物與背景,實現任意視角的試穿效果。

TryOnCrafter teaser

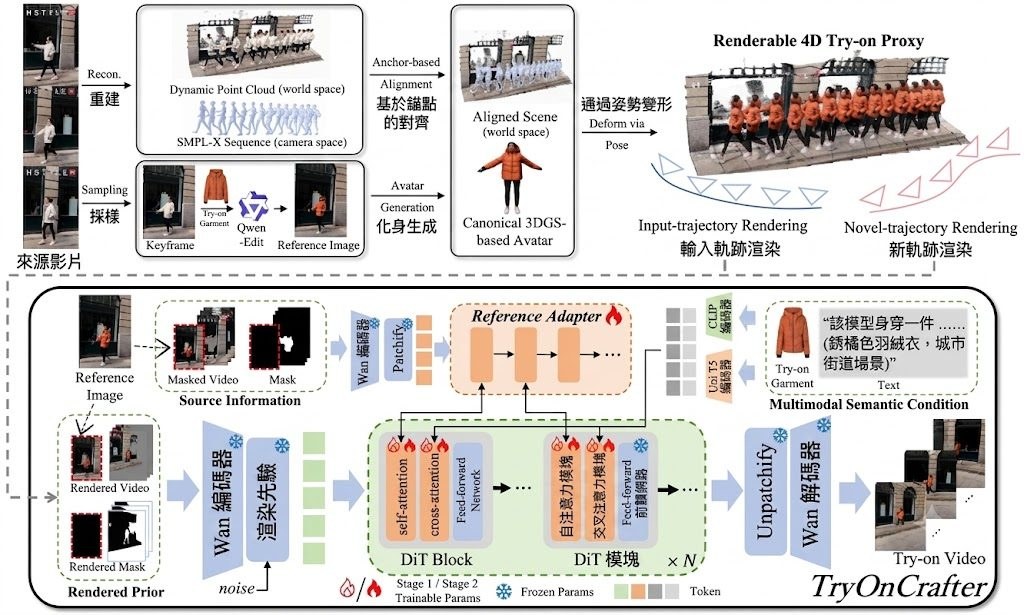
TryOnCrafter 是一個基於 DiT(Diffusion Transformer)的虛擬試穿影片框架,專門處理「鏡頭可控影片虛擬試穿」(Camera-controllable Video Virtual Try-on, CaM-VVT)這個新任務。它的主要用途是讓使用者能夠在指定鏡頭軌跡(例如推近、傾斜、環繞)的情況下,生成穿著指定服裝的人物影片。

傳統的影片虛擬試穿只能沿著原始影片的鏡頭路徑生成結果,無法讓使用者自由改變視角。TryOnCrafter 的做法是引入一個「可渲染的 4D 試穿代理」(Renderable 4D Try-on Proxy),先把 2D 試穿結果提煉成一個基於 3D Gaussian Splatting(3DGS)的穿衣化身,再用 SMPL-X 序列驅動動作,最後把這個化身對齊到重建的背景點雲中。這個代理模型把人物與環境分離開來,提供穩定的幾何骨架,讓後續的影片生成能夠在任意鏡頭下保持結構一致。

在生成階段,框架採用 Proxy-Anchored Video DiT,把代理模型渲染出來的多層資訊(包括渲染先驗、參考特徵、服裝語意提示)作為幾何錨點,確保最終影片在指定軌跡下保持物理合理的形變與外觀。這種設計同時支援多項延伸應用,包括人物重新定位、子彈時間效果,以及 360 度環繞檢視。

團隊建立了 CaM-VVTBench 評測基準,結果顯示 TryOnCrafter 在結構一致性與服裝身份保留方面,明顯優於現有方法。這個框架較適合需要展示服裝 3D 效果的研究團隊、電商內容製作,以及對鏡頭語言有要求的多媒體創作場景。

重點摘要

  • 首個鏡頭可控試穿框架:突破傳統 VVT 只能被動沿用原片鏡頭的限制,支援使用者自訂鏡頭軌跡。
  • 4D 試穿代理模型:以 3DGS 化身 + SMPL-X 動作序列,把人物與背景解耦,提供密集幾何引導。
  • Proxy-Anchored Video DiT:以代理渲染結果作為幾何錨點,確保任意視角下的結構與服裝一致性。
  • 多元延伸應用:支援人物重定位、子彈時間、360 度環繞等下游編輯。
  • 新基準 CaM-VVTBench:團隊建立的專用評測集,在結構一致性與服裝身份保留上明顯領先既有方法。

模型與源碼說明:原始資料為項目主頁,未提供具體的源碼下載連結、安裝步驟或模型權重取得方式。

項目主頁: https://sunhao242.github.io/TryOnCrafter_web.github.io/

Paper: https://arxiv.org/pdf/2606.26092

Categories: 開源, 阿里巴巴, AI productions, RAG, 數字人, 模型, 視覺模型, 視頻模型, Video, 影像模型, 影像處理, 框架

Wan Streamer:即時生成影音互動模型

阿里推出的 Wan Streamer v0.1,以單一 Transformer 同時處理聽、說、看、生成,實現亞秒級全雙工音視頻互動。

Wan Streamer framework

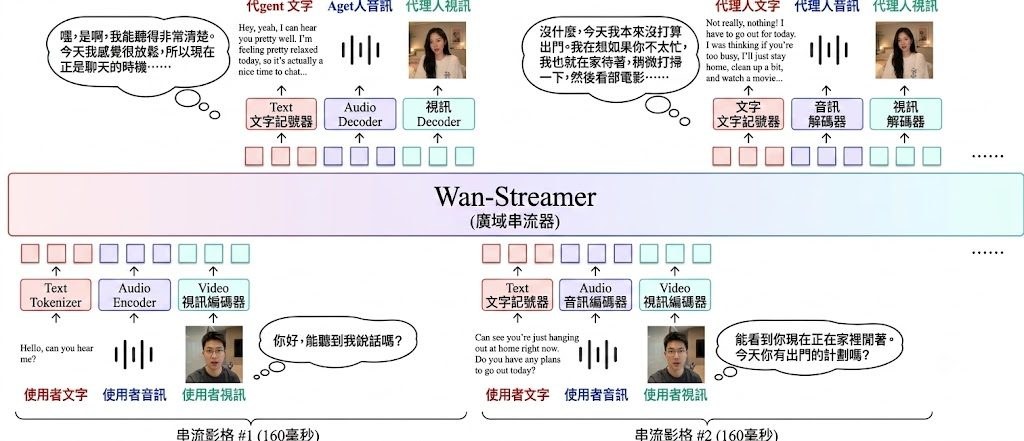
Wan Streamer v0.1 是一款由阿里巴巴(通義萬相/Wan 團隊)開發的原生流式端到端基礎模型,專為即時、低延遲、全雙工的音視頻互動而設計。它把語言、音訊、影像同時作為輸入與輸出,全部整合在單一 Transformer 之中,並以 block-causal attention 協調增量式生成。

現有即時互動系統普遍存在的延遲與不同步難題。純語音方案雖然回應快,但沒有可見的影像輸出;音視頻方案則多由 ASR、語言模型、TTS、動畫模組拼接而成,每個邊界都會疊加延遲,而且很少有系統公開端到端時延數字。Wan Streamer 把整個流程重新設計為可流式架構,包括因果編解碼器、block-causal attention、低延遲多模態 token 排程,在 25 fps 下最短流式單元可達 160 毫秒。

與常見做法的最大差異在於「端到端」與「同步影音輸出」。模型側延遲約 200 毫秒,加入 350 毫秒雙向網絡延遲後,總互動延遲約 550 毫秒,可支援亞秒級全雙工通訊。同時輸出語音與影片內容,而非分別由不同模組拼接,這是它最值得留意的特點。模型覆蓋聽、看、思考、說話、生成影像回應五種能力,適用於需要即時數字人、互動助理、虛擬陪伴等低延遲場景。

重點摘要:

  • 由阿里 Wan/通義萬相團隊研發,定位為即時互動基礎模型
  • 單一 Transformer 同時處理語音、影像、文字輸入與輸出
  • 模型側延遲約 200 毫秒,總互動延遲約 550 毫秒
  • 支援 25 fps 串流,最短流式單元 160 毫秒
  • 與拼接式方案相比,延遲更低且影音輸出真正同步

項目主頁: https://wan-streamer.com/

Categories: 阿里巴巴, Agentic, 數字人, 模型, 多模態模型, 視頻模型, 語音

SpatialAvatar-0:人像重建高質 4D 頭像

用一張或少量人像,重建可動態呈現的4D頭像。這個項目同時兼顧跨場景泛化與快速個人微調。

SpatialReal

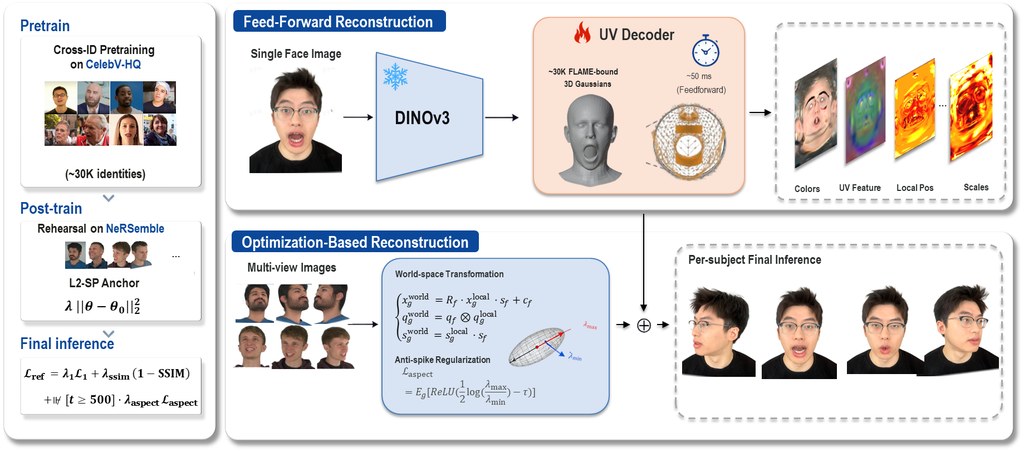
SpatialAvatar-0 針對的是 4D head avatar 重建:只靠一張或少量 source portraits,就生成可配合時間變化的頭像表示,適合 telepresence、AR/VR 同 digital-human interaction。它採用 FLAME-mesh-bound Gaussian 表示,核心是把 feed-forward generator 同 per-subject refinement 放入同一套結構,減少以往兩類方法各自為政的問題。

常見做法通常分成兩路:一類是可直接預測的模型,速度快,但容易受訓練數據領域限制;另一類是按單一人物慢慢微調,質素高但迭代很長,還會因 adaptive densification 打亂原本 Gaussian 佈局。SpatialAvatar-0 的差異,在於加入 parameter-free K-source mean-pool,支援可變數量輸入,並用 monocular-temporal 到 multi-view-spatial 的兩階段訓練,嘗試減少 identity-prior collapse。

微調部分也有明顯取向:它不是走 300K 至 600K iterations 的長流程,而是保留佈局的 10K-iter refinement loop,凍結 FLAME 綁定與 Gaussian 數量,再以 three-component anti-spike regularization 取代 densification。對想保留上游表示、又想做人物級細修的工作流,這種設計會較容易接軌。

已公開資料顯示,它在 VFHQ、HDTF 的 cross-domain zero-shot 測試中,PSNR 比 GAGAvatar 高 1.5 dB,而且模型未有在這兩個測試領域訓練;在 SplattingAvatar monocular benchmark,亦全面領先已報告指標,較 300K-iter 的 GeoAvatar 高 1.3 dB PSNR,同時把單人物微調流程縮短至最多 60 倍。數字反映它著重的是泛化能力與重建效率的平衡,但具體效果仍要視輸入人像質素與場景條件而定。

  • 支援一張或多張人像輸入,重建高質 4D 頭像
  • 統一 feed-forward generator 與 per-subject refinement 的表示方式
  • 10K-iter 微調流程,比常見長迭代方法短得多
  • 在 VFHQ、HDTF、SplattingAvatar 基準上有明確成績提升

頁面暫未提供 Code 與 🤗 Model 入口。對 3D Gaussian Splatting(3DGS)、數字人、AR/VR 內容製作有興趣的讀者,可以先從示範效果理解它的輸出風格,再留意它如何處理少樣本輸入與跨資料域表現。文中引用模型包括 GAGAvatar、GeoAvatar。

項目主頁: https://spatialwalk.github.io/SpatialAvatar-0/

Paper: https://arxiv.org/pdf/2606.15659

Categories: 開源, 數字人, 模型, 視覺模型, Image, 3D

OmniDirector:免配對數據的多鏡頭運鏡克隆技術

OmniDirector 透過「相機網格」表示法,從多鏡頭影片中克隆運鏡動作,驅動靜態圖像生成動態影片,無需交叉配對數據訓練。

Play video

OmniDirector 由清華大學(Yu-Shen Liu 為北京清華大學團隊)與 Kling Team(快手科技)的研究團隊,共同開發,成員包括 Jiwen Liu、Shujuan Li、Zhixue Fang 等人,團隊來自多個機構,橫跨學術界與業界。研究團隊提出一種無需交叉配對數據的通用多鏡頭相機克隆方法,解決從參考影片中複製運鏡來驅動靜態圖像的難題。

傳統相機控制方法往往依賴大量成對數據進行訓練,而 OmniDirector 的核心創新在於提出「相機網格」(camera grid)表示法。將參考影片的相機姿態渲染為三維空間中的運動軌跡,形成統一的網格表示。配合階層式提示詞擴展代理(hierarchical prompt expansion agent),把多模態控制信號整合成協調的指令。

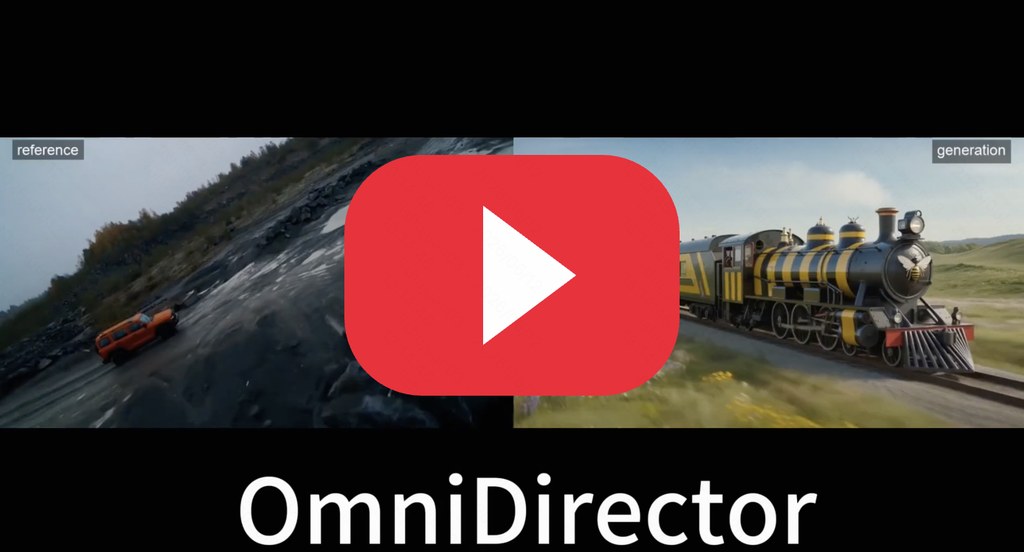
使用時,使用者只需提供一張源圖像和一段參考影片,OmniDirector 便能克隆其中的運鏡動作,生成動態影片。多鏡頭場景下,新方法支援鏡頭之間的連貫過渡與一致的內容呈現,保持原始的視覺語言。特殊運鏡方面,涵蓋希區柯克式變焦、子彈時間與鏡頭畸變效果,適用的場景類型包括人像、動物、建築及 AIGC 內容等。

OmniDirector: General Multi-Shot Camera Cloning without Cross-Paired Data

OmniDirector 適合從事影片創作、動畫製作或需要快速生成動態素材的內容創作者,以及研究相機控制技術的開發者。經過與其他頂尖相機控制方法的對比,新方法在控制穩定性與物件形變方面表現出色。

重點摘要:
– 核心創新為「相機網格」表示法,免依賴交叉配對數據
– 支援極端運鏡、多鏡頭連貫過渡與特殊相機效果
– 場景泛化能力強,涵蓋人像、動物、建築及 AIGC 內容
– 開源提供論文與程式碼,方便研究與應用

目前 github.com/lisj575/OmniDirector 這個倉庫是空的,沒有 source code 或 model 。

項目: https://ymlinfeng.github.io/OmniDirector.github.io/

Categories: 北京大學, 清華大學, AI productions, 數字人, 模型, 視覺模型, Video, 框架

Page 2 of 6
1 2 3 4 … 6