ComfyUI-DLSS5-Enhancer:強化影片材質細節

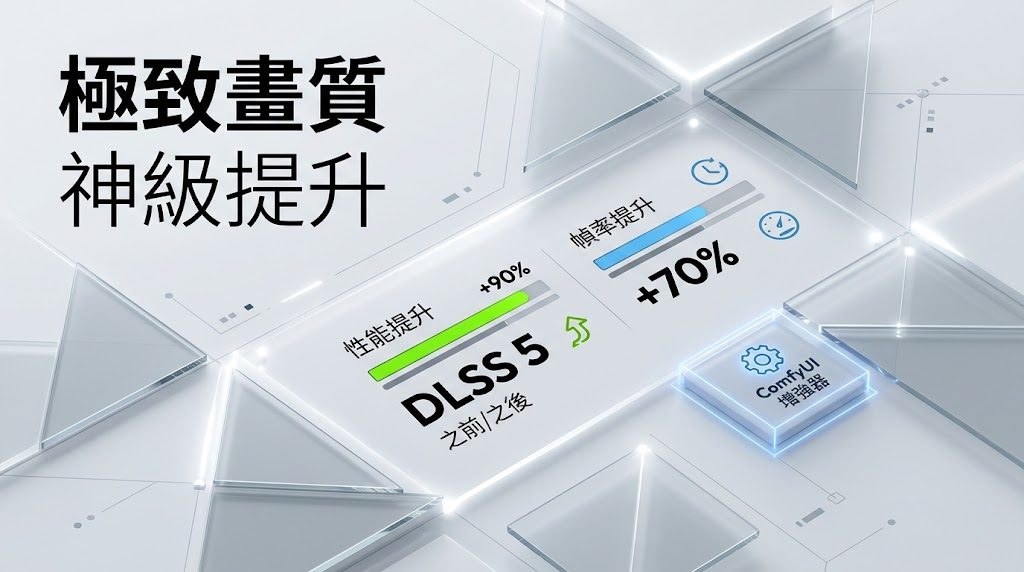
呢個 ComfyUI 節點包直接調用原生 D3D12 渲染管線,把遊戲級嘅 DLSS 5 Neural Rendering 套到影片幀上面,重建皮膚、頭髮同布料嘅材質反應,而不只是銳化。

Repository image for Blueforcer/ComfyUI-DLSS5-Enhancer

一般後製銳化或 AI upscale 工具處理嘅多數係邊緣同紋理,皮膚嘅次表面散射、頭髮嘅光線穿透呢類材質反應好難靠濾鏡模擬。Blueforcer/ComfyUI-DLSS5-Enhancer 選擇咗另一條路:將 ComfyUI 內部嘅 RGBA8 幀傳去一個原生 D3D12 worker,由 ReShade 載體配合 RenoDX DLSS 5 add-on 觸發 NGX feature 18,重建完再送返 ComfyUI,仲支援 1.5x 到 3x 升頻。影片本身冇 motion vectors,佢哋用 OpenCV DIS 做稠密光流逐幀估算,並喺場景切換時自動重置 history,等渲染器唔會將錯誤嘅時序資料傳入去。

呢個項目嘅類型係工具 / 節點包,定位好明確:畀 ComfyUI 用戶喺影像同影片工作流直接用 DLSS 5 嘅神經渲染器。佢唔係一個自帶模型嘅外掛,神經組件係 NVIDIA、ReShade、RenoDX 嘅原生 binary,呢個 repo 只負責實作 client side 嘅二進制協議,包括 session 建立、解像度協商、幀序、取消同診斷。

NVIDIA DLSS 5 In ComfyUI Changes EVERYTHING! Full Setup Guide

硬件要求 NVIDIA RTX 50 系列原生支援,透過社區 runtime 可以喺 RTX 40 同 30 上面跑,RTX 20 或更早直接拒絕。ComfyUI 需要 V3 node API(comfy_api.latest),Python 依賴 numpy、av 同 OpenCV,ComfyUI portable 通常已經內建。

幾個重要限制:nr intensity 鎖死喺 1.0,1.0、1.5、2.0 嘅輸出 bit identical;skin structure strength 必須開啟 automatic mask 先有效,閂咗之後所有皮膚參數都唔再產生變化;nr preset 喺任何數值下都係 bit identical。只有 local structure strength 同 local tone strength 係全程範圍真正可調。預設、J、K 幾個 dlss model preset 嘅源幀 detail energy 大約喺 0.56x 左右,呢個唔係銳化工具想要嘅走向,反映嘅係材質重建比邊緣強化重要嘅設計取向。

適合已經用 ComfyUI 做影片後製、CG 合成、AI 動畫修復或者數字人相關工作嘅團隊同個人創作,尤其係想處理 skin、hair、fabric 呢類容易被傳統濾鏡抹平嘅材質細節嘅場景。留意到嘅限制係 GPU 受限於 NVIDIA,而且沒有 Python API,調用方式只能透過 ComfyUI 節點流程。
GitHub

Categories: 開源, ComfyUI, AI productions, 數字人, NVIDIA, API, Video, Image, 工具, 3D, Python, 動畫

ComfyUI-MiniMaxH3-TimelineDirector:一張圖跑出無斷點長影片

想在 ComfyUI 內一次過生成超過一分鐘的影片,又要角色口型與背景音樂全程對得齊?這套 MiniMax H3 Timeline Director 插件把分段、續接、漂移修正全部收埋喺一張圖。

Creator WeCom contact card

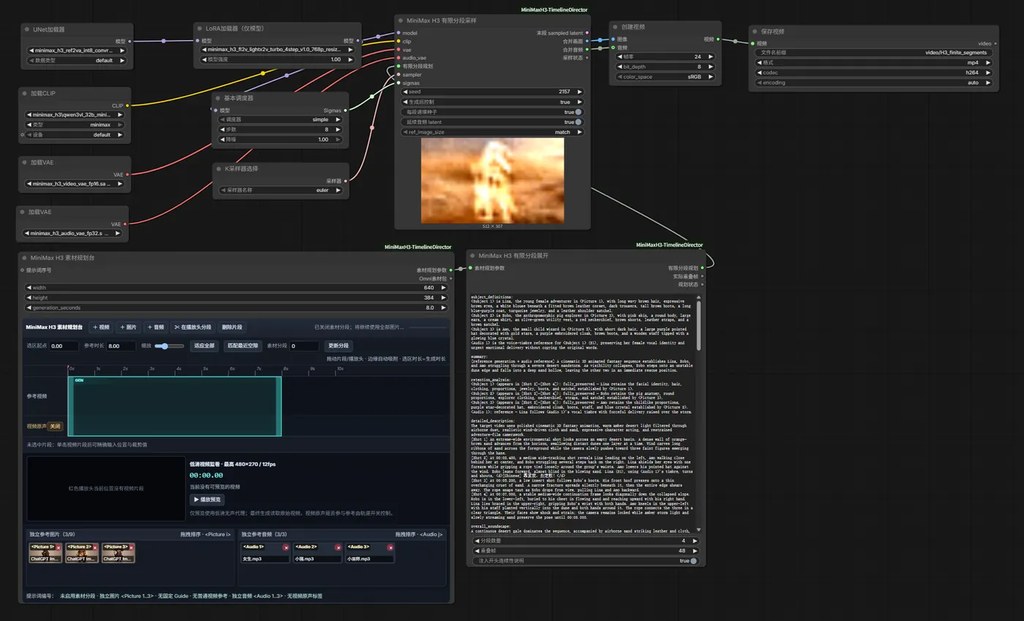
MiniMax H3 官方最令人卻步嘅限制之一,就係單次生成時長偏短,想做一段完整 Demo 或者長 Demo 都要靠 Loop 節點逐段駁,駁完口型同音軌成日走樣。ComfyUI-MiniMaxH3-TimelineDirector 嘅切入點正正喺呢個位:佢提供一個 Full Timeline Director 工作流,把 T2V、Image Reference、音訊驅動、角色替換、動作遷移、數字人同一條龍長片生成,全部塞入同一張 ComfyUI 圖。

插件會把目標時長拆成連續 GEN 窗口,並用同一個共享 seed 串接前一段嘅 AV-latent 尾部,配合 Drift-Control 影片遮罩同 Soft AV 音訊連續性處理,再做 overlap 移除並最終同步輸出成片。長度上限唔再由 Loop 節點或者重複 Sampler 鏈決定,而係睇本地 VRAM、RAM、磁碟空間同 ComfyUI 執行限制。

佢同一般「駁長片」做法最大嘅差異,係對齊音訊嘅方式。當你將一段長 MP3 標記為 Locked Original Audio,插件會將聲音按 sample 位置精確切片,注入每段 AV latent,並以零音訊降噪遮罩保留;Timeline 比音源短就截斷,比音源長就用靜音補尾,用戶唔使再人手對 MP3 metadata 或 codec priming delay。Long-form digital humans 同角色演唱場景亦靠同一條路徑處理:角色圖同長 soundtrack 鎖定後,手動 GEN 窗口即可逐段推出口型同步。

時間軸方面,每段 Clip 設有三種模式——Fixed Guide、Editable Reference、Boundary Only,支援 move、trim、split、delete、snap 同數值定位;只有同 cyan 生成範圍相交嘅媒體先會進入當前 Reference 或 Guide 計劃,避免雜訊干擾。

實際最易受惠嘅人,係要做完整 MV 級 Demo、產品概念片、教學影片、或者 AI 短劇分鏡嘅創作者同中小型團隊。官方已放出兩條約 52.6 秒 / 1263 幀嘅直接生成示範,包括純 latent 續接同 48 幀 Reference overlap 兩個 case,可直接喺 GitHub Release 拎 MP4 對照效果。

  • 類型:ComfyUI 插件 / 時間軸導演工具
  • 核心能力:一張圖內分段續接生成無斷點長影片,音訊 sample-sliced 注入 AV latent
  • 同類差異:唔靠通用 Loop 節點或重複 Sampler 鏈,直接由 AV-latent 尾部續接
  • 適用場景:長片數字人、角色演唱、概念片、教學影片等需要連貫長片嘅創作
  • 部署方式:經 ComfyUI Manager 或手動放入 custom_nodes 目錄後啟動 ComfyUI,載入 example_workflows 內嘅 All-in-One 工作流即可

項目主頁 · GitHub

Categories: 開源, ComfyUI, AI productions, 數字人, Video, Image, Audio, 教學, 工具, Content Creator, 音樂, MiniMax

4DAnyone 把單鏡頭影片重建 4D 多視角

由一段普通單鏡頭人物影片開始,4DAnyone 生成具一致性的多視角影片,再交由 4DGS 重建可動人物。

4DAnyone

由未校準的 monocular video 出發,4DAnyone 可以為同一個人物生成多個目標視角,接着交給 4D Gaussian Splatting(4DGS)建立可渲染的 4D 人物。這個 GitHub 項目屬於 4D 人物重建工具,處理的是拍攝時沒有多部相機、相機內參或姿態資料,卻想取得多視角動態素材的問題。

它不只把畫面轉成另一個角度,而是嘗試維持不同視角之間的時間和外觀一致性,讓後續 4DGS 重建不必直接面對單鏡頭資料的視角缺口。相較於需要 rig、校準相機或固定三腳架的流程,這個方法換來的是對輸入影片質素和人物動作的依賴。

使用 inference.py 讀取影片,再以 views_per_layerlayer_pitchesstart_yawyaw_span 控制相機層數、上下角度及水平覆蓋範圍。儲存庫提供 Python 3.11、requirements 和第三方 GVHMR 元件的安裝安排,缺少的模型及例子會在首次使用時自動取得;原始資料沒有交代硬件需求、推理時間或量化性能,因此不能把速度表現視為已被驗證。

  • 支援全身或上半身、畫面只包含一人的影片
  • 可生成 6、24、48 個或自訂數量的目標視角
  • 兼容輕微鏡頭移動,以及未知相機內參和姿態的素材
  • 可選 FlashAttention-3 或 SageAttention 加快推理

研究展示內容集中於不同人物影片、動作和場景的泛化能力。需要製作 4D 人物、研究自由視角影片,或建立動態人像資料的團隊;只想快速套用濾鏡或要求即時輸出的使用者,仍要先確認硬件、模型取得方式和影片條件是否符合要求。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 數字人, 視頻模型, Video, Python, 語音

Ex-Omni-2D 直接對話生成同步發聲與表情的數字人影片

Ex-Omni-2D 讓對話模型同時輸出文字、個人化語音與表情同步的頭像影片,以多碼本語音單元串接語音與畫面,並提供 Teacher 與 Prefix-Streaming Student 兩種部署模式。

Ex-Omni-2D framework

想讓 AI 數字人不只是「會打字」,而是真的「邊說邊演」?香港中文大學(深圳)與 LIGHTSPEED 合作開源的 Ex-Omni-2D,正是針對這個目標設計。它是一個開源對話框架,接受多模態查詢、參考圖像與參考音訊後,先由語言模型輸出一份結構化的 Visual Thought Plan(VTP),再依此生成文字回應、個人化語音,並產出嘴形與動作同步的頭像影片。

傳統做法通常把語音合成與人物影片視為兩條獨立管線,需要額外對齊文字、聲音與嘴形,容易出現時間錯位。Ex-Omni-2D 的差異在於採用 16 個 codebook 構成的原生多碼本語音單元,作為語音與影片共享的聲學與時序介面:同一組語音單元既驅動 TTS,也作為影片生成器的緊緻條件,從而降低跨模態錯位的風險。

影片生成路徑提供兩種互補模式:Full-sequence Teacher 採雙向注意力,追求最高畫質;Prefix-Streaming Student 則是蒸餾而來的少步數 block-causal 版本,支援 2、4、8 步串流推論,方便在工作站、GPU 伺服器甚至 Hugging Face Spaces 上做漸進式部署。

這個項目的重點:

  • 對話原生影片:視覺行為直接從多模態對話上下文規劃,不必再手動撰寫影片提示詞。
  • 結構化 VTP:明確定義首幀、場景、情緒、動作風格與動作細節,方便後續控制與除錯。
  • 共享語音介面:16 個 codebook 同步驅動語音合成與人物動作。
  • 品質與效率取捨:Teacher 負責最高畫質,Student 支援 2/4/8 步串流。
  • 彈性部署:同一套代碼可在個人工作站、GPU 伺服器或 HF Spaces 執行,並提供線上 Demo 試玩。

在串流場景中,作者指出 Prefix Streaming 從第 9 至 16 chunk 的一致性明顯較強,將 last-to-first consistency error 降低 21.4%,這對需要長時間維持角色身份一致的應用相當關鍵。論文亦提到 Prefix Streaming 能減少長序列累積形變,同時保留參考圖像的人物外觀。

較適合的對象包括需要快速打造可對話 AI 助手、虛擬主播、客服分身或教學數字人的團隊;對研究多模態對話、語音驅動動畫的人來說,這份開源代碼、模型權重與 arXiv 論文也是一個方便的起點。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 騰訊, 文字轉語音, AI productions, 數字人, 多模態模型, 視頻模型, Qwen, 香港, 語音

LTX-2.5 原生多鏡頭、4K HDR,一次看懂升級重點

LTX 最新開源基礎模型 LTX-2.5,主打原生多鏡頭銜接、4K HDR,並降低重試與算力成本,繼續走開放權重路線。

LTX-2.3 Examples Video

如果你是用開源模型做影片生成的開發者,LTX-2.5 這次更新解決的卡位頗明確:人物、環境、光線與聲音在多鏡頭之間斷裂的問題。它把多鏡頭生成變成原生能力,並加入自動時長預測,模型會按指令動作自行決定片段長度,省下人手剪接的麻煩。

對比起多數只能透過後製拼接的同類方案,LTX-2.5 在 prompt 跟隨度上也有明顯進步,能夠處理更複雜的創作指示,而且只需要更短的提示詞就能產生穩定結果。配合新的擴散影片解碼器,動態假影更少,畫面在高解析度與 HDR 下仍能逐格保持質感。

本地部署與微調是這次版本延續的核心承諾:開源權重可直接下載,預訓練基礎模型可在自家做 LoRA 微調,產出與後製則支援原生 RAW workflow,貼近專業調色與剪接流程。

從官方比較表來看,目前維持開放權重且不受地區限制的開源視頻生成選擇仍然有限,這也是 LTX-2.5 在定位上最值得留意的差異化。不過實際表現仍需視本地硬件配置與工作流整合程度而定。

重點摘要

  • 原生多鏡頭生成:人物、環境、光線與聲音在不同鏡頭間保持一致。
  • 自動時長預測:依據動作需要自動決定片段長度。
  • 4K HDR 與原生 RAW:支援專業調色與後製 pipeline。
  • Gemma 4 12B 文字編碼器:搭配自研提示詞增強器,提升 prompt 跟隨度。
  • 開源權重可下載:可在本地硬件運行,並支援 LoRA 微調。

項目主頁

Categories: 開源, AI productions, 數字人, 多模態模型, 視頻模型, 模型訓練, Video, Image, LTX

MiniMax H3 Turbo:4 步加速的影音生成 LoRA

MiniMax H3 的 ComfyUI 加速 LoRA,把 10 秒影片生成壓到固定 4 步。它適合要在速度、畫質和可控性之間取平衡的 T2V 與 I2V 工作流。

Og image

MiniMax H3 Turbo 走的是 ComfyUI 用途的加速路線,核心價值在於把 MiniMax H3 的文本生成影片(Text-to-Video, T2V)和圖像轉影片(Image-to-Video, I2V)流程固定到 4-step Euler 推理。它不是獨立模型,而是要配合 Comfy-Org/MiniMax-H3 的 BF16 base model 使用;頁面未提供更完整的 base model 參數規模或訓練細節,所以不能再往下猜。

這種設計的取捨很直接:步數少,生成時間通常更短,但對動作細節和穩定性的容錯也會更窄。頁面列出的比較都在同一個 BF16 base model、同一輸入與 10 秒、約 0.9MP 解析度條件下做,LoRA strength 固定 1.0;不同場景下,時間大概落在 174 到 190 秒之間,速度提升存在,但不是壓倒性。

重點摘要:
– 支援 T2V 與 I2V,I2V 走第一幀路徑,亦可用最後一幀收尾
– 固定 4-step Euler,重點是縮短推理流程而非擴大模型能力
– 需要配對 Comfy-Org/MiniMax-H3 的 BF16 base model
– 頁面未列出 GGUF、mmproj、上下文長度或量化檔案資訊
– 與 lightx2v LoRA 的比較屬同級加速方案,差距主要體現在時間與輸出取向

從檔案描述看,這個項目是 LoRA,不是完整 diffusion checkpoint,所以它的定位比較像「推理策略補丁」而不是全新模型。頁面也沒有提供 llama.cpp、Ollama 或 LM Studio 的支援資訊,顯示它主要面向 ComfyUI 工作流,而不是通用本地推理框架。

檔案命名上,頁面強調這是 v2 類型的更新版本脈絡;因此可確認的只有它圍繞 H3 的 joint audio-video diffusion path,並以固定 4 步作為加速契約。若要和原始 base model 比,差別不在功能範圍,而在於把生成速度和步數控制收緊,換取更快的工作流回饋。

模型

Categories: 開源, ComfyUI, 數字人, 視覺模型, 視頻模型, Video, Image, Audio, MiniMax

RVC WebUI:低門檻變聲框架的實用與代價

這個語音音色轉換框架把訓練、推理和即時變聲放進同一個網頁介面,重點是讓少量語音資料也能做出可用效果。它的強項在於速度、易用性和模型融合,代價是硬件與延遲條件仍會影響體驗。

Repository image for RVC-Project/Retrieval-based-Voice-Conversion-WebUI

RVC(Retrieval-based Voice Conversion)WebUI 把語音音色轉換、變聲推理和即時變聲收進同一套 Web 介面,適合要快速做 AI 歌聲、配音修音或聲音風格替換的人。它不是單純展示效果,而是把訓練、檢測、推理和即時輸出串成一條可操作流程,降低了進入門檻。

這個項目主打少量資料也能訓練出可用模型,官方建議至少準備 10 分鐘低底噪語音。它採用 top1 檢索去替換輸入特徵,減少音色洩漏,並用 InterSpeech2023-RMVPE 做人聲基頻提取,處理哑音問題時速度快、資源占用也較小。

支援 Python 3.12 x64;Ubuntu 24.04、Windows 與 Linux 都有對應路徑,A 卡和 I 卡則走 CPU 依賴方案,Windows 亦可用 DirectML。即時變聲延遲官方標示可達端到端 170ms,配合 ASIO 輸入輸出設備時可進一步降到 90ms,但對硬件驅動支援要求較高。

  • 可用少量語音資料訓練,門檻比傳統聲音模型低
  • WebUI 同時覆蓋訓練、推理與即時變聲
  • ckpt-merge 允許用模型融合去調整音色
  • 可接入 pymss/MSST 分離人聲與伴奏
  • 更適合配音、歌聲轉換、直播變聲與聲音原型測試

GitHub

Categories: 開源, 數字人, 模型, Linux, Python, 語音, 中國

LeapTalk:1 步生成會話數字人

講人像相片同語音,就能連續生成對嘴影片。LeapTalk把速度拉到接近即時,同時盡量守住人臉一致性。

teaser

想做會話數字人?卡位通常唔係能否生成,而係夠唔夠快、個樣會唔會愈播愈走樣。LeapTalk屬於開源 talking-head generation 項目,針對的正是即時串流、人臉一致性同嘴型同步三件事一齊要兼顧的難題。

它的吸引力在於每個影片片段只用 1 NFE 就可推進,在 Lite 設定下標示可達 200 FPS,而且 Web Demo 已經做成可載入人像圖、用文字或咪高峰對話的介面。底層並非單靠硬推速度,而是建基於 SoulX-FlashHead-1_3B,再配合 LoRAaudio_proj_step_*.ptwav2vec2-base-960h,用 audio-driven classifier-free guidance 強化對嘴。

  • 以 chunk-by-chunk streaming pipeline 連續生成長片
  • Brownian bridgeBridge Forcing 減少長片身份漂移
  • README 已交代需另外下載 base model、語音模型與 LeapTalk 權重
  • 推論前要自行填入 COND_IMAGEAUDIO_PATH 等本地路徑

同類做法常見取捨是速度快但畫面累積誤差,或畫質穩定但延遲高;LeapTalk明顯站在「先把延遲壓到可互動」這一邊,再用 reference-anchored data-to-data transport 補回穩定度。

現適合做數字人互動、虛擬主播、即時內容生成的團隊。200 FPS 與單張 H200 GPU 的說法來自項目提供資訊,普通硬件能否複製同樣效果、Web Demo 的完整部署細節是否齊備,仍要等更多實測佐證。

項目主頁 · GitHub

Categories: 開源, AI productions, 數字人, 視頻模型, 影像處理, Audio

SwanTale 以場景佈局生成

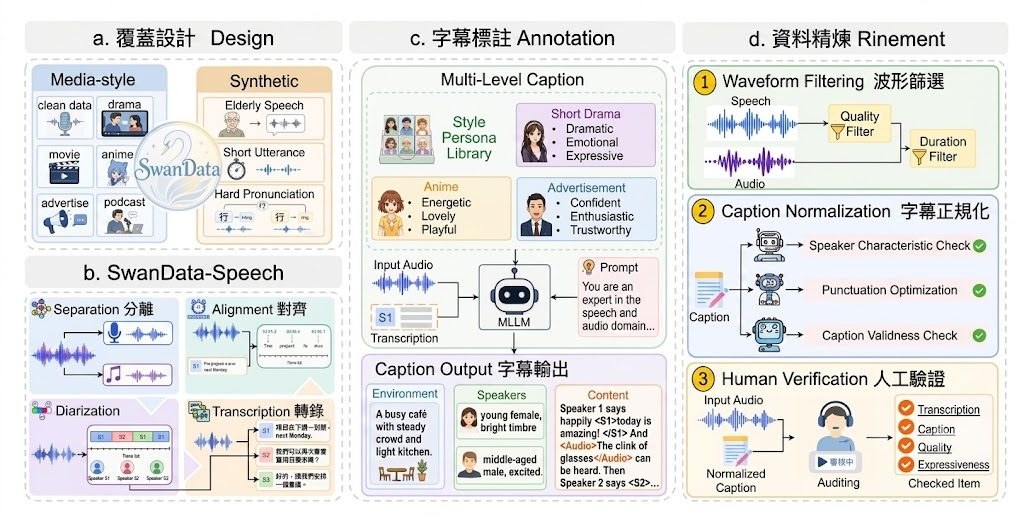
SwanTale 把語音與音訊研究集中成一個入口,重點放在更有表達力的生成能力。

swan logo

比起只追求把字讀出來,字節跳動的 SwanTale 更著重聲音是否自然、有情緒,亦能否處理多人說話生成。這個由 ByteDance 推出的研究項目,焦點放在 expressive audio、speech 與 multi-speaker generation。

現有資料不算多,但已見到它不是單一模型頁,而是一個集合式研究入口,整合 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere 等子項目。對做語音產品、數字人、配音內容與語音互動工作流的人來說,這類整理方式較易追蹤同一研究線的進展。

  • 聚焦 expressive audiospeechmulti-speaker generation
  • ByteDance 發佈,定位偏研究整合入口
  • 站內列出 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere
  • 目前公開資訊有限,性能與方法細節仍要逐個子項目再看

它的價值在於把聲音生成從「可用」推向「更像真人表達」,同時覆蓋多人語音場景。現階段較適合先把它視為字節跳動音訊與語音研究的總覽入口,而不是已完整公開規格的單一產品頁面。

項目主頁

Categories: 字節跳動, 數字人, Audio, 語音

Latent-Identity Tuning 人像身份細緻微調

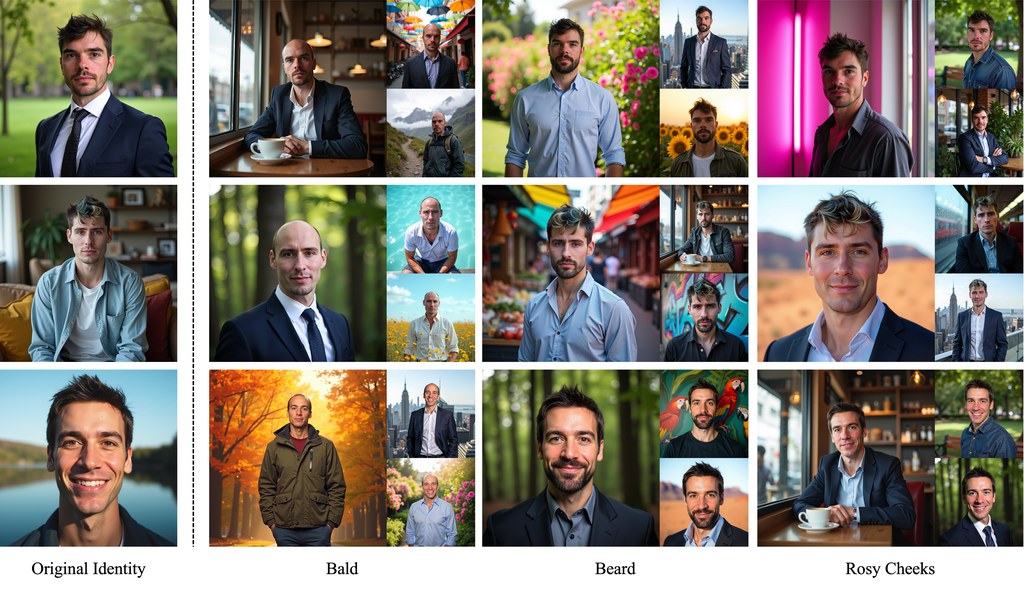
人像生成最怕改少少就變成另一個人。Latent-Identity Tuning 嘗試把臉部特徵拆得更細,令同一身份可在不同提示詞下保持一致。

teaser site

想修改鼻形、加鬍鬚或雀斑,同時又保留同一個人的辨識度,對 text-to-image (T2I) 個人化生成來說一直很難。Latent-Identity Tuning in Text-to-Image Personalization Models 聚焦在這個卡位:不只是改一張圖,而是調整某個人的身份表示,之後可在不同場景中生成同一個經過微調的人。

做法上,輸入人像會先經由預訓練 personalization encoder 轉成一組 identity tokens。研究發現,不同 token 會偏向捕捉眼、鼻、口、頭髮等不同區域或語義特徵,因此可以在這個 identity space 入面尋找有意思的方向,例如鬍鬚、捲髮或其他面部屬性,再沿着方向調整。

  • 直接微調 identity tokens,而不是只在單張圖片上修圖
  • 可做局部、細緻,而且語義較一致的人臉改動
  • 修改後的身份可配合不同 prompts 生成新圖
  • 透過 attention maps 觀察 token 與臉部區域的關係
  • 使用定性與定量實驗檢查局部編輯及跨圖身份一致性

和常見 image editing 相比,這個方法的差異在於它處理的是「身份的潛在表示」。換言之,改動不是鎖死在原圖姿勢、背景或光線,而是把編輯後的身份交給 T2I 模型,在新場景、新描述下仍盡量維持同一個人。

這類方法會較適合需要穩定角色形象的創作者、視覺設計工作流,以及研究人像個人化生成的人。限制上,資料未交代可直接使用的產品化介面或完整模型名單;引用模型方面,內容只提到預訓練 personalization encoder 與 text-to-image model,未列明具體基礎模型名稱。

項目主頁 · Paper

Categories: 數字人, Image, txt2img, 框架

Page 1 of 5
1 2 3 5