mv-split:千層級圖像生成實驗,效能與相容性兼顧

這個專案把超深層 DiT 圖像生成模型帶到可實際執行的層面,重點在速度優化與後備相容性。

Repository image for erwold/mv-split

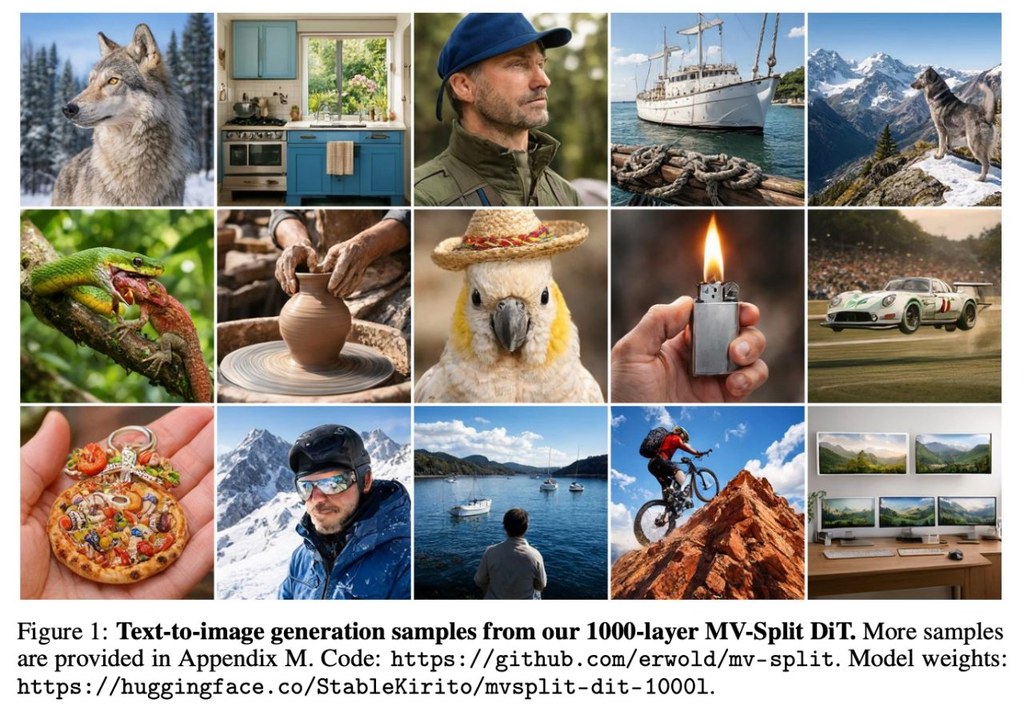
mv-split 是一個用來產生圖片的研究型專案,核心是名為 MVSplit-DiT 的超深層模型,整體深度達 1000 層。它不是一般即裝即用的圖片工具,而是較適合想測試新一代生成架構、比較效能,或者重現論文結果的人使用。

實際使用上,流程算清晰:先準備模型權重、FLUX.2 的自編碼器,以及 Qwen3 文字編碼器,之後透過 sample.py 輸入提示詞、指定輸出資料夾,就可以生成圖片。它亦支援從範例提示詞清單逐行抽樣、隨機抽樣,甚至一次過跑完整批提示,方便做測試和比較。

這個專案最值得留意的地方,是它同時提供 Triton 核心加速與 PyTorch 後備路徑。換句話說,就算機器沒有 Triton,理論上仍可運行;只是對於 1000 層這種深度,README 已明確提醒 CPU 雖可作後備,但實際上並不實用,較合適的環境仍是 PyTorch 2.x 配合 CUDA。

  • 採用超深層 DiT 架構,定位偏研究與高階實驗
  • 以 Triton 核心加速多個關鍵運算,同時保留 PyTorch 後備
  • 可直接用自訂提示詞、提示詞檔案或批次方式生成圖片
  • 會輸出 PNG 圖片及 metadata.jsonl,方便記錄實驗結果

從設計來看,它的主要創新不只在「層數夠深」,亦包括把多個底層運算元件拆得相當明確,例如 RoPE、RMSNorm、QK-Norm 和 SwiGLU 都有獨立實作,顯示作者很重視推論路徑的效率與可替換性。這種做法對一般用家未必直接有感,但對開發者或研究者來說,代表更容易針對效能瓶頸做調整。

最適合的應用場景,包括生成模型研究、推論效能測試、比較 Triton 與 PyTorch 後備表現,以及重現論文方法。若你只是想簡單輸入一句文字就穩定出圖,這個專案的門檻會偏高;但若你需要一個結構清楚、可觀察推論細節的實驗平台,它就相當有參考價值。相關模型方面,需配合 FLUX.2 AutoEncoder 與 Qwen/Qwen3-0.6B 文字編碼器。
Source: https://github.com/erwold/mv-split

Categories: 開源, 影像模型, 框架

PAE:令擴散模型更快收斂的潛在空間設計

PAE不是只追求重建清晰度,而是重新整理潛在空間本身。對想提升生成質素與訓練效率的人,這個方向值得留意。

pae teaser

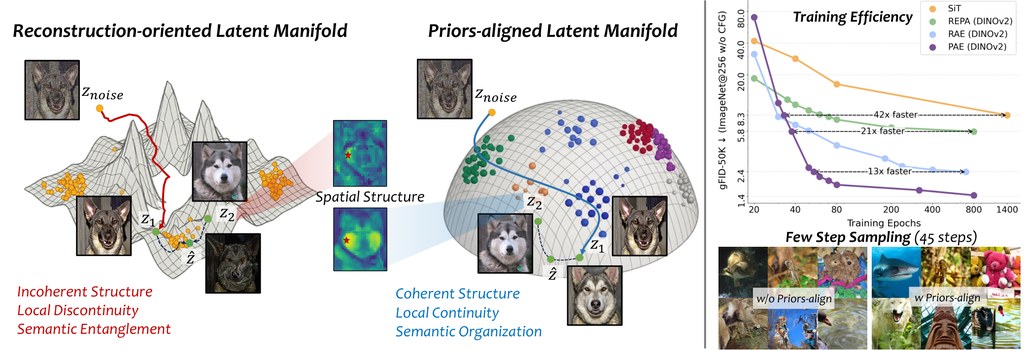
PAE 是一個為潛在擴散模型而設的自編碼器框架,重點不只是把圖片壓縮再還原,而是先把潛在空間整理成更適合擴散模型學習的形態。簡單講,它關心的不是「壓得靚唔靚」,而是「模型之後生圖時會唔會更順、更穩定」。

實際使用上,PAE 可理解為擴散模型前面的 tokenizer 或影像編碼模組:先把圖片轉成 latent,再交畀後續生成模型訓練。這種做法特別適合本身已在做 latent diffusion、但覺得收斂慢、訓練成本高,或者生成效果未夠穩定的研究與開發流程。

這個專案較有意思的地方,是它明確提出三個「對擴散友善」的潛在空間特質:空間結構一致性、局部流形連續性,以及全域語意組織。作者不是假設這些特質會自然出現,而是用三種 prior-alignment regularization 去主動約束,這比單靠重建誤差的傳統思路更進一步。

根據專案提供的結果,PAE 在 ImageNet 256×256 上做到 gFID 1.03,並且在相同 LightningDiT 設定下,收斂速度最高可比 RAE 快 13 倍。對非研究人員而言,這代表同樣資源下有機會更快見到可用成果;不過這些表現仍應視乎資料集、訓練設定與骨幹模型而定。

  • 核心定位:為 latent diffusion 準備更易學的潛在表示
  • 主要創新:把「擴散友善」拆成三個可優化的性質來訓練
  • 實際價值:有機會縮短訓練週期,提升生成質素與少步數採樣表現
  • 適合場景:影像生成研究、需要高效率訓練的生成系統、比較不同 tokenizer 設計
  • 可配骨幹:支援多種編碼器方向,包括 DINOv2、SigLIP2、DINOv3、MAE

如果你關心的是「如何令擴散模型學得更快,而唔係只換更大模型」,PAE 的切入點相當值得參考。它最適合有一定生成模型流程的人採用;對一般用家而言,未必是即裝即用工具,但作為下一代 latent tokenizer 的設計思路,含金量相當高。

Source: https://github.com/ZhengrongYue/PAE

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 模型訓練, 影像模型, 中國

Flow-OPD:讓文生圖多工對齊更穩的關鍵一步

這個專案把多教師蒸餾帶進 Flow Matching 文生圖訓練,重點是改善多任務獎勵互相拉扯的問題。

Teaser

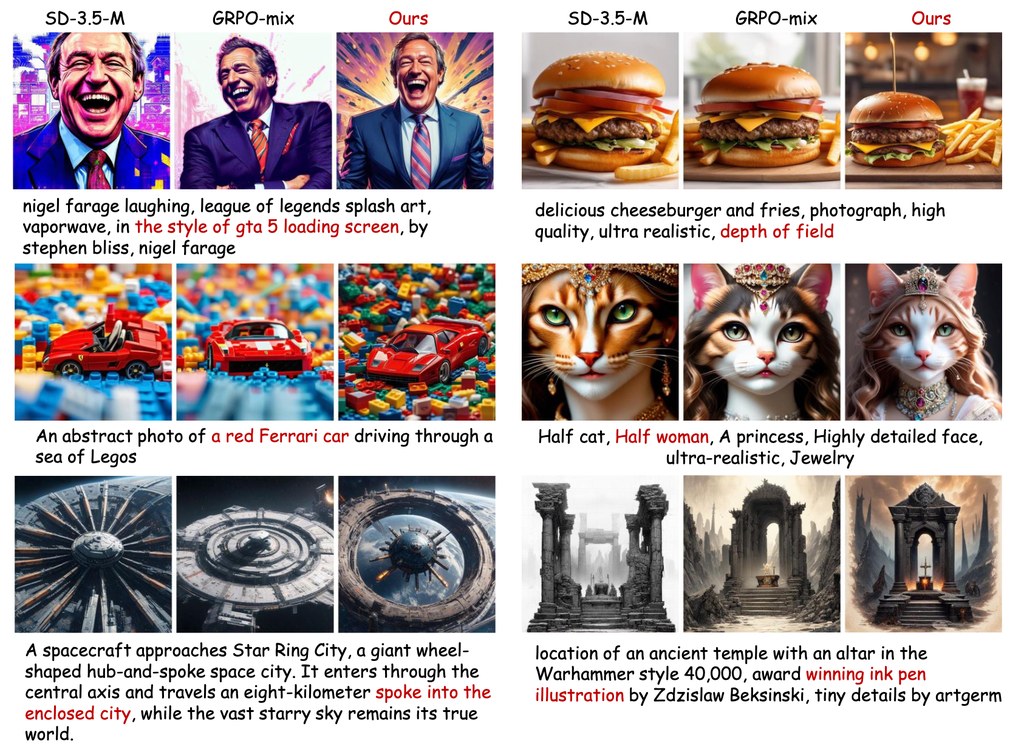
Flow-OPD 是一個針對 Flow Matching 文生圖模型的後訓練框架,核心目標不是單純追高某一項分數,而是把 OCR、組合理解、問答與人類偏好等不同能力整合進同一個學生模型。從公開資訊來看,它建立在 SD-3.5-Medium 上,並以兩階段流程處理「先培養專長、再統一能力」這個多任務對齊難題。

實際使用上,這個專案目前較適合研究者或進階生成模型開發者參考其方法與權重,而不是一般使用者直接拿來當完整訓練工具鏈。README 顯示模型權重已釋出,但完整訓練程式仍在進行中,因此比較合理的使用方式,是先檢視論文與模型成果,再評估是否將其蒸餾思路移植到自己的 Flow Matching 訓練流程。

它最值得注意的創新,在於把原本稀疏的標量獎勵,改成由多個教師模型提供的軌跡級稠密向量場監督。配合 on-policy 的 SDE 採樣,學生模型能在自身生成軌跡上接受更細緻的指導;再加上 MAR 正則化,則是用來降低純 RL 對齊常見的美感退化問題,這點對文生圖品質維持特別重要。

從結果看,Flow-OPD 的價值在於它不只比 vanilla GRPO 更強,還試圖解決多任務訓練常見的「翹翹板效應」。公開數據顯示,該方法在 GenEval、OCR、DeQA 與 PickScore 上都有提升,平均表現優於基線,且在 OCR、DeQA 上甚至出現超越個別教師的現象;不過這些結論仍應以論文設定與基準環境為前提理解。

  • 定位明確:專注於 Flow Matching 文生圖模型的多任務後訓練與對齊。
  • 方法新意:以多教師稠密監督取代單一標量獎勵,降低任務間梯度干擾。
  • 實務亮點:MAR 用來守住美感品質,避免只追指標造成生成退化。
  • 適用場景:適合需要同時兼顧文字生成、構圖理解與偏好對齊的通用型文生圖系統。
  • 使用前提:目前較偏研究型專案,若要重現訓練流程,可能仍需等待完整訓練程式公開。

Model download: https://huggingface.co/CostaliyA/Flow-OPD

Source: https://github.com/CostaliyA/Flow-OPD

Categories: 開源, 香港中文大學, 模型, 影像模型, 影像處理

MACE-Dance:把音樂變成舞蹈影片

MACE-Dance 聚焦音樂驅動的舞蹈影片生成,嘗試把動作與外觀拆開處理。對研究多模態生成與角色舞蹈合成的人特別值得留意。

Repository image for AMAP-ML/MACE-Dance

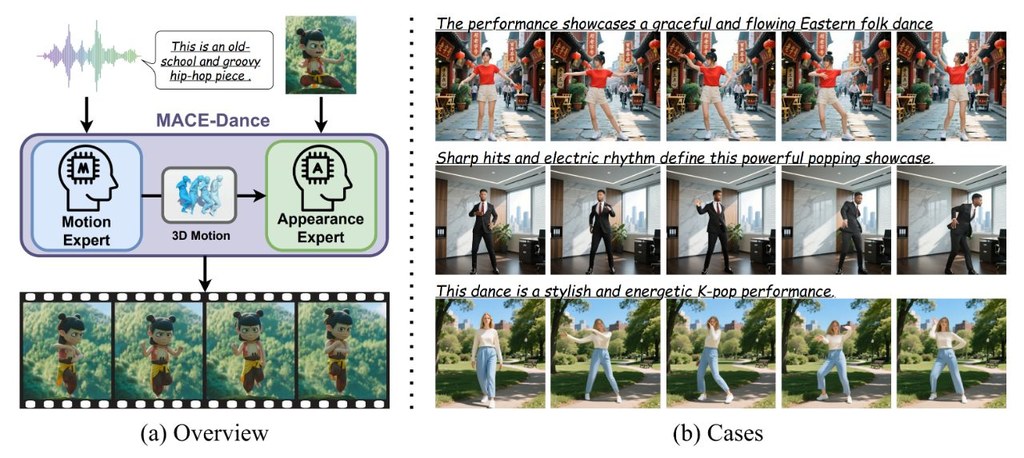
MACE-Dance 是一個面向音樂驅動舞蹈影片生成的研究型專案,核心目標是讓系統根據音樂內容,產生具有舞蹈動作與角色外觀一致性的影片。從名稱與簡介來看,它特別強調 motion 與 appearance 的分工建模,而不是把整個生成流程視為單一路徑處理。

這個專案最值得注意的地方,在於所謂 Motion-Appearance Cascaded Experts 的設計思路。簡單說,它像是把「先決定怎麼跳」與「再決定畫面怎麼呈現」拆成串接的專家模組,這種做法理論上有助於減少動作節奏與人物外觀彼此牽制的問題,也更貼近舞蹈影片生成常見的兩大難點。

實際使用上,這類儲存庫通常更適合已有生成式影音或人體動作研究背景的開發者與研究者。若你想評估模型表現,重點應放在輸入音樂後的動作對拍程度、角色連續性,以及生成影片是否維持合理的視覺一致性;若要延伸研究,則可觀察其模組拆分是否方便替換不同的音樂表徵或影像生成元件。

  • 聚焦音樂到舞蹈影片的多模態生成任務
  • 以動作與外觀分階段處理作為主要方法亮點
  • 適合分析節奏對齊、角色一致性與影片連續性
  • 較偏研究用途,不像一般即裝即用的消費型工具

就應用場景而言,它最適合用在舞蹈生成研究、虛擬人表演合成、音樂視覺化內容製作,以及多模態生成模型的比較實驗。若你正在找的是可快速產出商業級短影音的完整產品,這個專案目前看來更像方法驗證與學術探索平台;但若你的目標是理解音樂驅動角色影片生成的前沿方向,它具備相當明確的研究切入點。

Source: https://github.com/AMAP-ML/MACE-Dance

Categories: 開源, 模型, 視頻模型, 影像模型, 影像處理


X2SAM把影像與影片分割整合成單一模型

X2SAM將影像與影片分割整合到同一套多模態架構中,支援文字指令與視覺提示。它也強調影片遮罩的一致性與跨任務通用性。

HuggingFace

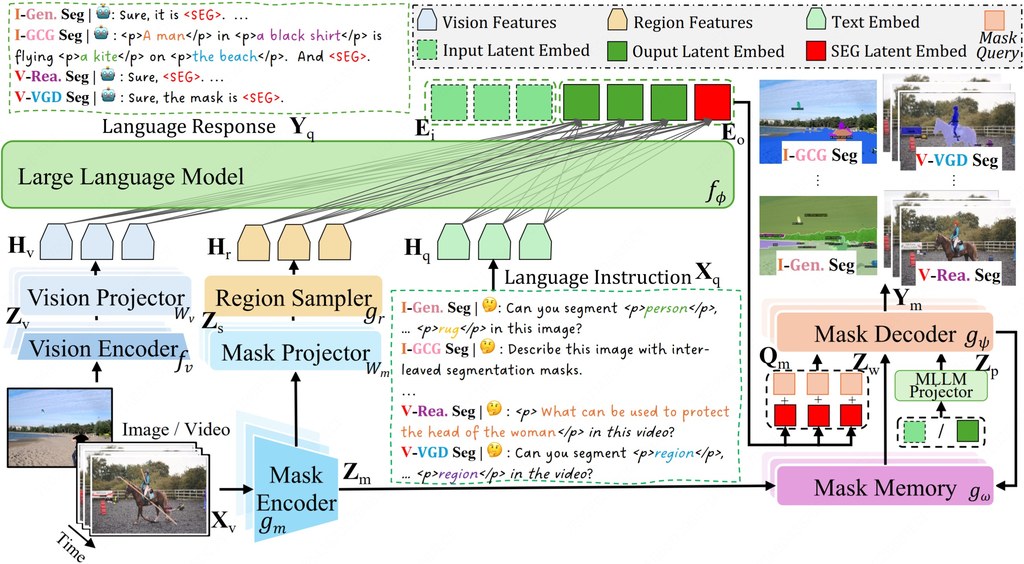
X2SAM 是一個統一式分割多模態大型語言模型,目標是把影像中的「任意分割」能力延伸到影片。它結合 LLM、Vision Encoder、Mask Encoder、Mask Decoder 與 Mask Memory,讓模型不只理解畫面內容,還能依照對話指令或視覺提示產生像素級遮罩。

實際使用上,X2SAM 可同時接受對話式文字指令視覺提示,適合需要指定目標、追蹤物件或互動修正結果的情境。官方描述指出,它支援 generic、open-vocabulary、referring、reasoning、grounded conversation generation、interactive 與 visual grounded segmentation,代表使用者可用較自然的方式提出分割需求,而不必侷限於單一輸入形式。

這個專案的主要創新,在於用單一介面整合影像與影片分割,並以 Mask Memory 儲存受引導的視覺特徵,改善影片中跨時間的遮罩一致性。此外,作者也提出 V-VGD(Video Visual Grounded) 分割基準,用來評估模型是否能根據互動式視覺提示,在影片中分割並追蹤物件。

  • 統一支援影像與影片分割,而非只專注單一媒體
  • 同時支援文字指令與視覺提示輸入
  • 透過 Mask Memory 強化影片遮罩的時序一致性
  • 提出 V-VGD 基準補足影片視覺定位分割評估
  • 採用異質影像與影片資料的聯合訓練策略

從工作應用來看,這類系統可望受惠於影片內容理解、互動式標註、智慧剪輯、視覺助理與多模態人機互動等任務。性能方面,原文表示 X2SAM 在影片分割上達到強勁表現,對影像分割基準仍具競爭力,並保留一般影像與影片聊天能力;不過此頁面未完整列出具體數值,因此解讀上仍應以論文與實驗表格為準。

模型列表:LLM、SAM 系列

Categories: 開源, 影像模型, 影像處理

ComboStoc 擴散模型訓練更快的關鍵

用非同步時間步,補足擴散模型盲點。

ComboStoc samples

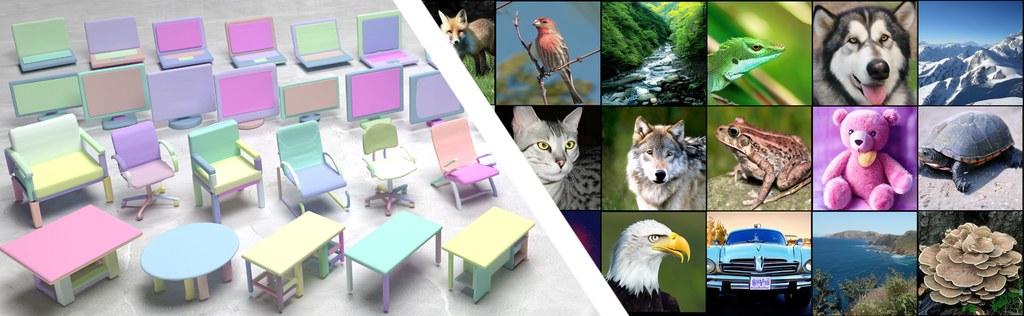
ComboStoc 是一個針對擴散生成模型訓練流程的研究型實作,核心目標不是換掉整個模型架構,而是修正既有訓練對「組合式結構」取樣不足的問題。這個版本以 PyTorch 為主,提供影像擴散模型、訓練腳本,以及預訓練權重,定位相當明確:拿來驗證論文方法,也適合已有 SiT 或相近擴散管線的人直接比較。

這個專案真正有辨識度的地方,在於它不再把整筆資料視為同步走在同一個 diffusion timestep。相反地,它讓不同維度、patch,甚至可能的屬性使用非同步時間步,藉此更完整覆蓋高維資料中的組合空間;這也是它和一般只調 loss、scheduler 或採樣器的做法最不一樣之處。

實務上,它延續 SiT 風格的實作思路,並提供基於 PyTorch DDP 的訓練流程,代表它不是紙上談兵,而是可在分散式訓練中直接測試。推論端也不只是在既有 checkpoint 上出圖,還能利用非同步時間步做更細緻的控制;若參考論文描述,這種機制對局部條件控制或結構化生成尤其有意義。

最能受益的族群,會是正在研究影像生成、擴散模型訓練效率,或需要面對高度結構化資料的人。若你關心的是更快收斂、較低 FID,或想把相同模型延伸到更有屬性組合複雜度的任務,這個專案值得細看;至於 3D structured shape 的完整程式,儲存庫目前看來仍是後續補上。

  • 特色在於非同步 diffusion timestep,不是單純更換 backbone
  • PyTorch 實作,並提供 DDP 訓練腳本
  • 已附預訓練的 ComboStoc-XL-2 權重,可直接做採樣比較
  • 適合拿來研究高維資料中組合複雜度對生成品質的影響

Source: https://github.com/Xrvitd/ComboStoc

Categories: 開源, 香港大學, 模型, 影像模型

SenseNova-U系列:一種突破性的多模態AI

SenseNova U1重新定義了多模態AI。深入探索吧!

SenseNova-U1
OpenSenseNova/SenseNova-U1 on GitHub

[2026-08-21] SenseNova-U1.5 更新版模型下載

SenseNova U1引入了一種突破性的多模態AI方法,通過單一架構統一語言和視覺。這種創新允許文本和圖像之間無縫互動,而不需要單獨的適配器,增強了效率和一致性。

在探索SenseNova U1時,最初應關注其核心架構NEO-Unify,這使得模型能夠將視覺和文本數據作為統一的複合體進行處理。實際上,這意味著模型可以更有效地跨不同類型的輸入進行推理,保留語義豐富性和視覺忠實度。

研究人員和開發者最能受益於SenseNova U1的能力,特別是那些從事需要高密度資訊渲染或交錯圖文生成應用的人。該模型處理複雜任務(如創建知識插圖或旅行日誌)的能力使其成為一個寶貴的工具。

為了充分利用SenseNova U1,用戶應擁有能夠支援多模態任務的強大大型語言模型(LLM)。該模型的開源性質也鼓勵社區貢獻和進一步發展。

• SenseNova U1原生統一多模態處理。
• 它擅長交錯圖文生成。
• 用戶需要一個穩健的LLM以實現最佳性能。
• 適合研究人員和開發者。
• 在開源多模態AI中設定了新的標準。

Source: https://github.com/OpenSenseNova/SenseNova-U1

Categories: 開源, 模型, 影像模型, 影像處理

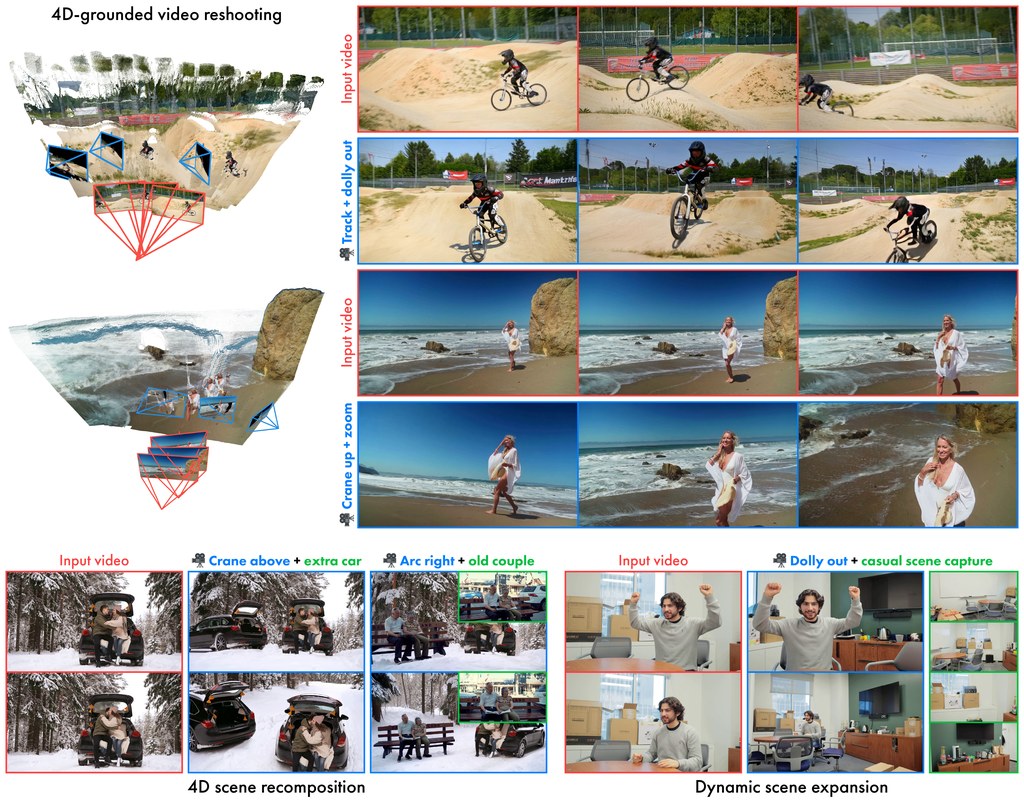
Vista4D 使用 4D 點雲進行視頻重拍

Vista4D 動態地重新拍攝視頻。對於創作者來說非常理想。

Vista4D 預告圖
Eyeline-Labs/Vista4D 在 GitHub 上

Vista4D 提供了一種獨特的視頻重拍方法,通過從新的角度合成場景。它利用 4D 點雲有效地處理現實世界中的視頻缺陷。這使得它特別適合希望擴展其視覺敘事能力的創作者。

在開始使用 Vista4D 時,重點是理解其核心功能——從新穎的角度重拍視頻。該框架對點雲工件的強健性確保了即使在不完美的重建下也能可靠運行。此特性對於維護場景完整性至關重要。

在實際應用中,Vista4D 受益於動態場景擴展和 4D 場景重組的專業人士。它在保留場景內容的同時允許精確的相機控制,為創意編輯打開了大門。用戶可以預期在視頻製作流程中獲得增強的靈活性。

該框架需要一個強大的大型語言模型(LLM)以獲得最佳結果。創作者和編輯人員將發現 Vista4D 因其創新性的視頻操作方法而極具價值。

• 使用新穎視角增強視頻重拍
• 對點雲工件具有強健性
• 適合動態場景擴展和重組

Source: https://github.com/Eyeline-Labs/Vista4D

Categories: 開源, 模型, 視頻模型, 影像模型, 影像處理

OmniShotCut 在鏡頭邊界偵測任務的最新技術

OmniShotCut 以其多功能的轉換器模型革新了鏡頭邊界偵測。對於追求精確度的影片編輯師和研究人員來說,這是理想的選擇。

logo

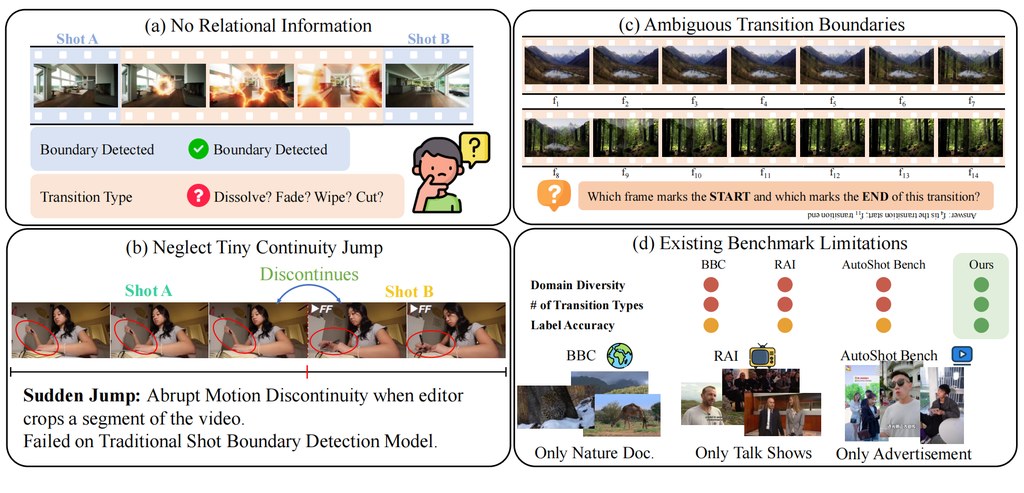
OmniShotCut 作為一種先進的解決方案,在各種類型的影片中都能出色地偵測鏡頭邊界,從動畫到體育轉播皆適用。該工具採用基於鏡頭查詢的影片轉換器,與傳統方法相比,提供了更高的靈敏度和資訊豐富性。處理多樣化影片來源的影片編輯師、內容創作者和研究人員應該考慮使用 OmniShotCut,因為它能夠準確識別突兀的跳接和微妙的轉場如溶解和漸變。對於初次使用該工具的人,首先理解鏡頭查詢機制的核心概念可以提供堅實的基礎。這種方法使模型能夠有效地分析和分類影片中的不同類型的鏡頭變化,特別適合需要對影片編輯過程進行精確控制的專業人士。

實際上,OmniShotCut 通過其複雜的轉換器架構處理影片幀來運作。模型學習根據視覺線索和時間關係區分不同的鏡頭類型。用戶可以從這項技術中獲益良多,特別是在處理需要細緻編輯的大批量影片內容時。自動偵測這些邊界可以節省大量的時間和精力,讓編輯師能夠專注於創意方面而非手動分割。此外,本地 Gradio 介面的加入簡化了實驗和與現有工作流程的整合,即使對那些程式設計經驗有限的人也同樣易於使用。

OmniShotCut 的主要受益者是媒體製作專業人士、研究影片內容的學術研究人員以及從事影片分析應用的開發人員。這些群體可以利用該工具的能力來提升他們項目的品質和效率。然而,需要注意潛在的權衡。雖然 OmniShotCut 在準確性和多功能性方面表現優異,但用戶必須確保擁有足夠的計算資源以高效運行模型。此外,底層轉換器架構的複雜性可能對不熟悉深度學習概念的用戶構成挑戰。因此,基本的機器學習原則理解將會很有幫助。

為了最大化 OmniShotCut 的效益,用戶應從探索提供的 Gradio 示範開始。這種親手實踐的體驗可以提供對模型性能的洞察,並有助於理解其輸出。觀察的重點包括模型如何處理不同類型的影片以及其鏡頭變化偵測的準確性。透過實驗各種輸入影片,用戶可以對將 OmniShotCut 應用於特定需求充滿信心。此外,在推理過程中考慮 clean_shot 模式可以簡化結果,提供僅聚焦於有效鏡頭而無轉場或突兀跳接的乾淨輸出。

OmniShotCut 代表了鏡頭邊界偵測技術的重大進步。其堅固的設計和多功能應用使其成為任何處理影片內容的人的無價資產。儘管在計算需求和技術知識方面存在某些考量,但使用 OmniShotCut 的好處遠遠超過這些小障礙。隨著影片分析領域的不斷髮展,像 OmniShotCut 這樣的工具無疑將在塑造未來創新中發揮關鍵作用。

Source: https://github.com/UVA-Computer-Vision-Lab/OmniShotCut

Categories: 開源, 視覺模型, 視頻模型, 影像模型, 影像處理

Page 6 of 12
1 4 5 6 7 8 12