Mask Forcing:雙重遮罩幫影片擴散模型

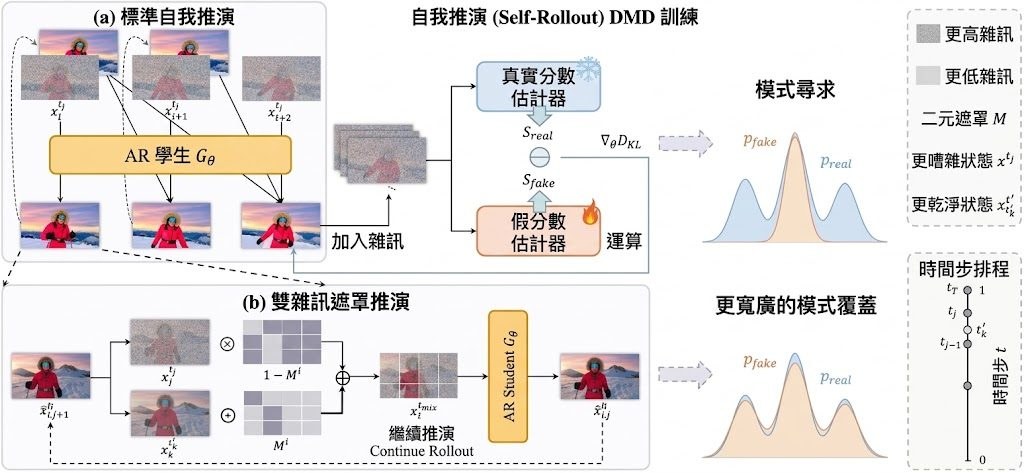
Mask Forcing 針對自回歸影片擴散蒸餾中嘅模式塌縮問題,利用雙重雜訊遮罩嘅 rollout 策略,令學生模型分佈覆蓋更多教師模式,同時唔使額外影片資料或後訓練。

Mask Forcing pipeline

用 DMD(Distribution Matching Distillation)把雙向影片擴散模型蒸餾成自回歸(AR)學生模型時,影片往往出現過度飽和同過度平滑嘅情況,背後成因係 reverse-KL 目標嘅 mode-seeking 傾向,令學生分佈容易塌縮到教師模型嘅少數模式之上。Mask Forcing 嘅切入點正正係呢個矛盾:佢喺 AR 蒸餾嘅 self-rollout 過程中,沿空間同時間軸隨機遮罩、注入較乾淨嘅 token,藉此擾動 rollout 軌跡,令學生有機會探索教師分佈嘅更多區域。

呢個做法同時帶來兩個好處:擾動令 DMD 嘅學習訊號唔再局限於學生已經覆蓋嘅模式;而較乾淨嘅 token 亦可以作為引導,協助同一 chunk 入面較嘈雜嘅 token 去噪,等中間過渡更穩定,從而減少錯誤喺後續 denoising step 同 chunk 之間累積。整個方法唔需要真實影片監督、唔需要額外後訓練階段,亦唔會增加推論成本,純粹改動訓練期嘅 rollout。

Mask Forcing 屬於一種蒸餾增強策略,主要服務於想把 AR 影片生成做快、但又想避開 DMD 視覺質素下降嘅團隊,例如做實時或近實時影片生成嘅研究同產品線。佢同一般做法嘅取捨清晰:放棄模式集中所帶來嘅短期穩定,換取分佈多樣性同中間步預測嘅可靠性。

  • 針對 AR 影片擴散蒸餾中 DMD 嘅 mode-seeking 問題,用雙重雜訊遮罩擾動 rollout
  • 不需真實影片監督或額外後訓練階段,唔改動推論流程
  • 令學生分佈覆蓋更多教師模式,並以較乾淨 token 引導較嘈雜 token 去噪
  • 適用於追求實時影片生成、又想提升視覺質素嘅研究同產品場景
項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 模型, 模型訓練, Video, 影像模型

Atlas 世界模型一次處理文字、圖片、影片與 3D

World Labs 推出 Atlas,聲稱是目前首個原生同時處理文字、圖像、影片與 3D 的「omni」世界模型,能從一張相機路徑推算未見過的視角,並重建真實場景。

Og image

World Labs 公開了新一代世界模型 Atlas。它的特別之處在於從訓練階段就同時處理四種輸入——文字、圖像、影片、3D——並把它們整合到同一個空間脈絡裡,再以多模態自迴歸擴散 Transformer 推算下一個畫面。這意味著 Atlas 不只是「看得更多」,而是嘗試理解世界怎樣呈現、怎樣變化,並把想像中的場景渲染出來。

從使用場景來看,Atlas 主要涵蓋四類工作:相機控制生成、空間重建、空間時間模擬,以及純文字生圖與 360 度全景。其中相機控制生成支援 1 至 6 張輸入圖片,可輸出最高 1440p、最長約 1 分鐘的影片,並以像素級精度的相機幾何作為輸入,而不只是粗略的文字描述。

重建方面,Atlas 只需要 1 張到幾十張相片,就能還原真實場景並產出新視角的影像幀與明確的 3D 輸出。團隊指出,這項表現優於專門做 3D 重建的同類模型。空間時間模擬則可從影片重新取景,生成電影級視覺效果,並支援 Real-to-Sim 流程,供機器人規劃動作。

以下幾點值得留意:

  • 原生多模態:文字、圖片、影片、3D 一開始就共享同一空間脈絡,並非後期拼接。
  • 像素級相機控制:把精確相機幾何列為原生輸入,能逐格構圖、逐段運鏡。
  • 超越專用模型:3D 重建表現優於專門訓練的模型。
  • 支援 Real-to-Sim:能把真實影片轉成可模擬的世界,供機器人規劃。
  • 規模持續擴展:團隊表示表現會隨訓練算力提升,並預期這個趨勢會延續下去。

World Labs 表示,Atlas 將驅動他們自家 Marble 的未來版本及其他產品,現已開放早期使用的申請。

項目主頁

Categories: AI productions, 多模態模型, 世界模型, 模型訓練, API, Video, Image, 影像模型, Robotic, 3D

Qwen-Video-Edit:開源影片編輯模型

它把文字指令式影片編輯做得更直接,透過現成的 image editing model 去改寫影片 latent。對需要長片段、分段修改同一條影片的工作流,會比重起一套 video transformer 更省力。

input contact sheet

Qwen-Video-Edit 是一個 instruction-based video editing 項目,核心做法是把 Qwen-Image-Edit 直接搬去處理影片 latent,再用兩個可訓練 projection 接上 Wan 2.1 的 video-VAE。這樣做的價值很清楚:不用再依賴 video-pretrained transformer,也能按文字指令改影片內容。

安裝和測試路線已經整理得相當明確。train.py 走單機多 GPU 訓練,infer.py 負責長影片逐段編輯與 Wan 2.2 denoising-enhancement,dataset.py 則讀取 Ditto 格式的 source、edited、instruction 配對。

和一般影片編輯方法相比,差異在於它不是從頭學影片理解,而是借用影像編輯模型的先驗,再用 warm-started projections 與 grid positional encoding 去補上時間維度。這代表訓練成本和架構複雜度較低,但限制也在於效果仍仰賴 Wan 2.1 latent 空間、Ditto-1M 資料,以及後段 enhancement。

  • 支援 LoRA 或 full fine-tuning,取捨在訓練成本與自由度之間
  • 長影片可以分段套用不同指令,適合剪接、局部修改、旁白對齊內容
  • 輸出 checkpoint 以 trainable-weights-only .safetensors 形式提供,載入流程較直接
  • 另有 zero-training demo,可先看 image-grid 與 latent-grid 編輯行為
  • 模型權重已公開,方便直接做復現或二次改造

項目主頁 · GitHub · 模型

Categories: 開源, 視頻模型, 模型訓練, Qwen, Video, Image, 影像模型, Dataset 數據集

GenRouter AI 圖像生成變成會分流的工作流

它把 agentic image generation 由單一路徑改成可分流的工作流,按任務難度配對不同執行方案。對要兼顧畫質、文字準確度同運算成本的團隊,這種做法比硬套同一套流程更有彈性。

Figure1 00

安裝方式偏向研究原型工作流,先建立 environment.yml 對應的 Conda 環境,再按 scripts/services/scripts/serve.sh 需要下載本地模型。README 亦提到 OneIG 同 WISE 有獨立環境,代表它不是單一命令就能完整跑通的輕量工具,而是要跟着項目內的服務配置同基準測試流程去部署。

GenRouter 處理的不是單純「生成得靚唔靚」,而是把不同提示詞導向不同算力配置。當任務涉及多步空間推理、精準文字渲染,或者需要較高視覺質素時,GenRouter 會揀更合適的執行計劃;較簡單的請求則不必走沉重流程,這種取捨直接針對延遲同成本問題。

  • GenCanvas 將 agentic image generation 拆成通用原語,方便重用工作流
  • GenRouter 以需求分析、記憶輔助匹配同 Pareto filtering 做路由
  • 目標是減少「一刀切」流程造成的算力浪費
  • 比較適合做圖像代理、生成管線同研究型系統的團隊
  • README 未見完整公開的數值結果摘要,較適合當作框架型項目理解

GitHub

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, Qwen, Image, 影像模型

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based onbase modelfine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

Context Scaling 把文生圖提示詞帶到結構化階段

寫得更長未必更準,關鍵反而是提示詞有幾多可對應畫面的結構資訊。Context Scaling 把這件事量化,連帶改寫文生圖訓練與編輯流程。

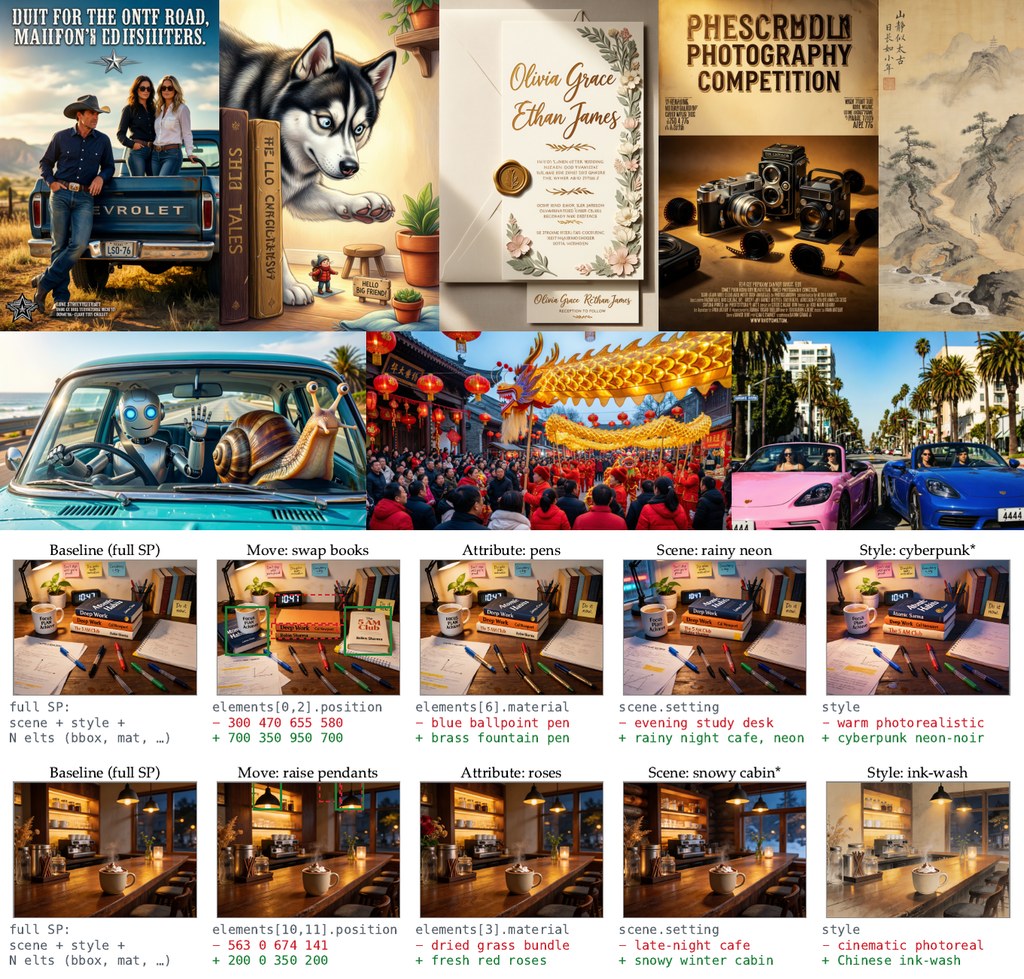
Text prompt scaling law overview

文生圖卡住的位置,很多時不是模型不夠大,而是提示詞交代得唔夠可計算。Context Scaling 聚焦影像生成中的文字條件 scaling law,屬於一個結合研究、模型與工作流程設計的項目,處理的是提示詞怎樣更有效描述構圖、屬性同空間關係,令 diffusion model 更容易學到、亦更容易按要求生成。

它最值得留意的判斷,是 caption 長度本身跟效果關係唔算緊密,反而 structured language 的資訊量更重要。團隊用兩個指標去量度這件事:white-box likelihood metric 的 GPG,同 black-box attribute metric 的 ED;受控訓練結果顯示,converged diffusion loss 會隨 GPG 近線性下降,亦會跟 ED 呈 power law 關係。

Context Scaling: Scaling Properties of Text Conditioning in Visual Generation

這個方向不只停留在分析。項目把 Structured prompts(SP)做成帶 semantic 與 geometric fields 的 JSON schema,再配合 trainable LLM prompter + captioner,將用戶要求或者輸入圖片轉成更有結構的描述;zero-shot structured editing 亦因此變得可行,因為每個可編輯因素都被拆成命名欄位,改其中一部分時,其他構圖元素較容易保留。

  • 重點不在提示詞有幾長,而在畫面資訊有幾可對齊
  • GPG 與 ED 為提示詞資訊量提供兩種量化方法
  • Structured prompts(SP)直接補強 compositional、reasoning、world-knowledge 類生成
  • prompter 經 supervised fine-tuning、cold-start、verifier-gated on-policy distillation 訓練
  • 已公開 Code、Models 與 Demo,理解路線可先看 project page,再到 Hugging Face collection

跟同類做法相比,它的取捨相當清楚:不是單靠更大模型或更長自然語言描述去碰運氣,而是先提升 captions 對影像的可監督性,再訓練 prompter 去穩定產生這類結構。官方說法指出,系統在多個 compositional、reasoning 與 world-knowledge benchmark 上超越全部已評測 open-weight models,並在多數評測追平或超過最強 closed-weight models;不過公開資訊仍以研究結果為主,部署細節與完整安裝流程未算多,現階段較適合做方法研究、提示詞工程、影像編輯流程設計,以及評估下一代文生圖介面的團隊參考。

項目主頁 · GitHub · 模型

Categories: 開源, 字節跳動, 模型, 模型訓練, Qwen, 影像模型, txt2img, Dataset 數據集

RefCaptioner:參考圖綁定對應影片字幕

RefCaptioner唔只寫影片字幕,仲會清楚標示句中描述對應邊張參考圖。對要處理多視角人物或混入干擾圖的情境,呢種做法實用得多。

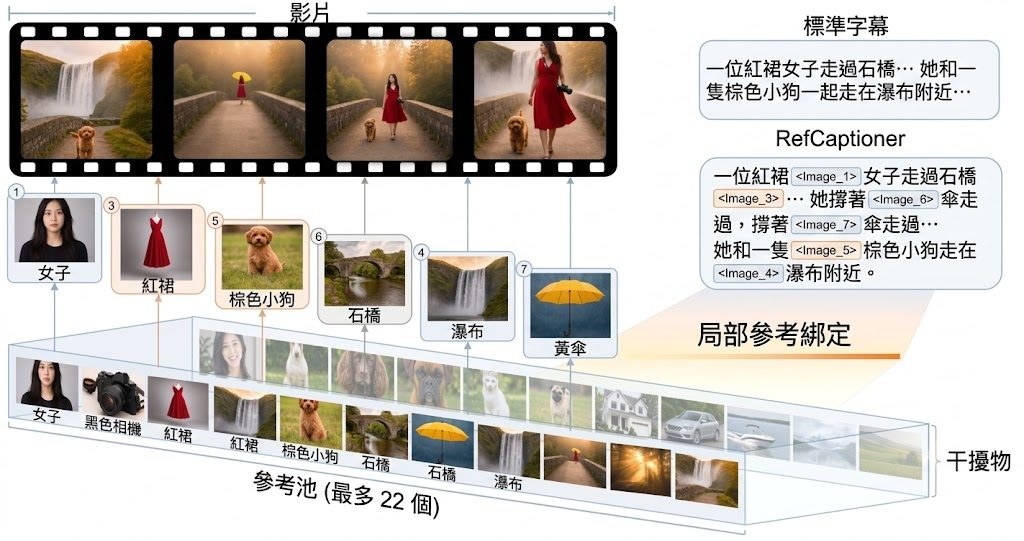
RefCaptioner grounds local caption phrases to relevant reference images while rejecting distractors.

做影片描述時,最易出錯唔係句子寫得唔夠長,而係講到某個人、物件或角度時,無法交代文字究竟對應邊張參考圖。RefCaptioner屬於影片字幕生成模型項目,集中處理 multi-reference image-grounded video captioning:一邊保留細節與事實準確度,一邊將局部描述同候選參考圖明確綁定。

RefCaptioner 不只是把所有參考圖塞入輸出,而係會挑選真正有用的圖,將對應片語加上 <Image_N> 標籤,遇到同一主體的不同視角又會做分組,影片根本無出現的內容就直接略過。呢種設計減少錯配同誤導,比起只追求流暢字幕,更著重可核對性。

技術上,RefCaptioner用兩段式 post-training。先以 capability-preserving SFT 學會 grounded caption 格式,同時盡量保留一般 captioning 能力;之後再用 Hierarchical Coverage-Discounted GRPO(HCD-GRPO)同時優化 factual-caption 分支與 multi-reference grounding 分支,並加入 deterministic guards,避免產生格式錯誤或指向不存在圖片的標籤。

  • 提供官方 inference pipeline、SFT 資料準備、HCD-GRPO 訓練同 MRVBench evaluation pipeline
  • 已公開論文與模型權重,亦有 Data Format、Training、Evaluation 文件可跟進
  • 環境分成主環境與 GRPO 專用 veRL/vLLM 環境,代表訓練流程較完整但配置亦較講究
  • 適合做影片理解、資料標註、多鏡頭人物敘述同需要檢查圖文對應的研究團隊

部署與測試:推理、SFT、評估共用主環境,GRPO 另設一套環境,並且要對指定 veRL 版本套用 patch,反映佢較偏研究型工作流,而唔係下載即用的小工具。效能數字在提供的內容未見完整展開,但既然已附 MRVBench evaluation pipeline,至少表示作者有把「字幕寫得對」同「圖文對得準」分開檢驗,較適合重視可解釋輸出的團隊採用。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Video, Image, 影像模型

Microsoft Mage:4B 多模態輕量路線

想做影像生成、編輯,甚至進一步研究多模態模型,但運算資源有限,Mage 會係一個值得留意的方向。它把 4B 規模壓到夠細,同時仍然追住更大模型的表現。

gallery

當你想喺有限 GPU 預算下做影像生成、編輯,甚至延伸到影像與影片理解,Mage 這個開源模型家族的定位就相當直接:用固定 4B 參數規模,處理多模態理解與生成兩條路線,目標唔係堆大模型,而係保留研究可控性同部署可行性。

Mage 目前最完整的是 Mage-Flow,屬於模型家族中的生成與編輯分支。它把 Mage-VAE 同 Native-Resolution Multimodal Diffusion Transformer 組合起來,前者負責更高效率的 latent tokenizer,後者負責文字生圖與指令式修圖;同時提供 Base、RL-aligned 同 4-step Turbo 版本,方便按畫質、對齊程度與速度取捨。另一條線 Mage-VL 對準 image/video understanding,但程式與權重細節仍待釋出。

同類開源影像模型很多都靠更大參數量換效果,Mage 的判斷明顯不同:它把重點放喺 codec-aligned efficiency,同一個 checkpoint 已可覆蓋 512 到 2048、不同長闊比,連 4:1 這類極端尺寸都原生支援,減少多套模型或額外縮放流程。它在生成、編輯表現上可與 Qwen-Image 20B、FLUX.2 32B、FireRed-Image-Edit 20B 等較大型開源系統競爭,但取捨是 Mage-VL 仍未完整開放,整個家族現階段更適合關注研究與工作流整合的人先行評估。

Super fast Image Edit model Mage-Flow on 8GB VRAM
  • 固定 4B 規模,主打可訓練、可微調、可部署
  • Mage-Flow 已覆蓋 text-to-image 與 instruction-based image editing
  • Mage-VAE 以更低 encode/decode MACs 減輕高解析度瓶頸
  • 單一 checkpoint 支援 512–2048 與多種 aspect ratio
  • Turbo 版本強調速度,1024² 在單張 A100 有明確推理數字

部署與測試方面,現有資料顯示 Hugging Face 已提供多個 Mage-Flow 與 Mage-Flow-Edit 權重,適合先用現成 checkpoint 驗證生成、修圖與速度,再決定是否進一步做微調。對做垂直領域影像項目、想研究後訓練方法,或者需要把高解析度生成放入較實際算力條件的人,Mage 的吸引力不在花巧包裝,而在它用一條輕量路線,把研究、性能與部署成本拉回較平衡的位置。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Stable Diffusion, Video, Image, 影像模型, 影像處理, txt2img, Medical醫學

Qwen Image 3 Studio 一站式玩轉文字、影像與工具

想一次過處理聊天、讀圖、生成內容同文件分析,Qwen Studio 提供咗一個整合入口。你可以把它理解成把多種 AI 能力放入同一個工作台。

Og image

想喺同一個介面完成對話、睇圖、生成影像、處理文件,同時再配合網頁搜尋同工具調用,Qwen Studio 走的是整合式 AI 工作台路線。對一般用家而言,重點唔係逐個模型切換,而係可以較順手地喺同一流程內完成理解、生成同操作。

現有資料顯示,Qwen Studio 涵蓋 chatbot、image and video understanding、image generation、document processing、web search integration、tool utilization 同 artifacts。這種組合對內容整理、資料查找、讀圖問答,以至需要一邊對話一邊調用工具的工作流較有吸引力,因為中間少咗介面切換同上下文斷裂。

  • 把聊天、讀圖、影片理解同生成能力集中喺同一入口
  • 支援 document processing,適合處理文件內容同資料整理
  • 結合 web search integration,可補充即時或外部資訊
  • 包含 tool utilization 同 artifacts,方便延伸到更完整操作流程

目前公開內容偏向功能層面的簡介,未見更詳細的模型結構、效能指標或評測結果,所以較適合先將它理解為 Qwen 生態入面的一個綜合使用介面,而唔係單一模型發表。對想快速試用多模態模型、工具調用同線上服務整合的人,呢類入口通常更容易上手。

項目主頁

Categories: 阿里巴巴, Qwen, Video, Image, 影像模型

Krea 2 Outpaint:外擴 LoRA 補畫面

想將圖片自然延伸到更大畫布,又唔想主體走位,呢個 Krea 2 Outpaint 就係針對呢個卡位而來。它唔只做補邊,重點係知道原圖應該擺喺新畫布邊個位置。

Og image

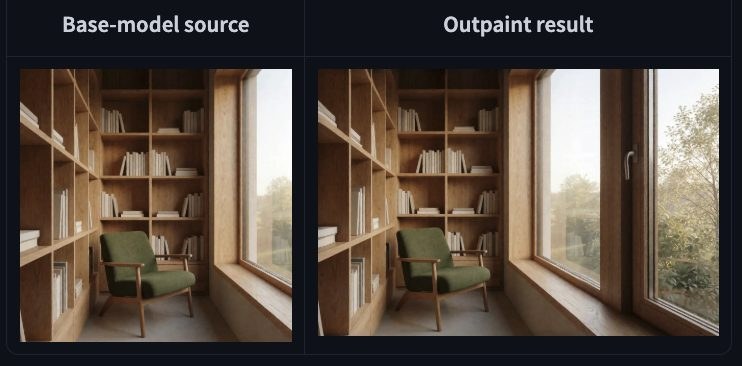
畫面外擴最怕兩件事:原圖內容被改壞,或者延伸後透視、光線同結構接唔上。呢個項目明確建立在 Krea/Krea-2-Turbo 之上,並以 Krea 2 Raw 作訓練目標,形式係一個 rank-32 的 LoRA,用嚟做 image-to-image outpainting,重點唔係單純參考原圖,而係連原圖要放喺新畫布邊個區域都一併編碼。

它的做法是把來源 latent tokens 加上來自目標 bounding box 的 rotary coordinates,令 denoiser 能理解「已知畫面屬於整張新圖的哪個位置」。所以它比一般 image-reference adapter 更適合做左貼右擴、上貼下擴,甚至置中後向兩邊延伸,對透視、光照、紋理連續性的控制更直接。

檔案資訊相當清楚,但重點不在量化版本。頁面列出 krea2_outpaint_rank32.safetensorspipeline.pyoutpaint.pyexample.py,另有授權與雜湊檔;同時明確說明 Hugging Face 自動產生的 Diffusers snippet 及一般 LoRA importer 不相容,要用隨附腳本與自訂 pipeline。這代表它不是即插即用型 LoRA,而係帶有功能性介面的適配器。

  • 基礎模型已指明為 Krea/Krea-2-Turbo,並針對 distilled 8-step inference 設計。
  • 核心差異在 registered reference_placements,可指定原圖在目標畫布的位置。
  • 已測試寫實、水彩、stylized 3D 等場景,涵蓋橫向、縱向與置中延伸。
  • 頁面沒有提供 GGUF、mmproj、llama.cpp、Ollama、LM Studio 或量化等資訊。

使用取向上,它更像為 Krea 2 編輯流程補上一個 UI 版的外擴能力,而唔係通用本地推理模型。由於依賴 diffusers 與自訂程式碼,適合已經在 Python 圖像流程中工作、需要穩定控制構圖位置的人。

項目主頁 · 模型

Categories: 開源, 視覺模型, Image, 影像模型, 影像處理, Ollama

Page 1 of 12
1 2 3 12