教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。
n8n with ComfyUI AI Video Automation Local Setup Walkthrough

教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。
教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。
1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。 影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)
1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。
影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)

💥 FaceFusion 3.2.0 更新不僅帶來了全新的GPU加速,還提升了不少效能與真實感! 🔍 新功能1️⃣ YOLO NSFW過濾2️⃣ 多GPU支援3️⃣ FLAC音訊輸出4️⃣ 臉部選擇增強
💥 FaceFusion 3.2.0 更新不僅帶來了全新的GPU加速,還提升了不少效能與真實感!
🔍 新功能
1️⃣ YOLO NSFW過濾
2️⃣ 多GPU支援
3️⃣ FLAC音訊輸出
4️⃣ 臉部選擇增強

LTX-Video 是第一個基於 DiT 的視訊生成模型,可以即時產生高品質的視訊。它可以以 1216×704 的分辨率生成 30 FPS 的視頻,比觀看這些視頻的速度還快。該模型在多樣化影片的大規模資料集上進行訓練,可以產生具有逼真和多樣化內容的高解析度影片。模型支援文字轉圖像、圖像轉影片、基於關鍵影格的動畫、影片擴充(正向和反向)、影片轉影片以及這些功能的任意組合。
LTX-Video 是第一個基於 DiT 的視訊生成模型,可以即時產生高品質的視訊。它可以以 1216×704 的分辨率生成 30 FPS 的視頻,比觀看這些視頻的速度還快。該模型在多樣化影片的大規模資料集上進行訓練,可以產生具有逼真和多樣化內容的高解析度影片。模型支援文字轉圖像、圖像轉影片、基於關鍵影格的動畫、影片擴充(正向和反向)、影片轉影片以及這些功能的任意組合。
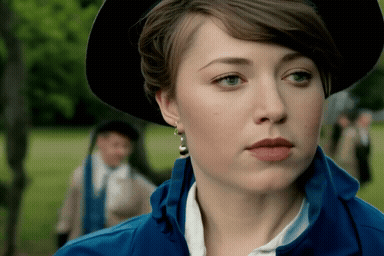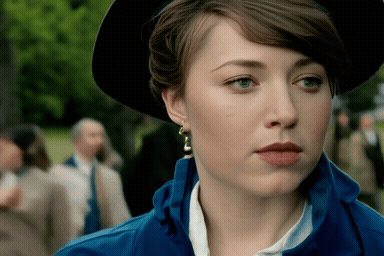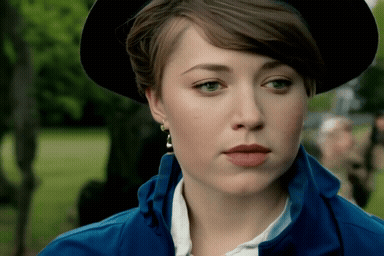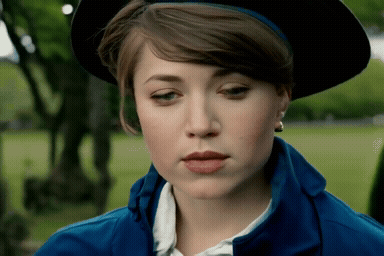
Skywork 是一個創新的研究團隊,致力於推動 LLM 和多模式理解。它們的使命是透過視覺和語言開發並實現無縫互動的尖端模型和資料集來突破人工智慧的界限。模型支援文字到視訊(T2V) 和圖像到視訊(I2V) 任務,並且可以在同步和非同步模式下進行推理。 影片長度限制的突破:雖然像 LTXV 和 HuanYun 等模型在速度或品質方面表現出色,但它們通常限制生成約 5 到 10 秒的短片。Frame pack 可以生成高達 60 秒的高品質影片,但 60 秒是其最大長度。Skyreels V2 透過其稱為「擴散強制 (diffusion forcing)」的技術,可以讓您生成長達 60 秒甚至可能更長的影片。技術上,擴散強制模型可以透過不斷訓練一個擴散強制取樣器並在最後組合每個結果來無限延長影片長度。
Skywork 是一個創新的研究團隊,致力於推動 LLM 和多模式理解。它們的使命是透過視覺和語言開發並實現無縫互動的尖端模型和資料集來突破人工智慧的界限。模型支援文字到視訊(T2V) 和圖像到視訊(I2V) 任務,並且可以在同步和非同步模式下進行推理。
影片長度限制的突破:雖然像 LTXV 和 HuanYun 等模型在速度或品質方面表現出色,但它們通常限制生成約 5 到 10 秒的短片。Frame pack 可以生成高達 60 秒的高品質影片,但 60 秒是其最大長度。Skyreels V2 透過其稱為「擴散強制 (diffusion forcing)」的技術,可以讓您生成長達 60 秒甚至可能更長的影片。技術上,擴散強制模型可以透過不斷訓練一個擴散強制取樣器並在最後組合每個結果來無限延長影片長度。

FramePack 是一種新的視頻擴散設計,用壓縮上下文令工作量不會隨著影片的長度而增加,只需一張圖片,就可以令你的 6GB vRAM 的電腦透過 13B 模型生成每秒 30 格影片的 60 秒影片。而用 RTX 4090 的話,最快速度為每格 1.5 秒。 作者 Lvmin Zhang
FramePack 是一種新的視頻擴散設計,用壓縮上下文令工作量不會隨著影片的長度而增加,只需一張圖片,就可以令你的 6GB vRAM 的電腦透過 13B 模型生成每秒 30 格影片的 60 秒影片。而用 RTX 4090 的話,最快速度為每格 1.5 秒。
作者 Lvmin Zhang

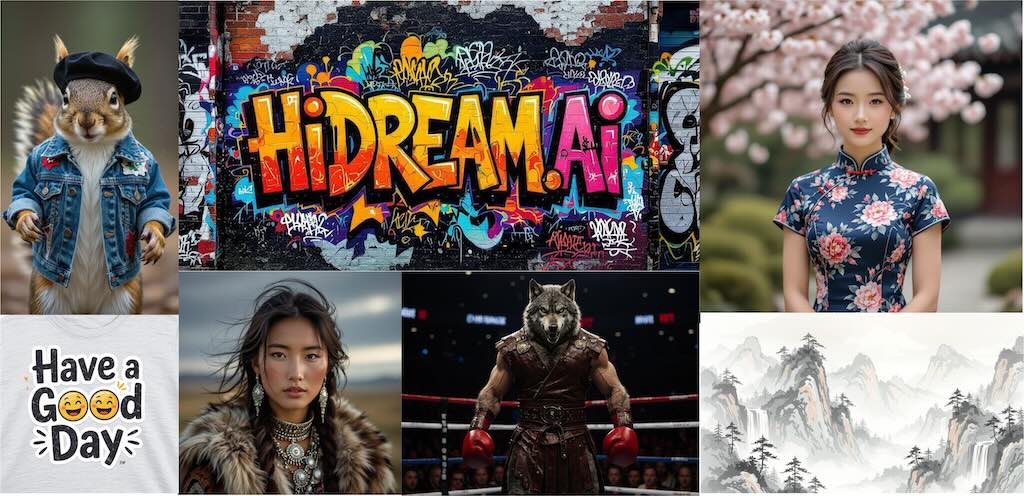
北京的 AI 初創公司 HiDream (智象未來),剛剛推出了開源 170 億參數的文生圖模型,性能比 FLUX 更為出色。甚至已經在模型排行榜入面升上第二位。而由它生成出來的人物質感、結構、邏輯都非常之唔錯。甚至生成英文文字的準確性同排版能力亦相當之高。除了提供開源版本,亦提供了網上測試同商業版本。