Lance:一個模型包辦圖像與影片

Lance 把理解、生成與編輯放進同一個多模態框架。對想同時處理圖片與影片的人來說,方向相當清晰。

Lance logo

Lance 是 ByteDance 推出的 3B 級多模態模型,重點不只是「識圖」,而是把圖片與影片的理解、生成、編輯放在同一套框架內處理。對一般讀者來說,最易明白的價值是:同一個專案可應付多種視覺工作,不用為每個任務分開找不同模型。

Lance 可處理的任務包括文字生成圖片、文字生成影片、圖片編輯、影片編輯,以及由圖片或影片輸出文字說明。環境方面需要 Python 3.10+、CUDA 12.4+,推理亦要至少 40GB VRAM 的 GPU,較適合有工作站或伺服器資源的團隊先做測試,再按任務修改預設參數與樣本配置。

它較有意思的地方,在於用 3B active parameters 去覆蓋多種視覺任務,並強調由零開始訓練,加上分階段的多任務訓練方法。這代表它的設計方向不是只追單一指標,而是希望不同任務之間互相帶動,令圖片與影片能力更集中在同一模型內。

  • 支援的任務範圍廣:t2i、t2v、image edit、video edit、x2t image、x2t video
  • 模型規模屬 3B,但官方稱在多項圖片與影片基準上表現不俗
  • 重點是統一框架,減少多模型切換的複雜度
  • 推理硬件門檻不低,較適合研究、內容工具開發及企業試驗

合適視覺 AI 研究、內容製作流程整合、需要同時處理圖像與短片的原型系統。相關模型方向可留意文字轉圖片、文字轉影片、影像編輯、影片編輯,以及視覺轉文字這幾類;Lance 的特點正是把這些能力盡量收攏到同一個模型體系之中。

GitHub: https://github.com/bytedance/Lance

Paper: https://arxiv.org/pdf/2605.18678

Categories: 開源, 字節跳動, 影像模型, 影像處理

LongLive:長片段影片生成再快一步

LongLive 專注解決長影片生成的速度與記憶體壓力,重點放在更長、更連貫的輸出流程。它同時照顧訓練與推理效率,方向相當清晰。

LongLive2.0 logo

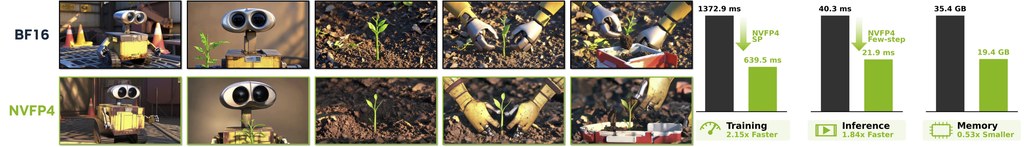
LongLive 係 NVIDIA NVLabs 針對長影片生成提出的基礎設施,核心目標唔係單純「整到片」,而係令模型喺處理長時間、多鏡頭內容時,冇咁易被記憶體同速度拖慢。由 1.0 強調即時互動式生成,到 2.0 加入 NVFP4 平行化設計,重點已經擴展到訓練、蒸餾同推理全流程。

實際使用時,較自然嘅路線係先睇示範頁同文件,了解佢點樣接收連續提示詞,再按需要選擇 BF16 或 NVFP4 模型版本。現有公開模型包括 LongLive-2.0-5BLongLive-2.0-5B-NVFP4-S4,而較早期分支亦有 LongLive-1.3B,方便分別比較畫質、速度同硬件需求。

呢個專案最值得留意嘅地方,在於佢唔只優化生成結果,仲直接處理長影片常見樽頸,例如 KV cache 佔用、跨卡通訊、以及多鏡頭自回歸生成時嘅效率問題。資料顯示,2.0 版本支援多鏡頭或單鏡頭訓練、序列平行推理、非同步解碼,同時可用較低精度格式減少記憶體開銷;論文亦提到訓練與推理速度都有明顯提升,但實際表現仍要視乎 GPU 架構而定。

  • 支援長影片、多鏡頭連續生成,方向比一般短片生成更明確
  • 提供 BF16NVFP4 版本,方便按硬件取捨
  • 針對訓練與推理一齊優化,唔係只顧其中一端
  • 包含序列平行、KV cache 量化、非同步解碼等工程設計
  • 適合研究人員、影片生成開發者,同埋需要評估部署效率嘅團隊

整體來講,LongLive 比較似一個面向進階影片生成工作流嘅「引擎室升級」,特別適合關注長片段敘事、互動式生成,或者想研究多鏡頭影片模型點樣落地嘅人。對一般讀者而言,最容易理解嘅價值就係:佢嘗試用更慳資源、更快嘅方式,令 AI 生成長影片唔再只停留喺概念展示。

GitHub: https://github.com/NVlabs/LongLive

Paper: https://arxiv.org/pdf/2605.18739

Categories: 開源, NVIDIA, 影像模型

Flash-GRPO:影片生成訓練再提速

這個專案聚焦影片擴散模型對齊訓練,用更省資源的方法換來更快效率。對研究型團隊尤其值得留意。

LOGO

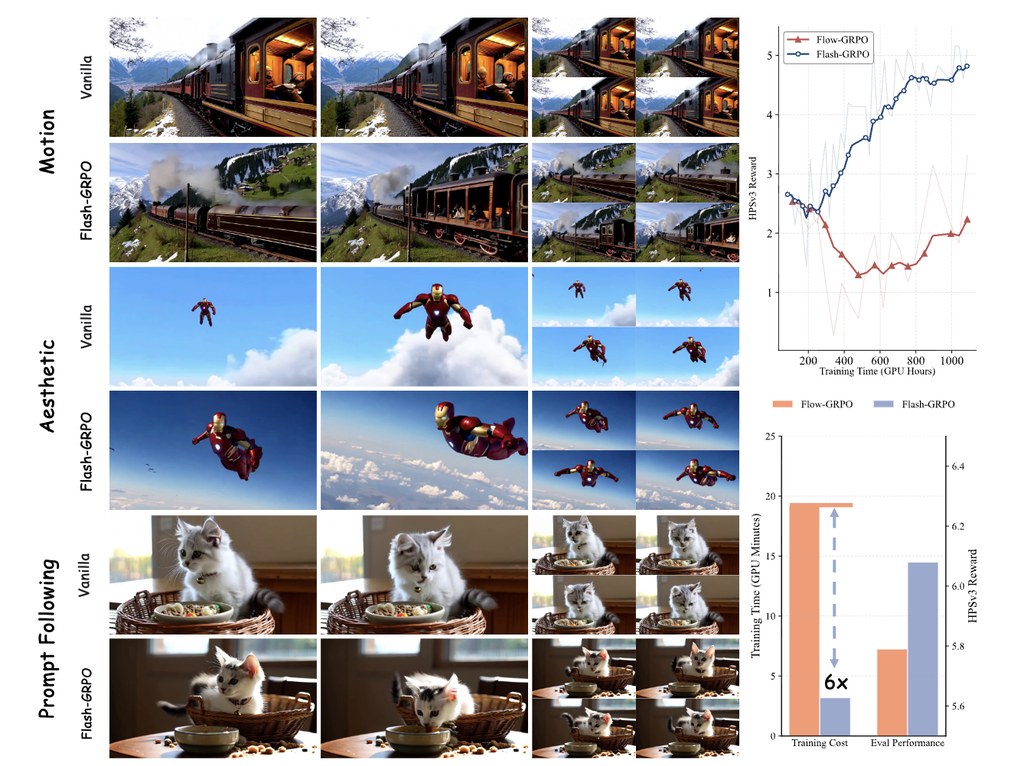
Flash-GRPO 針對的是影片生成模型訓練中一個很實際的難題:要令模型更貼近人類偏好或評分標準,傳統做法往往要走完整訓練軌跡,計算量高、時間長,對硬件要求亦相當重。這個專案提出單步式優化框架,重點是用較低運算預算,換取更有效率的對齊效果。

從公開資料來看,它主要面向影片擴散模型,並配合獎勵模型一同使用。實際動手時,需要先準備基礎模型 Wan2.1-1.3B,以及 README 提到的 HPSv3 獎勵模型,再按專案提供的訓練流程啟動;現階段較適合已熟悉 Python、分散式訓練和 GPU 環境的人直接試跑。

這個方法較有意思的地方,在於它不只是「少做步驟」,而是嘗試處理時間步之間訓練訊號不穩定的問題。README 提到兩個核心設計:一個是維持同一提示詞在時間上的一致性分組,另一個是修正不同時間步梯度尺度不一致的情況,目標是令訓練更穩定,也更容易比較模型表現。

  • 主打影片擴散模型的對齊訓練,而非一般文字模型微調
  • 強調單步式策略優化,方向上比完整軌跡訓練更省資源
  • 已在 1.3B 到 14B 規模模型做實驗驗證
  • 相關基礎組件,包括 Wan2.1-1.3BHPSv3

整體來說,Flash-GRPO 比較適合做生成式 AI 研究、影片模型訓練優化,或想評估低成本對齊方案的團隊。對一般用家而言,它不是即裝即用的成品;但對需要在有限 GPU 預算下提升訓練效率的人,這個專案展示了一條相當值得關注的技術路線。

GitHub: https://github.com/Shredded-Pork/Flash-GRPO

Paper: https://arxiv.org/pdf/2605.15980

Categories: 開源, 清華大學, 影像模型, 中國

PhysBrain-VLA:教機械人先懂物理常識

全球首個物理智能數據引擎,將海量人類視頻轉化為多模態大模型訓練數據

Repository image for Phys-Brain/PhysBrain-VLA

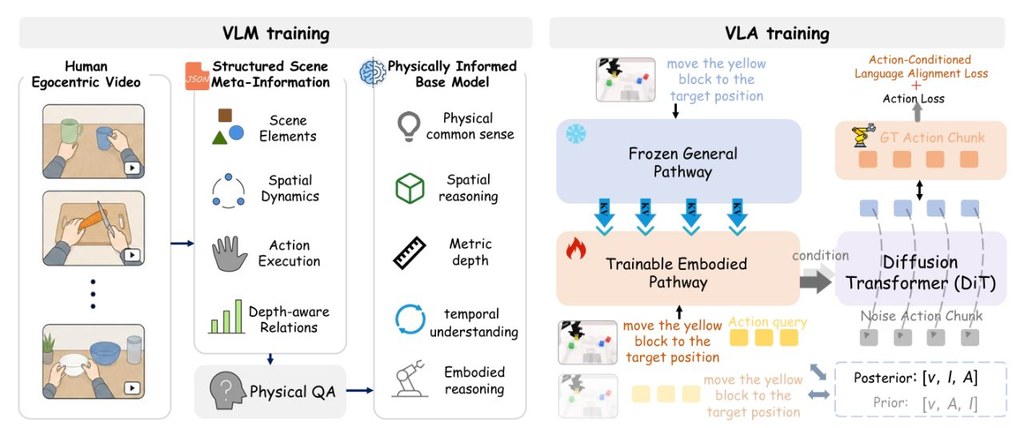
PhysBrain-VLA 係一個面向機械人控制的研究專案,但它最值得留意的地方,其實係訓練思路改變咗。以往不少系統主要靠機械人示範資料學動作,成本高之餘,遇到新場景亦未必識變通;而呢個專案就主張先由大量人類第一身影片抽取「物理常識」,再轉化畀模型學習。

對一般讀者嚟講,可以將它理解為:與其死記「點樣拎起杯」,不如先明白杯喺枱上、手要接近、物件有前後高低關係,甚至某些動作做唔做到。根據公開資料,團隊處理咗超過 3,000 小時人類影片,並整理成包含空間關係、動作可行性同推理線索的多模態訓練資料。

如果你想上手理解這個專案,較實際的方法唔係直接當成即裝即用工具,而係先由它的整體架構入手:先看資料引擎點樣把影片轉成結構化訊息,再看基礎模型如何吸收這些知識,最後理解 VLA 部分點樣把理解能力轉成機械人動作。對研究員、機械人開發者,或者關心 embodied AI 發展方向的人,呢個閱讀路線會比較清晰。

  • 核心價值係減少對昂貴機械人示範數據的依賴
  • 主要做法係由人類第一身影片提煉物理與空間常識
  • 架構包含 PhysBrainTwinBrainVLALangForce
  • 提到的評測包括 ERQA、PhysBench、SimplerEnv-WidowX、LIBERO、RoboCasa

其中較有新意的是 TwinBrainVLA 的雙腦式設計,目標是減輕微調後「學咗新嘢就忘記舊嘢」的問題;LangForce 則把訓練重心由單純模仿行為,轉向較貼近物理推理的學習方式。從論文摘要來看,它在多個理解與控制評測都有強表現,尤其在陌生環境的泛化能力方面值得關注。

整體而言,PhysBrain-VLA 未必係面向普通用家的產品型專案,但作為技術方向,它展示咗一條幾實際的路:先讓模型理解世界,再叫它出手做事。若你想追蹤未來機械人如何由「照做」走向「識判斷」,這個專案相當有參考價值。

Project Page:  https://phys-brain.github.io

網址: https://github.com/Phys-Brain/PhysBrain-VLA

網址: https://arxiv.org/pdf/2605.15298

Categories: 開源, 模型, 視覺模型, 影像模型, Robotic, 中國

PAGER 提升 GUI 操作介面準確度

呢項研究聚焦AI喺幾何畫布上嘅精準點擊難題,並提出新基準同方法縮窄「識做」同「做到」之間嘅落差。

pager icon v3

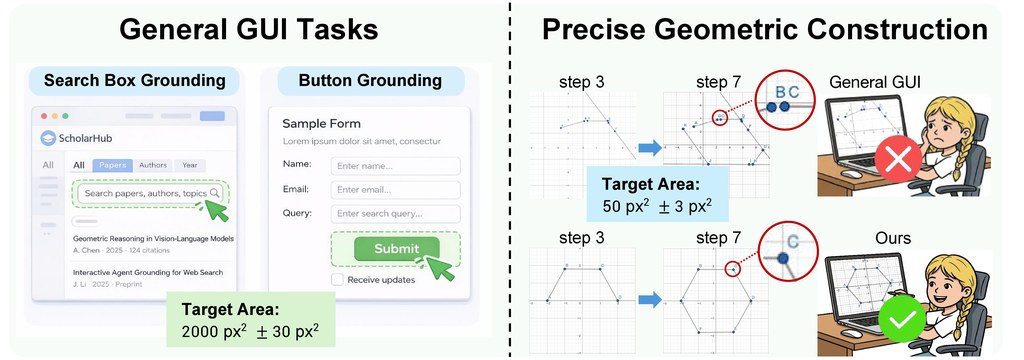
而家好多 GUI 智能代理都已經識得喺網頁、手機同桌面介面按掣、輸入文字,但呢類能力多數建立喺「大概撳中就得」嘅情況。呢篇研究處理嘅,係另一種要求高好多嘅環境:喺幾何畫布上落點,少少座標偏差都可能令之後所有圖形關係出錯。

研究團隊將呢類任務界定為對精度非常敏感嘅介面操作,並提出 PAGE Bench 作為評測基準,包含 4,906 條題目,同超過 22.4 萬個帶有過程監督嘅像素級操作資料。對一般讀者嚟講,可以理解為:研究者唔單止睇最後畫啱未,仲會逐步記錄每一下應該點做,方便訓練同評估模型。

為咗應付呢個問題,團隊提出 PAGER。佢會先按幾何物件之間嘅依賴關係做規劃,再執行像素級操作;另外再配合針對精準度嘅強化學習,用當前畫面狀態同幾何回饋去修正行為。簡單講,佢唔只係「認得要畫咩」,而係更著重「每一步要落喺邊個點」。

重點可以歸納為:
– 針對連續畫布上嘅落點操作,而唔係一般按鈕式介面
– 建立咗 PAGE Bench,專門量度像素級幾何控制能力
– 指出多模態模型存在明顯落差:理解指令未必代表真係做到
– PAGER 透過結構化規劃同幾何回饋,提升實際完成率

實驗結果亦幾有代表性。論文指出,一般多模態模型即使喺動作類型判斷上可超過 88% 準確率,整體任務成功率仍低於 6%,反映「語意理解」同「可執行操作」之間有明顯鴻溝;PAGER 就將任務成功率提升到最強通用基線嘅 4.1 倍,步驟成功率亦由不足 9% 提升到超過 62%。如果你關注 AI 代理、自動化操作,或者需要處理 CAD、教學幾何、精密繪圖等場景,呢項工作值得留意。

由應用角度睇,PAGER 特別適合用喺幾何教學軟件、自動作圖代理,同需要高精度圖形互動嘅研究場景。相比只判斷「有冇撳中元件」嘅方法,佢更重視座標、半徑、端點等連續參數,對處理精細圖形操作更有參考價值。

網址: https://openraiser.github.io/Pager-webpage/

Categories: 開源, 影像模型, 中國, Dataset 數據集

DepthVLM:識睇圖又識估距離

DepthVLM 想將影像理解同深度估算合二為一,兼顧速度與實用性。對想做 3D 視覺應用的人,幾值得留意。

DepthVLM Logo

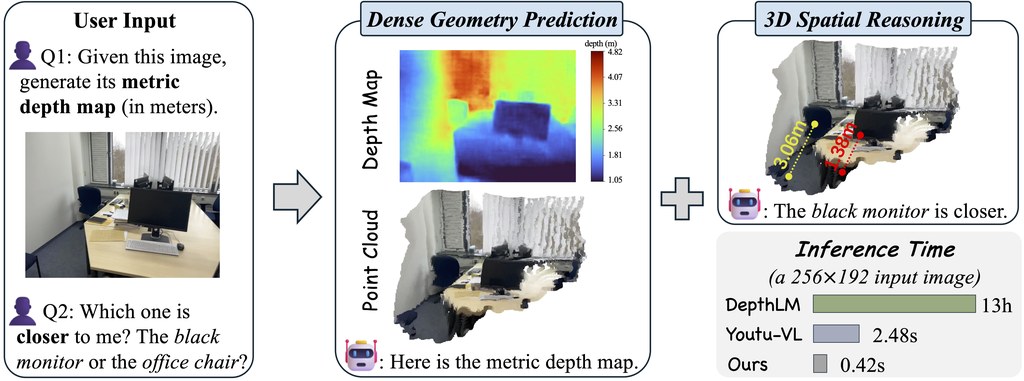
如果你曾經好奇電腦點樣由一張相片判斷物件有幾遠,DepthVLM 就係一個幾有代表性的答案。呢個專案主打由單張圖片直接輸出具實際尺度的深度資訊,同時保留問答、理解畫面內容等多模態能力,唔係只做單一視覺任務。

對一般開發者而言,上手方向算清晰:程式碼、模型權重同基準資料都已有公開入口,亦提供示例視覺化結果方便先睇效果。要留意資料本身受授權限制,作者未有直接派發整理後全集,但有公開資料整理流程,較適合願意自己重現訓練或評估的人。

佢較特別之處,在於唔需要將「睇圖理解」同「估深度」拆開做。論文資訊顯示,DepthVLM 會喺單次推理中同時產生深度圖與文字輸出,並以輕量模組接到語言模型骨幹上,速度亦比同類 VLM 方案如 DepthLMYoutu-VL 更快。

如果你做機械人、AR/VR、室內導航,或者想研究影像中的 3D 空間推理,呢類模型特別有價值。從公開內容看,相關比較對象包括 DepthLM-12BYoutu-VL-4BInternVL3.5-38B,以及偏純視覺路線的 Depth Anything V3UniDepth V2Metric3D v2Depth ProZoeDepth

  • 一個模型兼顧畫面理解與深度預測
  • 可輸出具米制尺度的稠密深度圖
  • 推理效率強調比部分現有 VLM 更快
  • 已提供範例、模型檔與基準標註入口
  • 較適合研究、實驗同進階應用整合

整體來講,DepthVLM 吸引之處唔單止係準確度,而係它試圖將 3D 感知正式帶入視覺語言模型工作流。若你想搵一個連接「識答問題」同「識判斷空間距離」的方案,呢個專案相當值得先收藏再深入試用。

網址: https://github.com/hanxunyu/DepthVLM

網址: https://arxiv.org/pdf/2605.15876

Categories: 開源, 香港科技大學, 騰訊, 視覺模型, 影像模型

PhyMotion點樣令人物動作更似真

這個專案不是直接生影片,而是幫模型判斷人物動作是否合乎物理。對想提升人像影片自然度的人特別有參考價值。

teaser image

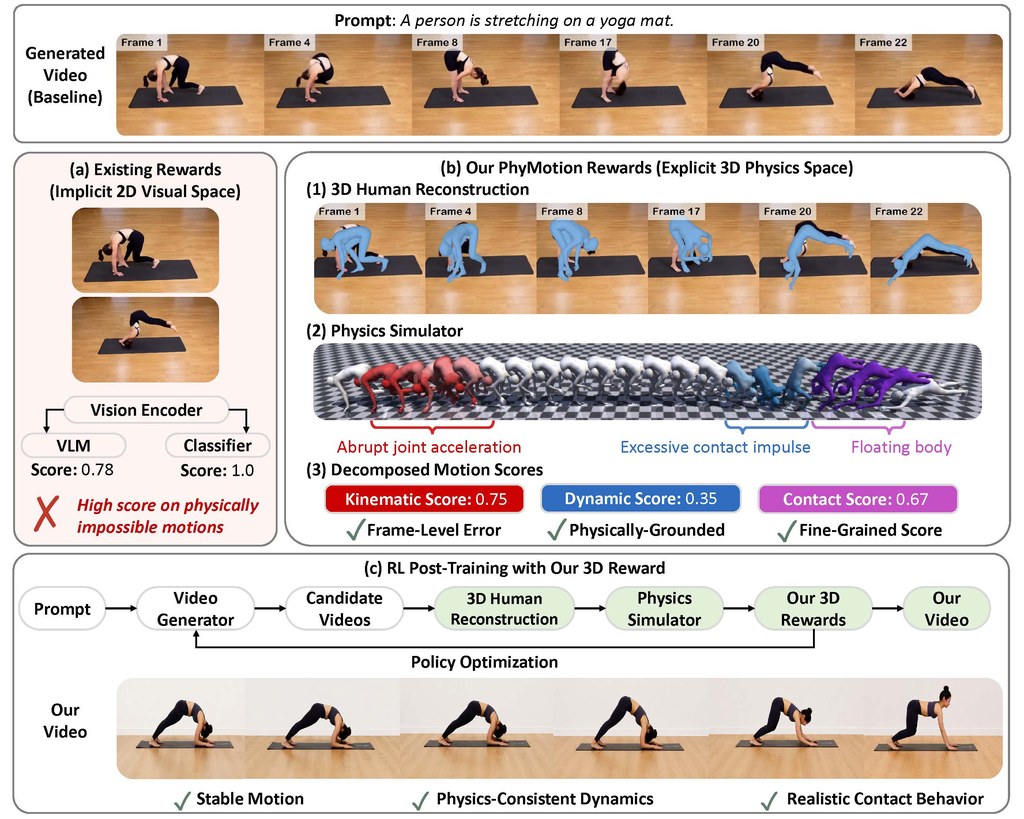
做人物影片生成,最難往往不是畫面靚唔靚,而係人郁動時有冇「似真」。PhyMotion針對的正是這個痛點:它提供一套較細緻的評分方法,專門檢查生成影片中的人體動作是否合理,例如會否出現腳步飄浮、失去平衡,或者動作雖然順眼但其實不合物理常識。

它的做法幾有意思。團隊先從影片還原出3D人體網格,使用SMPL表示身體,再把動作轉到MuJoCo的人形物理模擬環境內,從三方面評估:關節運動是否自然、接觸與平衡是否一致、以及整體動態是否可行。比起只靠2D畫面觀感打分,這種方法更能指出問題究竟出在哪一層。

如果你想上手,較合理的方式不是把它當成一般剪片工具,而是當成研究或訓練流程中的「動作評審」。儲存庫提供有 PhyMotion-CausalForcing-1.3B 相關權重與 LoRA 形式檢查點,較適合已經在做人像影片生成、後訓練或獎勵設計的人逐步接入。

  • 重點不在直接生成影片,而在替影片中的人體動作評分
  • 結合 SMPLMuJoCo,比純2D評估更重視身體結構與物理性
  • 適用於自回歸與雙向類型的影片生成訓練流程
  • 相關資源包括論文、模型、資料集,以及 PhyMotion-CausalForcing-1.3B

整體來看,PhyMotion最有價值的地方,是把「睇落順眼」進一步拆成可分析的幾個部分,令改進方向更清楚。它特別適合研究員、AI 影片開發者,或者想提升人物動作真實感的團隊;對一般用家來說,未必是即裝即用,但作為理解下一代人物影片質素點樣提升,這個項目相當值得留意。

網址: https://github.com/h6kplus/PhyMotion

Categories: 開源, 數字人, 影像模型, 影像處理

AlphaGRPO:能自我修正的多模態生成

呢個框架針對文字生圖與編輯任務,加入可驗證回饋,提升推理同自我修正能力。

Og image

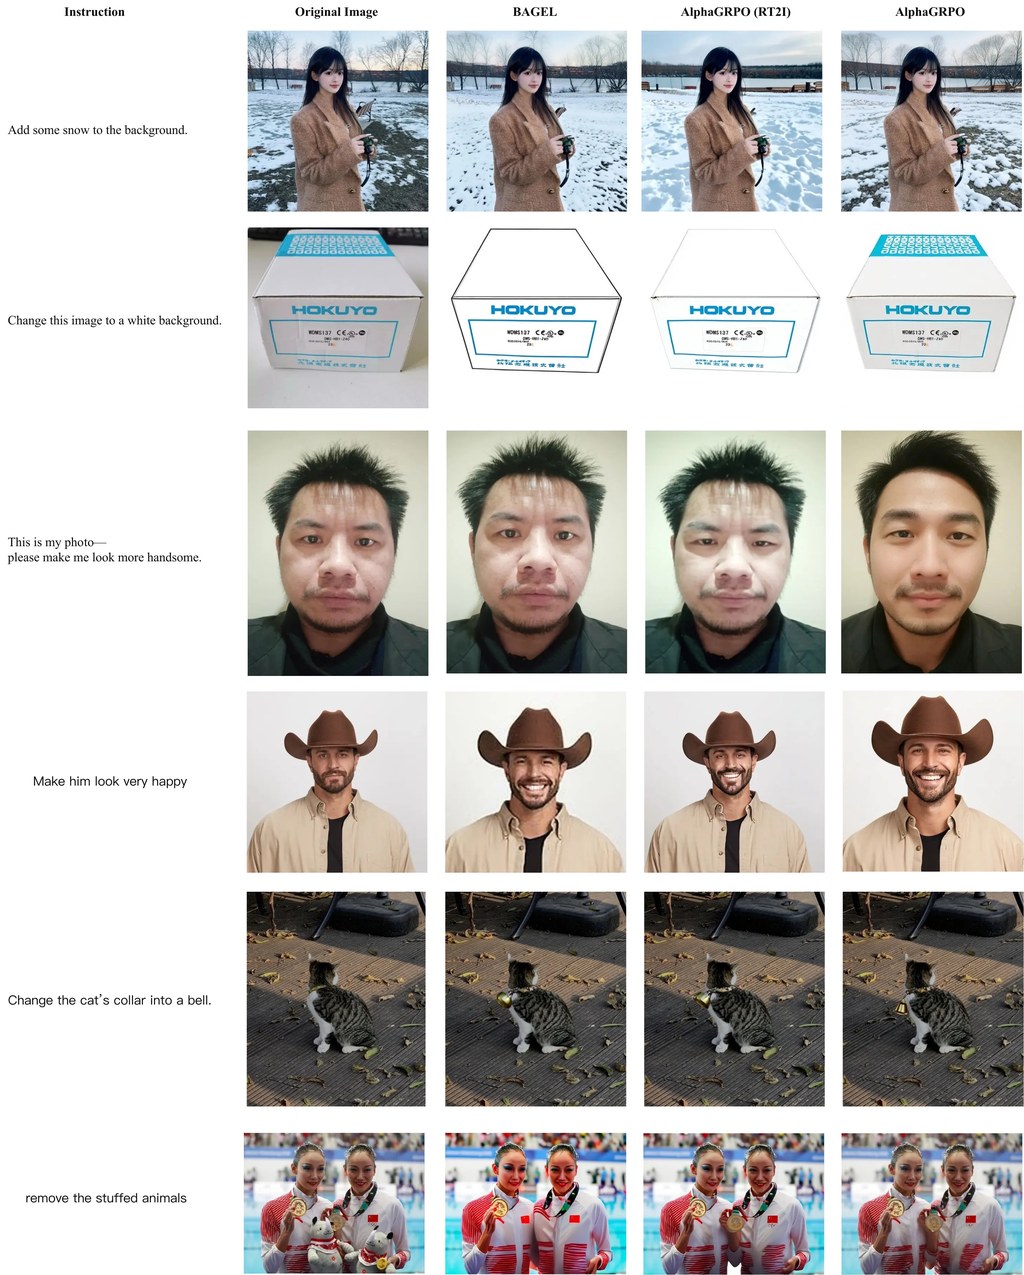
AlphaGRPO 係一個用喺原生統一多模態模型嘅訓練框架,重點係令模型唔只係「生成」,而係會根據提示主動推理,並喺輸出有偏差時嘗試自行修正。網頁內容指出,佢主要面向文字生圖同相關編輯場景,目標係改善細節理解、構圖一致性,同埋對隱含要求嘅掌握。

呢個方法特別之處,在於將 GRPO 引入 AR-Diffusion 類型嘅統一模型,而且唔需要額外 cold-start 階段。另一個核心設計係 DVReward:先將複雜指令拆成多個可核實嘅細問題,再由開源多模態模型按語意對齊同畫面品質提供較穩定、可解釋嘅回饋,避免只靠單一分數太過籠統。

如果你想理解點樣使用,概念上可以當佢係一種訓練或強化現有多模態生成模型嘅方法,而唔係一般終端用家即開即用嘅 App。較適合研究人員、模型工程師,或者需要改善文字生圖、細粒度屬性控制、影像編輯泛化能力嘅團隊參考同實作。

  • 支援推理型文字生圖,能更主動補足用家未明講嘅意圖
  • 可做自我反思式修正,生成後再檢查並調整錯配內容
  • 回饋機制較細緻,將要求拆解成可驗證項目再評估
  • 在多個生成基準上有一致進步,亦可遷移到編輯任務
  • 推論階段加入自我修正後,文中指最高可再提升 5.8%

就評估結果而言,頁面提到 AlphaGRPO 喺 GenEval、TIIF-Bench、DPG-Bench、WISE 等生成基準,以及 GEdit 編輯任務都有提升,而且編輯能力並非靠專門編輯訓練得來,反映泛化表現不俗。不過,具體效果仍應按模型底座、評測設定同實際資料而定。

訓練程式碼和模型權重目前正在進行內部審核,審核通過後將予以發布。

網址: https://huangrh99.github.io/AlphaGRPO/

Categories: 開源, 香港大學, 字節跳動, 影像模型, 影像處理, 框架

HiDream-O1-Image:一個模型包辦生圖與改圖

這個開源影像模型想用同一套架構處理生成、改圖與個人化,定位相當進取。重點是高解像度與文字、版面控制表現。
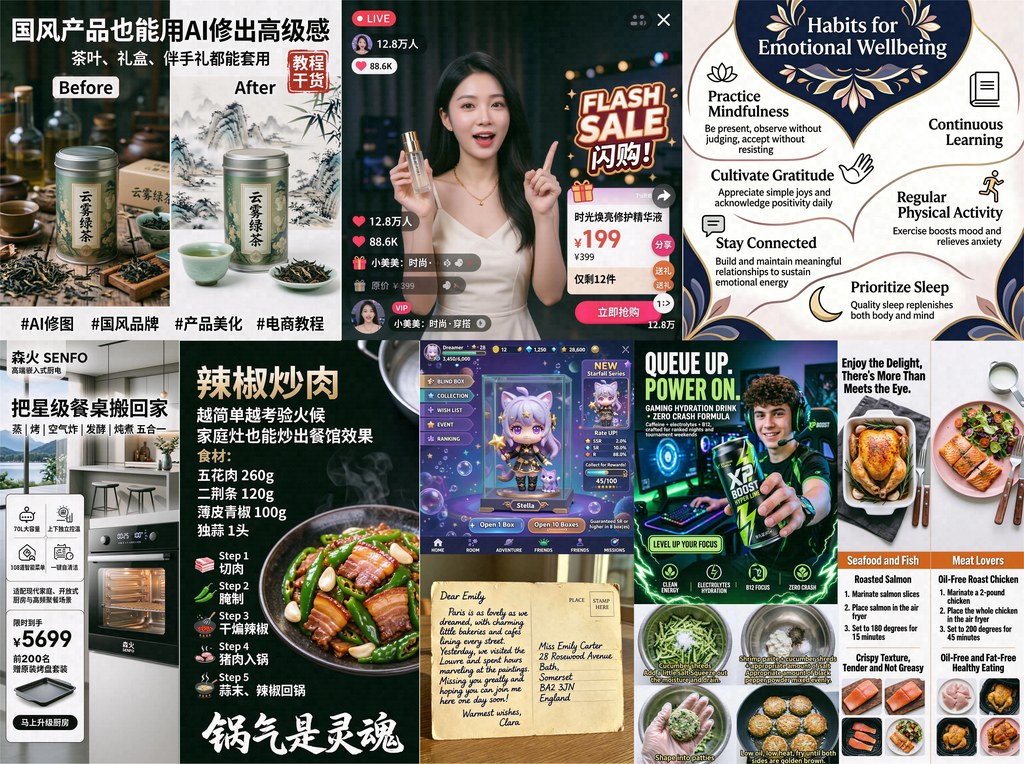
Artificial Analysis Text to Image Arena

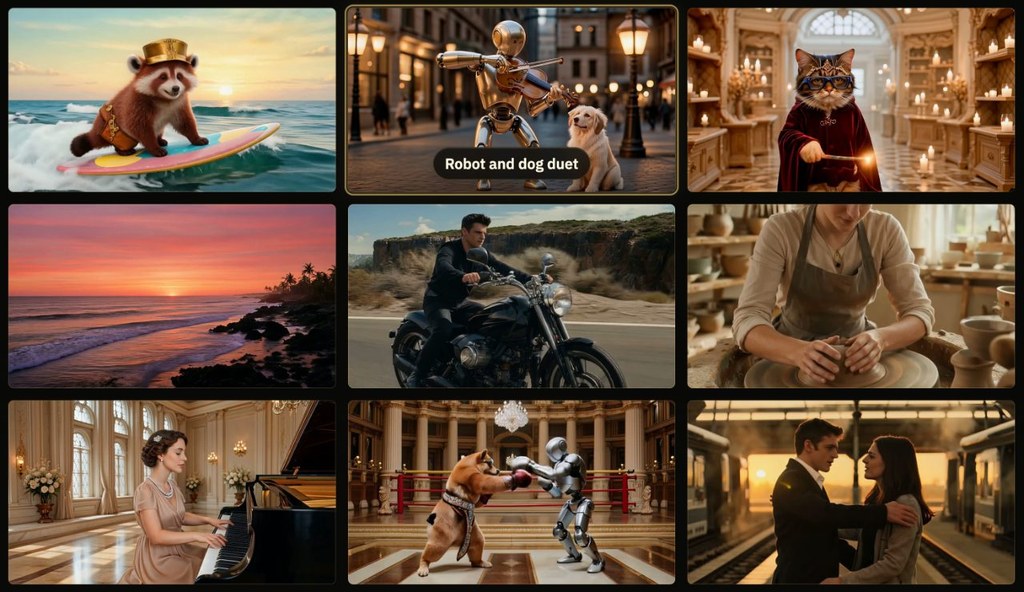
HiDream-O1-Image 是一個開源影像生成模型,主打把文字、圖片像素和不同任務條件放進同一個系統處理。對一般用家來說,可以將它理解為一個不只會「生圖」,亦能處理改圖、角色一致化,甚至長文字排版的多功能工具。

實際使用上,它較適合拿來做文字生成圖片、按指令修改現有圖片,或者用同一角色、產品去延伸出不同場景。官方亦提供 Hugging Face 上的模型與線上體驗,因此未必一定要自行搭建環境先感受到效果。

這個專案最值得留意的創新,是它採用所謂 Pixel-Level Unified Transformer,聲稱不依賴外部 VAE 或分開的文字編碼器。簡單講,即是想用更統一的方法直接理解像素與文字,理論上有助減少不同模組之間的割裂,對複雜提示、版面安排和文字渲染會更有幫助。

  • 支援text-to-image、圖片編輯、主體個人化等多種任務
  • 可原生輸出最高 2048×2048,較適合需要細節的畫面
  • 內建 reasoning-driven prompt agent,強調先處理布局與隱含需求
  • 提供 8B 規模版本,並有 distilled 與 undistilled 變體
这个模型居然没有 VAE?实测 HiDream-O1 像素级统一 Transformer 的威力

若你常做海報草圖、分鏡、品牌角色延伸,這類模型會特別實用;如果重視圖片內長文字、指定區域排版,HiDream-O1-Image 亦屬值得關注的一類。不過實際效果仍會受提示寫法、任務類型和版本選擇影響,尤其編輯任務方面,官方就建議優先考慮完整模型。

硬體需求

GPU:需要 CUDA 支援的 NVIDIA GPU 。模型本身有兩個版本 — 標準版(Full)和蒸餾版(Dev)。標準版需要 50 個推理步驟,蒸餾版則需要 28 個步驟,因此蒸餾版對硬體的需求更低。

根據社群資訊,使用 FP8 量化的蒸餾版本可以用約 10GB VRAM 的 GPU 運行 。如果使用全精度模型(Full),VRAM 需求會更高,具體取決於生成的影像解析度(最高支持 2048×2048)。

軟體依賴

安裝後需要執行 pip install -r requirements.txt 。官方強烈建議安裝 flash-attn 以優化注意力運算,如果無法安裝,則需要手動編輯 models/pipeline.py 第 291 行,將 "use_flash_attn": True 改為 "use_flash_attn": False,否則推理會失敗 。

推理模式選擇

  • Dev 模式(蒸餾版):28 步,guidance scale 為 0.0,適合資源受限的環境
  • Full 模式(標準版):50 步,guidance scale 為 5.0,品質更高但運算成本更大

網址 https://github.com/HiDream-ai/HiDream-O1-Image

網址 https://huggingface.co/HiDream-ai/HiDream-O1-Image
Categories: 開源, 模型, 視覺模型, 影像模型

AnyFlow:影片生成更靈活的一步

AnyFlow 主打「任意步數」影片生成,同一模型可兼顧速度與畫質。對想試文字轉影片的人來說,方向相當實際。

Repository image for nvlabs/AnyFlow

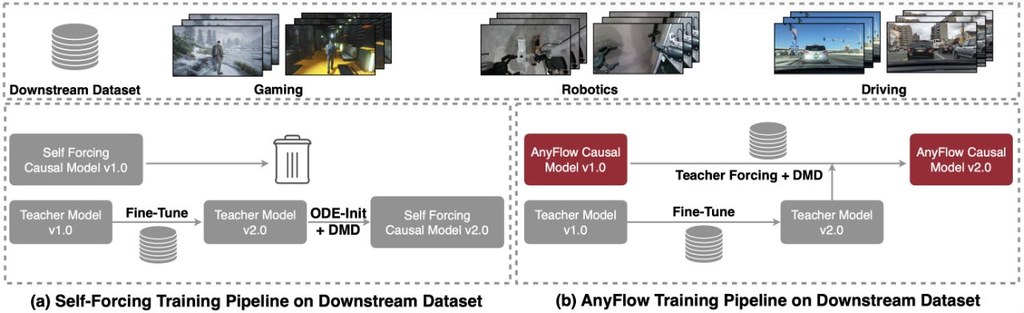
AnyFlow 是 NVIDIA Labs 推出的影片擴散框架,重點不是單純把片生出來,而是讓同一個模型可按你手上的運算時間,自由調整推理步數。簡單講,趕時間時可以用較少步數先出結果;有更多資源時,再加步數換取更穩定的細節表現。

實際使用上,它較適合研究員、開發者或內容生成團隊,用來測試文字轉影片、圖片轉影片,以及影片轉影片。README 顯示它已有示範程式和預訓練模型,代表使用者可直接下載模型試效果,而不一定要由零開始訓練。

這個專案較有新意的地方,是把傳統常見「固定步數」的限制放寬,做成 any-step 生成。對非專業人士來說,可理解為同一套引擎在快出片與慢慢精修之間更有彈性,而不是每種速度都要換另一個模型。

  • 支援 Text-to-Video、Image-to-Video、Video-to-Video
  • 可配合不同推理步數,平衡速度與質素
  • 涵蓋 causalbidirectional 影片擴散架構
  • 已驗證可擴展到 1.3B 至 14B 參數級別

若你要做社交媒體短片原型、廣告分鏡視覺化,或研究影片生成流程,AnyFlow 的定位相當清晰。相關模型方面,README 提到可找到 AnyFlow-FAR-Wan2.1-1.3B-Diffusers、AnyFlow-FAR-Wan2.1-14B-Diffusers、AnyFlow-Wan2.1-T2V-1.3B-Diffusers、AnyFlow-Wan2.1-T2V-14B-Diffusers;名稱反映它既有偏研究框架,也有文字轉影片版本。整體來看,這不是一般即開即用的消費級工具,但對需要靈活控制生成成本與效果的人,確有參考價值。

Source: https://github.com/nvlabs/AnyFlow

Categories: 開源, 模型, 視頻模型, NVIDIA, 影像模型

Page 5 of 12
1 3 4 5 6 7 12