DRDD:用兩階段拆解擴散模型,更省數據的圖像轉譯方案

港大團隊提出的 DRDD 把擴散過程拆成兩段獨立階段,統一處理多種圖像修復任務,並在配對數據有限時仍維持穩定表現。

Main figure

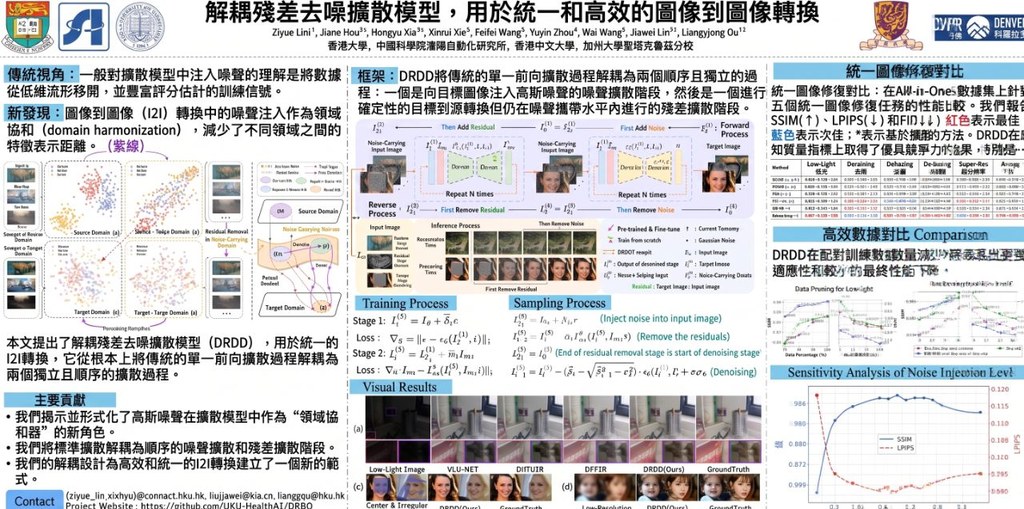
圖像到圖像轉譯(Image-to-Image Translation, I2I)涵蓋去雨、去霧、低光增強、去噪、去模糊等多種任務,傳統做法往往需要為每個場景單獨訓練模型。HKU-HealthAI 提出的 Decoupled Residual Denoising Diffusion models(DRDD)嘗試用一套架構同時處理這些任務,並減少對大量配對數據的依賴。

DRDD 的核心做法是把擴散過程拆成兩個獨立階段:第一階段負責加入雜訊,達到所謂的「域調和」(domain harmonization)與流形抬升(manifold lifting);第二階段則在固定雜訊下做決定性的殘差擴散,專注學習語意對應。這種解耦設計避免了傳統擴散模型在去噪過程中提早耗散域調和效果的問題,因此能在一個模型內統一處理多個修復任務。

由於第一階段的雜訊擴散只使用目標域的非配對圖像訓練,DRDD 在配對數據稀缺時仍能保持表現,這對醫療影像或特殊場景數據蒐集成本高的領域特別有用。團隊在 all-in-one-5 設定下測試,涵蓋 Rain100L、GoPro、Dehaze、CBSD68 與 LOL 等數據集,並使用 LPIPS 等指標評估。論文亦提供理論與實證分析,說明其設計相容於主流擴散模型架構。

這個項目適合從事圖像修復、影像增強或風格轉換的研究者與工程師,尤其關心多任務統一、數據效率的團隊。使用前需要 Linux 環境、NVIDIA GPU、Python 3.7 以上,以及 Conda。預訓練權重可從 Quark 或其他途徑取得,並依說明放入 ./pretrained_models 目錄。

重點摘要:
– 將擴散拆成「雜訊擴散」與「殘差擴散」兩階段,保留域調和效果。
– 支援去雨、去霧、低光、去噪、去模糊等多種 I2I 任務的統一訓練。
– 第一階段僅用非配對目標域數據,降低對配對樣本的依賴。
– 相容主流擴散模型,可作為插件式改良方向。
– 適合醫療影像、遙測或數據稀缺場景的研究團隊。

DRDD 已在 GitHub 公開代碼與數據集結構,鼓勵社群以現有擴散骨幹(如 DDPM 系列)進一步測試與延伸。
GitHub: https://github.com/HKU-HealthAI/DRDD

Paper: https://arxiv.org/pdf/2606.01048

Categories: 開源, 香港中文大學, 香港大學, 模型, 視覺模型, 影像模型, 影像處理, Dataset 數據集

Lumos-Custom:DAMO 學院的影片生成套件

阿里巴巴達摩院(DAMO)開源的影片定制研究項目,涵蓋主體個性化生成、影像重新打光,以及推理驅動的統一影片生成框架。

ETV task prompt

Lumos-Custom 是阿里巴巴DAMO 學院的開源影片定制研究合集,把三個子項目整合在同一個儲存庫,方便研究者各自取用。三個子項目分別對應不同的影片生成難題:身份與屬性定制、打光控制,以及結合推理的統一生成。

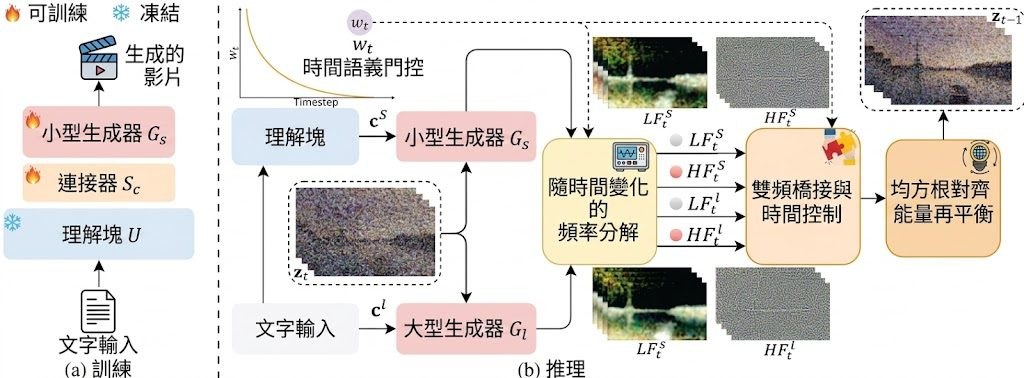
其中最受關注的是 Lumos-Nexus (arXiv 2605.31603)。它解決了一個長期痛點:把大型高保真生成器放進統一訓練迴圈成本太高,改為訓練一個輕量的連接器對齊理解模組,再用「Unified Progressive Frequency Bridging (UPFB)」在推論時把任務交接給預訓練的高容量生成器,既省訓練資源又保留視覺品質。為了補足推理類影片生成的評測空白,作者還發布了 VR-Bench

第二個項目是 LumosX,已被 ICLR 2026 接收。它的切入點是「多主體個性化影片生成」:先用字幕與 MLLM 抽取的先驗建構關係結構,再透過 Relational Self-Attention 與 Relational Cross-Attention 編碼主體與屬性之間的依賴。評測資源集中在 LumosX/benchmark/,權重已上傳 Hugging Face。

第三個項目是 UniLumos(NeurIPS 2025),專注於圖像與影片的統一重新打光,採用 RGB 空間幾何回饋配合 flow-matching 主幹,適合需要控制光影的研究與應用場景。

總結要點:

  • ** DAMO 是 Discovery, Adventure, Momentum and Outlook
  • Lumos-Nexus:輕量訓練搭配 UPFB 頻率交接,兼顧推理品質與視覺保真度
  • LumosX:以關係式注意力處理多主體個性化生成,附 benchmark 與 Hugging Face 權重
  • UniLumos:統一圖片與影片重新打光,採用 flow-matching 與幾何回饋
  • VR-Bench:補上推理驅動影片生成的評測缺口
  • 子項目獨立部署:每個子項目都有獨立 README,支援單獨安裝與重現

這個項目適合研究影片生成、多模態統一模型與個性化生成的研究者與工程師。如果你想驗證 Lumos-Nexus 的推理影片效果,可進入 Lumos-Nexus/ 跟隨 README 取得 OmniVideo 權重並跑批次推論;想評測打光則可參考 UniLumos 提供的流程。

✧ Repository layout ✧

Lumos-Custom/
├── README.md                 # This file: umbrella overview
├── LumosX/                   # ICLR 2026 · personalized multi-subject video generation
│   └── README.md
├── UniLumos/                 # NeurIPS 2025 · unified relighting + LumosBench/
│   ├── README.md
│   └── LumosBench/
└── Lumos-Nexus/              # arXiv preprint · reasoning-driven unified video generation + VR-Bench
    ├── README.md
    └── vr_bench_eval/

GitHub: https://github.com/alibaba-damo-academy/Lumos-Custom

項目: https://jiazheng-xing.github.io/nexus-lumos-home/

Categories: 開源, 香港科技大學, 清華大學, 阿里巴巴, 視頻模型, 影像模型

minWM:由影片生成走向 World Model

minWM不是單一模型,而是一套由資料到推理的 World Model 框架。它特別照顧初學者,也兼顧研究與改造彈性。

Repository image for shengshu-ai/minWM

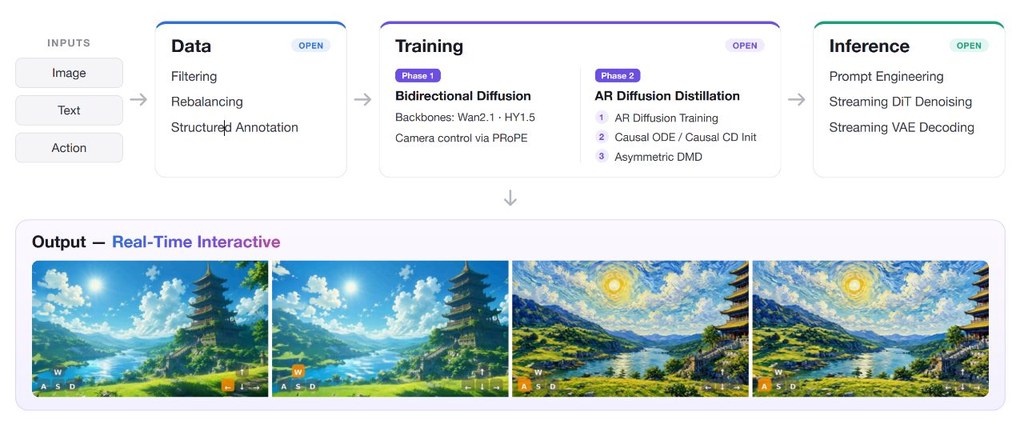
minWM 的定位很清楚:它不是再提供一個新模型,而是把建立 video world model 的整條流程拆開,讓人由 bidirectional T2V(Text-to-Video)或 TI2V(Text-and-Image-to-Video)基礎模型,一步步轉成 action-conditioned video world model。對剛接觸這個領域的人來說,這種完整路線比只放權重或單段程式碼更有幫助。

這項目重點不是「裝完即用」,而是按它提供的資料處理、訓練、蒸餾與推理流程逐段走。項目公開了 data → training → inference 的全流程,並提供 example data、runnable scripts、Claude Skills 與新手知識整理,方便你先跟一次標準流程,再按自己需要改 backbone、資料分佈或控制方式。

它要解決的問題,在於高質影片生成模型未必等同可互動的 world model。要做到低延遲、可因果 rollout、可回應鏡頭軌跡等操作,背後需要 camera control、autoregressive training、few-step distillation 及 streaming inference 等整套機制;minWM 正是把這些環節模組化,並用 Causal Forcing、Causal Forcing++、Teacher Forcing 與 asymmetric DMD 串連起來。

  • 支援 4-step DMD inference,並提到 multi-GPU sequence parallelism
  • 可用 pose strings 或 JSON 檔控制 camera trajectory
  • 提供 debug-world-model,整理 loss NaN、jitter、camera drift 等常見失敗模式
  • 提供 integrate-new-backbone,示範怎樣接入新的 video DiT
  • 參考 backbone 包括 Wan2.1-T2V-1.3B、HY1.5-TI2V-8B,亦提到 HY Action2V、HY TI2V、Wan Action2V

項目的新意在於它同時處理「怎樣訓練」與「怎樣改造」。除了支援不同 backbone 與 condition injection 方式,也把團隊累積的排錯經驗與 Claude 協作流程寫進項目,令研究者或工程人員不只看到結果,還能理解常見錯誤從哪裡出現。

它的目標是 real-time interactive video world models,並附有對 camera trajectory quality、controllability training steps、minimal batch-size requirements 的實驗分析。不過公開資訊較偏向框架與流程,若你想比較單一模型跑分,這個項目更適合當作建立、重現及擴展 World Model 的工作底座。

GitHub: https://github.com/shengshu-ai/minWM

Categories: 開源, 香港科技大學, Agentic, 模型, 視覺模型, 視頻模型, 世界模型, 模型訓練, 影像模型, 影像處理, 框架

CollectionLoRA:把多個效果 LoRA 濃縮成一個

把 50 甚至 180 個效果 LoRA 集中到單一 LoRA,減少部署成本,也降低多重 adapter 疊加帶來的干擾。

Repository image for Qwen-Applications/CollectionLoRA

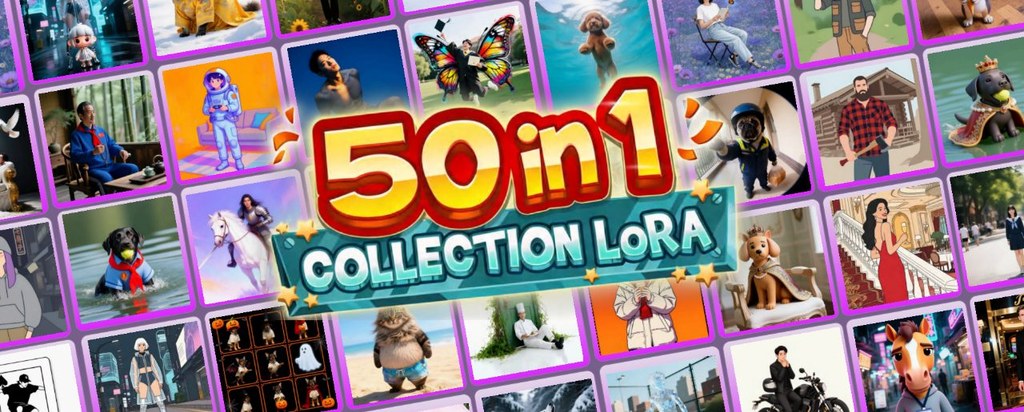
CollectionLoRA 是一個針對 LoRA 管理成本而設的項目,核心做法是用 multi-teacher on-policy distillation,將多個效果 LoRAs 的概念,以及 few-step generation 能力,一次過蒸餾進單一 LoRA。對一般使用者來說,意思就是原本要為不同效果切換或串接多個 adapter,現在有機會改用一個整合版本處理,流程會更簡潔。

使用這個項目時,重點不是由零開始訓練,而是先按項目提供的 ckpt/ 結構放好權重,之後以 50_in_1/ 作推理用途。倉庫亦提供公開的 training and inference code,而 data/manga_tone/ 內有起步用的 teacher LoRA 和示範訓練資產,方便了解整個資料與模型配置方式。

它解決的問題相當明確:當效果 LoRA 數量愈來愈多,部署、切換與疊加都會變得麻煩,配合 acceleration modules 時,還可能出現互相干擾。CollectionLoRA 嘗試把「多效果」與「少步數生成」合併到同一個 LoRA,這比單純收藏大量 LoRA 更像是重新整理整個工作流。

項目公開的重點包括幾個方向:
– 可把 50→1,甚至 180→1 的效果教師整合到單一 LoRA
– 在 EffectBench 上,文中稱其於 8 NFE 下可取得較高 VSA 與較低 BCR
– 支援 zero-shot 的 A ⊕ B 組合效果,推理時可配對兩個已訓練教師,無需額外訓練
– 已開放 training and inference code,但 model weights 仍標示為未全面開放

這個項目較適合會接觸生成效果控制、需要管理大量 LoRA 的研究者與開發者,也適合想減少部署複雜度的團隊。若你關心的是把多種風格或效果整合成較易分發的模型形式,CollectionLoRA 展示的方向很有參考價值;不過現階段公開資訊主要集中在框架、指標與示範資產,完整權重供應情況仍要留意項目後續更新。

GitHub: https://github.com/Qwen-Applications/CollectionLoRA

Categories: 開源, 阿里巴巴, 視覺模型, 影像模型, 影像處理, 框架

Skill0.5 如何提升強化學習泛化力

這個項目嘗試平衡技能記憶與即場調用,改善新情境下的表現。重點在於分流難度與分開優化兩類技能。

Og image

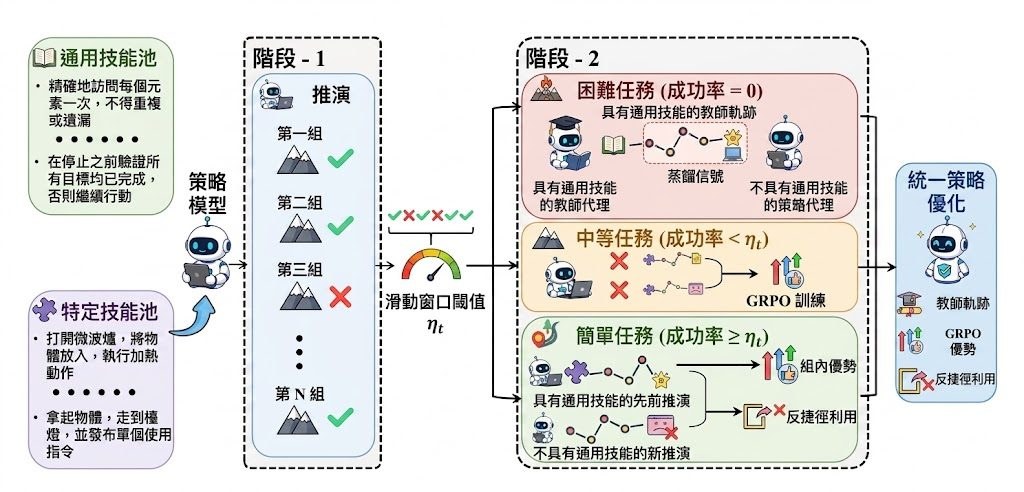
Skill0.5 是一個面向 Agentic Reinforcement Learning 的研究項目,聚焦處理 out-of-distribution generalization 問題。它指出傳統 skill-based RL 方法常要在 full externalization 與 full internalization 之間二選一,前者會帶來高昂的 context 開銷,後者則容易出現 overfitting 與知識衝突。

這項目把 general skill internalization 與 task-specific skill utilization 一同納入訓練,但用不同策略處理兩種性質不同的技能。系統會用 difficulty-aware router 按任務難度分流:Hard tasks 用 privileged distillation 內化通用技能,Medium tasks 用標準 RL 提升成功率,Easy tasks 則透過 diagnostic probing 懲罰走捷徑的行為,迫使模型忠實運用任務相關技能。

對初步理解這個項目的人來說,可先把它視為一種「按難度分工」的訓練框架,而不是單一模型結構。使用時要留意 context 開銷被視為問題之一,某程度上也反映較重的外部技能依賴可能增加資源壓力,包括 VRAM 與序列處理成本。

  • 解決 rigid choice 問題,避免只靠 externalization 或 internalization
  • 用 difficulty-aware router 把任務分成 Hard、Medium、Easy 三層
  • 分別結合 privileged distillation、標準 RL 與 diagnostic probing
  • 在 ALFWorld 與 WebShop 中,據摘要所述優於 memory-based 與 skill-based RL baselines

這類項目較適合研究智能代理、任務規劃與泛化能力的人參考,尤其是想改善模型在陌生情境下穩定性的團隊。

訓練和實現時使用 Qwen2.5-7B-Instruct 作為基礎模型。策略最佳化方面採用 GRPO 作為骨幹網絡,組別大小 G = 8,學習率為 1 × 10⁻⁶。訓練在 4 個 H800 GPU 上進行,每次迭代的批次大小為 16 個任務,最大互動範圍設定為 30 步。任務特定技能透過 Qwen3-Embedding-0.6B 取得。

GitHub: https://github.com/JasonZhujp/Skill0_5

Categories: 開源, 多模態模型, 影像模型, 影像處理

LaRA 用層級表示找出 RL 訓練污染

這篇論文提出 LaRA,以模型內部表示偵測 RL 後訓練的資料污染,比只看輸出更可靠。

Hero image preview

這篇論文介紹 LaRA(Layer-wise Representation Analysis),目的是找出 Reinforcement learning(RL)post-training 階段的資料污染問題。所謂污染,是指評估題目或基準資料混入訓練資料,令 Large Language Models(LLMs)看似表現很好,但其實可能只是記住答案,影響泛化能力與評估可信度。

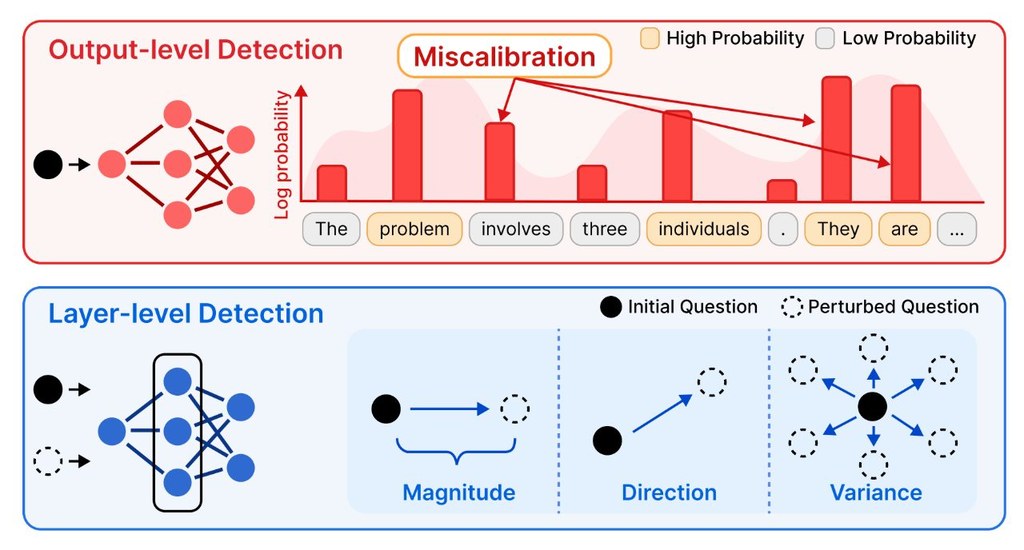
作者指出,現有方法多數只看輸出層面的訊號,例如 likelihood、entropy 或生成行為差異,但這類方法對 RL 訓練後的模型未必穩定。原因是 RL 重點在整條 reasoning trajectory 的 reward,而不是逐個 token 的機率,因此只靠輸出分佈,容易受 miscalibration 影響,未必能準確反映模型是否記住了評測資料。

LaRA 改為分析模型各層的內部表示,觀察受控擾動前後的幾何變化。論文提出三個互補指標:perturbation sensitivity、directional collapse、local representation rigidity,用來量度污染樣本在不同 layer 的異常反應;作者發現,受污染資料會在多層表示中逐步出現更高敏感度、更強方向收縮,以及更高局部剛性。

使用這個項目時,重點不是增加推理速度,而是作為檢測流程,協助研究人員審視 RL 訓練後模型的可信度。文中也提出一套偵測 protocol,把不同 layer 與不同指標的偏差整合起來;在 RL-trained reasoning models 的實驗中,這套方法表現優於現有 output-level baseline。

  • 解決 RL post-training 資料污染難以辨識的問題
  • 以 representation-level 訊號取代單看輸出機率
  • 結合三個指標,從多層 layer 分析污染痕跡
  • 適合用於 reasoning 模型評估、訓練審核與研究比較
  • 論文摘要未提供 VRAM 需求,較可能受模型大小、抽取 layer 數目與批次分析設定影響

如果你關心 VRAM 的應用,這篇內容沒有列出明確顯示卡記憶體需求,也沒有提供部署規格。不過按方法性質推測,LaRA 需要讀取多個 layer 的 hidden representations,使用時 VRAM 主要會花在模型載入、儲存中間層表示,以及對多個擾動版本做批次分析;模型越大、分析層數越多,VRAM 需求通常越高。

Paper: https://arxiv.org/pdf/2605.29888

Categories: 開源, 多模態模型, 影像模型, 影像處理

NAVA 點樣做好聲畫同步生成

NAVA 把影片與聲音一齊生成,重點放在聲畫同步與人聲控制。對想研究 AI 影片聲音生成的人,這個項目很有參考價值。

NAVA

NAVA 是一個主打音訊與影片同步生成的項目,目標不是先整好畫面再補聲,而是由一開始就把兩者放在同一個生成流程內處理。對非技術讀者來說,可以把它理解成一個較重視「畫面發生什麼,聲音就跟住發生什麼」的模型,因此打鬥、說話、環境聲這類時間配合會更自然。

這個項目的核心做法,是先在獨立空間建立 audio-video alignment,再用文字或其他 context 去引導生成,並採用 Align-then-Fuse MMDiT 架構。另一個亮點是 Timbre-in-Context Conditioning,能把參考 WAV 的音色對應到指定語音片段,適合多角色對白、指定聲線或旁白控制。

NAVA 有 6.3B 參數,可在 8 張 GPUs 配合 Ulysses sequence parallelism 下約 1 分鐘生成 720p 影片,這代表它主要面向高階 GPU 環境;VRAM 的作用是存放模型權重、推理中的中間特徵、音訊與影片 token,以及較高解像度生成所需的緩衝空間,VRAM 越充足,越有機會支援更高畫質、較長內容或較穩定的批次推理。

  • 支援 native stereo audio,畫面、場景聲與語音一併生成
  • 可用文字控制鏡頭構圖、運鏡與節奏
  • 支援 multi-timbre voice control,適合多角色配音場景
  • 同一 checkpoint 可輸出橫向、直向與正方形比例
  • 英文 TTS 表現較強,其他語言支援看來仍較有限

它在 Verse-Bench、Seed-TTS 及用戶研究中,於影片質素、聲畫同步和參考音色可控性有明顯優勢,音訊質素亦具競爭力。若你關注開放式 audio-video generation、TTS、虛擬角色影片、短片內容製作,或者想研究 6.3B 級別模型如何平衡同步效果與運算需求,NAVA 是一個很值得細看的項目。

GitHub: https://github.com/ernie-research/NAVA

Categories: 開源, 多模態模型, 影像模型, 影像處理

Lens:更慳算力的高質文字生圖

Lens 主打用較少訓練資源,做出接近大型文字生圖模型的效果。這個 GitHub 項目則提供最精簡的圖片生成功能。

Lens Teaser

Lens 是 Microsoft 推出的文字生成圖片模型,規模約 3.8B 參數,重點不只是畫質,還包括「用較少訓練成本做到接近甚至追上更大模型」。這個 GitHub 項目目前定位清晰,主要提供推論用途的最小程式碼,方便直接用現成 checkpoint 生成圖片。

動手方式很直接:準備好 Lens 的權重後,利用這個項目的推論程式輸入文字提示,便可生成圖像。它特別適合想快速試畫面風格、測試長提示詞效果,或者比較不同文字生圖模型輸出的人;若要完整訓練或微調流程,現有儲存庫資訊顯示並不是這個項目的重心。

它解決的核心問題,在於近年文字生圖模型愈做愈大,訓練成本高得驚人。Lens 嘗試從資料密度、模型結構和解析度學習方式入手,在較緊湊的 3.8B 規模下,仍保持不錯的提示理解、高解析度輸出,以及多種長寬比生成能力。

較值得留意的地方有幾個:它用長篇密集描述的圖文資料預訓練,配合 mixed-resolution learning,令模型一次學到更多內容;文字理解方面則結合 GPT-OSS 多層特徵與 FLUX.2 semantic VAE。官方亦提到有 Lens-Turbo 這類後續變體,主打 4-step 快速生成,另有 RL 調整版本用來改善畫質與壓低瑕疵。不過仍需要 A100/V100 GPU。

  • 3.8B 參數規模,定位是高效率文字生圖模型
  • 支援約 1:2 至 2:1 長寬比,最高可到 1440×1440
  • 相關模型包括 Lens、Lens-Turbo,以及經 RL 調整的變體
  • 官方論文指出 1024×1024 輸圖可達約 3.15 秒,Turbo 4-step 約 0.84 秒

整體來看,這個項目最吸引之處不是功能包山包海,而是把焦點放在「精簡推論」與「高效率模型設計」上。對研究生成式 AI 趨勢、想評估新一代文字生圖效率,或需要高解析度輸出的開發者與創作者來說,Lens 是一個值得留意的項目;不過涉及基準細節與全面比較時,仍建議一併參考論文與模型頁面。

GitHub: https://github.com/microsoft/Lens

Paper: https://arxiv.org/pdf/2605.21573

Categories: 開源, 模型, 微軟, 影像模型

PhysX-Omni:讓 3D 生成更貼近物理世界

項目不只生成3D外形,還嘗試補上材質、尺寸與關節等物理資訊。對模擬、機械人與場景製作尤其有參考價值。

teaser

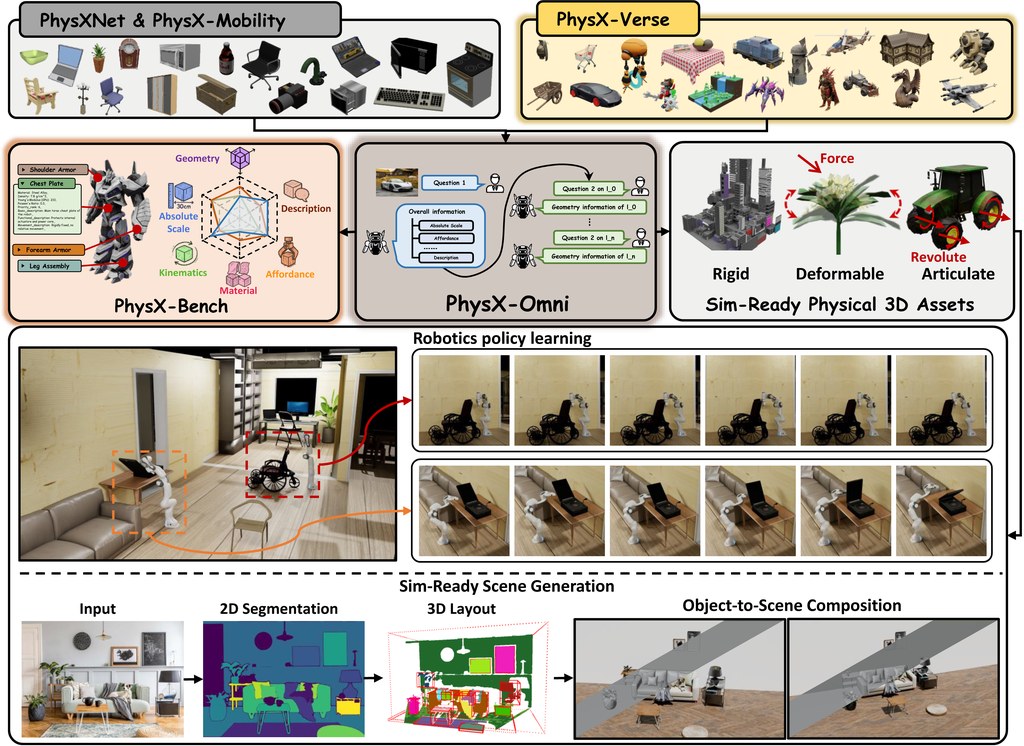
PhysX-Omni 由南洋理工大學及 中國 ACE Robotics 開發,是個面向模擬用途的 3D 生成項目,重點不只是做出外觀,而是連同剛體、可變形物件與可動關節物件一併考慮。簡單說,它想解決的問題是:很多 3D 生成結果看起來像樣,但未必能直接放進物理模擬或機械人流程裡使用。

這個項目的亮點,在於把幾何形狀、絕對尺寸、材質、可供互動的功能,以及運動結構放到同一套框架內處理。它配合 PhysXVerse 資料集和 PhysX-Bench 評估方法,目標是同時檢查生成能力與理解能力,這點比只看外觀相似度更進一步。

整體流程偏向研究型:先準備 Python/conda 環境,再安裝相依套件,之後下載 PhysXNet、PhysX-Mobility 與 PhysXVerse 等資料,完成前處理和條件圖像渲染,最後再設定訓練路徑。這代表它較適合已有 AI 或 3D 處理基礎的人,而不是即開即用的輕量工具。

PhysX-Omni: Unified Sim-Ready Physical 3D Generation for Rigid, Deformable, and Articulated Objects
  • 核心價值:生成可放進模擬流程的 3D 資產,而非只有表面外觀
  • 覆蓋範圍:支援剛體、可變形物件、關節物件三類內容
  • 相關資源:包括 PhysXVerse 資料集、PhysX-Bench 評估,以及 README 提到的 Qwen2.5 相依套件
  • 適合場景:機械人訓練、物理模擬、具條件控制的 3D 場景生成

性能方面,公開資料指出它會用一般指標加上自家的基準一同評估,並強調在生成與理解兩邊都有不錯表現。不過從現有資訊來看,較完整的數字仍應以論文與官方頁面為準;對一般讀者而言,最值得留意的是它把「看得像」推進到「更可能用得著」,這正是這個項目最有意思的地方。

GitHub: https://github.com/physx-omni/PhysX-Omni

Paper: https://arxiv.org/pdf/2605.21572

Categories: 開源, 模型, 影像模型, 影像處理, 中國, Dataset 數據集

KVPO 點樣提升影片生成對齊

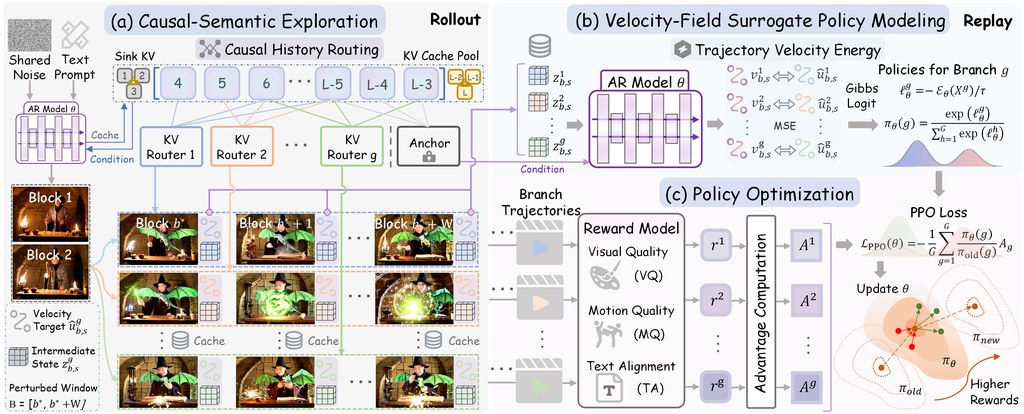
KVPO聚焦自動回歸影片生成訓練,嘗試令結果更貼近提示內容。重點在於用分支探索加獎勵學習,改善畫面走向。

KVPO

KVPO 係一個針對影片生成訓練流程嘅研究型專案,焦點唔係單純「生成到片」,而係令模型喺逐格、逐段生成嘅過程中,更穩定咁貼近文字提示同預期內容。對一般讀者嚟講,可以理解成:佢想改善 AI 影片成日出現嘅「開頭啱、之後走樣」問題。

呢個方法特別之處,在於佢唔只睇最後條影片好唔好,而係會喺生成途中做多條候選路線探索,再用獎勵模型判斷邊條路線更值得學。README 提到佢結合咗類似 PPO 嘅強化學習更新,以及對生成軌跡嘅機率估計,目標係令自動回歸影片模型學得更準。

實際了解同試用呢個專案,會由查看論文、專案頁面同釋出權重開始,再按設定準備對應環境、模型權重同資料。由於文件列出咗 H200、CUDA 12.8、Wan2.1 backbone,以及 HPSv3、VideoReward 等元件,較適合已有 GPU 資源、熟悉深度學習訓練流程嘅讀者,而唔係即開即用型工具。

  • 主要處理影片生成中內容偏離提示、時間一致性變差等問題
  • 核心做法係先探索多個生成分支,再用獎勵分數引導學習
  • 研究重點放喺自動回歸影片模型,而唔係一般圖片生成
  • 文件顯示會配合 Wan2.1-T2V-1.3B 等 backbone 使用
  • 仲會涉及 HPSv3VideoReward 呢類評分或獎勵相關模型

整體而言,KVPO 比較適合關注影片生成訓練方法嘅研究者、工程師,或者想比較唔同對齊策略嘅團隊。對非技術用家,佢未必係直接拎嚟出片嘅方案;但作為觀察新一代影片模型點樣「學識跟指令」嘅方向,呢個專案幾有參考價值。

GitHub: https://github.com/Richard-Zhang-AI/KVPO

Paper: https://arxiv.org/pdf/2605.14278

Categories: 開源, 香港科技大學, 清華大學, 影像模型, 影像處理

Page 4 of 12
1 2 3 4 5 6 12