MetaView 補回生成的空間感

只用一張相就想轉出大幅度新視角,最難是畫面似真之餘仲要守住空間比例。MetaView 針對的正是這個卡位。

teaser

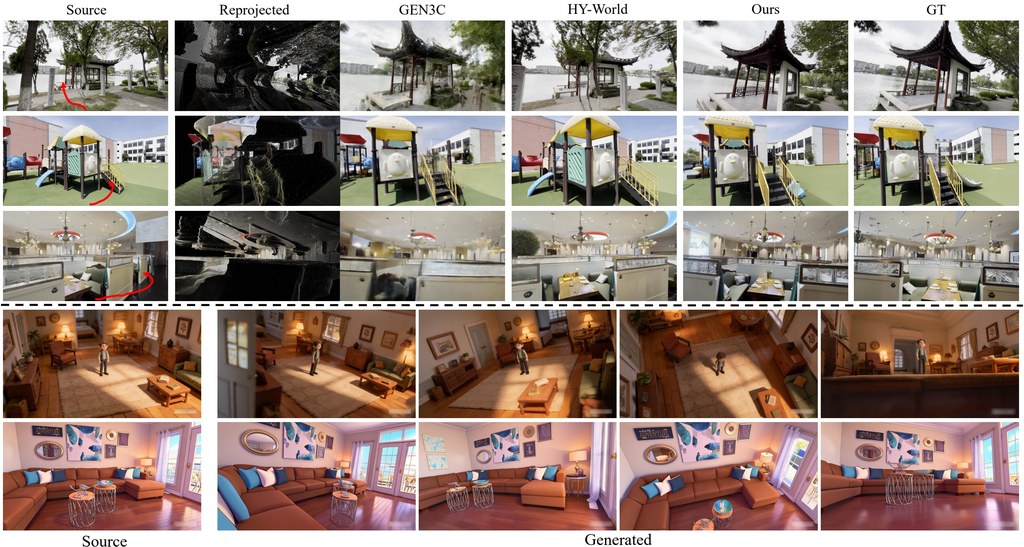
單靠一張圖片生成大角度新視角,很多方法一轉得遠就會出現結構鬆散、比例飄移,鏡頭控制亦未必準。MetaView 屬於影像生成框架,集中處理 monocular novel view synthesis,目標是在不做顯式 3D reconstruction pipeline 的前提下,仍然保住 geometry consistency 同可控的 camera pose rendering。

它的取向幾清楚:唔想被重建流程綁死泛化能力,但又唔接受純 implicit 方法常見的 scale drifting。項目把 Depth Anything 3 提供的 implicit geometry priors 接到 pretrained MM-DiT backbone,做法是加入 non-invasive parallel attention layers;同時再用 modified RoPE,配合 PRoPE 為 z-axis 留出額外子空間,把場景尺度固定在較一致的 3D metric space。

對研究團隊、做 novel view synthesis、3D-aware image generation,或者需要從單張圖控制鏡頭輸出的工作流,這個項目值得留意。現有資訊較像研究原型:README 與 project homepage 已提供 paper、demo 與 model 入口,但未見完整安裝與部署細節,所以現階段較合理的理解方式,是先用 demo 看大視角轉換與 spherical poses control 的效果,再等待公開模型與程式流程補齊。

  • 單張圖片輸入,主打大幅度 viewpoint changes 下仍保持高保真輸出
  • 不走 explicit 3D reconstruction pipelines,換取更高彈性與泛化空間
  • 用 Depth Anything 3 幾何先驗補結構,再用 modified RoPE 處理 scale anchoring
  • 比較對象包括 ViewCrafter、Gen3C、Voyager、PE-Field、HY-World、Lingbot-World

MetaView 在具挑戰性的 monocular large viewpoint changes 測試中,表現優於多個 reconstruction-based 與 implicit 方法,強調的是 geometry consistency、precise controllability 與 generalization。現階段較適合把它視為一個方向鮮明的研究項目:它不是單純追求更靚畫面,而是嘗試把單圖生成長期欠缺的空間尺度感補回來。
項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, Image, 影像模型, 香港, 3D

SpectraReward:用 MLLM 反讀圖片做文生圖獎勵

想提升文生圖結果,但又唔想另外訓練獎勵模型,SpectraReward提供了一條更直接的路。它用預訓練 MLLM 反過來讀圖還原提示詞,作為生成好壞的依據。

Og image

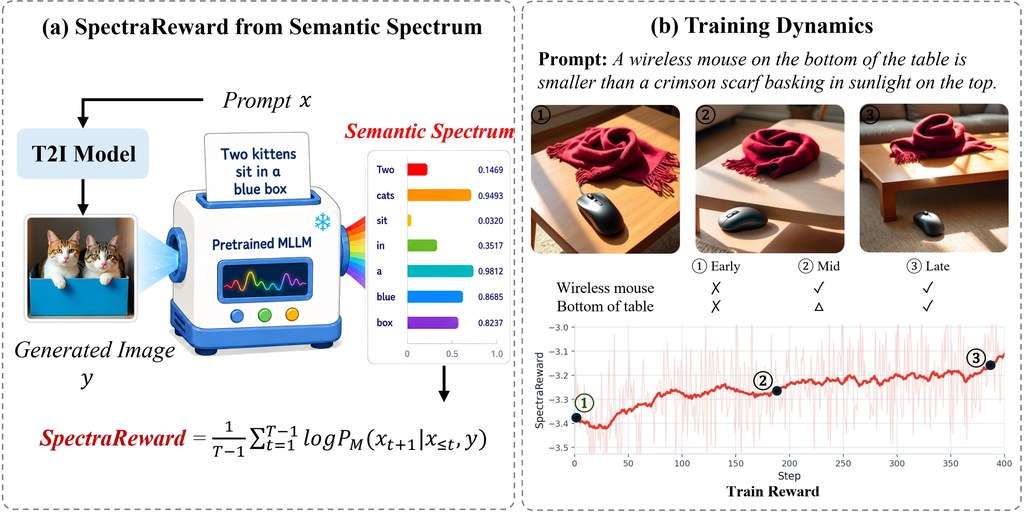
文生圖訓練最麻煩的一環,往往不是生成本身,而是怎樣穩定判斷圖片有冇跟足提示詞。SpectraReward 屬於影像生成 reinforcement learning 的獎勵方法,處理的正是這個問題:它不靠人工偏好標註,也不用再微調 reward model,而是借用預訓練 Multimodal Large Language Models(MLLMs)本身已有的圖文對齊能力,直接替生成結果打分。

核心做法很直觀:先讓 MLLM 看生成出來的圖片,再檢查它能否把原本的 prompt「讀返出嚟」。SpectraReward 用一次 image-conditioned、teacher-forced forward pass,計算 prompt 的平均 log-likelihood,數值越高,代表圖片越能還原文字意圖。相比常見做法要模型直接評分、回答拆解後的驗證問題,這個方法少了額外訓練步驟,也減少了設計評分流程的負擔。

項目亦提出 Self-SpectraReward,對 BAGEL 這類 unified multimodal models(UMMs)尤其有意思。做法是讓同一個模型的 understanding branch,為 generation branch 產生的樣本評分,形成 self-reward。這種安排的重點不在模型愈大愈好,而在 reward 與 policy 是否真正對齊;資料指出,這種內部對齊效果有時可追平,甚至超過更大型的外部 MLLMs。

  • 不需要 preference labels,也不需要 reward-model fine-tuning
  • 只用一次 MLLM forward pass,就可計出 training-free reward
  • 把「圖片能否還原 prompt」變成可量化的獎勵訊號
  • Self-SpectraReward 適合 BAGEL 類 unified multimodal models(UMMs)

從結果描述來看,reward 提升時,複雜場景生成質素也同步改善,表示這個訊號不只理論上合理,亦能推動可見的畫面進步。對正在做 text-to-image generation、影像模型強化學習,或想減少外部獎勵模型依賴的讀者來說,SpectraReward 提供了一種更省步驟、但仍保留語義判斷能力的路線。文中提到的模型包括 MLLMs,以及 BAGEL 這類 unified multimodal models。

項目主頁 · GitHub

Categories: 香港大學, 北京大學, 字節跳動, 多模態模型, 模型訓練, Image, 影像模型, txt2img, 香港

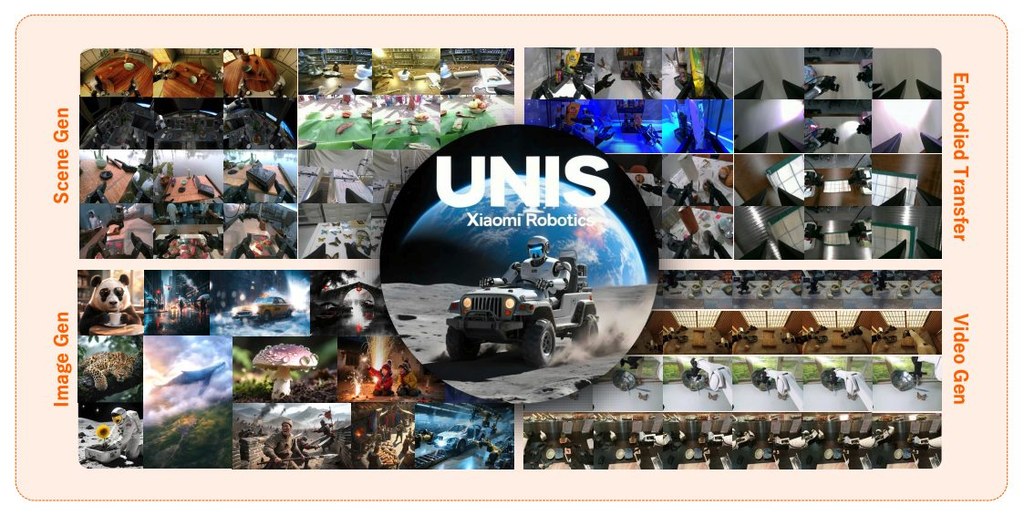
[技術文章] Xiaomi-Robotics-U0 小米用世界模型打通機械人

同一個模型兼顧場景生成、影像編輯同機械人操作資料合成,重點唔只係畫面靚,而係多視角一致同可直接餵去訓練策略。

smileybones small

當世界模型式的影像與影片生成能力要落到機械人場景,難題唔止係出圖或出片,而係同一個場景喺多個視角下都要合理,物件幾何要一致,仲要符合唔同 robot embodiment 嘅操作限制。

Xiaomi-Robotics-U0 屬於 world foundation model 路線,針對的正是這類 embodied synthesis 工作:一邊保留大型 image and video generation model 已學到的視覺知識,一邊補上機械人資料需要的可控性與一致性。

常見做法通常係用有限的機械人資料去微調 foundation model,但作者認為呢種範式容易犧牲大規模預訓練帶來的泛化能力。Xiaomi-Robotics-U0 改用 unified embodied synthesis 設計,把 text-to-image generation、image editing、embodied scene generation、embodied transfer 同 embodied video generation 放入同一個 38-billion-parameter multimodal autoregressive model 聯合優化,將 embodied generation 視為 foundation image and video generation 的延伸,而唔係另一條割裂的任務線。

呢個項目最有用的地方,在於它不只生成好看的資料,而是生成可拿來支援機械人學習的資料。文中提到它首次支援跨多種 robot embodiments 的高品質 multi-view scene generation,亦加入 structured、controllable embodied transfer,做細緻編輯時仍可保留 multi-view consistency 同 interaction dynamics,對要做模擬資料擴增、場景改寫、操作軌跡配套生成的工作流幫助較大。

  • 聯合處理多種任務,減少每個場景各自做模型適配的割裂流程
  • 核心差異在於保住 pre-trained world foundation model 的泛化,同時加入 embodied constraints
  • 支援 multi-view scene generation 與 embodied transfer,重點放在幾何一致性與互動連貫性
  • 生成結果可作為 scalable data engine,服務後續 policy training

效能上,Xiaomi-Robotics-U0 在 single-step 與 sequential generation 任務都做到 state-of-the-art,human evaluations 中於 embodied scene generation 同 transfer 超過 GPT-Image-2.0,embodied video generation 在 World Arena 排名第一。更實際的指標來自真實操作任務:它把 π 0.5 \pi_{0.5} 在 out-of-distribution 情況下的 success rate 由 36.9% 提升到 63.2%,說明這類 world model 不只是內容生成工具,亦開始成為 embodied intelligence 的資料引擎。

文中亦提到完整流程涵蓋 dataset curation、unified annotation pipeline、single-step training、sequential training,以及配合 FlashAR 與 vLLM Integration 的 inference 設計。整體訊息很清楚:作者想證明 foundation world models 可以同時扮演 embodied world models 與合成資料基建,讓機械人訓練不再只依賴昂貴而稀缺的真人示範。

Paper

Categories: 模型, 多模態模型, 視頻模型, 世界模型, 模型訓練, Video, Image, 影像模型, txt2img, Robotic, 軟件, Dataset 數據集, 小米-Xiaomi

CtrlVTON 把虛擬試穿變成可控編輯

想像網購試衫唔只係換件衫上身,連鬆身、束入褲頭同疊穿位置都可以指定。CtrlVTON瞄準的,正正是這種以往 VTO 很難處理的控制感。

NXN LABS

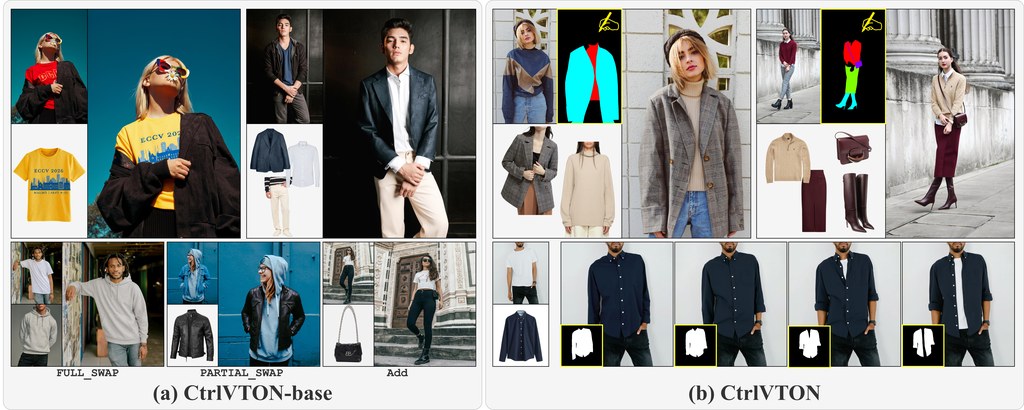
網購試衫最常見的落差,不是像不像,而是你根本無法指定件衫要點樣著。CtrlVTON 屬於影像生成與虛擬試穿項目,處理的是 Virtual try-on (VTO) 長期欠缺的可控性:同一件衫可以鬆身或貼身、束入或放出、打開或扣上,甚至改變穿著位置與疊穿方式。

現有做法多數把 VTO 當成 inpainting 問題,擅長補畫衣物,卻不容易精準跟住使用者指定的版型同位置。CtrlVTON 改用 image editing framing,再配合 segmentation mask 做 pixel-level control,重點不是單純生成得自然,而是令版面安排真正聽話。論文亦明確指出,它在服裝忠實度接近強勢 proprietary editing systems 的同時,對使用者提供的布局跟隨得更準。

支撐這套方法的另一半,是 Visual-Instance-Prompt Segmentation 與對應模型 VIP-SAM。以往常見的是 category-level visual-reference segmentation,但作者針對的是 instance-level 任務:先給你一張平拍服裝圖,再從人物穿著照片中分出同一件衣物。這一步對同類衣物干擾、遮擋,以及布料變形都更敏感,所以 VIP-SAM 會把 support features 提早注入 SAM backbone,目標是令定位更穩。

  • 把 VTO 由 inpainting 轉成 image editing,控制粒度更細
  • 用 segmentation masks 指定服裝大小、風格與身體上的位置
  • VIP-SAM 先解決「相中究竟係邊一件衫」的 instance-level 分割問題
  • 一個框架內處理 garment swapping、layering、selective switching、multi-garment composition
  • 已公開 VITON-HD-edit dataset,並有 arXiv 論文可交叉核對方法與結果

理解這個項目的較合理方式,不是把它當成即裝即用成品,而是研究型原型加資料集組合。,測試與部署會圍繞論文、GitHub 儲存庫,以及 Hugging Face 上的 VITON-HD-edit dataset 展開;較適合做可控試穿研究、電商影像流程驗證,或想比較 LoRA 式輕量微調能否取代大型封閉編輯服務的團隊。限制也很清楚:Project Page 尚未公開,README 釋出的安裝與推理細節仍不完整,現階段更適合有影像模型基礎的人先跟論文設定重現,再評估能否接入產品流程。

GitHub · Paper

Categories: 開源, Image, 影像模型, 影像處理, Dataset 數據集

Canvas360 把全景生成拉回可用水平

全景圖最易穿崩嘅位置,往往唔係畫質,而係左右接縫同空間感。Canvas360 針對呢個痛點落手,想令文字生成同後續修補都更連貫。

teaser

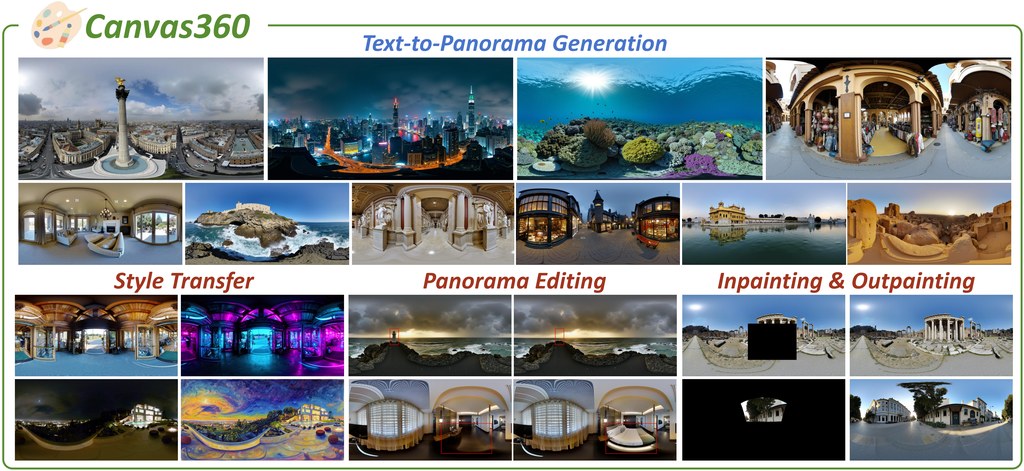
最值得留意嘅地方,在於佢唔只想生成一張闊圖,而係想處理 360 度全景最常見嘅破綻:左右邊界接唔上、透視變形唔自然、補圖後空間結構散開。Canvas360 屬於影像生成框架,建基於 FLUX,處理嘅係 text-to-panorama image generation,同時延伸到 inpainting、outpainting、editing 同 style transfer 呢類全景工作流。

現有做法多數先把全景當成一般平面圖片生成,再靠後處理減少接縫;作者認為呢種範式忽略咗 panoramic projection 本身嘅幾何特性,所以容易喺邊界、深度關係同局部結構出現錯位。Canvas360 用 two-stage framework 重組呢件事:先做 geometry-aware pretraining,引入 parallel RGB-depth pretraining,再配合 continuous position encoding、circular latent padding 同 per-block feature synchronization,將 360 度連續性直接放入模型學習過程。

同類項目相比,Canvas360 嘅取向唔係單純追求更華麗嘅畫面,而係優先修正全景生成最影響可用性嘅一致性問題。項目亦補上 Canvas360Dataset,提供 1M paired panoramic samples,支援 style transfer、inpainting、outpainting 同 editing,反映作者唔止做單一模型改良,仲想連訓練資料結構一併補強。

  • 核心定位係 FLUX-based framework,主打 text-to-panorama image generation 同全景補全
  • 關鍵方法包括 geometry-aware pretraining、continuous position encoding、circular latent padding
  • 已公開 inference code 同 training code,但 model weights 與 online demo 仍然未釋出
  • 需要 base model black-forest-labs/FLUX.1-dev,並可配合自備 LoRA 跑生成或下游任務
  • 相關比較對象包括 PanFusion、SMGD、PAR、WorldGen、HunyuanWorld、DiT360,以及 FLUX.1-Kontext-dev、FLUX.2-dev、Qwen-Image-Edit

測試同現階段較接近研究型項目而唔係即開即用服務。儲存庫已提供 inference.py 同 inference_downstream.py,代表你可以在本地環境配好 PyTorch、依賴套件、FLUX.1-dev 存取權同 LoRA 後,直接驗證文字生成全景,或者試全景補圖與延展;不過權重未公開,所以現時更適合研究團隊、全景影像工具開發者,或者想研究 360 度生成方法嘅人先行閱讀同跟進。現有介紹強調結果比多個舊方法更少接縫瑕疵、結構更清晰,但儲存庫內容未見完整量化指標表,判斷性能仍要等論文與權重進一步公開後先更穩陣。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型, 視覺模型, 模型訓練, Stable Diffusion, Image, 影像模型, 框架, Python, Dataset 數據集

RDM:一步生成影像的新取向

RDM 係一個一步式影像生成研究項目,目標係用一次網絡推理,做出接近多步模型質素的圖像。

iRDM post-trains four-step FLUX.2 [klein] into a one-step generator at matched quality; GenEval and PickScore climb past

RDM 是一個一步式影像生成研究項目,也是面向 one-step visual generation 的訓練方法。它要解決的問題很直接:把原本需要多次採樣的生成流程,壓縮成一次 network evaluation,仍然盡量保住影像質素。

現有做法通常會依賴 online teacher、adversary,或者追蹤 trajectory 來蒸餾多步生成器;作者認為這類範式訓練成本高、流程複雜,亦容易被單一訊號牽著走。RDM 改用 Representation Distribution Matching,把生成圖與真實圖在多個 frozen pretrained encoders 之下的特徵分佈對齊,核心比較方式是 squared MMD with a Gaussian kernel,同時配合 Nyström attraction、within-batch repulsion,以及 joint image-text law。

這個取向和同類方法的差異,在於它不靠 online teacher、no adversary、no trajectory,訓練邏輯更像直接校準「生成分佈是否接近真實分佈」。作者亦刻意不用單一 encoder,而是用一組 frozen encoders(10 train + 4 held out),再用 proportional Lagrangian controller 平衡各個表示空間,這個設計明顯是想減少模型只迎合某一種評分器的問題。

README 已交代基本理解方式:安裝後可用 ImageNet-256 影像樹做訓練與驗證,也可沿 FLUX text-to-image 路線配合 COCO、GenEval、Pick-a-Pic 做評測;另有 Hugging Face demo 與 checkpoints,可直接看輸出效果。部署上它較像研究型訓練框架,不是即開即用的終端應用,較適合有 GPU 資源、想重現論文結果或做後訓練實驗的團隊。

性能數字有辨識度。RDM 報稱達到 one-step ImageNet state of the art,SW_r14 為 1.30;在 FLUX.2 [klein] 的 post-training 路線中,one-step 模型於 GenEval 達到 0.826,高於 four-step teacher 的 0.794,PickScore 亦升到 22.76,高過 teacher 的 22.58。相關模型與組件包括 FLUX.2 [klein]、open_clip、DreamSim,以及多個 frozen pretrained encoders;整體更適合關注模型訓練、生成效率與影像評測方法的研究或產品項目。

  • 項目類型:研究型訓練方法/框架,重點在一步式影像生成
  • 核心差異:不用 online teacher、adversary、trajectory,改做分佈匹配
  • 測試方式:可用 ImageNet-256、COCO、GenEval、Pick-a-Pic 驗證結果
  • 主要取捨:流程更乾淨,但仍需要資料準備、GPU 資源與完整評測環境
  • 受益情境:想把多步生成器壓成單步模型的研究團隊與影像生成項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型訓練, Stable Diffusion, Image, 影像模型, txt2img, 框架, Dataset 數據集

PRA:像素級自回歸生圖的新路線

PRA 是一個 PyTorch 影像生成研究項目,主打 pixel-space autoregressive 生成。它嘗試用較細模型規模,換到更低 FID 表現。

result

PRA 是一個以 PyTorch 實作的影像生成研究項目,屬於 class-conditional pixel-space autoregressive image generation 模型與訓練框架。它要解決的問題,是直接在像素空間逐步生成圖片時,單步誤差大、而且 teacher-forced training 與推理流程不一致,令誤差一路累積。

現有 pixel-space continuous-token autoregressive 做法,多數直接預測高維像素 patch,或用 x-prediction、input noise injection 減輕誤差,但改善有限;exact rollout training 雖然更貼近推理,代價又太高。PRA 的取向是加入 Parallel Rollout Approximation (PRA):先生成低維 intermediate states,再經 pixel decoder 映射回 pixel-space tokens,同時用近似推理時的 pixel-feedback 方式保留平行訓練效率。

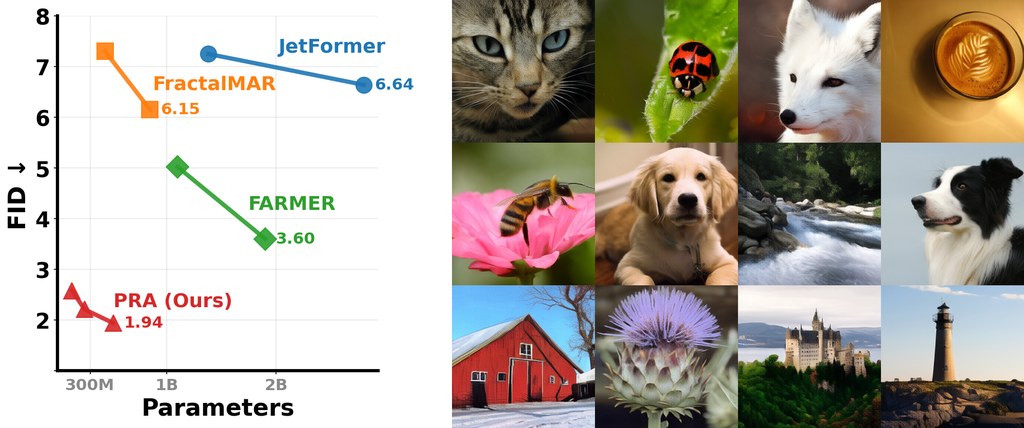
這個設計的重點,不是單純追求更大模型,而是重新處理「訓練見到的輸入」與「生成時真正收到的回饋」之間的落差。論文資料顯示,它在 ImageNet-1K 256×256 的 class-conditional 生成上,PRA-S 135M 參數已做到 FID 2.58,優於先前 billion-scale pixel-space AR 的 3.60;PRA-L 511M 進一步到 1.94,定位很清楚,就是衝着 pixel-space AR 的 SOTA 而來。

部署理解上,儲存庫已提供 environment.yml、requirements.txt、預訓練權重與 sample_ddp.py,代表作者預設你會用多卡分散式抽樣與評測。評估指標包括 FID、Inception Score、precision、recall,另有 ImageNet classification probing accuracy 作為生成以外的補充觀察,表示作者也在測試表徵能力,而不只看出圖漂亮與否。

  • 項目類型:研究原型兼模型實作,集中展示 PRA 訓練與取樣流程
  • 相關模型:PRA-S、PRA-B、PRA-L,參數量約 135M、250M、511M
  • 主要差異:不用離散 tokenizer,維持 pixel-in、pixel-out AR 介面
  • 較適合情境:研究 pixel-space AR、比較生成指標、重現 ImageNet 類條件生圖結果
  • 需要留意:目前公開內容偏向研究重現,不是即裝即用的終端應用工具

受益最大的,會是做影像生成研究的團隊、想比較 autoregressive 與 diffusion 路線的人,以及要研究像素空間建模取捨的學術項目。對一般開發者來說,這個項目較像高水準實驗平台;有現成 checkpoint 和評測流程是優點,但 CUDA、PyTorch 與 FlashAttention 相容性仍需自行處理。

GitHub · Paper

Categories: 北京大學, 模型訓練, Image, 影像模型, Python

DanceOPD:多能力影像生成的場景蒸餾框架

DanceOPD 提出 on-policy 生成場景蒸餾方法,將不同影像能力整合到單一模型,同時保持 T2I 與編輯表現。

ByteDance Seed

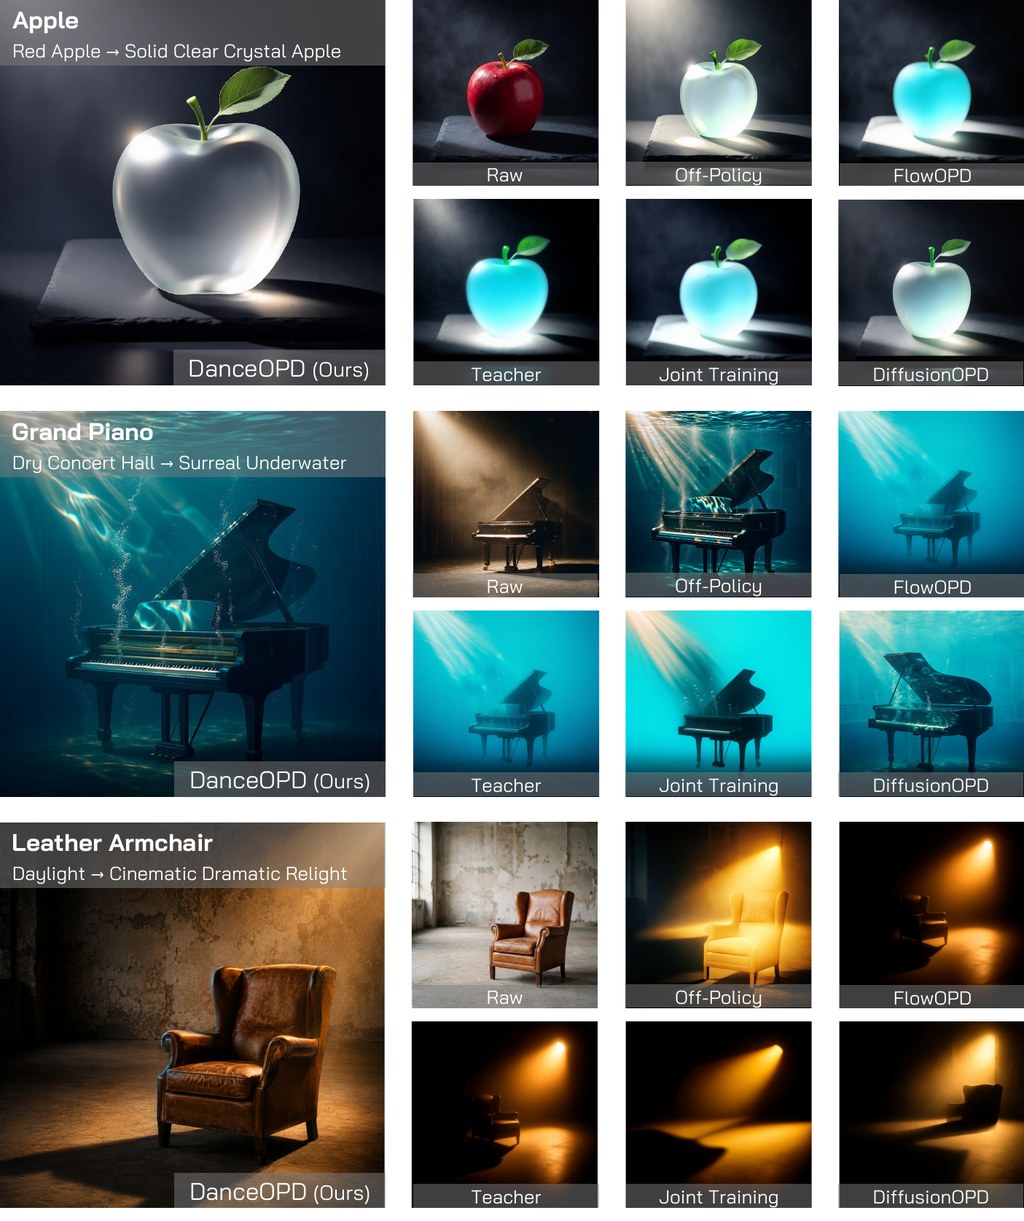
DanceOPD 是一個針對 flow-matching 模型設計的 on-policy 生成場景蒸餾框架,目標是讓單一影像生成模型同時具備文字生成影像(T2I)、局部編輯與全域編輯等多種能力。核心做法是將每個來源能力視為一個速度場(velocity field),然後在學生模型自己產生的 on-policy 狀態上查詢這個場景,再以簡單的速度 MSE 損失進行訓練。

這套方法最值得留意的差異在於 hard-routed 設計:每個樣本只被路由到一個被選中的能力場,並且只查詢一個低噪聲的語義側狀態(semantic query),避免了對多個來源場景做平均而模糊語義身份的問題。同一套框架也能吸收 operator-defined fields,例如 classifier-free guidance,讓引導機制自然融入訓練。

在評估方面,DanceOPD 報告了多項指標,包含 GEditBench-avg 在 T2I + Edit Composition 上達到 5.347、GenEval Overall 達到 0.849 同時保持 T2I 表現,以及 Local + Global Edit Composition 的 5.498、CFG 吸收診斷中 5.833 的最佳值。

這項工作適合關注多能力影像生成整合、蒸餾方法以及 flow-matching 模型研究的開發者與研究者。由於 Code 標示為「Soon」,目前尚未提供源碼或模型下載,因此暫無可對應的安裝或使用步驟可分享。

主要重點:

  • 核心定位:flow-matching 模型的 on-policy 生成場景蒸餾框架
  • 方法差異:hard routing 單一能力場景加單一低噪聲語義查詢,避免場景平均造成的語義模糊
  • 支援能力:T2I、局部編輯、全域編輯,並能吸收 classifier-free guidance 等 operator-defined fields
  • 評估數字:GenEval 0.849、GEditBench T2I+Edit 5.347、Local+Global 5.498
  • 現有狀態:論文可在 arXiv 瀏覽,原始碼尚未公開

項目主頁: https://danceopd.github.io/

Paper: https://arxiv.org/pdf/2606.27377

Categories: 開源, 字節跳動, 模型, 模型訓練, Image, 影像模型, txt2img, 框架, 教學, Content Creator, 深度學習

TryOnCrafter:首個鏡頭可控的影片虛擬試穿框架

TryOnCrafter 是首個支援鏡頭軌跡控制的影片虛擬試穿框架,以 4D 代理模型分離人物與背景,實現任意視角的試穿效果。

TryOnCrafter teaser

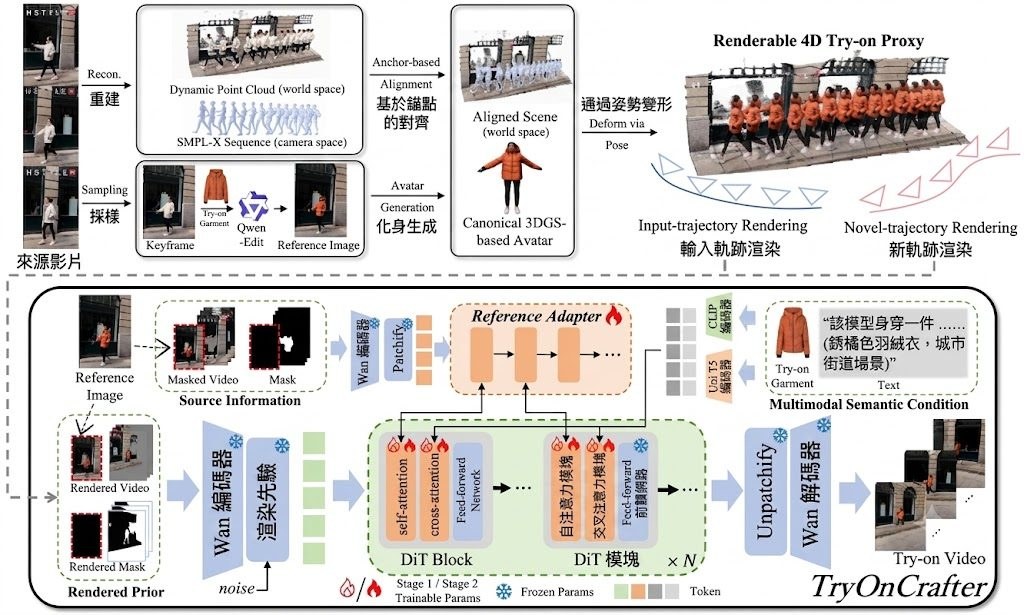
TryOnCrafter 是一個基於 DiT(Diffusion Transformer)的虛擬試穿影片框架,專門處理「鏡頭可控影片虛擬試穿」(Camera-controllable Video Virtual Try-on, CaM-VVT)這個新任務。它的主要用途是讓使用者能夠在指定鏡頭軌跡(例如推近、傾斜、環繞)的情況下,生成穿著指定服裝的人物影片。

傳統的影片虛擬試穿只能沿著原始影片的鏡頭路徑生成結果,無法讓使用者自由改變視角。TryOnCrafter 的做法是引入一個「可渲染的 4D 試穿代理」(Renderable 4D Try-on Proxy),先把 2D 試穿結果提煉成一個基於 3D Gaussian Splatting(3DGS)的穿衣化身,再用 SMPL-X 序列驅動動作,最後把這個化身對齊到重建的背景點雲中。這個代理模型把人物與環境分離開來,提供穩定的幾何骨架,讓後續的影片生成能夠在任意鏡頭下保持結構一致。

在生成階段,框架採用 Proxy-Anchored Video DiT,把代理模型渲染出來的多層資訊(包括渲染先驗、參考特徵、服裝語意提示)作為幾何錨點,確保最終影片在指定軌跡下保持物理合理的形變與外觀。這種設計同時支援多項延伸應用,包括人物重新定位、子彈時間效果,以及 360 度環繞檢視。

團隊建立了 CaM-VVTBench 評測基準,結果顯示 TryOnCrafter 在結構一致性與服裝身份保留方面,明顯優於現有方法。這個框架較適合需要展示服裝 3D 效果的研究團隊、電商內容製作,以及對鏡頭語言有要求的多媒體創作場景。

重點摘要

  • 首個鏡頭可控試穿框架:突破傳統 VVT 只能被動沿用原片鏡頭的限制,支援使用者自訂鏡頭軌跡。
  • 4D 試穿代理模型:以 3DGS 化身 + SMPL-X 動作序列,把人物與背景解耦,提供密集幾何引導。
  • Proxy-Anchored Video DiT:以代理渲染結果作為幾何錨點,確保任意視角下的結構與服裝一致性。
  • 多元延伸應用:支援人物重定位、子彈時間、360 度環繞等下游編輯。
  • 新基準 CaM-VVTBench:團隊建立的專用評測集,在結構一致性與服裝身份保留上明顯領先既有方法。

模型與源碼說明:原始資料為項目主頁,未提供具體的源碼下載連結、安裝步驟或模型權重取得方式。

項目主頁: https://sunhao242.github.io/TryOnCrafter_web.github.io/

Paper: https://arxiv.org/pdf/2606.26092

Categories: 開源, 阿里巴巴, AI productions, RAG, 數字人, 模型, 視覺模型, 視頻模型, Video, 影像模型, 影像處理, 框架

DiffusionBench:擴散模型評測框架

DiffusionBench 透過統一的 NanoGen 框架,橫向比較 25 種 DiT 方法在 ImageNet 與文字生成圖像的表現,挑戰僅靠 FID 評估擴散模型的舊範式。

DiffusionBench logo

這是一個針對擴散 Transformer(Diffusion Transformers, DiT)研究的基準測試項目(benchmark),核心目的是在 ImageNet 與文字生成圖像(T2I)兩種場景下,對擴散模型進行統一的訓練與橫向評測。舊有做法普遍以 ImageNet 的類別條件生成(class-conditional generation)為單一評測標準,作者批評這種範式已經難以反映生成模型的真實進展,因為 T2I 雖然更貼近實用,卻常被視為過於昂貴或不便而跳過。為此,項目推出 NanoGen 統一訓練框架,並以 DiffusionBench 重新組織評測結構,把 ImageNet 與 T2I 納入同一比較基準。

  • 統一訓練介面:NanoGen 只需約 12 行的配置更改,就能在 ImageNet 與 T2I 之間切換。
  • 跨任務方法比較:系統性收錄並比較 25 種 DiT 方法。
  • 多維度評測指標:涵蓋 FID 等多項 ImageNet 與 T2I 指標。
  • 研究成果已收錄 arXiv 論文(2606.24888),對應的模型權重同步上載至 HuggingFace。
  • 目前版本為 v0.1,作者明確標示仍處於初步階段,並積極招募社群貢獻者。

與單獨的 ImageNet 評測相比,DiffusionBench 的關鍵差異在於同時納入 T2I 任務,藉此揭示方法排名在兩類任務之間並無強相關(no strong correlation),這意味著 ImageNet 上的 FID 提升未必代表 T2I 生成品質同步改善。框架支援 VAE、RAE 與 Pixel space 等不同潛在空間(latent space)的訓練,技術上整合了 REPA-E 與 iREPA 等對比方法,適合 DiT 研究團隊、生成式模型工程師,以及關心基準公正性的學術工作者使用。受惠最大的,是需要評估自家方法在多任務泛化能力的團隊,以及希望避免單一指標誤導的審稿人與研究者。

GitHub: https://github.com/End2End-Diffusion/diffusion-bench

項目主頁: https://end2end-diffusion.github.io/diffusion-bench/

Model: https://huggingface.co/diffusion-bench/diffusion-bench

Categories: 開源, 模型, 模型訓練, Image, 影像模型, txt2img, 框架, 深度學習

Page 2 of 12
1 2 3 4 12