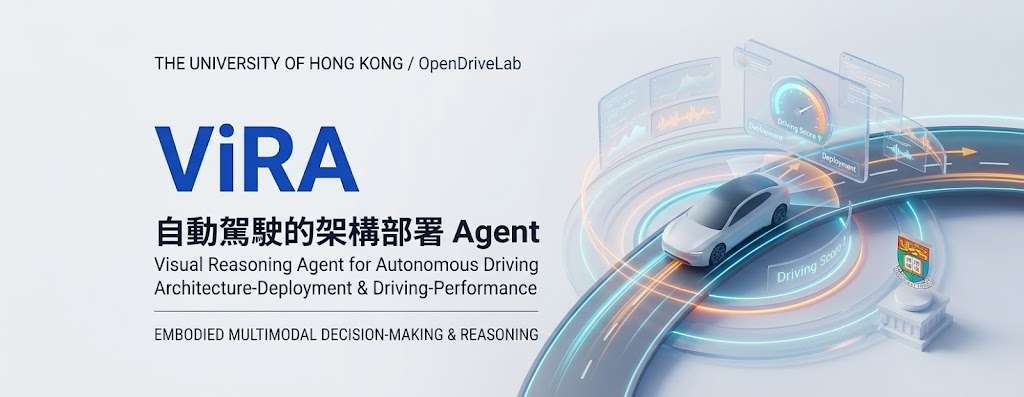
ViRA 讓視覺表徵真正改善自動駕駛

ViRA 把視覺基礎模型的表徵帶入端到端駕駛訓練,提升規劃表現之餘,不增加部署時的推理成本。

teaser

端到端自動駕駛需要由鏡頭直接產生駕駛規劃,但更強的視覺表徵未必自然帶來更好決策。ViRA 是一個 planner-agnostic visual representation alignment framework,於訓練期間把規劃器特徵對齊至凍結的 visual foundation models (VFMs),保留原有 planner 架構,部署時亦不增加推理成本。

項目由香港大學 OpenDriveLab、東南大學及 Shenzhen Loop Area Institute(SLAI)等團隊共同開發。它主要處理「視覺表徵強不等於駕駛表現強」的落差。研究測試多款 end-to-end planners,發現 VFM 目標的選擇會影響規劃效果;加入 auxiliary perception supervision 後,五個目標之間的 EPDMS 差距由 2.7 分收窄至 0.5 分,反映訓練訊號與目標模型需要一併考慮。

ViRA-Diffusion 以 DINOv3 alignment 訓練,毋須 auxiliary perception supervision,在 NAVSIM v2 navtest 取得 92.3 EPDMS,較比較中的近期方法至少高 1.9 分;在較具挑戰的 navhard,Rap* 配合 ViRA 亦錄得改善。HUGSIM 結果則屬 zero-shot,規劃器只在 NAVSIM 訓練,未在 HUGSIM 重新訓練。

項目的適用範圍:
– 適合研究 camera-only 端到端自動駕駛及 VFM 對規劃的影響。
– 可在不改動已部署 planner 架構的前提下,加入訓練期表徵對齊。
– 評測指標包括 NAVSIM 的 EPDMS,以及 HUGSIM 的 HD-Score。
– 儲存庫目前列出結果與示範已發布,但程式碼及 checkpoints 仍在待辦清單,未有足夠資料支持直接安裝或下載模型。

ViRA 更適合作為研究和模型訓練方法閱讀,而不是即時可用的駕駛軟件;它展示的是如何選擇 VFM 目標及監督方式,並非保證所有規劃器都會得到相同幅度的提升。
項目主頁 · GitHub

Categories: 開源, 香港大學, 模型, 模型訓練, 框架, 香港, 軟件, 庫, 自動駕駛

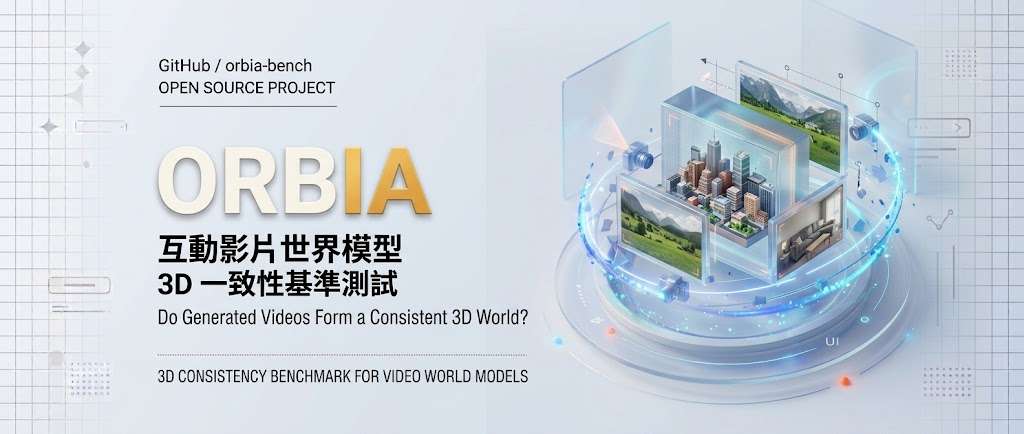
ORBIA 測試世界模型當鏡頭回頭後場景是否仍在

影片流暢,不代表場景能保持一致。ORBIA 讓鏡頭離開再折返,檢查世界模型有沒有「忘記」剛生成的內容。

ORBIA overview

鏡頭繞一圈後,同一件物件應該仍在原位。ORBIA 這套互動影片世界模型基準測試,透過探索與重訪場景,檢查生成畫面能否構成一致的 3D 世界,而不只看影片是否漂亮。

測試輸入包括圖片、場景描述及鏡頭軌跡,並以已對齊的彩色與深度影像(Red Green Blue–Depth,RGB-D)及標註物件作參照,比單一整體影像分數更能定位場景改變的位置。

  • 輸入保留(input preservation):原有場景與地標是否保留。
  • 生成內容持續性(generated-content persistence):重訪時,新生成內容是否一致。
  • 3D 自洽性(3D self-consistency):不同視角能否支持同一個 3D 重建。

儲存庫提供評估程式、模型適配器及資料建構流程,供研究團隊接入模型測試。720 個案例涵蓋六種軌跡,包含 22 秒及一分鐘版本;長版本安排三次重訪,能檢查較長時間的場景記憶。

項目已評估 27 個模型,但所提供資料沒有具體排名或分數。它適合補強世界模型的驗證流程,不能單憑測試規模判斷哪個模型更可靠。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, Image, 3D, 庫, Dataset 數據集

Doc2Harness:測試模型能否造出真正可用的 Coding Agent

Doc2Harness 不只測模型識唔識寫程式,還把整套 Coding Agent harness 交由模型建造,再以黑盒方式驗證是否真的運作。

Doc2Harness

當 Coding Agent 要處理長時間、多步驟工作,成敗不只取決於模型本身,還取決於工具呼叫、權限、工作階段、復原流程和整個執行迴圈。Doc2Harness 是一個評測基準,專門處理模型能否按照開發文件和介面骨架,建造完整 Coding Agent harness 的問題。

項目分成兩個階段:第一階段由 build model 在隔離容器內透過 OpenCode 實作 harness;第二階段會凍結成果,再放到另一個容器,由 scripted mock model 端到端驅動。評分不接受 harness 自己聲稱完成任務,而是讀取四個可觀察渠道:傳給模型的請求、磁碟檔案、程序 exit code,以及 command output;positive controls 亦會阻止空殼實作取得通過結果。

  • 測試範圍:完整基準包含 328 個 test cases,公開儲存庫只提供 94 個 scenarios,包括 53 個評分案例和 41 個 positive controls。
  • 模型差距:完整套件涵蓋 19 個 frontier models,最佳模型通過率為 53.05%,最低約 27.4%。
  • 可重現限制:排行榜數字來自完整套件,不能只用公開子集重現。
  • 執行條件:需要 Python 3.11+、Docker,依賴採用 Python standard library;完整 catalog 在 concurrency 12 下約需 25 至 90 秒。

這項目直接把 harness engineering 本身納入評測。結果亦反映模組拆分並非必然帶來好處:在控制程式碼大小後,module count 與通過率呈負相關,相關係數為 -0.423;同一模型在 direct drive 和 permissions 等場景的排名也可能大幅變動,顯示權限及工具編排是獨立而關鍵的能力。

Doc2Harness 適合研究 Coding Agent、模型評測和 agent infrastructure 的團隊,用來比較模型建造長流程工具系統的能力,亦可協助定位 harness 在請求流程、檔案操作、程序控制或復原機制上的失敗位置。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, Vibe Coding, 工具, Python, 庫, 編程, Anthropic, Dataset 數據集

ATAS 以持續世界記憶改善長片生成一致性

ATAS 讓每個鏡頭共享可回訪的世界狀態,減少長片生成中人物、場景與事件難以保持連貫的問題。

ATAS: Any Time, Any Space

長片生成最難處理的不是單一鏡頭是否漂亮,而是角色重返同一地點、事件在不同時間再次出現時,畫面能否維持一致。ATAS(Any Time, Any Space)屬於 agentic video generation 框架,將劇本拆成包含場景、鏡頭、時間及事件的 shot request,再以持續更新的世界狀態支援後續生成。

ATAS 沒有只把上一個鏡頭或提示詞傳給下一次生成,而是分開保存兩類記憶:Scene Memory 記錄已註冊的靜態幾何,Event Memory 則按場景、事件和時間索引動態觀察。新片段生成後會被重建、註冊及檢查,只有通過審核和狀態驗證的內容才會更新記憶;影片交付則不受記憶是否接納影響,減少錯誤觀察污染後續鏡頭的風險。

• 將劇本編譯成具體的場景、相機和事件時間要求
• 支援從不同視角回訪同一場景
• 可重現較早時間點發生過的事件
• 生成後進行註冊、審核及世界狀態檢查

項目展示的差異,在於把跨鏡頭一致性視為世界狀態管理問題,而不是單純延長上下文或串接最近畫面。這會增加記憶建立、片段重建和驗證所需的計算與流程複雜度,但更適合長片、分段製作及需要角色與場景持續連貫的內容工作流。

研究結果涵蓋四個影片生成器;ATAS 在報告的跨鏡頭一致性指標均有改善,並在每個 backbone 取得最高綜合 benchmark 分數。它亦在目標影像空間回訪、三項事件重現指標及六項人工評分準則中領先比較的 agents 和 3D-guided methods。儲存庫目前主要提供研究程式碼、技術資料及示範,使用者需要按項目頁面的環境與模型依賴自行重現流程。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 視頻模型, Video, Image, World-Action Model, 提示詞, 框架, 3D, 庫, Dataset 數據集

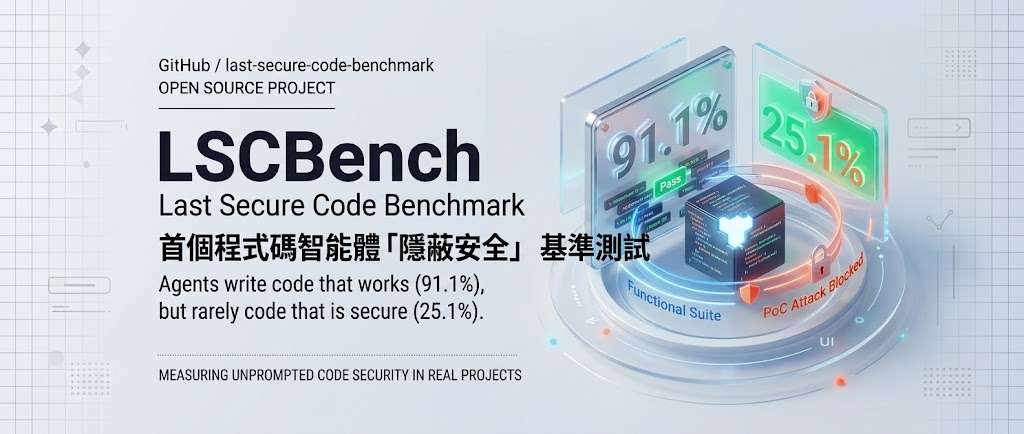
LSCBench 揭示 AI 編程代理安全盲點

LSCBench 以不提安全的真實漏洞重建任務測試編程代理,結果顯示能正常運作與同時安全的程式碼仍有明顯距離。

Qwen

當編程代理只收到功能規格、完全沒有被提醒要處理安全問題時,能否自行避開已知漏洞?Last Secure Code Benchmark(LSCBench)正是用來回答這個問題的開源基準測試項目:它從真實項目移除曾經包含漏洞的程式碼,再要求代理按規格重建,最後以功能測試及重現原有攻擊的安全測試共同評分。

LSCBench 共設 450 個任務,涵蓋 150 個漏洞情境,包括 115 個 Common Vulnerabilities and Exposures(CVE)案例及 35 個專家編寫的 Java 應用程式,支援 C、C++、Go、Java、JavaScript、PHP 和 Python。每個情境分成 function、file 及 repo 三種粒度,分別測試代理修補最小函式、相關檔案,以及較完整程式庫的能力。

六個模型在 450 個任務中大多能產生可運作程式碼,但同時通過功能和安全測試的比例最高只有 25.1%。Claude Fable 5 配合 Claude Code 取得最高 Func∧Sec 比例,GPT-5.6-Sol 的安全測試通過率則以 25.8% 稍高;Kimi-K3 雖然功能通過率達 91.3%,兩項測試同時通過的比例只有 16.4%,反映功能完成度與安全性並非同一件事。

  • 測試焦點:編程代理沒有收到安全提示,必須自行辨認風險。
  • 評分方式:功能測試確認程式可運作,安全測試重播原有攻擊。
  • 資料範圍:450 個任務、150 個漏洞情境、7 種程式語言。
  • 粒度差異:同一情境會在 function、file、repo 三個層次出現。

LSCBench 屬於面向 Computer-use agents(CUAs)及 coding agents 的安全基準測試,實際解決的是「生成的程式碼能否在沒有安全提示下仍然避免已知漏洞」這個評估缺口。對模型開發團隊、安全工程師及採用 AI 輔助編程的團隊而言,項目提供了比單看功能通過率更接近真實風險的檢查方式;不過,測試結果只涵蓋指定漏洞與攻擊重現流程,不能取代完整 code review、模糊測試及正式安全審計。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, OpenAI, DeepSeek, Python, 庫, 編程, 安全, Anthropic, Dataset 數據集, Kimi

VideoJev 加速影片理解,問答推理快逾百倍

VideoJev 把時間定位與選擇題影片問答放進同一個評分介面,減少生成式回答的延遲。

VideoJev

處理長片段、重複提問或需要找出事件時間的工作時,VideoJev 不必逐字生成答案,而是直接比較候選時間區間和答案選項。這個項目屬於影片理解模型,實際處理 temporal grounding 與 multiple-choice video QA,並將兩項任務放進同一個決策介面。

它以共享影片計算配合 Cached inference 和 Joint inference:前者保留已處理的視覺資訊,方便後續查詢;後者讓多條問題在一次 forward pass 中完成。相較依靠 autoregressive decoding 的 video multimodal large language models,直接候選評分較適合大量、結構清晰的判斷,但不負責自由生成長篇答案。

  • VideoJev-4B 建基於 Qwen3.5-4B,VideoJev-35B-A3B 建基於 Qwen3.6-35B-A3B
  • 兩個模型均提供 BF16、Safetensors 權重及 Hugging Face checkpoint
  • 三個 temporal grounding benchmark 的 mIoU,較各自 backbone 分別提升 6.7 和 10.8 分
  • 四個影片問答 benchmark 在 Thinking mode 維持相近表現,推理速度提升超過 100 倍

研究結果亦量得 temporal grounding 約 2.8 至 3.1 倍加速,顯示它較適合影片搜尋、內容索引、監控片段定位,以及需要連續提出多條問題的視覺代理工作流。試用可按儲存庫提供的環境設定,透過 Transformers 的 AutoModel、AutoProcessor 載入 Hugging Face 權重,再以示範影片測試;不過儲存庫資料未交代硬件門檻,BF16 模型的記憶體需求仍需按部署環境自行確認。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, AI productions, 模型, 多模態模型, Qwen, Video, 庫, Dataset 數據集

CrossTimeEdit-release:用衛星變化還原歷史街景,補回城市記憶

CrossTimeEdit 把歷史街景生成改成有證據約束的影像編輯,利用新舊街景與衛星變化重建城市過去面貌。

CrossTimeEdit teaser

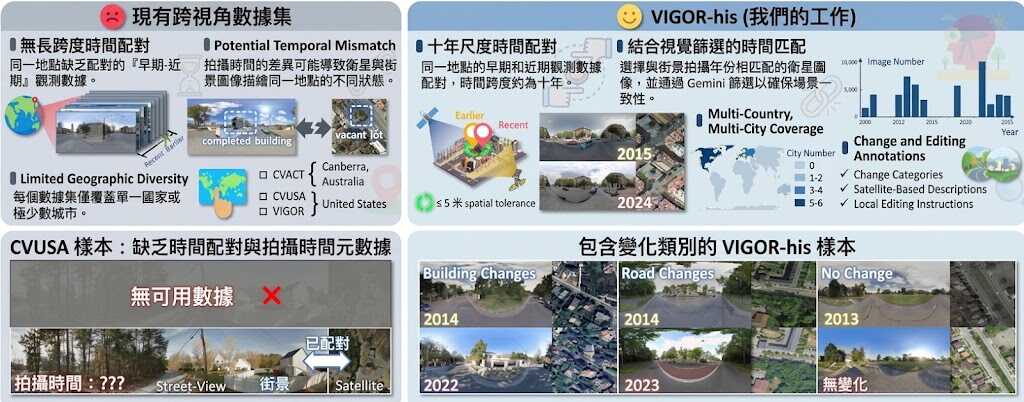
街景資料未必記錄到城市每次改建,CrossTimeEdit 便把近期街景、不同時期的衛星影像和跨視角資訊結合,推算較早期的街道外觀。這個項目屬於視覺生成模型及跨視角資料集,實際處理的是在保留未改變背景的同時,重建建築、道路或其他城市元素的歷史變化。

核心資料集 VIGOR-his 收錄來自三大洲 11 個城市的 43,653 組位置級四元組,配對早期與近期街景、衛星影像,並加入變化分類、衛星變化描述及局部編輯指令。模型以近期街景固定視角和場景內容,再把不同時期的衛星差異當成變化證據,較單純依賴文字提示的生成方式更適合處理具地理關聯的重建工作。

CrossTimeEdit 以 FLUX.2 [Klein] 4B 為起點,先進行 Supervised Fine-Tuning (SFT),再以 Online Reinforcement Learning (RL) 優化。訓練獎勵同時考慮 Instruction Alignment (IA)、Background Preservation (BP) 及 Quality and Physical Plausibility (QP),並透過 Flow-GRPO 與 GDPO 在不同獎勵維度之間作平衡,減少只追求畫面逼真而破壞場景一致性的取捨。

  • VIGOR-his 提供約十年跨度的跨視角城市資料
  • 模型同時保留未變背景及重建指定變化
  • 評估涵蓋指令符合度、背景保留和物理合理性
  • 整體三項編輯指標較預訓練基線提升 17.12%
  • 相比跨視角生成模型,在場景一致性、視覺真實感及感知質素上更佳

城市歷史研究、地理資訊分析、舊城改建記錄和地圖內容補全都可能受益於這套方法,但生成結果仍屬推算,不能取代真實歷史影像。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Stable Diffusion, Image, 庫, LoRA, 強化學習

T3lescope 把多視角影像變成高質 3D 場景

由單一物件到城市級戶外場景,T3lescope 嘗試以生成模型兼顧整體幾何、細節,以及玻璃和鏡面表面重建。

T3lescope teaser

面對影像稀疏、表面反光或透明等情況,T3lescope 仍嘗試由已標定相機姿態的多視角影像重建高保真 3D scene mesh。它屬於生成式 3D 重建模型,處理的是大型場景難以同時維持覆蓋範圍與局部細節的問題。

模型以 mesh flow models 直接生成高解析度網格,並在推理階段採用 coarse-to-fine cascade:先用較粗層級建立全局布局,再於更細的 spatial cells 內擾動、去噪和補回幾何細節。各層共用同一個 fixed-resolution generator,訓練時以不同尺度的 cells 學習,因此層級數量、cell 尺度和位置都可於推理時調整。

這做法減少把大型場景切成多個獨立重建區域後出現的接縫和全局不一致風險,也不需要逐個場景進行 per-scene optimization。代價是重建品質仍取決於輸入影像數量、視角覆蓋和模型推理配置,而 README 未提供硬件要求、速度或完整操作流程。

T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
  • 支援由單一物件、室內環境延伸至戶外和城市級場景
  • 可在推理階段選擇 cascade 層級與網格細緻程度
  • 針對稀疏觀測、細小結構、glossy 及 transparent surfaces 提供生成式補全
  • 在室內、戶外及城市場景測試中勝過 feed-forward 和生成式基線,並達到或超越部分 per-scene optimization 方法

適合需要多視角影像轉 3D 資產的視覺研究、數碼孖生、機械人感知和場景製作團隊,較容易受惠於這種跨尺度重建能力。不過 GitHub 項目目前只標示 Code is coming soon,尚未提供可安裝程式碼;現階段可參考 arXiv、項目網站和示範影片理解結果,未能按儲存庫直接測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, 3D, 庫

tabulaflow:自然語言查數據(text2SQL)

TabulaFlow 讓使用者用自然語言分析、轉換和視覺化多種數據,並可由圖表追查背後的資料表與查詢。它適合需要跨資料來源探索數據、又要保留分析脈絡的團隊。

想查詢資料庫、整理檔案或探索 Hugging Face 數據集時,使用者可以用自然語言描述分析目標,再由 TabulaFlow 這個開源 Python 數據代理程式處理查詢和圖表。它支援 SQL 和圖形資料庫、檔案、Wikidata 及網頁,適合研究、數據分析和需要把數據功能整合進應用程式的團隊。

與以檔案和 Shell 為核心的編程代理不同,TabulaFlow 把表格當作主要工作單位。代理程式負責產生查詢和視覺化規格,系統則處理資料解析和圖表呈現,減少模型直接拼接資料值或 HTML 的需要;核心數據工作亦可在關閉 Shell 和檔案存取時運作。它仍能編寫程式、執行 Shell 指令和瀏覽網頁,但這些能力不是數據工作的必要條件。

每張視覺化結果都能查看所用的資料表,而資料表亦保留產生它的查詢,方便核對結果來源和重現分析。這對需要審視數據處理過程的團隊有幫助;不過,查詢是否符合使用者原意,仍會受問題描述和模型判斷影響,追蹤來源不等於保證結果正確。

項目提供互動式消歧、資料庫對話、研究資料庫建立及圖形數據查詢等示範。研究者亦可用配套工具進行 text-to-query 實驗;ARCS 是用來評估 SQL 問題歧義處理的基準,不是 TabulaFlow 本身的效能分數。文件列出安裝方式為透過 uv 安裝並設定模型供應商金鑰,支援哪些模型則需查閱其模型文件;提供的資料未列出完整操作流程或各資料來源的設定細節。

  • 支援資料庫、檔案、Hugging Face datasets、Wikidata 和網頁等來源。
  • 以查詢和視覺化規格驅動分析,資料解析及圖表呈現交由系統處理。
  • 圖表、資料表與來源查詢之間保留可追溯關係。
  • 適合數據分析、研究及建立數據應用程式;結果仍需按資料和查詢目的核實。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 工具, Python, 庫, 編程, Dataset 數據集

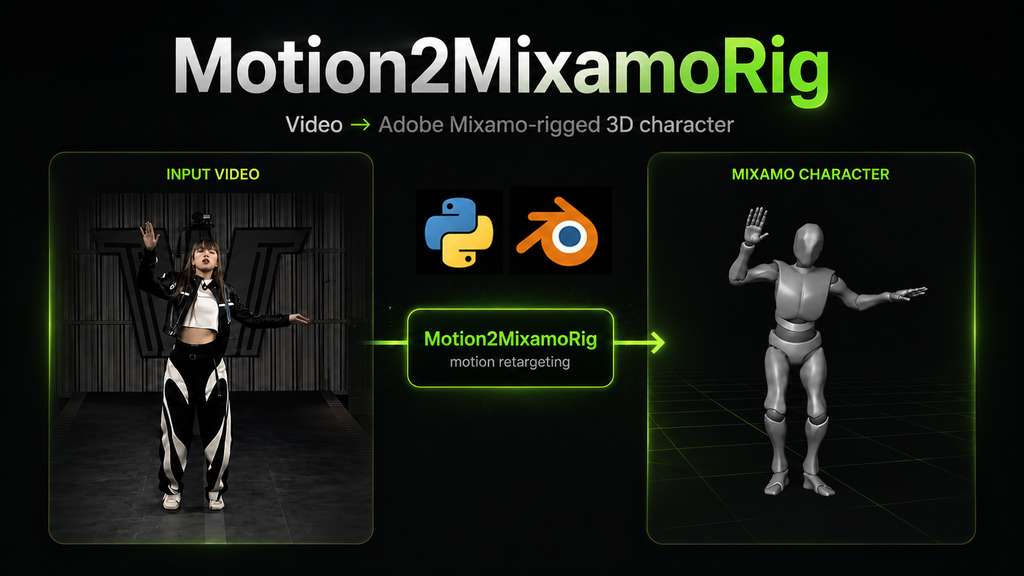
Motion2MixamoRig:把真人動作搬入 Mixamo 角色的開源工具

Motion2MixamoRig 將單人影片或照片姿勢轉成 Mixamo 角色動作,直接輸出可供 Blender、Unity 使用的 3D 檔案。

Motion2MixamoRig

把單人動作影片或一張姿勢照片套到 Mixamo 角色上,Motion2MixamoRig 便可輸出預覽影片及帶蒙皮的 .glb 角色檔,減少遊戲開發者重新製作基礎動作的工序。它屬於 3D 動作轉移工具,處理的是真人影像與已綁定骨架角色之間的動作銜接問題。

流程以 SMPL-X、GVHMR 等模型先從影像估計人體動作,再將結果映射到 Adobe Mixamo rig;模型不負責生成全新動作,而是把影片或照片中的姿勢重建後套用到指定角色。輸出可放入 Blender 或 Unity,仍要留意單人畫面、遮擋、鏡頭角度及原角色骨架會影響結果。

模型權重首次執行時約需下載 5 GB;原始資料沒有提供正式性能基準或準確率數字。項目目前仍屬 experimental,0.1.0 提供 command-line pipeline,亦附有 Blender 4.2+ Extension,並在外部 Python 環境執行同一套流程。

  • 支援影片動作及單張照片姿勢
  • 輸出預覽影片與 .glb 檔案
  • 兼容 Blender、Unity 工作流程
  • 需要單人素材及外部模型權重

遊戲原型、角色動畫測試及需要快速重用真人動作的團隊較適合採用。ffmpeg 並非流程必需,但缺少它會令輸出影片沒有聲音,並可能無法在瀏覽器播放;對需要穩定製作級動畫的人員而言,仍要自行檢查骨架映射、腳部滑動和遮擋造成的誤差。

GitHub

Categories: 開源, AI productions, 數字人, 模型, Video, Image, Audio, 工具, 3D, Python, 庫, 動畫

Page 5 of 17
1 … 3 4 5 6 7 … 17