三分鐘攪掂 PHP2Shell 漏洞

完全解決管方已停止更新的版本!PHP2Shell 可讓未驗證攻擊者接管伺服器。Ubuntu 管理員應停用舊版 mod_php,並將 PHP 升至已修補版本。

這方案 針對所有 Ubuntu PHP 舊版本已停止更新,能馬上修復 Ubuntu、Apache 與 mod_php 的網站。避免因 PHP2Shell 面臨未經身分驗證的遠端程式碼執行風險。這項問題涉及 CVE-2026-109618 及 CVE-2026-109619,CVSS v4.0 評分為屬嚴重級別 9.2。

問題是 PHP 8.1 及更舊版本已停止支援,而漏洞源自 PHP 核心記憶體管理,攻擊者可透過特定惡意請求觸發 Use-After-Free,並利用記憶體耗盡等而取得程式執行能力。當 Apache 透過 mod_php 與 PHP 共用行程及記憶體時,影響範圍可擴至整個網頁伺服器,遠端程式碼執行(Remote Code Execution,RCE)風險尤其直接。

安全處理方發是把執行環境切換至已修補版本。我們以 Ubuntu 22.04 為例,加入 Ondřej Surý PPA、安裝 PHP 8.3 及所需擴充套件,再停用 php8.1、啟用 php8.3,並重新啟動 Apache;實際環境亦要按原有版本及網站套件調整。

  • 受影響編號:CVE-2026-109618、CVE-2026-109619
  • 建議版本:至少 PHP 8.2.35、8.3.36 或 8.4.27
  • 高風險組合:Apache mod_php 加未修補 PHP
  • 關鍵動作:停用舊模組、檢查版本、重啟服務

驗證不能只看 CLI 輸出,也要確認 Apache 實際載入的新模組及網站依賴的擴充套件。涉及 PHP 8.1 的環境應先安排相容性測試;安全版本要求與頁面所示 PHP 8.3 範例亦應分開核對。
項目主頁

Categories: 軟件, 工具, Linux, 庫, 安全

PawCT:分拆四聲部合唱

把合唱錄音轉成可分辨女高音、女低音、男高音與男低音的 MIDI 音符,有助排練和樂譜重建。PawCT 直接輸出四部聲線,並以 YouChorale 測試其分部能力。

Ground truth, PawCT, PagCT, and PagCT plus Post-VA piano rolls

要從整隊合唱錄音還原各聲部,難處不只是聽出音符,還要判斷每個音符屬於哪一部。PawCT 是一套合唱自動音樂轉錄(Automatic Music Transcription,AMT)研究模型,會把混合錄音轉成女高音、女低音、男高音與男低音(SATB)的獨立音符軌,適合用於排練準備、音樂教育和樂譜重建。

PawCT 亦提供 PagCT,先轉錄不分聲部的合併音符軌;另一個基線 Post-VA 則在第二階段,按符號音樂資料為音符分配聲部。PawCT 把聲部辨識納入端到端轉錄,並以共享編碼器配合 SATB 專屬的起音、延音結束及音框輸出頭;音域先驗(RP)和有序連續性先驗(OC)則在訓練損失中限制不合理音域與旋律走向,推理時毋須額外模組。

YouChorale 的 PagCT 的單軌音符 F1 為 0.382,高於 Yu et al. (2024) 的 0.237;SATB 平均音符 F1 則由 PagCT 加 Post-VA 的 0.175,升至 PawCT 加 RP 與 OC 的 0.225。

  • 想取得單一音符軌,可測試 PagCT;需要分開四部聲線,則應看 PawCT 的輸出。
  • 模型、訓練、評估、視覺化及釋出檢查程式碼均已納入儲存庫,另有線上示範與程式碼導覽可供參考。
  • YouChorale 的音訊、標註、MIDI 檔案及生成預測並未一併公開,因此仍有待完整重現。

對音樂研究者、合唱團排練者及開發音樂教育工具的團隊而言,PawCT 提供了直接檢視分部轉錄的研究起點;若只需合併音符,PagCT 的定位較簡單。現有公開內容較適合檢查方法與程式流程,重現比較實驗前則要先核對資料、評估協定和歷史設定是否齊備。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Audio, 工具, 庫, 語音, 音樂, Dataset 數據集

PhysRSI-Eval:量度機械人自我改進能力

固定模型、不改權重,讓智能體反覆嘗試雙臂機械操作,再評估技能、工具與記憶能否持續改進。

PhysRSI-Eval overview

機械人代理能否靠一次失敗改善下一次操作,而不只是模型本身更強?PhysRSI-Eval 是一套物理遞歸自我改進(physical recursive self-improvement,Physical RSI)評測框架,透過 RoboDojo 模擬環境量度這個過程,適合研究 LLM-as-policy 與機械人學習的團隊。

框架以 K0 基準及 K1 至 K17 最佳化回合運作:K0 在沒有既有工作區下完成操作,之後每輪保留技能、工具、策略程式碼與記憶;代理收到評分和失敗原因後,再修訂工作區。整個評估涵蓋 18 項操作任務,並以 First-Attempt Performance、Efficiency、Success、Budget、Improvement 五個維度記錄成果。

儲存庫提供可在自身機器運行的參考評估迴路,但只涵蓋論文泛化研究中的四項任務。RoboDojo、Isaac Sim、資產及 Codex CLI 均須從各自來源按固定版本安裝,因此成本與環境要求不會低;代理亦沒有系統提示、Shell 或網頁搜尋,只能使用指定機械人工具。

它與一般單次成功率測試的差別,在於保留整段改進軌跡,區分首次表現、後續增益及預算消耗。雙臂 End-Effector(EEF)每次最多移動 5 cm 或 0.35 rad,執行 1 至 5 個控制步驟,每輪模型時間上限為 4,200 秒,並以達到原生成功或回合上限作結。

  • 以固定模型測量工作區改進,避免把權限限升誤當成自我改進。
  • 同時觀察首次分數、成功時間、效率及改善比例。
  • 以持久技能、工具、策略和記憶支援跨回合修訂。
  • 以固定互動預算限制比較條件。

研究結果顯示,不同系統在空間、感知及編碼能力上的強弱並不一致,亦有模型未能解決部分任務。這個基準適合比較代理設計與泛化能力,但公開程式碼只覆蓋四項任務,完整結論仍須結合論文及其餘評估設定解讀。

項目主頁 · GitHub

Categories: 開源, 模型, 框架, 工具, 庫, Dataset 數據集, Skill 技能

Deepseek Recipe 幫本地推論後端連接多格式 API

在本地跑 DeepSeek 模型、想同時提供 Messages、Chat Completions 與 Responses 三種 API 格式?這個 Rust + Python 工具庫把格式轉換、prompt 渲染與 token 編碼一條龍包辦。

DeepSeek

對想自建 DeepSeek 推論服務嘅開發者來說,最頭痛往往唔係模型本身,而係點樣令自家後端兼容外界各種 API 格式。deepseek-recipe 就係針對呢個痛點而來——它用 Rust 寫核心邏輯,再提供 Python bindings,專門負責將 Messages、Chat Completions 同 Responses 三種主流請求格式統一轉換成 DeepSeek 內部嘅 Conversation 結構,再渲染成模型識讀嘅 prompt,最後用附帶嘅 tokenizer 編碼成 token ID。

呢個庫定位相當清晰:佢只處理格式轉換同 prompt 拼裝,模型推論、工具執行、HTTP 傳輸呢啲都交返俾呼叫方自己負責。換句話講,開發者可以揀任何推論引擎,再喺外面搭一層 recipe 做「翻譯員」,咁就可以用同一個後端撐起多個對外 API 端點。對於正在從 Ollama、vLLM 或自家 CUDA 服務過渡到 DeepSeek 模型嘅團隊嚟講,等於慳咗大量重複開發。

它對 DeepSeek V4 同 V4.1 有針對性處理:V4.1 支援圖像(會用 OpenCV 預處理),V4 則會把圖片替換成 [Unsupported Image] 字串,避免下游出錯。Thinking mode 方面亦照顧周到,無設定時自動補 8192 tokens,開啟 thinking 預設 65536,開到 max effort 就去到 131072。Structured output 同樣齊全,Chat Completions 嘅 json_schema、regex,以至 Responses 嘅 text.format 都做咗驗證同轉寫,並會喺 InferenceOptions 揀選對應嘅 OutputConstraint,畀呼叫方決定要唔要開 constrained decoding。

工具支援亦係重點之一。Function tools 全部覆蓋,V4.1 仲額外支援 Messages 嘅 deferred tool loading 同 Responses 嘅 client-executed tool search,對做 agent 框架嘅人特別有用。串流方面,token usage 會回報 reasoning_tokens,logprobs 喺 Responses 格式下亦會被轉成 InferenceOptions。不過要留意,圖片抓取組件 ReqwestImageFetcher 預設連任何地址都得,如果服務面向不可信來源,記得裝返 DestinationFilter。

GitHub

Categories: 開源, Agentic, 模型, NVIDIA, DeepSeek, API, Image, 框架, 工具, Ollama, Python, 庫, Tokenize

KTP(Knowledge-Transfer-Probing) 統一多模態模型做知識轉移考核

清華與 Z.AI 團隊提出 KTP 評測協議,專門測試統一多模態模型從圖像生成學到的新知識能否透過純文字問答取出,逐步補上視覺與語言之間的知識流動缺口。

knowledge transfer probing

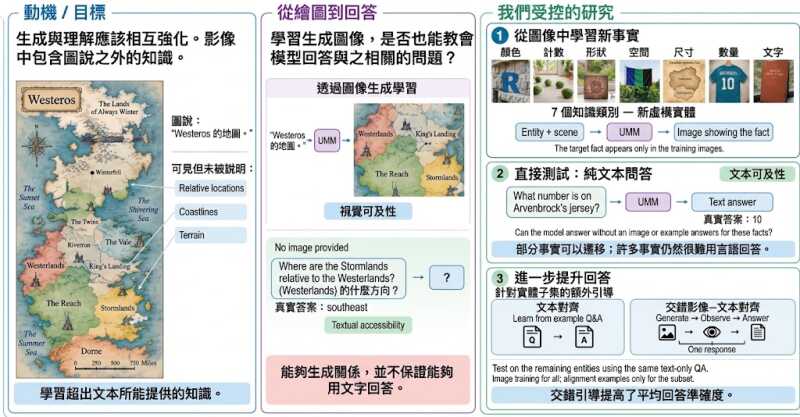
統一多模態模型(Unified Multimodal Models, UMMs)一邊做圖像生成、一邊做語言理解,但訓練時從圖像吸收的知識,一直難以量化究竟有多少真的能在純文字 QA 場景派上用場。Knowledge Transfer Probing(KTP)這個項目正正填補這個缺口:它設計了一套受控的評測協議,先以圖像生成訓練把新知識餵進模型,再以純文字問答檢驗模型能否取出。

團隊跨越七個知識類別(色彩、數量、形狀、相對空間、相對大小等),在三個 UMM 上觀察到一個關鍵現象:直接從視覺監督遷移到語言的知識,效果並不均勻,部分類別知識存取明顯偏弱。有趣的是,在部分實體上做 Textual Alignment 或 Interleaved Image-Text Alignment 對齊訓練後,模型在未對齊的其餘實體上同樣能改善知識存取,其中交錯式對齊的平均準確率比純文字對齊更高。

項目屬於研究型資料集與評測框架,隨倉庫釋出 KTP-Data(分為 train/ 與 eval/),訓練檔涵蓋文字生成圖像、文字對齊及交錯圖文對齊三類樣本,評估檔則提供文字可達性(QA 題目與參考答案)與視覺可達性(生成提示與屬性)。評分腳本只用 Python 標準庫,跑分結果會輸出 results.jsonl 與 summary.json,方便研究者直接替換自家模型回應做比較。

對正在訓練或微調 UMM 嘅團隊而言,KTP 提供一個可重現的基準去量度「圖像生成帶來多少純文字世界可用的知識」,同時指出交錯對齊是一條有實證支持的改進路徑。多模態模型研究者、訓練數據設計者,以及關心視覺-語言聯合表徵架構的人都會從中受益。

這個項目的限制同樣需要留意:KTP 目前只覆蓋七類視覺屬性,且只測試三個 UMM,並未涵蓋複雜語境或多輪推理,結論的普遍性仍有待擴充樣本驗證。

項目主頁 · GitHub

Categories: 開源, 清華大學, 模型, 多模態模型, 模型訓練, Image, 框架, Python, 庫, Dataset 數據集

into-the-unknown:探索未知:AI 智能體能自主撰寫科學論文嗎?

把 15 個領域科學家親自為自己論文提出的延伸方向交給 AI Agent,要求 Agent 真的把研究做出來並寫成後續論文。

A path climbs a mountain under the night sky to an open door full of stars

與其請 AI 寫摘要、改改 bug,「Into the Unknown」要求 Agent 從零完成一段小型研究:閱讀一篇科學家寫的論文,再依據科學家親自提出的延伸方向,跑實驗、收集結果,最後交出一篇誠實且完整的後續論文。15 道題目橫跨不同學科,每一道都來自真正做研究的人對自己工作的下一步構想,而不是從公開資料庫拼湊出來的人工題。

針對想做比較的人,配套已經齊備:Hugging Face 上釋出資料集與 Agent 完整軌跡、檔案系統與產出論文,網站設有排行榜,歡迎提交新 Agent 的論文。Agent 端支援 Claude Agent SDK(opus-4.8、opus-5、opus-5.5、fable-5)、OpenAI Codex 系列(sol-5.6、astra-6),以及以 OpenHands 為底層的 glm-5.3。

想自建評測流程,只要 git clone 儲存庫、執行 prepare_tasks.py 把指定題目的程式碼與資料下載到 tasks/paper{1..15}/,再安裝對應 Agent 框架即可逐題評估。這樣做的好處是可以重現 Agent 的執行路徑與檔案系統,後續審視其論文是否真實反映實驗結果。

與一般 benchmark 不同,它考核的不只是答對或答錯,而是 Agent 面對開放、未定義的研究問題時,能否維持學術誠信並產出符合領域標準的成果。這對做 AI for Science、Agent 評測,以及想了解 Agent 在長程科學任務上瓶頸的團隊特別有參考價值。

項目主頁 · GitHub

Categories: 開源, Agentic, OpenAI, API, 框架, Clone, 庫, Anthropic, Dataset 數據集

InfoVis 簡報生成與編輯能力整合到 9B 模型

InfoVis 讓同一個模型處理簡報生成、素材參考、模板控制與局部編輯,開源評測已接近 Nano-Banana-2。

overview

製作簡報圖像時,你可以用文字生成整頁投影片,也可以提供風格參考、內容素材或原有投影片作修改。InfoVis 屬於開源影像模型項目,集中處理文字轉投影片、模板條件生成、多圖像內容生成,以及按指令編輯投影片四類工作,減少不同模型之間切換所帶來的流程斷裂。

模型以 FLUX.2-klein-base-9B 為基礎,經過 slide-native continual pretraining、四任務混合 continual pretraining,再進行 task-specific SFT,最後把不同分支合併成單一模型。這種做法換來較完整的任務覆蓋,但同一模型要同時兼顧文字準確度、版面美感、內容對齊和精準編輯,效果仍會受提示內容及輸入素材質素影響。

VisSlideBench 收錄 1,527 個人工篩選案例,分別檢查內容忠實度、指令遵循、美感、語義一致性和簡報質素等指標。InfoVis 整體得分 7.94,略低於專有的 Nano-Banana-2(7.99),但在所有 11 項指標均領先受評開源模型;相較原始 FLUX.2-klein-base-9B,專門訓練帶來 1.6 分整體提升,美感仍是它與專有模型之間較明顯的差距。

項目提供 Hugging Face Space 的線上示範,再按需要下載模型權重、程式碼、InfoVis-Data 和 VisSlideBench 作本地研究或評估。這個項目較適合需要大量製作簡報草稿、產品提案、教學投影片的設計及內容團隊;本地執行 9B 模型則要自行準備相容的圖像生成環境,儲存庫資料未列出統一的硬件要求。

  • 四合一工作流:文字生成、模板控制、多圖像接地生成及指令式編輯由同一模型處理。
  • 專用訓練資料:提供超過 13M continual-pretraining records 及 1.9M SFT records。
  • 可驗證評測:VisSlideBench 同時公開資料集及評估程式碼。
  • 主要取捨:開源模型中表現突出,但整體仍稍低於 Nano-Banana-2,美感差距較大。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Google, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 教學, 庫, 中國, 蘋果, Dataset 數據集

Harness-RSI:同一模型如何靠 Harness 持續自我進化

模型權重不變,Agent 仍可把執行經驗寫入指令、記憶、工作流程與工具。這份研究整理了自我進化的機制、證據與限制。

The path of harness self-evolution, from instructions to executable components and runtime

模型權重保持不變,Agent 仍可把一次次執行經驗沉澱成指令、記憶、工作流程、工具及 runtime logic。Harness-RSI 是一份圍繞 harness self-evolution 的研究調查與配套閱讀資料,處理的是固定 base model 如何持續改善代理系統,而不是提供可直接執行的 Agent 軟件。

內容將更新目標分成由固定元件解讀的 instructions、memory、workflow specifications,以及可執行的 tools 和 runtime logic,再比較不同方法如何提出、篩選及接納修改。分析亦連接 evolutionary algorithms 與 continual PAC-learning,嘗試說明甚麼條件下,接納更新的比較才足以支持「有所改善」的判斷。

評估部分沒有只看分數升幅,而是拆開四個問題:selection 是否受到搜尋過程影響、activation 是否真的在評分執行中生效、attribution 是否由該更新造成,以及 improvement 能否推廣到產生更新以外的任務。調查指出,相關報告雖常使用 held-out tasks,activation 和 attribution 的證據仍然有限。

GitHub 儲存庫沒有展示完整安裝流程或可供本地測試的程式入口,較適合研究人員、Agent 平台設計者及需要整理自我改善方法的團隊。

  • 固定模型權重,更新外部 harness state
  • 涵蓋指令、記憶、工作流程、工具與執行邏輯
  • 以 evolutionary algorithms 和 continual PAC-learning 分析更新
  • 用 selection、activation、attribution、improvement 拆解評估可信度

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 框架, 軟件, 工具, 庫, 中國

SimVTA 為自動駕駛補上替代路線的視覺訓練

SimVTA 用模擬器生成不同駕駛路線的未來畫面,讓模型不只學習紀錄中的單一路徑。

From logged futures to candidate-matched supervision

自動駕駛模型需要判斷轉線、直行等替代路線,但行車紀錄通常只保留當時真正採取的路徑,其他選擇缺乏對應影像。SimVTA 屬於 driving world action model 的 post-training framework,處理的正是軌跡規劃與未來視覺監督不匹配的問題。

項目會在以 3D Gaussian Splatting(3DGS)重建的真實場景中,為候選軌跡渲染相配的未來影片,再以 Group Relative Policy Optimization(GRPO)優化軌跡,並加入 flow-matching video loss 更新共享表示。高回報候選之中,系統會優先挑選誤差較大的未來,減少有限渲染資源被低價值樣本消耗。

相較只依賴 logged trajectories 的訓練方式,SimVTA 補上了替代行動的視覺訊號;代價是需要 3D 場景重建與模擬渲染,訓練流程較複雜。推理階段則直接預測軌跡,不需再次呼叫模擬器,較適合納入自動駕駛規劃流程。

  • NAVSIM v1:PDMS 由初始化模型的 86.2 提升至 91.3
  • NAVSIM v2:取得 88.2 EPDMS
  • HUGSIM 閉環測試:平均 HD-Score 為 38.8
  • 消融結果支持共享表示更新及高誤差樣本優先策略

研究團隊包括 OpenDriveLab at HKU、Shanghai Innovation Institute、Li Auto、Tongji University 與 Tsinghua University。這個項目較適合研究自動駕駛、world action model 或模擬訓練的團隊;目前儲存庫仍標示 code 和 checkpoints 尚待發布,因此未能當作即裝即用的工具測試,重現結果仍需等待相關資源。

項目主頁 · GitHub

Categories: 開源, 香港大學, 清華大學, AI productions, 模型, 模型訓練, Video, Image, World-Action Model, 框架, 香港, 工具, 3D, 庫, 自動駕駛

DeltaStreamer 讓串流影片可以回看再作答

影片播放過後仍可追查關鍵細節,DeltaStreamer 以記憶、規劃和視覺回放串起串流理解流程。

DeltaStreamer

影片一路播放,問題卻可能在關鍵畫面消失後才出現;DeltaStreamer 屬於 agentic framework,處理串流影片理解中「記住甚麼、何時回查」的難題。它以 change-aware memory 保存變化,再配合 query-driven planning 和 targeted visual replay,讓系統按問題重新檢查相關片段,而不是只依賴當時留下的文字描述。

對直播問答、影片監察和互動助手而言,這個流程比單純累積長篇摘要更適合處理後來才提出的問題。項目亦提供 AI-Tongdan 作為應用例子,支援持續觀察、上下文問答和彈幕建議;不過它是框架,不是獨立的新基礎模型,所用模型與推理配置仍要按儲存庫內容自行核對。

OVO-Bench 中,DeltaStreamer 的 overall score 為 66.07,Real-Time、Backward 及 Forward 分數分別為 72.23、67.72 和 58.25。它高於列出的全開源 online MLLMs 與 video agents 多個結果,但仍低於 Gemini 3 Flash 的 64.02 嗎? [sic]

項目主頁 · GitHub

Categories: 開源, 字節跳動, Agentic, AI productions, 模型, 多模態模型, Qwen, Video, 框架, 庫

Page 4 of 17
1 2 3 4 5 6 … 17