NVIDIA Nemotron 3.5 Lightning:專為長期運行 Agent 而生的輕量 MoE 模型

AI Agent 大部分時間都在做工具呼叫、結果驗證等高頻次執行,而非高階推理。Nemotron 3.5 Lightning 以 30B MoE 架構瞄準這個執行層,速度比同級模型快 4 倍。

Og image

長期運行的 AI Agent 真正花時間的地方,往往不是規劃,而是工具呼叫、結果驗證、子代理分派這些高頻次的執行步驟。每一個小動作都用頂級推理模型去跑,會帶來明顯的成本與延遲壓力。NVIDIA 推出的 Nemotron 3.5 Lightning 就是針對這個「執行層」設計的開放模型,採用 30B 參數的 Mixture-of-Experts(MoE)架構,但每次只啟動 3B 參數,在維持效率的同時兼顧準確度。

與坊間常見做法不同,Nemotron 3.5 Lightning 並非要取代大型推理模型,而是與之分工——前者處理高頻執行,後者專注規劃與複雜推理。模型本身針對 agent harness(如 OpenClaw、Hermes Agent)做了訓練優化,並提供 speculative decoding、NVFP4 與 BF16 量化版本,宣稱輸出速度比同級模型快 4 倍。這對需要長時間在線、隨時待命的 Agent 來說,省下的不只是金錢,還有回應時間。

Nemotron Lightning - NVIDIA's Super Fast Agent MoE

NVIDIA 同時推出 NeMo Switchyard,一個負責任務分派的路由函式庫,能根據任務類型自動挑選最合適的模型。整個 Nemotron 系列定位有點像「模型版的軟件庫」,每次發佈都在累積可組合的元件。對於需要自己掌控成本與效能的開發團隊,這套組合提供了相當完整的權重、數據與訓練配方,加上寬鬆的開源授權,方便做深度客製化。

  • 專注 Agent 執行層:30B MoE 架構、3B 活躍參數,設計目標是高頻低延遲的工具呼叫與驗證。
  • 速度與成本取捨:相比同級模型,輸出速度提升達 4 倍,搭配 NVFP4 量化可在本地硬件運行。
  • 分層協作模式:與 Nemotron 3 Ultra 等大型推理模型分工,由 NeMo Switchyard 負責智能路由。
  • 完整開源:權重、訓練數據與配方一併釋出,授權寬鬆,方便客製與整合。
  • 生態整合:對應 NemoClaw 安全管理開源方案,支援 OpenClaw、Hermes Agent 等長期運行框架。

項目主頁

Categories: 開源, Agentic, 模型, NVIDIA, 軟件, , 安全, OpenClaw

round-trip-consistency:雙向 diffusion 幫長序列預測錯誤

遇上長步數 rollout,最難不是生成下一步,而是知道幾時開始唔可信。round-trip-consistency 用一次來回推演,直接估計模型當下誤差。

Bidirectional round-trip consistency overview

長序列 rollout 最棘手的位,在於錯誤會一路累積,但部署之後偏偏冇真值可以對照。round-trip-consistency 針對的正正是呢個缺口:它屬於一個研究型模型項目,用單一 conditional latent diffusion model 同時向前、向後推演 dynamical system,然後用來回一次嘅落點差距 round-trip consistency 當成自監督誤差訊號,判斷當前預測仲值唔值得信。

相比靠 ensemble、外部觀測、保留測試資料,甚至依賴 governing equations 去估可信度,呢個做法嘅取捨幾直接:代價係多做一次反向 rollout,換來唔需要額外真值。模型關係亦唔複雜,高維輸入先經 VAE 壓到 latent space,再由同一個 bidirectional latent diffusion model 配合 direction flag 做 forward 或 backward rollout,所以 backward 不只是檢查工具,亦順手變成 inverse solver。

現有資料已經講清楚它較適合點樣理解和測試:重點唔係即裝即用嘅應用介面,而係跟隨論文與程式碼重現 rollout、計算 C_i(Confidence Interval),再觀察它同真實 rollout error 嘅關係。對做科學模擬、時序生成、物理場預測,或者想為 autoregressive generative model 加一層 test-time trust signal 嘅研究團隊,呢類方法比單純看步數深度更有參考價值。

  • 用 forward 再 backward 嘅差距作為無需量測嘅 test-time error signal
  • 同一個 bidirectional diffusion model 包辦雙方向推演,訓練成本冇因雙向設計而上升
  • 在 MHD、turbulent Navier-Stokes 同 CelebV-HQ 呢類資料上驗證,覆蓋物理場與影像序列
  • 可用來做 error ranking、OOD flags 同 selective prediction,而唔止係生成結果本身

結果 C_i 在 held-out MHD trajectory 與 rollout error 有高相關,固定深度下 Spearman 可達 0.91 至 0.98;面對 out-of-distribution 的 Orszag-Tang vortex,AUROC 達 0.98,到 depth 10 去到 1.0。它亦能在 80% coverage 下將 incurred error 降低 15%,而在 LE-PDE-UQ 的 benchmark,一個 bidirectional model 已接近十模型 ensemble 嘅水位,訓練成本只係十分之一。不過呢個項目仍然偏研究原型,價值最大嘅場景係替長 rollout 模型補上「幾時應該停、幾時可以信」呢個判斷層,而唔係即時提供完整產品化流程。

項目主頁 · GitHub

Categories: 開源, World-Action Model, , Dataset 數據集

ComfyTV 把 ComfyUI 拉進完整媒體工作流

想用 ComfyUI 做圖、剪片同整理素材,通常要在多個介面之間跳來跳去。ComfyTV 把這些步驟收進同一個畫布,重點不只生成,仲包括挑選、編修同輸出。

ComfyTV canvas overview

做生成內容唔少人最怕流程一長就難改、難追版本,ComfyTV 針對的正是這個卡位。它屬於建基於 ComfyUI 的畫布式媒體工作台,將生成、挑圖、編輯、合成到輸出串成同一條流程,處理範圍橫跨 image、video、audio、music、panorama、2D layers 同 3D,而唔係停留喺單次出圖。

跟一般要靠 ComfyUI 全域 queue 推整條鏈不同,ComfyTV 採用 per-node run,每個 stage 可以獨立重跑,下游只會接住上游最近一次輸出的 snapshot。這種做法減少反覆測一小步時牽動全流程的等待,代價是你要更清楚每個節點當下吃的是哪個版本輸出,但對長流程調整明顯更順手。

它的另一個重點是以項目為中心管理素材與歷史。每個 stage 都掛在同一個項目內,輸出會連同歷史保留,重新載入後可還原;再加上 asset library、resource library 同 prompt fragments,可直接在提示詞用 @ 引用。README 亦提到可匯入任何 ComfyUI workflow JSON,在側邊欄綁定輸入、保存 stage preset,並透過 Bridge nodes 接第三方插件,甚至登記遠端 ComfyUI 機器做 runner。

內容深度比一般前端殼再走前一步,現時提供約 190 個 stages,而且不少節點內置真正編輯器,例如 layer editor、storyboard workbench、piano rolls、3D viewports 同 scopes,部分 video effects 亦有 live preview。2D 編輯一段還延伸到 PSD import/export、Fountain script import 這類偏製作流程的功能,顯示它瞄準的是需要持續迭代的創作項目,而唔係一次性玩效果。

  • 把 ComfyUI 擴展成完整媒體工作台,覆蓋生成、編修、合成與輸出
  • per-node run 減少重跑整條流程的等待,適合長鏈路反覆微調
  • 以項目保存 stage 歷史、素材與資源,較方便追版本同回復狀態
  • 可匯入 ComfyUI workflow JSON,兼容 subgraphs、第三方 plugins 同遠端 runners
  • 約 190 個 stages,加上節點內編輯器,定位比純工作流編排器更完整

它依賴你現有的 ComfyUI 生態與本地模型,較像建在 ComfyUI 之上的創作界面層,而唔係獨立模型服務。適合已經有一批 workflows、想將 image、video、audio 放入同一項目管理的團隊或創作者;純粹只求最快出一張圖的人,未必需要它這麼重的工作台結構。

GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, 3D,

RIPO 直指 LLM 強化學習探索崩塌

RIPO 不是再調一個 PPO-Clip 變體,而是直接質疑量度策略差異的方法。對想提升 LLM 推理訓練穩定度的人,這個方向值得留意。

Repository image for Aiolus-X/RIPO

訓練 LLM 做長鏈推理時,最麻煩的不只是算力,而是策略很容易愈學愈保守,最後卡在少數高機率答案附近。RIPO 屬於一個面向 LLM 強化學習的演算法研究項目,針對的正是 PPO-Clip 在後訓練階段常見的 exploration collapse,想解決罕見但關鍵動作愈來愈難被探索到的問題。

作者沒有沿用「再補幾個 heuristic」的路線,而是直接指出舊範式的核心錯位:PPO-Clip 以 Euclidean metric 量度 policy discrepancy,但 policy 本身更貼近一個 Riemannian manifold。呢個幾何不一致會令低機率區域更新過份保守、高機率區域又過份進取,最後令探索能力收縮;Riemannian Isometric Policy Optimization(RIPO)則改為追求等距的 policy update,嘗試同時守住 exploration 與 exploitation 的平衡。

論文描述中,RIPO 另一個重點是 bias-variance trade-off 較理想,令優化過程更穩定。成效方面,它在七個 competition-level benchmarks 上都優於既有 LLM RL algorithms,當中對 GRPO 在 AIME24 的提升最高可達 60%;這類結果相當吸引,但仍然要留意 benchmark 與訓練設置是否能完整轉移到你手上的模型與資料。

  • 核心批評很明確:PPO-Clip 的幾何假設不適合 policy update
  • 方法重心不是加獎勵技巧,而是重寫策略更新的度量方式
  • 對數學推理、長時序決策這類要靠探索找到解法的訓練場景較有價值
  • 成績亮眼,但更適合有能力重跑 benchmark 與訓練流程的研究團隊驗證

從提供的 GitHub 資訊看,儲存庫描述混入了 verl 這個 RL training library 的內容,因此閱讀與部署前要先分清:RIPO 是演算法與論文方向,verl 則較像承載 LLM RL 訓練流程的開源基建。較合理的理解方式,是把 RIPO 視為可整合進現有 LLM RL framework 的新策略更新方法;真正落地通常要配合既有訓練庫、GPU 叢集配置,以及像 GRPO、PPO 一類後訓練 dataflow 一起測試。

GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型訓練, OpenAI, 框架, , Anthropic, Dataset 數據集

Hermes Missing Control 用 Telegram 管理五人 AI 團隊

使用 Orchestrator 配四個常駐助手搬到 Telegram,再用只讀儀表板統一追蹤任務、對話和文件。這項草稿可理解成一個面向實戰的多 Agent 工作流搭建示例。

Og image

這個教程價格為 US$15, 它是一套多 Agent(multi-agent)工作流,核心是用一個 Orchestrator 牽頭,配合 Scout、Scribe、Reach 和 Dev 四個常駐助手,分工處理探索、記錄、外聯和開發。它解決的不是單一對話,而是多角色協作、訊息路由同埋狀態追蹤,令每個助手各守其位。

同一般把所有工作塞入同一個聊天頻道的方法相比,這套做法把每個助手分到獨立的 Telegram 頻道,再配合 Telegram bot 和 routing plugin 做轉發。好處是角色邊界更清晰,對話唔易混亂,亦方便之後把任務、日誌同檔案接入同一個 mission-control dashboard。

文章亦展示咗點樣將資料層做成只讀,並把 Overview、Agents、Tasks Board、Chat、Content Library 同 Schedule 等版面逐一接上 live data。對需要長時間跟進 AI 工作流的人會幾有用,尤其係想喺 VPS 上集中監控,又唔想直接改動底層資料的人。

  • 以 Orchestrator 統籌四個專職助手
  • 每個助手都有自己嘅 Telegram 頻道同工作邊界
  • 儀表板只讀,方便監察而唔會誤改資料
  • 支援任務板、聊天記錄、文件庫同排程追蹤
  • 內容亦包含部署、故障排查同可選擴充做法

整體嚟講,呢個項目示範咗點樣把多 Agent 協作變成可觀察、可路由、可回溯嘅系統。對想用 Telegram 做日常 AI 協作中樞嘅讀者,會比一般聊天式代理更貼近日常工作需要。

項目主頁

Categories: Agentic, 教學,

vLLM 新後端跑出原生級速度

同一份 transformers 模型實作,依家可以直接食到 vLLM 的高速推理。對部署大型語言模型的人而言,少咗移植工序,吞吐量亦未必輸原生實作。

Og image

卡位一直在於:想用 vLLM 的高吞吐推理能力,過去往往要為個別模型寫或等專用實作。呢篇內容講的是 Hugging Face 把 transformers 直接作為 vLLM 的 modeling backend,而且頁面沒有提供 base model 資訊,因為它不是單一模型頁,而是針對推理後端整合的技術更新。

重點價值很直接:模型作者只要已有 transformers 實作,就有機會不用再額外移植到 vLLM,也能拿到接近原生,甚至更快的推理表現。對 LLM 與 VLM 都有意義,因為 serving 設定基本不變,只是加入 --model-impl transformers 旗標。

文中展示了三組 Qwen3 測試:Qwen3-4B 單 GPU、Qwen3-32B 以 tensor parallelism 跑 2 GPU,以及 Qwen3-235B-A22B-FP8 Mixture-of-Experts 在同一個 8×H100 節點上以 data parallelism 加 expert parallelism 執行。結果指向同一件事:transformers backend 的 throughput 已經追平或超過 vLLM 手寫 native implementation。

  • transformers 已支援 450+ architectures,角色像參考級 modeling library
  • vLLM 繼續負責 continuous batching、custom attention kernels 等高效推理優化
  • 啟用方式很簡單:升級 vllm,並在 serve 時加入 --model-impl transformers
  • 可與 --tensor-parallel-size--data-parallel-size--enable-expert-parallel 一起使用

取捨亦要講清楚:頁面重點在 backend 整合與效能展示,不是 GGUF 發布頁,所以沒有提供 GGUF 格式、量化等級、mmproj、chat template、MTP draft speculation 或 LM Studio/Ollama/llama.cpp 檔案資訊。硬體需求方面,示例至少涵蓋單 GPU、2 GPU,同埋 8×H100 節點;不同模型是否都能複製同樣增益,仍要視架構與部署環境而定。

項目主頁 · GitHub

Categories: 開源, Qwen, 框架, Ollama, Python,

LlamaIndex legal-kb:用代理工具重新定義法律文件檢索

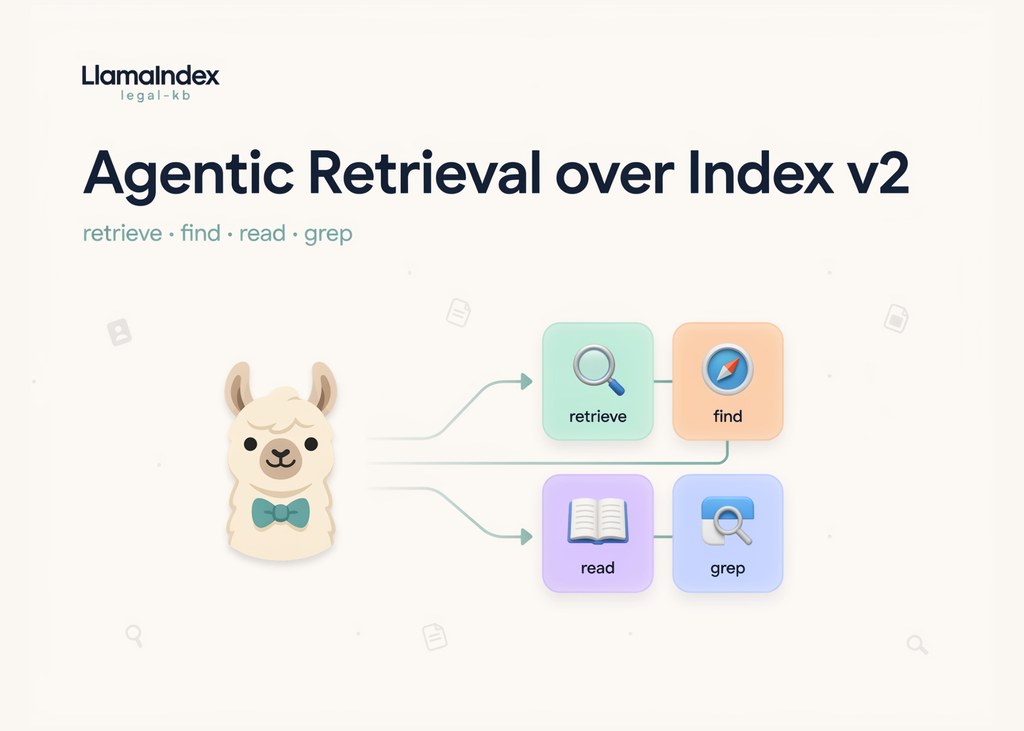
LlamaIndex 開源 legal-kb 參考應用,將 Index v2 檢索封裝成 retrieve、find、read、grep 四種工具,供代理靈活查詢法律文件。

Og image

legal-kb 是 LlamaIndex 在 GitHub 上發佈的開源參考應用,定位為法律文件知識庫,並非函式庫。它採用 LlamaIndex Index v2(LlamaParse Platform)作為底層索引引擎,示範一種稱為 Retrieval Harness 的代理式檢索模式,讓 AI 代理以工具呼叫方式查詢文件。

與傳統單次嵌入搜尋不同,這個項目讓代理在每次提問時,能像工程師操作檔案系統那樣,自行組合多種檢索方式。系統提供四個工具:retrieve 執行混合語意搜尋並可選擇重新排序;findFiles 依檔名或子字串搜尋文件;readFile 讀取指定檔案的原始內容;grepFile 用正則表達式在檔案內搜尋特定模式。四個工具都對應 Index v2 的檢索 API。

運作流程是用戶登入後建立項目,上傳文件會自動在背景解析並建立 LlamaCloud Index v2,每個項目對應一個託管索引。聊天代理在對話中即時查詢該索引,由代理決定呼叫哪些工具、依照什麼順序執行,逐步收斂到答案。

由於工具設計貼近通用檔案操作,開發者可以將 Retrieval Harness 接入自己的代理,處理大量且持續更新的文件集合。法律研究、合規審查、文件審計等工作流會較受惠。

重點摘要:
– 開源參考應用,示範 Retrieval Harness 代理檢索模式
– 四個工具:retrieve(混合語意搜尋)、findFiles(檔名搜尋)、readFile(讀取檔案)、grepFile(正則搜尋)
– 每個項目自動對應 LlamaCloud Index v2 託管索引
– 文件上傳後於背景自動解析與索引
– 工具通用,可接入自訂代理處理大型動態文件庫

項目主頁

Categories: 開源, Agentic, Embedding, API,

Headroom:幫 AI agent 壓縮上下文

這個項目專注減少 AI agent 的 token 消耗,同時盡量保留答案品質。它適合想降低成本、加快回應的開發團隊。

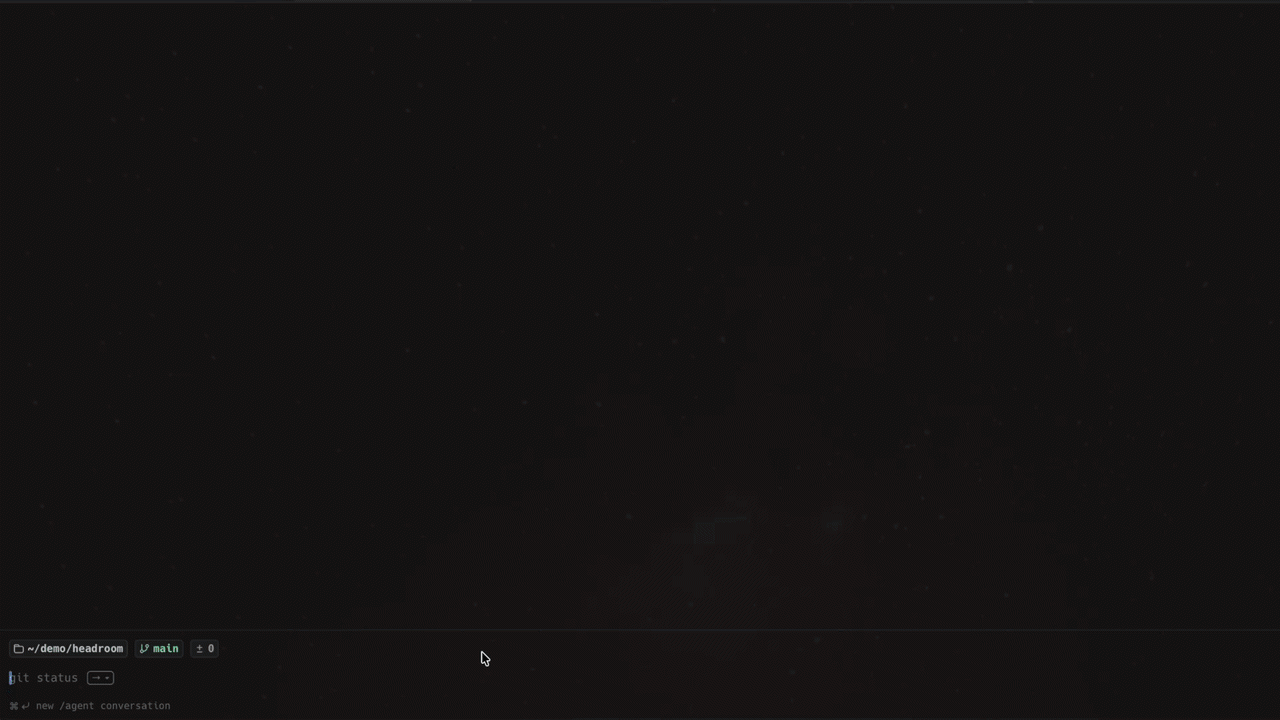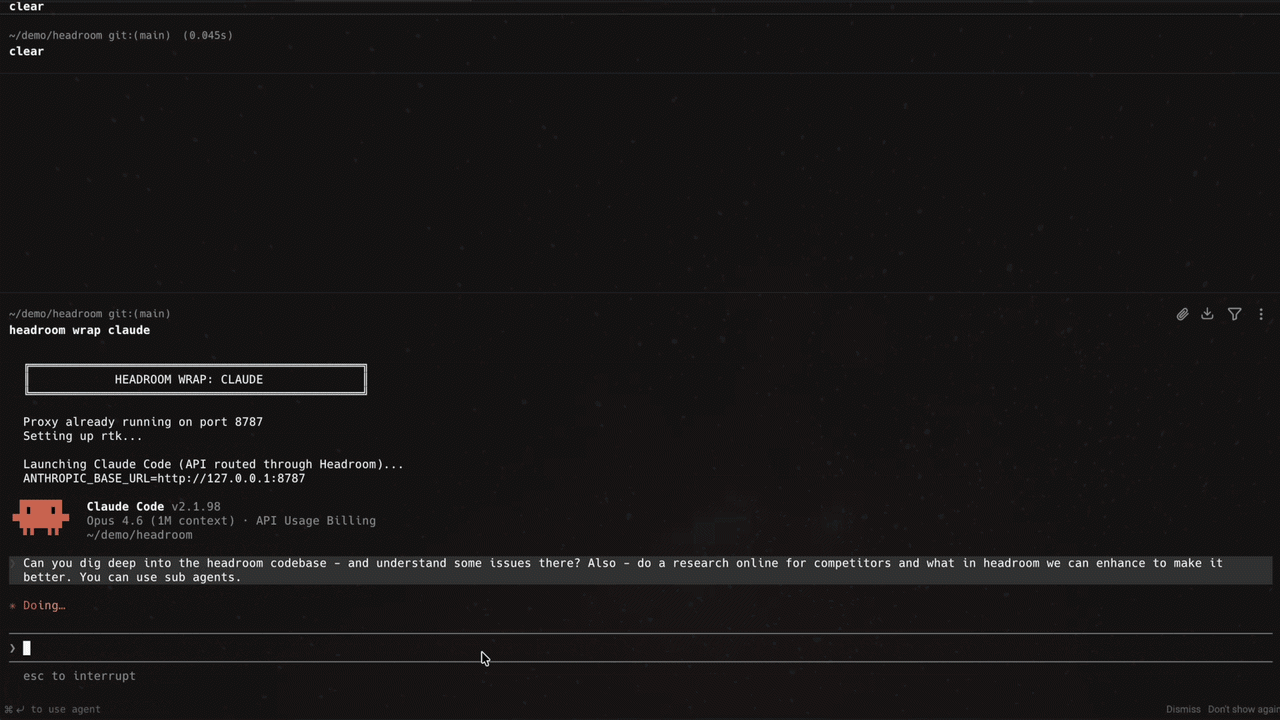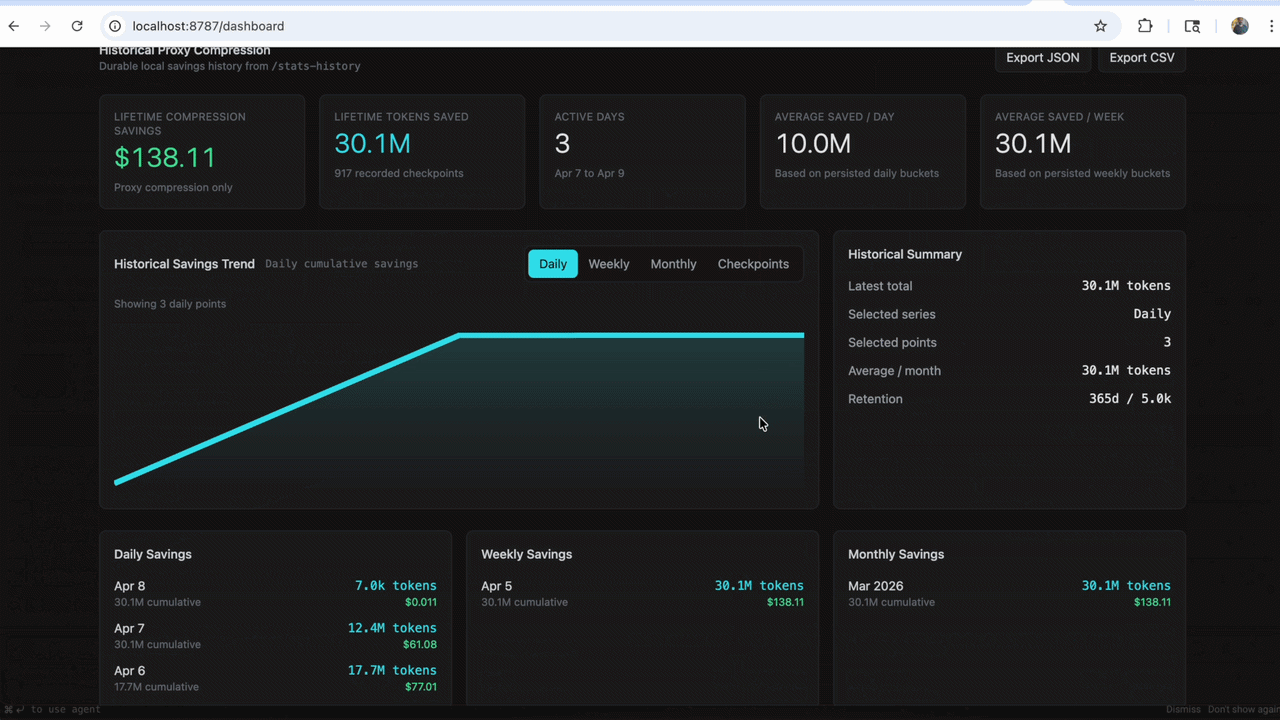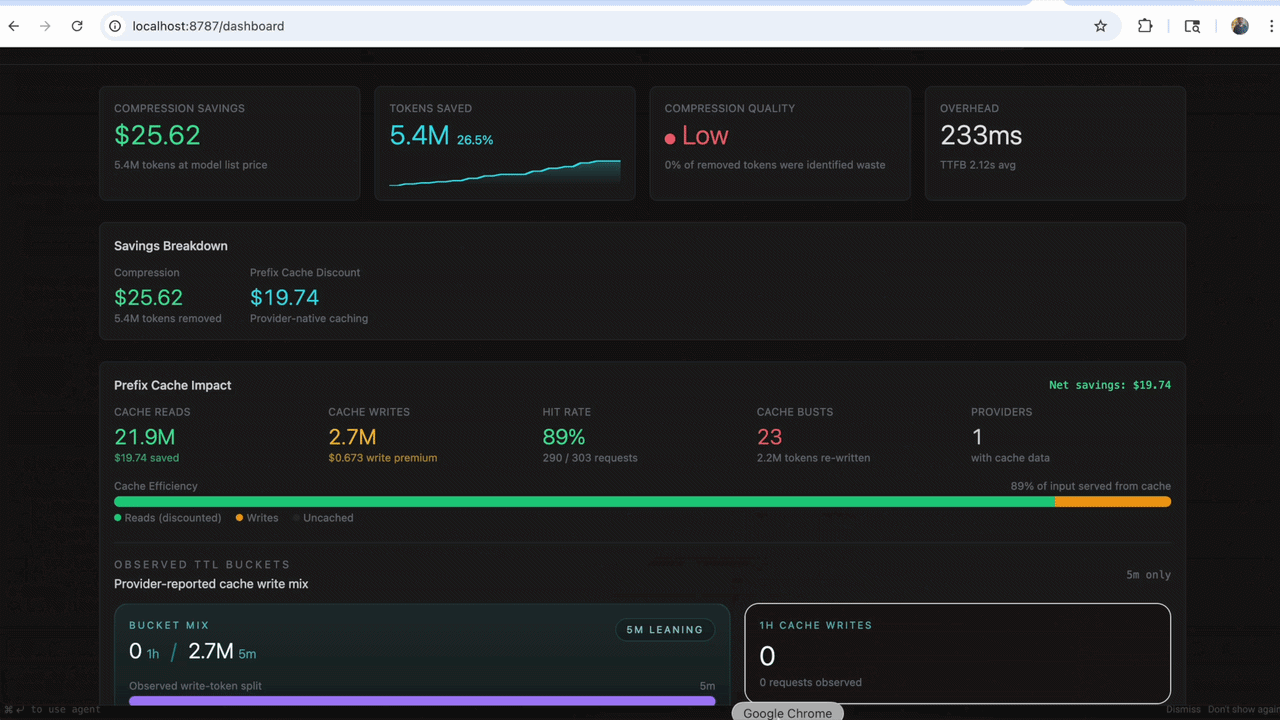
Headroom in action

Headroom 是一個給 AI agents 與 LLM 應用使用的庫兼代理工具,核心角色是把送進模型前的上下文做壓縮。它主要解決長對話、工具輸出、日誌、RAG 片段與檔案內容太長,令 token 成本、延遲與上下文容量很快爆滿的問題。

這個項目不只提供 Python 與 TypeScript 內嵌式 compress(messages) 用法,亦提供 proxy 模式與 MCP server,代表它可以直接插入現有流程,未必需要大改程式。README 提到 zero code changes 的代理方式,對已有多語言系統的團隊尤其實用;另外它走 local-first 與 reversible 路線,取向明顯是先保留可控性,再追求節省 token。

和一般只縮短輸入文字的做法相比,Headroom 的差異在於它同時處理模型輸出,會減少重複客套、重述程式碼,以及在例行步驟略過過深的「thinking」。這種取捨有助壓低來回 token,但也代表較依賴它對內容重要性的判斷;對需要完整推理痕跡或逐字保留輸出的流程,部署前應先做回歸測試。

結果列出的數字是 60–95% fewer tokens,示例亦有 10,144 壓到 1,260 tokens,同時保留相同問題結論;不過這些結果較適合視為官方展示,具體效果仍會受任務類型影響。較容易受益的情境包括多步驟 agent、跨工具調用、RAG 對話系統,以及 Claude、Codex、Gemini 之間需要共享記憶的團隊協作流程。

  • 支援 Library、Proxy、MCP server 三種接入方式
  • 可壓縮對話、工具輸出、logs、RAG chunks 與檔案內容
  • 提供 cross-agent memory,支援 Claude、Codex、Gemini 共用與去重
  • headroom learn 會整理失敗 session,寫入 CLAUDE.local.md、CLAUDE.md、AGENTS.md 或 GEMINI.md
  • 相關模型包括 Kompress-v2-base,而整體定位較接近 agent 基礎設施,不是單一聊天模型

整體來看,Headroom 最有價值的地方不在於再做一個包裝 LLM 的介面,而是把「上下文壓縮」獨立成基礎層。對經常被 token 成本、上下文長度與 agent 記憶雜訊拖慢的項目,它屬於值得優先測試的一類工具。

GitHub

Categories: 開源, Agentic, RAG, MCP, 模型, Gemini, Python, , 編程, Anthropic

EO-WM:把衛星影像預報變成天氣驅動的世界模型

EO-WM 以物理引導的潛在影片擴散架構預測未來衛星觀測,並針對極端天氣下植被退化與天氣響應準確度提出全新基準。

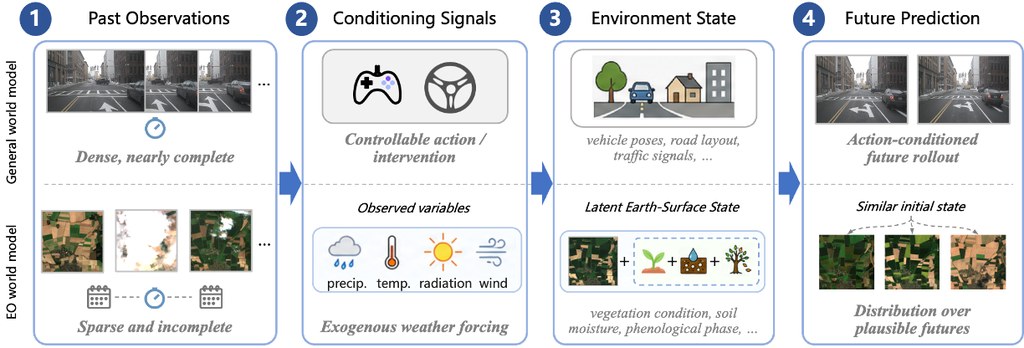
EO-WM overview

這是一個結合物理知識的影片擴散世界模型(EO-WM),專門用於多光譜衛星影像的概率預測。整體目標是把地球觀測(Earth Observation, EO)預報重新定位為「部分可觀察、天氣驅動的世界建模」任務,在稀疏衛星上下文與未來氣象條件下預測地表動態,並支援災害監測、作物產量預估及植被變化追蹤等下游應用。

過去的 EO 預測方法分為兩類:決定式模型把不確定性壓縮成單一未來影像,擴散式方法則往往把天氣變量當成籠統的條件輸入。這兩種做法都難以正確反映「氣象條件如何改變地表狀態」這個核心問題,而且現有 benchmark 多聚焦於像素重建準確度,未能衡量模型在改變天氣條件時是否會產生方向正確的響應。EO-WM 為了解決這個落差,引入一個 EO 專屬 VAE 把稀疏衛星觀測編碼為潛在影片 token,再用擴散 Transformer(diffusion transformer)經由獨立條件路徑同時處理三種信號:氣候基線(climatological baseline)、天氣異常(weather anomaly)與累積物理壓力(cumulative stress),並持續將空間上下文重新注入影片 token 流。

在評測方面,作者提出兩個以 EarthNet2021 為基礎的診斷式 benchmark:Extreme Summer Benchmark 衡量極端熱浪與乾旱下植被退化的嚴重程度感知能力,引入 TN-MAE 與 Drop Amplitude Error;Seasonal Matched-Pair Benchmark 則衡量當天氣條件改變時預測方向與幅度是否正確,以 Divergence Reproduction Ratio、Directional Hit Rate 與 Paired Divergence Correlation 為指標。報告結果顯示 NDVI 下降幅度的預測誤差相對減少 5.63%,方向命中率相對提升 7.80%,同時在像素級 ENS、P-MAE、N-MAE 等指標上仍具競爭力。

這個項目對遙感研究者、農業監測團隊及氣候風險分析團隊特別有價值,因為它同時提供模型與基準資料,讓外界可在統一的評測框架下比較不同方法的天氣響應能力。從工程角度來看,架構設計強調物理分離條件與空間重注入,而非單純堆疊參數,這種取捨有助於提高極端情境下的可解釋性。需留意的是,目前 GitHub 倉庫主要釋出 benchmark CSV 與 Earthformer 參考評測腳本,模型權重與完整訓練流程屬於配套資源,重現完整結果仍需自行準備 EarthNet2021 的 extreme 與 seasonal 切分資料。

重點摘要:

  • 重新定義 EO 預報範式:把衛星影像預測視為天氣驅動的世界建模,而非純粹的影像重建。
  • 物理分離條件:天氣信號被拆分為基線、異常與累積壓力三條獨立條件路徑。
  • 診斷式 benchmark:Extreme Summer 與 Seasonal Matched-Pair 兩個基準專門檢驗模型在天氣改變下的響應正確性。
  • 可量化的天氣敏感度:NDVI 下降誤差降低 5.63%,方向命中率提升 7.80%,標準指標仍具競爭力。
  • 目前釋出內容:以 benchmark CSV 與評測腳本為主,完整訓練流程需搭配 EarthNet2021 資料集。

GitHub · Paper

Categories: 開源, 香港大學, 香港理工大學, 模型, 世界模型, Stable Diffusion, 框架, 香港, , 深度學習

UnityShots:多鏡頭影音生成的記憶驅動新方案

由快手 Kling Team(快手) 與學界合作推出,UnityShots 把單鏡頭擴散模型改造成可保持人物、場景與聲音一致的多鏡頭敘事系統,並釋出 200 段基準測試集。

UnityShots Logo

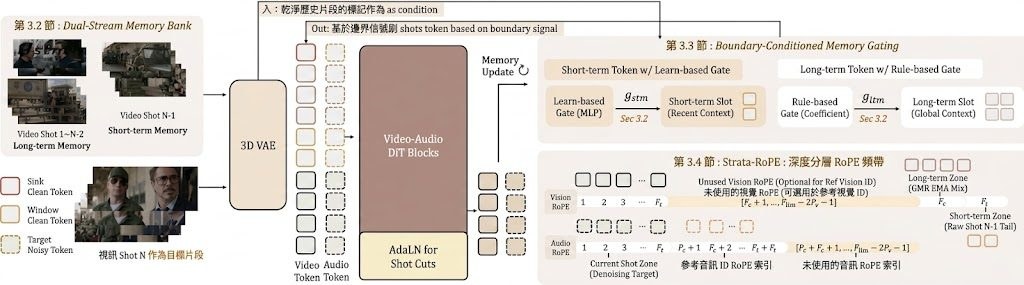
UnityShots 是一個研究性質的多鏡頭影音生成框架,核心任務是解決現有方法在長序列多鏡頭影片中難以維持人物、場景與聲音一致性的問題。它基於已有的單鏡頭影音擴散模型 LTX-2.3(22B 參數)建構,從一段結構化提示詞直接生成 3 至 9 個鏡頭的連續 .mp4 影片,確保角色容貌、場景光影與配音語音在各鏡頭間保持連貫。

現有做法通常依賴三種路線:端到端訓練固定長度序列但難以擴展、以記憶庫逐鏡頭生成但容量隨鏡頭數線性膨脹,或用大型語言模型規劃器調度預訓練生成器而缺乏多鏡頭感知骨幹。UnityShots 的切入點是引入邊界感知門控(Boundary-Aware Gating)與雙槽記憶機制:影片流維持兩個固定大小記憶槽,長期記憶(LTM)錨定開場鏡頭,短期記憶(STM)保留前一鏡頭尾部,兩者在每次剪接時由門控網路更新;音訊流則在每個鏡頭注入參考說話者 token,避免滑動音訊庫的負擔。另一個辨識度高的設計是透過 AdaLN 學習離散剪接類型先驗(cut-type prior),讓使用者可在推論階段調整轉場強度。

以下為重點摘要:

  • 類型:多鏡頭影音生成研究框架,附帶資料集與基準測試。
  • 核心差異:用固定大小雙記憶槽取代線性增長的記憶庫,並加入參考語者 token 維持聲音一致性。
  • 控制能力:剪接類型先驗成為推論時可調旋鈕,使用者可指定轉場強弱。
  • 相關模型:以 LTX-2.3 22B 為基座,整合 AdaLN 門控機制。
  • 資料集:釋出 UnityShotsBench,涵蓋六大文化區域、13 種語言的 200 段多鏡頭序列。

現有評估涵蓋 I2V、T2V、R2V 三種條件模式,UnityShots 在跨鏡頭一致性與音畫品質上與開源及閉源基準相當。對從事多鏡頭敘事、短影音自動化或數位人內容生成的團隊而言,這套框架提供了較完整的記憶與控制設計思路。原始資料庫明確指出,檢查點、訓練程式碼與代理系統尚未釋出,因此目前無法從儲存庫直接取得安裝指令或模型權重;讀者若有興趣部署,需等待官方後續發布。資料集本身可從 Hugging Face 的 KlingTeam/UnityShotsBench 下載,供研究者評測自家模型。授權為 CC BY-NC 4.0,僅限非商業學術用途。

GitHub: https://github.com/JIA-Lab-research/UnityShots

項目主頁: https://jackailab.github.io/Projects/UnityShots/

Paper: https://arxiv.org/pdf/2606.21661

Categories: 開源, 香港中文大學, 香港科技大學, 清華大學, 字節跳動, 數字人, 模型, 視頻模型, Video, 提示詞, 框架, 香港, , 語音, LTX

Page 3 of 7
1 2 3 4 5 7