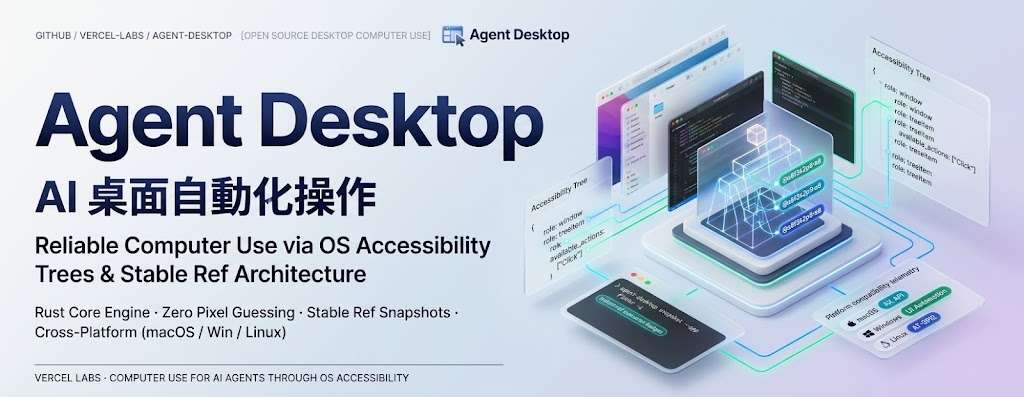
agent-desktop:讓 AI 代理讀取並操作桌面應用程式

以 OS accessibility tree 取代像素定位,讓 AI 代理操作桌面應用程式並逐步核對結果。

Repository image for vercel-labs/agent-desktop

要讓 AI 代理操作桌面應用程式,agent-desktop 讀取 OS accessibility tree,以 ref 指向按鈕、輸入框等元素,再用 JSON snapshot 核對結果。這個跨 macOS、Windows、Linux 的 CLI 與 C library 不靠 pixel matching,將控制循環留在 agent。

可透過 npm 安裝並先確認 version;macOS 要 Accessibility permission,Linux 要 graphical session 及 at-spi2-core,Windows 受終端機 integrity level 限制。macOS command host 保留 native accessibility objects,減低舊 identifier 誤連到已移除元素的風險。

  • 適合:需要 AI 控制桌面軟件、並自行編排 agent 的團隊。
  • 限制:沒有 benchmark 或成功率;JEV helper 與 native CLI 分開,headless calls 亦禁止 foreground activation 和 synthesized input。
  • 私隱:snapshot、screenshots、剪貼簿及 debug artifacts 可能含私人內容,不應放入公開 logs。

項目更像桌面操作底層而非完整代理,是否適合取決於目標程式的 accessibility 支援、權限和資料處理方式。
GitHub

Categories: 開源, Agentic, 軟件, Mac, Linux, 庫, Dataset 數據集

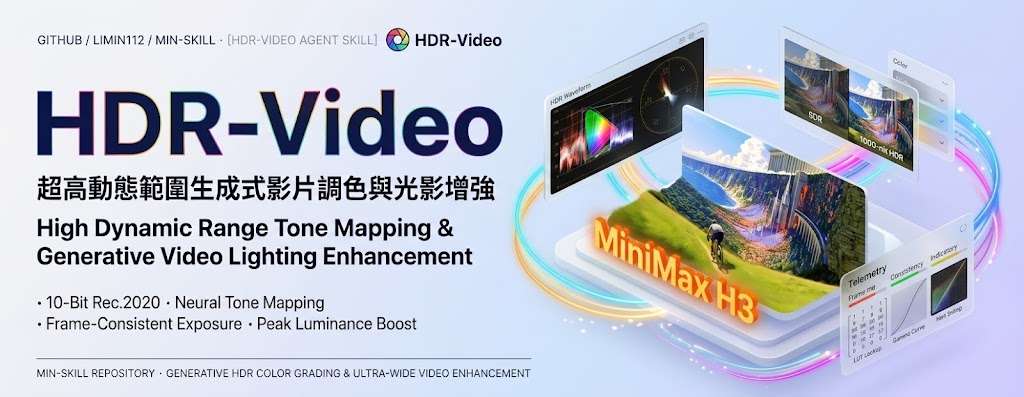
HDR mini-skill 讓 AI 片由 SDR 轉為 HDR

纯 ffmpeg + 自己生成的 3D LUT,不依赖 zscale / libplacebo / drawtext(Homebrew 的 ffmpeg 常常没带)。

Repository image for limin112/min-skill

把普通(SDR)視頻或其中一段,轉成 10-bit HEVC / HLG / BT.2020 的 HDR 文件:在 HDR 屏幕上,雲、太陽、水面反光、 金屬高光會“發光”。還能做左右對比:同一個文件里左邊 SDR、右邊 HDR。

  • 輸出 HLG HDR、10-bit HEVC 及 SDR/HDR 對比片。
  • 效果取決於素材。 米色卡片、文字、PPT 這類畫面轉成 HDR 只是把“紙”變亮,不適合。
  • 只有在 HDR 屏(Mac XDR、iPhone)上用 QuickTime 才有效果;普通播放器里會發灰、紅偏橙,這是正常的。
  • 原片已經是 HDR 的,腳本會拒絕(退出碼 2)。
  • 沒在真正的 HDR 屏上做過觀感驗證,也沒驗證過上傳各平台後是否保持 HDR;詳見 SKILL.md 末尾“已驗證 / 沒驗證”。

GitHub

Categories: 開源, 文字轉語音, AI productions, 數字人, 模型, Video, 框架, 工具, Content Creator, 3D, 庫, 語音, Anthropic, MiniMax, Skill 技能, LoRA

WebAnything 把真實網站重建成可重設的測試環境

從網站獲其內容重建互動網站,能在可重設的環境中完成任務。

WebAnything concept logo

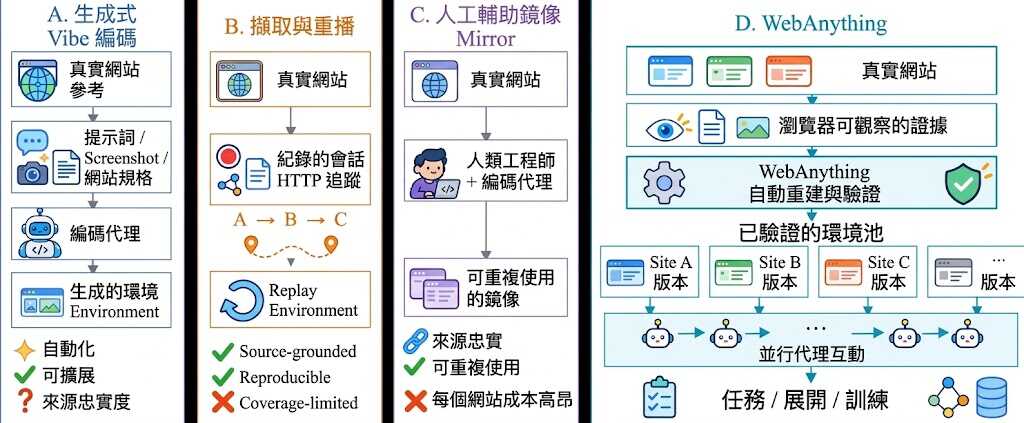
要訓練或評測 Web agent,截取網站畫面並不足夠,代理還要能操作控制項、切換頁面並完成多步任務。WebAnything 是一套研究程式碼,將網站證據轉成可執行、可重設的代理環境,目標是保留任務流程,而不只是重現畫面。

建構流程先由 Builder 透過瀏覽器探索網站,記錄頁面狀態、互動資料、DOM、畫面截圖及網絡資源,再重建環境。候選環境會先凍結,交由 Verifier 獨立檢查;發現實作錯誤或證據不足時,系統會針對問題修正。Full 模式適合追求較廣覆蓋,JIT 則按代理任務需要建構環境,兩者在完整度與建構成本之間作取捨。

項目分析了 6,172 個獲接納的來源任務執行紀錄,平均每個任務使用 10.4 個工具步驟,中位數為 8 步;34.7% 的任務超過 10 步,最長達 89 步。這些數字反映任務包含多步互動,但不能單獨代表重建保真度或代理能力;評估亦分別涵蓋歷史頁面狀態的保真度,以及模型在指定基準測試中的下游效用。

  • 適合研究 Web agent 訓練與評測、需要可重複網站任務環境的團隊。
  • Builder 和 Verifier 使用支援 Responses API 的模型服務;兩者需配置模型 ID、API URL 及 API key。
  • 本機需安裝 Chromium,瀏覽器操作由 Playwright 支援;代理亦需要終端機存取權。README 未列出最低 CPU、記憶體或 GPU 規格,不能據此判定具體硬件門檻。
  • 儲存庫提供建構流程及 244 個歷史網站項目的清單,但網站原始碼與第三方媒體存放在外部 artifact store,並未隨儲存庫附上。

Web agent 提供 Python 套件、命令列工具及設定流程,並可把本機 agent skill 安裝給 Codex 或 Claude Code;這個 skill 不是 MCP server。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 模型訓練, Qwen, API, 工具, Python, 庫, Anthropic, 中國, Dataset 數據集, Skill 技能

L3G-World 可以連續生成長達數分鐘影片

L3G-World 把單張影像、文字提示和鏡頭路徑接成可持續探索的 3D 世界,重點在長片段一致性與生成速度。

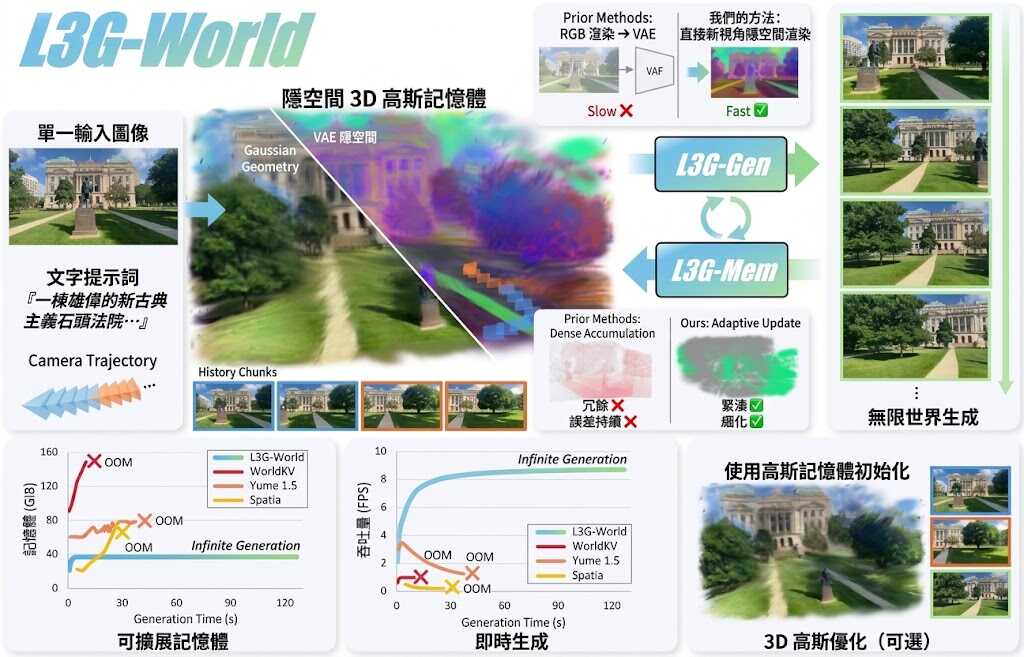
L3G-World overview: input images, text and cameras initialize latent 3D Gaussian memory; L3G-Mem updates the memory whil

由單張影像、文字提示和鏡頭路徑開始,L3G-World 可以連續生成長達數分鐘、視角一致的影片。它屬於世界模型及視頻生成模型項目,針對長時間生成容易失去場景結構、記憶不斷膨脹的問題,加入可持續更新的 3D 記憶。

L3G-Mem 會在新探索區域建立 Gaussian,重訪舊區域時則修正原有幾何資料;L3G-Gen 再利用更新後的記憶,自回歸生成下一段影片。每個 Gaussian 儲存 VAE latent,直接渲染到 diffusion 的 latent space,省去先渲染 RGB、再重新編碼的步驟,配合 few-step video model,目標是支援即時生成。

  • 長時一致性:影片片段會共享持續更新的 3D memory。
  • 記憶增長受控:記憶量跟隨探索範圍,而不是單純跟隨影片幀數增加。
  • 多視角探索:支援單張影像或少量多視角輸入,沿不同 camera trajectory 延伸場景。
  • 速度取捨:直接 latent rendering 減少重建成本,但項目仍屬研究原型。

對需要從影像建立可探索場景的研究團隊、世界模型開發者、機械人和虛擬環境項目較有參考價值。相比每段影片獨立生成的做法,它把場景記憶放入閉環流程;代價是需要同時處理 3D Gaussian 記憶、latent rendering 和擴散模型,工程整合較複雜。

項目首頁展示了 minute-long generation、不同鏡頭路徑和多視角場景延伸,但未提供明確的 FPS、GPU 型號或 VRAM 要求。儲存庫列出的 L3G-Mem、L3G-Gen、推理程式及 Fast checkpoints 仍在發布計劃中,因此目前只能按公開展示理解能力,未能據此確認安裝流程、所需硬件或可直接部署程度。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Video, Image, World-Action Model, 3D, 庫

OpenCode V2:程式碼探索與修改兩種模式

新功能加入 /goal,能持續目標驅動循環(自主執行直至目標完成)。接手陌生程式碼時,OpenCode 會先協助分析,再切換至開發模式;但模型配置與硬件門檻仍未交代。

OpenCode logo

V2 連續 3 日更新!OpenCode 能在接手陌生程式碼時,先讓 OpenCode 分析結構及規劃修改,再交由開發模式處理。這個開源 AI 編程代理工具以不同權限配合工作階段,並非獨立模型。

很多時,開發技術差異在於代理模式:預設 build 具完整存取權,負責開發;plan 則以唯讀方式探索程式碼,執行 bash 指令前會要求批准。兩者是操作模式,不是兩款模型。

  • build 適合需要修改程式碼的開發工作。
  • plan 適合熟悉陌生儲存庫及規劃變更。
  • 可透過 npm、Homebrew 等套件管理器安裝。
  • 另有桌面應用程式測試版,可於 opencode.ai/download 下載。

需要先審視再修改程式碼的開發者,可考慮這套分工方式;選用前仍須確認模型配置與運算需求。安裝前亦應移除早於 0.1.x 的版本。

GitHub

Categories: 開源, 模型, 工具, 庫, 編程

Work Agents 將數碼工作拆成可驗證成果

跨應用程式完成工作,不能只看模型答得對不對;Work Agents 把代理流程、能力與可驗證成果放進同一研究脈絡。

Work Agents: Systems, Capabilities, and Optimization

當 AI 要跨應用程式完成多步工作,交付可核實、能供後續使用的成果,比單次答對更重要。Work Agents 是配合調查研究整理的開源閱讀清單,收錄數碼工作代理的系統、訓練、環境、記憶、基準與官方資源,並非可直接安裝的代理軟件。

研究以工作持續性(work persistence)和工作開放性(work openness)描述工作條件,並分成對話(Conversation)、單一步驟(Atomic Action)、多步(Multi-step)、工作流程(Workflow)及工作區(Workspace)五類。它也梳理 foundation models(基礎模型)與 runtime harnesses(執行時框架)的單獨或協同優化,評估則聚焦成果能否符合要求並供下游使用。

你可由 GitHub 清單挑選論文、基準和工具;暫未有可直接執行的代理或統一安裝、測試流程,不能當成部署指南。

  • 整理代理系統、訓練方法、環境與記憶研究
  • 涵蓋五類數碼工作及相關評測資源
  • 比較模型、執行框架及兩者的協同優化
  • 以可驗證、能供下游使用的成果作評估焦點

產品團隊和自動化流程負責人可用它整理能力缺口與評測方法。清單沒有同一環境下的性能數字,具體效果仍要回到各研究與工具核實。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, 框架, 香港, 軟件, 工具, 庫

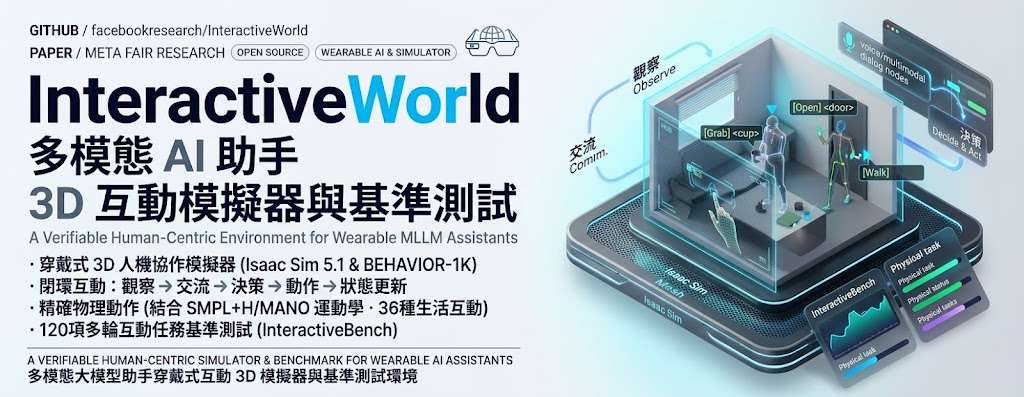
InteractiveWorld:把穿戴式 AI 助理放進可驗證的互動世界

穿戴式助理要看見甚麼、怎樣給建議,最後能否幫人完成任務,InteractiveWorld 把整段互動放進可持續變化的 3D 場景中測試。

First-person view of the human walking to a soda can, grabbing it, putting it on the coffee table and sitting on the sof

穿戴式 AI 助理不只要辨認眼前物件,還要理解人的要求、給出可執行的指引,並跟進行動後的變化。InteractiveWorld 是一套以人為中心的 3D 模擬器,用第一人稱視角呈現環境,讓助理與模擬人物多輪互動;同一個儲存庫亦提供 InteractiveBench,用來比較多模態大型語言模型(MLLM)在這類任務中的表現。

場景涵蓋 44 個 BEHAVIOR-1K 家居及活動空間。助理以對話提供建議,模擬人物則根據所見自行決定行動;研究者可用簡短指令描述抓取、開門、倒液體等操作,由模擬器處理移動、避障、操作物件及更新場景。世界狀態會延續到下一輪,因此助理要根據新視角調整回答,而非只生成一次性的文字答案。

InteractiveBench 收錄 120 個固定的多輪任務,分為六類,每類 20 個。評分會檢查場景中的狀態是否達成目標,而不是單憑回答文字判斷;基準亦提供評估流程、報告及影片。首頁資料提到曾以 12 個前沿 MLLM 進行評估,但所提供的內容沒有列出各模型分數,無法據此比較排名或判斷差距。

• 模擬器可用 Python API 開啟場景、執行動作、取得觀察結果及原生分數。
• 場景與人物行動涵蓋物件操作、室內移動及第一人稱畫面更新。
• 基準任務固定,適合研究團隊比較模型在多輪助理情境下的完成能力。
• 安裝指南列明資產準備與環境需求;執行需要處理 Isaac Sim 場景及相關資產,並非只呼叫一個輕量 API。

這個項目適合研究穿戴式助理、多模態模型及具身互動的團隊,尤其是需要可重複測試、以環境狀態核實結果的工作。模擬場景能補足純文字評測看不到的行動後果,但仍不能完全代表真實佩戴裝置時的感測誤差、人的習慣差異或實體操作風險;評測結果應視為模擬環境中的能力證據。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, API, Video, 3D, Python, 庫, Meta, 蘋果

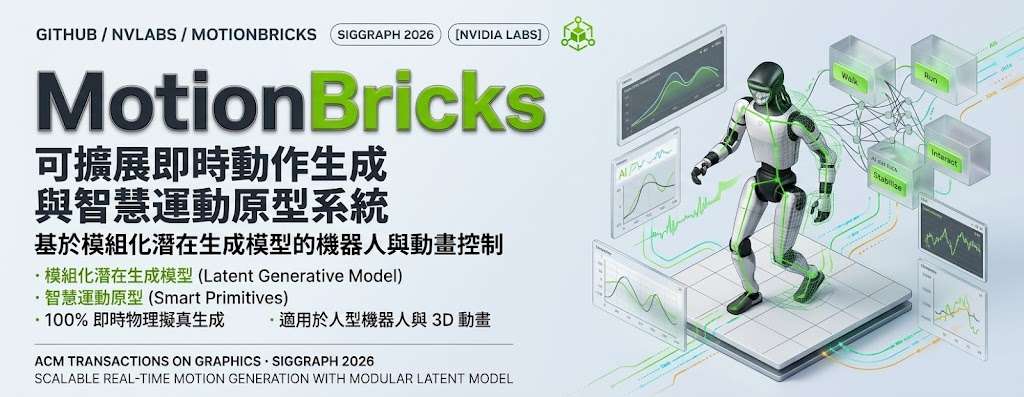
MotionBricks 讓動畫或機械人即時串接自然動作

只需提供角色最近的姿勢和目標姿勢,MotionBricks 就能生成中間動作,並把行走、跨越或坐下等行為組合成連貫場景。

MotionBricks animates characters and robots with one model

機械人或遊戲角色要由一個姿勢自然移動到另一個姿勢,MotionBricks 可以即時補出中間動作。這個模組化潛在生成模型(modular latent generative model)支援角色與機械人動畫,透過最近四個姿勢作為上下文,再以一至四個目標姿勢控制終點及抵達時的動作方式。

它提供 SOMA 人體模型和 Unitree G1 機械人的預訓練模型,並附有 Python 執行環境、動作示範及場景編輯器。使用者可在 Inbetweener 放置姿勢來生成動作,也可用 Scene Preview 測試角色在場景中行走、奔跑、跨越、躲避和坐下;編輯器則可製作 Smart Primitives,將導航與物件互動動作組合起來,無須為新行為重新訓練模型。

MotionBricks 的做法,是讓三個學習模組分工生成動作,再以 Smart Primitives 提供可組合的行為積木。研究團隊表示,模型涵蓋超過 35 萬段動作,並可用於新任務而無須微調或逐項標記;這有助遊戲動畫、機械人模擬及互動場景製作,但實際效果仍取決於目標姿勢和場景設定。

項目網站報告最高每秒 15,000 FPS、延遲 2 毫秒。執行環境依賴 NVIDIA GPU 和 TensorRT,示範曾在 Windows 及 Linux x86-64、配備 GeForce RTX 4090 的系統測試;首次載入模型與精度設定時,還要建立 TensorRT 執行計劃,因此這些數字不宜直接視為所有硬件上的保證。

  • 支援 SOMA 人體模型及 Unitree G1 預訓練模型,模型以 ONNX 提供,檢查點則放在 Hugging Face。
  • Python 執行環境以 Warp、Newton 和 TensorRT 串接多次生成,形成連續動作。
  • 附有 Inbetweener、Scene Preview,以及 Smart Primitives 和場景編輯器。
  • 儲存庫提供導覽教學;但執行需要 NVIDIA GPU,設定亦涉及 Git LFS、uv 和首次建立 TensorRT 計劃。

對需要快速製作可控角色動畫、驗證機械人動作或搭建互動場景的團隊,MotionBricks 提供由姿勢控制到行為組合的一套研究原型。它減少了手工編排動作轉場及為每個任務重新訓練的需要,但硬件門檻和場景設定工作仍需納入製作流程。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, NVIDIA, 教學, Linux, Python, 庫, 動畫, Dataset 數據集

Digital Human Koubo:一句需求生成數字人口播廣告,連聲音也自動完成

相片加一句需求,就能串起數字人口播、字幕與影片包裝;代價是依賴外部雲端生成。

一張相片加一句需求,便可生成有數字人口播、字幕和促銷包裝的短片。andyhuo520/digital-human-koubo 是由人工智能(Artificial Intelligence,AI)代理執行的影片工作流,串連文案、對嘴、聲音整理和剪輯。

主持人設定存於 persona.json,固定外觀和聲線描述;GPT Image 合成場景後,Grok Video 1.5 經 Renoise 的 Model Context Protocol(MCP)製作每段最多 15 秒的口播片。按 SKILL.md 配置代理並連接服務後,可先看倉庫示例;其中一條 27 秒廣告耗用 482 Renoise credits,不能視為固定價格。

  • Whisper 逐段轉錄核對文稿,每段檢查 4 格畫面;若畫面出現生成字幕,該段會重做。
  • 頻譜匹配、去齒音及響度標準化協助統一分段聲音;測試中的齒音差距由 13.2 dB 降至 5.9 dB。
  • 48 項影片包裝手法參考 25 條創作者影片整理,可按需要增減。

這套流程適合需要反覆製作商品介紹或社交平台短片的小型內容團隊,也能把文字置於主持人身後。成品仍受外部模型服務和點數成本限制,使用前宜先檢查口型、畫面及人物一致性。

GitHub

Categories: 開源, AI productions, MCP, 數字人, 模型, Video, Image, Audio, Content Creator, 庫, Skill 技能

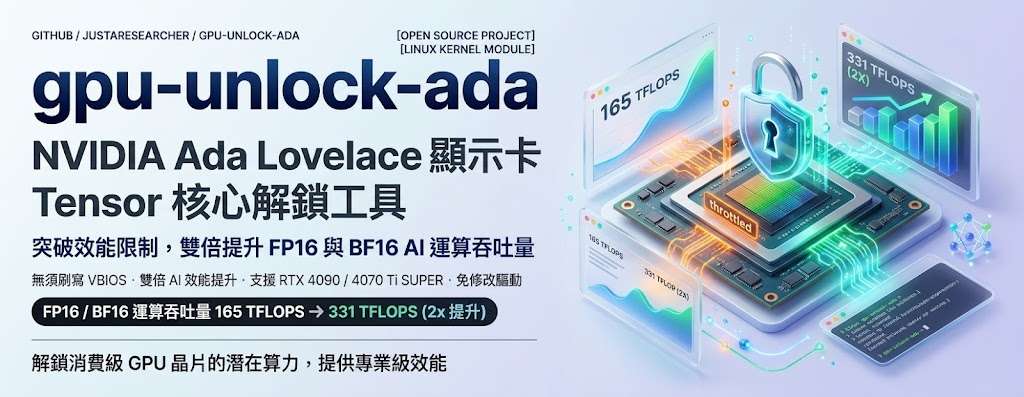
gpu-unlock-ada:RTX 4090 張量運算吞吐翻倍

Linux 核心模組可在 NVIDIA 驅動程式載入前啟用 Ada GPU 的 SM speed-select override,讓 RTX 4090 的 FP16、BF16 張量指令吞吐接近翻倍。實際 GEMM 增幅較小,量化推理甚至沒有受益。

Repository image for JustAResearcher/gpu-unlock-ada

想提升 RTX 4090 的 FP16、BF16 張量運算能力,這個 Linux 核心模組會在原廠 NVIDIA 驅動程式啟動前套用 SM speed-select override。它針對的是 FP32 累加的張量指令路徑,不是全面提高顯示卡效能;項目亦列出 RTX 4070 Ti SUPER 的實驗結果,Ada 系列支援仍須按型號和環境驗證。

測試中,RTX 4090 的 FP16/FP32 指令吞吐由約 160 TF/s 升至 320 TF/s,BF16/FP32 亦接近翻倍。不過,cuBLAS GEMM 的增幅按矩陣尺寸約為 12% 至 34%;量化混合專家模型推理測試則沒有加速,反映指令吞吐提升不等於應用程式整體提速。

模組須在 NVIDIA 驅動程式初始化前生效,因此項目提供 mkinitcpio 和 dracut 的 initramfs 設定方式,並附有 Quick Start、測試流程及各次硬件與驅動程式測試記錄。測試涵蓋 PCIe Function Level Reset、驅動程式交接和數值檢查,但不少結果來自單張顯示卡或單次配對測試,未足以證明長期穩定性。

• RTX 4090 的 FP16、BF16 張量指令吞吐接近翻倍。
• GEMM 增幅依矩陣形狀而異,量化推理未見收益。
• 支援依賴核心、顯示卡型號及 NVIDIA 驅動程式組合。
• 適合有 Linux GPU 測試環境、能自行核對結果的研究者與工程團隊。

對需要測試 NVidia RTX 4090 Ada GPU 張量指令上限的團隊,這項目提供了可查閱的測試流程與硬件證據;若工作負載主要依賴量化矩陣運算,或要求長時間穩定運行,現有結果並未證明它能帶來相應收益。

GitHub

Categories: 開源, 模型, NVIDIA, Linux, 庫

Page 2 of 17
1 2 3 4 … 17