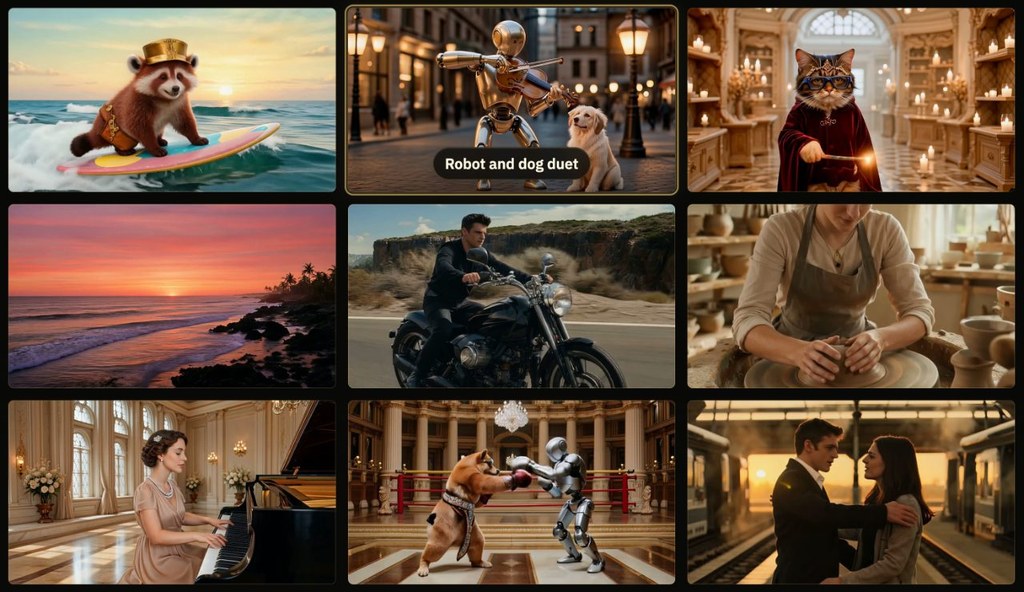
UnityShots:多鏡頭影音生成的記憶驅動新方案

由快手 Kling Team(快手) 與學界合作推出,UnityShots 把單鏡頭擴散模型改造成可保持人物、場景與聲音一致的多鏡頭敘事系統,並釋出 200 段基準測試集。

UnityShots Logo

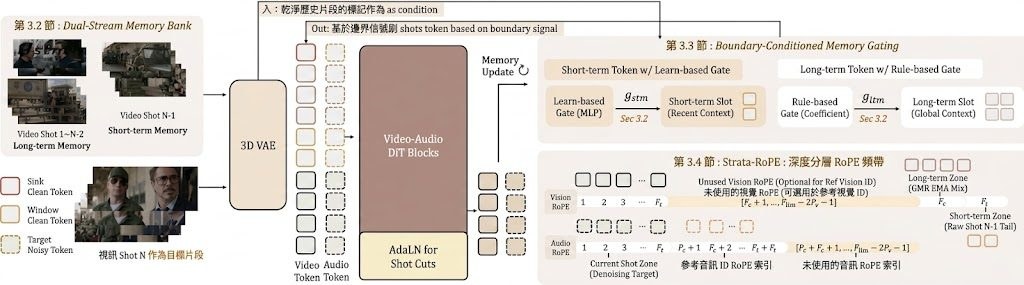
UnityShots 是一個研究性質的多鏡頭影音生成框架,核心任務是解決現有方法在長序列多鏡頭影片中難以維持人物、場景與聲音一致性的問題。它基於已有的單鏡頭影音擴散模型 LTX-2.3(22B 參數)建構,從一段結構化提示詞直接生成 3 至 9 個鏡頭的連續 .mp4 影片,確保角色容貌、場景光影與配音語音在各鏡頭間保持連貫。

現有做法通常依賴三種路線:端到端訓練固定長度序列但難以擴展、以記憶庫逐鏡頭生成但容量隨鏡頭數線性膨脹,或用大型語言模型規劃器調度預訓練生成器而缺乏多鏡頭感知骨幹。UnityShots 的切入點是引入邊界感知門控(Boundary-Aware Gating)與雙槽記憶機制:影片流維持兩個固定大小記憶槽,長期記憶(LTM)錨定開場鏡頭,短期記憶(STM)保留前一鏡頭尾部,兩者在每次剪接時由門控網路更新;音訊流則在每個鏡頭注入參考說話者 token,避免滑動音訊庫的負擔。另一個辨識度高的設計是透過 AdaLN 學習離散剪接類型先驗(cut-type prior),讓使用者可在推論階段調整轉場強度。

以下為重點摘要:

  • 類型:多鏡頭影音生成研究框架,附帶資料集與基準測試。
  • 核心差異:用固定大小雙記憶槽取代線性增長的記憶庫,並加入參考語者 token 維持聲音一致性。
  • 控制能力:剪接類型先驗成為推論時可調旋鈕,使用者可指定轉場強弱。
  • 相關模型:以 LTX-2.3 22B 為基座,整合 AdaLN 門控機制。
  • 資料集:釋出 UnityShotsBench,涵蓋六大文化區域、13 種語言的 200 段多鏡頭序列。

現有評估涵蓋 I2V、T2V、R2V 三種條件模式,UnityShots 在跨鏡頭一致性與音畫品質上與開源及閉源基準相當。對從事多鏡頭敘事、短影音自動化或數位人內容生成的團隊而言,這套框架提供了較完整的記憶與控制設計思路。原始資料庫明確指出,檢查點、訓練程式碼與代理系統尚未釋出,因此目前無法從儲存庫直接取得安裝指令或模型權重;讀者若有興趣部署,需等待官方後續發布。資料集本身可從 Hugging Face 的 KlingTeam/UnityShotsBench 下載,供研究者評測自家模型。授權為 CC BY-NC 4.0,僅限非商業學術用途。

GitHub: https://github.com/JIA-Lab-research/UnityShots
項目主頁: https://jackailab.github.io/Projects/UnityShots/

Paper: https://arxiv.org/pdf/2606.21661

Categories: 開源, 香港中文大學, 香港科技大學, 清華大學, 字節跳動, 數字人, 模型, 視頻模型, Video, 提示詞, 框架, 香港, 庫, 語音, LTX

PerceptionDLM:多區域圖像描述加速方案

PerceptionDLM 把多個區域描述改成並行生成,重點不是只追準確度,而是連速度一齊納入比較。

icon

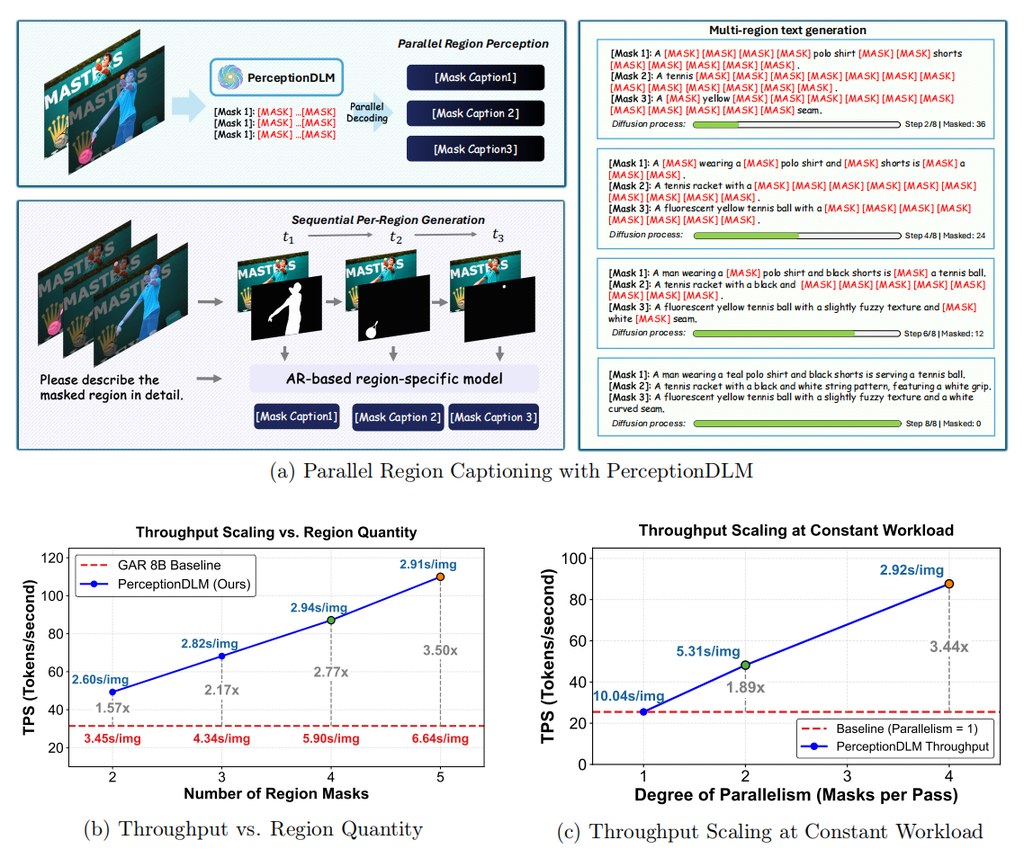
現時不少 Multimodal Large Language Models (MLLMs) 做區域描述時,仍然依賴 autoregressive (AR) 逐段生成:一張圖有幾多個 mask,就要逐個區域慢慢解讀。PerceptionDLM 提出的方向很明確,改用 Multimodal Diffusion Language Model,同一輪 denoising process 內同時輸出多個區域描述,目標是解決多區域感知在延遲上隨數量線性上升的問題。

這是一個偏向模型加基準測試的開源項目:核心是 PerceptionDLM 與 PerceptionDLM-Base,另加 ParaDLC-Bench、PerceptionDLM-Data 和 Bee / Honey 系列訓練資料配方。作者點名批評舊範式主要卡在 autoregressive region captioning,因此加入 efficient prompting 與 structured attention masking,讓平行生成不只停留在概念,而是落到 sequence level 同 token level。

從公開資料看,這個項目較適合以 Hugging Face 已釋出的模型、資料集與 evaluation suite 來理解和測試;想重現結果的人,亦可沿住訓練資料配方、Training 與 Evaluation 流程部署。對一般開發團隊而言,最有參考價值的不是安裝細節,而是它示範了 diffusion VLM 怎樣處理「多區域同時描述」這種以往較少由 DLM 承擔的任務。

  • 單次 denoising pass 可同時描述多個 masked regions,官方稱在密集多區域情境可有最高 3.4× throughput speedup
  • PerceptionDLM-Base 據稱在 16 個 multimodal benchmarks 之中,15 個勝過 LLaDA-V
  • ParaDLC-Bench 不只看 caption quality,也把 inference efficiency 一併納入
  • 已公開 code、model weights、training data recipe、evaluation suite,重現門檻比只放論文低

它較適合做視覺理解、圖像標註、自動資料整理,或者需要一次看多個區域的研究團隊。限制也很清楚:目前公開資訊主力強調 benchmark 與吞吐提升,對一般產品場景的記憶體需求、延遲分佈與部署成本仍要再看實測;相關模型則包括 PerceptionDLM、PerceptionDLM-Base,以及其 backbone LLaDA-8B-Instruct,對比對象則有 LLaDA-V。

GitHub: https://github.com/MSALab-PKU/PerceptionDLM

項目主頁: https://msalab-pku.github.io/projects/PerceptionDLM/index.html

項目: https://huggingface.co/collections/MSALab/perceptiondlm-model-zoo

Categories: 開源, 北京大學, 字節跳動, 模型, 視覺模型, 多模態模型, 模型訓練, Stable Diffusion, 提示詞, Dataset 數據集

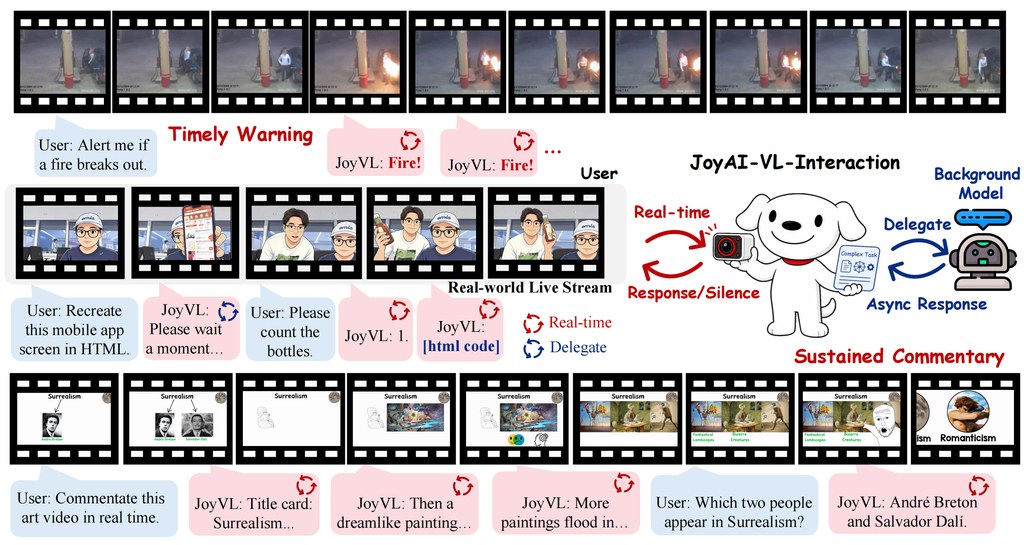
JoyAI-VL-Interaction 把影像助手變主動

這不是等你發問的聊天模型,而是持續看畫面、自己判斷何時出聲的互動項目。

JoyAI-VL-Interaction overview

現時多數視覺語言模型仍然沿用 turn-based 問答範式:用戶問一句,模型答一句;就算放進視像通話或直播介面,底層仍是被動回應。JoyAI-VL-Interaction 直接挑戰這個做法,改成持續觀看、按秒判斷要沉默、回應,還是把難題交給背景模型處理,目標是把 VLM 從「被問先答」推向即時互動。

這是一個多模態模型加可部署系統項目,想解決的不是普通問答,而是「畫面中的關鍵一刻不會等人發問」這個問題。技術報告提到它是 8B vision-first 模型,支援 real-time video-language interaction,並配合 time-aligned interaction data、training recipe 與完整系統,重點放在時間感、主動觸發與持續在線。

如果你想理解它是否適合自己,最容易的測試場景是把 webcam、直播畫面或監控串流接入,觀察它會否在有事件時主動開口,而不是每次都等指令。這種模式較適合直播助理、居家提醒、遠端看護、商務示範,甚至要一邊看影像一邊調用 API 或 agent 的流程。

  • 核心改動是由問答式互動,轉向 watch-and-do 式互動
  • 模型每秒自行決定沉默、回應或 delegation
  • 系統可接駁 ASR、TTS、memory、API 與其他 agent
  • 報告稱可長時間處理連續影片,延遲維持在 sub-second
  • 人工評分比較中,對 Doubao 與 Gemini 的質量與時機掌握都有明顯優勢

創新位不只在模型本身,也在整個開放堆疊一起釋出:模型、數據、訓練方法與部署系統放在同一個項目脈絡,方便研究者與開發者沿原路線延伸。相關模型與組件包括背景大模型、API、agent,以及文中對比的 Doubao、Gemini;若完整開源內容如期提供,這個項目會對即時多模態互動研究有相當高參考價值。

GitHub: https://github.com/jd-opensource/JoyAI-VL-Interaction

項目:https://joyai-vl-video-future-academy-jd.github.io/JoyAI-VL-Interaction/

Categories: 開源, 字節跳動, 文字轉語音, Agentic, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, OpenAI, Gemini, API, Video, Image, 工具, IDE, 語音

ARM:把生圖與修圖收進同一模型

ARM 用離散 visual tokens 統一理解、生成與編輯,RL 亦為修圖與生圖帶來量化提升。

Institute of Trustworthy Embodied AI logo

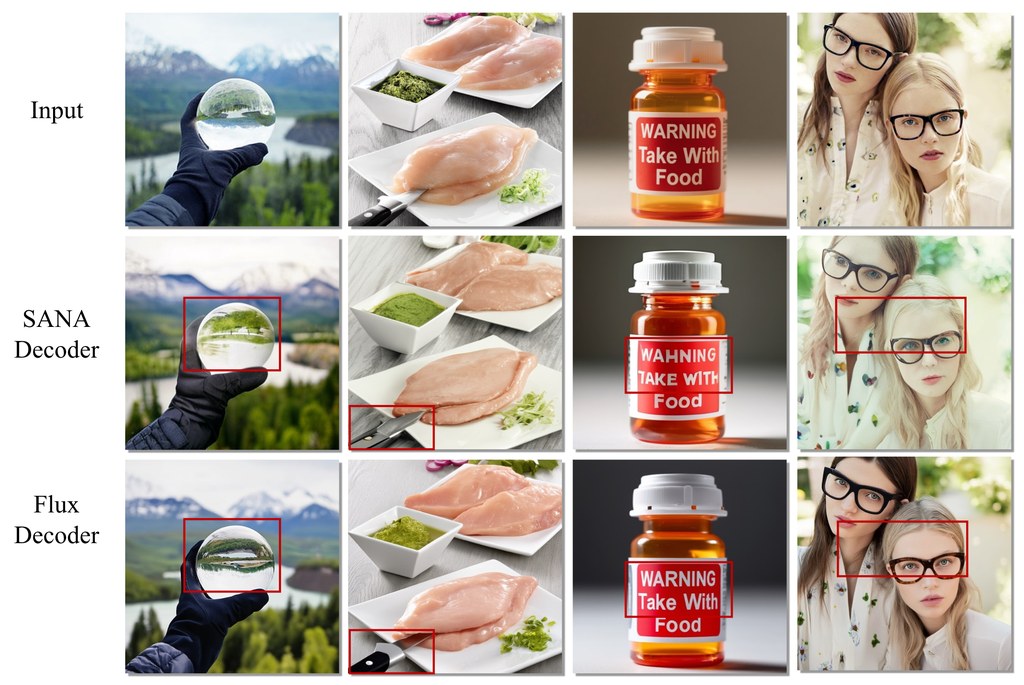
ARM 是一個 AutoRegressive Large Multimodal Model(ARM)類型的多模態模型,把圖像轉成離散 visual tokens,再以同一套 next-token prediction 處理理解、text-to-image 和指令式編輯,目標是把三種能力收進單一流程。

它的核心新意,是用 shared visual token space 連接看圖、生成與修圖,再以純 autoregressive multimodal modeling 處理交錯的文字與圖像 tokens。對一般讀者來說,可理解成「把圖片也變成語言模型可續寫的內容」。

• 7B 規模,重點在統一表示
• reinforcement learning(RL)結合 preference optimization
• WISE overall 由 0.50 升至 0.56
• GEdit-Bench-EN overall 由 5.75 升至 6.68

現階段較適合先讀論文和 benchmark。儲存庫節錄未見完整安裝、推理或權重說明,因此目前看來更像研究項目,不一定適合立即部署。

如果你關注 Large Multimodal Models(LMMs)、image editing,或想比較 unified autoregressive models,這個項目有參考價值。可對照的相關模型路線,包括 unified autoregressive models 與主流 image generation systems;論文亦提到它在 GenEval、DPG、WISE 具競爭力。

GitHub: https://github.com/wdrink/ARM

Paper: https://arxiv.org/pdf/2606.11188

Categories: 開源, 字節跳動, 模型, 影像處理, 框架

Bernini:影片生成與編輯的新路線

Bernini 是統一式的影片生成與編輯框架,目標是令生成與修改片段更可控。硬件要求不低,但定位相當鮮明。

Bernini

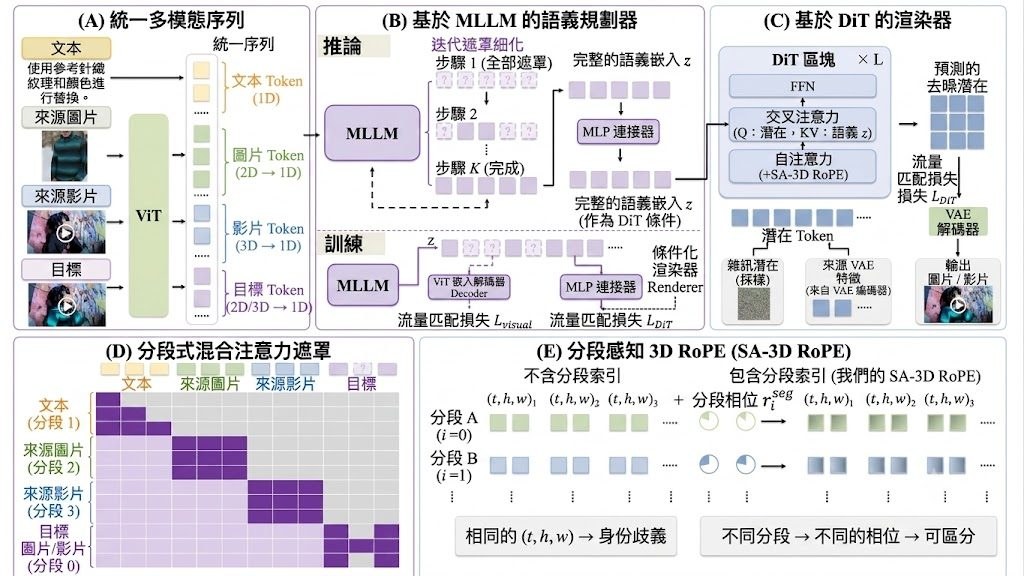
Bernini 是一個影片生成與編輯框架,核心是把 MLLM-based semantic planner 與 DiT-based renderer 組合起來,處理一般影片擴散模型常見的內容漂移、指令跟從不穩定,以及長片段規劃鬆散等問題。從定位看,它不是單純再堆大模型,而是先做語意規劃,再交由生成器落實畫面。

這個項目的關鍵想法,在於「Latent Semantic Planning」:先在潛在空間安排語意,再做 video diffusion。對非研究背景讀者來說,可以理解為先寫分鏡草稿,再逐格畫面化,這比直接由文字一步到位生成影片,更有機會保持故事連貫和編輯意圖一致。

如果想試,較合理的切入點是影片編輯任務,例如風格轉換、字幕或水印移除、局部修改,再觀察輸出有沒有跟足指令。倉庫列出的環境偏高階,建議準備 CUDA 12.4、Python 3.11.2,以及 torch==2.5.1+cu124、diffusers==0.35.2、accelerate==0.34.2、transformers==4.57.3;若有 H100、H800、H200 可配合 FlashAttention-3,其他 CUDA GPU 則退回 FlashAttention-2 或 PyTorch SDPA。

Bernini 在 video editing 的表現進入部分主流 closed-source commercial models 的第一梯隊,評分來自其自建 arena,以人工盲選、Bradley-Terry score 及 pairwise win-rate matrix 彙整。這類結果有參考價值,但暫時主要反映編輯場景;若你關心更複雜的人物生成,官方也提到 1.3B 的 Bernini-R 在簡單任務接近 14B 版本,面對複雜任務仍有差距。

Bernini: Latent Semantic Planning for Video Diffusion
  • 核心組成是 MLLM-based semantic planner + DiT-based renderer
  • 已公開 Bernini-R 權重,包含 1.3B 版本
  • 適合研究影片生成、影片編輯流程,或想比較規劃式生成方法的人
  • 硬件門檻偏高,Multi-GPU sequence parallel 亦需要 Open-VeOmni
  • 相關模型可先留意 Bernini-R-1.3B-Diffusers,以及文中提到的 14B 變體

整體來看,Bernini 最有價值的地方不是「再一個影片模型」,而是把規劃與渲染拆開處理,令可控性成為主要賣點。若你想找可直接在普通電腦輕鬆跑的項目,它未必合適;但如果你重視研究方向、編輯質素與系統設計,這個項目相當值得細看。

GitHub: https://github.com/bytedance/Bernini

Categories: 開源, 字節跳動, 模型, 視覺模型, 視頻模型, 影像模型, 影像處理, 框架, 語音

TaskMem:教多模態智能體學會選擇性記憶

ByteDance Seed 與復旦大學提出 TaskMem,以強化學習訓練智能體的記憶策略,在三個串流基準上明顯提升多模態問答表現。

Og image

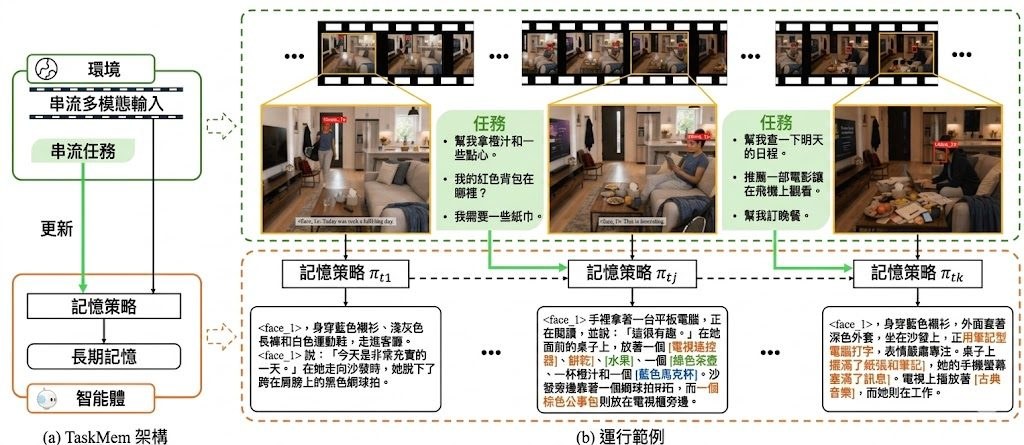
多模態智能體在持續觀察環境時,會接收海量且不斷累積的視覺與語言資訊。若把所有內容都存進長期記憶,既不實際也容易雜訊過多。Task-Focused Memorization for Multimodal Agents 這份研究,把焦點放在一個根本問題:智能體到底應該記住什麼?

來自 ByteDance Seed 與復旦大學的作者群提出名為 TaskMem(Task-focused Memorization Policy Learning) 的框架,把記憶生成視為一項可學習的策略。系統採用兩階段訓練:第一階段先學習怎樣記得準確,第二階段則在部署後,根據近期遇到的任務調整一個 adapter,使基礎多模態大型語言模型(MLLM)偏向記錄與任務相關的內容。整個過程以強化學習驅動,獎勵訊號來自真實任務的表現。

為了評估記憶品質,研究團隊將 VideoMME、EgoLife 與 EgoTempo 改造成串流基準,模擬智能體邊觀察邊回答的場景,且回答時只能依賴記憶,不能翻看原始影片。基於 Qwen3-VL-30B-A3B,TaskMem 在三個基準的 VQA 準確率分別提升 6.3%、7.0% 與 5.3%,並在多項指標上超越 Gemini-2.5-Pro、GPT-5.2 等大型模型。

這項工作對從事多模態智能體、機器人記錄系統或長期對話助手開發的研究者特別有參考價值,因為它把「該記什麼」變成可優化的決策,而非寫死規則。對於關注世界模型與持續學習(continual learning)的團隊,TaskMem 亦提供了一個結合任務回饋與記憶策略的可行路徑。

重點摘要:

  • 核心問題:多模態智能體面對資訊洪流,需要學會選擇性記憶。
  • 方法:以強化學習訓練記憶策略,分為基礎保真度與任務相關性兩階段。
  • 評估方式:將三個影片基準改造成串流設定,僅以記憶回答問題。
  • 成效:在 VideoMME、EgoLife、EgoTempo 上 VQA 準確率提升 5.3% 至 7.0%。
  • 適用對象:研究多模態智能體、機器人記憶與持續學習的開發者與學者。

項目: https://taskmem.github.io/

Categories: 開源, 字節跳動, Agentic, 框架, OpenClaw

Lance:一個模型包辦圖像與影片

Lance 把理解、生成與編輯放進同一個多模態框架。對想同時處理圖片與影片的人來說,方向相當清晰。

Lance logo

Lance 是 ByteDance 推出的 3B 級多模態模型,重點不只是「識圖」,而是把圖片與影片的理解、生成、編輯放在同一套框架內處理。對一般讀者來說,最易明白的價值是:同一個專案可應付多種視覺工作,不用為每個任務分開找不同模型。

Lance 可處理的任務包括文字生成圖片、文字生成影片、圖片編輯、影片編輯,以及由圖片或影片輸出文字說明。環境方面需要 Python 3.10+、CUDA 12.4+,推理亦要至少 40GB VRAM 的 GPU,較適合有工作站或伺服器資源的團隊先做測試,再按任務修改預設參數與樣本配置。

它較有意思的地方,在於用 3B active parameters 去覆蓋多種視覺任務,並強調由零開始訓練,加上分階段的多任務訓練方法。這代表它的設計方向不是只追單一指標,而是希望不同任務之間互相帶動,令圖片與影片能力更集中在同一模型內。

  • 支援的任務範圍廣:t2i、t2v、image edit、video edit、x2t image、x2t video
  • 模型規模屬 3B,但官方稱在多項圖片與影片基準上表現不俗
  • 重點是統一框架,減少多模型切換的複雜度
  • 推理硬件門檻不低,較適合研究、內容工具開發及企業試驗

合適視覺 AI 研究、內容製作流程整合、需要同時處理圖像與短片的原型系統。相關模型方向可留意文字轉圖片、文字轉影片、影像編輯、影片編輯,以及視覺轉文字這幾類;Lance 的特點正是把這些能力盡量收攏到同一個模型體系之中。

GitHub: https://github.com/bytedance/Lance

Paper: https://arxiv.org/pdf/2605.18678

Categories: 開源, 字節跳動, 影像模型, 影像處理

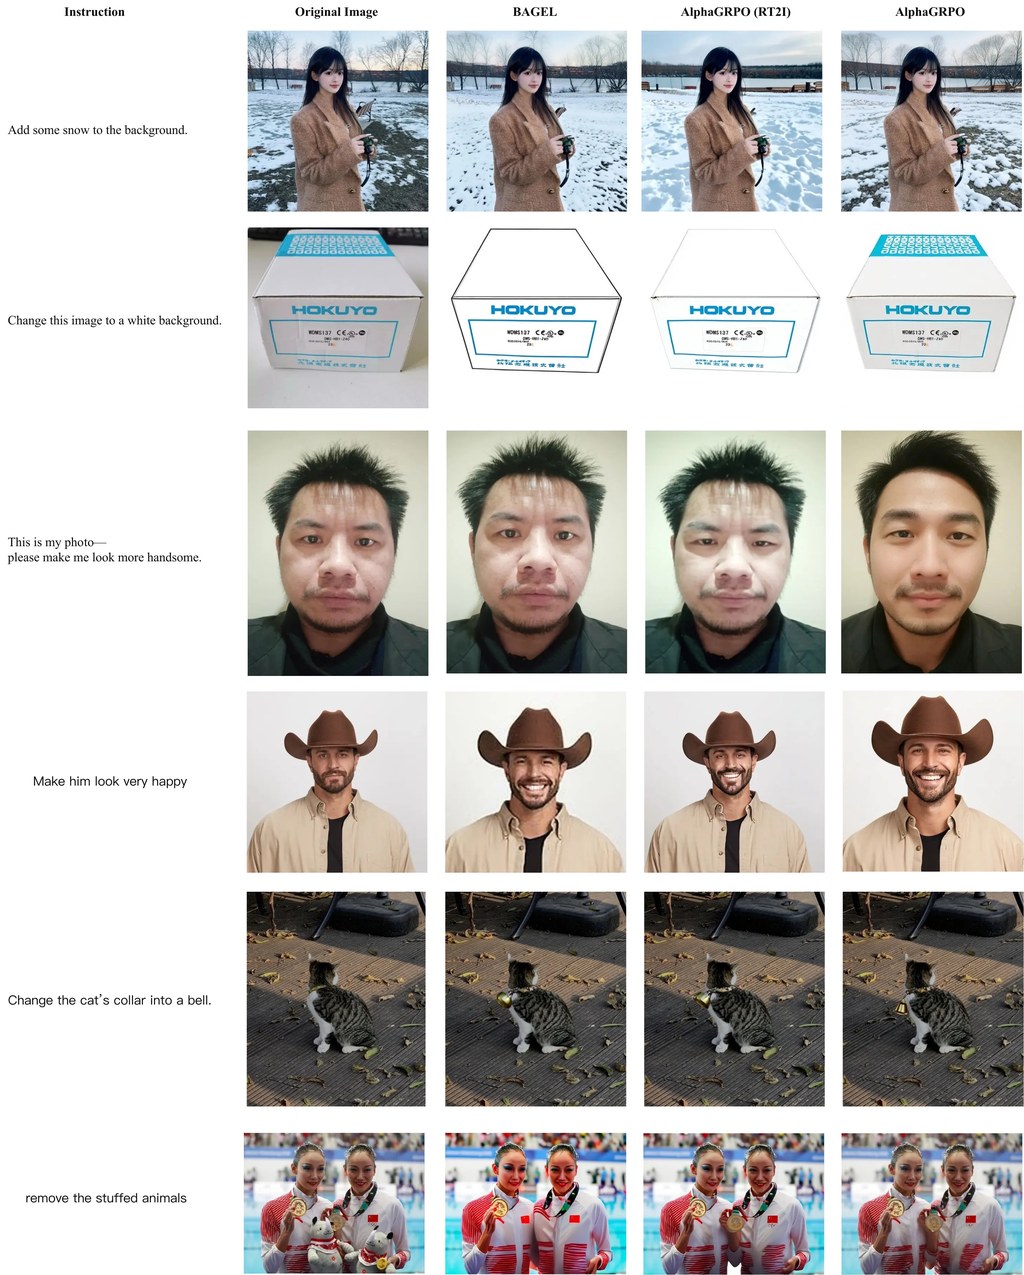
AlphaGRPO:能自我修正的多模態生成

呢個框架針對文字生圖與編輯任務,加入可驗證回饋,提升推理同自我修正能力。

Og image

AlphaGRPO 係一個用喺原生統一多模態模型嘅訓練框架,重點係令模型唔只係「生成」,而係會根據提示主動推理,並喺輸出有偏差時嘗試自行修正。網頁內容指出,佢主要面向文字生圖同相關編輯場景,目標係改善細節理解、構圖一致性,同埋對隱含要求嘅掌握。

呢個方法特別之處,在於將 GRPO 引入 AR-Diffusion 類型嘅統一模型,而且唔需要額外 cold-start 階段。另一個核心設計係 DVReward:先將複雜指令拆成多個可核實嘅細問題,再由開源多模態模型按語意對齊同畫面品質提供較穩定、可解釋嘅回饋,避免只靠單一分數太過籠統。

如果你想理解點樣使用,概念上可以當佢係一種訓練或強化現有多模態生成模型嘅方法,而唔係一般終端用家即開即用嘅 App。較適合研究人員、模型工程師,或者需要改善文字生圖、細粒度屬性控制、影像編輯泛化能力嘅團隊參考同實作。

  • 支援推理型文字生圖,能更主動補足用家未明講嘅意圖
  • 可做自我反思式修正,生成後再檢查並調整錯配內容
  • 回饋機制較細緻,將要求拆解成可驗證項目再評估
  • 在多個生成基準上有一致進步,亦可遷移到編輯任務
  • 推論階段加入自我修正後,文中指最高可再提升 5.8%

就評估結果而言,頁面提到 AlphaGRPO 喺 GenEval、TIIF-Bench、DPG-Bench、WISE 等生成基準,以及 GEdit 編輯任務都有提升,而且編輯能力並非靠專門編輯訓練得來,反映泛化表現不俗。不過,具體效果仍應按模型底座、評測設定同實際資料而定。

訓練程式碼和模型權重目前正在進行內部審核,審核通過後將予以發布。

網址: https://huangrh99.github.io/AlphaGRPO/

Categories: 開源, 香港大學, 字節跳動, 影像模型, 影像處理, 框架

Helios – 實時生成分鐘級長視頻

Helios 是一個 140 億參數(14B)自回歸擴散模型(autoregressive diffusion model),設計成可以在 單張 NVIDIA H100 GPU 上以約 19.5 FPS 實時生成分鐘級長視頻。它原生支援 Text‑to‑Video(T2V)、Image‑to‑Video(I2V)和 Video‑to‑Video(V2V) 三種任務,並有一個統一的輸入表示。 在維持 14B 規模的前提下,不使用 KV‑cache、稀疏/線性注意力、量化等常見加速技術,單卡就能跑到 19.5 FPS。

Helios 是一個 140 億參數(14B)自回歸擴散模型(autoregressive diffusion model),設計成可以在 單張 NVIDIA H100 GPU 上以約 19.5 FPS 實時生成分鐘級長視頻。它原生支援 Text‑to‑Video(T2V)、Image‑to‑Video(I2V)和 Video‑to‑Video(V2V) 三種任務,並有一個統一的輸入表示。

在維持 14B 規模的前提下,不使用 KV‑cache、稀疏/線性注意力、量化等常見加速技術,單卡就能跑到 19.5 FPS。

  • Helios‑Base(高質量)
  • Helios‑Mid(中間 checkpoint)
  • Helios‑Distilled(極端高效、對消費卡更友好),有 YouTuber 甚至在 RTX 4090 級別上跑 33 幀每段、分鐘級長視頻。
Helios - A 14B ByteDance Real-Time Long Video Generation Model Run Locally.

Categories: 開源, 字節跳動, 視頻模型

DreamActor-M2 基於時空上下文動畫

DreamActor-M2 是一個通用的角色圖像動畫框架,它將運動條件化重新定義為時空上下文學習任務。我們的設計利用了視訊基礎模型固有的生成先驗訊息,同時實現了從原始視訊直接進行無姿態、端到端運動遷移的關鍵演進。這種範式消除了明確姿態估計的需求,使得DreamActor-M2 能夠在各種複雜場景中實現卓越的泛化能力和高保真度的結果。

DreamActor-M2 是一個通用的角色圖像動畫框架,它將運動條件化重新定義為時空上下文學習任務。我們的設計利用了視訊基礎模型固有的生成先驗訊息,同時實現了從原始視訊直接進行無姿態、端到端運動遷移的關鍵演進。這種範式消除了明確姿態估計的需求,使得
DreamActor-M2 能夠在各種複雜場景中實現卓越的泛化能力和高保真度的結果。

Categories: 開源, 字節跳動, 視頻模型, 影像模型, 影像處理

Page 3 of 4
1 2 3 4