DeltaStreamer 讓串流影片可以回看再作答

影片播放過後仍可追查關鍵細節,DeltaStreamer 以記憶、規劃和視覺回放串起串流理解流程。

DeltaStreamer

影片一路播放,問題卻可能在關鍵畫面消失後才出現;DeltaStreamer 屬於 agentic framework,處理串流影片理解中「記住甚麼、何時回查」的難題。它以 change-aware memory 保存變化,再配合 query-driven planning 和 targeted visual replay,讓系統按問題重新檢查相關片段,而不是只依賴當時留下的文字描述。

對直播問答、影片監察和互動助手而言,這個流程比單純累積長篇摘要更適合處理後來才提出的問題。項目亦提供 AI-Tongdan 作為應用例子,支援持續觀察、上下文問答和彈幕建議;不過它是框架,不是獨立的新基礎模型,所用模型與推理配置仍要按儲存庫內容自行核對。

OVO-Bench 中,DeltaStreamer 的 overall score 為 66.07,Real-Time、Backward 及 Forward 分數分別為 72.23、67.72 和 58.25。它高於列出的全開源 online MLLMs 與 video agents 多個結果,但仍低於 Gemini 3 Flash 的 64.02 嗎? [sic]

項目主頁 · GitHub

Categories: 開源, 字節跳動, Agentic, AI productions, 模型, 多模態模型, Qwen, Video, 框架, 庫

ThinkV2V 讓影片編輯先思考再生成

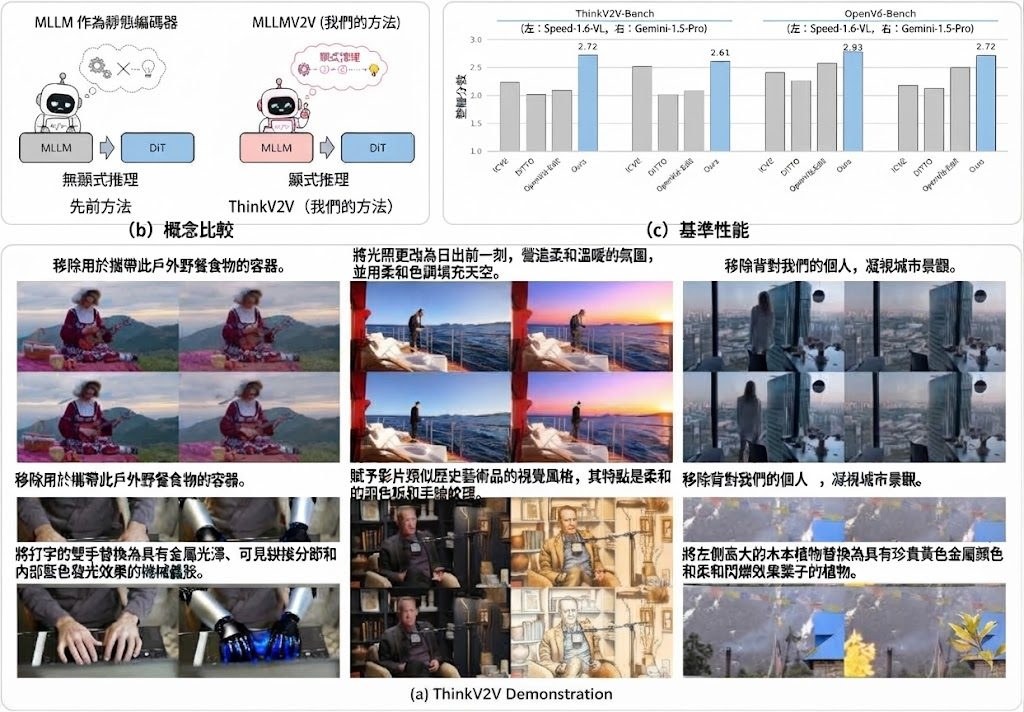
ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

ThinkV2V Overview

面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

Lucida:用「解析、生成、放置」三步把實景變成可編輯的模擬場景

字節跳動 Seed 團隊把真實室內環境拆解成獨立物件資產,透過閉環姿態修正讓重建結果能直接用於模擬。

Og image

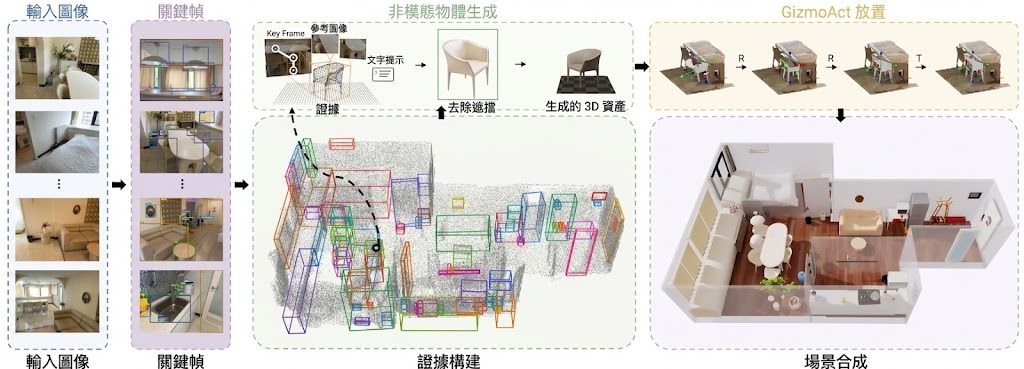
從一段真實拍攝的室內影片,要還原成可以模擬、可逐個編輯嘅場景,一直都係 3D 重建嘅痛點:擺位、遮擋同殘缺幾何往往令資產難以重用。Lucida 就係針對呢個矛盾提出嘅方案,屬於實景到模擬(real-to-sim)類嘅場景建模系統。

整個流程分成三步。第一步 Parse 揀選有用嘅關鍵幀,跨視角對應實例並建立場景圖,輸出遮擋、局部點雲同參考視圖等證據。第二步 Generate 利用每組證據合成無遮擋嘅物件影像,再提升成完整、可編輯嘅 3D 資產。第三步 Place 先粗略初始化,再用 GizmoAct 喺閉環中反覆執行姿態編輯,直到渲染結果同觀察對齊。

GizmoAct 係呢套系統嘅核心控制器,由視覺語言模型(VLM)操作 3D 編輯器,每一步根據渲染觀察、點雲疊加同正交視圖等線索,落一個可執行嘅姿態修正。同一條策略可應付由 Boxer、Any6D* 到 SAM 3D 等不同初始化,並以最多 4 個視圖同 12 步修正完成對齊。

Lucida 喺 R2S、CA-1M 同 Aria Digital Twin 數據集上都提升咗場景級 3D 物件檢測、姿態估計同完整場景重建指標。重建出嚟嘅場景以一組獨立、可編輯嘅 mesh 呈現,每件物件都準備好進入模擬階段。

對從事機器人模擬、室內數據合成或場景理解嘅團隊,呢套閉環做法比起傳統單次擬合更能容忍幾何誤差同遮擋問題,令實景資產更易直接落落去模擬器使用。

重點摘要

  • 三步流程:Parse、Generate、Place 把實景拆解成可重用物件資產
  • GizmoAct 閉環修正:VLM 操作 3D 編輯器,反覆落姿態編輯直到對齊
  • 初始化容忍度高:同一策略兼容 Boxer、Any6D*、SAM 3D 等不同起點
  • 輸出可直接模擬:每件物件係獨立、可編輯 mesh
  • 多數據集提升:喺 R2S、CA-1M、Aria Digital Twin 都有指標改進

項目主頁

Categories: 北京大學, 字節跳動, 視覺模型, Video, Image, 3D

Video-IFBench:跟足要求的影片評測

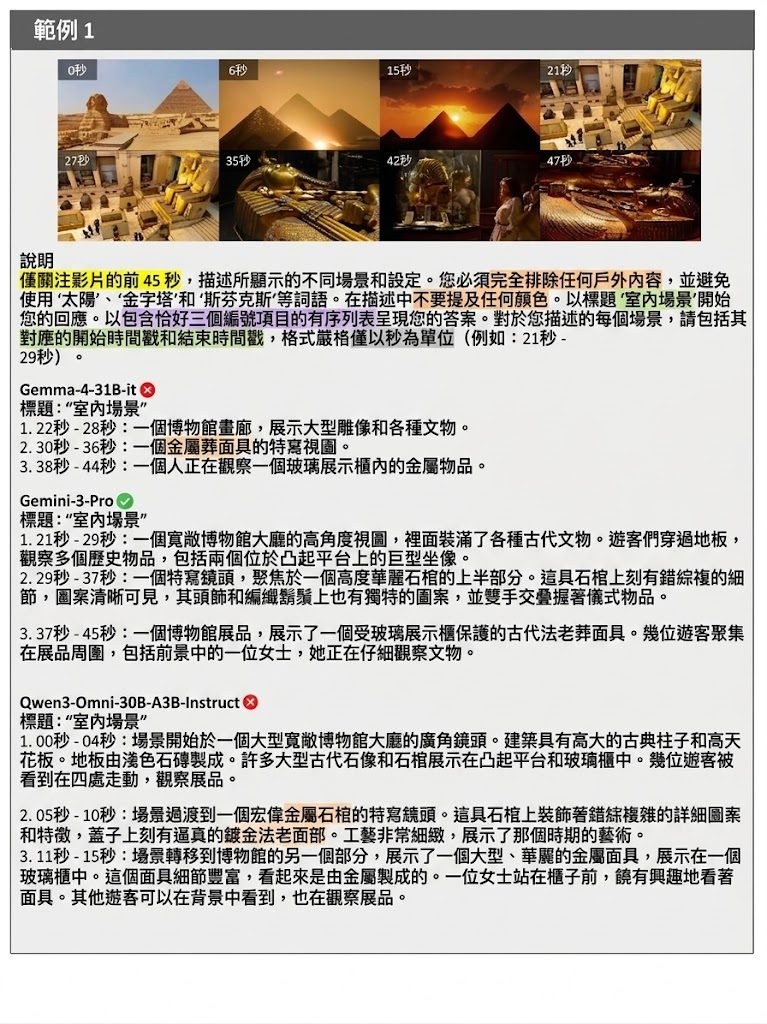
Video-IFBench 用來量度多模態大語言模型在影片理解場景中的指令跟隨能力。它把單步、多步、選擇和嵌套指令拆開測,直接看模型能否按條件做對。

Overview of the Video-IFBench construction and evaluation pipeline

Video-IFBench 是一個用來評測多模態大語言模型(Multimodal Large Language Models, MLLMs)在影片理解場景中是否跟足指令的資料集與基準。它處理的不是單純看懂影片,而是模型能否在複雜限制下,依照影片證據作出正確分支判斷、完成多重要求,並保持輸出格式一致。

這套基準把任務分成 Single、Multi、Selection 和 Nested 四類,覆蓋由簡單到層層加條件的情境。項目建構流程結合影片標註、任務與限制採樣、複雜指令生成、checklist、程序化處理和人工驗證,適合拿來測試模型在真實工作流裡會否因為條件一多就失手。

和一般只看整體問答正確率的影片基準相比,Video-IFBench 更著重嚴格遵循指令的程度。資料集同時提供 TCSR 和 TISR 兩種指標,結果顯示即使是頂級商用模型,遇到條件累積或需要按證據選分支的題目,分數也會明顯下滑;開源模型的差距更大,尤其在 Nested 類別。

對做影片理解、視覺問答、agent 評測,或者需要檢查模型能否按規則輸出內容的團隊,這個基準很有參考價值。它不只看模型「知唔知」,而是看模型「有冇照做」,這正是很多落地應用最容易出問題的位置。

  • 覆蓋影片理解中的四種指令型態,從單步到嵌套條件都有測。
  • 以 checklist 和人工驗證強化標註可靠度。
  • 用 TCSR 與 TISR 分開看內容命中與指令跟隨。
  • 商用模型整體較強,但複雜條件下仍有明顯失分。
  • 開源模型在多條件、分支選擇和格式遵循上差距更大。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 字節跳動, 騰訊, Agentic, 視覺模型, 多模態模型, Video, Dataset 數據集

DiffusionOPSD:將自我蒸餾影像獎勵轉為可更新訓練目標

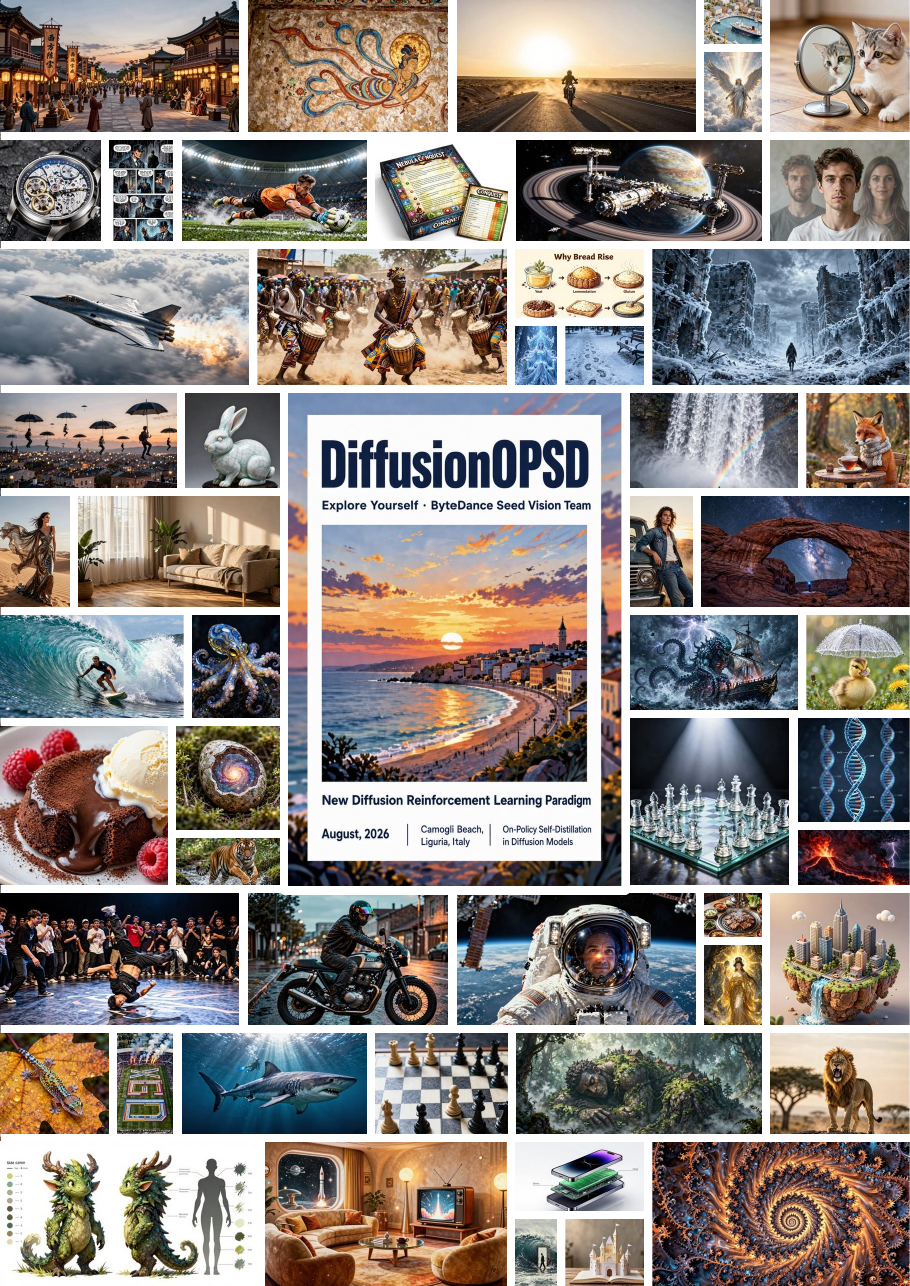
DiffusionOPSD 將影像級獎勵轉成可反覆更新的中間目標,補上 diffusion 訓練中間步驟的監督空白。它適合想在有限訓練預算下,改良生成質素同可診斷性的團隊。

DiffusionOPSD qualitative gallery

DiffusionOPSD(ByteDance Seed) 主攻的是 diffusion 模型後訓練時,只有最終圖片分數、欠缺中間步驟指引的問題。它屬於一套用於模型後訓練的開源方法,透過 on-policy self-distillation,把影像級 reward 轉成可直接學習的中間目標。

它的做法不是單純追分,而是先用凍結的 behavior policy 收集低噪聲查詢狀態,再用 reward gradient 建出正負兩種 bounded target,最後由可訓練 policy 去擬合這些切斷計算圖的目標。這種安排把目標品質和模型更新分開處理,亦令 supervision 可以隨住模型演化持續刷新。

實作層面,公開版本支援 SD3.5-M 512²,同時覆蓋原生 few-step 的 Z-Image-Turbo 1024² 設定;文件亦提到可做單一 reward 或多個 reward 的加權訓練。原文未提供完整安裝流程或逐步使用指引,只能確認它有項目頁與程式碼釋出,適合自行拉取後依研究環境配置。

它和同類 diffusion reward optimization 的主要分別,在於用 on-policy 查詢配合 EMA 持續重建 supervision,而不是只依賴離線或固定噪聲替代狀態。官方結果聲稱在多個 evaluator 與兩種 backbone 上都有較強的最終 held-out 表現,亦以較少 GPU-hours 完成訓練;這令它特別適合做生成模型後訓練、獎勵對齊與方法比較的研究團隊。

  • 將 image-level reward 轉成可學習的中間目標
  • 用 EMA 反覆刷新 trajectory、anchor 與 target
  • 支援 SD3.5-M 與 Z-Image-Turbo 兩種 backbone
  • 可做單一 reward,亦可做多 reward 加權
  • 適合研究 diffusion 後訓練同 reward alignment 的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 字節跳動, 模型訓練, Image, 影像處理, txt2img, 框架

OmniAssistBench:以多輪互動評測即時影片助手的表現

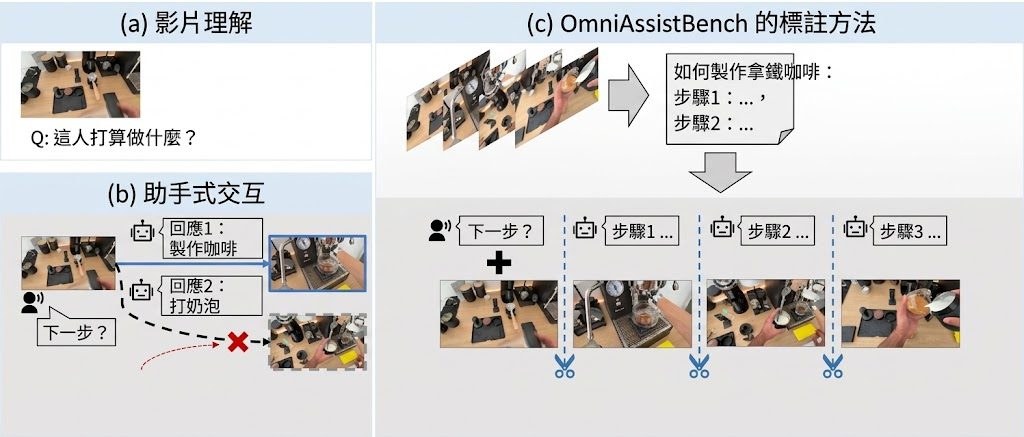
OmniAssistBench 以 LLM-as-a-Judge 固定互動路徑測試 Omni-LLMs 的多輪影片助手能力,涵蓋685組開放式問答、7類任務,影片含自然語音、打字或手寫提示。評分顯示 Gemini-3-Pro 以66.4分領先。

OmniAssistBench proposes an annotation pipeline which allows annotators to build test samples from existing Internet vid

當影片助手的回答會改變使用者下一步行動,傳統只對固定影片問答的測試便難以反映真實體驗。OmniAssistBench 屬於 Omni-LLMs 的影片助手評測基準及數據集,透過固定互動路徑,處理多輪對話中影片內容會隨模型回應變化的問題。

項目涵蓋 685 組開放式問答,分成 Basic Tier 與 Advanced Tier,涉及社交理解、時間感知、手勢提示、程序指導及主動回應等 7 類主要任務和 16 類細分任務。影片取材自運動、煮食、講課、DIY 及談話節目,另有 3 個自行拍攝案例,每個平均超過 15 輪互動;問題會以自然語音、打字或手寫方式嵌入影片,而不是只放文字提示。

  • 以影片連同對應音訊輸入模型,再按互動回合回答問題
  • 由專家先整理影片步驟,再剪輯片段及加入字幕,固定測試路徑
  • 評分採用 LLM-as-a-Judge,原始 0 至 5 分再換算為 0 至 100
  • 建立數據集耗用超過 1,000 小時專家工時

這種做法比靜態影片問答更貼近助手場景,但固定路徑亦代表其他合理回應未必能在同一測試中獲得充分反映。Project homepage 的排行榜顯示,Gemini-3-Pro 整體得分為 66.4,Gemini-2.5-Pro 為 64.6,商用及開源 Omni-LLMs 都只達部分正確,反映可靠的即時影片助手仍有明顯改進空間。

研究團隊來自南京大學、南開大學及 University of Waterloo。測試者需要按照項目提供的評測流程處理影片和音訊,相關 Dataset、Project Page 及評估程式碼可供查閱;正式採用前應先確認版本、存取權限及評分流程是否已更新。

項目主頁 · GitHub

Categories: 開源, 南京大學, 字節跳動, Qwen, Gemini, Dataset 數據集

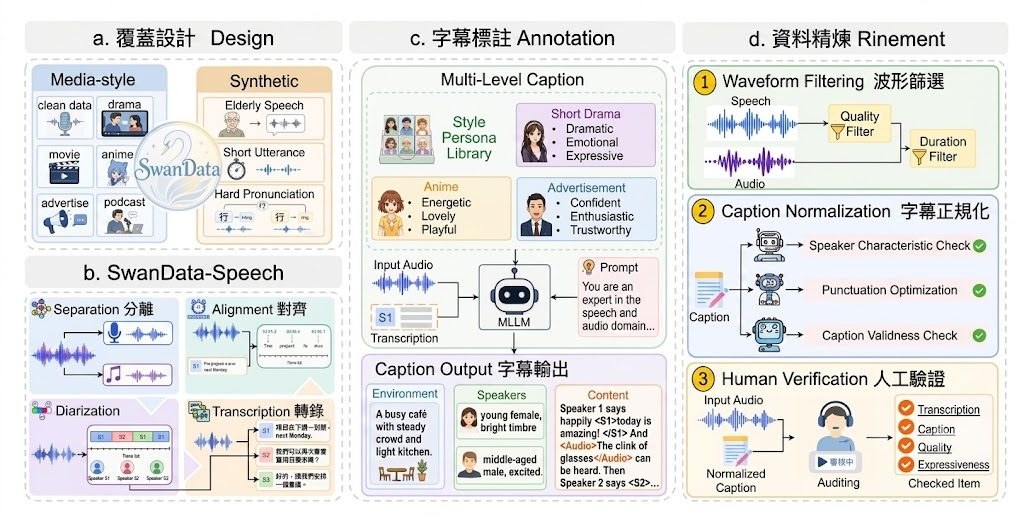
SwanTale 以場景佈局生成

SwanTale 把語音與音訊研究集中成一個入口,重點放在更有表達力的生成能力。

swan logo

比起只追求把字讀出來,字節跳動的 SwanTale 更著重聲音是否自然、有情緒,亦能否處理多人說話生成。這個由 ByteDance 推出的研究項目,焦點放在 expressive audio、speech 與 multi-speaker generation。

現有資料不算多,但已見到它不是單一模型頁,而是一個集合式研究入口,整合 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere 等子項目。對做語音產品、數字人、配音內容與語音互動工作流的人來說,這類整理方式較易追蹤同一研究線的進展。

  • 聚焦 expressive audio、speech 與 multi-speaker generation
  • 由 ByteDance 發佈,定位偏研究整合入口
  • 站內列出 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere
  • 目前公開資訊有限,性能與方法細節仍要逐個子項目再看

它的價值在於把聲音生成從「可用」推向「更像真人表達」,同時覆蓋多人語音場景。現階段較適合先把它視為字節跳動音訊與語音研究的總覽入口,而不是已完整公開規格的單一產品頁面。

項目主頁

Categories: 字節跳動, 數字人, Audio, 語音

Context Scaling 把文生圖提示詞帶到結構化階段

寫得更長未必更準,關鍵反而是提示詞有幾多可對應畫面的結構資訊。Context Scaling 把這件事量化,連帶改寫文生圖訓練與編輯流程。

Text prompt scaling law overview

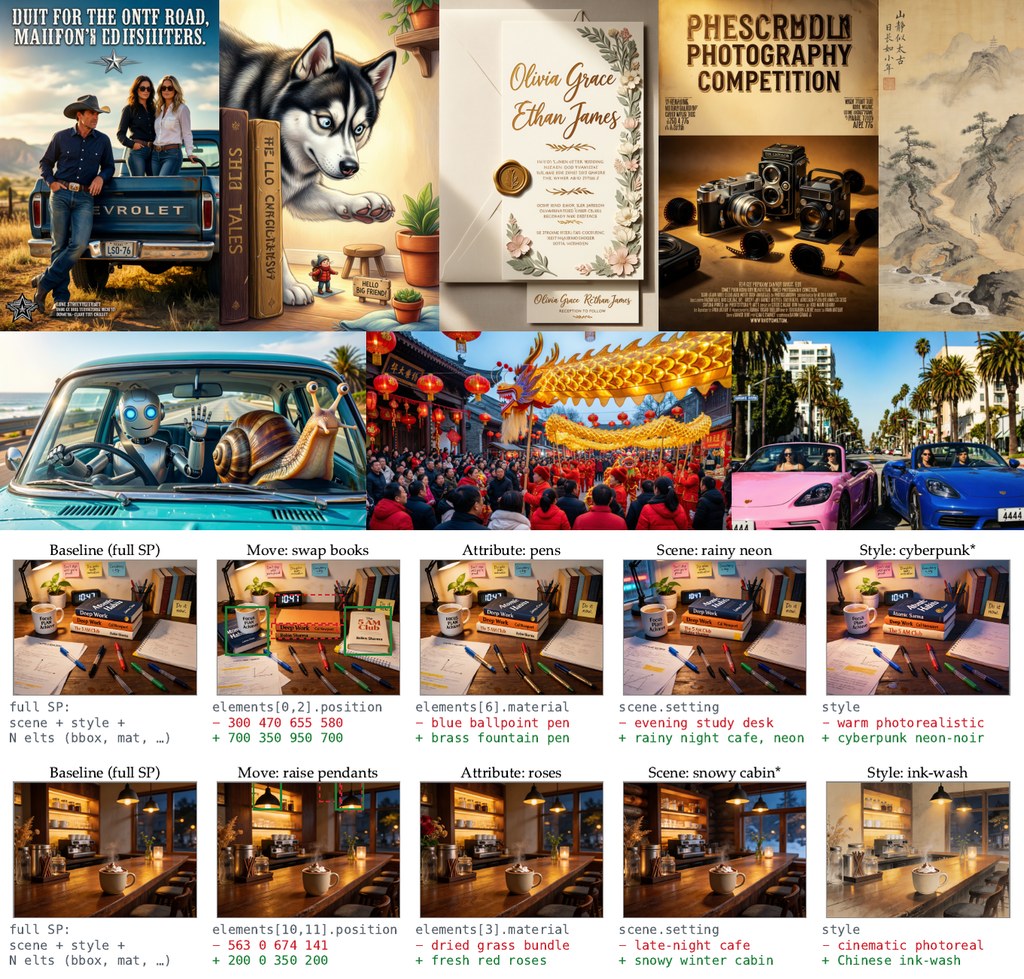
文生圖卡住的位置,很多時不是模型不夠大,而是提示詞交代得唔夠可計算。Context Scaling 聚焦影像生成中的文字條件 scaling law,屬於一個結合研究、模型與工作流程設計的項目,處理的是提示詞怎樣更有效描述構圖、屬性同空間關係,令 diffusion model 更容易學到、亦更容易按要求生成。

它最值得留意的判斷,是 caption 長度本身跟效果關係唔算緊密,反而 structured language 的資訊量更重要。團隊用兩個指標去量度這件事:white-box likelihood metric 的 GPG,同 black-box attribute metric 的 ED;受控訓練結果顯示,converged diffusion loss 會隨 GPG 近線性下降,亦會跟 ED 呈 power law 關係。

Context Scaling: Scaling Properties of Text Conditioning in Visual Generation
這個方向不只停留在分析。項目把 Structured prompts(SP)做成帶 semantic 與 geometric fields 的 JSON schema,再配合 trainable LLM prompter + captioner,將用戶要求或者輸入圖片轉成更有結構的描述;zero-shot structured editing 亦因此變得可行,因為每個可編輯因素都被拆成命名欄位,改其中一部分時,其他構圖元素較容易保留。

  • 重點不在提示詞有幾長,而在畫面資訊有幾可對齊
  • GPG 與 ED 為提示詞資訊量提供兩種量化方法
  • Structured prompts(SP)直接補強 compositional、reasoning、world-knowledge 類生成
  • prompter 經 supervised fine-tuning、cold-start、verifier-gated on-policy distillation 訓練
  • 已公開 Code、Models 與 Demo,理解路線可先看 project page,再到 Hugging Face collection

跟同類做法相比,它的取捨相當清楚:不是單靠更大模型或更長自然語言描述去碰運氣,而是先提升 captions 對影像的可監督性,再訓練 prompter 去穩定產生這類結構。官方說法指出,系統在多個 compositional、reasoning 與 world-knowledge benchmark 上超越全部已評測 open-weight models,並在多數評測追平或超過最強 closed-weight models;不過公開資訊仍以研究結果為主,部署細節與完整安裝流程未算多,現階段較適合做方法研究、提示詞工程、影像編輯流程設計,以及評估下一代文生圖介面的團隊參考。

項目主頁 · GitHub · 模型

Categories: 開源, 字節跳動, 模型, 模型訓練, Qwen, 影像模型, txt2img, Dataset 數據集

TableVerse 想補上機械臂數據缺口

想訓練更能適應雜亂桌面嘅機械臂,最缺的往往唔係模型,而係夠真實又夠大量嘅場景數據。TableVerse 用 Real2Sim 把網上圖片整理成可模擬環境,方向相當清晰。

TableVerse main figure

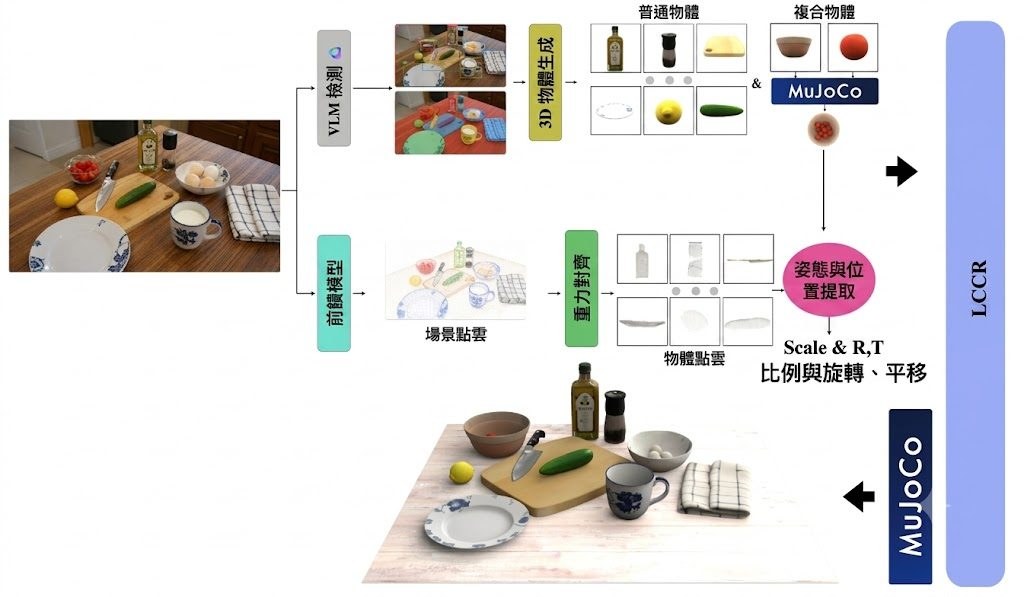
機械臂要學會喺凌亂桌面執放物件,卡位通常唔在控制器,而在訓練資料太乾淨、太想像化。TableVerse 屬於Dataset 數據集加上資料生成流程,重點不是再用文字幻想場景,而是用 Real2Sim 從網上真實圖片重建可放進模擬器的桌面配置,直接處理泛化操作最缺的場景真實感。

現有做法常見兩條路:text-to-layout hallucination,或者較簡化的 procedural generation。作者批評前者容易做出物理上唔合理的擺位,後者又捉唔到人類日常環境常見的密集雜物;因此 TableVerse 改成 deterministic reconstruction,從非結構化的 in-the-wild image data 還原具備 metric scales、authentic topologies 同 verified mechanical stability 的場景,取向明顯偏向可落地訓練,而唔係只追求合成速度。

項目現時最重要的成果是 TableVerse-100K,公開了 100,000 個 physically consistent 的桌面環境,並配對 interactive manipulation trajectories。網站資料顯示,它還接上自動化 task-conditioned trajectory generation,先由 MLLM 根據場景視角提出 object-to-target 配對,再生成 collision-free pick-and-place demonstrations,令數據不只得靜態場景,亦包含可直接餵給操作策略學習的示範。

  • 以真實圖片重建桌面,而非只靠生成式佈局
  • 提供 100K 場景與 pick-and-place 軌跡,規模夠大
  • 強調物理一致性、機械穩定性與模擬可用性
  • 適合做 generalizable manipulation 與桌面操作研究

部署角度上,這個 GitHub 儲存庫目前更接近論文與資料入口,主要連到 arXiv、HuggingFace dataset 同項目網站,未見完整訓練或評測程式公開。換句話說,研究團隊現階段較可能把它理解為高品質資料來源與方法參考,而不是即裝即跑的機械臂框架;對做 robotic manipulation、模擬訓練數據建構,或者研究 Real2Sim 流程的人,參考價值很高。

項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, 多模態模型, Image, Robotic, Dataset 數據集

RIPO 直指 LLM 強化學習探索崩塌

RIPO 不是再調一個 PPO-Clip 變體,而是直接質疑量度策略差異的方法。對想提升 LLM 推理訓練穩定度的人,這個方向值得留意。

Repository image for Aiolus-X/RIPO

訓練 LLM 做長鏈推理時,最麻煩的不只是算力,而是策略很容易愈學愈保守,最後卡在少數高機率答案附近。RIPO 屬於一個面向 LLM 強化學習的演算法研究項目,針對的正是 PPO-Clip 在後訓練階段常見的 exploration collapse,想解決罕見但關鍵動作愈來愈難被探索到的問題。

作者沒有沿用「再補幾個 heuristic」的路線,而是直接指出舊範式的核心錯位:PPO-Clip 以 Euclidean metric 量度 policy discrepancy,但 policy 本身更貼近一個 Riemannian manifold。呢個幾何不一致會令低機率區域更新過份保守、高機率區域又過份進取,最後令探索能力收縮;Riemannian Isometric Policy Optimization(RIPO)則改為追求等距的 policy update,嘗試同時守住 exploration 與 exploitation 的平衡。

論文描述中,RIPO 另一個重點是 bias-variance trade-off 較理想,令優化過程更穩定。成效方面,它在七個 competition-level benchmarks 上都優於既有 LLM RL algorithms,當中對 GRPO 在 AIME24 的提升最高可達 60%;這類結果相當吸引,但仍然要留意 benchmark 與訓練設置是否能完整轉移到你手上的模型與資料。

  • 核心批評很明確:PPO-Clip 的幾何假設不適合 policy update
  • 方法重心不是加獎勵技巧,而是重寫策略更新的度量方式
  • 對數學推理、長時序決策這類要靠探索找到解法的訓練場景較有價值
  • 成績亮眼,但更適合有能力重跑 benchmark 與訓練流程的研究團隊驗證

從提供的 GitHub 資訊看,儲存庫描述混入了 verl 這個 RL training library 的內容,因此閱讀與部署前要先分清:RIPO 是演算法與論文方向,verl 則較像承載 LLM RL 訓練流程的開源基建。較合理的理解方式,是把 RIPO 視為可整合進現有 LLM RL framework 的新策略更新方法;真正落地通常要配合既有訓練庫、GPU 叢集配置,以及像 GRPO、PPO 一類後訓練 dataflow 一起測試。

GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型訓練, OpenAI, 框架, 庫, Anthropic, Dataset 數據集

Page 1 of 4
1 2 3 4