DEFT-RLVR 用延後曝光減少自動駕駛 VLM 誤判

自動駕駛 Vision-language-action models 唔少都會被正確軌跡「提示」到答啱。DEFT-RLVR想處理的,正是這種看似會推理、其實先知道答案的偏差。

Ground-truth trajectory exposure can induce post-hoc rationalization and hallucination.

自動駕駛 Vision-language-action models 一旦在推理前先見到真實未來軌跡,很容易把答案合理化,卻未必真係根據場景作判斷。DEFT-RLVR 屬於訓練與驗證框架項目,核心是把「先看場景作決定」同「之後再對照候選軌跡」拆開,減少 trajectory anchoring bias。

它的做法唔係直接生成開放式座標,而是先用 AD-MCQ 把規劃問題改成多選題,再用 DEFT 兩階段流程處理:模型先做 candidate-blind scene reasoning,之後先見到候選軌跡再揀答案。這種設計的好處,是答案可被精確核對;代價則是任務表述被收窄到候選集合之內,較接近「可驗證決策」而唔係完整路徑生成。

  • 針對的不是感知本身,而是推理監督被答案污染的問題
  • AD-MCQ 保留 braking、speed 同 lateral geometry 等差異,方便精確評分
  • DEFT-RLVR 用 GRPO 聯合優化,並且可選用 rubric 監督推理過程
  • RL 階段直接由 base VLM 開始,毋須 cold-start SFT
  • 模型採用 Qwen3-VL

部署門檻不算低。項目要求另行安裝支援 CUDA 的 vLLM,Waymo codebook reconstruction 還要額外用 Python 3.9 的 autovla waymo py39 環境;預設 recipe 亦明顯偏向大型多 GPU 節點,小型設備需要自行調整 tensor parallelism、batch size、sequence length 同 offloading。

目前公開資訊顯示,它在 AD-MCQ-500 上同時提升 trajectory selection 與 candidate-blind reasoning,較穩妥的判斷是:這套方法對研究自動駕駛 VLM/VLA 訓練可靠性、想避免「先知答案再解釋」的團隊尤其有參考價值;要落地到更開放的真實規劃流程,仍要看候選軌跡構建與算力成本能否接受。
GitHub

Categories: 開源, 視覺模型, 多模態模型, NVIDIA, VLA, Python

UEmbed:單一模型同時做稠密與稀疏檢索

UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,令稠密向量與稀疏詞彙向量可以一併輸出。對要做多模態搜尋或檢索增強生成的團隊,這種設計可減少來回切換模型。

Repository image for Alibaba-NLP/UEmbed

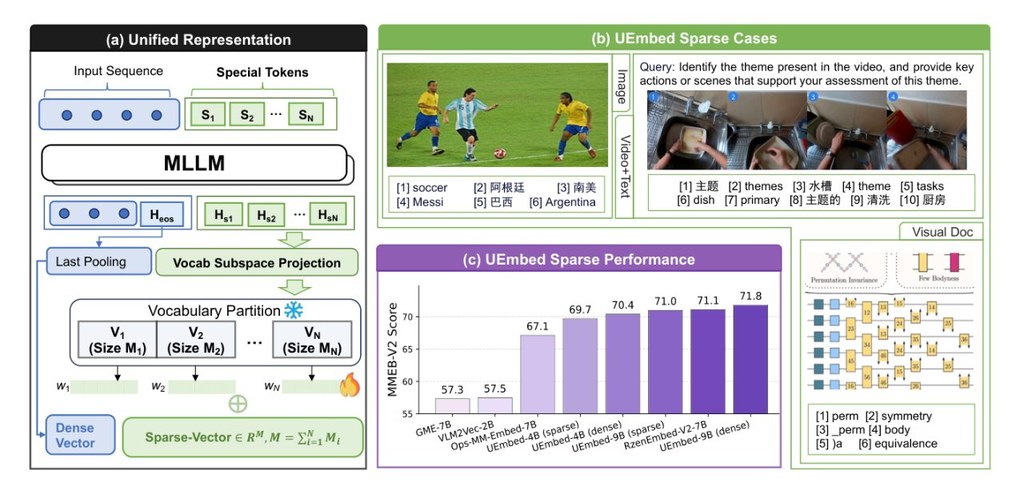
UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,它走的是多模態 embedding 模型路線,重點是把 dense 向量和 SPLADE-style sparse lexical 向量放在同一個 causal forward pass 內處理,方便直接做檢索、多模態搜尋和 visual-document retrieval。它不是只做文字匹配,而是把文字、圖片、影片與混合輸入統一到同一套表示空間。

直接取用 Hugging Face 上的 2B、4B、9B 權重,再按輸入格式送入不同媒體內容,檢查 dense 與 sparse 輸出是否符合預期。若要部署到搜尋系統,dense 部分可接向量檢索,sparse 部分可接倒排索引,兩條路可以同時保留。

它和傳統 learned sparse retriever 最大分別,在於保留 decoder-only multimodal backbone,並用 16 個 learnable special tokens 分攤稀疏詞彙空間,避開單一 token 的表達瓶頸。訓練時同時優化 dense InfoNCE、sparse InfoNCE 和 FLOPS regularization,取捨是結構較巧,但推理時可以用同一個模型兼顧語義召回與詞彙可解釋性。

效能方面,UEmbed-9B 在 MMEB-v2 取得 71.8(dense)與 71.0(sparse),並在公開數據訓練條件下做出很強的稀疏檢索表現;在 BEIR 上亦保持競爭力。對做搜尋、RAG、跨媒體內容索引,或者要把文字與圖像一齊納入檢索的團隊,這套做法會較有吸引力。

  • 同一個模型同時輸出 dense 與 sparse 表示
  • 支援文字、圖片、影片與混合輸入
  • 稀疏輸出可直接對接倒排索引,較易解釋
  • 以 Qwen3.5 multimodal backbone 為基礎,並用公開資料訓練
  • 2B、4B、9B 三個規模可選

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, RAG, Embedding, 模型, 多模態模型, Qwen, Image

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based onbase modelfine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

N0-TWAM 把觸覺帶進機械人決策

鏡頭睇到嘅畫面未必足夠,N0-TWAM連觸覺一齊預測,再生成動作。對接觸密集操作來說,這個方向比只看影像更貼近現場需要。

teaser

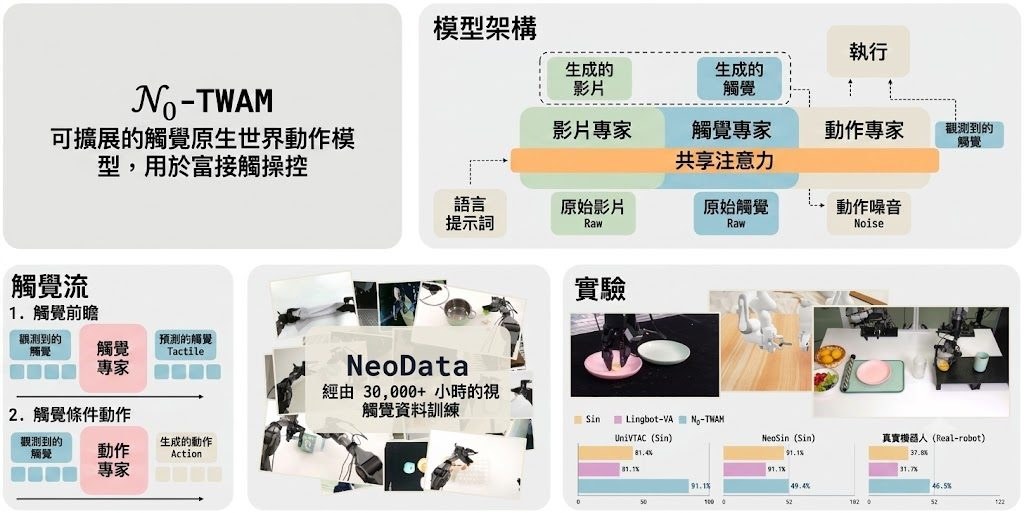
插頭有冇卡住、夾爪有冇真係受力,單靠畫面往往判斷唔完整。N0-TWAM放喺呢個空缺上處理問題:它屬於世界動作模型,將 vision、tactile 同 action 一齊建模,先推進未來會見到乜、摸到乜,再輸出低層動作,目標直指 contact-rich manipulation。

它吸引之處不只是多加一種感測,而係把觸覺當成未來狀態的一部分,而唔係事後補充訊號。相比只預測影片的 world-action model,或者直接由當前觀察回歸動作的 VLA policy,N0-TWAM更著重「預測之後再行動」;代價是系統更重,儲存庫亦只釋出 pretrained checkpoint、inference server 同 post-training toolkit,未包含大規模預訓練流程。

  • 可直接載入 pretrained checkpoint,再用自家 demonstrations 做 post-training
  • 可經 websocket 部署,由 observation 持續取回動作,也可接到自家 robot 或 simulator 做 closed-loop 控制
  • 支援 NeoSim 的 closed-loop benchmark,方便用 vision–tactile 場景驗證表現
  • 核心做法是 Mixture-of-Transformers (MoT),分開 video、tactile、action 三個 experts,再共享注意力交換資訊

模型背後沿用 WAN2.2 TI2V-5B video diffusion transformer 作 backbone,重組成三個 experts,並用 rectified-flow / flow-matching 目標聯合學習。readme 亦交代 action space 是 20-dim dual-arm end-effector,配合 tactile-aware execution,明顯不是聊天式 agent,而是面向機械臂操作與接觸控制的研究模型。

它在 UniVTAC、NeoSim 與八個 real-robot tasks 的平均成功率分別達到 84.5%、49.4% 和 46.3%。這些結果說明觸覺對高接觸操作有實質幫助;同時也要留意,部署門檻仍然偏研究導向,較適合機械人團隊、模擬環境開發者,以及已經有 demonstrations 與感測資料流的項目直接接入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 模型訓練, Video, VLA, Robotic, Dataset 數據集

PerceptionBench:Moonshot AI 教你測試 MLLM 視覺盲點

不少多模態模型答得似模似樣,但未必真係睇得準。PerceptionBench 把問題拆到最細,專門量度 MLLM 最基本的視覺感知能力。

kimi small

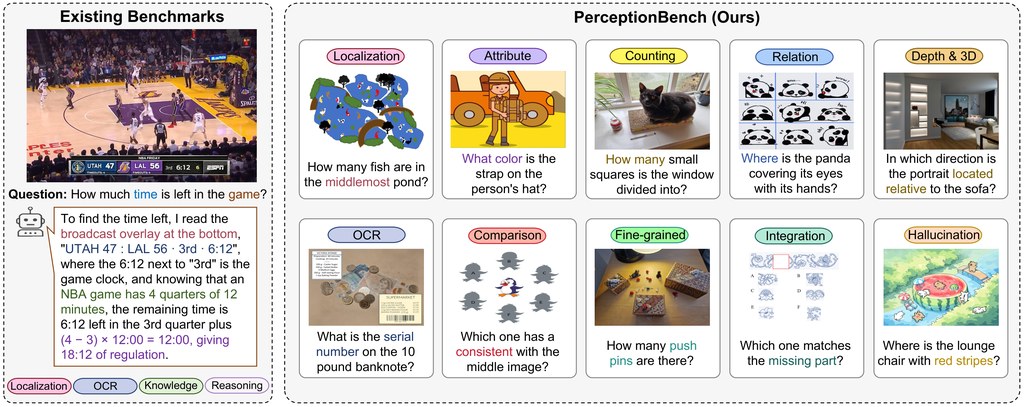
不少 Multimodal Large Language Models(MLLMs)表面上回答完整,但錯誤未必來自推理,往往早在「看圖」那一步已經出現。PerceptionBench 就是一個評測資料集兼 benchmark,專門把視覺感知拆成最細單元,檢查模型究竟係讀錯字、看漏關係,還是出現 perception-related hallucination(Hallu)。

它的價值,在於不再用一個總分掩蓋問題。團隊先分析 42 個現有 benchmarks 的失敗案例,再整理出一套錯誤分類,當中視覺感知分支包含十種 atomic perceptual capabilities,之後用這個框架建立 3,000 條經驗證題目,每題只測一種能力,答案亦刻意保持簡短而明確,盡量避免把推理或背景知識混入結果。

對做模型評估、資料標註或多模態產品調校的人來說,這個項目最有用的地方,是你可以更早定位問題源頭。它不是教你部署模型的工具,而是用來比較模型能力輪廓的尺;資料已放上 Hugging Face,程式碼亦公開,較適合拿來跑 benchmark、重現論文結果,或者把自家模型放入同一套題目做橫向比較。

  • 以 3,000 條 verified questions 測十種 atomic visual perception 能力
  • 題目刻意隔離單一能力,減少推理與知識干擾
  • 共評測 16 個 frontier MLLMs,使用統一 prompts
  • 沒有模型準確率超過 60%,Hallu 表現平均最弱
  • 相近總分之下,不同模型的能力分佈可以差很遠

所有題目都採用開放式短答案,再由 GPT-oss-120B 依參考答案判分,官方指它與人工審核在 300 個樣本上的一致率達 99.7%。這類設計未必等同真實產品場景,但很適合做能力層面的診斷;當你想知道模型到底「唔識答」還是「睇錯圖」,PerceptionBench 提供的資訊比一般綜合排行榜更有分析價值。

GitHub

Categories: 開源, 多模態模型, Dataset 數據集, Kimi

See2Think 驗證多模態模型有冇「睇圖再諗」

多模態模型會畫輔助線、標示區域,未必代表後續推理真係依賴咗呢些中間視覺狀態。See2Think想量度的,正正就是這段常被忽略的過程。

See2Think — Do Multimodal Models Really Use Intermediate Visual States?

見到模型會畫線、裁圖、標記物件,很多人自然會當它「有睇過先答」。See2Think屬於基準測試加診斷框架,焦點不是只看最後答啱幾多,而是拆開檢查中間視覺狀態有冇被真正用到、渲染是否忠實,以及後續推理有冇因此改變,這點對多模態模型(Multimodal Models)尤其關鍵。

它的核心設計分成兩部分:See2ThinkBench 收錄 1,200 條 visually dependent 問題,涵蓋 2D structured reasoning、3D scene reasoning 同 real-world visual reasoning;另一部分是 Visual Action-of-Thought(VAoT)流程,會把文字思路、structured visual actions、rendered states 同之後的推理串連起來。這種做法比單看 final-answer accuracy 更有診斷力,因為可以分辨模型是在「做出圖像」還是在「依賴圖像」。

同類研究常停留在結果分數,See2Think較著重受控比較。它設有 CoT、NoRender、Full、WrongRender 等 matched comparisons,又會檢查 render-benefit、corrupted-feedback sensitivity,以及 process judging 裡的 relevance、faithfulness、uptake,換句話說,不只問模型答得對不對,還會問中間那一步是否相關、是否被正確執行、以及模型有沒有吸收回來的視覺資訊。

  • 適合研究多模態推理、agent 行為分析、視覺工具鏈設計的團隊
  • 強項在於把「中間圖像是否有用」變成可觀察、可干預的測試問題
  • 覆蓋圖表、幾何、符號結構、3D 空間關係到真實圖片場景
  • GitHub 已公開程式與 quick start 線索,但論文仍標示為 coming soon,細部實驗設定仍要以後續正式文件核對

對模型評估要求較細緻的情境,這個項目很有參考價值;想拿它直接當應用工具就未必是同一回事。它更像研究型基礎設施,幫團隊判斷多模態系統的推理鏈是否可信,而不是單純追求更高答題分數。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 上海人工智慧實驗室, Agentic, 多模態模型, 3D, Dataset 數據集

SpatialCLI 用空間工具補強視覺推理

模型唔係睇唔明圖,而係成日差半步先答得準。SpatialCLI 想補上的,正正係定位、分割、深度與姿態判斷呢類容易失手的細節。

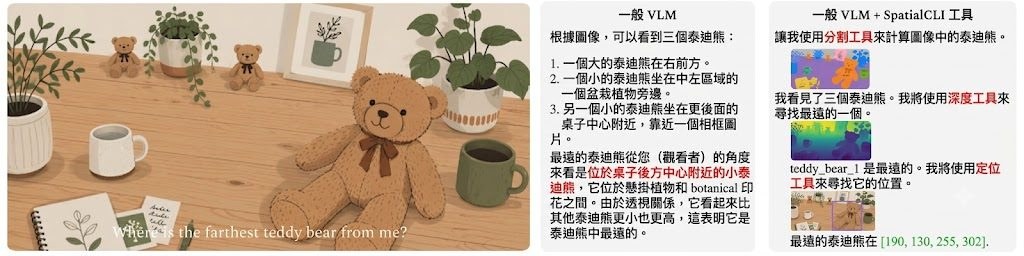
A comparison between a general VLM and a general VLM augmented with SpatialCLI tools

一到要指出物件位置、分清遮擋關係,或者估計深度與姿態,純 Vision-Language Model 往往會答到有方向但未夠準。SpatialCLI 把呢個落差處理得幾直接:它不是單靠一個大模型硬撐,而是把空間能力拆開,先讓模型懂得呼叫工具,再進一步把這些能力學回自己身上;整體定位更像一個結合模型、工具鏈與訓練方法的研究項目。

它最有意思的地方,在於三段式 Call-Learn-Internalize。第一步先接上做 localization、segmentation、metric depth、pose 的 specialist vision models,第二步用 Cold-Start SFT 與 agentic RL 訓練模型判斷幾時要用哪個工具、怎樣整合結果,第三步再把成功軌跡轉回模型能力。取向很清楚:寧願先借助外部工具拿到更可靠的局部感知,再追求把能力內化,減少每次推理都依賴外掛模組。

對研究團隊或做多模態 Agentic 工作流的人來說,這個項目值得留意,因為它同時放出 SpatialCLI code、SpatialCLI-8B 與 SpatialCLI-Data,不只是概念展示。理解它的部署方式也不難:代碼庫負責工具調用與訓練流程,Hugging Face 上的模型與資料集則對應推理、微調和重現實驗的核心材料;要完整驗證效果,通常要連同外部空間工具一併配置。

  • 類型上屬於模型加框架的研究項目,目的是提升多模態模型在空間推理上的準確度與工具使用能力。
  • 重點不只在「可呼叫工具」,而是進一步把工具使用經驗轉化成模型本身的能力。
  • 已公開論文、SpatialCLI-8B 與 SpatialCLI-Data,方便重現與延伸訓練。
  • 適合要處理定位、分割、深度、姿態等視覺任務的人員參考其工作流設計。

現有資訊未見 README 完整列出量化結果細節,但評測章節與 specialist models 章節已預留,顯示作者不是把它包裝成單一模型升級,而是把「何時調工具、如何學會不用工具也保留能力」當成核心問題。這種做法的代價也很明顯:系統整合與訓練鏈會比單純跑一個 VLM 複雜,不過換來的是更貼近真實空間任務的推理穩定性。

GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, 影像處理

OmegaUse-OfficeVal 量度 Office 代理能力

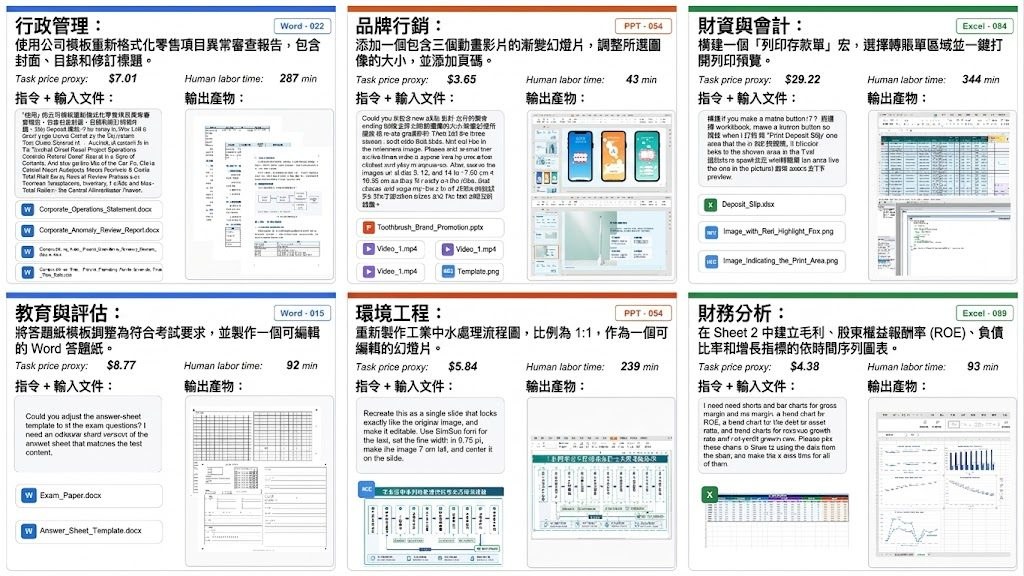
想比較 LLM agents 做 Office 工作交付得好唔好,單靠主觀打分唔夠。OmegaUse-OfficeVal 用可執行驗證器同經濟訊號,將評測流程整理成可重跑的框架。

OmegaUse-OfficeVal benchmark framework

做 Office-suite 長流程任務,最難唔係叫模型產生文件,而係點樣穩定判斷交付物到底合格未。OmegaUse-OfficeVal 把這件事做成一個 Python 框架,同時連接 benchmark 思路與驗證流程:它收 ZIP 提交、先做安全檢查,再逐個執行 100 個 Office document evaluators,最後輸出 JSON 同 CSV 報告,適合用來評測 LLM agents 在 Office 任務中的完成度。

呢個項目的取向幾鮮明:重點唔放喺即場互動,而係放喺可重複、可審核、可批量執行的驗證。網站資料亦交代,OmegaUse-OfficeVal 對應的是一組有經濟 grounding 的長時程 Office-suite tasks,100 個任務平均要 2.32 小時人手完成,並附有人力時間與 task price proxy,方便把模型推理成本同人類成本放埋一齊看。相比只做最終分數排行,這種設計更接近團隊挑選 agent、比較交付價值時會遇到的問題。

它不是把資料集、提交內容同工作目錄全部包在倉庫內,而是把評測框架與 verifier source code 分開提供,benchmark data 另外發佈。Python 3.10 以上可跑,Windows、macOS、Linux 都支援 normal mode;其中 91 個 verifiers 可跨平台執行,另有 9 個 verifiers 依賴 Windows 上的 Office COM,相關環境未齊時會被跳過或只限指定平台處理。

  • evaluate(directory: str) -> dict 統一 100 個驗證器介面,方便批量評測與整合
  • 收件前先檢查 ZIP traversal、加密、大小、檔案數量與壓縮比,安全性考慮算完整
  • 每個 verifier 在隔離 subprocess 執行,可設定 concurrency 同 timeout,減少互相干擾
  • 輸出採用 machine-readable JSON、CSV,而且每個 verifier 各有結果,後續分析較方便

這個倉庫裡主要體現在覆蓋範圍與流程穩定性,而唔係模型速度本身:可見進度、目前 verifier ID、執行 channel 同耗時,對跑大批提交會實用。它更像一個面向 Agentic 評測、研究復現同內部驗收的基建項目;想測 Office 類代理,尤其想把安全收件、隔離執行、可讀報告放進同一條流水線,這個項目的完成度相當高。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 框架, Mac, Linux, Python, Dataset 數據集, 百度

HumanCLAW 直指 VLM 身體感缺口

當 Vision-Language Models 真正要控制一個會碰撞、會受重力影響的人形身體,表現遠比畫面理解困難。HumanCLAW 把問題拆開來量度,直接揭開 VLM 行動判斷的弱點。

HumanCLAW teaser

畫面睇得明,不等於身體識得郁得啱。HumanCLAW 把 Vision-Language Models(VLMs)放進一個閉環人形行動測試環境,集中量度模型每個瞬間應該做哪個動作,而不是把失敗全數歸咎於低層馬達控制。它屬於評測框架兼基準測試項目,處理的是 VLM 在具身場景中的行動決策能力,到底有沒有足夠「身體感」去完成找路、移動與互動。

呢個設計最值得留意的地方,是它把 action decision-making 與 low-level motor execution 分開。每 0.5 秒,凍結的 VLM 只需要根據第一身視角、指令、技能列表與歷史內容,提出一個 atomic whole-body skill;後面的 verifier、motion generator 同 half-physics simulator 再負責驗證、安全過濾與連續動作執行,令接觸、碰撞、重力等物理後果仍然保留下來,但平衡失誤與動作追蹤誤差會被盡量排除。

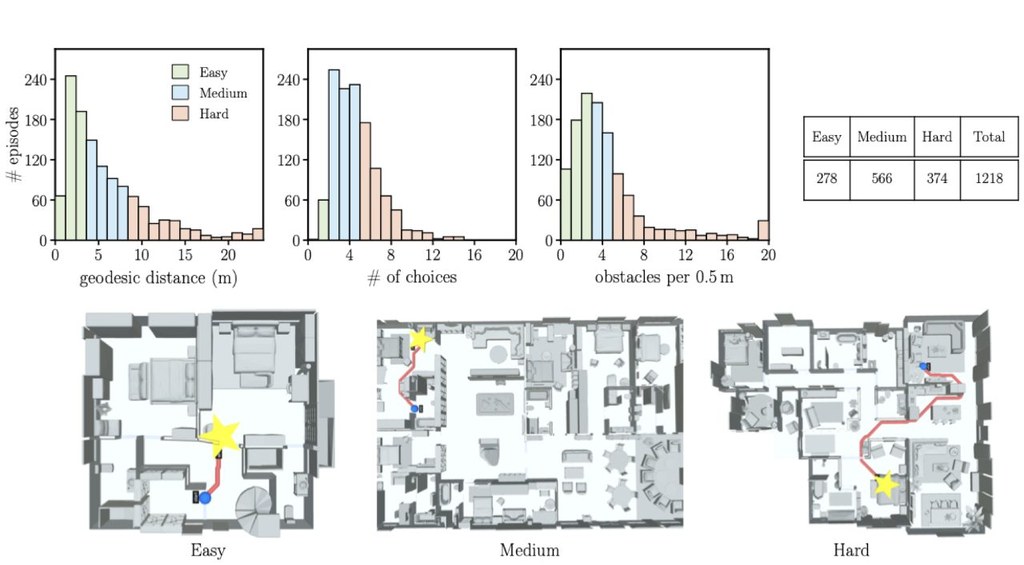
HumanCLAW-Bench 則在這個框架之上提供 1,218 個長時程 find–navigate–interact episodes,覆蓋 41 個室內場景。數字相當直接:九個最先進 VLM 全部未能解決這套基準,最佳成績只有 16.8% success rate,反映問題不在單次辨識,而在模型持續追蹤自身位置、判斷是否到達目標,以及理解自己有沒有撞上環境。

  • 把高層決策同低層動作分離,較易睇清 VLM 真正弱點
  • 保留真實物理後果,唔會因為純符號化環境而高估能力
  • HumanCLAW-Bench 著重長時程、第一身視角、連續互動任務
  • 目前公開資訊顯示程式碼與 benchmark 仍在準備釋出

對研究 embodied AI、Computer-use agents 延伸方向、VLM 評測方法的人來說,呢個項目有參考價值,尤其適合用來檢查模型是否具備 closed-loop spatial action intelligence,而不只是識描述畫面。現階段較大的限制也很清楚:GitHub 儲存庫尚未正式放出 harness、motion generator weights、half-physics simulation environment 與完整評測內容,暫時主要仍是透過 project page、paper 同 leaderboard 理解方法與結果。

項目主頁 · GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, Meta, Dataset 數據集, Skill 技能

MiniMax H3 頂級高清影片生成

MiniMax H3 提供咗一套較完整的影片生成 API。它重點不只是出片,仲包括參考生成同影片編輯控制。

Og image

做影片內容時,最麻煩往往不只是「生成一段片」,而係點樣令角色、鏡頭起承轉合同參考素材保持一致。MiniMax H3 屬於多模態影片模型,處理的正正係呢類控制力需求:除咗 Text-to-Video,亦支援以首幀、尾幀、參考圖片、參考影片同音訊去引導生成結果。

對內容團隊、短片創作者同需要自動化出片流程的開發者而言,呢個項目的吸引力在於輸入方式夠彈性。你可以由一段 prompt 起步,也可以加入第一張或最後一張畫面去約束開場與收尾;當需要保留人物、動作、鏡頭風格、聲線或剪接節奏,則可改用 Reference Generation。

MiniMax Just Dropped a "Seedance Killer" with a Twist
  • 支援 Text-to-Video、First/Last-Frame Image-to-Video、Reference Generation
  • 統一理解 text、image、video、audio,多種素材可混合輸入
  • 輸出最高為 2K,片長 4 至 15 秒,只接受整數秒
  • 參考輸入上限包括最多 9 張圖片、3 段影片、3 段音訊,混合檔案總數上限 12

規格上,MiniMax H3 支援常見長闊比,圖片、影片與音訊都有清晰的格式及大小限制,例如影片可用 H.264/AVC、H.265/HEVC,圖片可用 JPG、PNG、WEBP,音訊則支援 WAV、MP3。音訊不能單獨提交,必須配合圖片或影片一齊使用;而較大的素材更建議用 URL 方式傳入,避免 API request body 超出 64 MB。

現有資料集中在能力範圍、輸入限制同 API 使用方向,能夠幫你快速判斷適唔適合接入工作流。

項目主頁

Categories: MCP, 多模態模型, 視頻模型, API, Video, Image, Audio, 語音, MiniMax

Page 8 of 23
1 6 7 8 9 10 23