HarnessVLN:不訓練也能走的統一導航框架

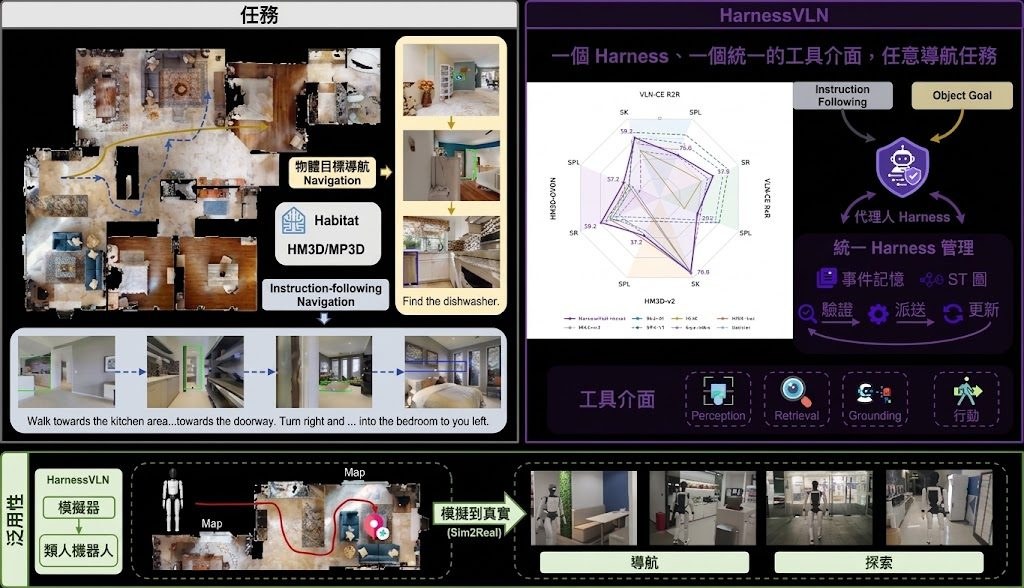
HarnessVLN 把視覺、語言、空間證據交給一套 Agent Harness 統籌,用零訓練方式處理多任務導航,並以層化記憶與時空圖解決長程失敗。

Repository image for AgibotGeneral/harnessvln

Embodied Navigation 過去依賴大規模訓練與任務專用流程,但不同場景的 pipeline 各自為政,難以共享空間證據與錯誤紀錄。HarnessVLN 把這個痛點攤開:現有 training-free 方法雖然借助多模態大語言模型,卻缺乏把「提案」與「空間證據、任務進度、執行失敗」對齊的機制,於是同一個 agent 在長時序任務中容易重複犯錯、難以回收。

作為一個訓練無需更新的 agent harness,HarnessVLN 用統一工具介面串接感知、檢索、定位、導航、恢復與終止,並透過層化事件記憶與持久化時空圖(Spatiotemporal Graph)保留可重用的空間證據與失敗標註,讓跨子目標的經驗真正沉澱。提案不再直接落地,而是先被 Agent Harness 結合幾何可行性與過往失敗做驗證,再分派給工具執行。

在 R2R、RxR、HM3D-v2、HM3D-OVON 等基準上,HarnessVLN 報出 60.8、53.9、76.0、59.3 的 SR%,覆蓋 instruction navigation 與 online exploration 兩種形態,並提供真機 demo 與模擬環境。對機器人團隊、具身 AI 研究者與需要快速驗證導航策略的工程師來說,它提供一個不必從零訓練就能橫向比較的底層框架。

重點摘要

  • 訓練無需更新:以 Agent Harness 統一感知、檢索、定位、導航、恢復與終止工具
  • 層化事件記憶 + 時空圖:把子目標進度與空間證據沉澱為可重用資產
  • 提案先驗證再執行:用幾何可行性與失敗紀錄把 LLM 操作提案過濾一次
  • 覆蓋 R2R、RxR、HM3D-v2、HM3D-OVON 等多項導航基準
  • 同時提供模擬與真機 demo,適合做跨任務導航策略的快速評測

對在意長時序導航穩定性、想避開昂貴 fine-tuning 的團隊,這套來自南京大學、清華大學與 AGIBOT 合作的方案,給出一條「不訓練也能走得更穩」的工程化路線。
項目主頁 · GitHub · Paper

Categories: 開源, 南京大學, 清華大學, Agentic, 多模態模型, 模型訓練, Robotic, 框架, 工具, Dataset 數據集

LynnReal-Omni 把十幾種影片任務塞進一個 32B 模型

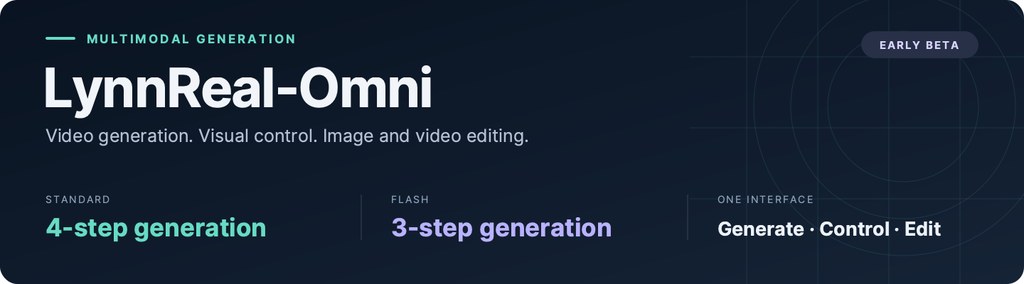
一個 32B 多模態擴散 Transformer,同時做文字生影片、圖生影片、動作控制、風格遷移、影片修復同長影片串流。Flash 版本更可喺單張 H100 上 377 毫秒出 22 帧 540p 短片。

LynnReal-Omni — Standard four-step and Flash three-step multimodal generation

LynnReal-Omni 想解決嘅,係影片生成工具鏈最煩嘅一件事:每加一個任務(動作控制、參考影像、風格遷移、編輯、修復)就要疊多一個模型或多一套 pipeline。作者選擇用一個 32B 共享多模態擴散 Transformer(跟 MiniMax H3 架構)一次過承載文字生影片、圖生影片、人體與手部姿勢控制、結構控制、omni-reference、風格遷移、影片編輯、退化影片修復,以至串流式長影片生成,仲可以接駁外觀參考、可編輯 3D render、遊戲錄影等異質輸入,等 Agent 可以喺同一個模型內組合視覺條件。

對比同類做法,最大差異係「統一框架」而非「任務專用模型」。每個源帧獨立編輯再組裝成無聲 24fps 影片,每帧只需四次 DiT forward,120 帧即 480 次 forward。輸入限制清楚:24fps、寬高需為 32 倍數、目前只支援 768p(1344×768 起手)。獨立逐帧編輯會帶來亮度或形狀嘅帧間抖動,作者亦坦白標示為已知限制。

對短片創作者、遊戲或 3D 團隊、Agent 開發者來講,好處係少咗一套模型接駁嘅工程成本;Agent 可以直接用外觀參考同 3D render 嚟組裝條件。Flash 版本(27B、三步生成、輕量 VAE decoder)將單張 H100 上 22 帧 540p 由 843 毫秒壓到 377 毫秒,為實時或互動應用鋪路。

項目已提供 ComfyUI workflow 涵蓋 t2v、i2v、r2v、pose2v、v2v 幾個入口,但作者明言仲係早期 beta,質量、兼容性同 bug 仍然存在,訓練代碼、部分訓練數據同更高效 DiT 預計稍後釋出。打算用佢做關鍵流程嘅團隊,宜先以小批量預覽(--indices 0,24,48 --keep-clips)確認穩定性再評估是否引入生產。

重點摘要:
– 一個 32B DiT 模型覆蓋十幾種影片任務,Agent 可直接組合異質視覺條件
– 每源帧四次 DiT forward,120 帧共 480 次;輸入限 24fps、寬高需 32 倍數、768p
– Flash 版本用 27B 加輕量 VAE,單張 H100 上 22 帧 540p 暖機生成耗 377 毫秒
– 獨立逐帧編輯會產生帧間亮度與形狀抖動,屬已知限制
– ComfyUI 支援 t2v、i2v、r2v、pose2v、v2v,目前屬早期 beta,訓練代碼尚未開源

GitHub · 模型

Categories: 開源, ComfyUI, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Image, 框架, 工具, Content Creator, 3D, MiniMax

LLaDA-UI 首個開源擴散 GUI Agent 16.7B MoE 力壓 Qwen3-VL

Inclusion AI 把 block-wise 擴散語言模型搬進螢幕操作場景,推出約 16.7B 參數的 LLaDA-UI,在六個 GUI 基準上贏 Qwen2.5-VL-7B,部分項目更超越 Qwen3-VL-8B。

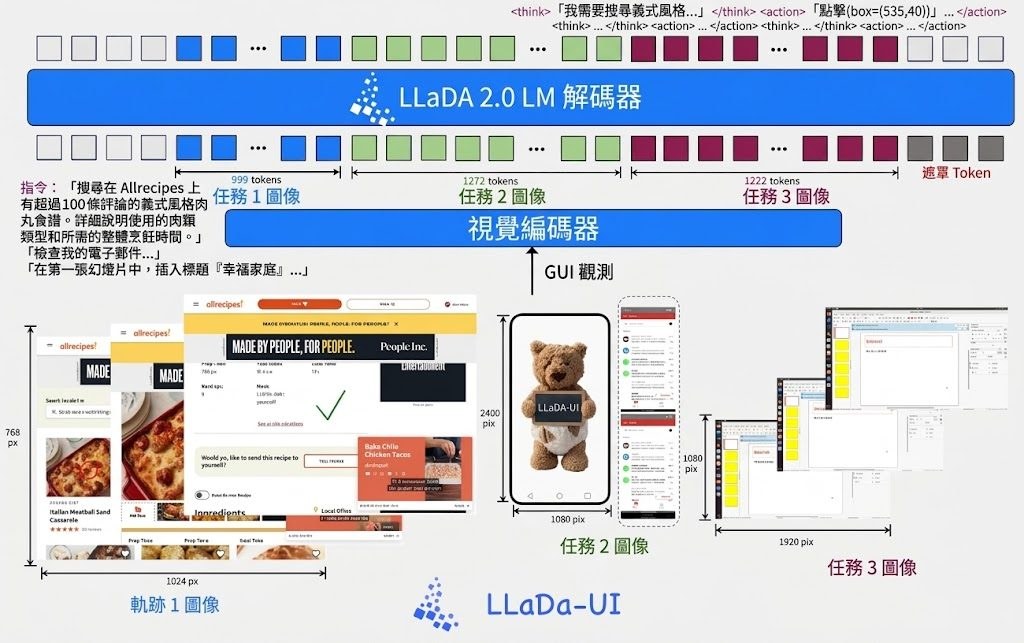
LLaDA-UI GUI-agent benchmark comparison and animated qualitative diffusion decoding

一般講 GUI Agent,都預設底層係自回歸 VLM;Inclusion AI 同螞蟻集團 Venus Team、西湖大學合作推出的 LLaDA-UI,偏偏選擇用 block-wise 擴散語言模型做骨幹,直接從遮罩 token 逐塊 denoise 出推理同動作,配合原生動態解像度視覺編碼器,覆蓋手機、桌面、網頁同 grounding 任務。模型全段約 16.7B 參數嘅 MoE 架構,訓練分兩階段,先做大規模多模態預訓練對齊 LLaDA2.0-mini-base,再做 GUI 監督微調。

喺 ScreenSpot-Pro、AndroidWorld、MobileWorld、WebVoyager 等六個基準上,LLaDA-UI 全部贏過 Qwen2.5-VL-7B,其中 ScreenSpot-Pro 52.9、AndroidWorld 53.5、WebVoyager 56.9,喺呢四項仲壓過 Qwen3-VL-8B;官方同時提到 API 速度最高有 8.95 倍 mean speedup。佢仲針對擴散解碼做咗一輪分析,包括動作合法性、軌跡長度、EOS 處理、denoising 步數同 block size 對表現嘅影響。

如果你做開手機或桌面自動化、需要 GUI Agent 處理長步驟任務又想避開自回歸延遲,LLaDA-UI 提供咗一套唔同嘅技術路線選擇;研究擴散語言模型落地嘅人,亦可以直接拎佢嘅 block-parallel 解碼行為做案例。

重點摘要

  • 約 16.7B 參數 MoE 擴散 GUI Agent,由 Inclusion AI、Ant Group Venus Team 與西湖大學共同發表
  • 骨幹為 LLaDA2.0-mini-base 配合 SigLIP 初始化嘅動態解像度 ViT
  • 六個 GUI 基準全部超越 Qwen2.5-VL-7B,ScreenSpot-Pro 等四項高過 Qwen3-VL-8B
  • 訓練涵蓋 100+ 中文與 70+ 英文手機 App,覆蓋 mobile、desktop、web、grounding
  • 附帶針對 block-wise 擴散解碼嘅分析,包括結構化動作有效性、EOS、denoising 步數等

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, UI/UX

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bashframes,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, , Anthropic, 動畫, Dataset 數據集

PhysBrain 1.5 統一三項能力,機器人世界模型走進單一詞彙表

PhysBrain 1.5 把語言、動作軌跡、未來畫面全部折成離散詞元,用同一個自迴歸骨幹同時回答、理解與預測。它基於 Qwen3-VL 構建,2B 與 8B 兩個版本已開源。

DeepCybo · Zhongguancun Academy · Zhongguancun Institute of Artificial Intelligence

PhysBrain 1.5 把機器人的「看懂」、「出手」、「預測下一步畫面」三件事,塞進同一個自迴歸模型裡。對做具身智能的人而言,最直接的體感差異是:不用再為理解、動作、預測各掛一個任務頭(task-specific head),全部以離散詞元(discrete tokens)在同一個 next-token prediction 目標下聯合學習。等於讓模型在推理時,能在語句、空間輸出、末端執行器軌跡、未來 RGB 影像之間自由切換。

對比同類路線,許多開源具身模型要嘛只做視覺語言理解,要嘛只做動作生成;PhysBrain 1.5 則強調三者共享詞彙表(vocabulary),並透過 ActionPiece 詞元把不同機械臂、控制配置統一在一個動作碼本(codebook)下。預訓練以人類互動影片為主,監督微調混入真人示教、真機軌跡與模擬經驗,等於把世界模型與策略模型壓進同一副骨架。

2B 與 8B 的權重已上傳 Hugging Face,開發者可透過官方評測工具 PhysBrainEvalKit 對齊 28 個具身基準測試。PhysBrain 1.5-8B 整體得分 72.5,在 14 個基準上排開源第一、10 個排第二。對機器人團隊或在做 VLA、世界模型研究的人,這套統一詞表的做法,是現時少數能把三者一齊端出來的開源選擇。

重點摘要:

  • 三能力統一:理解、動作生成、未來狀態預測共享同一個自迴歸骨幹與 next-token 目標,無需任務專屬輸出頭。
  • 基於 Qwen3-VL:以 Qwen3-VL 為起點,把語言、空間、軌跡與視覺詞元納入同一詞彙表。
  • 2B 與 8B 開源:權重已釋出至 Hugging Face,2B 適合邊緣部署,8B 瞄準基準測試表現。
  • 基準表現:PhysBrain 1.5-8B 在 28 個具身基準取得 72.5 整體分,14 項開源第一、10 項第二。
  • 配套工具:PhysBrainEvalKit 評測工具與官方 Demo 已上線,方便重現結果與部署測試。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, Image, VLA, Robotic, 工具

OST:可撤回串流推理的「過早下結論」

香港大學與香港科大(廣州)團隊開源 Omni-Streaming Thinking(OST)針對解決串流影音推理中視覺先到、聲音後到的錯位問題。

Repository image for EnjunDu/OST

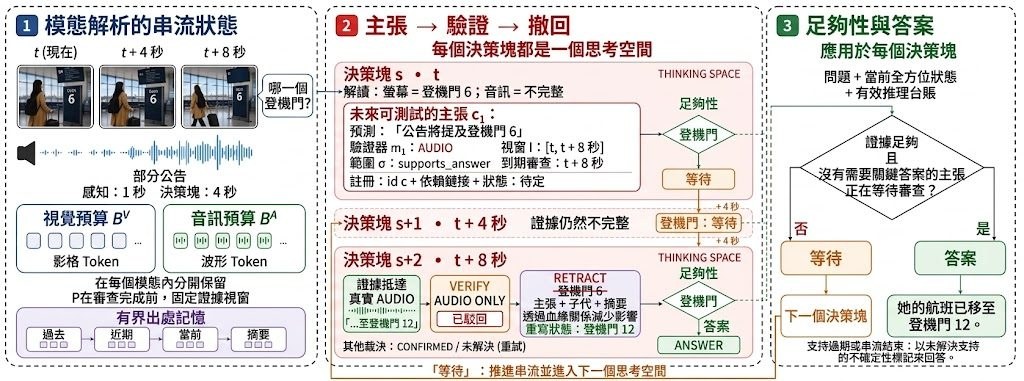
看串流影片做即時推理,最常見的卡位是視覺線索先到位、聲音事件卻還在展開——模型若把視覺猜測當成事實寫進記憶,後續聲音即使推翻它,舊結論仍可能一路延續下去。OST 正是針對這個「提早跨模態承諾」的失敗模式設計:每一個未解的詮釋都被記成一條 claim,附帶預期事件、指定驗證模態、證據到期時段,以及依賴它的狀態;期限一到就用對應模態的證據覆核,被推翻時連帶下修相關狀態,再由引導式解碼產出修正後的回應。

OST 以凍結的骨幹模型為基礎,所有新增的部分都是 adapter、soft prompt 或輕量 head,骨幹參數完全不會被改動。聲音與視覺各自有獨立的保留緩衝區與配額,避免高密度的視覺 token 把聲音擠出記憶;舊狀態以四向折疊收進金字塔結構,讓推理上下文維持在有界範圍內。回答閘門則會延遲輸出,直到所有影響答案的 claim 都完成覆核。

適合研究串流多模態推理、想重播或審視 claim–verify–retract 循環的團隊,會比較容易從中受益。程式碼只涵蓋推論與執行記錄,不包含訓練、評測 harness 或診斷 benchmark。

重點摘要:

  • 類型:串流影音推理的推論實作,骨幹凍結,僅加掛 adapter 與 head。
  • 核心機制:claim–verify–retract,未確認詮釋附帶驗證模態與到期時段。
  • 記憶設計:聲音與視覺分開配額,舊狀態四向折疊維持上下文有界。
  • 輸出控制:answer gate 會等到關鍵 claim 覆核完成才放行。
  • 範圍限制:僅推論,不含訓練、評測 harness 與 OST-DiagBench 資料集。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港大學, 香港科技大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio, 香港, Dataset 數據集

YuE2 用樂譜做中介 把 AI 寫歌變成可改寫的工序

由香港科大 M·A·P 團隊推出的 YuE2,把歌詞與風格提示先轉成旋律與和弦樂譜,再渲染成完整歌曲。比起直接端出成品的做法,這條路線讓編曲、翻唱與代理編輯都變得可介入。

YuE

AI 寫歌工具多數只給你一首成品,YuE2 想處理的是另一個問題:怎樣讓生成過程本身可被人讀懂和修改。M·A·P 與港科大的團隊把流程拆成兩步,先用歌詞加風格提示寫出一份旋律與和弦計劃,再用同一個模型把樂譜變成帶人聲與伴奏的完整歌曲。

Melody 和 chord 不再藏在黑盒裡,而是可以預覽、試播,甚至交給人或 AI 代理去修改。這意味著同一個 checkpoint 可以同時做三件事:從零寫歌、把一段錄音轉成新風格的翻唱、以及透過對話逐步修編曲與歌詞。零樣本翻唱與代理式編輯不再需要切換不同模型。

當多數音樂生成模型只能交出一條「不能再拆」的音檔時,YuE2 走出了一條比較少見的路:它先把歌詞和風格提示轉成一份明確的樂譜與和弦藍圖,再用那份藍圖去唱出完整歌曲。等於把創作流程切成「規劃」和「演奏」兩段,而那份中間的樂譜本身就是可讀、可播、可改的物件,創作者或 AI 代理都能直接在上面動手。

开源翻唱音乐模型-YuE2:你的专业程度=模型上限,没有suno的各种限制。演示《Butterfly》。
YuE2 in ComfyUI: AI Music with an Editable Piano Roll

衡量歌曲品質的 WildSongBench 上,YuE2 best-of-8 取得 6.9632 平均分,是目前該榜觀察到的最高均值,並在多個面向與 Suno v5/v6 拉成均勢。它不只追求像 Suno,而是把 Suno 做不到的那一步:讓成品背後的樂譜可被檢視與修改,當作核心能力。

獨立音樂人、編曲助理、以及想把 AI 寫歌串進更長工作流的開發者,都是比較直接的使用者。代理式編輯對於要快速試不同編曲方向、需要保留人聲或旋律骨幹再重做風格的場景特別有用。

重點摘要

  • 先樂譜後音效:歌詞與風格提示先產出 melody 與 chord 計劃,再渲染成完整歌曲
  • WildSongBench 最佳均值:YuE2 best-of-8 取得 6.9632 分,與 Suno v5/v6 在多個面向拉成均勢
  • White-box 控制:樂譜可預覽、可試播、可交由人或代理修改
  • 零樣本翻唱:同一個 checkpoint 支援把轉錄樂譜換成新風格詮釋
  • 代理式編輯:可用對話方式逐步修編曲、歌詞與編排

入門方面,項目提供 Hugging Face 上的 YuE2-3B 權重、Demos 頁面,以及 Discord 社群。舊版 YuE 的程式碼與授權保留在 YuE-v1 分支,方便比對兩代做法差異。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 多模態模型, 工具, 音樂, 廣東話

MaP-WAM:把記憶變成計劃

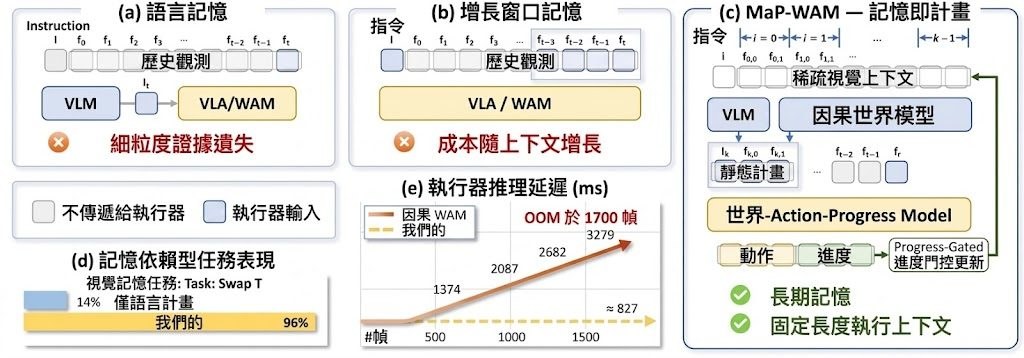
MaP-WAM 將機械臂長任務拆成「記憶 → 計劃 → 行動」三步,先保留稀疏視覺證據,再壓成固定長度的計劃執行,讓 executor 不再因歷史增長而越來越慢。

Repository image for aipixel/MaP-WAM

做過長任務的 robot policy 都知道,當動作序列拉長,模型要嘛靠語言摘要回憶過去,要嘛硬把一堆畫面塞進上下文,結果前者丟失精確視覺證據,後者則隨步數累積越來越慢。MaP-WAM 走的第三條路:把記憶視為「規劃時的證據」,而非「執行時的負擔」。它由哈爾濱工業大學、南洋理工大學及山東大學等團隊共同提出,屬於 VLA 框架與 World-Action Model 思路的延伸。

主流機器人策略通常採用馬可夫公式,但許多複雜的現實世界操縱任務本質上是非馬可夫的,需要超越當前觀察的長視野記憶。MaP-WAM 的核心分三層:每完成一段任務,便把該段的語言指令與少量真實執行幀打包成 episodic memory;之後由視覺語言模型生成下一段的語言計劃,並由因果世界模型補出對應的視覺引導;最後由 World-Action-Progress(WAP)模型在同一上下文內同時輸出動作 chunk 與進度,再以 plan-observation alignment 校正遞迴估計、以 progress-gated transitions 決定何時更新記憶並請求下一段計劃。由於已完成片段的 episodic 證據與當前計劃都可被 cache,executor 的上下文長度保持固定。

在 RMBench 上達到 83.3% 成功率、真機實驗約 78.0%,同時 executor 維持近似常數的 per-chunk 延遲。在三個長任務記憶方案中,這套設計拿來對比的恰是「語言記憶丟視覺證據」與「滑動視窗記憶吃 GPU」這兩個老毛病,並以固定上下文的方式直接拆解效率與覆蓋率的取捨。

適合關注機器人長任務、World-Action Model、VLA 框架的研究團隊與工程團隊參考。模型 checkpoint 標示為 Coming Soon,現階段只能讀 paper 與項目頁理解思路。

重點摘要:

  • Memory-as-Plans:將長任務記憶拆成「已完成片段的稀疏視覺證據 + 語言計劃」,而非把所有歷史塞回 executor。
  • WAP 模型:在同一上下文內同時輸出動作 chunk 與任務進度,並透過 plan-observation alignment 校正遞迴估計。
  • 固定上下文執行:已完成片段與當前計劃皆可 cache,executor 上下文長度不再隨歷史增長。
  • 對比清晰:直接挑戰語言記憶丟失視覺證據、滑動視窗吃 GPU 記憶體兩種主流做法。
  • 現況限制:訓練與推理程式碼、模型 checkpoint 均未釋出,目前僅有 paper 與項目頁可參考。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, VLA, World-Action Model, Robotic, 框架

騰訊混元開源 AuK:1.5B 模型統一語音生成與編輯

騰訊混元把零樣本 TTS、語音編輯、分離與增強收進同一個自然語言指令介面,並同步釋出追求速度的蒸餾版本 AuK-Flash。

AuK performance across speech generation, editing, enhancement, and separation benchmarks

語音模型一直存在一個尷尬:零樣本合成、語音克隆、音色替換、分離、降噪往往是幾套獨立系統,要串起來就得堆 pipeline。騰訊 Hunyuan 開源的 AuK 想打破這個分工,以 1.5B 參數的基礎模型為核心,讓一句自然語言指令直接對應到編輯後或生成的音訊。

AuK 由三部分組成:負責語義條件的多模態語言模型、提供聲學潛在空間的 50 Hz VAE,以及一個混合 rectified-flow Transformer,用雙流 MMDiT 塊融合兩種條件後再做單流 DiT 生成。訓練數據規模相當可觀——約 30.3 億條指令-音訊配對,加上約 195 萬小時的有效監督,覆蓋五大任務族:語音生成、內容編輯、增強與分離、副語言資訊編輯、聲學編輯。

同步釋出的 AuK-Flash 走速度路線:透過一致性初始化加上任務路由的 Decoupled DMD 蒸餾,做到 NFE=4、無 CFG 的 4 步推論,官方指在匹配條件下對比完整 AuK 有約 4.5 倍 wall-clock 加速,質量接近教師模型。這個分層策略對需要即時語音生成的應用場景(如對話 agent、實時配音)有直接意義。

部署層面,官方同時提供 Hugging Face Space、ModelScope Space、Gradio 互動介面、ComfyUI 節點、Python API,以及 uv 和 Conda 兩種依賴管理方式,並已獲 SGLang-Omni Day 0 支援。對於本地資源有限的團隊,AuK-Flash 配合 SGLang-Omni 是較合理的切入點;如果追求最高質量、且不在意推論延遲,則可選 AuK Base,並透過可配置的 NFE 與 CFG 做品質/速度取捨。

重點摘要:

  • 1.5B 統一模型:用自然語言指令統一零樣本 TTS、語音編輯、分離、增強、副語言與聲學編輯。
  • 三模組架構:多模態語言模型 + 50 Hz 音訊 VAE + 混合 rectified-flow Transformer,採雙流 MMDiT 接單流 DiT。
  • AuK-Flash 蒸餾:一致性初始化 + 任務路由 DMD,4 步推論無需 CFG,wall-clock 加速約 4.5 倍。
  • 後訓練策略:語音生成用獎勵強化學習,開放式編輯用人類偏好優化。
  • 部署支援完整:Hugging Face、ModelScope、Gradio、ComfyUI、Python API、SGLang-Omni 齊備。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, 文字轉語音, ComfyUI, Agentic, 模型, 多模態模型, 模型訓練, API, Audio, Python, 語音

RoboSPA 用 280 個難度變體幫你壓力測試

RoboSPA 是浙江大學團隊針對 Vision-Language-Action 模型推出的診斷式基準,透過逐步拉高空間歧義與程序步數,揭開現有機器人策略在精準定位與長程規劃上的短板。

Repository image for fanzhenxuan/RoboSPA

當 VLA(Vision-Language-Action)模型在乾淨、短任務的環境中跑出不錯的成功率,要怎樣才知道它是真正「理解」指令,還是只是剛好蒙對?RoboSPA 給出的答案是:把場景弄得更亂、把步驟拉得更長,然後看模型從第幾關開始崩潰。這是一個基準與數據集項目,建基於 RoboTwin 2.0 模擬框架(SAPIEN + CuRobo),由浙江大學主導,已獲 EMNLP 2026 收錄。

它把 56 個基礎任務各衍生出五個難度級別(L1–L5),共 280 個變體,覆蓋五種機械臂實體(Franka、Piper、UR5、Aloha-AgileX、ARX-X5),總計 527K 條軌跡、約 108M 步數、997 小時互動影片。Spatial 維度持續加入外觀相近的候選物,Procedural 維度則逐步疊加子目標、執行順序、重複次數與記憶需求。

與只看最終二元成敗的傳統做法相比,RoboSPA 額外提供兩個診斷指標:空間任務用 ONTA(Object-Normalized Target Accuracy) 衡量模型能否在「看起來都像」的物件中選對目標,並以 chance-corrected 方式扣掉隨機命中;程序任務則用 Progress Score(PS) 計算實際完成的子目標比例,反映模型在中途卡住或跳步的真實狀況。

適合機器人實驗室、VLA 模型開發者,以及需要評估策略可擴展性的團隊。支援自帶策略接入,數據與代碼均已公開。研究端在多個代表性 VLA 模型上的結果顯示,空間關係、低階精細動作與長程記憶仍然是明顯瓶頸。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, Video, VLA, 框架, 中國, Dataset 數據集

Page 1 of 23
1 2 3 23