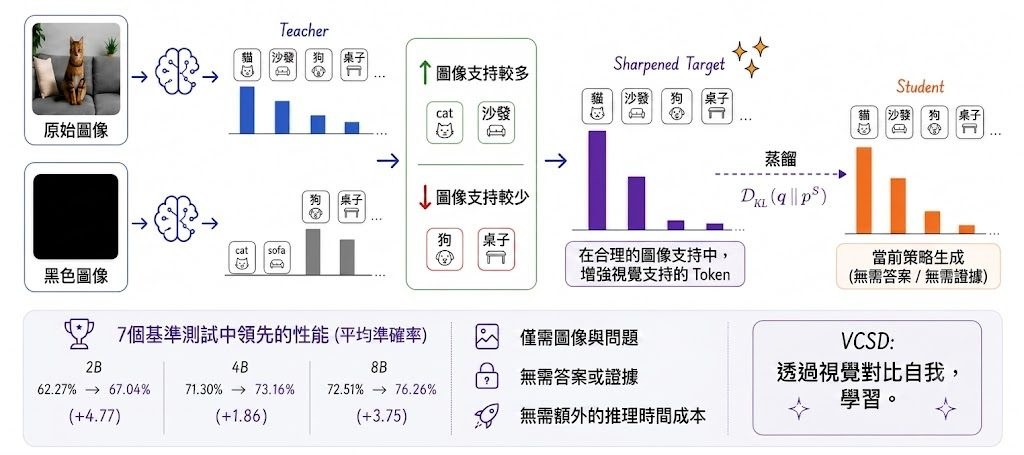
VCSD 點樣逼可以 Vision-Language Models 真係睇圖

同一條問題配原圖同抹走內容嘅控制輸入,VCSD用兩次預測差異教模型分清邊啲答案真係來自視覺訊息。它瞄準嘅唔係加大模型,而係減少模型「冇睇圖都答到」嘅錯位。

Cover Figure overview

不少 Vision-Language Models 會表面上處理圖片,實際卻沿住語言慣性作答。VCSD 屬於模型訓練方法,針對嘅正正係呢種「答案似乎合理,但未必真係由圖像帶動」嘅問題:它讓同一個 EMA teacher 分別看原圖同內容被抹走嘅 control input,再用兩者對每個 response token 嘅分佈差異,提煉出更依賴視覺內容嘅學習目標。

現有 on-policy self-distillation(OPSD)多數靠 privileged answers 或 visual evidence 製造 teacher 比 student 更強嘅訊號,VCSD反過來把 image-content removal 變成非對稱來源。做法唔係直接獎勵某幾個字,而係用原圖分佈 p_hi 同控制輸入分佈 p_ctrl 嘅 log-probability 差,配合 α 調整對比強度,再用 β-plausibility mask 限制只喺 teacher 原本已視為可信嘅 token 集合內重新分配機率;README 亦講明 β 設成 0.0 會令訓練崩潰,代表呢個護欄唔係裝飾,而係方法成立嘅關鍵。

項目目前仍然係 work in progress,代碼、設定同文件都可能再改。倉庫已放出訓練資料格式線索,例如 train.parquet 需要 prompt 同 image 欄位,train_answer.parquetval_answer.parquet 用作 answer-conditioned validation;訓練則建基於繼承自 verl 嘅 GRPO/PPO 流程,VCSD 相關改動集中喺 verl/trainer/ppo/vcsd.pyverl/workers/actor/dp_actor.py 同 actor 設定檔,表示它比較似可插入現有 RL 訓練管線嘅附加目標,而唔係一套獨立框架。

  • 核心取向係用 visual contrast 代替 privileged answers 或 visual evidence
  • 學生模型學習嘅係 full-vocab KL 目標,唔係逐 token 手動加權
  • control input 可設成 black、degrade 或 noimg,用來測試答案有幾多真係靠圖像
  • 已公開結果顯示,VCSD 在 ViRL39K 上對 Qwen3-VL 與 Qwen3.5 系列均比 matched OPSD 更好

從已公開數字看,Qwen3-VL 在七個 benchmark aggregate 上由 2B 的 62.27 升到 67.04、4B 由 71.30 升到 73.16、8B 由 72.51 升到 76.26,方向相當清楚:它想改善嘅唔係推理時計算量,而係訓練期間點樣把「圖片真正提供咗乜嘢」變成更乾淨嘅監督訊號。對已經有 Vision-Language Models RL 訓練流程、又想減少外部 teacher 與額外標註依賴嘅研究團隊,呢個項目值得跟進;不過現階段仍要接受文件未齊、介面可能變動,以及結果主要來自論文與項目頁面披露。
項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Image, VLA, Robotic, 框架, Dataset 數據集

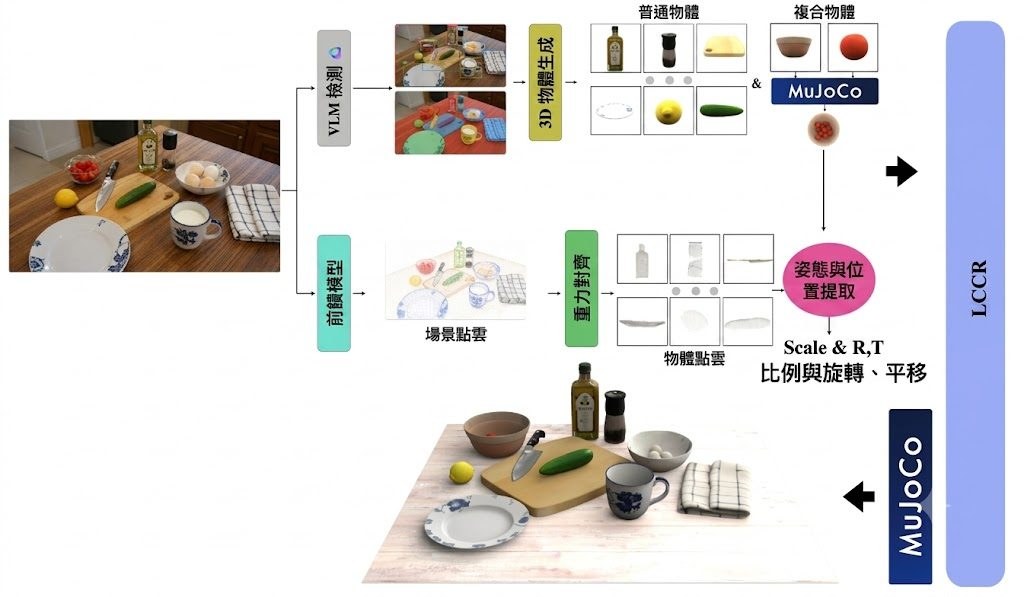
TableVerse 想補上機械臂數據缺口

想訓練更能適應雜亂桌面嘅機械臂,最缺的往往唔係模型,而係夠真實又夠大量嘅場景數據。TableVerse 用 Real2Sim 把網上圖片整理成可模擬環境,方向相當清晰。

TableVerse main figure

機械臂要學會喺凌亂桌面執放物件,卡位通常唔在控制器,而在訓練資料太乾淨、太想像化。TableVerse 屬於Dataset 數據集加上資料生成流程,重點不是再用文字幻想場景,而是用 Real2Sim 從網上真實圖片重建可放進模擬器的桌面配置,直接處理泛化操作最缺的場景真實感。

現有做法常見兩條路:text-to-layout hallucination,或者較簡化的 procedural generation。作者批評前者容易做出物理上唔合理的擺位,後者又捉唔到人類日常環境常見的密集雜物;因此 TableVerse 改成 deterministic reconstruction,從非結構化的 in-the-wild image data 還原具備 metric scales、authentic topologies 同 verified mechanical stability 的場景,取向明顯偏向可落地訓練,而唔係只追求合成速度。

項目現時最重要的成果是 TableVerse-100K,公開了 100,000 個 physically consistent 的桌面環境,並配對 interactive manipulation trajectories。網站資料顯示,它還接上自動化 task-conditioned trajectory generation,先由 MLLM 根據場景視角提出 object-to-target 配對,再生成 collision-free pick-and-place demonstrations,令數據不只得靜態場景,亦包含可直接餵給操作策略學習的示範。

  • 以真實圖片重建桌面,而非只靠生成式佈局
  • 提供 100K 場景與 pick-and-place 軌跡,規模夠大
  • 強調物理一致性、機械穩定性與模擬可用性
  • 適合做 generalizable manipulation 與桌面操作研究

部署角度上,這個 GitHub 儲存庫目前更接近論文與資料入口,主要連到 arXiv、HuggingFace dataset 同項目網站,未見完整訓練或評測程式公開。換句話說,研究團隊現階段較可能把它理解為高品質資料來源與方法參考,而不是即裝即跑的機械臂框架;對做 robotic manipulation、模擬訓練數據建構,或者研究 Real2Sim 流程的人,參考價值很高。

項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, 多模態模型, Image, Robotic, Dataset 數據集

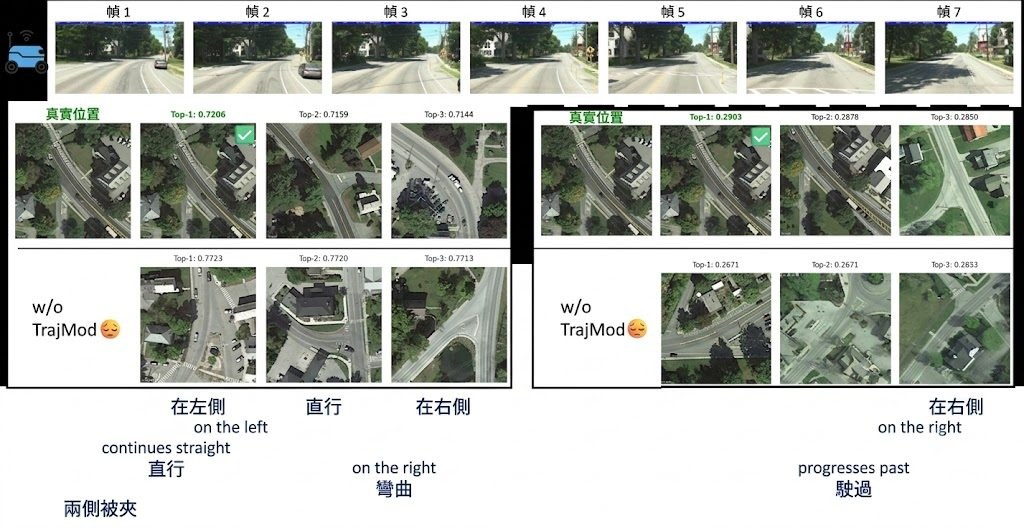
TrajLoc 把路線描述對準衛星圖

單張街景未必足夠判斷位置,TrajLoc改為沿住整段路線做比對。影片、文字敘述,甚至兩者一齊用,都可以指向同一塊衛星瓦片。

A trajectory can be queried as dense video or as abstract language — both retrieve the same satellite tile.

只靠一張街景相去配對衛星圖,遇到轉彎、路口相似、視角受限時好容易失手;TrajLoc改為追蹤整段移動路線,將街景影片、自然語言路線描述,或者兩者結合後對應到帶地理標記的衛星瓦片。它屬於跨視角 geo-localization 模型連同 benchmark 項目,處理的是「把連續路徑準確放回地圖」這個問題。

現有 cross-view 資料多數停留在 single-image、video-only 或 text-only 範式,作者認為這樣會拆散同一條路線入面本來互相補強的時序線索與語意線索,因此一併推出 SeqGeo-VL。呢個 benchmark 收錄 38,863 組對齊的 video-text-satellite triplets,並有 91.8% human verification pass rate,重點不是再加大資料量,而是把 sequential 同 linguistic 兩種證據放入同一任務。

TrajLoc沒有另起一套龐大時序架構,而是由 pretrained CLIP ViT-L/14 延伸成 video、text 同 satellite encoders,再用 co-training curriculum 將三種查詢模式放入同一個表示空間。作者另外加入 TrajMod,將路線幾何資訊 tau={(Δx_i, Δy_i, θ_i)} 轉成 FiLM 的 scale/shift 參數,直接調節 query embedding;做法比單靠提示詞更明確,亦保留 frozen encoders 的可重用性。

  • 支援 video、plain language、video+text 三種查詢方式
  • SeqGeo-VL 是首個同時包含 sequential 與 linguistic cross-view benchmark
  • TrajMod 只用 waypoint offsets 與 headings,不靠 map 或 POI metadata
  • 項目提供 agent-ready tool interface、persistent Python API 同 JSON CLI

從示範與說明看,TrajLoc的定位很清楚:它不是通用多模態聊天模型,而是給 spatial reasoning、戶外機械人、導航研究同 multimodal agents 調用的專門工具。225 ms 的示例檢索速度對互動式流程有吸引力,但目前公開資訊主要集中在 benchmark 與檢索能力,部署前仍要留意資料覆蓋範圍、地區泛化,以及自己的工作流是否真有影片或路線文本可供查詢。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, Embedding, 多模態模型, 模型訓練, Qwen, API, Video, Image, Python, Dataset 數據集

SeededGrasp 用自然語言指揮機械人精準抓取雜亂物件

面對一堆擺得亂的物件,只用一句文字指令就能幫機械人揀中目標。SeededGrasp把語意理解同抓取動作拆開處理,令多種夾爪更易落地。

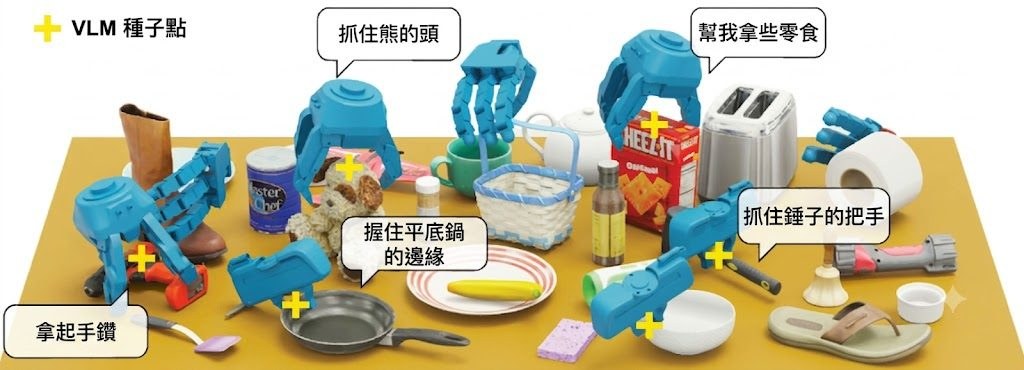
SeededGrasp: Language-Guided Grasping in Complex Scenes with Multiple Embodiments teaser figure

當桌面堆滿不同物件,機械人要聽得明「拎紅色杯旁邊嗰支筆」這類指令,難處不只在辨認物件,仲要同時算準 3D 空間位置同抓取角度。SeededGrasp 針對的正是這類語言引導抓取場景,重點不是端到端硬推整個動作,而是先找對目標,再生成穩定抓取姿態。

它的做法相當清晰:先用預訓練 Vision-Language Model(VLM)把文字指令轉成影像中的 2D 種子點,再投影到 3D 點雲,交給輕量的 flow-matching grasp model 產生 6DOF 抓取姿態。這種拆分方式把高層語意判斷同低層幾何執行分開,減少重新訓練整個系統的成本,也較容易支援多種 embodiment。

相比直接由 VLM 預測抓取,SeededGrasp 保留語言理解的直觀操作,同時補回空間推理不足;相比把 VLM 同抓取模型一併訓練,它對語言標註資料與算力的需求更克制。團隊亦公開多 embodiment 桌面抓取數據集,包含超過 2.56M 個 cluttered scenes 抓取姿態,涵蓋 Franka Panda、Allegro Hand 同 Robotiq 3-Finger。

  • 用簡單文字指令指定目標,適合雜亂桌面抓取情境
  • 以 2D 種子點連接 VLM 與 3D 抓取生成,降低端到端訓練負擔
  • 支援多種 embodiment,不限單一夾爪或手型
  • 公開 2.56M grasp dataset,補足多 embodiment 訓練資源
  • 模擬成功率達 72%,真實環境抓取實驗達 78%

對機械人操作、語言介面同 grasp planning 有興趣的讀者,會較容易感受到這個項目的價值:它沒有把所有問題塞進同一個大模型,而是用較節制的架構處理語意與幾何之間的落差。現階段重點仍在桌面雜亂場景抓取,但它已經展示出多 embodiment 擴展同資料效率上的實用方向。

項目主頁 · Paper

Categories: 視覺模型, 多模態模型, 模型訓練, Google, Robotic, 框架, 3D, Dataset 數據集

ActiveVision 點出視覺推理真空帶

望一眼答題的多模態模型,在 ActiveVision 幾乎集體失靈。這個 benchmark 把「要一路觀察先答到」的能力,拆成更貼近人類解題節奏的測試。

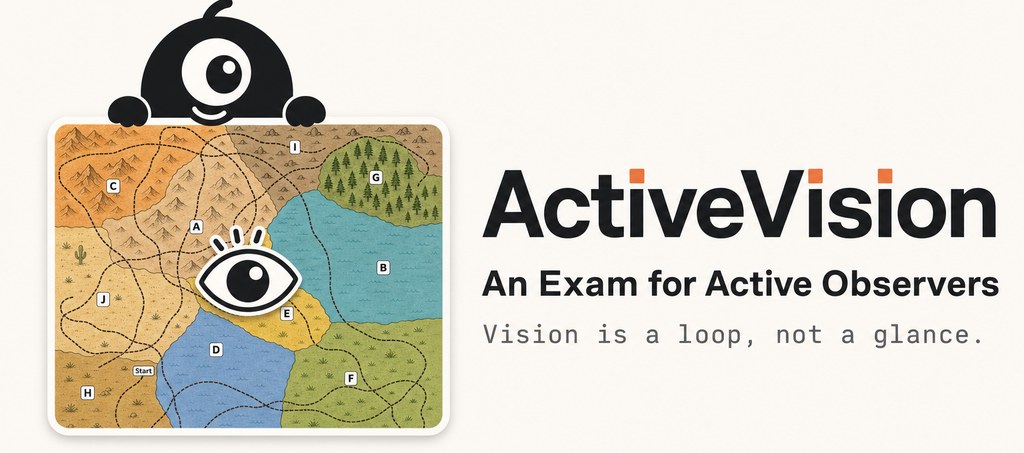
ActiveVision — An Exam for Active Observers. Vision is a loop, not a glance.

不少視覺題目唔係靠一眼辨認,而係要沿住線追、逐區域數、一步步核對先答得到;ActiveVision 正正針對呢種落差而來。作為一個 benchmark,它集中測試 iterative visual reasoning,處理的是模型看得到畫面,但未必能持續整理觀察過程的問題。

現有多模態模型常見做法是對單張圖作一次性判讀,再配合 chain-of-thought 直接作答;作者認為這種 single-glance 範式,對需要反覆掃描、追蹤順序與維持中間狀態的題型特別吃力。ActiveVision 因此設計了 17 個任務,並用 deterministic program 生成場景,再以 photorealistic 方式重繪,令畫面自然之餘仍保留可驗證結構。

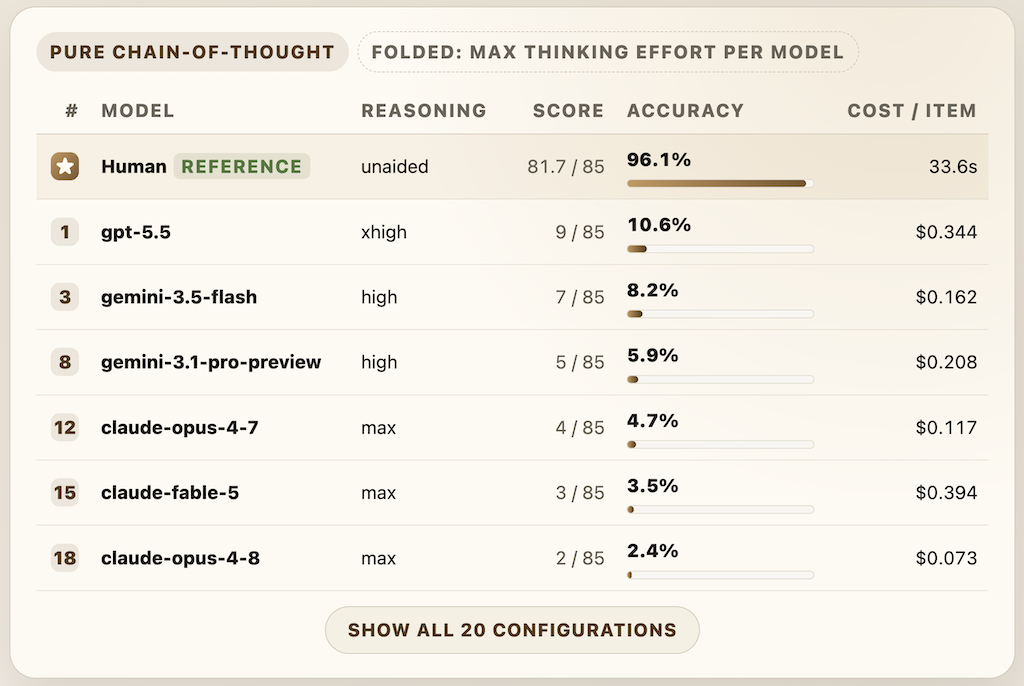
數字相當直接:人類表現為 96.1%,前沿模型在官方無工具評測下最高約 10.6%,差距接近 9 倍。網站亦列出 agent 版本的 tool-use ablation,像 Claude Code 與 Codex 接入工具後,分數明顯高過純 chain-of-thought,表示問題未必只是「看不懂圖」,而是缺少可逐步外化與操作的解題流程。

  • 收錄 17 個任務,重點放在 distributed scanning 與 sequential traversal 一類逐步觀察題
  • 官方評測涵蓋 Claude、GPT、Gemini,亦提供 agent ablation 腳本
  • 數據集可經 Hugging Face 下載,評測程式以 Python 為主
  • 同一靜態圖片也能迫使模型做多步推理,唔靠影片輸入撐起難度

整個 GitHub 項目比較像研究與評測基建,而唔係即用型產品:你需要先下載數據集、配置對應供應商 API,然後用 repo 內的 eval 腳本跑結果。對做多模態模型評測、Agentic 工作流、或者想驗證 Computer-use agents、CUAs 式外部工具協作價值的團隊,它提供了一個很尖銳的檢查點:模型是否真的會「觀察」,還是只會對影像作高階猜測。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 多模態模型, OpenAI, Gemini, API, Python, Anthropic, Dataset 數據集

Trace 用可驗證資料重做視覺推理訓練

想訓練視覺模型識得真係推理,而唔係靠題型記憶,Trace提供咗一套可重播、可核對的資料生成方法。它不只出題,連答案點樣得來都一併保留。

trace mark

很多視覺推理資料集都只交付圖片同答案,模型答啱咗,未必代表推理過程真係站得住腳。Trace把重點放在可驗證 post-training:它屬於一個資料集兼生成環境,針對的問題是怎樣穩定產生 grounded visual-reasoning 任務,並且讓答案、標註與驗證流程互相對得上。

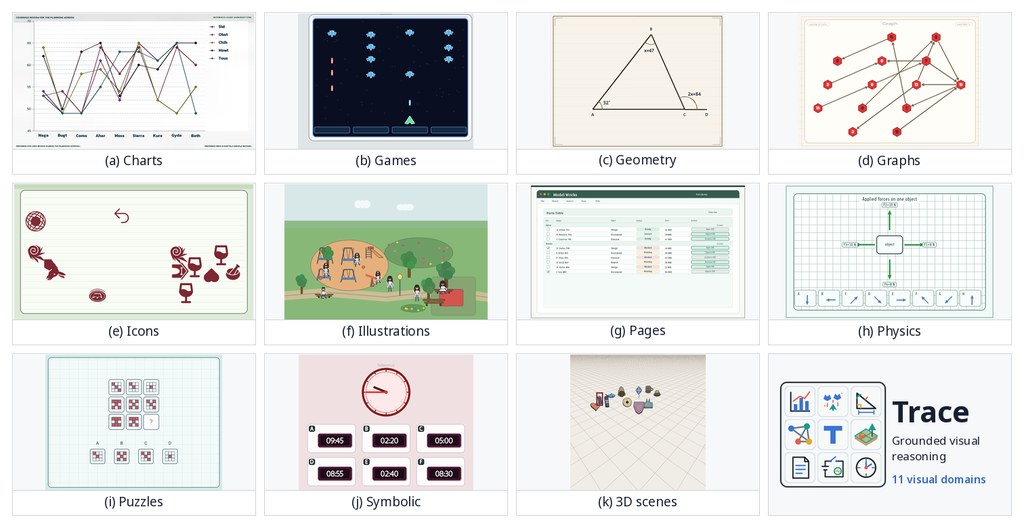
它採用一條很清晰的生成路線:domain → scene grammar → task program。現有做法常見是先有人手整理題目,或者由圖像與文字鬆散配對,再用最終答案做監督;Trace則用 deterministic seed 先建立 semantic scene state,再由 task program 從同一個狀態推導 typed answer、verifier state,最後才渲染圖片與提示。這種 shared-state 設計的分別,在於題目不是「生成完再補標註」,而是從源頭就把圖像、問題、答案同 execution trace 綁定。

對研究團隊來說,這個取向很有吸引力,因為它同時照顧訓練、檢查同重播。每個例子除了 image、prompt、typed answer,還有 image-space annotation、verifier metadata 同 execution trace;對想做 RLVR、後訓練驗證,或者想分析模型到底錯在觀察、計算還是規則理解的人,資料密度比一般 benchmark 高得多。

  • 收錄 11 個 visual domains、277 個 scene grammars、1,000 個任務
  • 已公開 66,000 個 generated examples,亦提供 Hugging Face dataset 與模型檢查點
  • 驗證不只看最終答案,還保留 verifier state 與 replayable execution trace
  • 以 Qwen2.5-VL-3B、Qwen2.5-VL-7B 做 post-training,兩個尺度都有明顯提升

數字上,它在 2,000 個未見過、但由同一批 task programs 生成的新例子上,將 Qwen2.5-VL-3B 由 24.45 提升到 41.05,Qwen2.5-VL-7B 由 34.25 提升到 51.55。這些結果首先說明 Trace對同分佈泛化有幫助;首頁亦提到用 64,000 個 Trace instances 訓練後,對 24 個外部 benchmarks 的 macro-average 也有改善,但摘要資訊未列完整分項,解讀時仍要看原始報告。

Trace最適合被理解為一個用來建構可核對視覺推理訓練資料的基礎項目,而不只是另一個出題庫。它的取捨也很明確:換來高度可驗證與可重播,代價是任務分佈由 scene grammar 同 task program 明確界定,較適合研究訓練方法、評測設計同模型行為分析,未必等同自然世界的開放式視覺理解。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 模型訓練, Qwen, DeepSeek, Image, Dataset 數據集

Cura 1T 瞄準醫療代理工作流

Cura 1T唔只想答醫療問題,而係朝住診療對話、臨床推理同 EHR 操作一條龍處理。對想評估醫療 Agentic 能力嘅團隊,呢個項目值得細看。

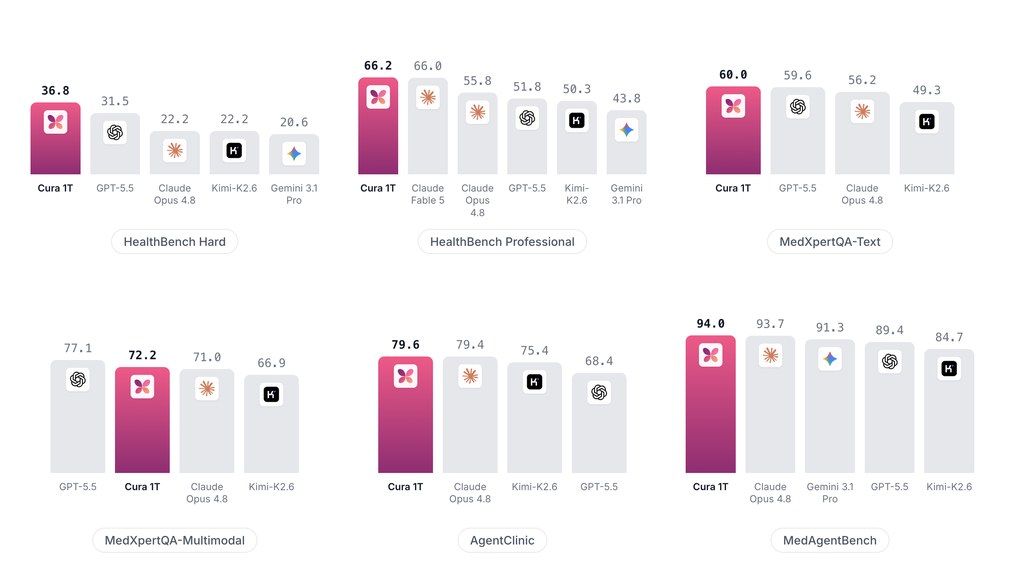
main comparison

醫療場景最難處理嘅,往往唔係單次問答,而係要連續對話、讀文字同影像、再連到 EHR 做操作。Cura 1T 就係朝住呢種 Agentic healthcare 用途打造嘅大型模型,重點不在通用聊天,而在病人諮詢、臨床推理同 FHIR-based record operations 呢三類高風險任務。

同類模型多數以通用能力再加醫療微調去應付需求,Cura 1T 則明顯押注 recursive self-improvement:由 training agent 規劃目標能力、訓練、沿 benchmark trajectories 找失誤,再調整 data mixture,而且每輪都有人類決定 keep-or-revert。呢個取向反映佢想解決嘅不只是知識覆蓋,而係醫療流程中跨回合、跨工具、跨模態嘅穩定度。

現階段最實際係經 OpenAI-compatible API 接入,model id 為 actava/cura-soar;公開資訊未見完整開放權重,較似面向企業試用與系統整合,而唔係本地自行訓練或離線推理。對醫療機構、健康科技團隊,或者要做 EHR、care management、行政自動化項目嘅開發者,呢種交付方式會較直接。

  • 以醫療模型定位,但核心賣點其實係 agentic workflows
  • 支援 text + vision,同時提供 256K context,適合長病歷與多模態判讀
  • 基於 Kimi-K2.6 後訓練而成,並非由零開始訓練
  • 基準測試在 6 個 healthcare benchmark panels 之中領先 5 項,但 MedXpertQA-Multimodal 仍落後 GPT-5.5

表現:HealthBench Hard 36.8、HealthBench Professional 66.2,亦在 AgentClinic 與 MedAgentBench 略勝 Claude Opus 4.8;相對 base model Kimi-K2.6 亦有明顯進步。要留意嘅限制係,分數來自 technical report 指定 protocol,而且 API 仍需排隊申請,現階段更適合做能力評估、流程驗證同企業整合規劃,未算係隨手可用嘅開源醫療模型。

項目主頁 · GitHub · Paper

Categories: 清華大學, Agentic, 多模態模型, API, Medical醫學, Dataset 數據集, Kimi

VIABench 視覺模型如何協助失明應用

不少影片模型識描述畫面,未必識幫人做決定。VIABench 把測試搬到視障人士日常片段,重點睇模型能否提供真正有用的協助。

VIABench cover

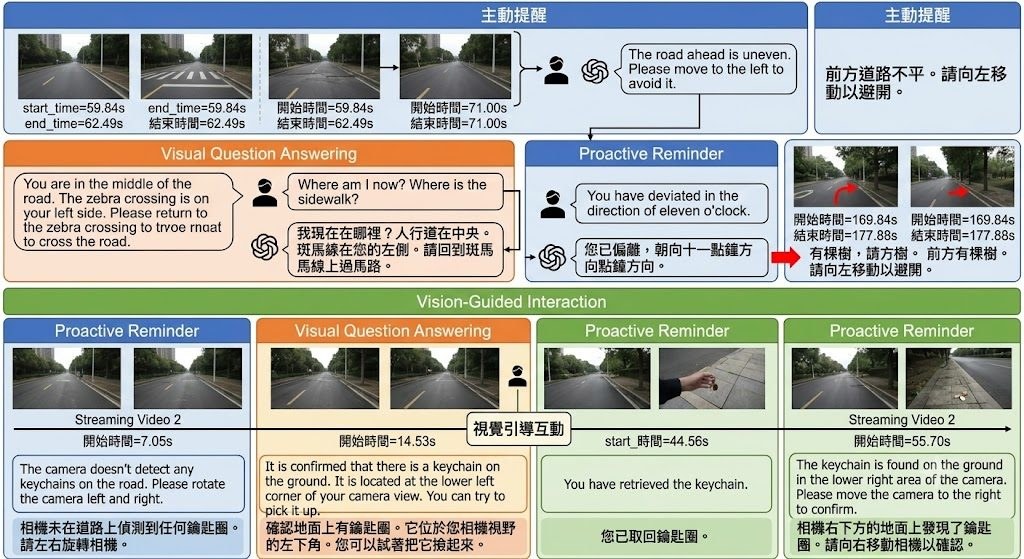
講到視覺模型,很多測試仍然停留在「見到乜、答到乜」;VIABench 把焦點轉去更貼身的助盲情境,直接檢查多模態大型語言模型可否在日常片段中作出提醒、回答環境問題,甚至按目標提供引導。它屬於Dataset 數據集兼評測基準,處理的是視障協助場景長期缺乏貼地測試標準這個問題。

VIABench 不再只量度被動理解,而是把影片 Multimodal Large Language Models 與真實任務綁在一起。資料來自盲人錄製或分享的第一身影片,包含 761 段影片、46.9 小時內容,以及 14,526 筆人工整理標註,圍繞 Proactive Reminder、Visual Question Answering、Vision-Guided Interaction 三類任務,測試模型會否在合適時間講合適內容。

和常見視覺問答基準相比,VIABench 的分野在於它重視「協助能力」多過一般描述能力。這意味模型不單要看懂畫面,還要判斷何時提醒、如何回應環境細節,以及怎樣支援使用者完成目標;取捨是任務更接近真實世界,但評測難度也更高,單靠表面語意對齊未必夠。

  • 核心價值在於測試影片 MLLMs 能否提供可行協助,而非只做畫面解說
  • 任務覆蓋主動提醒、視覺問答、互動引導三種助盲場景
  • 數據來自真實第一身影片,場景代表性比通用影片基準更強

較適合關注無障礙 AI、assistive technology、video MLLMs 評測的研究團隊,也適合想比較不同模型在真實互動場景表現的人。現有資料已足夠理解它作為基準的定位;使用前較合理的做法,是先查閱論文與 Hugging Face 資料集頁面,再確認支援哪些相關模型與評測設定。

GitHub

Categories: 開源, 南京大學, 視覺模型, 多模態模型, Video, Dataset 數據集

UniVR:視覺推理訓練變成可控工作流

UniVR 把 Emu3.5 的視覺推理訓練拆成 SFT 與 GRPO 兩段,讓團隊可用自己的資料同獎勵函數接上去。它更像一個面向視覺任務的訓練骨架,而唔係單一模型。

UniVR Overview

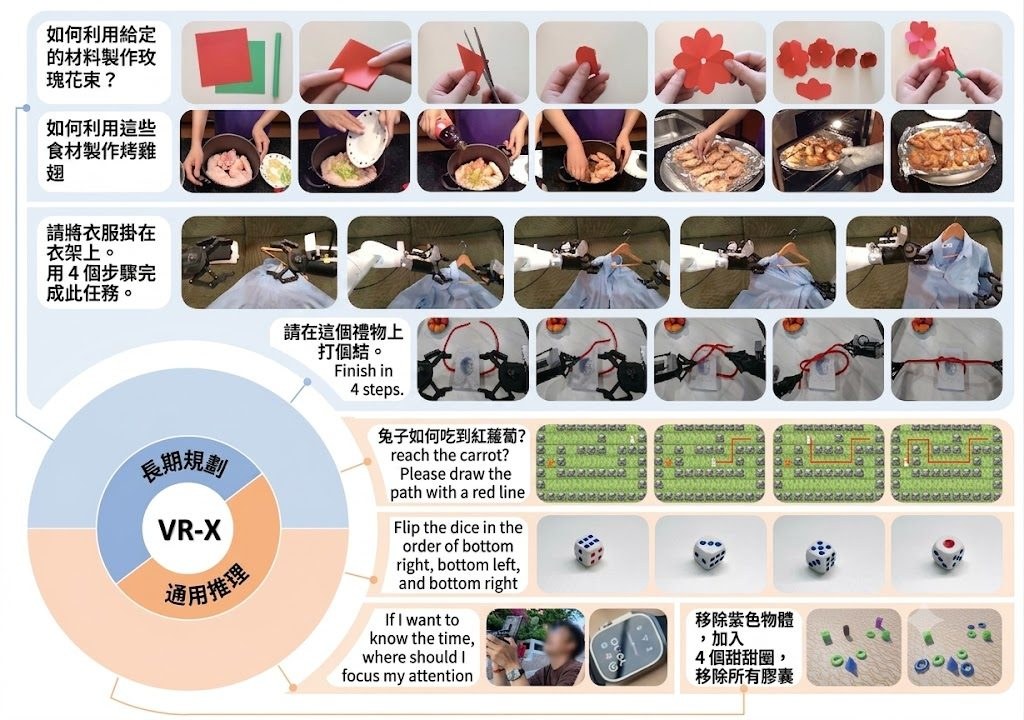
UniVR 係一個能理解我們視覺空間中的思考方式及其在統一視覺推理中的應用,它針對 Emu3.5 unified generative models 的訓練框架,處理的是視覺推理、長程規劃同結果判斷點樣一齊學。它唔係拿來直接做推理展示,而係俾你用自己的資料同獎勵訊號,去微調一個已經懂得處理圖像與文字的底座模型。

SFT(supervised fine-tuning)階段要提供統一格式的樣本:query image、textual instruction、visual reasoning trajectory;RL(reinforcement learning)階段則改成透過 HTTP reward server 送回分數。原始資料沒有提供完整安裝流程,所以目前可確定的只有要把自定義 PyTorch Dataset 接入 UniVR_SFT/train.py,以及把 reward function 換成自己的服務。

和一般只做單次微調的做法相比,UniVR 的取向更偏向「先教格式,再用獎勵修正推理」。它在 RL 端用 GRPO,並配合 HybridEngine 與 Emu3.5 的 vLLM patch,強調 rollout 效率;同時保留 LoRA 同 full-parameter training,適合資源與改動幅度唔同的團隊。

  • 支援多節點 SFT,兼容 LoRA 同 full-parameter training
  • RL 端基於 verl,同 GRPO 搭配自訂 HybridEngine
  • Emu3.5 的 vLLM no-CFG parallel inference 可做到約 2 倍 throughput
  • 獎勵設計分成 format reward、global reward,同 step-level 的視覺推理約束
  • 相關模型包括 Emu3.5 同作為評分器的 Qwen3-VL-30B

較容易受惠的情境包括做視覺代理、機械臂/操作規劃、長程任務推理,或者想將現成視覺模型轉成自己工作流的團隊。它的價值在於把「資料格式、推理軌跡、獎勵判斷」串成同一條訓練路線,令視覺任務唔再只靠靜態標註去學。

項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Gemini, Image, Python, Dataset 數據集

VideoChat3 一個睇得耐又睇得準的影片模型

要同一個模型同時處理細微動作、長片理解同直播回應,一向好難。VideoChat3 把重點放在時序理解同效率,定位相當清晰。

VideoChat3 logo

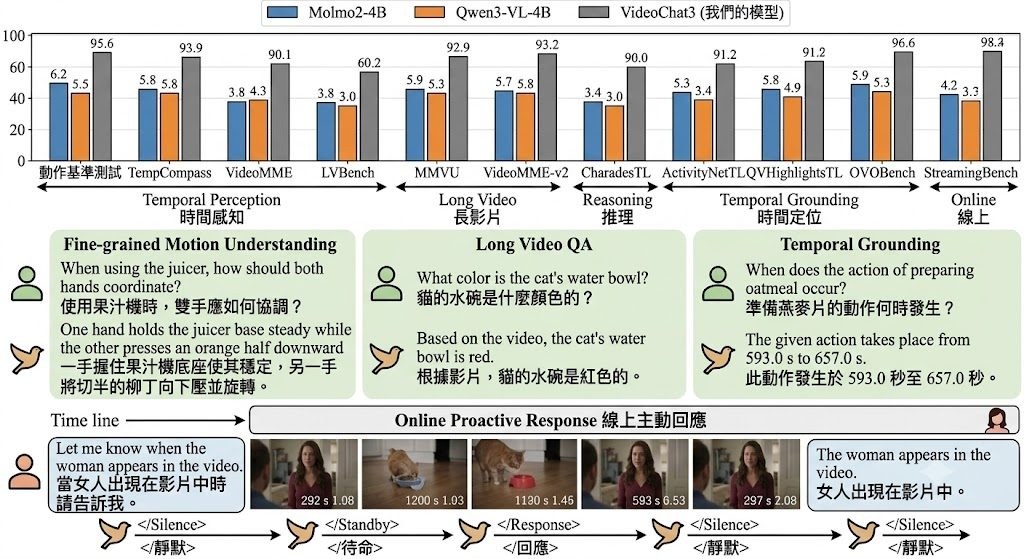
影片理解最麻煩的地方,往往唔係「識唔識睇」,而係要一邊保留動作細節,一邊捱得住長時間片段。VideoChat3 就係朝住呢個矛盾落手:它屬於多模態模型(Multimodal Large Language Model, MLLM),目標係用同一個 4B 模型處理細微動作、長片推理、temporal grounding 同 live streaming 回應。

同類項目好多時只會專注其中一段工作流,例如短片動作辨識,或者長片問答。VideoChat3 的取向係做 generalist video understanding,代價就唔係追求單一場景最極致的規格,而係用 I3D-ViT 同 Adaptive Frame Resolution 平衡 token 成本、時序證據同延遲,令模型唔需要全程用高成本方式讀完整段影片。

  • 重點唔只係睇單格畫面,而係保留跨時間的證據
  • I3D-ViT 提供 16× spatiotemporal compression,主打效率
  • Adaptive Frame Resolution 會按需要提高畫面解析度,較適合 streaming 場景
  • 已公開 model weights 同完整訓練數據,但 training code 仍未釋出

部署同測試的理解方式幾直接:現階段較接近研究釋出與模型體驗,適合先經 Hugging Face 取用 models & data,再按示範場景驗證長片問答、時間定位同串流回應表現。README 已列明完整訓練資料包括 Academic2M、LV116K、OL617K,對研究團隊、做 video agent、或者要建構影片檢索與監察流程的團隊最有參考價值。

公開資訊亦交代咗幾個關鍵數字:4B parameters、3M curated instruction samples、2,048 frames 下約 20.4s latency。呢啲數據未必代表所有環境都會有同樣效果,但至少講清楚它想證明的方向:唔靠超大模型,都可以把影片中的時間線索、事件關聯同即時反應放入同一套架構。相關模型與模組則以 VideoChat3、I3D-ViT、Adaptive Frame Resolution 為核心,整體更似一個面向研究與進階應用的開源影片理解項目。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, 模型, 視覺模型, 多模態模型, Video, 框架, 3D

Page 10 of 23
1 8 9 10 11 12 23