OmniEdu 把課程理解帶進 AI

OmniEdu 不只回答題目,還會對照課程、診斷學習缺口,再決定下一步應給提示、提問或講解。

Repository image for haolpku/Omni-Edu

學生卡在一道題目時,答案本身未必足夠,真正需要的是知道漏了哪個前置概念,以及下一步應怎樣學。OmniEdu 屬於開源多模態模型家族,處理 K–12 學習與教學流程,將課程對應、解題、學習診斷和教學支援放在同一套模型內。

模型以 Qwen3.5-4B-Base、Qwen3.5-9B-Base 和 Qwen3.8-27B 為基礎,推出 4B、9B、27B 三個 checkpoint。訓練資料包括 69,999 個 instruction examples、15.96M supervised response tokens,當中 60,951 個屬教育專用資料,涵蓋超過 100 個來源;模型亦支援圖片等多模態輸入,能把問題、知識點、年級、先修關係和課程證據連繫起來。

可下載的權重和資料集適合教育研究團隊、教材平台,以及需要本地模型作學習分析的開發者;4B 較適合本地試驗,9B 和 27B 則提供更高能力但需要更多硬件資源。模型可透過 Transformers 或 vLLM 執行,公開配置使用 Qwen3_5ForConditionalGeneration,訓練序列長度為 32,768 tokens。

  • OmniEdu-27B 在 16 個模型比較中,取得 K12-Bench EM 63.12% 和 F1 76.69%,兩項均列第一。
  • OmniEdu-27B 在 MathFish 達 85.89% 準確率,並取得 LongTutor 3.02 教學分數。
  • EDUMATH MaC 為 86.95%,MathTutorBench Scaffold win rate 為 78.74%,兩項均列第二。
  • 模型的差異不只在答對題目,而是嘗試判斷誤解、缺失的先修知識,再選擇提示、引導問題、複習或解釋。

OmniEdu 的取捨也很直接:全參數 supervised fine-tuning 和長序列訓練有助整合教育情境,但 27B checkpoint 對硬件要求較高,模型的教學判斷亦應配合教師審核。對只需要一般問答的工作流程,它可能過於專門;對重視課程對齊和個別學習支援的團隊,公開權重與資料集則提供了可檢查、可延伸的起點。
項目主頁 · GitHub

Categories: 開源, 北京大學, 模型, 多模態模型, 模型訓練, Image, 教學, Dataset 數據集

Grounded-Action-Model:讓機械人先理解物件位置,再決定如何動作

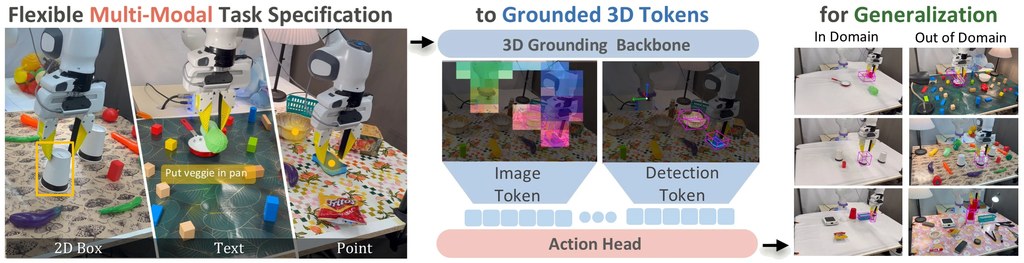
Grounded Action Model 把語言、點和框選提示轉成同一套 3D 物件表示,提升機械臂面對場景變化時的穩定性。

A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

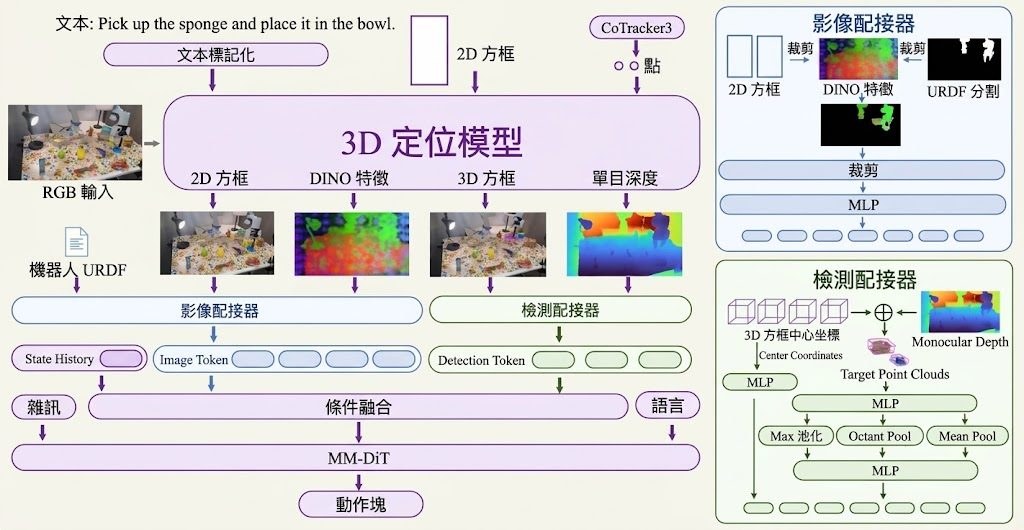
面對物件被移位、場景重新排列,機械臂未必只需要更長的指令,而是要準確知道目標在哪裏。Grounded Action Model(GAM)屬於機械人基礎模型,透過 3D grounding 將語言、2D 點或 2D 框選轉成同一套以物件為中心的觀察,再預測連續動作。

GAM 使用凍結的 promptable 3D detector,提取目標物件的視覺特徵和 metric geometry,並與機械人狀態歷史交給 multi-stream transformer,輸出 action chunks。相較於由 Vision-Language-Action Models(VLAs)或 World-Action Models(WAMs)從示範中隱性學習位置關係,GAM 把 3D 位置直接放進控制流程,也可由高層 planner 透過不同提示方式控制,支援較長流程和需要記憶的操作。

A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

目前可參考的結果包括:
– RoboTwin 2.0 的 50 項任務平均成功率為 55.3%,場景隨機化時為 47.6%。
– LIBERO-PRO 的 16 種擾動設定平均成功率為 61%,目標重新放置時改善較明顯。
– 雙臂 YAM 面對視覺變化仍成功 17/20 次;Franka 配合 Molmo2 planner,長流程任務的 OOD step completion 為 49.8%。

Grounded-Action-Model 適合研究機械人操作、視覺變化和高低層控制協作的團隊,但目前 GitHub 仍只有論文與項目頁面,training and inference code、pretrained checkpoints 及 real-robot setup 尚待公開,因此暫時不能按儲存庫直接安裝或重現結果。數據主要來自指定基準和兩款機械人,能否延伸到其他硬件與未見過的操作,仍要等待程式碼及更多測試。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, 微軟, VLA, World-Action Model, Robotic, 3D, 庫

OmniVChat:測試 AI 能否同時聽懂及看懂

直接把聲音和影像交給AI,回覆是否仍有根據?OmniVChat 提供評分工具,但測試與訓練分數不能混用。

OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue

讓AI直接接收用戶的聲音和影像,再以文字回答,OmniVChat(Omni Video Chat)提供了檢驗這類對話的評估與訓練獎勵工具。問題藏在影音之中,不另附文字提問、外部影像描述或自動語音辨識(Automatic Speech Recognition,ASR)轉錄,適合測試多模態模型能否連結所見所聞。

OmniVChat-Bench包含2,800段合成對話,按分層準則評分,涵蓋五類能力:

  • Dialogue-State & Link Perception(DSLP):理解對話狀態與連結。
  • Multimodal Entity Alignment(MEA):把說話對應至正確的可見實體。
  • Model Self-Awareness(MSA):交代自身身分與物理限制。
  • Anti-Hallucination(AH):回答以影音證據為依據。
  • Emotion Recognition(ER):結合面部與聲線辨識情緒。

評估分數r(y)介乎0至1,以Subcategory Mean匯報;OmniVChat-RL共用評分核心,另加格式、效率與風格獎勵,範圍為0至1.5,兩者不能直接比較。

研究團隊可先查看儲存庫的評分程式與範例,再到Hugging Face取得完整標註及媒體。這個項目只提供程式碼、範例與文件;合成對話的結果亦不足以單獨判斷模型在真人影音互動中的可靠程度。

GitHub

Categories: 開源, 香港中文大學, 阿里巴巴, 多模態模型, Video, Audio, 工具, 庫, 語音

RecreationWorld:從操作到重建軟件介面

代理不只觀察介面,還要自行寫程式、啟動成品及核對結果,測試由操作走向完整交付。

RecreationWorld logo

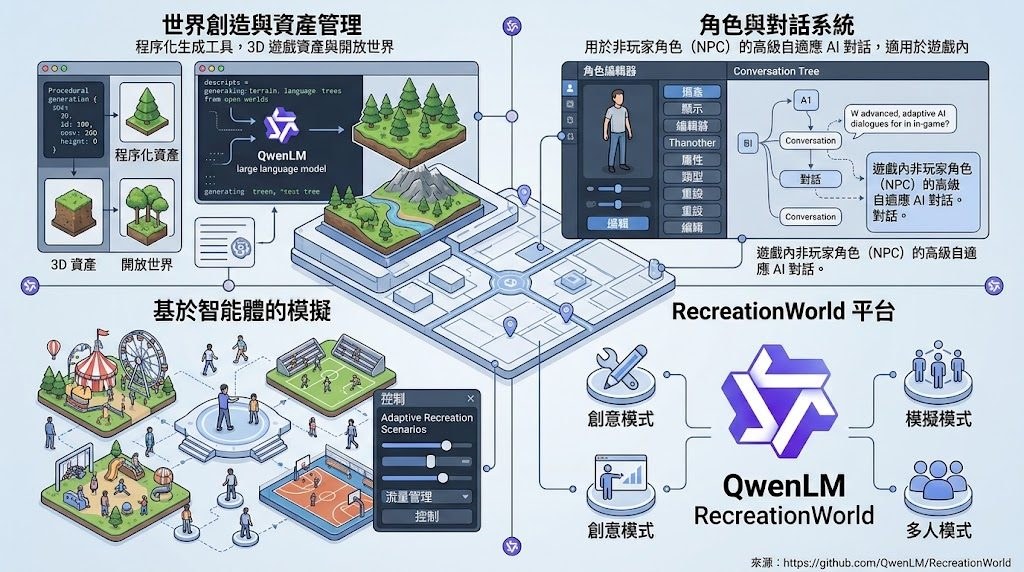
給代理一個正在運行的參考程式,它要邊操作、邊寫程式,再自行啟動及檢查成品。RecreationWorld 是研究混合式電腦操作代理(hybrid computer-use agents)的五平台框架,處理代理能否按可見行為重建軟件的問題。

它把參考程式當作可執行判準,讓代理反覆進行探索、實作與驗證,而非依固定階段完成任務。最終評分看功能與畫面是否吻合,不要求源碼、語言或架構相同,保留了實作自由。

  • 涵蓋 Ubuntu、macOS、Windows、Android 與 Web
  • RecreationBench 提供 250 個未公開於訓練流程的應用任務
  • 同時採用程式化檢查與視覺模型(Vision-Language Model,VLM)評分
  • 可比較完成度、接近滿分的應用比例及每項任務成本

已列出的結果中,GPT-6 Astra 平均 58.06%,領先 Claude Opus 5 的 44.16%,但估算成本達每項任務 115.80 美元;較便宜的模型則要接受明顯分數差距。這反映長時間探索、編碼與視覺核對仍然昂貴,而且只有少量應用能達到完整功能分數。

開發代理、GUI 自動化或程式生成系統的團隊,可下載 RecreationBench 資料集並依儲存庫的 Quickstart 配置環境;自行託管模型的正式評估需要聯絡團隊。它較適合作研究與模型比較,未見足夠資料證明可直接充當一般軟件重建服務。

項目主頁 · GitHub · 數據集

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架, Mac, Linux, 庫, Dataset 數據集

Qwen3.8 邊講邊翻譯即時生成字幕

阿里旗下 Qwen 推出 LiveTranslate 模式,用同一個模型一邊聽語音、一邊翻譯、一邊輸出字幕,支援中文、英文等多語言即時對話。

Og image

Qwen 團隊最近公開了 LiveTranslate 模式,主打邊聽邊譯、邊講邊出字幕。它把語音輸入、翻譯與字幕生成壓在同一個模型流程內,使用者開咪講一句,系統幾乎同步輸出另一種語言的文字,毋須額外挂接翻譯 API 或字幕引擎。

對於要做跨語言會議、外語直播、跨國客戶支援或聽打外語影片的團隊,這種一條龍處理可以直接省掉以往語音轉文字、再丟給翻譯模型、再做字幕排版的工序。直播主開英語節目時,中文觀眾可以即時睇到字幕;外語客戶打電話進來,中文客服亦可以一邊聽、一邊睇到對話內容。

LiveTranslate 屬於 Qwen3.8 系列下的語音功能延伸,目前支援普通話、英文等多語言之間互譯,亦可配合即時對話模式使用。Qwen.ai 用戶開啟 LiveTranslate 後揀選輸入與目標語言,便可以對住手機或電腦講話,螢幕同步顯示譯文。

Qwen 由阿里巴巴達摩院推出,屬於多語言、多模態大模型系列。LiveTranslate 的出現令 Qwen 在語音應用層面更貼近日常使用場景,而不限於純文字問答或文件分析。

重點摘要

  • Qwen3.8 新增 LiveTranslate 模式,主打邊聽邊譯、邊講邊出字幕
  • 語音輸入、翻譯、字幕生成整合在同一個模型流程內
  • 支援普通話、英文等多語言之間的即時互譯
  • 可用於跨語言會議、外語直播、客戶支援等場景
  • 透過 Qwen.ai 網站即可開啟試用,毋須額外安裝

項目主頁

Categories: 阿里巴巴, AI productions, 模型, 多模態模型, Qwen, API, Video, 語音

MiniMax-H3-Reason:多模態仍未帶來物理推理穩定答案

這份評估刻意把任務資訊藏在圖像、音訊和影片裡,逼模型從片段線索拼出合理結果。MiniMax-H3 在 517 個案例中只得 41.97% 成功率,顯示多模態整合仍是關卡。

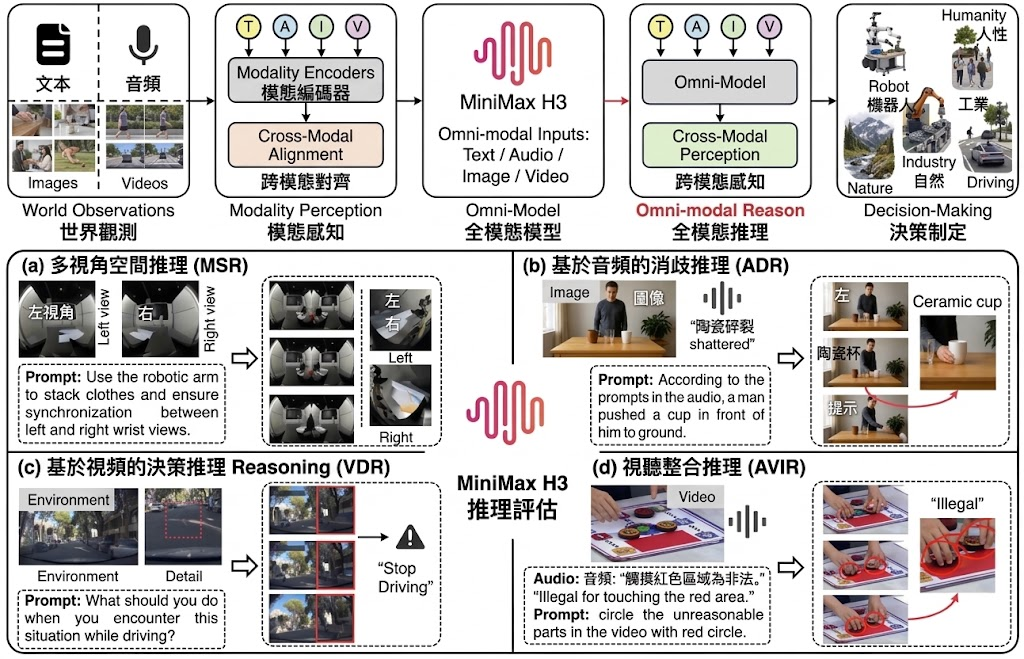
面對一段被刻意刪去關鍵資訊的指令,模型要靠圖像、聲音或前段影片這些「不在文字裡」的線索去補完事件,這正是這個評估項目想驗證的能力。它屬於研究類型的基準測試(Benchmark),專門設計來測 omni-modal 生成模型在物理世界推理上的表現,而不是單純比較畫質或動作流暢度。

整個框架圍繞四個場景展開:MSR 多視角空間推理、ADR 聲音消歧推理、VDR 影片決策推理,以及把聲音與影片約束結合的場景。每個場景都要求模型在 200 張圖、146 段聲音、影片前段等不完整輸入下,推斷出合理後續,並由專家判斷生成結果是否真的滿足語意要求,而非只追求像素相似。

MiniMax-H3 在這 517 個案例中整體成功率為 41.97%,差距明顯落在不同場景之間:影片決策推理最高,達 56.00%;聲音消歧推理最弱,只有 27.40%。這個落差直接說明,當聲音要承擔解開視覺模糊的責任時,模型很容易抓錯重點;反之,延續已觀察到的動態相對容易,因為線索更密集、更接近訓練分佈。

對做影片生成、世界模型或多模態整合的團隊來說,這套測試比起傳統 FID 或描述相似度更能反映真實瓶頸。它告訴我們,「支援多模態輸入」和「能可靠完成任務」之間仍有很大距離,尤其在聲音與畫面的細節對齊上。開發者可以用它找出弱項,研究者則能以此為基準,比較下一代模型是否真的在「聽懂並接住物理世界」這件事上有所進步。

重點摘要:

  • 任務描述刻意不完整,逼模型從圖像、音訊或影片中補回缺失資訊
  • 四個場景涵蓋空間、聲音、時間與音畫對齊四類物理推理
  • MiniMax-H3 整體成功率 41.97%,影片延續最易、聲音消歧最難
  • 由專家判斷生成結果是否滿足語意,而非僅看畫面或動作
  • 對開發 omni-modal 影片生成與世界模型的團隊,是更貼近實戰的評估方式

GitHub

Categories: 開源, AI productions, 視覺模型, 多模態模型, 框架, MiniMax

GPT-Policy 把 VLM 變現場教練

GPT-Policy 讓固定的視覺語言模型在現場讀懂示範影片、目標圖與互動回饋,直接輸出可執行的機械臂動作,省去微調與重訓成本。

GPT-Policy wordmark

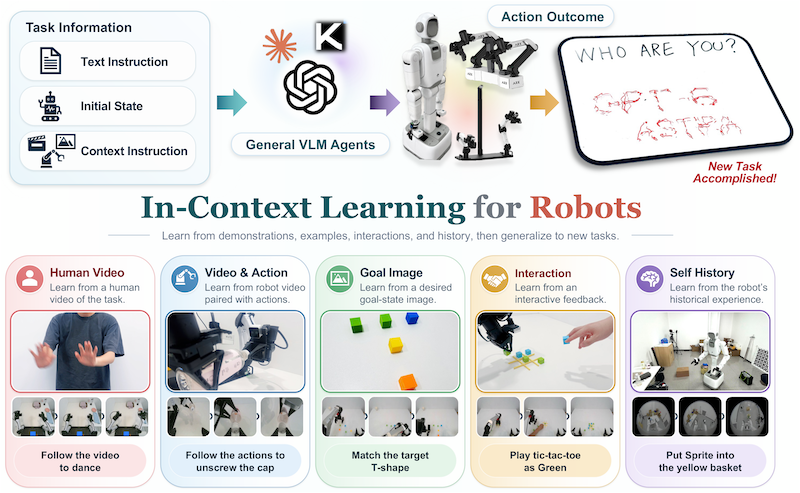
機械臂要適應新任務,傳統做法往往是收集大量數據再微調模型,成本高且迭代慢。GPT-Policy 走另一條路:保留一個固定的視覺語言模型(VLM)作為決策核心,現場把任務指令、示範影片、目標圖像、過往觀察與執行回饋打包成單一輸入,讓模型一次輸出一個結構化動作請求,再交給專屬的硬件適配器(adapter)驗證並執行。

的關鍵在於「context compiler」與「constrained controller」的分工。前者負責保留示範中與任務相關的視覺轉折,後者則檢查動作是否安全、可執行,並回報結果給 VLM 進入下一輪決策,整個過程沒有梯度更新,也不需要為新任務調整參數。對於 ARX X5 與 I2RT/YAM 兩款機械臂平台,項目已提供對應的適配器,支援笛卡兒目標、waypoint 序列、順序 IK 檢查、夾爪控制,以及 append-only 的運行記錄,方便日後追溯。

從結果來看,團隊在真實機械臂試驗中發現,即使只有人類影片而無機械臂動作標記,GPT-Policy 仍能改善任務完成率;若加上對齊的動作參考,表現會進一步提升,尤其在接觸敏感的任務上更明顯。對比同類做法,GPT-Policy 沒有走端到端策略網絡的路線,而是把通用 VLM 的推理能力當作即插即用的策略模組,取捨是更依賴適配器與閉環回饋的工程品質。

適合使用的場景包括:研究 VLM 與機器人結合的團隊、需要快速讓機械臂適應新任務示範的實驗室,以及想評估「不重訓」路線可行性的工程團隊。目前的限制在於硬件覆蓋仍集中在兩款臂,且效能高度取決於上下文編譯器能否保留關鍵視覺資訊。

重點摘要:

  • 固定 VLM 即決策核心:不微調、不重訓,靠現場上下文即時生成動作
  • context compiler + controller 雙層架構:前者保留任務相關視覺轉折,後者驗證並執行
  • 支援 ARX X5 與 I2RT/YAM:提供笛卡兒目標、IK 檢查、夾爪控制等適配器
  • 人類影片已能改善任務成功率:對齊動作參考後表現更穩,尤其接觸敏感任務
  • 定位為研究框架:適合探索通用模型在實體機器人上的即時學習能力

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, Video, Image, 影像處理, Robotic, 框架, 安全

PANORAMA 把場景描述逐個詞對應到像素

Inria 與捷克理工合作開源的 PANORAMA,能為整個場景生成描述並把每個實體精確對應到像素遮罩,並同步釋出近全幅覆蓋的人工標註基準 PanoCaps。

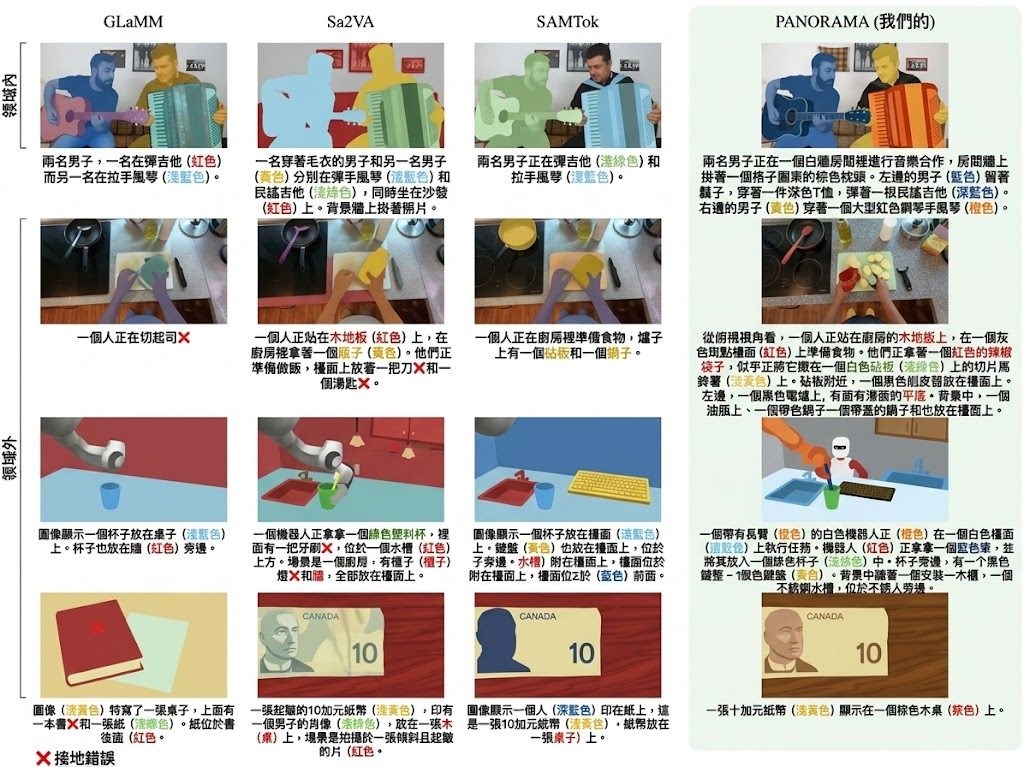
PANORAMA compared with prior grounded captioning models, in and out of domain

現時的視覺語言模型(VLM)寫得出漂亮描述,卻往往無法把句子裡的物件真正對到像素,導致「說的是一回事、畫出來又是另一回事」。PANORAMA 想處理的是 panoptic grounded captioning:模型要不只描述前景物件,還要連背景區域都講清楚,並為每個提到的實體給出像素級遮罩。

做法上,它把短語定位(phrase grounding)重新定義成「從短語條件化的遮罩提案池中挑選」。預訓練分割器根據每個短語的上下文表徵生成候選遮罩,模型再從中選出真正對應的那一塊,無論是單一區域、多個實例,或根本沒有對應都涵蓋在內。這樣把分割與語言生成用同一介面聯合訓練,文字與遮罩就不再各說各話。

配套資源同樣在 Hugging Face 公開:PanoCaps 約有 3.5K 張圖片、34K 個遮罩和 17.9K 條獨立短語,參照區域覆蓋近 99% 像素;COCONut-PanCap-Recaptioned 提供 118K 張訓練圖的重新標註;MRSeg-Referring-Expressions 則帶來約 101K 條改編自 SegLLM 的單輪指代表達。評估端還提出 generalized Panoptic Quality(gPQ),把文字與遮罩的一致性納入單一指標。實驗結果顯示,PANORAMA 在 PanoCaps 上整體定位表現最佳,並在多個像素級任務上與專門模型持平或更強。

這個項目適合以下情境:

  • 做機器人感知或場景理解的研究團隊:需要模型同時提供自然語言描述與實例級遮罩,減少對接多個模型的成本
  • 訓練數據匱乏的多模態團隊:PanoCaps 與兩份重新標註集合計逾十萬張圖,可直接用作訓練或微調
  • 需要精細指代(referring expression)任務的工作:MRSeg-Referring-Expressions 提供多粒度指代表達,比單一句式更有助泛化
  • 對 VLM 評測有疑慮的研究者:gPQ 指標把文字與遮罩綁定,避免「描述漂亮但對錯位置」的高分陷阱

對想直接跑實驗的人,訓練、微調與評估程式碼已隨倉庫釋出;模型權重則透過 Hugging Face 取得。如果你關心的是 VLM 能否真正「看懂」場景而不只是寫句子,這套統一框架比多數把描述與分割拆開處理的方案更接近落地需求。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Image, 框架, 庫, Dataset 數據集

ActionPiece:設計動作分詞器,幫機械人學得更穩

可以把 ActionPiece 理解為一個專給視覺語言動作模型用的動作編碼器,特別針對自回歸生成時動作細節流失的問題,強調保留物理距離的先後關係。

DeepCybo, Zhongguancun Academy, and Zhongguancun Institute of Artificial Intelligence

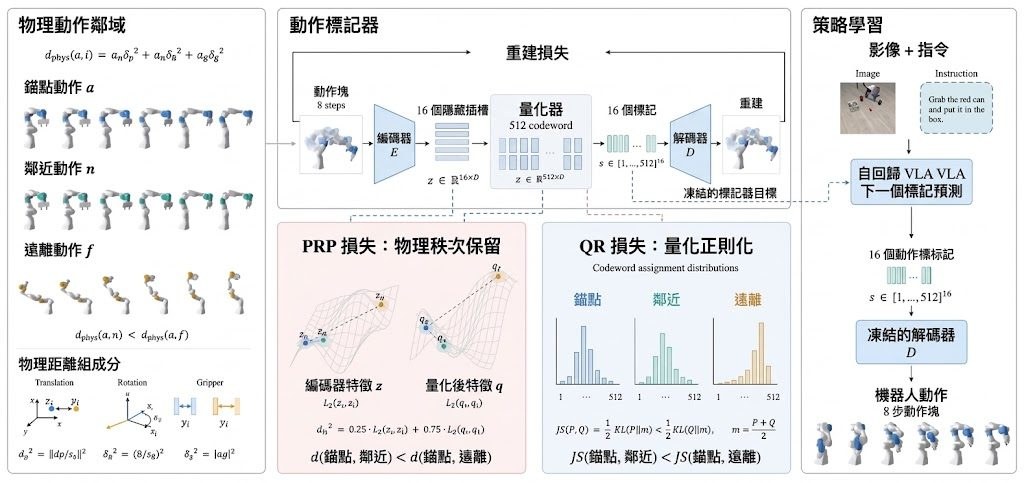
當自回歸視覺語言動作模型(VLA)把機械人動作切成離散 token 再一個個吐出來,最大的隱性成本往往不是單一動作的誤差,而是相鄰動作之間的物理距離被打亂。ActionPiece 正是針對這個卡位設計:它把動作切成一塊八步的短序列,每塊壓成 16 個離散 token,並要求 tokenizer 不只重建動作,還要保留「物理排序一致性」(physical rank consistency, PRC)。換句話,兩個本來很接近的動作,編碼後的距離也要維持接近;兩個本來很遠的動作,編碼後也要維持較遠。這種監督讓 token 表徵本身帶有物理結構,而不是純粹的重建損失。

在 Libero、Libero-Plus、SimplerEnv 與 VLA-Arena 四組基準上,ActionPiece 配合 Qwen3-VL-4B 作為策略骨幹,跑出 94.8%、68.8%、71.9%,以及 VLA-Arena L0 至 L2 平均 51.5% 的成功率。Libero-Plus 的訓練刻意排除其示範數據,因此這項成績更能反映遷移表現,而不是單純記住示範。從結果可以看到,重建保真度與 PRC 之間並非完全等價:有些 tokenizer 重建得很好,但鄰近關係一塌糊塗,部署成功率也跟著掉。ActionPiece 把「物理排序保留」與「碼字分配的量化正則化」綁在一起訓練,正好同時壓住這兩個問題。

這個項目的實際意義,是給正在做 VLA 研究的團隊一個可直接替換的動作 tokenizer,無需重寫策略架構。對關注 SimplerEnv 真實遙操作或 VLA-Arena 跨平台泛化的工程師來說,這類保留物理關係的分詞方式,會比純重建式 tokenizer 更貼近控制任務的需求。PhysBrain 1.5 也採用了 ActionPiece 作為動作 tokenizer,顯示它已不只在論文層面,而是走進實際模型發佈。

要真正評估它,比較合理的做法是把它接進自己的 VLA 流程,比對換 tokenizer 前後的策略成功率與 PRC;單看 Libero 94.8% 容易被低估,因為重建誤差小的 tokenizer 不一定保留鄰近結構。原始程式碼與 PhysBrain 1.5 的權重將在官方頁面釋出,想搶先試的人可以先讀論文並鎖定後續更新。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, VLA, Robotic, Dataset 數據集

HarnessVLN:不訓練也能走的統一導航框架

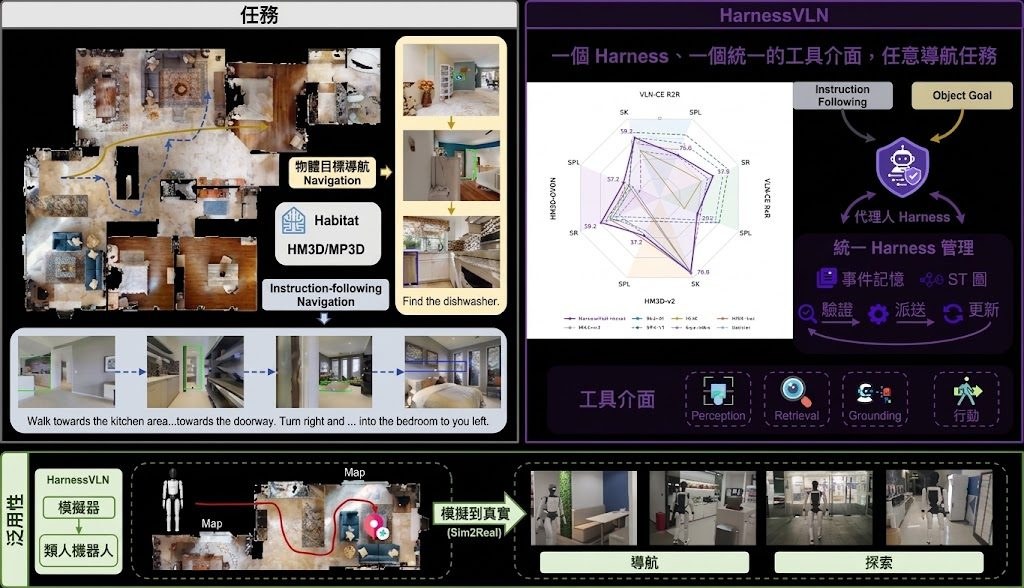
HarnessVLN 把視覺、語言、空間證據交給一套 Agent Harness 統籌,用零訓練方式處理多任務導航,並以層化記憶與時空圖解決長程失敗。

Repository image for AgibotGeneral/harnessvln

Embodied Navigation 過去依賴大規模訓練與任務專用流程,但不同場景的 pipeline 各自為政,難以共享空間證據與錯誤紀錄。HarnessVLN 把這個痛點攤開:現有 training-free 方法雖然借助多模態大語言模型,卻缺乏把「提案」與「空間證據、任務進度、執行失敗」對齊的機制,於是同一個 agent 在長時序任務中容易重複犯錯、難以回收。

作為一個訓練無需更新的 agent harness,HarnessVLN 用統一工具介面串接感知、檢索、定位、導航、恢復與終止,並透過層化事件記憶與持久化時空圖(Spatiotemporal Graph)保留可重用的空間證據與失敗標註,讓跨子目標的經驗真正沉澱。提案不再直接落地,而是先被 Agent Harness 結合幾何可行性與過往失敗做驗證,再分派給工具執行。

在 R2R、RxR、HM3D-v2、HM3D-OVON 等基準上,HarnessVLN 報出 60.8、53.9、76.0、59.3 的 SR%,覆蓋 instruction navigation 與 online exploration 兩種形態,並提供真機 demo 與模擬環境。對機器人團隊、具身 AI 研究者與需要快速驗證導航策略的工程師來說,它提供一個不必從零訓練就能橫向比較的底層框架。

重點摘要

  • 訓練無需更新:以 Agent Harness 統一感知、檢索、定位、導航、恢復與終止工具
  • 層化事件記憶 + 時空圖:把子目標進度與空間證據沉澱為可重用資產
  • 提案先驗證再執行:用幾何可行性與失敗紀錄把 LLM 操作提案過濾一次
  • 覆蓋 R2R、RxR、HM3D-v2、HM3D-OVON 等多項導航基準
  • 同時提供模擬與真機 demo,適合做跨任務導航策略的快速評測

對在意長時序導航穩定性、想避開昂貴 fine-tuning 的團隊,這套來自南京大學、清華大學與 AGIBOT 合作的方案,給出一條「不訓練也能走得更穩」的工程化路線。

項目主頁 · GitHub · Paper

Categories: 開源, 南京大學, 清華大學, Agentic, 多模態模型, 模型訓練, Robotic, 框架, 工具, Dataset 數據集

Page 7 of 29
1 … 5 6 7 8 9 … 29