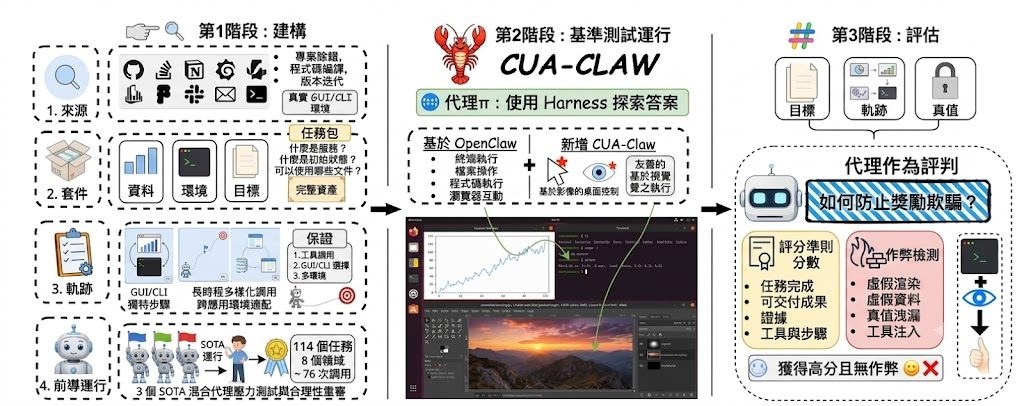
如果想先了解它怎樣運作,可以先看離線 demo,直接觀察 score.json、judge model 回應和逐項證據,再決定是否下載完整資料集與 qcow2 執行環境。完整流程需要 Linux、KVM、Docker 及相當多記憶體與磁碟空間,較適合研究團隊、模型評測人員,或正在建構代理系統的工程師。
114 個長流程任務,涵蓋 8 個工作領域
每個任務都要求 GUI 與 CLI/code 交替操作
最佳公開結果為 41.2% PassRate,顯示難度仍然很高
提供 OSWorld hybrid-scoring experiment,可對照不同評分與執行框架
資料集、runtime 與 qcow2 已放在 🤗 wanlilll/WeaveBench
相關模型與組合方面,公開結果包括 Claude Opus 4.7 + Claude Code、Claude Opus 4.7 + OpenClaw、GPT-5.5 + Codex CLI、GPT-5.5 + OpenClaw、GPT-5.4 + OpenClaw,以及 Gemini 3.1 Pro + OpenClaw。若你關心代理是否真的懂得跨介面完成工作,而不是只會在單一測試集刷分,這個項目很有研究價值。
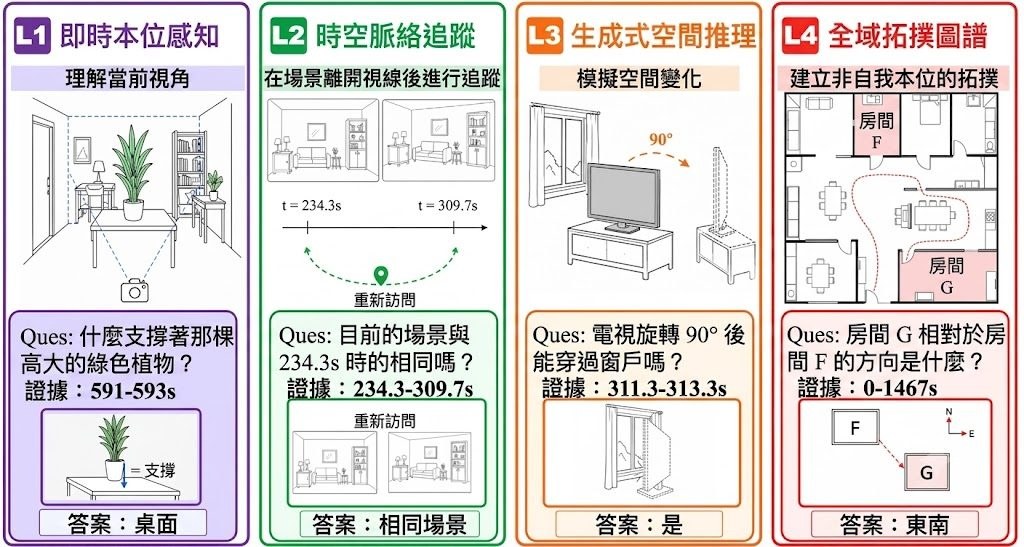
由清華大學、上海 AI 實驗室及北京航空航天大學共同推出的 OVO-S-Bench,是一套專門測試多模態大型語言模型 (Multimodal Large Language Models, MLLMs) 在連續影片中空間理解能力的基準。它針對機械人、AR 眼鏡和自動駕駛等需要「邊看邊想」的真實場景,要求模型根據問題時間點之前看到的畫面片段,推理出地點與佈局的變化,而非讀取整段影片。
題目來源相當多元,涵蓋室內導覽、第一視角活動、戶外場景、駕駛影片及帶有 3D 註解的環境,共 348 段影片。12 位具備 3D 視覺背景的標註員耗時約 804 小時撰寫及反覆核對每條題目,並透過「文字探針」和盲測覆核機制,剔除可憑題幹文字或常識直接答對的題目,確保難度真正來自空間理解。
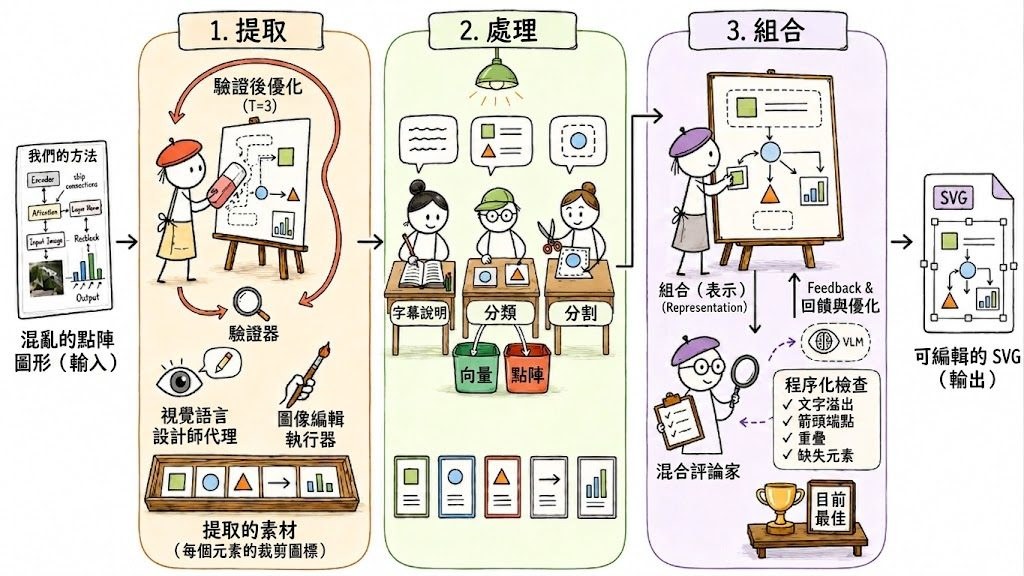
做研究的人都遇過這種困擾:論文裡的圖表要花好幾個小時排版、微調細節,市面上的 AI 生圖工具又常常「整體不錯、局部出錯」,改一個元素就把整張圖搞砸。Crafter 正是針對這個痛點而來,它不是把底層生成模型換得更強,而是在外面包了一層多智能體(multi-agent)協作框架,專門處理「結構化、由離散語意元件組成」的科研圖表。