PixVerve-95K:衝擊超高像素生圖評測

這個項目不只談生成圖片,更想建立一套面向超高解析度生圖的資料與評測框架。對研究與模型比較都頗有參考價值。

image

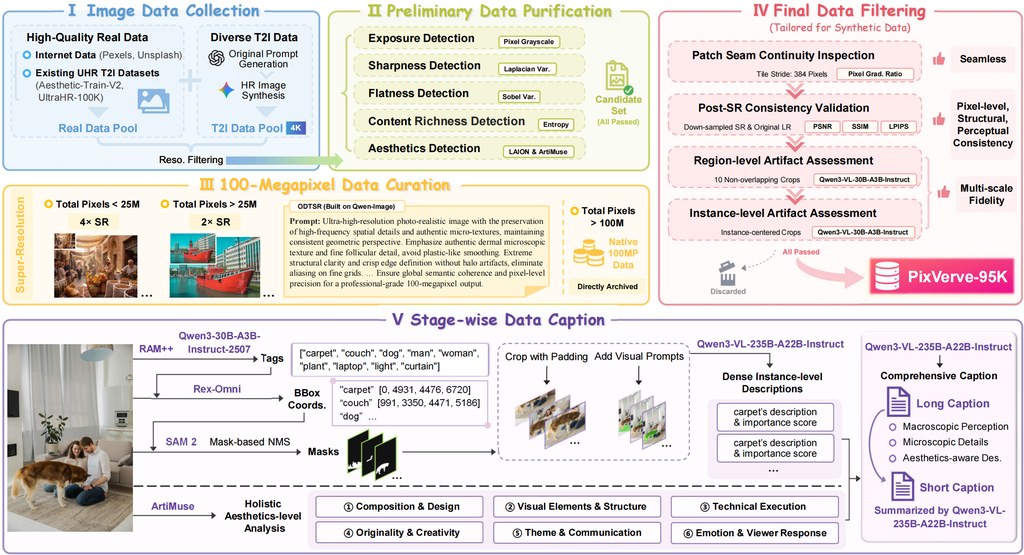
PixVerve-95K 是一個圍繞原生文字生成圖片而設的研究項目,重點放在把輸出推向 100MP 等級的超高解析度。它不只是提供資料,還連同模型方法與評測基準一併整理,方向相當清晰:回答「高像素生圖到底做得夠唔夠好」這個常見但難量化的問題。

對一般讀者來說,最易理解的切入點是把它視為一個「比較平台」。研究人員或開發者可先查看公開的資料集與基準設定,再用自己的文字生成圖片模型產出結果,之後按它提出的評估方式比較畫面細節、主體是否貼合描述,以及不同縮放層級下的穩定度。

這個項目的亮點,在於它不是只看一張圖表面是否好看,而是更重視超高解析度下的完整性與一致性。README 提到的 Multi-scale Fidelity Index(MSFI)與 Instance-centric Compliance Score(ICS),反映它嘗試由多尺度保真度與主體對應程度兩方面衡量結果,這比單純看主觀觀感更有系統。

重點可先看這幾項:
– 目標聚焦於原生文字生成圖片走向 100MP
– 內容涵蓋資料集、模型方法、基準評測三部分
– 評估指標包括 MSFI 與 ICS
– 適合拿來比較不同模型在高解析度場景的表現
– 已提及可配合 Qwen3.5-35B-A3B 與 vLLM 相關流程使用

適合關注這個項目的人,包括做文字生成圖片研究的團隊、想測試高解析度輸出能力的模型開發者,以及需要有系統 benchmark 的學術場景。若你平時留意的模型包括 Qwen3.5-35B-A3B,或其他文字到圖片生成系統,PixVerve-95K 的價值更像是一把尺,幫你判斷模型在大尺寸畫面下是否仍能守住細節與語意一致性。
GitHub: https://github.com/HaojunChen663/PixVerve-95K

Paper: https://arxiv.org/pdf/2605.20147

Categories: 開源, 清華大學, 框架, 中國

ZEDA 點樣令 MoE 推理更慳力

ZEDA針對已訓練完成的 MoE 模型,嘗試用較低成本換取更快推理。重點是減少專家計算,同時盡量保住原有表現。

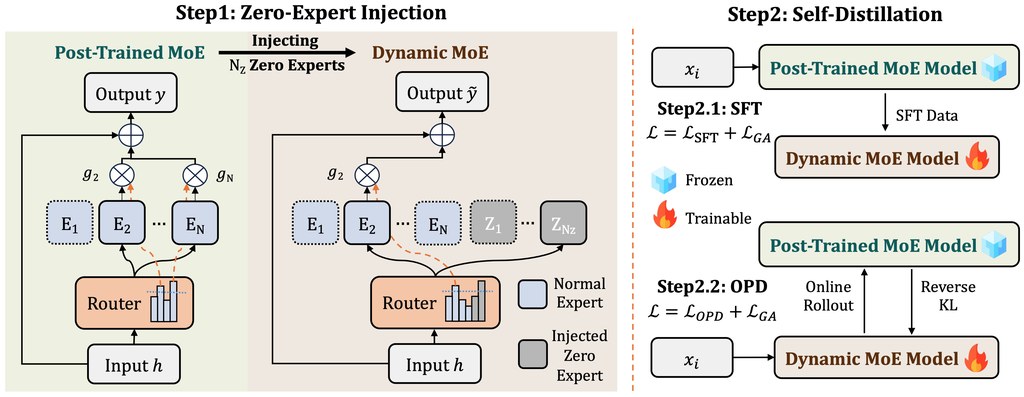
Overview of Unified Post-Training Framework.

ZEDA 針對的是一個很實際的痛點:大型 MoE 模型雖然強,但部署時每次回應都要動用唔少計算資源,成本高、速度亦受影響。呢個專案的目標,係唔使由頭再訓練模型,而係在現有、已做完後訓練的 MoE 之上,再改造成更靈活的動態版本。

它的做法有點似「老師帶學生」:先用原本的 MoE 當固定老師,再訓練新的學生模型去學習輸出,同時加入一種零輸出的專家,讓部分較簡單的 token 可以略過不必要計算。根據論文與倉庫資訊,這種方法可減少超過一半 expert FLOPs,整體表現只屬輕微下跌,並帶來約 1.20 倍端到端推理加速。

ZEDA 不是通用開發框架;它是清華 C3I 團隊的一個研究專案,從公開論文摘要看,全名是 Zero-Expert Self-Distillation Adaptation,目標是把靜態 MoE 模型轉成更高效的動態 MoE 模型,以降低推理成本並提升速度。這個專案對應的 GitHub 倉庫就是 TsinghuaC3I/ZEDA,而論文頁面也明確指向該 repo。

實際動手時,流程大致分兩步:先做 SFT,利用老師模型產生的回應或已釋出的 rollout 結果訓練學生;之後再做 OPD,改為由學生自己生成,再由老師提供 token 級別目標去微調。倉庫亦提到可配合已公開的 prompts 與 rollout 資料使用,對想重現結果或套用到指定 MoE 的人會方便不少。

  • 核心價值:把已完成訓練的靜態 MoE,改成推理時更慳算力的動態 MoE
  • 方法亮點:加入零輸出專家,再用兩階段自蒸餾穩定轉換過程
  • 可選模型:Qwen3-30B-A3B、GLM-4.7-Flash
  • 適合場景:模型已定版,但上線後仍想再壓低推理成本
  • 資料配套:提供 prompts 集合,亦釋出部分 rollout 結果可直接利用

整體來看,ZEDA 最值得留意的地方,不是單純追求更高分,而是補上「模型已經訓練完,之後仲可以點樣再慳資源」這一步。對研究 MoE 部署、推理優化,或者手上已有大型後訓練模型的團隊,這個方向相當有參考價值;至於一般讀者,可以把它理解成一種用較少電腦功夫,換來差不多效果的改裝方案。

GitHub: https://github.com/TsinghuaC3I/ZEDA

Paper: https://arxiv.org/pdf/2605.18643

Categories: 開源, 清華大學, 上海人工智慧實驗室, 中國

KVPO 點樣提升影片生成對齊

KVPO聚焦自動回歸影片生成訓練,嘗試令結果更貼近提示內容。重點在於用分支探索加獎勵學習,改善畫面走向。

KVPO

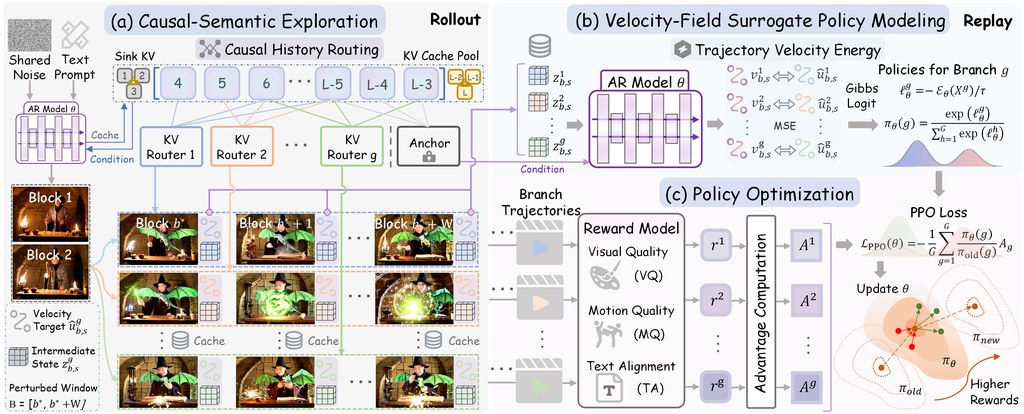
KVPO 係一個針對影片生成訓練流程嘅研究型專案,焦點唔係單純「生成到片」,而係令模型喺逐格、逐段生成嘅過程中,更穩定咁貼近文字提示同預期內容。對一般讀者嚟講,可以理解成:佢想改善 AI 影片成日出現嘅「開頭啱、之後走樣」問題。

呢個方法特別之處,在於佢唔只睇最後條影片好唔好,而係會喺生成途中做多條候選路線探索,再用獎勵模型判斷邊條路線更值得學。README 提到佢結合咗類似 PPO 嘅強化學習更新,以及對生成軌跡嘅機率估計,目標係令自動回歸影片模型學得更準。

實際了解同試用呢個專案,會由查看論文、專案頁面同釋出權重開始,再按設定準備對應環境、模型權重同資料。由於文件列出咗 H200、CUDA 12.8、Wan2.1 backbone,以及 HPSv3、VideoReward 等元件,較適合已有 GPU 資源、熟悉深度學習訓練流程嘅讀者,而唔係即開即用型工具。

  • 主要處理影片生成中內容偏離提示、時間一致性變差等問題
  • 核心做法係先探索多個生成分支,再用獎勵分數引導學習
  • 研究重點放喺自動回歸影片模型,而唔係一般圖片生成
  • 文件顯示會配合 Wan2.1-T2V-1.3B 等 backbone 使用
  • 仲會涉及 HPSv3、VideoReward 呢類評分或獎勵相關模型

整體而言,KVPO 比較適合關注影片生成訓練方法嘅研究者、工程師,或者想比較唔同對齊策略嘅團隊。對非技術用家,佢未必係直接拎嚟出片嘅方案;但作為觀察新一代影片模型點樣「學識跟指令」嘅方向,呢個專案幾有參考價值。

GitHub: https://github.com/Richard-Zhang-AI/KVPO

Paper: https://arxiv.org/pdf/2605.14278

Categories: 開源, 香港科技大學, 清華大學, 影像模型, 影像處理

Flash-GRPO:影片生成訓練再提速

這個專案聚焦影片擴散模型對齊訓練,用更省資源的方法換來更快效率。對研究型團隊尤其值得留意。

LOGO

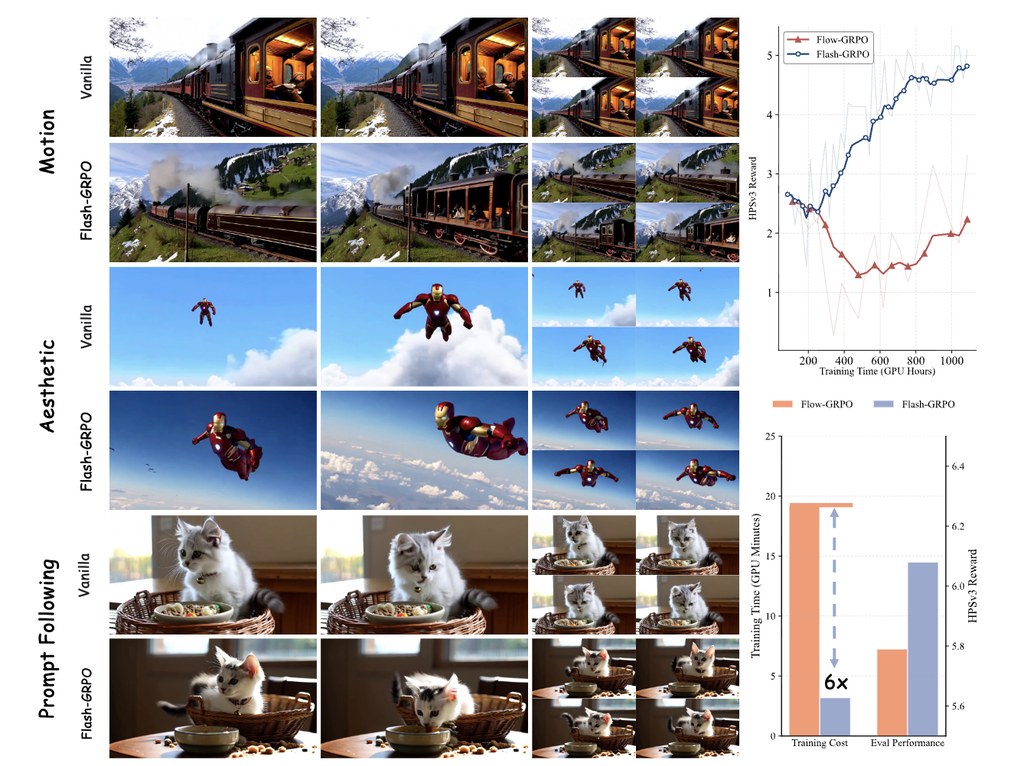
Flash-GRPO 針對的是影片生成模型訓練中一個很實際的難題:要令模型更貼近人類偏好或評分標準,傳統做法往往要走完整訓練軌跡,計算量高、時間長,對硬件要求亦相當重。這個專案提出單步式優化框架,重點是用較低運算預算,換取更有效率的對齊效果。

從公開資料來看,它主要面向影片擴散模型,並配合獎勵模型一同使用。實際動手時,需要先準備基礎模型 Wan2.1-1.3B,以及 README 提到的 HPSv3 獎勵模型,再按專案提供的訓練流程啟動;現階段較適合已熟悉 Python、分散式訓練和 GPU 環境的人直接試跑。

這個方法較有意思的地方,在於它不只是「少做步驟」,而是嘗試處理時間步之間訓練訊號不穩定的問題。README 提到兩個核心設計:一個是維持同一提示詞在時間上的一致性分組,另一個是修正不同時間步梯度尺度不一致的情況,目標是令訓練更穩定,也更容易比較模型表現。

  • 主打影片擴散模型的對齊訓練,而非一般文字模型微調
  • 強調單步式策略優化,方向上比完整軌跡訓練更省資源
  • 已在 1.3B 到 14B 規模模型做實驗驗證
  • 相關基礎組件,包括 Wan2.1-1.3B 與 HPSv3

整體來說,Flash-GRPO 比較適合做生成式 AI 研究、影片模型訓練優化,或想評估低成本對齊方案的團隊。對一般用家而言,它不是即裝即用的成品;但對需要在有限 GPU 預算下提升訓練效率的人,這個專案展示了一條相當值得關注的技術路線。

GitHub: https://github.com/Shredded-Pork/Flash-GRPO

Paper: https://arxiv.org/pdf/2605.15980

Categories: 開源, 清華大學, 影像模型, 中國

InsightTok:令生圖文字人臉更清晰

這個專案專注改善生成圖片中最易失真的文字與人臉細節。對已有自回歸生圖流程的人來說,特別有參考價值。

Method

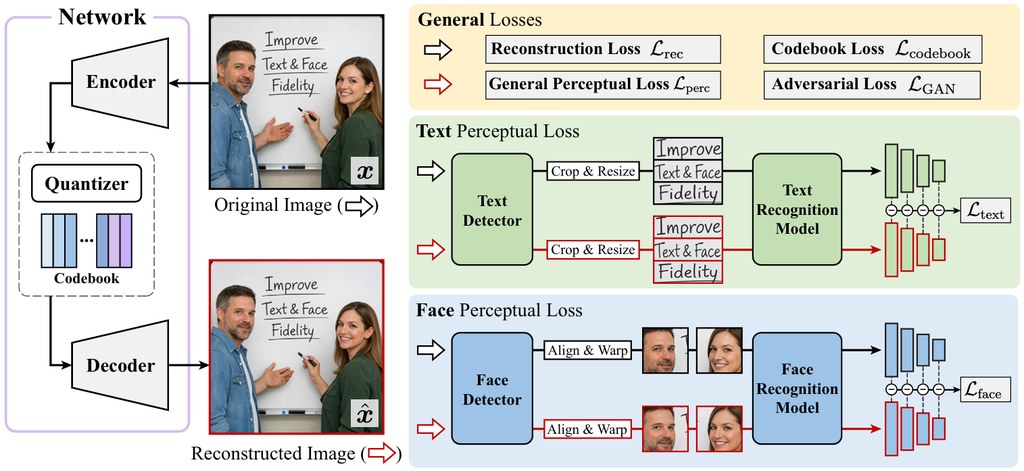
生成圖片時,最常令人出戲的往往不是背景,而是招牌上的字、海報上的字句,或者人臉五官的細節。InsightTok 針對的正正是這兩個難位:它不是直接改整個生圖模型,而是先改善圖片被「拆解成代碼」的方式,讓後續生成時更易保留重要內容。

實際使用上,這類專案較適合已經在做文字生成圖片、研究離散視覺 tokenization,或使用自回歸圖像生成流程的開發者與研究者。重點在於把原有流程中的視覺 tokenizer 換成 InsightTok 這一類方案,後面的生成模型理論上毋須大改,對現有管線算是較容易接入。

它的特別之處,在於沒有只用一般重建目標,而是更有意識地照顧局部而且重要的內容,例如文字區域與人臉區域。根據儲存庫提供的說明,它在相同壓縮率下,能做到更好的文字與人臉重建,同時只用 16× downsampling 和 16,384 個條目的 codebook,額外訓練成本亦相對有限。

  • 主要改善圖片中的文字可讀性與人臉細節還原
  • 可兼容標準自回歸圖像生成流程,毋須連下游模型一併重寫
  • 在相同壓縮條件下,重建效果主打更清晰、更忠於原圖
  • 設計上延續 VQGAN 風格 tokenizer 思路,但加強重點區域 supervision
  • 相關脈絡包括離散視覺 tokenizer、VQGAN 風格方法,以及文字生成圖片模型

整體來看,InsightTok 吸引之處不在花巧功能,而在於它抓到生圖最常被批評的痛點,再用相對務實的方法補強。對一般讀者來說,可以把它理解成一個「令 AI 更識得保住字同樣貌」的底層零件;對技術團隊而言,它較像是一個可直接提升畫面可用性的基礎組件。

GitHub: https://github.com/LeapLabTHU/InsightTok

Paper: https://arxiv.org/pdf/2605.14333

Categories: 開源, 清華大學, 視覺模型, 視頻模型, 微軟, 中國

Causal-Forcing 點樣令影片動作更豐富

呢個專案主打即時互動影片生成,特別強化動作連貫同自然感。重點在於用更貼近時間因果的方式,改善畫面會動但唔夠順的問題。

overview

如果你對 AI 生成影片有興趣,Causal-Forcing 最值得留意的地方,不只是「出片快」,而是它特別著重動作變化是否合理。很多影片模型可以生成靚畫面,但人物移動、鏡頭轉換或物件軌跡,往往會有忽快忽慢、前後不連貫的情況;呢個專案正正是針對這類動態問題下手。

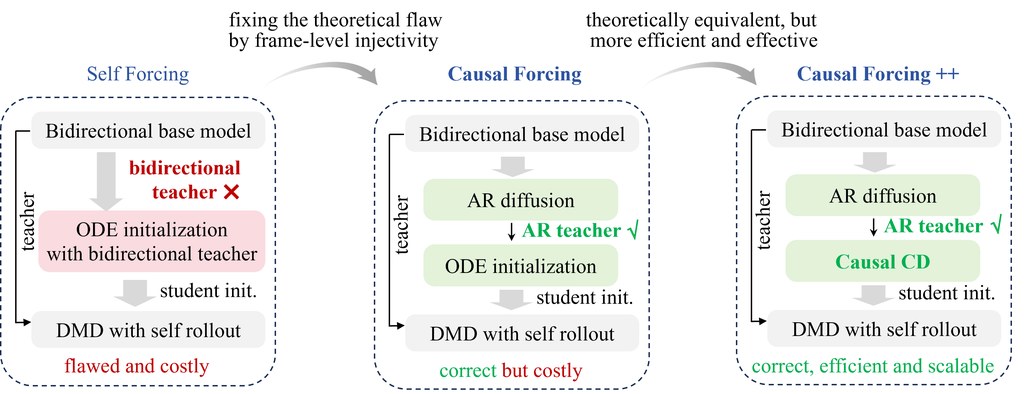
它的核心想法,是用更符合時間先後關係的方法,去引導自回歸式影片生成。簡單講,模型不只是學每一格畫面「似唔似」,而是更重視每一步動作點樣接續上一刻,令運動軌跡更穩定。README 亦明確指出,Causal Forcing 在視覺品質之外,對 motion dynamics 的表現比 Self Forcing 更好,而且訓練成本與推理效率大致維持同一水平。

對一般使用者而言,上手方向算清晰:它已提供推理與訓練流程,並支援文字生成影片,以及由圖片延伸成影片的形式。特別是 frame-wise 版本,因為按逐格方式處理,較容易理解為直接面向每個時間步,對需要細緻控制動作延續的人會更有吸引力。

  • 重點放在動作連貫性,不只追求單幀畫面靚
  • 支援 chunk-wise 與 frame-wise 兩類模型設計
  • 涵蓋 T2V、I2V,實用場景較廣
  • Causal Forcing++ 再進一步提供 1-step、2-step frame-wise 模型
  • 相關版本可留意 Causal Forcing、Causal Forcing++,以及 README 提到的 Self Forcing 作比較對象

再看它的創新位,關鍵在於用 Causal ODE,或在 Causal Forcing++ 中改用 causal Consistency Distillation,去做一個更合理的初始化,再配合 asymmetric DMD。從專案說明可見,作者很強調「生成軌跡要對齊」這件事,亦因此在某些階段要使用自回歸老師模型,這對保持動作隨時間推進的一致性尤其重要。

如果你的重點是互動式影片、角色連續動作、長一點的鏡頭推進,呢個專案比起只看單張效果的模型更值得研究。它未必是最易即學即用的大眾化工具,但對於想改善 AI 影片「會動但唔自然」這個老問題的人,方向相當明確。

網址: https://github.com/thu-ml/Causal-Forcing

網址: https://arxiv.org/pdf/2605.15141

Categories: 開源, 清華大學, 視頻模型

Relit-LiVE:令影片重新打燈更自然

這個專案主打影片重打光,重點是光影連貫而且更像真實拍攝。對影像研究者和進階創作者特別有參考價值。

Nanjing University

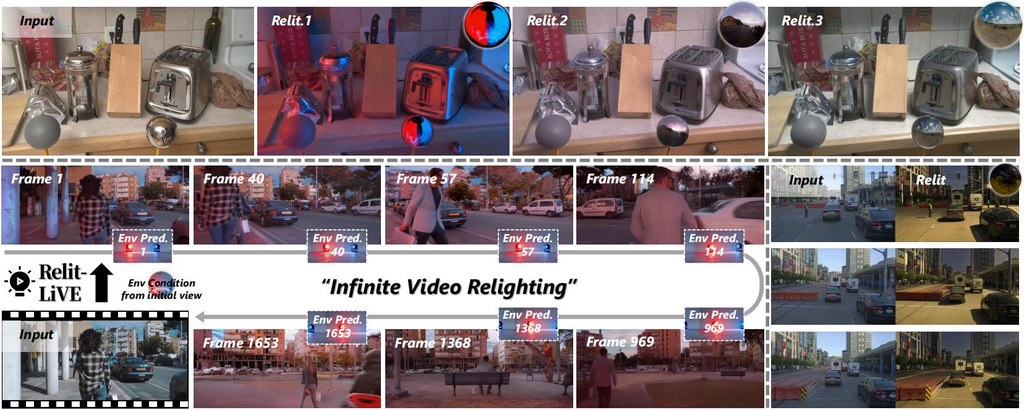
Relit-LiVE 是一個用來幫影片「重新打燈」的研究型專案。簡單講,就是把原本影片中的人物或場景,在不改動內容主體下,換成另一種光線效果,並盡量保持整段影片前後一致,不會一時光、一時暗。

這個專案較特別的地方,是它不依賴預先知道鏡頭姿態,並且會一同生成重打燈影片與環境光影片。這種做法有助提升物理一致性,令反光、陰影等細節看起來更合理,對比只逐格處理的方式,更重視時間上的穩定。

實際使用上,它目前較適合有 NVIDIA GPU 的使用者,官方亦建議至少 24GB VRAM,代表一般人未必適合在普通手提電腦直接試。現階段已提供推論程式與模型權重,但訓練流程、完整 inverse-forward pipeline,以及 Gradio 介面似乎仍未完全公開。

如果你是做影像研究、生成式影片實驗,或者想測試影片後期中的光照控制,這類工具會幾有參考價值。它未必是即開即用的消費級產品,但對需要高質感光影變化、又想減少畫面閃爍的人來說,方向相當清晰。

  • 主要用途是把現有影片重新套用新的光照效果
  • 重點創新是聯合生成環境光影片,提升連貫性與真實感
  • 已公開推論代碼與 checkpoints,適合先做效果驗證
  • 硬件要求偏高,較適合研究者或進階創作者
  • 相關模型資訊可見權重路徑提到的 Wan2.1-T2V-1.3B,亦有 Hugging Face 模型發佈頁可供參考

整體來看,Relit-LiVE 最吸引之處不只是「換光」,而是嘗試令影片中的光影變化更像真實世界。若你關心影片生成中的物理合理性、時間穩定性,以及反射和陰影表現,這個專案值得加入觀察名單。

Source: https://github.com/zhuxing0/Relit-LiVE

Categories: 開源, 南京大學, 清華大學, 模型, 視覺模型, 視頻模型, 影像處理, 中國

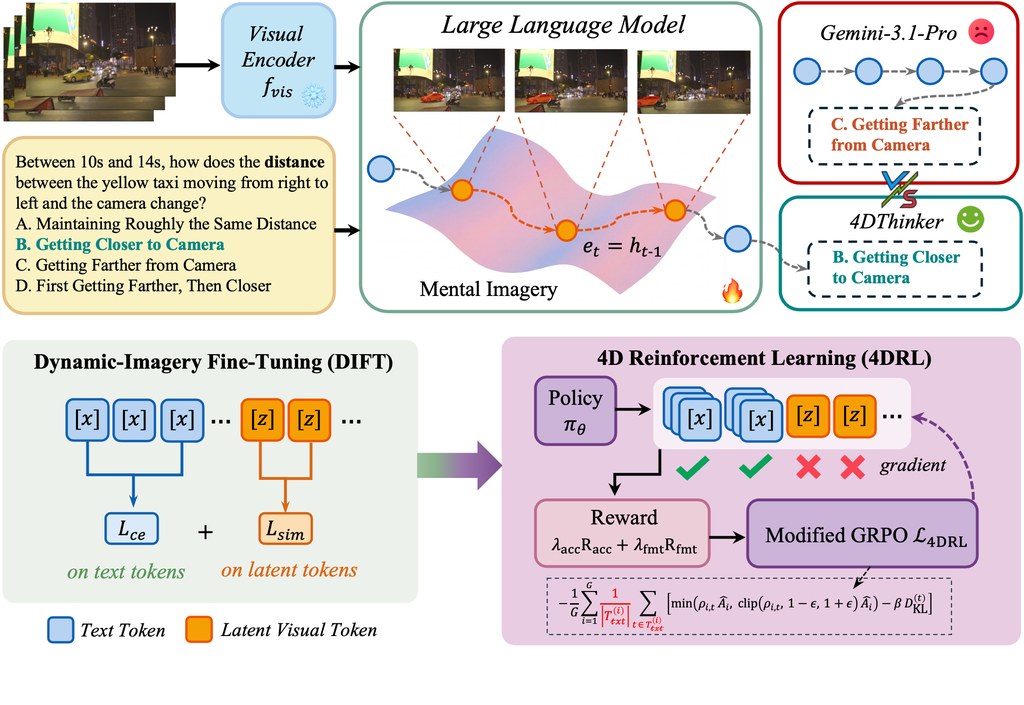
4DThinker:讓影片理解動態空間的4D視覺腦

4DThinker嘗試令模型不只「看圖說話」,而是從影片內部模擬場景變化。對動態空間推理有明顯研究價值。

drawing

4DThinker 是一個面向研究用途的視覺語言模型框架,重點不是單純描述影片內容,而是讓模型從單鏡頭影片理解物件如何移動、互相影響,以及場景隨時間怎樣變化。簡單講,它想解決「模型見到影片,能否真正理解空間變動」這件事。

它的實際用法較接近訓練與評估流程,而不是即裝即用的消費級工具。專案提供資料集、模型權重、訓練程式,以及前處理所需資源;若要重現效果,需準備影片資料、SAM3 checkpoint,並以 Qwen2.5-VL-3B-Instruct 作為基礎模型,部分資料生成流程亦會用到 OpenAI 相容 API。

這個專案最值得留意的創新,在於它不再只靠文字一步步「講出」推理過程,而是加入所謂 4D latent imagery,讓模型在隱藏空間中模擬場景演化。配合 DIFT 微調,以及 4DRL 強化學習,方向上是希望把動態視覺理解能力直接學進模型本身,而非額外串接複雜幾何模組。

重點摘要:
– 針對單鏡頭影片的動態空間推理
– 提供資料生成、訓練與評測相關組件
– 以 4D 潛在表徵處理時間與空間變化
– 支援調整 latent token 數量與損失權重
– 較適合研究團隊,而非一般用家直接部署

如果你做的是機械人感知、影片問答、場景理解,或者想提升模型對「之後會怎樣」的判斷,4DThinker 特別值得留意。至於一般內容摘要或靜態圖片分析,它未必是最直接的選擇,因為整個設計明顯是為動態推理而生。

Source: https://github.com/zhangquanchen/4DThinker

Categories: 開源, 清華大學, Agentic, 模型, 視覺模型, 庫, 中國

Page 6 of 6
1 … 4 5 6