AsySplat:3D 場景重建更省算力

長場景的新視角合成,常見難點是算力花得多,但畫面未必再明顯變好。AsySplat 直接把幾何和外觀分開處理,在保留細節之餘減少重複計算。

Teaser Image

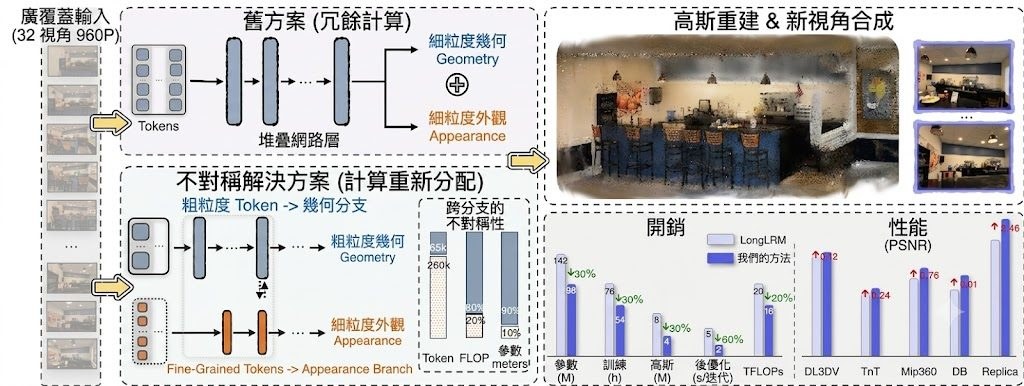
AsySplat 是一個用於 3D Gaussian Splatting 的重建框架,主力解決長序列、廣覆蓋場景做新視角合成時,訓練和推理都太重的問題。現階段這個 GitHub 儲存庫主要提供項目頁、論文連結和資源,程式碼尚未公開,所以要理解它,重點放在方法設計而不是直接安裝部署。

它的做法是把 geometry branch 和 appearance branch 分開,前者處理較粗粒度的資訊,後者用較少參數補回外觀細節,再用 bilateral connections 互相引導。這種取向和一般把所有資訊一起硬塞進去的做法不同,目標是把算力用在更值得的位置。

從現有資料看,AsySplat 比較適合做多視角場景重建、研究級新視角合成,或需要在較大輸入規模下控制訓練成本的團隊。同時使用 sparse attention module,結合 convolution blocks 和 self attention 來減少開銷,並在 32-view 960P 輸入上取得較少參數和較低訓練、推理負擔的結果。

  • 類型:3D Gaussian Splatting 重建框架
  • 目標:降低 wide-coverage scene modeling 的重複計算
  • 特色:幾何與外觀分流處理,再以 bilateral connections 協調
  • 效能:在 32-view 960P 設定下,宣稱比之前的 generalizable models 更省參數和開銷
  • 相關模型:3D Gaussian Splatting、generalizable 3DGS models、novel view synthesis (NVS)
項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港城市大學, 香港, 3D, Dataset 數據集

VIABench 視覺模型如何協助失明應用

不少影片模型識描述畫面,未必識幫人做決定。VIABench 把測試搬到視障人士日常片段,重點睇模型能否提供真正有用的協助。

VIABench cover

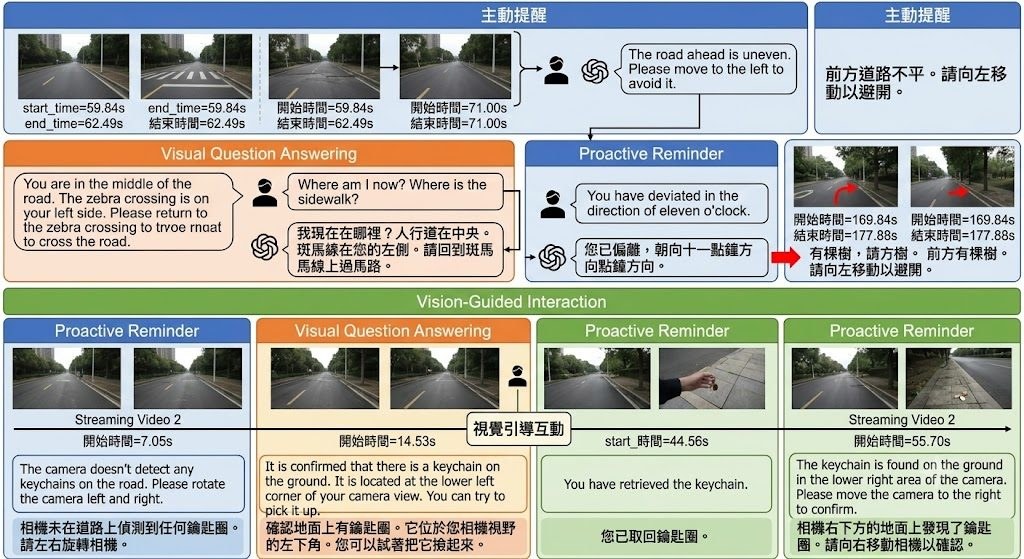
講到視覺模型,很多測試仍然停留在「見到乜、答到乜」;VIABench 把焦點轉去更貼身的助盲情境,直接檢查多模態大型語言模型可否在日常片段中作出提醒、回答環境問題,甚至按目標提供引導。它屬於Dataset 數據集兼評測基準,處理的是視障協助場景長期缺乏貼地測試標準這個問題。

VIABench 不再只量度被動理解,而是把影片 Multimodal Large Language Models 與真實任務綁在一起。資料來自盲人錄製或分享的第一身影片,包含 761 段影片、46.9 小時內容,以及 14,526 筆人工整理標註,圍繞 Proactive Reminder、Visual Question Answering、Vision-Guided Interaction 三類任務,測試模型會否在合適時間講合適內容。

和常見視覺問答基準相比,VIABench 的分野在於它重視「協助能力」多過一般描述能力。這意味模型不單要看懂畫面,還要判斷何時提醒、如何回應環境細節,以及怎樣支援使用者完成目標;取捨是任務更接近真實世界,但評測難度也更高,單靠表面語意對齊未必夠。

  • 核心價值在於測試影片 MLLMs 能否提供可行協助,而非只做畫面解說
  • 任務覆蓋主動提醒、視覺問答、互動引導三種助盲場景
  • 數據來自真實第一身影片,場景代表性比通用影片基準更強

較適合關注無障礙 AI、assistive technology、video MLLMs 評測的研究團隊,也適合想比較不同模型在真實互動場景表現的人。現有資料已足夠理解它作為基準的定位;使用前較合理的做法,是先查閱論文與 Hugging Face 資料集頁面,再確認支援哪些相關模型與評測設定。

GitHub

Categories: 開源, 南京大學, 視覺模型, 多模態模型, Video, Dataset 數據集

statistical_self_consistency:檢查 LLM 判斷靠唔靠得住

同一個問題換幾種切法,模型答案未必能夠互相對得上。呢個研究項目正正用統計方法量度呢種落差。

Statistical self-consistency in language models

當你想用 Large Language Models(LLMs)去估計某個群體的收入、意見分布或問卷答案,最麻煩唔係模型有冇答,而係同一批人用不同條件拆開再合併之後,結果會唔會前後一致。statistical_self_consistency 針對的正是呢個問題:它屬於研究實驗型程式庫,用二元 conditioning tree 把人群逐層分割,向模型索取各節點估計,再用 law of total probability 重建整體分布,檢查模型輸出有幾接近真正「條件機率」應有的表現。

項目的技術重點唔係再訓練一個新模型,而係替現有 LLM 加上一套 reference-free 的自我檢查方法。它一邊比較重建後的 aggregate 與直接 marginal estimate 是否一致,一邊再用 American Community Survey(ACS)、Global Opinion QA 同 World Values Survey(WVS)的人類統計資料做 alignment 對照。呢個取向同一般只睇單題準確率或 benchmark 分數的做法唔同,因為它更關心模型輸出在統計層面有冇內在矛盾。

資料與執行方式也反映出它偏向研究用途。README 已交代實驗分佈在 src/experiments_acs/src/experiments_global_opinion_qa/src/experiments_wvs/,ACS 與 WVS 亦有對應 data loader;WVS 需要自行從官方網站下載 SPSS 檔案並放到指定資料夾,另有 secrets/secret_config.yaml 儲存 API keys。原始資料沒有提供一鍵部署、公開模型下載或產品化介面,較合理的理解是:你會用它重跑論文實驗、檢查提示設計下的估計穩定性,或者把同類方法接到自己的 LLM 評測流程。

  • 用 binary conditioning trees 檢查 LLM 估計能否在分割與聚合後保持一致
  • 涵蓋 ACS、Global Opinion QA、WVS 三類任務,包含收入估計、跨國意見題與問卷分布
  • 同時做 self-consistency checks 與 human data alignment,唔只看單次回答
  • 依賴外部資料與 API keys,較接近研究驗證流程,未見即裝即用的產品包裝

受益最大的會是做 LLM evaluation、computational social science、survey estimation 或 prompt-based inference 的研究者與團隊。它未有在目前資料中列出完整性能數字,但方法定位相當清楚:不是追求更花巧的生成能力,而是量度模型在條件推斷場景下有幾可信。相關模型名稱在現有資訊中未被具體列出,只能確認此項目面向一般 LLM 實驗,而非綁定單一模型家族。

GitHub

Categories: 開源, API, 框架, Dataset 數據集

UniVR:視覺推理訓練變成可控工作流

UniVR 把 Emu3.5 的視覺推理訓練拆成 SFT 與 GRPO 兩段,讓團隊可用自己的資料同獎勵函數接上去。它更像一個面向視覺任務的訓練骨架,而唔係單一模型。

UniVR Overview

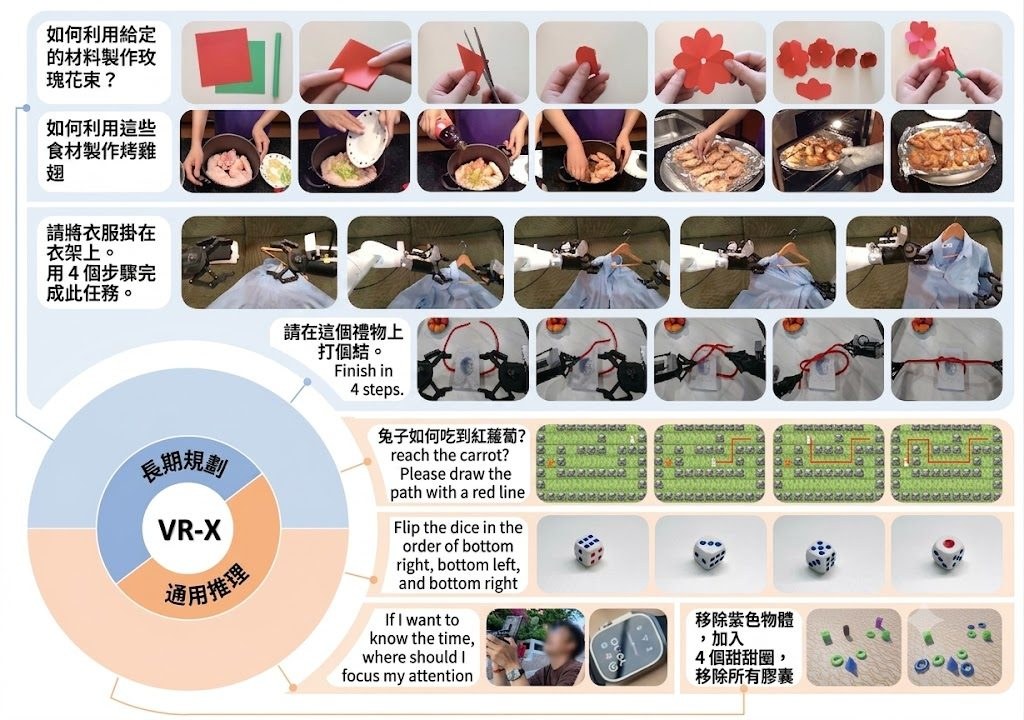
UniVR 係一個能理解我們視覺空間中的思考方式及其在統一視覺推理中的應用,它針對 Emu3.5 unified generative models 的訓練框架,處理的是視覺推理、長程規劃同結果判斷點樣一齊學。它唔係拿來直接做推理展示,而係俾你用自己的資料同獎勵訊號,去微調一個已經懂得處理圖像與文字的底座模型。

SFT(supervised fine-tuning)階段要提供統一格式的樣本:query image、textual instruction、visual reasoning trajectory;RL(reinforcement learning)階段則改成透過 HTTP reward server 送回分數。原始資料沒有提供完整安裝流程,所以目前可確定的只有要把自定義 PyTorch Dataset 接入 UniVR_SFT/train.py,以及把 reward function 換成自己的服務。

和一般只做單次微調的做法相比,UniVR 的取向更偏向「先教格式,再用獎勵修正推理」。它在 RL 端用 GRPO,並配合 HybridEngine 與 Emu3.5 的 vLLM patch,強調 rollout 效率;同時保留 LoRA 同 full-parameter training,適合資源與改動幅度唔同的團隊。

  • 支援多節點 SFT,兼容 LoRA 同 full-parameter training
  • RL 端基於 verl,同 GRPO 搭配自訂 HybridEngine
  • Emu3.5 的 vLLM no-CFG parallel inference 可做到約 2 倍 throughput
  • 獎勵設計分成 format reward、global reward,同 step-level 的視覺推理約束
  • 相關模型包括 Emu3.5 同作為評分器的 Qwen3-VL-30B

較容易受惠的情境包括做視覺代理、機械臂/操作規劃、長程任務推理,或者想將現成視覺模型轉成自己工作流的團隊。它的價值在於把「資料格式、推理軌跡、獎勵判斷」串成同一條訓練路線,令視覺任務唔再只靠靜態標註去學。

項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Gemini, Image, Python, Dataset 數據集

VideoChat3 一個睇得耐又睇得準的影片模型

要同一個模型同時處理細微動作、長片理解同直播回應,一向好難。VideoChat3 把重點放在時序理解同效率,定位相當清晰。

VideoChat3 logo

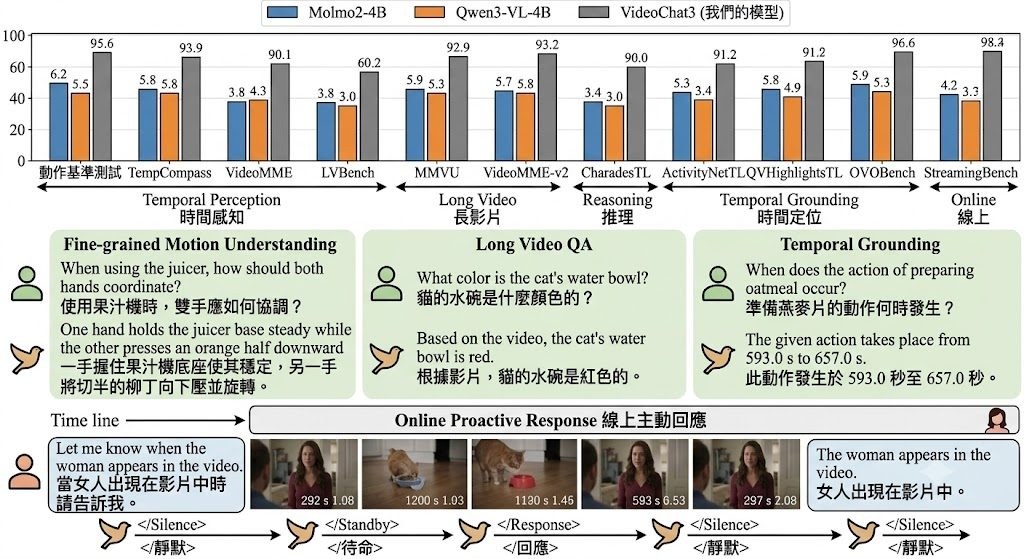
影片理解最麻煩的地方,往往唔係「識唔識睇」,而係要一邊保留動作細節,一邊捱得住長時間片段。VideoChat3 就係朝住呢個矛盾落手:它屬於多模態模型(Multimodal Large Language Model, MLLM),目標係用同一個 4B 模型處理細微動作、長片推理、temporal grounding 同 live streaming 回應。

同類項目好多時只會專注其中一段工作流,例如短片動作辨識,或者長片問答。VideoChat3 的取向係做 generalist video understanding,代價就唔係追求單一場景最極致的規格,而係用 I3D-ViT 同 Adaptive Frame Resolution 平衡 token 成本、時序證據同延遲,令模型唔需要全程用高成本方式讀完整段影片。

  • 重點唔只係睇單格畫面,而係保留跨時間的證據
  • I3D-ViT 提供 16× spatiotemporal compression,主打效率
  • Adaptive Frame Resolution 會按需要提高畫面解析度,較適合 streaming 場景
  • 已公開 model weights 同完整訓練數據,但 training code 仍未釋出

部署同測試的理解方式幾直接:現階段較接近研究釋出與模型體驗,適合先經 Hugging Face 取用 models & data,再按示範場景驗證長片問答、時間定位同串流回應表現。README 已列明完整訓練資料包括 Academic2M、LV116K、OL617K,對研究團隊、做 video agent、或者要建構影片檢索與監察流程的團隊最有參考價值。

公開資訊亦交代咗幾個關鍵數字:4B parameters、3M curated instruction samples、2,048 frames 下約 20.4s latency。呢啲數據未必代表所有環境都會有同樣效果,但至少講清楚它想證明的方向:唔靠超大模型,都可以把影片中的時間線索、事件關聯同即時反應放入同一套架構。相關模型與模組則以 VideoChat3、I3D-ViT、Adaptive Frame Resolution 為核心,整體更似一個面向研究與進階應用的開源影片理解項目。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, 模型, 視覺模型, 多模態模型, Video, 框架, 3D

SearchOS:把搜尋變成像作業系統排程一樣的多代理協作

面對開放領域的複雜提問,多數 AI 搜尋都困在對話歷史裡打轉。SearchOS 把問題拆成一張覆蓋表,由多個子代理平行補齊每個空格,最後交出一份附引用的答案。

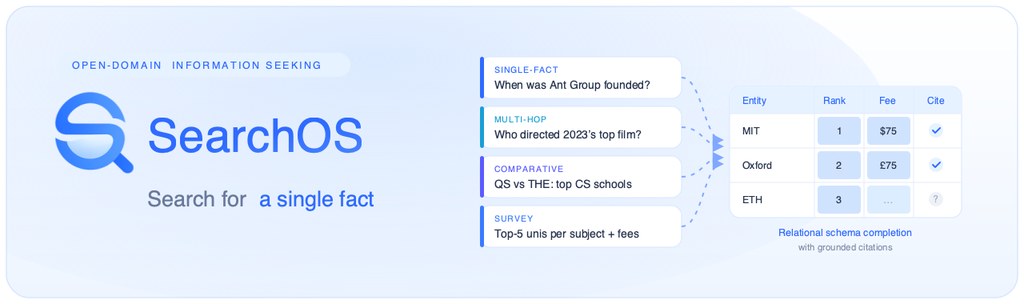
SearchOS — from single-fact lookups to full-domain research, unified as citation-grounded relational schema completion

開放領域搜尋最常見的瓶頸,不是模型不夠聰明,而是任務一複雜,搜尋狀態就會淹沒在對話紀錄裡,代理開始遺忘、繞圈、重複。SearchOS 嘗試解決的正是這個卡位:它把搜尋狀態從對話裡抽離,放進一個像檔案系統一樣的常駐層,由 Search-Oriented Context Management(SOCM)統一管理任務序列、證據圖和覆蓋表。

這個開源框架以 LangGraph 為骨幹,把提問先正規化成 entity × attribute 的覆蓋表,再把空格派給多個 pipeline-parallel 子代理去填。每格證據都帶著來源寫入共享的證據圖,最後由合成階段產出附引用的答案。整體端到端耗時接近最慢的那條單鏈,而不是各鏈相加。內建 sensor 機制會偵測五種迴圈或停滯,必要時重新派工。

Introduce SearchOS: Agentic Search Operating System

Skills 系統與 SF PROVIDER 讓它能處理反爬、登入牆,也能對接多家搜尋供應商。對做深度研究、競品盤點、盡職調查的團隊來說,這種「每個結論都追得到來源」的設計,比單純的長上下文檢索更貼近真正的工作場景。需要留意的是,覆蓋表驅動的設計在簡單事實查詢上略嫌重,平行代理也會增加 API 成本;但對於需要高召回、可審核的研究任務,差異是明顯的。

GitHub

Categories: 開源, Agentic, API, LangGraph, Skill 技能

KeyFrame-Compass:關鍵幀尺度評測

想知道影片生成有沒有跟住關鍵畫面,KeyFrame-Compass 就把這個矛盾拆開量度。它同時看畫面有沒有到位、順序有沒有跟足,還會檢查整體影片質感。

KeyFrame-Compass benchmark domains and examples

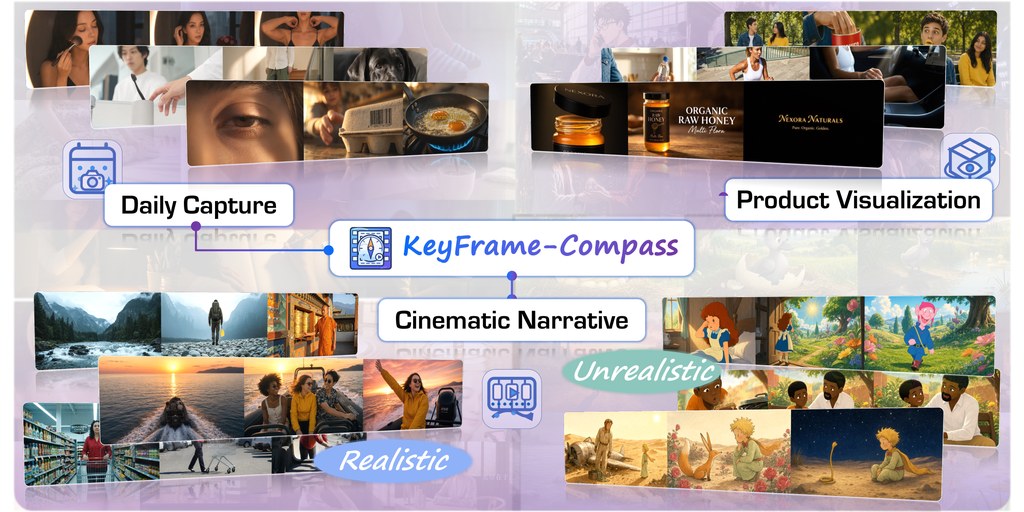
KeyFrame-Compass 是一個用來評測 keyframe-conditioned video generation 的基準項目,重點在於檢查模型能否同時跟住文字提示同一組按順序排列的 keyframes 生成影片。對做影片生成的人來說,這類測試最有價值的地方,是它不只看成片好不好看,還會追問畫面有沒有真係按要求出現、順序有沒有走樣。

這個項目把評測拆成兩層:一層看 keyframe execution,包括關鍵畫面存在、視覺還原、時間順序、定位、持續性同回應唯一性;另一層看 overall video quality,會用 evidence-grounded MLLM(Multimodal Large Language Model, MLLM)判斷,加上專門的感知模型去量度視覺質素、時間連貫性、指令遵從同音訊表現。這種分法比單純比對整體分數更清楚,因為它能分辨出模型係「畫得靚」定「跟得準」。

官方提供 386 個案例,涵蓋三個應用領域,亦分有 multi-shot 同 one-take 片段,配合四種 keyframe 密度。安裝上需要 Linux、Conda 或 Mamba、NVIDIA GPU,同埋可用的 VLM API;倉庫亦提供 envsassetsall 三種設定模式,方便只建環境、只拉資產,或者一次過做完整驗證。

  • 把影片生成的「跟畫面」同「成片質感」分開量度,結果較容易解讀
  • 支援不同 keyframe 密度,較適合比較模型對控制力的穩定度
  • 適合做影片生成模型、研究原型或產品 demo 的質量驗證
  • 需要 GPU 同外部 VLM API,部署門檻唔算低
  • 相關模型類別可歸到 Video、視覺模型、多模態模型、模型、工具

GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Gemini, API, Video, 工具, Linux

MultiRef-Compass:多模態影片不再各自為政

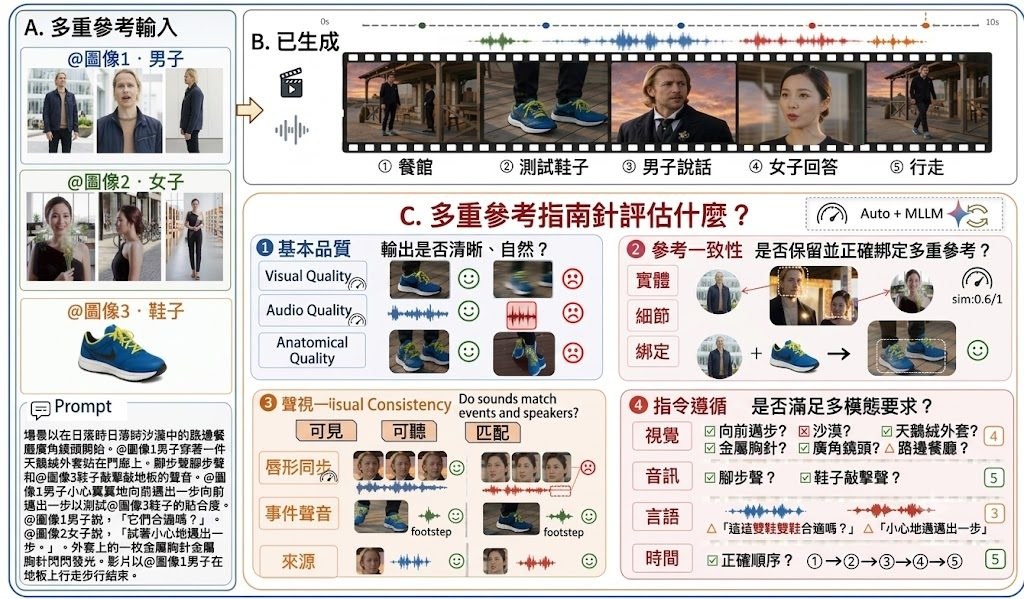
做多模態影片生成,最難往往唔係出片,而係點樣公平比較結果。MultiRef-Compass 把文字、影像參考同音訊參考放入同一套評測流程。

MultiRef-Compass overview

同一段生成影片,畫面可能順眼、聲畫卻唔對位;角色外觀接近參考圖,指令跟從又未必準。MultiRef-Compass 抓住呢種常見落差,定位成一個開源評測工具包,處理 multi-reference multimodal video generation 的比較問題,重點唔係逐條片人手睇,而係用可重現的方法把不同模型放到同一把尺上量度。

它的取向相當明確:偏向研究比較,而唔係臨時檢查作品。項目用固定的 CSV 輸入欄位,接收文字、視覺參考、音訊參考同生成影片,再輸出 per_sample.csvmodel_summary.csvranking.mddetails.json。這種設計的好處,是團隊可以用同一批樣本反覆測不同模型;代價是流程較講究資料整理,較適合已有實驗管線的人。

跟只看單一分數的做法相比,MultiRef-Compass 把結果拆成四組共 14 個公開指標,包括 Basic Quality、Entity Fidelity、Audio-Video Consistency 同 Instruction Following。它同時混合 classical media-analysis pipelines、learned quality models、speaker embeddings,以及 multimodal language model judges,所以看到的不只是整體高低,仲會知道問題出在 anatomy、reference fidelity、voice timbre similarity,定係 temporal order。

  • 用統一 schema 比較不同影片生成模型,較容易做橫向排名
  • 保留 sample-level diagnosis,同時支援 model-level ranking
  • 支援 text、visual-reference、audio-reference 三種條件一齊評測
  • 著重公開 metric taxonomy,同類研究較易重現結果

現有資訊未見到完整安裝細節,但理解方式已很清楚:先準備符合欄位要求的 CSV manifest,再按指標群組跑評測後端。受益最大的,會是做多模態影片生成、聲畫對齊、角色一致性與指令跟從研究的團隊。相關能力圍繞 Visual Quality、Audio Quality、Entity Fidelity、Speech-Lip Synchronization、Voice Timbre Similarity 等指標展開;它未必幫你直接提升模型質素,卻能先把模型到底差在哪一環講清楚。

GitHub · 模型

Categories: 開源, Embedding, 多模態模型, 視頻模型, Video, Audio, 語音

BadWAM 直指 World-Action Models 盲點

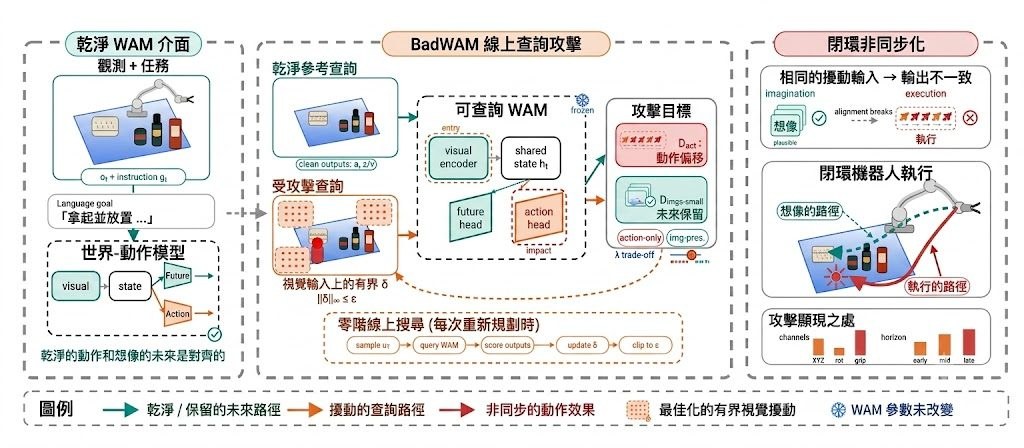
BadWAM唔係做更強控制,而係專門測試 World-Action Models 會點樣「想得啱、做錯事」。對研究機械人安全同對抗攻擊的人來說,呢類偏移比一般失敗更值得警惕。

Repository image for LiQiiiii/BadWAM

當一個 World-Action Models(WAMs)睇落仍然能夠預測合理未來,但實際控制已經被悄悄帶偏,問題就唔再只是準確率高低。BadWAM 屬於研究型安全測試框架,集中模擬 World-Action Drift Attacks,用細微視覺擾動去拆開「想像」同「行動」之間原本應該對齊的部分。

呢個項目的價值,在於它唔係單純證明模型會失手,而係指出一種更難察覺的失效方式:未來預測仍然似樣,行動卻已經朝向任務失敗。相比一般只睇輸出有冇偏移的對抗攻擊做法,BadWAM更貼近 WAM 的結構特性,分成 Action-only Adversarial Attack 同 Imagination-preserving Adversarial Attack 兩條路線,後者尤其針對「表面正常、實際出錯」的情況。

重點可先睇幾項:
– 支援 query-based 攻擊,重點在凍結的 WAM 上做線上搜尋
– 提供 LIBERO closed-loop attack evaluation,唔只停留在單步分析
– 包含 matched-strength stealth analysis 同 ablation experiments
– 內附 statistics export 與 plotting utilities,方便整理結果

從部署角度看,儲存庫提供的是研究代碼而唔係開箱即用套件,基礎環境指向 Python 3.10+,並建基於 FastWAM。README 亦講明未附 model checkpoints、LIBERO data、dataset statistics、RoboTwin assets 同實驗輸出,所以要重現結果,仍然要自行補齊相關資源與依賴。

現有公開結果已經說明這個框架唔只係概念展示。在 LIBERO closed-loop 測試中,action-only WAM 成功率由 96.5% 跌到 43.1%,joint WAM 亦由 98.1% 跌到 61.5%。受益最大的會係做機械人控制、WAM 安全、對抗魯棒性測試的研究團隊;對一般應用開發者來說,它未必直接幫你部署產品,但很適合作為檢查模型是否「睇落可靠、其實已偏航」的驗證工具。

項目主頁 · GitHub

Categories: 開源, 香港理工大學, 世界模型, 框架, 香港, Python, 安全, Dataset 數據集

Kimi K3 把開源大模型推到 3T 級別

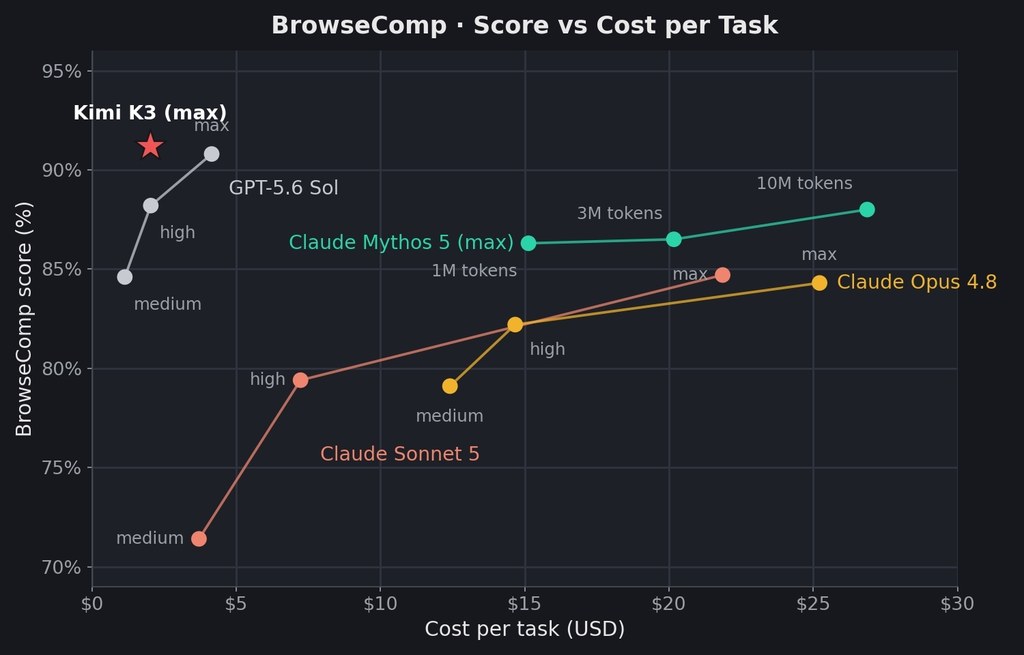
想要一個同時處理寫碼、長文件同推理工作的模型,Kimi K3值得留意。它未追平最強閉源模型,但已把開源模型的上限再推高一截。

Kimi K3 hero visual

長上下文、程式開發同知識工作往往要分開交畀不同模型處理,Kimi K3嘗試把這幾件事收在同一個開放模型內。它屬於大型多模態模型,重點是處理長流程 coding、長篇資料閱讀與推理之間的切換成本,並提供原生 vision 能力與 1M context。

Kimi K3 的定位,不是單靠參數規模取勝,而是想在開源路線上逼近 frontier intelligence。資料提到它有 2.8T parameters,屬於首個 open 3T-class model,整體表現仍落後於 Claude Fable 5 和 GPT 5.6 Sol,但在自家 evaluation suite 內已持續超過其他被測模型,顯示它在開源陣營有明顯競爭力。

技術上,這個模型建基於 Kimi Delta Attention(KDA)同 Attention Residuals(AttnRes),目的是改善資訊在長序列與深層網絡中的流動方式;同時也擴大了 Mixture of Experts(MoE)sparsity。這種做法反映它要處理的核心矛盾:一邊維持超長 context 與多類任務能力,一邊控制推理與訓練效率。

  • 首個 open 3T-class model,規模達 2.8T parameters
  • 原生支援 vision,並提供 1M context window
  • 目標場景包括 long-horizon coding、knowledge work 同 reasoning
  • 採用 Kimi Delta Attention(KDA)、Attention Residuals(AttnRes)與 Mixture of Experts(MoE)
  • 已在 Kimi.com、Kimi Work、Kimi Code 同 Kimi API 提供使用

對開發者、研究者同需要長文檔工作流的人來說,Kimi K3最有吸引力的地方,在於它把「夠長、夠廣、夠開放」放在同一個項目裡。現階段可確認的限制也很清楚:它未到最強閉源模型的水平,而完整權重、架構與訓練細節仍要等後續 technical report 與正式釋出。

項目主頁

Categories: 開源, Agentic, 多模態模型, API, Vibe Coding, 教學, 線上服務, IDE, Mac, 編程, OpenClaw

Page 33 of 92
1 31 32 33 34 35 92