OpenWorker – Andrew Ng 開發桌面 AI 龍蝦

OpenWorker 係一個開源嘅桌面 AI 同事,由 Andrew Ng 團隊開發,強調本地執行、帶自己嘅模型 API key,並且會產出真正嘅成品而唔止係聊天回覆。

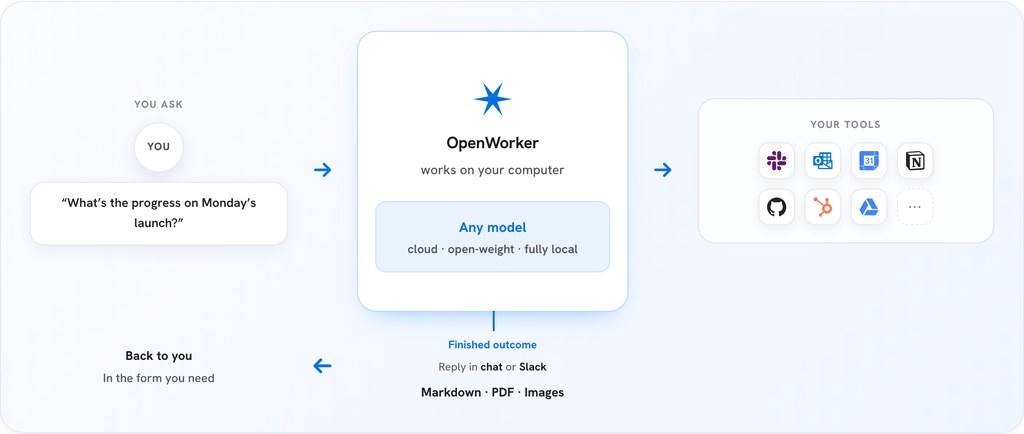
How OpenWorker works

對好多打工仔嚟講,最大嘅困擾唔係 AI 唔夠聰明,而係佢只識得「答問題」而唔識得「做完件事」。OpenWorker 嘅切入點正正喺呢度:佢定位係一個會跑喺你電腦上面嘅 AI 同事,可以幫你整理 calendar、寫 follow-up email、甚至自動出一份 customer brief,最後畀你一份可以直接開嚟用嘅文件,唔係一串對話。

OpenWorker 由 Andrew Ng(吳恩達)相關團隊推出,引擎建基於佢哋自己開發嘅 Python 開源庫 aisuite,呢個庫提供統一嘅 chat-completions API 以及支援工具調用(tool calling)、MCP 等功能。簡單講,OpenWorker 唔係從零寫起嘅 wrapper,而係將 aisuite 包成一個真正面向桌面用戶嘅應用,並且喺原本 aisuite 倉庫入面開發咗一段時間之後,先搬出嚟獨立成 repo。

目前支援 macOS(Apple Silicon)以及 Windows 10/11,用家可以貼上自己嘅 API key 去用 OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi、Qwen、Mistral 等模型,亦可以經 Ollama 完全本地跑開源模型。所有嘢都喺本機行,只有用家授權嘅 model call 或者連接工具先會接觸到網絡。對於注重私隱或者公司政策唔畀數據出 cloud 嘅人,呢個係一個幾實際嘅選擇。

OPENWORKER: The Free AI Desktop Agent That Isn't Locked to One Model

佢亦內建 25+ 個整合,包括 GitHub、Slack、Jira、Notion、Linear、HubSpot、Outlook、Gmail、Google Calendar 等,亦支援任何可以經 MCP(Model Context Protocol)接駁到嘅工具。最令筆者欣賞嘅係佢嘅審批機制:寫訊息、發送郵件、執行 shell 指令呢類「對外有影響」嘅動作,全部都要先經你確認先至會執行,唔會自己靜靜雞撳掣。

以下係幾個用家會比較關心嘅重點:

  • 定位係桌面 AI 同事,目標係交到「成品」而唔止係聊天回覆,例如 HTML brief、Markdown 報告、排好嘅 calendar 更新等。
  • 完全開源、MIT 授權,由 Andrew Ng 團隊開發,引擎建基於佢哋嘅 aisuite 開源庫。
  • 模型自選,支援多間主流 cloud provider,亦可以經 Ollama 完全本地執行開源模型。
  • 重視私隱,對話、token、API key 都儲喺本機 secret store,唔需要登入亦可以用。
  • MCP + 審批機制,所有對外動作(發訊息、執行指令)都會先問過你先做,減低「AI 自行撳掣」嘅風險。

如果你係一個人或者小型團隊,想搵一個可以幫你「跑手」而唔係淨係「傾偈」嘅 AI 工具,又唔想將公司敏感資料送去閉源服務,OpenWorker 算係一個值得試嘅選擇。佢而家仲喺 open beta,官方表示會自動更新、不斷執吓啲 bugs,畀用家提交 issue。適合想認真將 AI 融入日常工作流、對私隱同可控性有要求嘅人。
項目主頁 · GitHub

Categories: 開源, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Ollama, Python, Anthropic, 蘋果, Kimi

eeg-difflogic:邊緣 EEG 分類改用邏輯電路

這個項目把 EEG 分類從浮點神經網絡,轉向可直接編譯成布林電路的 Diff-Logic。你可以把它理解成一種更貼近邊緣裝置限制的做法,重點放在低延遲與記憶體壓力。

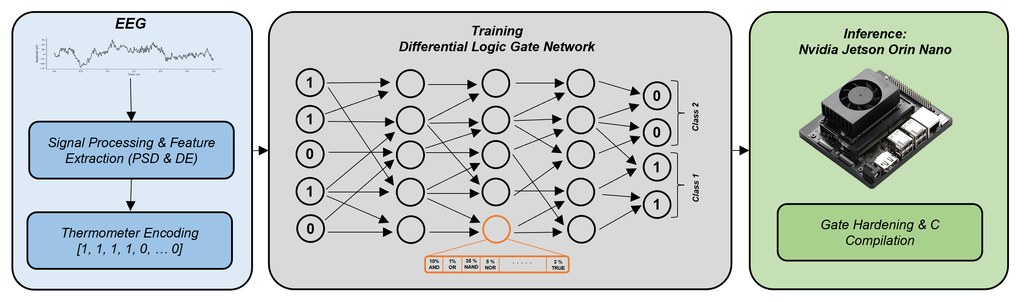
Workflow for EEG classification using differentiable logic gate networks

這份項目對準的是要在邊緣裝置即時分析 EEG 的場景,核心矛盾很直接:傳統神經網絡雖然準,但浮點運算和記憶體開銷會拖慢部署。它屬於研究型工具/框架,處理的是把 Differentiable Logic Gate Networks (Diff-Logic) 用在 EEG 分類,並在推理階段編譯成 Boolean circuits,以 bitwise CPU operations 跑得更輕。

作者同時看了兩類任務:臨床失智分類與情緒辨識。前者用 Power Spectral Density (PSD),後者用 Differential Entropy (DE),再配合 fold-wise Min-Max normalization、thermometer encoding 和多層 differentiable logic gates,最後把學到的 soft gates 硬化成可執行的布林電路。

和 Multi-Layer Perceptrons (MLPs) 及 Binarized Neural Networks (BNNs) 比起來,這個項目不追求單純堆大模型,而是用 iso-parameter evaluation 去看同等參數量下的表現與效率。論文報告在 dementia screening 上 Diff-Logic 拿到 80.2% Macro F1,較 MLP 高 6.8%;在 emotion recognition 上 MLP 準度略有優勢,但部署到 NVIDIA Jetson Orin Nano 單核心 CPU 時,延遲高 2.3 倍、模型體積大 14 倍。

  • 推理路徑清楚:先訓練,再轉成 Boolean circuits 做 inference
  • 適合關心低延遲、低記憶體、能在 edge device 跑的 EEG 系統
  • 評測覆蓋 CN vs. AD、CN vs. FTD,以及三類情緒辨識資料集
  • 在較大規模下,Diff-Logic 的推理時間幾乎保持不變
  • 這個項目最有價值的地方,不在於取代所有 EEG 模型,而是在資源受限環境下提供另一條更貼近硬件的路線

GitHub · Paper

Categories: 開源, 模型, NVIDIA, 框架, Medical醫學, Dataset 數據集

TrajLoc 把路線描述對準衛星圖

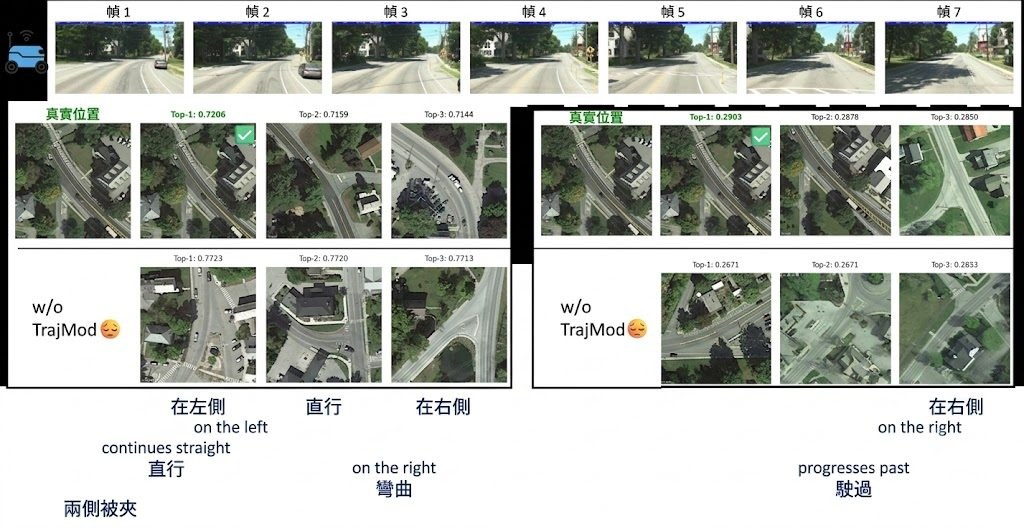
單張街景未必足夠判斷位置,TrajLoc改為沿住整段路線做比對。影片、文字敘述,甚至兩者一齊用,都可以指向同一塊衛星瓦片。

A trajectory can be queried as dense video or as abstract language — both retrieve the same satellite tile.

只靠一張街景相去配對衛星圖,遇到轉彎、路口相似、視角受限時好容易失手;TrajLoc改為追蹤整段移動路線,將街景影片、自然語言路線描述,或者兩者結合後對應到帶地理標記的衛星瓦片。它屬於跨視角 geo-localization 模型連同 benchmark 項目,處理的是「把連續路徑準確放回地圖」這個問題。

現有 cross-view 資料多數停留在 single-image、video-only 或 text-only 範式,作者認為這樣會拆散同一條路線入面本來互相補強的時序線索與語意線索,因此一併推出 SeqGeo-VL。呢個 benchmark 收錄 38,863 組對齊的 video-text-satellite triplets,並有 91.8% human verification pass rate,重點不是再加大資料量,而是把 sequential 同 linguistic 兩種證據放入同一任務。

TrajLoc沒有另起一套龐大時序架構,而是由 pretrained CLIP ViT-L/14 延伸成 video、text 同 satellite encoders,再用 co-training curriculum 將三種查詢模式放入同一個表示空間。作者另外加入 TrajMod,將路線幾何資訊 tau={(Δx_i, Δy_i, θ_i)} 轉成 FiLM 的 scale/shift 參數,直接調節 query embedding;做法比單靠提示詞更明確,亦保留 frozen encoders 的可重用性。

  • 支援 video、plain language、video+text 三種查詢方式
  • SeqGeo-VL 是首個同時包含 sequential 與 linguistic cross-view benchmark
  • TrajMod 只用 waypoint offsets 與 headings,不靠 map 或 POI metadata
  • 項目提供 agent-ready tool interface、persistent Python API 同 JSON CLI

從示範與說明看,TrajLoc的定位很清楚:它不是通用多模態聊天模型,而是給 spatial reasoning、戶外機械人、導航研究同 multimodal agents 調用的專門工具。225 ms 的示例檢索速度對互動式流程有吸引力,但目前公開資訊主要集中在 benchmark 與檢索能力,部署前仍要留意資料覆蓋範圍、地區泛化,以及自己的工作流是否真有影片或路線文本可供查詢。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, Embedding, 多模態模型, 模型訓練, Qwen, API, Video, Image, Python, Dataset 數據集

CrisperWhisper 把語音逐字稿變成可控制輸出

同一段錄音,可以要逐字保留停頓與口吃,也可以要乾淨可讀版本。CrisperWhisper 把語音辨識最常混在一起的兩種需求分開處理。

Repository image for nyrahealth/CrisperWhisper

做會議紀錄、訪談整理或臨床語音分析時,最大落差往往唔係辨識到幾多字,而係系統究竟寫出「講咗乜」定「本來想表達乜」。CrisperWhisper 屬於開源語音辨識模型項目,核心價值係將 verbatim 同 intended 兩種轉錄模式變成可明確控制的輸出,令逐字稿唔再受訓練資料風格左右。

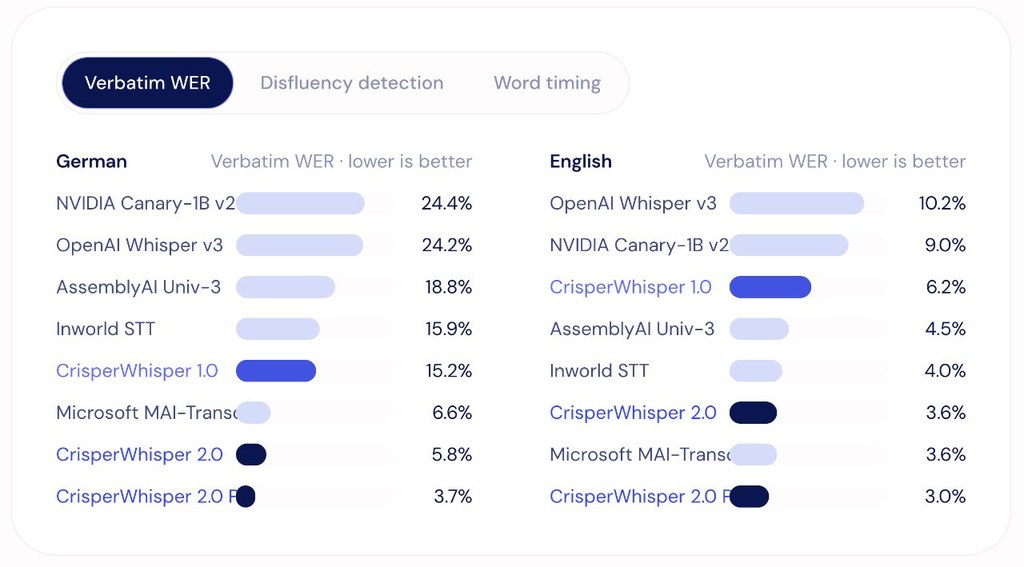
呢個取向同一般 speech-to-text 系統好唔同。常見做法會不一致地刪走 filler、重複、停頓同 cut-off,CrisperWhisper 2.0 就刻意保留呢啲語音細節,或者按需要輸出整理後版本;同一段錄音可以得出兩份用途完全不同嘅文本。對做 TTS 資料整理、醫療或研究訪談分析、需要精準字幕時間碼嘅團隊,呢種分流比單純追求可讀性更有用。

項目另一個關鍵位係時間對齊同長音訊處理。它提供 word-level timings,讀稿語音平均邊界誤差約 30 ms,對話語音約 41 ms;長音訊則用 conditional continuation 避免一般分段轉錄常見嘅重複漏字。README 亦提到推理端基於 CTranslate2,配合 speculative decoding,同時減輕 Whisper 常見 looping-hallucination 問題,方向明顯係朝住 production inference。

  • verbatim 與 intended 兩種模式分開控制,適合同一錄音對應不同工作流
  • 支援 multilingual,覆蓋多數 Whisper 支援語言
  • 可用 Verbatimize 依據音訊加乾淨文本補回真實語氣詞與口誤
  • 長音訊轉錄著重連續性,減少 chunk 邊界造成嘅錯漏
  • Nyra Verbatim Speech Benchmark 以 disfluency F1 等指標衡量保真能力

安裝與部署方向相對清晰:模型可經 PyPI、Hugging Face 同文件使用,推理路線圍繞 CTranslate2 runtime,而唔係只停留喺研究展示。要留意嘅取捨亦好直接,當你要的是可讀、可發布文本,intended 模式更合適;當你要保留猶豫、重複、笑聲同語音事件,verbatim 模式先真正發揮價值。呢個項目唔係單靠更高 WER 成績去吸引人,而係重新界定逐字稿應否忠於說話表面形式,並且用 benchmark 將呢件事量化。

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, 模型, NVIDIA, Medical醫學, 語音, Dataset 數據集

Self Gradient Forcing 補長影片一致性缺口

短片訓練、長片生成之間最易出事的,往往是角色走樣同場景漂移。Self Gradient Forcing想補上的,正正是長時間影片外推時失掉的記憶監督。

Self Gradient Forcing teaser

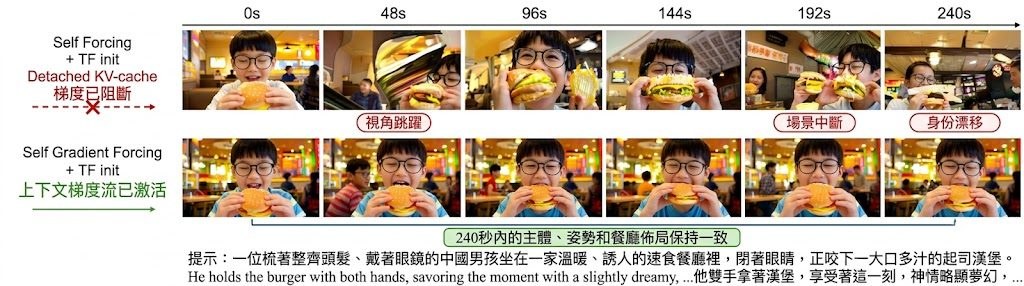
生成影片拉長到幾分鐘之後,角色樣貌、鏡頭方位同場景佈局愈來愈唔穩,往往不是畫質問題,而是模型早段寫入的歷史記憶愈來愈幫不到後面幀。Self Gradient Forcing(SGF)屬於訓練方法項目,核心是替自回歸影片擴散模型補回一段原本缺失的 context-gradient path,處理 long-video extrapolation 時常見的 identity drift、scene break 同 temporal instability。

作者點名現有做法多建基於 Self Forcing:模型用自己 rollout 出來的歷史作訓練,的確能減少 exposure bias,但 historical key-value cache 在後續生成裡只是 frozen rollout state,未能讓未來幀的損失回頭教早前的記憶應該怎樣寫得更有用。SGF 的做法是 bounded two-pass replay,第一輪先照推理方式無梯度 rollout,第二輪只重建抽樣步驟所需的 context-gradient,避開完整長序列反向傳播的成本,同時保住 causal memory 的可訓練性。

項目現時已放出訓練碼、推理碼同 checkpoint,底層接到 Wan2.1-T2V-1.3B 與 Wan2.1-T2V-14B,亦依賴 Causal-Forcing 的初始化權重。配置分成 framewise 同 chunkwise 兩路,預設推理可生成 963 個 latent frames,解碼後約 240 秒、16 fps,環境足夠時會用 8 GPUs,否則退回單卡串行生成;這個門檻說明它較接近研究與算力密集型內容生產流程,而不是輕量即開即用工具。

  • 針對 Self Forcing 的 historical context-gradient gap,而不是單純調參延長影片
  • 用 bounded two-pass replay 補監督,取捨在於訓練更複雜,但比全序列回傳梯度更可控
  • 同時提供 framewise 與 chunkwise 設定,方便比較不同長片生成路線
  • 依賴 Wan 基座模型與 Causal-Forcing 初始化,部署前要先備好對應權重

就已公開描述來看,SGF 的價值不在另起一套全新生成架構,而是在保留 native autoregressive training objective 的前提下,修正自生成記憶無法被未來損失有效監督的缺口。對研究 long-horizon video generation、需要單一 prompt 與 seed 維持數分鐘敘事一致性的團隊,這個項目有相當清晰的參考價值。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, 模型訓練, Video

ActiveVision 點出視覺推理真空帶

望一眼答題的多模態模型,在 ActiveVision 幾乎集體失靈。這個 benchmark 把「要一路觀察先答到」的能力,拆成更貼近人類解題節奏的測試。

ActiveVision — An Exam for Active Observers. Vision is a loop, not a glance.

不少視覺題目唔係靠一眼辨認,而係要沿住線追、逐區域數、一步步核對先答得到;ActiveVision 正正針對呢種落差而來。作為一個 benchmark,它集中測試 iterative visual reasoning,處理的是模型看得到畫面,但未必能持續整理觀察過程的問題。

現有多模態模型常見做法是對單張圖作一次性判讀,再配合 chain-of-thought 直接作答;作者認為這種 single-glance 範式,對需要反覆掃描、追蹤順序與維持中間狀態的題型特別吃力。ActiveVision 因此設計了 17 個任務,並用 deterministic program 生成場景,再以 photorealistic 方式重繪,令畫面自然之餘仍保留可驗證結構。

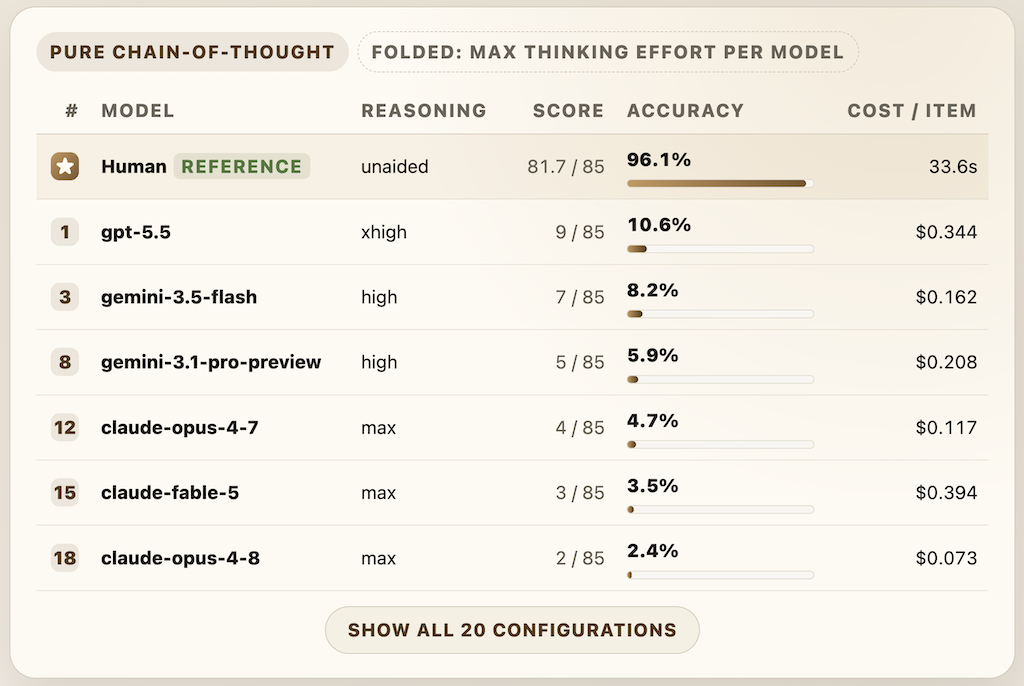
數字相當直接:人類表現為 96.1%,前沿模型在官方無工具評測下最高約 10.6%,差距接近 9 倍。網站亦列出 agent 版本的 tool-use ablation,像 Claude Code 與 Codex 接入工具後,分數明顯高過純 chain-of-thought,表示問題未必只是「看不懂圖」,而是缺少可逐步外化與操作的解題流程。

  • 收錄 17 個任務,重點放在 distributed scanning 與 sequential traversal 一類逐步觀察題
  • 官方評測涵蓋 Claude、GPT、Gemini,亦提供 agent ablation 腳本
  • 數據集可經 Hugging Face 下載,評測程式以 Python 為主
  • 同一靜態圖片也能迫使模型做多步推理,唔靠影片輸入撐起難度

整個 GitHub 項目比較像研究與評測基建,而唔係即用型產品:你需要先下載數據集、配置對應供應商 API,然後用 repo 內的 eval 腳本跑結果。對做多模態模型評測、Agentic 工作流、或者想驗證 Computer-use agents、CUAs 式外部工具協作價值的團隊,它提供了一個很尖銳的檢查點:模型是否真的會「觀察」,還是只會對影像作高階猜測。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 多模態模型, OpenAI, Gemini, API, Python, Anthropic, Dataset 數據集

RIPO 直指 LLM 強化學習探索崩塌

RIPO 不是再調一個 PPO-Clip 變體,而是直接質疑量度策略差異的方法。對想提升 LLM 推理訓練穩定度的人,這個方向值得留意。

Repository image for Aiolus-X/RIPO

訓練 LLM 做長鏈推理時,最麻煩的不只是算力,而是策略很容易愈學愈保守,最後卡在少數高機率答案附近。RIPO 屬於一個面向 LLM 強化學習的演算法研究項目,針對的正是 PPO-Clip 在後訓練階段常見的 exploration collapse,想解決罕見但關鍵動作愈來愈難被探索到的問題。

作者沒有沿用「再補幾個 heuristic」的路線,而是直接指出舊範式的核心錯位:PPO-Clip 以 Euclidean metric 量度 policy discrepancy,但 policy 本身更貼近一個 Riemannian manifold。呢個幾何不一致會令低機率區域更新過份保守、高機率區域又過份進取,最後令探索能力收縮;Riemannian Isometric Policy Optimization(RIPO)則改為追求等距的 policy update,嘗試同時守住 exploration 與 exploitation 的平衡。

論文描述中,RIPO 另一個重點是 bias-variance trade-off 較理想,令優化過程更穩定。成效方面,它在七個 competition-level benchmarks 上都優於既有 LLM RL algorithms,當中對 GRPO 在 AIME24 的提升最高可達 60%;這類結果相當吸引,但仍然要留意 benchmark 與訓練設置是否能完整轉移到你手上的模型與資料。

  • 核心批評很明確:PPO-Clip 的幾何假設不適合 policy update
  • 方法重心不是加獎勵技巧,而是重寫策略更新的度量方式
  • 對數學推理、長時序決策這類要靠探索找到解法的訓練場景較有價值
  • 成績亮眼,但更適合有能力重跑 benchmark 與訓練流程的研究團隊驗證

從提供的 GitHub 資訊看,儲存庫描述混入了 verl 這個 RL training library 的內容,因此閱讀與部署前要先分清:RIPO 是演算法與論文方向,verl 則較像承載 LLM RL 訓練流程的開源基建。較合理的理解方式,是把 RIPO 視為可整合進現有 LLM RL framework 的新策略更新方法;真正落地通常要配合既有訓練庫、GPU 叢集配置,以及像 GRPO、PPO 一類後訓練 dataflow 一起測試。

GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型訓練, OpenAI, 框架, , Anthropic, Dataset 數據集

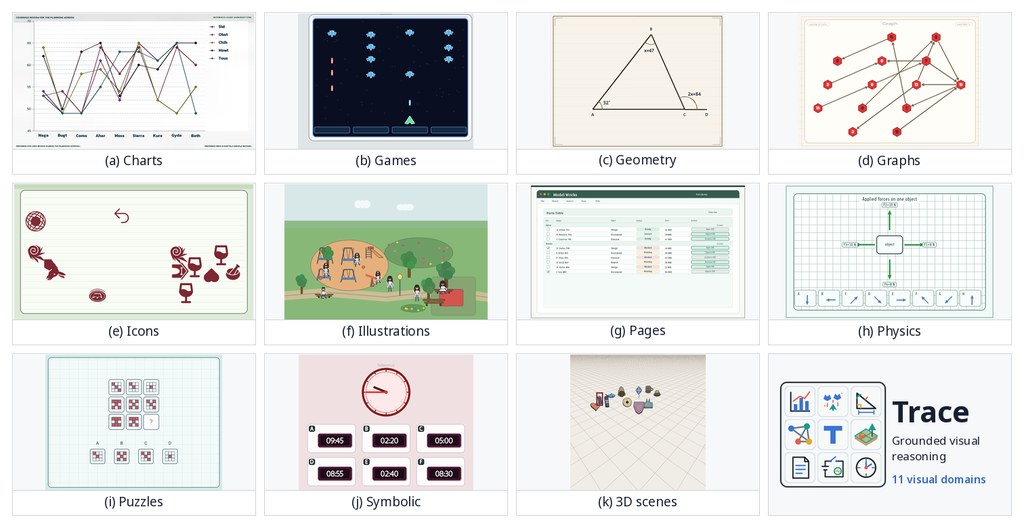
Trace 用可驗證資料重做視覺推理訓練

想訓練視覺模型識得真係推理,而唔係靠題型記憶,Trace提供咗一套可重播、可核對的資料生成方法。它不只出題,連答案點樣得來都一併保留。

trace mark

很多視覺推理資料集都只交付圖片同答案,模型答啱咗,未必代表推理過程真係站得住腳。Trace把重點放在可驗證 post-training:它屬於一個資料集兼生成環境,針對的問題是怎樣穩定產生 grounded visual-reasoning 任務,並且讓答案、標註與驗證流程互相對得上。

它採用一條很清晰的生成路線:domain → scene grammar → task program。現有做法常見是先有人手整理題目,或者由圖像與文字鬆散配對,再用最終答案做監督;Trace則用 deterministic seed 先建立 semantic scene state,再由 task program 從同一個狀態推導 typed answer、verifier state,最後才渲染圖片與提示。這種 shared-state 設計的分別,在於題目不是「生成完再補標註」,而是從源頭就把圖像、問題、答案同 execution trace 綁定。

對研究團隊來說,這個取向很有吸引力,因為它同時照顧訓練、檢查同重播。每個例子除了 image、prompt、typed answer,還有 image-space annotation、verifier metadata 同 execution trace;對想做 RLVR、後訓練驗證,或者想分析模型到底錯在觀察、計算還是規則理解的人,資料密度比一般 benchmark 高得多。

  • 收錄 11 個 visual domains、277 個 scene grammars、1,000 個任務
  • 已公開 66,000 個 generated examples,亦提供 Hugging Face dataset 與模型檢查點
  • 驗證不只看最終答案,還保留 verifier state 與 replayable execution trace
  • 以 Qwen2.5-VL-3B、Qwen2.5-VL-7B 做 post-training,兩個尺度都有明顯提升

數字上,它在 2,000 個未見過、但由同一批 task programs 生成的新例子上,將 Qwen2.5-VL-3B 由 24.45 提升到 41.05,Qwen2.5-VL-7B 由 34.25 提升到 51.55。這些結果首先說明 Trace對同分佈泛化有幫助;首頁亦提到用 64,000 個 Trace instances 訓練後,對 24 個外部 benchmarks 的 macro-average 也有改善,但摘要資訊未列完整分項,解讀時仍要看原始報告。

Trace最適合被理解為一個用來建構可核對視覺推理訓練資料的基礎項目,而不只是另一個出題庫。它的取捨也很明確:換來高度可驗證與可重播,代價是任務分佈由 scene grammar 同 task program 明確界定,較適合研究訓練方法、評測設計同模型行為分析,未必等同自然世界的開放式視覺理解。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 模型訓練, Qwen, DeepSeek, Image, Dataset 數據集

DocOps 直擊文件代理真功夫

文件代理唔止要答啱內容,仲要改得啱格式同結構。DocOps將評測焦點放回原生文件本身,較易看清代理係真識做事,定只係識講答案。

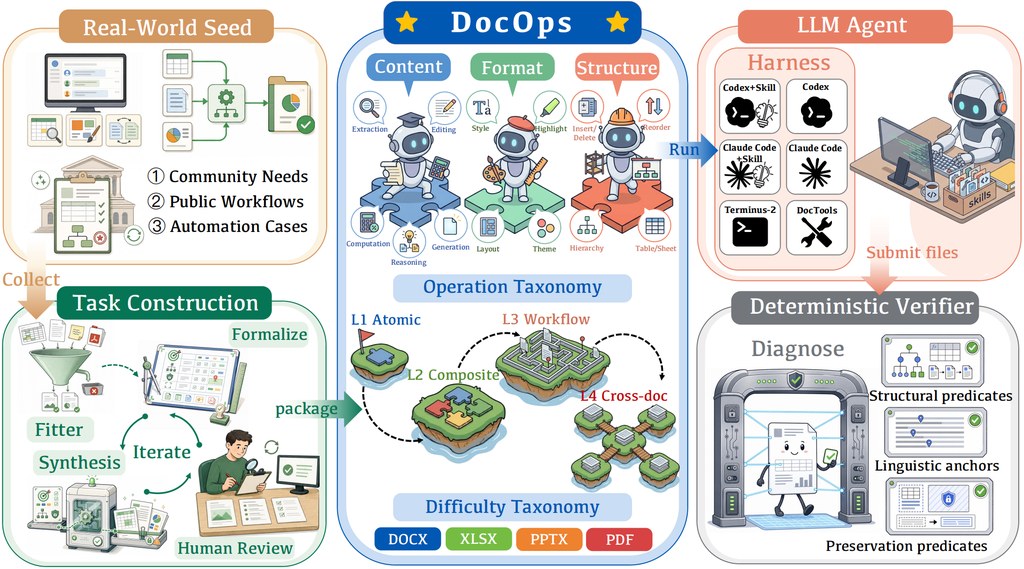
DocOps benchmark overview

改 Excel、Word、PowerPoint 同 PDF,最難唔係生成一段合理回覆,而係交返一份可用、冇整爛結構的原生文件。DocOps屬於 benchmark 類型,針對 document-operation agents 而設,重點不是問答得分,而是檢查代理能否把文件改到指定狀態,同時保住公式、樣式、大綱、書籤與格式有效性。

現有評測常落在兩個範式:static document understanding 把文件當成唯讀材料做擷取或問答;workflow-oriented software evaluation 則把文件當成在應用程式之間流轉的附屬品。DocOps反過來把「文件本身」放回中心,用 Harbor 格式整理 210 個可執行任務,再用 deterministic artifact-level verifiers 直接驗最終檔案狀態,這種設計比只看可見文字更能捉到破壞性修改與狀態遺漏。

它的取向相當鮮明:不是追求聊天式流暢回覆,而是拆解 document manipulation 到 content、format、structure 三個維度,再按 L1 到 L4 拉開難度,涵蓋局部原子操作、同文件組合操作、單文件流程,到跨文件工作流程。對研究 agent 能否長步驟維持全局一致性的人來說,這個分層比單一總分更有診斷價值。

  • 收錄 210 個 Harbor tasks,覆蓋四種常見文件格式
  • 內建 deterministic verifiers,驗證原生檔案而非只看輸出文字
  • 提供 DocumentTools、Terminus-2、Codex、Claude Code 等 execution harnesses
  • 支援 skill-on / skill-off 評測,較易分辨工具能力與模型能力

這個 GitHub 項目已包 task、skills、harnesses 同 Docker base images,重點在重現 benchmark run,而不是單獨提供某個辦公自動化工具。現有結果亦說明門檻不低:例如 GPT-5.5 在不同 harness 的表現有明顯落差,Claude Sonnet 4.6、DeepSeek-V4-Pro 等模型亦未見接近滿分,反映文件操作代理距離穩定處理端到端工作仍有一段距離。對做 Agentic 評測、辦公自動化代理、或想比較 skill 與模型邊界的團隊而言,DocOps的參考價值很高。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, Robotic, 軟件, Anthropic, Meta, Dataset 數據集, 百度, Skill 技能

Voicebox 本地語音克隆完整工作台

想喺自己部機完成語音克隆、朗讀同聽寫,Voicebox 幾乎把整條語音 I/O 流程收進同一個桌面項目。它吸引人的地方,不只係多模型,仲有本地私隱同跨平台部署。

Voicebox

把語音克隆、TTS、聽寫同 agent 語音互動放埋一個桌面介面,正正擊中不少內容創作、無障礙輸入同 AI 工作流嘅痛點。Voicebox 屬於本地優先嘅開源語音工具項目,重點唔係單做一種聲音生成,而係將完整 voice I/O stack 放到 Mac、Windows 同 Linux 上運行,令模型、錄音同聲音資料都留喺自己部機內。

它最有競爭力嘅地方,在於把雲端常見嘅兩段流程合併:一邊做語音輸出,一邊做全域聽寫,仲可以接到 MCP-aware AI agent。對比只做 TTS 或只做 dictation 嘅服務,Voicebox 提供嘅係一個較完整工作台;代價亦明顯,本地推理對硬件、模型管理同快取安排有一定要求,想追求最省心體驗,未必比純雲端方案輕鬆。

支援面向相當廣,內建 7 個 TTS engines,包括 Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 同 Kokoro,亦提供 zero-shot cloning 同 50+ preset voices。23 種語言加上後製效果,例如 pitch shift、reverb、delay、chorus、compression 同 filters,令它唔止適合做旁白,對要快速試聲線、做角色語氣、整理語音筆記嘅小團隊同個人創作者都幾有用。

  • 本地執行係核心價值,私隱敏感內容唔使上傳雲端
  • 一個項目包辦 voice cloning、speech generation、dictation 同 agent 語音介面
  • 支援多個 TTS engines,同一段內容可按聲線、語氣同語言需要切換
  • Chatterbox Turbo 可處理 [laugh]、[sigh]、[gasp] 等 paralinguistic tags,Qwen CustomVoice 可用自然語言控制演繹方式

安裝方式以桌面應用為主,官方已提供下載、文件同 troubleshooting,理解上接近本地 AI studio,而唔係單一模型倉庫。現有資料未見統一基準分數或嚴格 benchmark,對聲音相似度、延遲同穩定性,仍要視乎你選用邊個 engine、樣本質素,同埋會唔會改用 local or remote inference;但作為把多語音模型、克隆流程同輸入輸出控制整合起來嘅開源項目,它已經比只提供單點功能嘅工具更接近可長期放入工作流。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, Agentic, MCP, Qwen, Clone, Mac, Linux, 語音

Page 31 of 92
1 29 30 31 32 33 92