Galahad:12B 凍結模型零解碼作答的工業經驗

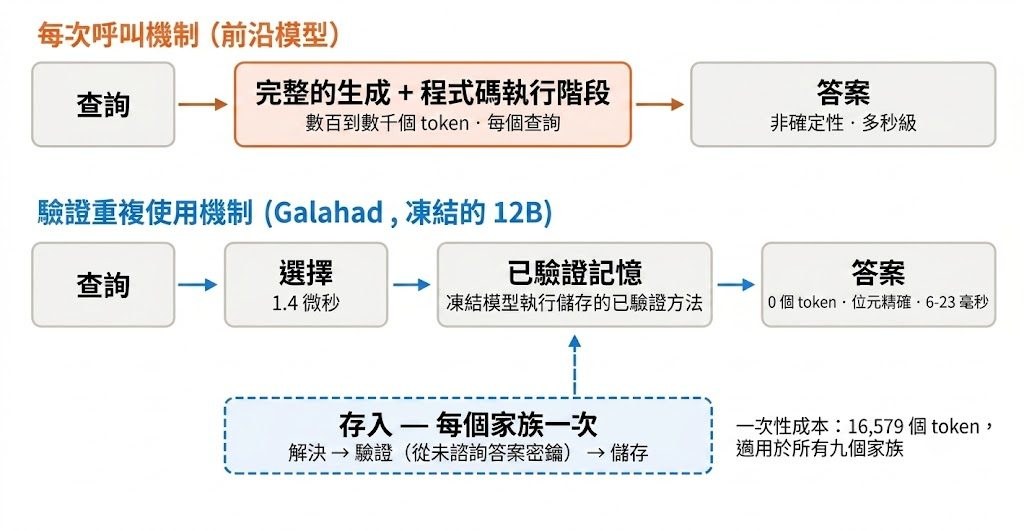
你可以把它理解成:模型不重新推理,而是直接重用已驗證過的求解結果,每次都一模一樣,而且不耗 GPU。

Repository image for corbenicai/galahad-bench

這套 Galahad 系統背後的關注點很直接:今天要提升語言模型,就要重訓練,每次都得重新生成答案,既貴又隨機。他們選擇反向操作——模型參數完全凍結,只在旁邊持續累積已驗證的解題記憶。同一個 12B 模型,對於已處理過的題目家族,直接命中記憶中的求解器,整數級精確一致,每次結果都完全相同,而且生成 token 數為零;對於新題目,則照常從零推理解答。系統聲稱在 180 個全新題目、橫跨九個題目家族上,讓四個來自不同供應商、架構各異的開源模型全部拿到 180/180,並且每次回答都不耗任何生成 token。

這個做法最值得留意的,是它對「記憶」一詞的重新定義。系統內部存的是可被獨立外部 oracle 自動驗證的執行式解題結果,不是用相似度檢索找出來的近似片段。作者在特別批評了業界慣用的近似向量相似度檢索:在一個 4,500 條已驗證答案的庫上,這種方法有 94.3% 機率選錯項目,而精確定址則零錯誤。換句話說,對於可驗證、可執行的知識,相似度近似檢索不是表現稍差,而是幾乎不可用,精確定位是必須的設計前提,不是可選偏好。

對於要部署閉環計算、形式化證明、程式碼執行這類可驗證任務的團隊,這套思路很有吸引力:記憶檢索耗時約 1.4 微秒,完整重用流程 6 至 23 毫秒,每次重用只耗 36 毫瓦時電力,相對於一次性求解兼驗證所需的 81.1 瓦時,節能差距明顯。模型本身不重新訓練,能力靠記憶累積,這對想控制運算開支、又需要可重現輸出的場景,例如 CI 中的程式生成或單元測試,是務實的取捨。

但限制也要看清楚:作者指出在公開基準的從零推理上,前沿模型依然遠勝任何 12B;Galahad 的強處是對「已被系統解決並驗證過」的題目家族做到零成本重用,不等於通用智能提升。負面控制也排除了另一種解釋——把記憶清空,系統一道也解不出來,這進一步確認能力確實來自記憶層,不是模型本身突然變聰明。對於想關注的是開源權重能否落地到工業管道的讀者,這份來自 Corbenic AI 的工業經驗報告值得留意,因為它把「訓練之外如何持續累積能力」這條路寫成了可量化的章節。

  • 模型凍結,能力改由外部已驗證記憶承擔,180 題零 token 滿分
  • 精確定址取代向量相似度檢索,在 4,500 條庫上錯誤率 94.3% 對 0%
  • 重用耗時 6–23 毫秒、每次 36 毫瓦時,對比一次性求解 81.1 瓦時
  • 開源模型架構無關:四個不同 dense 與 MoE 模型皆達 180/180
  • GitHub 目前僅放測試頁占位,引擎源碼尚未公開釋出

GitHub · Paper

Categories: 開源, Qwen, DeepSeek, Gemini, 框架, Dataset 數據集

ViMax 把影片生成變成多代理流程

想由一句想法走到完整影片,卡位往往唔係生成本身,而係分鏡、節奏同角色一致性。ViMax把呢條流程拆成多個 Agent 協作,重點放在先規劃、再生成。

Repository image for hkuds/vimax

直接由文字生成影片,最易出問題的通常不是畫面夠不夠靚,而是故事走向會散、鏡頭難連貫、角色設定前後不一。ViMax把這些環節拉回工作流處理:它屬於 Agentic Video Generation 類型的開源項目,用多個 Agent 分別扮演 Director、Screenwriter、Producer 與 Video Generator,目標是把影片生成由單次出圖,變成可規劃的多步驟流程。

這種取向的分別,在於它不只追求「一句提示詞出片」,而是先把敘事、鏡頭與製作安排拆開,再交回生成模組執行。對內容創作者、想做短片原型的團隊,或者研究多代理協作點樣落地到視頻模型工作流的人,這個項目會較有參考價值;但儲存庫提供的資訊目前偏簡短,未見完整測試結果、部署細節或清晰的安裝流程。

從名稱與描述判斷,ViMax較像一個協調層或框架,而不只是單一視頻模型。它想補的是影片生成裡最難靠單一模型穩定完成的前置規劃,因此價值未必在最終某一幀畫質,而在於整段片能否保持節奏與結構。不過,原始資料未交代它串接哪些底層模型、怎樣處理角色一致性,亦未提供性能指標,現階段較適合先當成研究方向與工作流設計來理解。

  • 把影片生成拆成 Director、Screenwriter、Producer、Video Generator 多個 Agent
  • 重點放在規劃與協作,不只是單次提示詞生成
  • 適合研究多代理、多步驟視頻製作流程的人參考
  • 儲存庫描述很短,暫時未見完整安裝、部署與評測資訊

ViMax最吸引人的地方,是它把「生成影片」理解成一條需要分工的製作鏈,而不是單一模型一次完成所有事。現有資訊仍不足以判斷成品穩定性或生產可用度,但作為開源方向,它清楚對準了多模態模型在長段影片敘事上的核心難題。

GitHub

Categories: 開源, 香港大學, Agentic, AI productions, Video

ClinFusion 把醫療影像讀懂再回答

ClinFusion瞄準的不是一般聊天,而是把2D與3D醫療影像連同文字指令一併理解。它想解決的重點,是醫療多模態模型常見的看得多、答得快,卻未必貼近臨床判讀。

radar chart

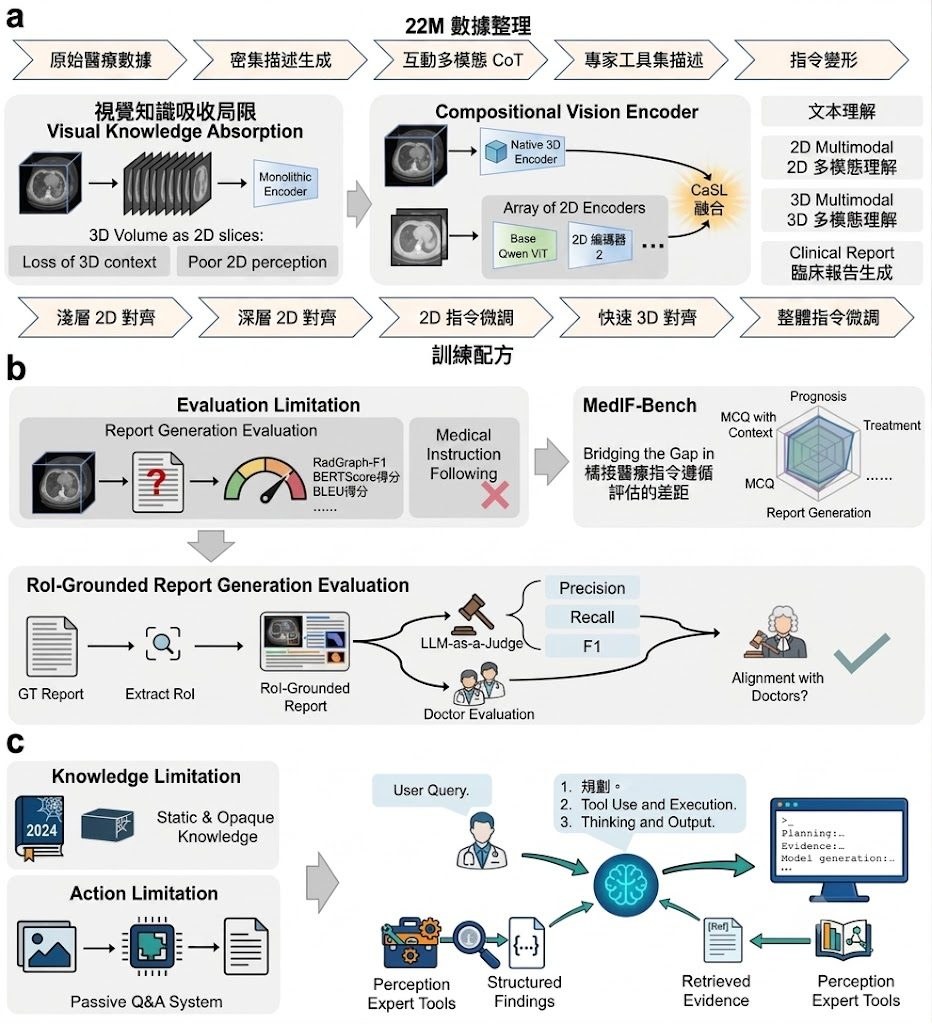
醫療多模態模型最易失準的位置,往往不是會不會答,而是有沒有真正對準影像內容。ClinFusion屬於模型,更準確地說是面向臨床理解的 vision-centric Multimodal large language models (MLLMs) 系統,重點放在同時處理 2D 圖像、原生 3D NIfTI 影像與文字任務,減少只靠文字對齊時常見的臨床細節流失。

現有做法常把醫療問題當成一般多模態問答處理,但作者認為這種範式忽略了 3D 影像與放射科判讀流程,因此用 compositional and cascaded vision encoder 配合 Cascade Spatial-Aware Locality Fusion,把 2D 與 native 3D 醫療影像放進同一個 fused encoder。另一個關鍵不是只換模型,而是連評測也改寫:加入 MedIF-Bench 檢查 instruction following,並用 region-of-interest-grounded 方法評估報告生成的 factualness。

論文給出的成績相當進取:ClinFusion 在 24 個基準中有 20 個超過 Hulu-Med、Lingshu 等開源醫療 MLLMs,也在 16 個比較裡有 13 個勝過 GPT-5.2 與 Gemini-3-Flash。盲測部分由 board-certified radiologists 進行,報告排名亦拿到最佳,RoI-grounded metric 與專家判斷的相關性也最高,這點比單看自動分數更有說服力。

  • 可接受文字 prompt、2D 圖像路徑,以及 3D NIfTI volumes(.nii.gz)
  • 定位不是通用聊天,而是臨床導向的整體醫療理解
  • 核心取向是把 2D/3D 視覺編碼與臨床一致的評測一併重做
  • 已公開模型推理方向,但儲存庫資訊未完整交代部署流程與完整安裝細節

較適合留意這個項目的,會是做醫療 AI、放射影像、多模態研究或醫療報告生成評測的團隊。它的亮點在於把「模型看見了什麼」與「臨床上是否講得準」放到同一條線上;限制亦很清楚,現有 GitHub 資訊主要集中在作者主張與推理輸入格式,真正要落地到醫院工作流,仍要再看公開模型、硬件需求與後續工具鏈是否齊備。

GitHub · 模型

Categories: 開源, 清華大學, 阿里巴巴, 模型, 多模態模型, Qwen, Image, Medical醫學, 3D, 中國, Dataset 數據集

Google 開源 GNM Head:更完整的人頭 3D 模型

做人頭 3D 建模時,最麻煩往往唔係外形,而係眼球、牙齒同舌頭呢類細節。GNM Head 把呢些結構一併納入,定位明顯唔止係傳統面部 3DMM。

GNM Teaser Image

只做臉部外殼,很多時已經唔夠用;去到動畫、重建同生成式影像控制,眼球、口腔同頭部姿態一旦分離得唔好,效果就會即刻穿崩。google/GNM 目前先開放的 GNM Head,屬於3D parametric statistical human model 項目,焦點是用更完整的人頭幾何表示,處理傳統 3D Morphable Models (3DMMs) 對內部 anatomy 覆蓋不足的問題。

這個項目的取向很鮮明:不只是追求一個可調參的人臉網格,而是把 head、face、neck、eyeballs、teeth、tongue 放進同一個生成式人體測量框架。作者在技術報告指出,現有公開模型多數只覆蓋外部幾何,亦容易受限於低保真掃描資料;GNM 則結合高解析 3D scans 與 anatomy-specific artist-made samples,並加入 ocular 同 intra-oral specialized sub-models,目的就是改善幾何品質同可控性之間的取捨。

現有儲存庫較像一個生態系入口,而唔係即開即用的單一應用程式。README 清楚列出 GNM Head 已提供 NumPy、JAX、PyTorch、TensorFlow 多後端支援,亦有 Linux、macOS、Windows 的 CI;但目前公開資訊以模型與技術報告為主,未見到很完整的產品化操作流程說明,所以較適合研究、角色生成、數碼人、3D 視覺或生成式影像控制團隊按其子目錄文件逐步接入。

  • 補足傳統 3DMM 常見缺口:不只外形,連眼球、牙齒、舌頭都可控
  • GNM Head 強調 identity、expressions、head pose 的 disentangled control
  • 同時支援 NumPy、JAX、PyTorch、TensorFlow,方便接去不同研究流程
  • 技術報告聲稱在 fitting target 3D face scans 達到 SotA 表現,但具體指標仍要回看原報告

它最吸引人的地方,在於把「可生成、可擬合、可作條件控制」三條路線拉到同一個模型家族內。現階段公開內容仍以 GNM Ecosystem 的起步版本為主,想拿來做完整 production pipeline,仍要自己判斷與現有重建、動畫或生成系統的整合成本;但作為高保真人頭 3DMM 的新基礎,這個項目的研究價值同延展空間都相當高。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Google, TensorFlow, Mac, 3D, Linux, Python, 語音, Dataset 數據集

FilmOps 將電影語言拆成可分析標籤

想認真分析影片鏡頭,而唔只看「好唔好睇」,FilmOps 提供一套更接近電影製作語言的開源方法。它將畫面拆成可讀標籤,方便做評測、整理同研究。

FilmOps logo

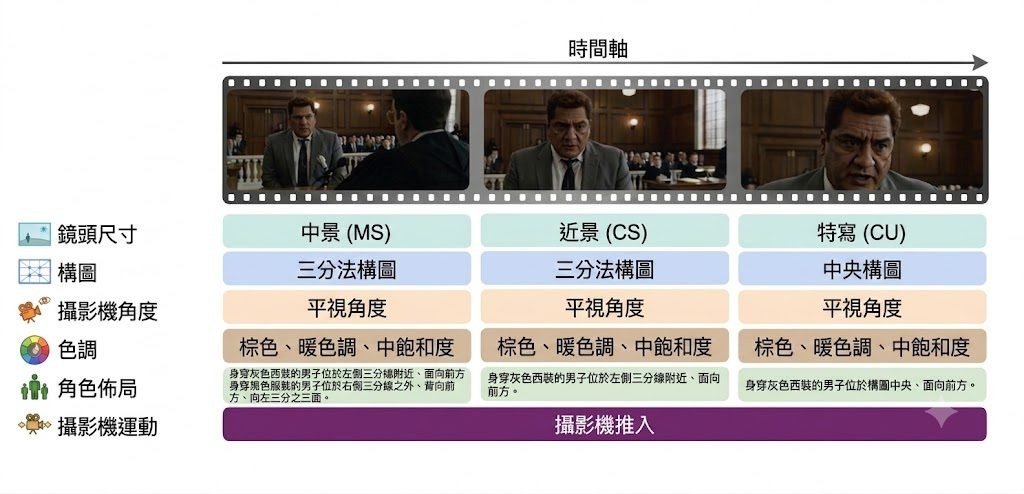
一段影片好不好,不一定只靠整體觀感判斷;鏡頭遠近、構圖、機位、色調同運鏡,往往先係影響觀感的核心。FilmOps 正正瞄準呢個缺口:它不是一般影片生成模型,而是一套開源 operator suite,用來把影片畫面映射成結構化的 cinematographic labels,處理的是電影語言難以被細緻分析與量化的問題。

現有影片 benchmark 多數集中在 general perceptual quality、text alignment 或 temporal smoothness,對專業 cinematographic language 仍然偏粗略;general-purpose MLLMs 又難以穩定辨認 film-specific attributes,而 aesthetic predictors 這類領域模型面對 cinematic content 亦有明顯 domain gap。FilmOps 的取向很清楚:不用單一大模型包辦所有判斷,而是把六個維度拆開,按任務特性分配不同 backbone,令 shot scale、composition、camera angle、color & tone、character layout 同 camera movement 可以分別處理。

它的價值在於更像一套分析管線,而不是只給你一個總分。項目覆蓋 55 個以上子類別,分類定義對齊 Film Art、ASC Manual、Cinematography: Theory and Practice,亦經過 practitioner 驗證;加上 modular architecture,可以獨立用單一 operator,或者走 unified pipeline。對要做影片生成評測、鏡頭標註、資料整理,甚至研究 FilmBench 呢類 cinematic benchmark 的團隊,這種拆解方式會比泛用多模態評分更有解釋力。

  • 屬於開源工具/模型組合,重點是把影片拆成電影語言標籤,而不是直接生成影片
  • 六個 operator 採用 task-specific backbone,包含 DINO ViT-B/14、BEiT Base、ResNet-18、InternVL3-14B
  • 支援 live-action、3D animation、2D animation 同 stylized content,強調 cross-genre consistency
  • 已交代基本部署條件,包括 Python、PyTorch、CUDA 與 ffmpeg,也提供 unified pipeline 與 checkpoints 準備方向

現有資料只明確指出它在所有維度都勝過 general-purpose MLLMs,但細節主要放在論文。配套的 FilmBench 亦用同一套 Cinematic Language 思路建立 benchmark,並聲稱 evaluator 在模型排名上與人工評分高度一致,說明 FilmOps 並非只為展示而做,而是服務整個影片評測流程。不過它始終偏向分析與標註基建,想直接拿來做完整產品,仍要自行處理 checkpoints 下載、推理資源,並接受部分 operator 對 CUDA 與較重模型的依賴。

GitHub · Paper

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, NVIDIA, Gemini, 3D, Python, 語音, 動畫, Dataset 數據集

DriveDNA 將駕駛風格拆清楚

同一個人開唔同車、行唔同路,模型未必真係學到駕駛風格。DriveDNA正正用公開基準把呢個混淆拆開來驗證。

DriveDNA teaser

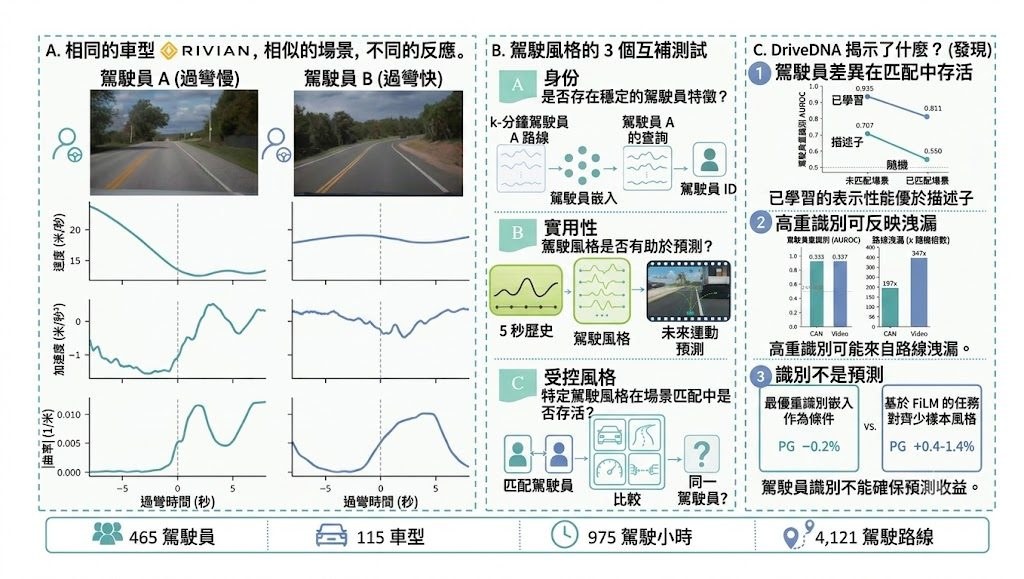
不少駕駛模型聲稱識別「駕駛風格」,但一換車款、路線或交通情境,學到的可能只是車主習慣路段與車輛特性。DriveDNA屬於多模態自然駕駛數據集與 benchmark,核心不是再加一批行車資料,而是把「邊個人在開車」與「開緊咩車、行緊邊條路」分開檢驗,直接處理個人化駕駛建模最常見的捷徑問題。

現有公開資源不是樣本太細、就是把車輛與路線幾乎固定,於是高分未必代表模型捉到穩定的個人風格。作者的做法更像重新定義評測:資料來自 465 位司機、115 款車、4,121 段駕駛,保留 CAN telemetry 與前向道路影片,並移除 automation-engaged frames,只留下 human-controlled driving,再配合 frozen evaluation protocol 與 leakage probes,要求研究者同時報告效用與洩漏風險。

它的價值在於評測不只看 re-identification 準唔準,還加入 personalized behavior prediction,以及在條件匹配下比較風格是否仍然存在。論文亦講得很直白:高 re-ID 可能只是 route leakage,能認出司機,不等於對未來行為預測更有幫助;相比只追單一識別分數,DriveDNA更重視模型有沒有學到可遷移、可解釋的駕駛表徵。

  • 規模夠大:465 位司機、975 小時 human-controlled driving、4,121 段駕駛
  • 模態完整:10 Hz CAN telemetry 配合同步前向道路影片
  • 評測設計針對混淆來源,明確檢查 vehicle、route、condition leakage
  • 倉庫已附 code 與 harness,但提供的是 benchmark 與研究流程,不是即插即用產品

私隱與資料治理亦寫得仔細:司機身份用 salted hashes,移除 VIN、裝置識別碼與 GPS,沒有車廂影片與音訊,受控影片版本會模糊人臉與車牌,並禁止 re-identification 與保險、就業、執法評分用途。較適合自動駕駛、駕駛行為建模、VLA 與多模態學習團隊拿來做表徵比較與洩漏檢查;現有資訊可確認倉庫附有 code & harness,但未見完整產品化安裝流程,重點仍是研究 benchmark 與可重現評測。

GitHub · Paper

Categories: 開源, 多模態模型, VLA, Dataset 數據集

ARI 用 RAG 修復韓國朝鮮古籍殘字

遇到人名、地名殘缺的古籍,單靠上下文往往會估錯。ARI把檢索到的史料一併交畀模型判斷,明顯更適合做歷史文獻修復。

Method Figure

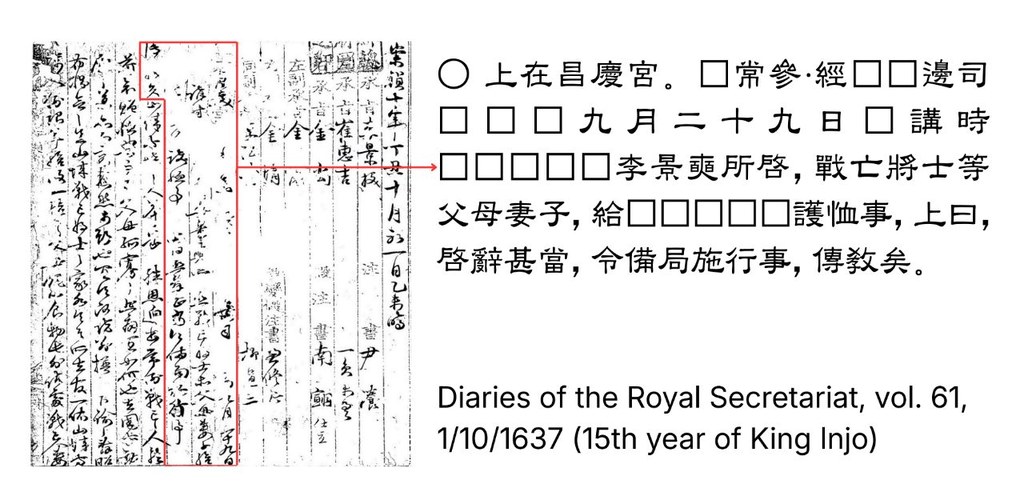
最值得留意的,不是模型把缺字補回來本身,而是它專門處理古籍修復最棘手的一類內容:人名、地名等 Named Entities。ARI 屬於一個結合 Retrieval-Augmented Generation(RAG)的文獻修復框架,針對朝鮮王朝實錄與承政院日記這類韓文漢字史料,補足只靠局部語境時經常失準的缺口。

現有做法多數依賴 masked language modeling,擅長根據前後文猜測一般字詞,但一遇到需要外部史實支持的專名就容易失手。ARI 的取向很清楚:先用 BM25 從歷史語料找出前 20 份相關文本,再以字串相似度 0.8 過濾重複內容,將這些外部證據交給模型一併生成,修正通用 LLM 容易出現的幻覺。

模型部分不是從零開始,而是建基於 Qwen3 32B 與 Qwen3 8B 微調成 ARI-32B 和 ARI-8B,並加入 25% named entity-prioritized masking 訓練策略,把學習重點放在知識密集片段。論文亦指出,對漢字材料而言,詞彙層面的 BM25 檢索比 embedding-based retrieval 更有效,這一點頗有說服力,因為表意文字的字形與字詞對應關係本身就影響檢索效果。

  • 適合歷史文獻整理、數位人文研究與古籍校勘團隊參考
  • 主要強項在於修復需要外部知識支撐的 Named Entities
  • ARI-32B 與 ARI-8B 同步提供,前者追求表現,後者較重視運算成本
  • 論文結果顯示,它在 named entity 與隨機遮罩字元修復都勝過多個基線與通用模型

把它視為一個已有公開模型與方法說明的研究項目。對需要先驗證效果的人來說,現階段較合理的路線會是先查看論文設定與模型頁面,再判斷是否足以接入自己的古籍修復工作流。

項目主頁 · GitHub · Paper

Categories: 開源, RAG, Embedding, 模型, Qwen, 語音, Dataset 數據集

CrossView 用 3D 數值控制鏡頭:LTX-Video 跨視角生成

同一段影片想換個拍攝角度,通常最難是保住人物一致性與空間感。這個 IC-LoRA 用深度 warp 加原片雙參考,讓跨視角生成更可控。

Og image

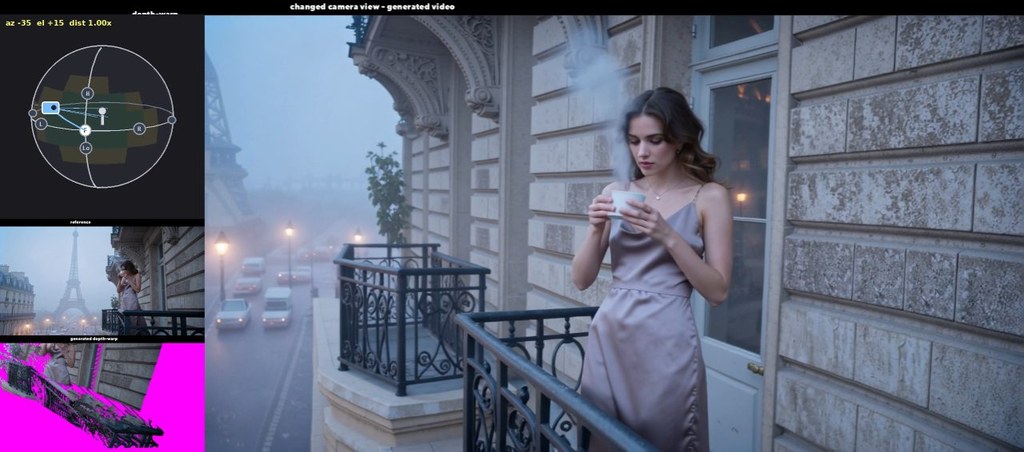
想將一段現成影片改成另一個鏡頭角度,又唔想主體變樣或空間關係散掉,這正是此模型處理的問題。它明確基於 Lightricks/LTX-2.3,屬於 LTX-Video 2.3 22B 的 IC-LoRA 微調,重點不是純文字改鏡頭,而是用輸入影片加相機偏移數值,重建同一場景的新視角。

頁面提供的做法幾清楚:模型同時接收兩段參考影片,一段是由 CrossViewWarp ComfyUI node 產生的 depth-warp 影片,用來保留幾何結構;另一段是原始影片,用來維持主體 identity。這種雙參考分工,反映它優先解決「換角度後仍要似原片」的取捨,比單靠 prompt 描述鏡頭更穩定。

它與同作者的 CrossView Prompt LoRA 差異亦很直接:後者由文字提示選鏡頭角度,這個版本改為輸入 azimuth / elevation / distance 等數值,所以鏡頭控制更精確。頁面亦提到可以在 3D orbit picker 加 keyframes,逐幀插值相機姿態,代表不只可做固定新視角,也可做繞拍式 camera move。

  • 基礎模型已標明為 Lightricks/LTX-2.3,授權為 Apache-2.0
  • 主要檔案是 LTX2.3-22B_IC-LoRA-CrossView-Warp_v0.9_18000.safetensors
  • 依賴 ComfyUI-CrossViewWarpDepth Anything V2 節點提供 depth 輸入。
  • 示例包含固定視角偏移與 keyframed 軌道鏡頭,並說明輸出來自真實影片而非合成訓練片段。

這個項目目前仍是 PoC,它較偏向 ComfyUI 工作流驗證,而不是通用本地大語言模型部署。

模型

Categories: 開源, ComfyUI, AI productions, 視覺模型, 視頻模型, Video, 3D, LTX

Ollama 3.25 把開源模型帶回你部機

想喺自己電腦跑開源大模型,又唔想先砌一大堆環境,Ollama 正正係針對呢個卡位。它將模型執行、管理同串接應用壓縮成一條較順手的路。

Repository image for ollama/ollama

想將開源模型放返本地處理,又要兼顧聊天、程式整合同 agent 工作流,Ollama 幾乎係目前最直接的一條路。它屬於模型執行與管理工具,核心作用係將本地大語言模型的下載、啟動、呼叫同整合收斂到同一套介面,令 Mac、Windows、Linux 甚至 Docker 部署都比較一致。

它吸引人的地方不只是可以對話,而係可以直接接去 Claude Code、OpenClaw、Codex、Copilot 等現有工具鏈。換句話說,Ollama 唔係只提供一個聊天殼,而係充當本地模型服務層;你可以用 CLI 跑模型、經 REST API 調用,亦可以配合 ollama-python、ollama-js,或者再接 Open WebUI、LibreChat、Lobe Chat、NextChat、Perplexica 呢類前端與應用。

同類做法入面,Ollama 的取向好清楚:它唔著重花巧介面,而係先處理「點樣穩定喺本地把模型跑起來,再供其他程式使用」呢件事。背後支援 llama.cpp,意味住它承接咗本地推理生態的成熟基礎;代價亦存在,本地效能仍然受你部機的記憶體、GPU 與模型大小限制,追求大型模型或高併發時,就未必有雲端服務咁輕鬆。

  • 安裝路徑完整,覆蓋 macOS、Windows、Linux 同 Docker,理解上可以當成一個本地 AI 服務。
  • 既可直接 run 模型聊天,亦可透過 REST API、Python、JavaScript 接入現有項目。
  • 跟 Claude Code、OpenClaw、Codex、Copilot 等整合,適合做本地 agent 與開發工作流。
  • 配合 Open WebUI、LibreChat、Lobe Chat、NextChat 等,可快速補上可視化操作層。

較受惠的一群,會係想保留資料喺本地的開發者、需要快速測試開源模型的團隊,以及想把 AI 能力嵌入內部工具的人。就產品定位而言,Ollama 最有價值的地方,係將「本地跑模型」由零散步驟變成可重用的基礎設施。

項目主頁 · GitHub

Categories: 開源, Agentic, API, Mac, Linux, Ollama, Python

TBSM 想把一步生成變得更實用

想要快,但又唔想靠冗長採樣或額外教師模型,TBSM正正瞄準呢個矛盾。它用一步生成處理影像與 text-to-image,取向相當鮮明。

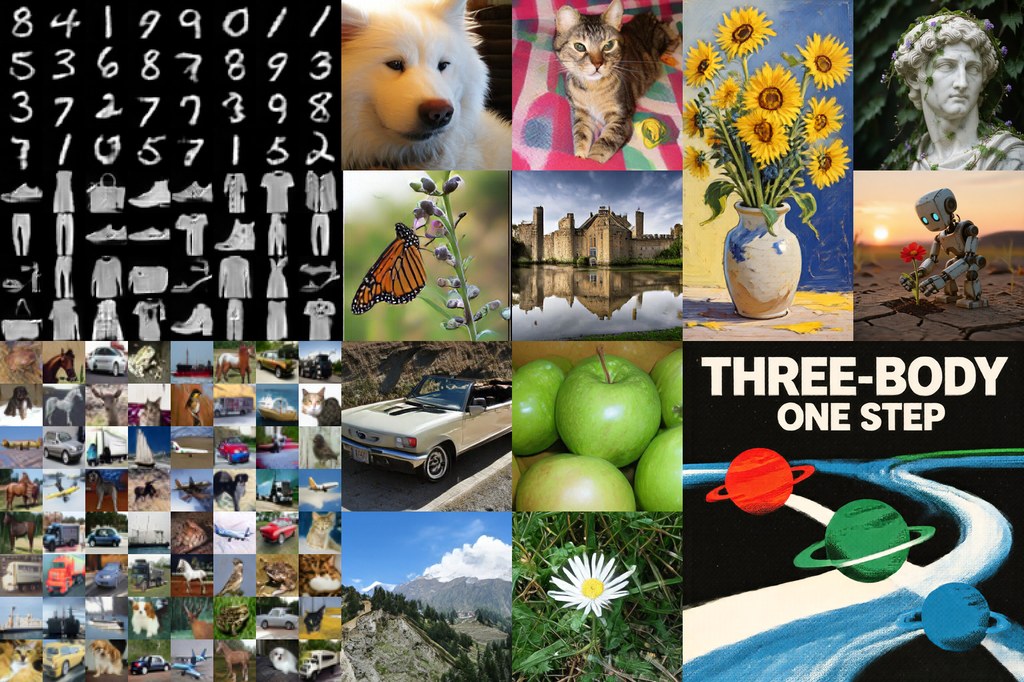
TBSM one-step samples across handwritten digits, fashion items, CIFAR-10, ImageNet, and text-to-image generation.

生成模型一路追求更快出圖,但速度一提升,訓練往往就變得更複雜。TBSM 把焦點放在one-step generation,而且唔係靠 adversarial critic、teacher queries,亦唔需要 batch-wide all-pairs field 去撐住整個流程;它屬於生成模型方法,處理的是怎樣用較直接的監督,把一次生成做得可訓練又可擴展。

這個項目的判斷重點,在於它不只是講快,而係試圖避開幾條常見路線的代價:GANs 容易受 adversarial min-max objective 影響,AR / Diffusion 要逐步解碼或反覆採樣,Drifting Models 會受 batch 規模拖高成本,diffusion distillation 又常常連帶額外模型、loss 或訓練技巧。TBSM 用 three-body scattering 連到 distributional energy,目標是把分佈層面的學習,壓成 sample-level supervision,令一步生成唔使再背住咁重的系統負擔。

它已展示多種資料與輸出空間,包括 handwritten digits、fashion items、CIFAR-10、ImageNet,以及 1024×1024 的 text-to-image。這代表它較像研究型項目而唔係即裝即用產品:你會先從 paper、示意圖與 quick start 去理解訓練與生成流程,再按資料集或任務類型測試效果,較適合有模型訓練環境的研究團隊、影像生成項目,或者想研究 one-step generation 取捨的人。

  • 核心賣點是一跳生成,不靠多步採樣換品質
  • 設計上避開 adversarial critic、teacher model 同 batch 全配對成本
  • 已展示多個資料集與 text-to-image,覆蓋面比純玩具示範更廣
  • 現階段更接近研究實驗框架,部署前要先消化方法與訓練設定

它吸引人的地方,在於把「生成速度」同「訓練系統複雜度」一齊拉入取捨表,而不只是追某個指標。現有資訊未見完整效能數字與部署細節,表示讀者現階段應把它看成值得追蹤的生成模型研究方向:概念清晰、定位明確,但要判斷是否適合生產環境,仍然要等更完整的評測與開源內容。

GitHub

Categories: 開源, Qwen, Image, txt2img

Page 29 of 92
1 27 28 29 30 31 92