內容圍繞 MCP 與 API 的差異。重點係解釋點解傳統 API 未必適合 AI agents。
內容圍繞 MCP 與 API 的差異。重點係解釋點解傳統 API 未必適合 AI agents。
用最簡單控制流程,講清 AI Agent 點樣反覆調用模型與工具。
這是一段介紹 AI Agent 底層控制流程的教學影片。它主要用來解釋主流 Agent 為何能連續思考、調用工具並完成任務,核心其實是一個簡化版 while 迴圈。
內容重點不是堆砌框架名詞,而是把 Agent Loop 拆成幾個基本步驟:先問模型、按模型要求執行工具、把結果回填,再繼續詢問模型,直到模型不再要求工具。這種講法有助非技術讀者理解,很多看似複雜的 AI Agent,底層控制流未必複雜。
它要處理的問題,是怎樣讓語言模型由一次性回答,變成可逐步執行任務的系統。相比只靠單輪提示詞的做法,Agent Loop 多了狀態延續、工具調用與停止條件,因此更適合查資料、操作 API、分步完成工作等情境。
這類內容特別適合剛接觸 Agentic 系統、MCP、工具代理或自動化工作流的讀者,也適合寫程式的人建立正確心智模型。單靠目前提供的資料,未見具體效能數字、基準測試或完整程式實作細節,因此較適合視為概念導讀,而不是完整技術文件。
AnyGroundBench不是新模型,而是專門測試影片理解能力的 benchmark。它把專業場景放入同一套規則,直接揭示現有 VLMs 的適應落差。
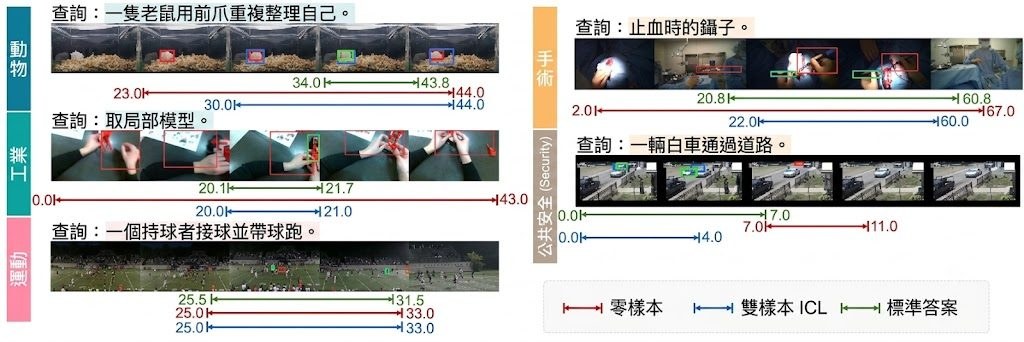
AnyGroundBench 是一個影片 grounding benchmark,也是面向專業領域的資料集與評測基準。它主要用來測試 Vision-Language Models(VLMs)在 animal、industry、sports、surgery、public security 幾類場景中,能否把文字描述準確對應到影片中的時間、位置,以及時空同時發生的事件。
現有做法多數停留在 general、daily-life benchmark 的 zero-shot 測試,重點是看模型有沒有通用理解力;作者認為這種範式無法反映專門場景,因為稀有視覺概念、複雜動作關係與領域術語,通常不會在通用資料裡被充分學到。AnyGroundBench 因而把評測重心轉去 domain adaptation,並加入 dedicated training subsets,令測試不再只問模型「有沒有見過」,而是進一步量度它「能不能適應新領域」。
這個項目的差異,在於它把 temporal、spatial、spatio-temporal annotations 用統一方式整理,並混合 newly captured videos 與 existing datasets。資料來源涵蓋 mouse、american_football、Animal-Kingdom、MECCANO、EgoSurgery 等,覆蓋面比單一領域 benchmark 廣,亦更接近研究團隊、產業分析、醫療影像研究與安全監測場景會遇到的資料分佈。
項目提供 Hugging Face dataset、project page:這不是即插即用應用程式,而是供研究與模型比較的 benchmark。部署重點不是介面安裝,而是按 domain 讀取整理後的資料,然後以 STVG、TVG、SVG 三類任務跑推理與評分;指標分別用 vIoU@0.3、tIoU@0.3、sIoU@0.3。
建議模型包括 GPT-4o、GPT-5.1、Gemini-2.5-Flash 等 proprietary VLMs;現有結果顯示,加入 2-shot ICL 雖然在部分 domain 有改善,但整體仍未解決 specialized-domain spatio-temporal reasoning 的缺口。對研究 VLM evaluation、video grounding、視覺模型遷移能力的團隊來說,這個項目最有價值的地方,是它把「通用測試看似可用」與「專業場景仍然失手」之間的差距量化出來。
這是一個提升機械人操控穩定性的研究方法。它用模擬訓練的殘差策略,零樣本補強真實世界的 VLA 表現。
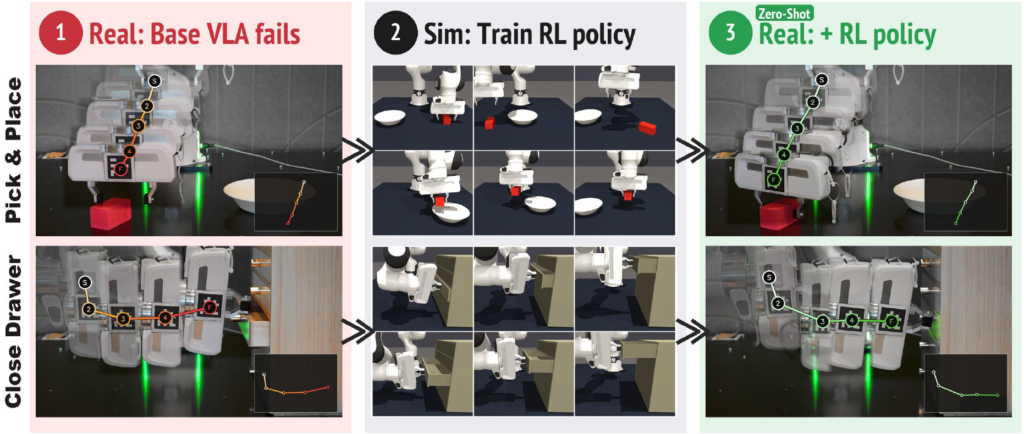
這是 Microsoft Research 的 Object-Centric Residual RL 方法。它的用途是為 Vision-Language-Action(VLA) 模型加入一層修正策略,減少機械人在真實操控中因細小誤差累積而失手的情況。
核心做法是把一個已凍結的 base VLA 保留不變,再額外疊加一個輕量 residual policy。這個 residual policy 完全在模擬環境訓練,輸入不是原始影像,而是 object-centric state、proprioception,以及 base VLA action,藉此避開常見的 visual sim-to-real gap,令策略可直接 zero-shot 轉移到真實機械人。
這個方法處理的是 imitation learning 常見的脆弱性:示範資料未覆蓋到的狀態一旦出現,誤差會一路放大。與直接微調 VLA、或在真實世界再做 reinforcement learning 相比,這個方法的差異在於只學「修正量」,而且訓練放在模擬中完成,成本與風險都較低。
這類方法較適合關注 VLA、Robotic 與 sim-to-real transfer 的研究者和開發者。現有資料清楚交代方法方向與問題設定,但未提供完整安裝流程或操作步驟;評估部分可確認作者以真實機械人成功率改善作為重點,更多數值細節仍需參考原始論文。
MMBench2唔只係資料集,亦連同模型、評測同互動介面一齊公開。重點在於預測同減少 World Models 出現 hallucination。
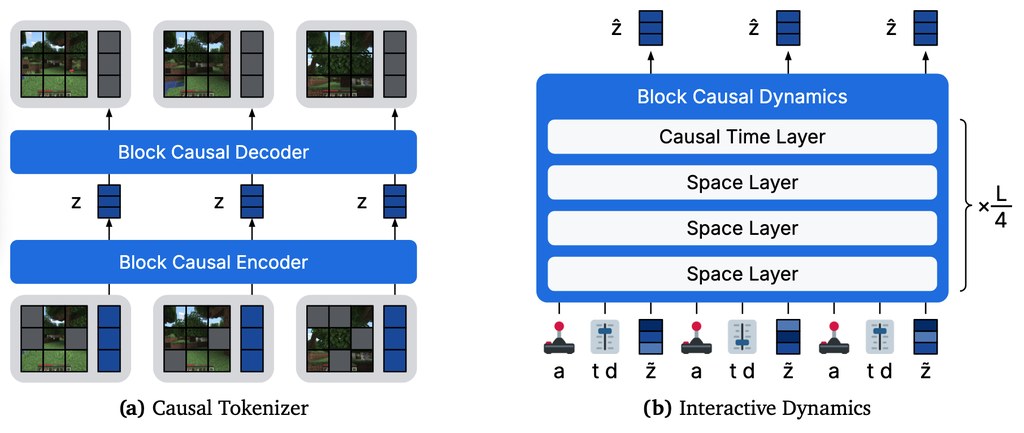
MMBench2 是一個圍繞 large generative world models 的研究型基準與開源項目,結合資料集、模型、訓練與評測程式。它主要處理 World Models 在生成未來軌跡時出現 hallucination 的問題,也就是畫面看似合理,但已經偏離真實動態與動作條件。
現有做法多數集中在把 world model 做得更大,或沿用固定的 open-loop rollout 範式觀察生成效果;作者認為這樣很難直接找出模型何時開始失真。這個項目改以「可預測、可預防」為核心,提出三種 runtime hallucination predictors:tokenizer round-trip residual、flow instability、inter-seed denoising variance,並配合 motion-normalized 版本做即時監測。
模型設計大致跟隨 Dreamer 4 路線,但重點不只在架構本身,而是把 coverage-aware training 與 targeted data collection 放入同一套流程。作者把 hallucination 視為 data coverage 問題,因此會重抽樣 under-represented 的 state-action space,亦會用 predictors 當 curiosity reward 做 closed-loop online data collection,這比單純加大模型更有方向性。
部署理解上,這個項目已提供互動式網頁介面,可在 CUDA GPU 上直接啟動,並用 live simulators 種出 rollout,連完整資料集都唔一定要先下載。官方亦公開 350M-parameter pretrained 與 finetuned world models,以及 427 小時、涵蓋 210 個 continuous control tasks、10 個 domain 的 MMBench2 dataset,方便研究團隊重做訓練、比較不同變體,或者先用 checkpoint 檢查 hallucination predictor 的表現。
這個項目較適合研究 world models、Robotic 控制、模型可靠性與安全的團隊閱讀和試驗。它未必是一般開發者即裝即用的應用工具,但作為 benchmark、分析框架與資料基礎設施,辨識 hallucination 成因與改善方向都相當清楚。
這是一組重現論文結果的研究代碼,集中比較三種多模態 misinformation detection agent 系統。重點不只看分數,亦看證據如何被拆解、檢索與重用。
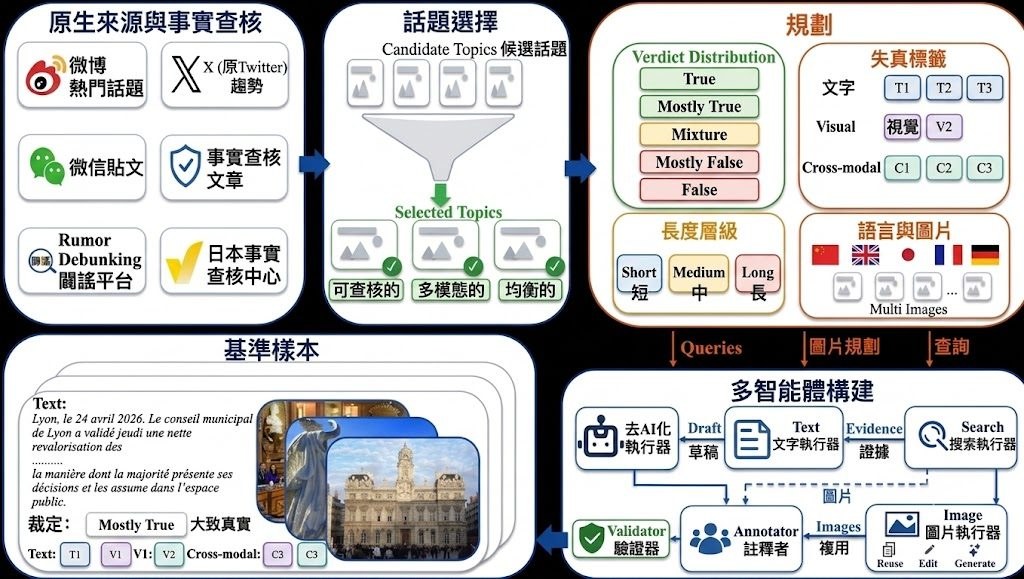
開發團隊來自上海交通大學、上海人工智慧實驗室、清華大學、中南大學,以及中國電子科技集團第十五研究所,核心作者把 ReMMDBench 同 ReMMD-Agent 一起公開,方向很明確:用較接近真實網絡帖文的方式,檢查圖文混合內容中的 misinformation。這個 GitHub 項目屬於研究原型加評測代碼集合,主要用來重現三個 multimodal misinformation detection agent 系統在 ReMMDBench 上的結果,並比較它們怎樣做判斷。
現有做法常把多模態假資訊檢測收窄成單圖、二分類,或者一次過把整段文字與圖片丟給模型判斷;作者認為這種 fixed-pass 判斷方式難以處理長敘事、多張圖片、跨語言與部分真實內容。這個項目因此提出一套以 ReMMDBench 為核心的 agentic 驗證路線:Baseline 1 是 3-stage MMD-Agent,Baseline 2 是 MCTS-based 5-verdict + 8-taxonomy agent,而主系統 ReMMD-Agent 則用 atomic decomposition、RAG(Retrieval-Augmented Generation)與 multi-expert judge,把結論建立在可追蹤的證據狀態上。
跟同類方法相比,ReMMD-Agent 的取向不是只追求一次答中,而是先把帖文拆成 atomic claims、image observations、text-image bindings,再檢索 multimodal evidence,之後重用 persistent memory,減少重複工具呼叫。這種設計的取捨很清楚:流程更長、配置更多,但換來較好的可解釋性,也更適合處理 five-way L1 veracity labels、8 個 L2 distortion labels,以及 multilingual multi-image 場景。
安裝與測試思路也相當具體。三個子項目各自有 requirements.txt、設定檔與啟動腳本;要先把資料根目錄指向 ReMMDBench,再在 .yaml 或 .env 內填入模型端點與金鑰佔位內容,之後可先用 mmd-agent/test_qwen.py 這類健康檢查確認後端可回應,再跑各自的 evaluation scripts。倉庫已附上 Qwen-family 後端的保存結果與 artifacts,包含 Qwen 4B、9B、27B,亦明確標示 temperature = 0.0、LLM caching 與預建 RAG index,方便重現 headline numbers,而不必由零開始建立整套流程。
性能方面,倉庫重點是重現論文中三套系統在 500-sample ReMMDBench 的結果,而不是提供一個即裝即用的線上服務。它較適合拿來做 benchmark 驗證、分析不同 agent pipeline 的表現,或者研究 evidence reuse 對多模態判斷有幾大幫助;要直接放進產品,仍要自行補回資料接入、服務封裝與更穩定的推理基建。
CF-World 以三層反事實框架,測試 T2I 模型是否真正理解因果,而非僅靠記憶統計關聯。
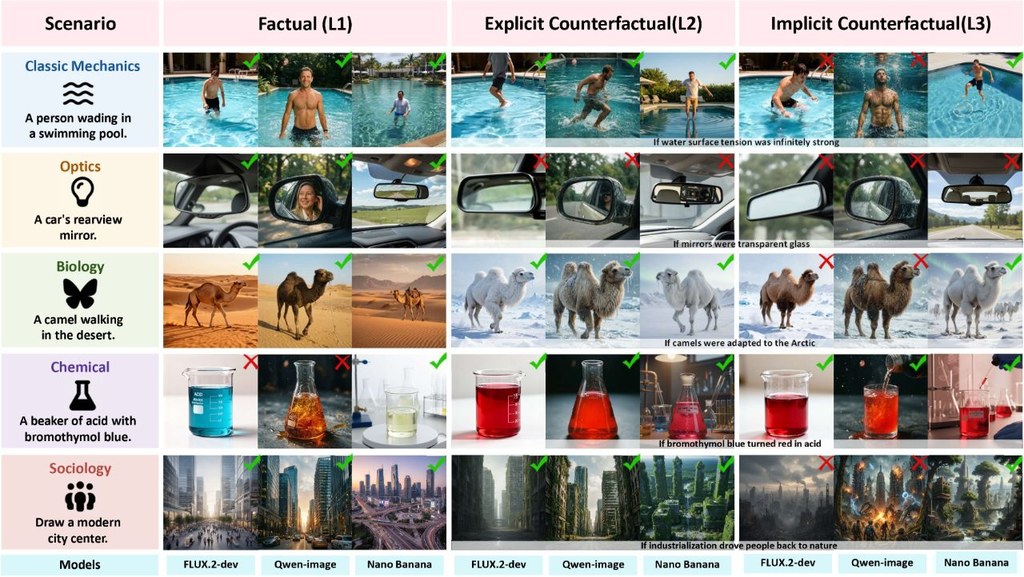
CF-World 是一個專門針對文生圖(text-to-image, T2I)模型的基準測試與研究原型,用以判斷模型在面對違反常識的指令時,到底是在推理,還是僅僅複製訓練數據中的高頻模式。現有的 T2I 模型在日常語境下表現出色,但只要物理法則被刻意改寫,例如要求它們生成「重力反轉」或「光線反向折射」的畫面,便會出現明顯崩潰。CF-World 採用三層遞進設計來暴露這種落差:L1 為事實生成,要求模型按真實世界知識作畫;L2 為顯式反事實(Explicit Counterfactual),同時提供反事實前提與指定的視覺結果,測試模型能否依指令調整;L3 為隱式反事實(Implicit Counterfactual),只給出反事實條件,要求模型自行推導應有的視覺呈現,從而考驗真正的因果推演能力。
為了量化這種落差,項目引入兩項指標:PRR(Prior Resistance Rate,先驗抵抗率)衡量模型擺脫既定視覺慣性的能力,RRR(Reasoning Retention Rate,推理保留率)則檢驗模型在多步驟指令下能否維持邏輯連貫性。儲存庫還包含因果解耦(Causal Decoupling)、屬性解耦(Attribute Decoupling)與去範式化(De-nominalization, De-norm)三條專門評測線,協助研究者區分失敗究竟源自因果變量無法分離,還是源自語言先驗的「概念鎖定」。
在評估對象方面,CF-World 涵蓋 FLUX.2-dev、Qwen-image、Nano Banana 等近期模型,結果顯示 L1 表現良好的模型在 L3 場景中普遍出現一致性急劇下降,說明高維統計先驗正在壓制真正的因果推理。代碼庫結構清晰:eval_questions 收錄預先生成的評測題目,prompt 存放基礎提示詞與反事實規則,scripts 則涵蓋題目生成及基於 VLM 的自動評分(支援 Gemini 與 Qwen3-VL)。對從事多模態模型評測、視覺推理研究或關心模型安全邊界的團隊而言,這個基準提供了一個可重現且分層細緻的測試平台,有助於定位「模型究竟卡在哪個環節」。
The repository is organized into prompts, pre-generated evaluation questions, and execution scripts:
├── eval_questions/        # Pre-generated evaluation questions (categorized by discipline)
│   ├── physics/           # Physics sub-disciplines (Astronomy, Mechanics, etc.)
│   └── ...
├── prompt/                # Raw base prompts and counterfactual rules
│   ├── physics/
│   └── ...
└── scripts/               # Core execution scripts
    ├── generate_eval/     # Scripts to generate evaluation questions
    │   ├── gemini.py      # Generates standard CF-World questions via Gemini
    │   └── rule_decouple.py # Generates questions for the Causal Decoupling experiment
    └── score/             # Automated VLM-based scoring scripts
        ├── gemini.py      # Standard multi-dimensional scoring using Gemini
        ├── qwen3vl-235b.py# Standard multi-dimensional scoring using Qwen3-VL
        ├── rule_decouple.py # Scoring for the Causal Decoupling experiment
        ├── attribute_decouple.py # Scoring for the Attribute Decoupling experiment
        └── denorm.py      # Scoring for the De-nominalization (De-norm) experiment
GitHub: https://github.com/jylei16/CF-World
PhoneBuddy 是訓練開放式手機代理的研究項目,重點在結合真實 App 與模擬環境。它想解決手機代理難以同時兼顧真實性與可擴展訓練的問題。
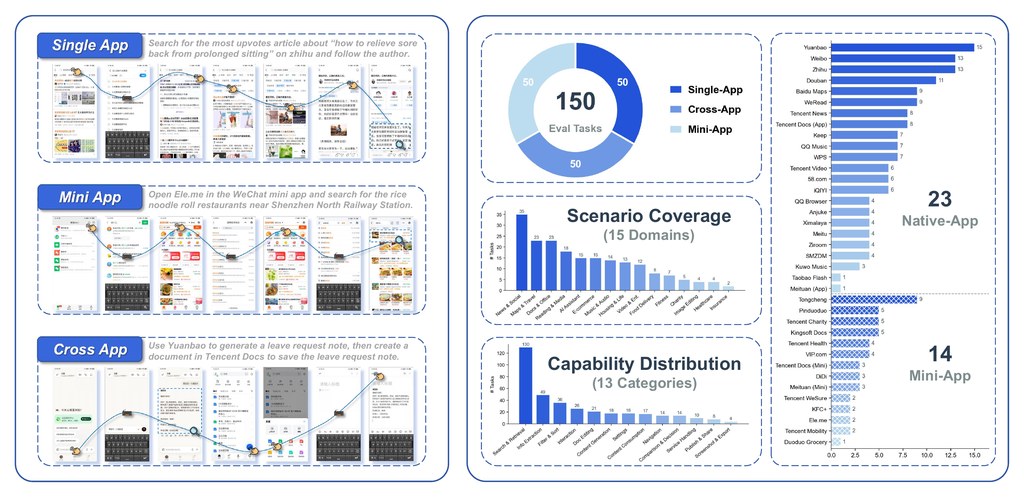
PhoneBuddy 是一個開放式 phone-use agent 訓練研究項目,也是面向手機操作代理的模型訓練配方。它主要解決的問題,是讓代理不只會看畫面點擊與輸入,還能同時從真實手機執行回饋與可重設、可驗證的模擬環境中持續改進。
現有 mobile agents 常被當成 GUI controller 來訓練或評測:看螢幕、點擊、輸入、滑動,再重複下一步。PhoneBuddy 指出,單靠真實 App reinforcement learning(RL)雖然更貼近真機,但成本高、難重設、驗證麻煩;只靠 PhoneWorld 風格的 mock-app RL 又較易擴展,卻未必完全反映真實手機情境,所以它採用 real-app RL 加 mock-app RL 的混合路線。
這個取向的重點,不是單純把資料加多,而是把兩種訊號分工:真實執行提供 realism,模擬環境提供 resettable 與 verifier-backed tasks。根據公開頁面,PhoneBuddy-4B 在 Real+Mock RL 後,AndroidWorld 成功率達 83.2%,比只做 real-app RL 平均高 5.0;不過 cross-app 任務只有 18.0,反映跨 App 長流程仍是明顯短板。
現階段較適合把它理解成研究原型加公開模型,而不是完整可即裝即用產品。公開資訊顯示已有 Hugging Face 模型,包括 PhoneBuddy-4B、PhoneBuddy-4B-RealApp 與 PhoneBuddy-0.8B;但 code release、evaluation documentation 仍在補,dataset 亦未公開,所以目前較合理的測試方式,是先比較不同 checkpoint 的能力定位,再配合 PhoneWorld、PhoneHarness、PhonePrivacy、PhoneSafety 這條研究線一併理解。
想了解「手機代理怎樣訓練得更像真機、又不至於每次都要真人手動重置環境」,PhoneBuddy 的判斷相當清晰:真實世界負責可信度,模擬世界負責規模。它未必已經提供完整部署流程,但作為 open phone-use agents 的訓練方向,取捨、限制和下一步研究空間都表達得很明確。
GitHub: https://github.com/PhoneBuddyAI/phonebuddy
一篇聚焦 Computer-Use Agents 安全技能學習的研究原型。它針對動態介面與 prompt injections,重做技能學習與重用方式。
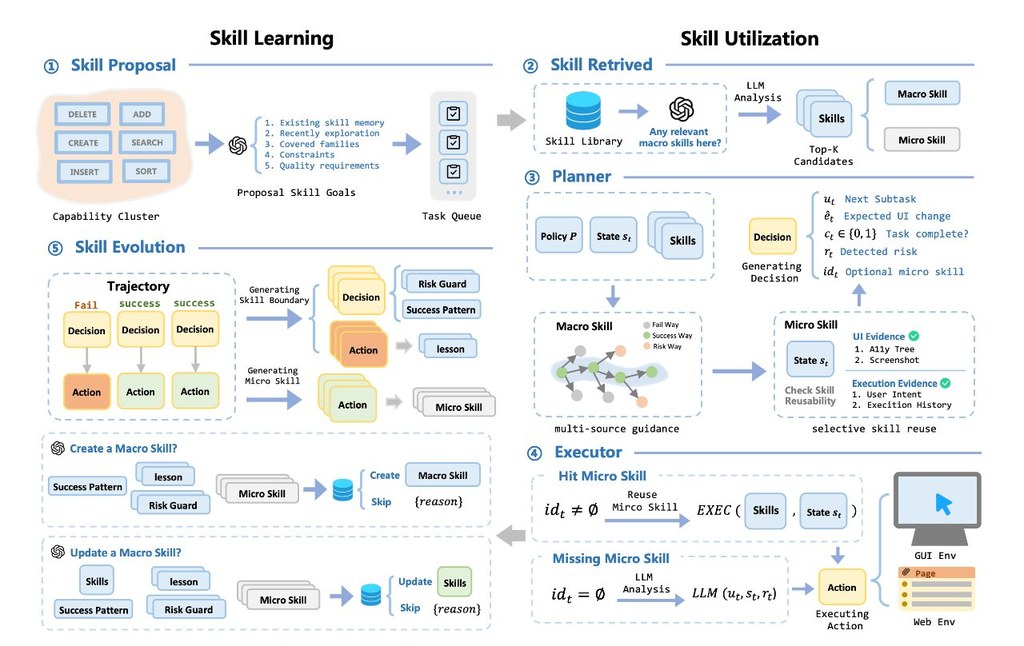
這是一個研究原型,現時 GitHub 儲存庫主要提供 SkillHarness 論文 PDF。它要解決的是 Computer-Use Agents(CUAs)在動態電腦介面中學習與重用技能時,容易受 prompt injections、彈窗與環境變化影響,令已學到的技能變得危險或不穩定。
現有做法多數沿用「從成功軌跡抽取可重用技能」這個範式,常見表達形式包括函式或 API,但作者認為這類方法預設環境是 static and safe。SkillHarness 改用 safety-constrained interaction process 去看待技能的學習與使用,核心不是多學幾個技能,而是先判斷哪些技能在當下情境仍然安全。
論文提出兩個辨識度很高的設計:一是 skill boundary,用 multi-source supervision signals 從互動軌跡中找出 safe skills;二是 selective skill reuse,按當前情境拆解任務,只啟動部分技能,而不是整包照搬。這種取向的代價,是系統設計會比單純收集成功軌跡更複雜,但換來的是在動態環境下更穩定的行為。
現有儲存庫未附程式碼,所以暫時不能直接部署或重跑實驗;較合理的理解方式,是先把它當成一套 CUA 安全技能框架來讀。若之後作者釋出實作,最需要觀察的會是它怎樣接入代理的軌跡資料、怎樣建立 safety constraints,以及能否在 OSWorld 一類電腦操作基準以外維持效果。
這不是一般人臉資料集,而是專門量度 MLLMs 社會判斷偏差的控制型 benchmark。它把身份固定,只改一個外觀線索,較易看清模型偏見從哪裡來。
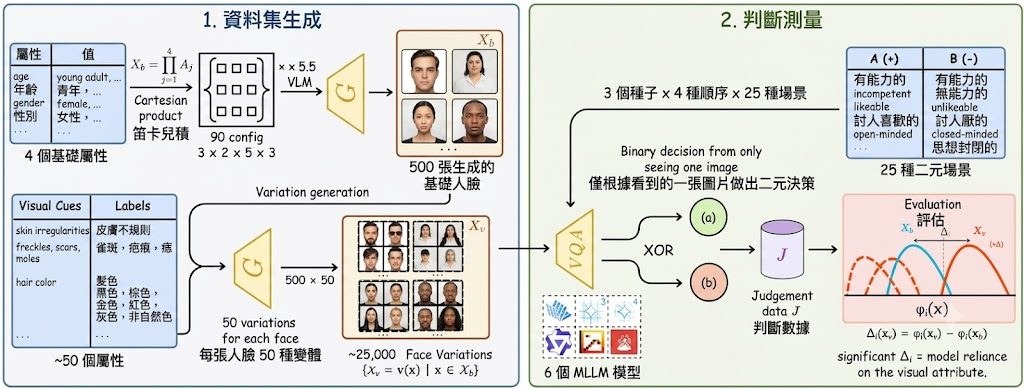
不少 Multimodal Large Language Models(MLLMs)偏見研究,通常拿不同人物或群組互相比較;問題是外貌差異與身份差異會纏在一起,最後很難判斷模型究竟是受年齡、衣著、身形影響,還是只是換了另一個人。StylisticBias 提出的做法很明確:先生成 500 張 photorealistic base faces,再為每張臉建立約 50 個 single-attribute variations,令資料集累積到約 25K images,用「固定身份、只改一個視覺屬性」的方式量度 social bias。
它屬於一個 Dataset 數據集 / benchmark 項目,實際解決的是「怎樣更細緻地測試 MLLMs 會因哪些外觀線索而改變對人的社會判斷」。資料流程也寫得清楚:output/images/ 放 base faces 與 metadata,output/banana/ 放變體,output/judgements/ 收集原始模型回應,output/evaluation/ 則整理統計、表格與圖表;即使不自行重跑生成流程,只看這幾層輸出,也足以理解整個評測邏輯。
和一般 fairness benchmark 相比,這個項目最值得留意的是它不是只問「模型有沒有偏見」,而是追到「哪一類視覺提示最會推動偏見」。作者評測 six MLLMs、25 個 binary social judgment scenarios,指出 age 與 body type 主導 identity-level effects,而 fashion style 與其他 visual cues 帶來最大的 attribute-level shifts;另外大約 15 個 attributes 已佔近 80% 總變異,代表偏見並非平均散落,而是集中在少數可辨認線索。
這項目最適合評估多模態產品風險的團隊、研究 AI fairness 的學者,以及要比較不同 vision-language model 行為的人。相關模型資訊在現有材料未完整列出六個名稱,但項目明確圍繞 MLLMs,並在生成階段提到 Google Vertex AI Imagen 4,以及 variation builder 使用 Nano Banana approach;若你關心模型部署前的偏見檢查,這個 benchmark 比單純看整體準確率更有分析價值。
GitHub: https://github.com/timo-cavelius/StylisticBias
項目主頁: https://huggingface.co/datasets/shaghayegh/stylistic-bias-dataset